


El aprendizaje por refuerzo es una técnica potente para adaptar los modelos de lenguaje grandes (LLM) y maximizar las recompensas de comentarios que proporciona una función de recompensa definida por el usuario. El modelo explora muchas respuestas posibles, observa una recompensa numérica para cada una y cambia gradualmente su comportamiento para que las respuestas con recompensas altas sean más probables y las respuestas con recompensas bajas sean menos probables. Este enfoque se destaca en situaciones que requieren un razonamiento de varios pasos, una toma de decisiones compleja o la comprensión de matices sutiles en las instrucciones.
El ajuste de aprendizaje por refuerzo para Gemini te permite ajustar Gemini con tus propias instrucciones y funciones de recompensa autodefinidas. Puedes usarlo para mejorar la capacidad de razonamiento y la calidad de los resultados de los modelos de Gemini para tus propios casos de uso y flujos de trabajo de agentes.
Cómo funciona
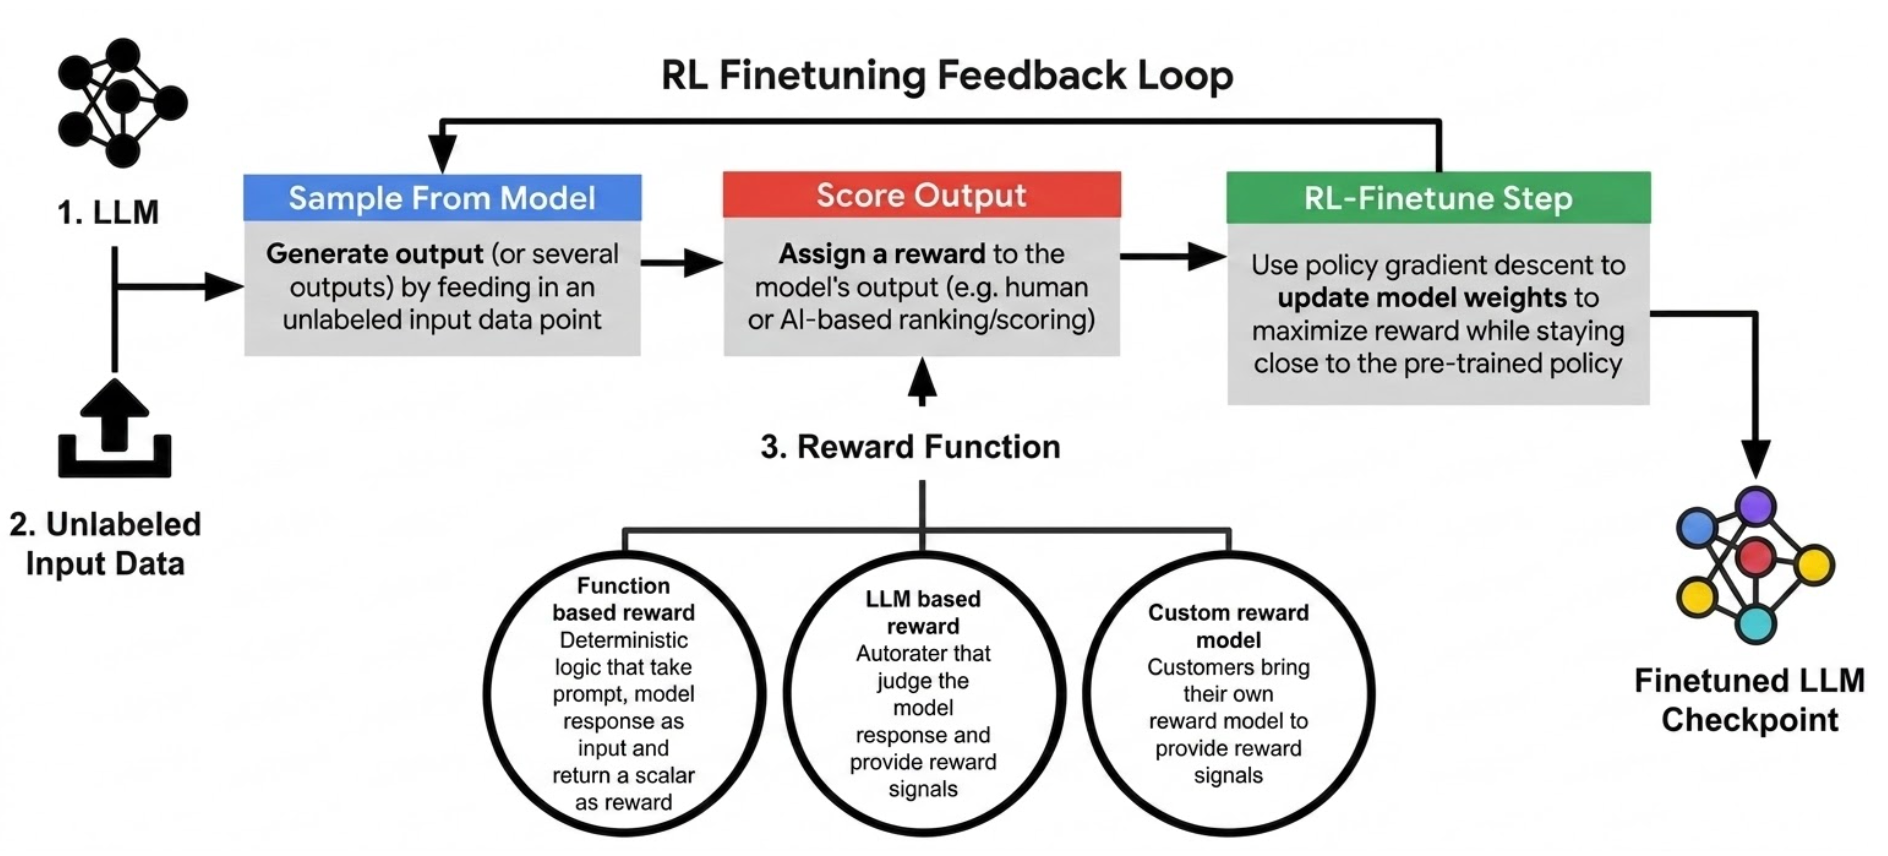
El ajuste de aprendizaje por refuerzo funciona de forma iterativa para definir mejor el comportamiento del LLM. Durante cada iteración, el modelo genera respuestas a un conjunto de instrucciones. Luego, estas respuestas se evalúan con una función de recompensa definida por el usuario, que cuantifica la calidad del resultado generado en función de tus criterios objetivo. El servicio usa este indicador de recompensa para actualizar los parámetros del modelo a través de algoritmos de aprendizaje por refuerzo, con el objetivo de fomentar comportamientos que generen recompensas más altas. Este proceso iterativo de generación, evaluación y actualización de parámetros adapta el modelo a tus casos de uso específicos.
En el siguiente diagrama, se muestra el flujo de trabajo general de ajuste de aprendizaje por refuerzo:
Características clave
El ajuste del aprendizaje por refuerzo incluye las siguientes funciones clave:
Funciones de recompensa personalizables: Define tus propias funciones de recompensa para optimizar con precisión una amplia gama de casos de uso personalizados y alinear el comportamiento del modelo con objetivos específicos. Para obtener detalles sobre los tipos de recompensas compatibles, consulta la página Funciones de recompensa.
Adaptadores para un ajuste eficiente: El ajuste de aprendizaje por refuerzo usa adaptadores, que permiten una adaptación eficaz y, al mismo tiempo, reutilizan la infraestructura de entrega existente.
Múltiples niveles de razonamiento: El servicio admite el ajuste en dos niveles de razonamiento,
MINIMALyHIGH(razonamiento dinámico), para que puedas elegir el enfoque que mejor se adapte a tus objetivos de optimización y patrones de generación de respuestas objetivo. Para obtener más información, consulta la página Hiperparámetros.Ajuste continuo: Refina aún más un modelo ajustado anteriormente incorporando ejemplos o ciclos de entrenamiento adicionales. Usar un modelo ajustado o un punto de control existentes como base permite un proceso más eficiente para ajustar la experimentación. Para obtener más detalles, consulta la página Ajuste continuo.
Conjuntos de datos multimodales: Admite modalidades de datos de texto, imagen, video (solo Gemini 3.5 Flash) y audio.
Cuándo usar el ajuste de aprendizaje por refuerzo
Se prefiere el ajuste de aprendizaje por refuerzo para ajustar los LLM en situaciones en las que las estrategias óptimas no son obvias a través del aprendizaje supervisado. Esto incluye tareas en las que el objetivo es optimizar métricas específicas sin etiquetas de verdad fundamental disponibles, en las que la alineación con las preferencias humanas es crucial (y existe un método de juicio) y para tareas que requieren mucho razonamiento y que se benefician de la mejora y la exploración iterativas.
A continuación, se incluyen algunas situaciones en las que se prefiere el ajuste de aprendizaje por refuerzo:
Seguimiento de instrucciones complejas: Cuando el modelo necesita seguir instrucciones complejas en las que el resultado "correcto" no es una sola respuesta, sino que requiere un conjunto de verificaciones. El aprendizaje por refuerzo puede adaptar el modelo para que navegue por estos conjuntos de instrucciones complejos.
Generación de contenido creativo: Para tareas como la generación de escritura creativa, poesía o código altamente especializado, en las que las métricas objetivas son difíciles de definir. El aprendizaje por refuerzo, con una función de recompensa bien diseñada (que puede incluir comentarios de humanos o evaluaciones de expertos), puede guiar al modelo hacia resultados más eficaces e innovadores.
Tareas de razonamiento: En el caso de las tareas que requieren un razonamiento intenso, como resolver acertijos de palabras o problemas matemáticos, el aprendizaje por refuerzo puede incentivar al modelo a explorar diferentes secuencias de razonamiento para identificar qué patrones son más eficaces para resolver problemas.
Modelos y regiones compatibles
Los siguientes modelos de Gemini admiten el ajuste de aprendizaje por refuerzo:
Gemini 3.5 Flash
| Especificación | Valor |
|---|---|
| Extremos compatibles para el ajuste de modelos |
|
| Extremos compatibles para la entrega de modelos ajustados |
|
| Versión de API | Solo v1beta1 |
Gemini 3.1 Flash-Lite
| Especificación | Valor |
|---|---|
| Extremos compatibles para el ajuste de modelos |
|
| Extremos compatibles para la entrega de modelos ajustados |
|
| Versión de API | Solo v1beta1 |
Modalidades de ajuste compatibles
El ajuste fino del aprendizaje por refuerzo admite las siguientes modalidades de datos en tus conjuntos de datos de ajuste:
- Texto
- Audio
- Imagen
- Video (solo compatible con Gemini 3.5 Flash)
Para conocer los límites de los conjuntos de datos por modalidad (como la cantidad máxima de archivos por instrucción, el tamaño máximo de los archivos y la longitud total máxima), consulta la página Conjunto de datos de ajuste.
Ajuste continuo
Puedes usar el resultado de un trabajo de ajuste anterior como base para un nuevo trabajo de ajuste de aprendizaje por refuerzo. Se admiten los siguientes patrones de ajuste continuo:
- Ajuste supervisado → Ajuste del aprendizaje por refuerzo
- Ajuste del aprendizaje por refuerzo → Ajuste del aprendizaje por refuerzo
Para obtener detalles sobre la configuración, consulta la página Ajuste continuo.
Entrega el modelo ajustado
Después de un trabajo de ajuste de aprendizaje por refuerzo exitoso en el modelo de Gemini base, se implementa un modelo ajustado basado en el último punto de control en un extremo de tu proyecto. Los modelos ajustados usan la misma estrategia de extremo de entrega
que el modelo base. Por ejemplo, si ejecutas un trabajo de ajuste en
us-central1, el modelo ajustado se implementa en un extremo multirregional (mREP)
de us.
Para recuperar el extremo del modelo ajustado implementado en la consola de Google Cloud o con la API y ejecutar la inferencia en él, consulta la guía de inicio rápido de la consola deGoogle Cloud o la guía de inicio rápido de la API.
Precios
Precios de ajuste
El ajuste de aprendizaje por refuerzo para Gemini genera tokens en dos fases: una de muestreo y otra de entrenamiento. Los tokens generados durante la fase de entrenamiento se cobran según la sección "Ajuste de modelos" de la página de precios de Gemini Enterprise Agent Platform.
Precios de inferencia
Después del ajuste, se aplican los costos de inferencia (solicitud de predicción) para el modelo ajustado. Para Gemini 3 y modelos posteriores, el precio de predicción del extremo del modelo ajustado es 1.5 veces el precio del modelo base. Para obtener más información, consulta Versiones disponibles del modelo estable de Gemini.
Si configuras el Gen AI Evaluation Service para que se ejecute automáticamente durante el ajuste, las evaluaciones se cobran como trabajos de predicción por lotes. Para obtener más información, consulta la sección "Ajuste de modelos" de la página Precios de Agent Platform.
¿Qué sigue?
- Sigue la guía de inicio rápido de la consola deGoogle Cloud o la guía de inicio rápido de la API para crear tu primer trabajo de ajuste de aprendizaje por refuerzo.
- Aprende a preparar un conjunto de datos de ajuste y configurar funciones de recompensa.
- Obtén información para implementar un modelo de Gemini ajustado.