


סיכום
במדריך הזה נסביר איך לפרוס מודלים של Llama 3.1 ו-3.2 ולהציג אותם באמצעות vLLM בפלטפורמת Gemini Enterprise Agent. הוא מיועד לשימוש בשילוב עם שני קובצי Notebook נפרדים: הצגת Llama 3.1 עם vLLM לפריסת מודלים של Llama 3.1 לטקסט בלבד, והצגת Llama 3.2 מולטי-מודאלי עם vLLM לפריסת מודלים של Llama 3.2 מולטי-מודאליים שמטפלים גם בקלט של טקסט וגם בקלט של תמונות. השלבים שמפורטים בדף הזה מראים איך לטפל ביעילות בהסקת מודלים ב-GPU ולהתאים אישית מודלים לאפליקציות שונות, כדי לתת לכם את הכלים לשלב מודלים מתקדמים של שפה בפרויקטים שלכם.
בסוף המדריך הזה, תבינו איך:
- מורידים מודלים של Llama שנוצרו מראש מ-Hugging Face עם קונטיינר vLLM.
- אתם יכולים להשתמש ב-vLLM כדי לפרוס את המודלים האלה במכונות GPU ב-Model Garden ב- Google CloudGemini Enterprise Agent Platform.
- להציג מודלים ביעילות כדי לטפל בבקשות להסקת מסקנות בקנה מידה רחב.
- להריץ הסקות על בקשות של טקסט בלבד ועל בקשות של טקסט ותמונה.
- ניקוי.
- ניפוי באגים בפריסה.
התכונות העיקריות של vLLM
| התכונה | תיאור |
|---|---|
| PagedAttention | מנגנון תשומת לב שעבר אופטימיזציה ומנהל את הזיכרון ביעילות במהלך הסקת המסקנות. תמיכה ביצירת טקסט בנפח גבוה על ידי הקצאה דינמית של משאבי זיכרון, שמאפשרת מדרגיות עבור מספר בקשות מקבילות. |
| עיבוד באצווה רציף | מאחד כמה בקשות קלט לאצווה אחת לעיבוד מקביל, כדי למקסם את השימוש ב-GPU ואת קצב הנתונים. |
| סטרימינג של טוקנים | הפעלת פלט בזמן אמת של טוקן אחר טוקן במהלך יצירת הטקסט. המודל הזה מתאים לאפליקציות שדורשות זמן אחזור קצר, כמו צ'אט בוטים או מערכות AI אינטראקטיביות. |
| תאימות למודלים | תמיכה במגוון רחב של מודלים שעברו אימון מראש במסגרות פופולריות כמו Hugging Face Transformers. קל יותר לשלב מודלים שונים של LLM ולהתנסות בהם. |
| מספר מעבדי GPU ומספר מארחים | מאפשרת לפרסם מודלים ביעילות על ידי חלוקת עומס העבודה בין כמה יחידות GPU במכונה אחת ובין כמה מכונות באשכול, וכך מגדילה באופן משמעותי את התפוקה ואת יכולת ההתאמה לעומס. |
| פריסה יעילה | הוא מציע שילוב חלק עם ממשקי API, כמו השלמות צ'אט של OpenAI, כך שקל לפרוס אותו בתרחישי שימוש בסביבת ייצור. |
| שילוב חלק עם מודלים של Hugging Face | vLLM תואם לפורמט של פריטי המידע שנוצרו בתהליך הפיתוח (artifacts) של מודל Hugging Face ותומך בטעינה מ-HF, כך שקל לפרוס מודלים של Llama לצד מודלים פופולריים אחרים כמו Gemma, Phi ו-Qwen בהגדרה אופטימלית. |
| פרויקט קוד פתוח שמונע על ידי הקהילה | vLLM הוא קוד פתוח ומעודד תרומות מהקהילה, מה שמקדם שיפור מתמשך ביעילות של הצגת LLM. |
התאמות אישיות של vLLM ב-Google Gemini Enterprise Agent Platform: שיפור הביצועים והשילוב
הטמעת ה-vLLM ב-Model Garden ב-Google Gemini Enterprise Agent Platform היא לא שילוב ישיר של ספריית הקוד הפתוח. ב-Gemini Enterprise Agent Platform יש גרסה מותאמת אישית ומשופרת של vLLM, שנועדה לשפר את הביצועים, האמינות והשילוב החלק ב- Google Cloud.
- אופטימיזציה של הביצועים:
- הורדה במקביל מ-Cloud Storage: מאפשרת לאחזר נתונים במקביל מ-Cloud Storage, וכך מקצרת משמעותית את זמני הטעינה והפריסה של המודל, מפחיתה את זמן האחזור ומשפרת את מהירות ההפעלה.
- שיפורים בתכונות:
- LoRA דינמי עם מטמון משופר ותמיכה ב-Cloud Storage: הרחבה של יכולות ה-LoRA הדינמיות באמצעות מנגנוני שמירה במטמון בדיסק המקומי וטיפול יעיל בשגיאות, לצד תמיכה בטעינת משקולות LoRA ישירות מנתיבי Cloud Storage ומכתובות URL חתומות. כך קל יותר לנהל ולפרוס מודלים בהתאמה אישית.
- ניתוח קריאה להפעלת פונקציות של Llama 3.1/3.2: הטמעה של ניתוח מיוחד לקריאה להפעלת פונקציות של Llama 3.1/3.2, שמשפר את עמידות הניתוח.
- שמירת קידומות במטמון בזיכרון המארח: ה-vLLM החיצוני תומך רק בשמירת קידומות במטמון בזיכרון ה-GPU.
- פענוח ספקולטיבי: זו תכונה קיימת של vLLM, אבל ב-Gemini Enterprise Agent Platform ערכנו ניסויים כדי למצוא הגדרות של מודלים עם ביצועים גבוהים.
ההתאמות האישיות האלה, שספציפיות ל-Gemini Enterprise Agent Platform, בדרך כלל לא גלויות למשתמשי הקצה, אבל הן מאפשרות לכם למקסם את הביצועים והיעילות של פריסות Llama 3.1 ב-Model Garden של Gemini Enterprise Agent Platform.
- שילוב של Gemini Enterprise Agent Platform בסביבה העסקית:
- תמיכה בפורמט הקלט/פלט של החיזוי ב-Gemini Enterprise Agent Platform: תאימות חלקה לפורמטים של הקלט והפלט של החיזוי ב-Gemini Enterprise Agent Platform, כדי לפשט את הטיפול בנתונים ואת השילוב עם שירותים אחרים של Gemini Enterprise Agent Platform.
- מודעות למשתני סביבה של Vertex: מכבדת את משתני הסביבה של Gemini Enterprise Agent Platform (
AIP_*) ומשתמשת בהם להגדרות ולניהול משאבים, כדי לייעל את הפריסה ולהבטיח התנהגות עקבית בסביבת Gemini Enterprise Agent Platform. - טיפול משופר בשגיאות ויציבות: הטמעה של מנגנונים מקיפים לטיפול בשגיאות, לאימות קלט/פלט ולסיום פעולת השרת, כדי להבטיח יציבות, אמינות ופעולה חלקה בסביבה המנוהלת של Gemini Enterprise Agent Platform.
- שרת Nginx ליכולת: משלב שרת Nginx מעל שרת ה-vLLM, מה שמאפשר לפרוס כמה רפליקות ומשפר את הסקלאביליות והזמינות הגבוהה של תשתית ההצגה.
יתרונות נוספים של vLLM
- ביצועים של נקודת השוואה (Benchmark): vLLM מציע ביצועים תחרותיים בהשוואה למערכות הצגה אחרות כמו הסקת מסקנות ליצירת טקסט של Hugging Face ו-FasterTransformer של NVIDIA, מבחינת תפוקה וזמן אחזור.
- קלות שימוש: הספרייה מספקת API פשוט לשילוב עם תהליכי עבודה קיימים, ומאפשרת לפרוס את המודלים של Llama 3.1 ו-3.2 בהגדרה מינימלית.
- תכונות מתקדמות: vLLM תומך בפלט סטרימינג (יצירת תשובות טוקן אחרי טוקן) ומטפל ביעילות בהנחיות באורכים שונים, מה שמשפר את האינטראקטיביות ואת מהירות התגובה באפליקציות.
במאמר הזה מופיעה סקירה כללית של מערכת vLLM.
מודלים נתמכים
vLLM תומך במגוון רחב של מודלים מתקדמים, כך שאתם יכולים לבחור את המודל שהכי מתאים לצרכים שלכם. בטבלה הבאה מוצגים כמה מהמודלים האלה. כדי לראות רשימה מקיפה של המודלים הנתמכים, כולל מודלים להסקת מסקנות מטקסט בלבד וממודלים מולטי-מודאליים, אתם יכולים להיכנס לאתר הרשמי של vLLM.
| קטגוריה | מודלים |
|---|---|
| Meta AI | Llama 3.3, Llama 3.2, Llama 3.1, Llama 3, Llama 2, Code Llama |
| Mistral AI | Mistral 7B, Mixtral 8x7B, Mixtral 8x22B והווריאציות שלהם (Instruct, Chat), Mistral-tiny, Mistral-small, Mistral-medium |
| DeepSeek AI | DeepSeek-V3, DeepSeek-R1, DeepSeek-R1-Distill-Qwen-1.5B, DeepSeek-R1-Distill-Qwen-7B, DeepSeek-R1-Distill-Llama-8B, DeepSeek-R1-Distill-Qwen-14B, DeepSeek-R1-Distill-Qwen-32B, DeepSeek-R1-Distill-Llama-70B, Deepseek-vl2-זעיר, Deepseek-vl2-קטן, Deepseek-vl2 |
| MosaicML | MPT (7B, 30B) וגרסאות (Instruct, Chat), MPT-7B-StoryWriter-65k |
| OpenAI | GPT-2, GPT-3, GPT-4, GPT-NeoX |
| Together AI | RedPajama, Pythia |
| Stability AI | StableLM (3B, 7B), StableLM-Alpha-3B, StableLM-Base-Alpha-7B, StableLM-Instruct-Alpha-7B |
| TII (Technology Innovation Institute) | Falcon 7B, Falcon 40B וגרסאות (Instruct, Chat), Falcon-RW-1B, Falcon-RW-7B |
| BigScience | BLOOM, BLOOMZ |
| FLAN-T5, UL2, Gemma (2B, 7B), PaLM 2, | |
| Salesforce | CodeT5, CodeT5+ |
| LightOn | Persimmon-8B-base, Persimmon-8B-chat |
| EleutherAI | GPT-Neo, Pythia |
| AI21 Labs | Jamba |
| Cerebras | Cerebras-GPT |
| Intel | Intel-NeuralChat-7B |
| מודלים בולטים אחרים | StarCoder, OPT, Baichuan, Aquila, Qwen, InternLM, XGen, OpenLLaMA, Phi-2, Yi, OpenCodeInterpreter, Nous-Hermes, Gemma-it, Mistral-Instruct-v0.2-7B-Zeus, |
תחילת העבודה ב-Model Garden
מאגר החוויות המוצגות של vLLM Cloud GPUs משולב ב-Model Garden, בארגז החול, בפריסה בלחיצה אחת ובדוגמאות של Notebook ב-Colab Enterprise. המדריך הזה מתמקד במשפחת המודלים Llama של Meta AI כדוגמה.
שימוש ב-notebook של Colab Enterprise
אפשר גם לפרוס באמצעות Playground ובלחיצה אחת, אבל לא נתאר את זה במדריך הזה.
- עוברים לדף כרטיס המודל ולוחצים על Open notebook.
- בוחרים את ה-notebook של Vertex Serving. ה-notebook נפתח ב-Colab Enterprise.
- מריצים את ה-notebook כדי לפרוס מודל באמצעות vLLM ולשלוח בקשות חיזוי לנקודת הקצה.
הגדרה ודרישות
בקטע הזה מוסבר איך להגדיר את הפרויקט ב- Google Cloudולוודא שיש לכם את המשאבים הנדרשים לפריסה ולשימוש במודלים של vLLM.
1. חיוב
- הפעלת החיוב: מוודאים שהחיוב מופעל בפרויקט. למידע נוסף, קראו את המאמר הפעלה, השבתה ושינוי של חיוב בפרויקט.
2. זמינות ומכסות של GPU
- כדי להריץ חיזויים באמצעות יחידות GPU עם ביצועים גבוהים (NVIDIA A100 80GB או H100 80GB), חשוב לבדוק את המכסות של יחידות ה-GPU האלה באזור שבחרתם:
| סוג המכונה | סוג המאיץ | אזורים מומלצים |
|---|---|---|
| a2-ultragpu-1g | 1 NVIDIA_A100_80GB | us-central1, us-east4, europe-west4, asia-southeast1 |
| a3-highgpu-8g | 8 NVIDIA_H100_80GB | us-central1, us-west1, europe-west4, asia-southeast1 |
3. הגדרת פרויקט ב- Google Cloud
מריצים את דוגמת הקוד הבאה כדי לוודא שהסביבה של Google Cloud מוגדרת בצורה נכונה. בשלב הזה מתקינים את ספריות Python הנדרשות ומגדירים גישה למשאבים של Google Cloud . הפעולות כוללות:
- התקנה: משדרגים את הספרייה
google-cloud-aiplatformומשכפלים את המאגר שמכיל פונקציות בסיסיות. - הגדרת הסביבה: הגדרת משתנים ל Google Cloud מזהה הפרויקט, לאזור ולקטגוריה ייחודית של Cloud Storage לאחסון פריטי המידע שנוצרו בתהליך הפיתוח (artifacts) של המודל.
- הפעלת ממשקי API: הפעילו את Gemini Enterprise Agent Platform ואת Compute Engine API, שחיוניים לפריסה ולניהול של מודלי AI.
- הגדרת קטגוריה של Cloud Storage: יוצרים קטגוריה חדשה של Cloud Storage או בודקים קטגוריה קיימת כדי לוודא שהיא נמצאת באזור הנכון.
- הפעלת Gemini Enterprise Agent Platform: מפעילים את ספריית הלקוח של Gemini Enterprise Agent Platform עם הגדרות הפרויקט, המיקום וה-staging bucket.
- הגדרת חשבון שירות: זיהוי חשבון השירות שמוגדר כברירת מחדל להרצת משימות ב-Gemini Enterprise Agent Platform, והענקת ההרשאות הנדרשות.
BUCKET_URI = "gs://"

REGION = ""

! pip3 install --upgrade --quiet 'google-cloud-aiplatform>=1.64.0'
! git clone https://github.com/GoogleCloudPlatform/vertex-ai-samples.git

import datetime
import importlib
import os
import uuid
from typing import Tuple

import requests
from google.cloud import aiplatform

common_util = importlib.import_module(
    "vertex-ai-samples.community-content.vertex_model_garden.model_oss.notebook_util.common_util"
)

models, endpoints = {}, {}

PROJECT_ID = os.environ["GOOGLE_CLOUD_PROJECT"]

if not REGION:
    REGION = os.environ["GOOGLE_CLOUD_REGION"]

print("Enabling Agent Platform API and Compute Engine API.")
! gcloud services enable aiplatform.googleapis.com compute.googleapis.com

now = datetime.datetime.now().strftime("%Y%m%d%H%M%S")
BUCKET_NAME = "/".join(BUCKET_URI.split("/")[:3])

if BUCKET_URI is None or BUCKET_URI.strip() == "" or BUCKET_URI == "gs://":
    BUCKET_URI = f"gs://{PROJECT_ID}-tmp-{now}-{str(uuid.uuid4())[:4]}"
    BUCKET_NAME = "/".join(BUCKET_URI.split("/")[:3])
    ! gsutil mb -l {REGION} {BUCKET_URI}
else:
    assert BUCKET_URI.startswith("gs://"), "BUCKET_URI must start with `gs://`."
    shell_output = ! gsutil ls -Lb {BUCKET_NAME} | grep "Location constraint:" | sed "s/Location constraint://"
    bucket_region = shell_output[0].strip().lower()
    if bucket_region != REGION:
        raise ValueError(
            "Bucket region %s is different from notebook region %s"
            % (bucket_region, REGION)
        )
print(f"Using this Bucket: {BUCKET_URI}")

STAGING_BUCKET = os.path.join(BUCKET_URI, "temporal")
MODEL_BUCKET = os.path.join(BUCKET_URI, "llama3_1")

print("Initializing Agent Platform API.")
aiplatform.init(project=PROJECT_ID, location=REGION, staging_bucket=STAGING_BUCKET)

shell_output = ! gcloud projects describe $PROJECT_ID
project_number = shell_output[-1].split(":")[1].strip().replace("'", "")
SERVICE_ACCOUNT = "your service account email"
print("Using this default Service Account:", SERVICE_ACCOUNT)

! gsutil iam ch serviceAccount:{SERVICE_ACCOUNT}:roles/storage.admin $BUCKET_NAME

! gcloud config set project $PROJECT_ID
! gcloud projects add-iam-policy-binding --no-user-output-enabled {PROJECT_ID} --member=serviceAccount:{SERVICE_ACCOUNT} --role="roles/storage.admin"
! gcloud projects add-iam-policy-binding --no-user-output-enabled {PROJECT_ID} --member=serviceAccount:{SERVICE_ACCOUNT} --role="roles/aiplatform.user"
שימוש ב-Hugging Face עם Meta Llama 3.1, 3.2 ו-vLLM
האוספים Llama 3.1 ו-Llama 3.2 של Meta כוללים מגוון מודלים גדולים של שפה (LLM) בכמה שפות, שמיועדים ליצירת טקסט באיכות גבוהה בתרחישים שונים לדוגמה. המודלים האלה עוברים אימון מקדים וכוונון לפי הוראות, והם מצטיינים במשימות כמו שיחה בכמה שפות, סיכום ושליפה אג'נטית. לפני שמשתמשים במודלים של Llama 3.1 ו-3.2, צריך לאשר את התנאים וההגבלות שלהם, כמו שמוצג בצילום המסך. ספריית vLLM מציעה סביבת שירות יעילה בקוד פתוח, עם אופטימיזציה של זמן האחזור, יעילות הזיכרון והתאמה לעומס (scaling).
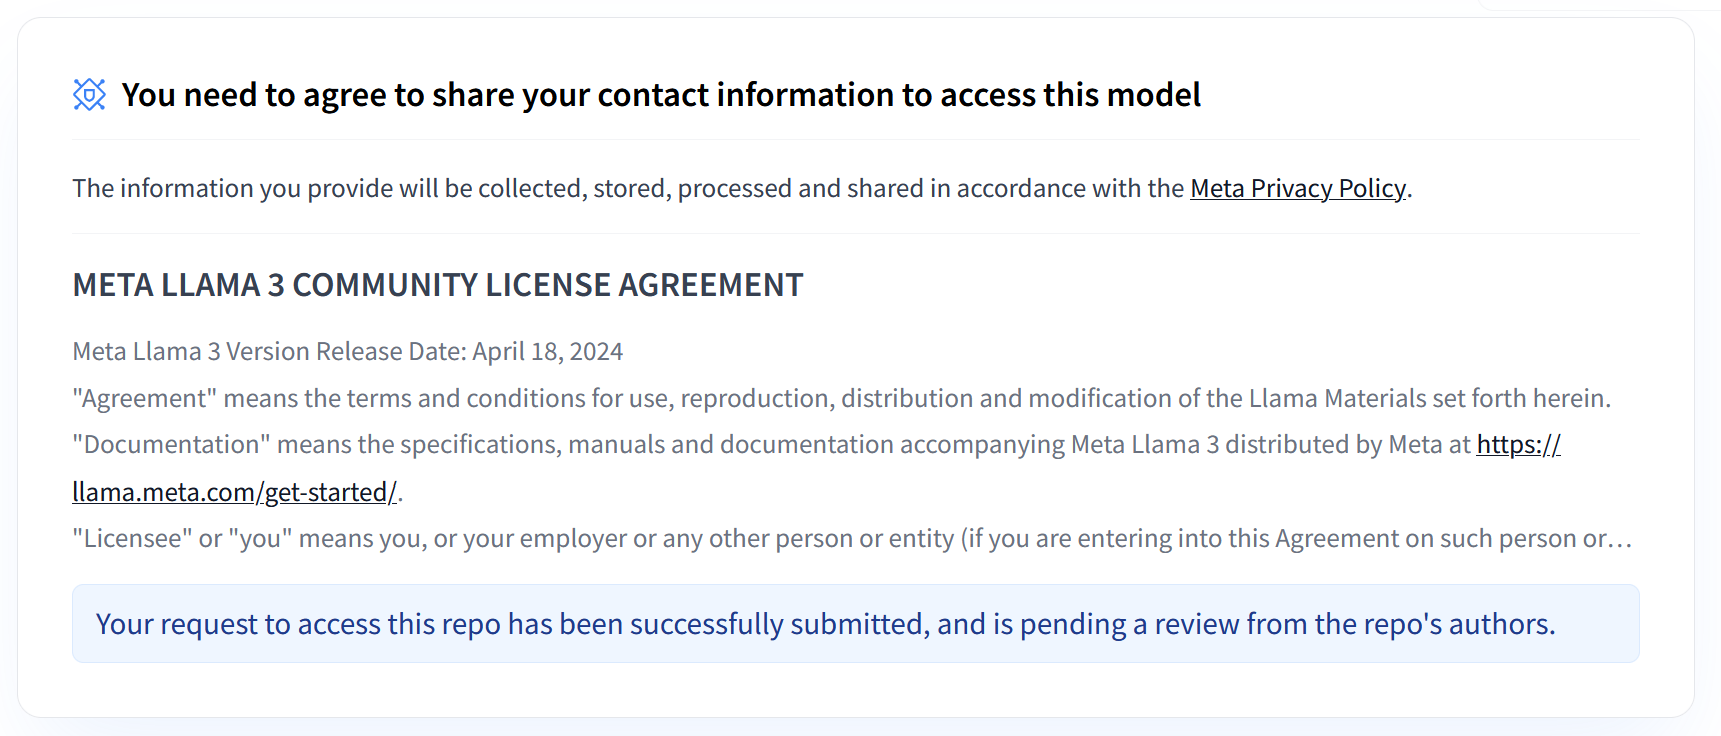 איור 1: הסכם הרישיון של קהילת Meta LLama 3
סקירה כללית על Meta Llama 3.1 ו-3.2 Collections
האוספים של Llama 3.1 ו-Llama 3.2 מתאימים להיקפי פריסה ולגדלים שונים של מודלים, ומספקים אפשרויות גמישות למשימות של דיאלוגים בכמה שפות ועוד. מידע נוסף זמין בדף הסקירה הכללית של Llama.
- טקסט בלבד: אוסף Llama 3.2 של מודלי שפה גדולים (LLM) רב-לשוניים הוא אוסף של מודלים גנרטיביים שעברו אימון מראש וכוונון לפי הוראות בגדלים 1B ו-3B (קלט טקסט, פלט טקסט).
- Vision ו-Vision Instruct: אוסף Llama 3.2-Vision של מודלים גדולים של שפה (LLM) מולטי-מודאליים הוא אוסף של מודלים גנרטיביים של חשיבה על תמונות, שעברו אימון מראש וכוונון לפי הוראות, בגדלים 11B ו-90B (קלט של טקסט ותמונות, פלט של טקסט). אופטימיזציה: כמו Llama 3.1, מודלי 3.2 מותאמים לשיחות בכמה שפות ומציגים ביצועים טובים במשימות אחזור וסיכום, עם תוצאות מובילות בבדיקות השוואתיות סטנדרטיות.
- ארכיטקטורת המודל: מודל Llama 3.2 כולל גם מסגרת טרנספורמר רגרסיבית אוטומטית, עם SFT ו-RLHF שנועדו להתאים את המודלים למועילוּת ולבטיחות.
טוקני גישה של משתמשים ב-Hugging Face
כדי לגשת למשאבים הנדרשים, במדריך הזה צריך אסימון גישה לקריאה מ-Hugging Face Hub. כדי להגדיר את האימות:
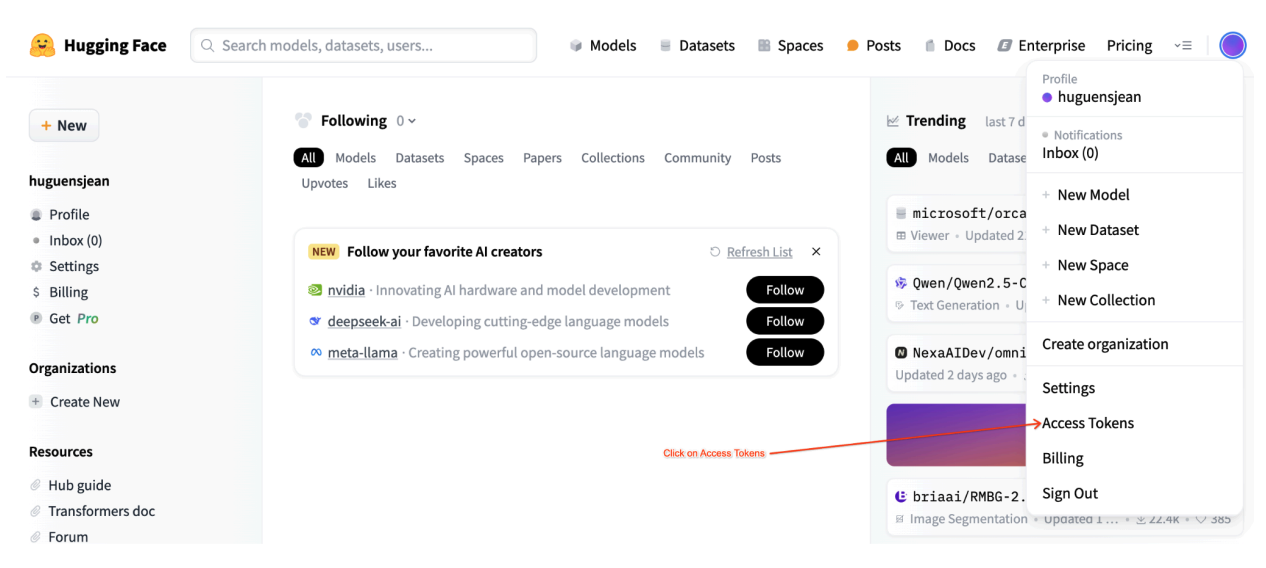 איור 2: הגדרות של טוקן גישה ל-Hugging Face
יוצרים טוקן גישה לקריאה:
- עוברים אל הגדרות החשבון ב-Hugging Face.
- יוצרים טוקן חדש, מקצים לו את התפקיד "קריאה" ושומרים את הטוקן באופן מאובטח.
משתמשים בטוקן:
- משתמשים בטוקן שנוצר כדי לאמת את הגישה למאגרים ציבוריים או פרטיים, לפי הצורך במדריך.
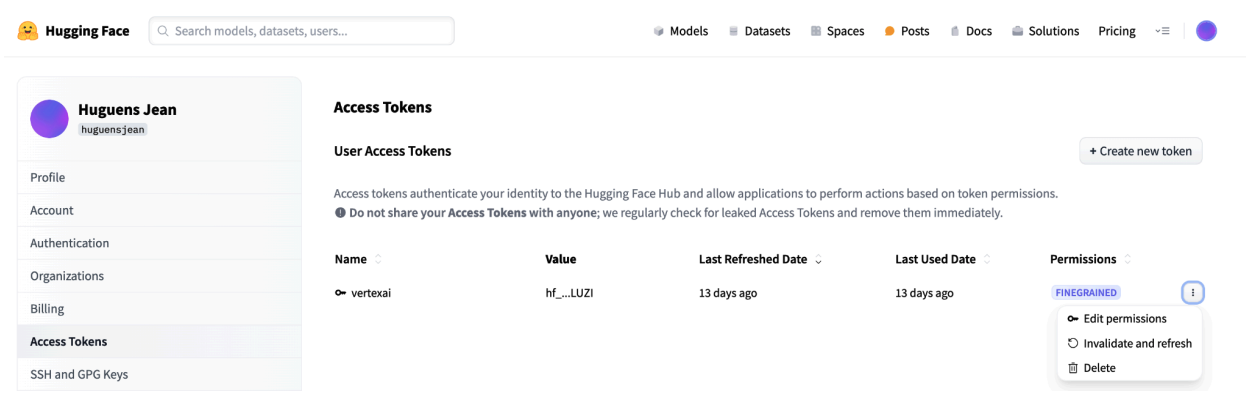 איור 3: ניהול טוקן הגישה ל-Hugging Face
כך תהיה לכם רמת הגישה המתאימה בלי הרשאות מיותרות. השיטות האלה משפרות את האבטחה ומונעות חשיפה מקרית של טוקנים. מידע נוסף על הגדרת טוקני גישה זמין בדף טוקני הגישה של Hugging Face.
אל תשתפו את הטוקן ואל תחשפו אותו באופן גלוי לכולם או באינטרנט. כשמגדירים את הטוקן כמשתנה סביבה במהלך הפריסה, הוא נשאר פרטי בפרויקט. כדי לשמור על האבטחה, פלטפורמת הסוכנים של Gemini Enterprise מונעת ממשתמשים אחרים לגשת למודלים ולנקודות הקצה שלכם.
מידע נוסף על הגנה על טוקן הגישה זמין במאמר Hugging Face Access Tokens - Best Practices.
פריסת מודלים של Llama 3.1 עם vLLM לטקסט בלבד
לפריסה של מודלי שפה גדולים ברמת הייצור, vLLM מספק פתרון יעיל להצגת מודעות שמשפר את השימוש בזיכרון, מקצר את זמן האחזור ומגדיל את הקיבולת. לכן הוא מתאים במיוחד לטיפול במודלים הגדולים יותר של Llama 3.1 וגם במודלים המולטי-מודאליים של Llama 3.2.
שלב 1: בוחרים מודל לפריסה
בוחרים את גרסת המודל של Llama 3.1 שרוצים לפרוס. האפשרויות הזמינות כוללות גדלים שונים וגרסאות שעברו כוונון לפי הוראות:
base_model_name = "Meta-Llama-3.1-8B"  # @param ["Meta-Llama-3.1-8B", "Meta-Llama-3.1-8B-Instruct", "Meta-Llama-3.1-70B", "Meta-Llama-3.1-70B-Instruct", "Meta-Llama-3.1-405B-FP8", "Meta-Llama-3.1-405B-Instruct-FP8"]
hf_model_id = "meta-Llama/" + base_model_name
שלב 2: בודקים את החומרה והמכסה של הפריסה
פונקציית הפריסה מגדירה את ה-GPU ואת סוג המכונה המתאימים לפי גודל המודל, ובודקת את המכסה באותו אזור לפרויקט מסוים:
if "8b" in base_model_name.lower():
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-12"
    accelerator_count = 1
elif "70b" in base_model_name.lower():
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-96"
    accelerator_count = 8
elif "405b" in base_model_name.lower():
    accelerator_type = "NVIDIA_H100_80GB"
    machine_type = "a3-highgpu-8g"
    accelerator_count = 8
else:
    raise ValueError(f"Recommended GPU setting not found for: {accelerator_type} and {base_model_name}.")
בודקים את זמינות המכסה של ה-GPU באזור שציינתם:
common_util.check_quota(
    project_id=PROJECT_ID,
    region=REGION,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    is_for_training=False,
)
שלב 3: בודקים את המודל באמצעות vLLM
הפונקציה הבאה מעלה את המודל ל-Gemini Enterprise Agent Platform, קובעת את הגדרות הפריסה ופורסת אותו בנקודת קצה באמצעות vLLM.
- קובץ אימג' של Docker: הפריסה משתמשת בקובץ אימג' של Docker ב-vLLM שנוצר מראש כדי להציג ביעילות.
- Configuration: הגדרת ניצול הזיכרון, אורך המודל והגדרות vLLM אחרות. מידע נוסף על הארגומנטים שנתמכים על ידי השרת זמין בדף התיעוד הרשמי של vLLM.
- Environment Variables: הגדרת משתני סביבה לאימות ולמקור הפריסה.
def deploy_model_vllm(
    model_name: str,
    model_id: str,
    service_account: str,
    base_model_id: str = None,
    machine_type: str = "g2-standard-8",
    accelerator_type: str = "NVIDIA_L4",
    accelerator_count: int = 1,
    gpu_memory_utilization: float = 0.9,
    max_model_len: int = 4096,
    dtype: str = "auto",
    enable_trust_remote_code: bool = False,
    enforce_eager: bool = False,
    enable_lora: bool = False,
    max_loras: int = 1,
    max_cpu_loras: int = 8,
    use_dedicated_endpoint: bool = False,
    max_num_seqs: int = 256,
) -> Tuple[aiplatform.Model, aiplatform.Endpoint]:
    """Deploys trained models with vLLM into Agent Platform."""
    endpoint = aiplatform.Endpoint.create(
        display_name=f"{model_name}-endpoint",
        dedicated_endpoint_enabled=use_dedicated_endpoint,
    )

    if "8b" in base_model_name.lower():
        accelerator_type = "NVIDIA_L4"
        machine_type = "g2-standard-12"
        accelerator_count = 1
    elif "70b" in base_model_name.lower():
        accelerator_type = "NVIDIA_L4"
        machine_type = "g2-standard-96"
        accelerator_count = 8
    elif "405b" in base_model_name.lower():
        accelerator_type = "NVIDIA_H100_80GB"
        machine_type = "a3-highgpu-8g"
        accelerator_count = 8
    else:
        raise ValueError(f"Recommended GPU setting not found for: {accelerator_type} and {base_model_name}.")

    common_util.check_quota(
        project_id=PROJECT_ID,
        region=REGION,
        accelerator_type=accelerator_type,
        accelerator_count=accelerator_count,
        is_for_training=False,
    )

    vllm_args = [
        "python", "-m", "vllm.entrypoints.api_server",
        "--host=0.0.0.0",
        "--port=8080",
        f"--model={model_id}",
        f"--tensor-parallel-size={accelerator_count}",
        "--swap-space=16",
        f"--gpu-memory-utilization={gpu_memory_utilization}",
        f"--max-model-len={max_model_len}", f"--dtype={dtype}",
        f"--max-loras={max_loras}", f"--max-cpu-loras={max_cpu_loras}",
        f"--max-num-seqs={max_num_seqs}", "--disable-log-stats"
    ]

    if enable_trust_remote_code:
        vllm_args.append("--trust-remote-code")
    if enforce_eager:
        vllm_args.append("--enforce-eager")
    if enable_lora:
        vllm_args.append("--enable-lora")
    if model_type:
        vllm_args.append(f"--model-type={model_type}")

    env_vars = {
        "MODEL_ID": model_id,
        "DEPLOY_SOURCE": "notebook",
        "HF_TOKEN": HF_TOKEN
    }

    model = aiplatform.Model.upload(
        display_name=model_name,
        serving_container_image_uri=VLLM_DOCKER_URI,
        serving_container_args=vllm_args,
        serving_container_ports=[8080],
        serving_container_predict_route="/generate",
        serving_container_health_route="/ping",
        serving_container_environment_variables=env_vars,
        serving_container_shared_memory_size_mb=(16 * 1024),
        serving_container_deployment_timeout=7200,
    )
    print(f"Deploying {model_name} on {machine_type} with {accelerator_count} {accelerator_type} GPU(s).")

    model.deploy(
        endpoint=endpoint,
        machine_type=machine_type,
        accelerator_type=accelerator_type,
        accelerator_count=accelerator_count,
        deploy_request_timeout=1800,
        service_account=service_account,
    )
    print("endpoint_name:", endpoint.name)

    return model, endpoint
שלב 4: מבצעים את הפריסה
מריצים את פונקציית הפריסה עם המודל וההגדרות שנבחרו. בשלב הזה המודל נפרס ומוחזרים המופעים של המודל ושל נקודת הקצה:
HF_TOKEN = ""

VLLM_DOCKER_URI = "us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20241001_0916_RC00"

model_name = common_util.get_job_name_with_datetime(prefix=f"{base_model_name}-serve-vllm")
gpu_memory_utilization = 0.9
max_model_len = 4096
max_loras = 1

models["vllm_gpu"], endpoints["vllm_gpu"] = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(prefix=f"{base_model_name}-serve"),
    model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=machine_type,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    gpu_memory_utilization=gpu_memory_utilization,
    max_model_len=max_model_len,
    max_loras=max_loras,
    enforce_eager=True,
    enable_lora=True,
    use_dedicated_endpoint=use_dedicated_endpoint,
)
אחרי שתריצו את דוגמת הקוד הזו, מודל Llama 3.1 יופעל ב-Gemini Enterprise Agent Platform ותוכלו לגשת אליו דרך נקודת הקצה שציינתם. אתם יכולים להשתמש בו למשימות הסקה כמו יצירת טקסט, סיכום ודיאלוג. בהתאם לגודל המודל, פריסת מודל חדש יכולה להימשך עד שעה. אפשר לבדוק את ההתקדמות בחיזוי אונליין.
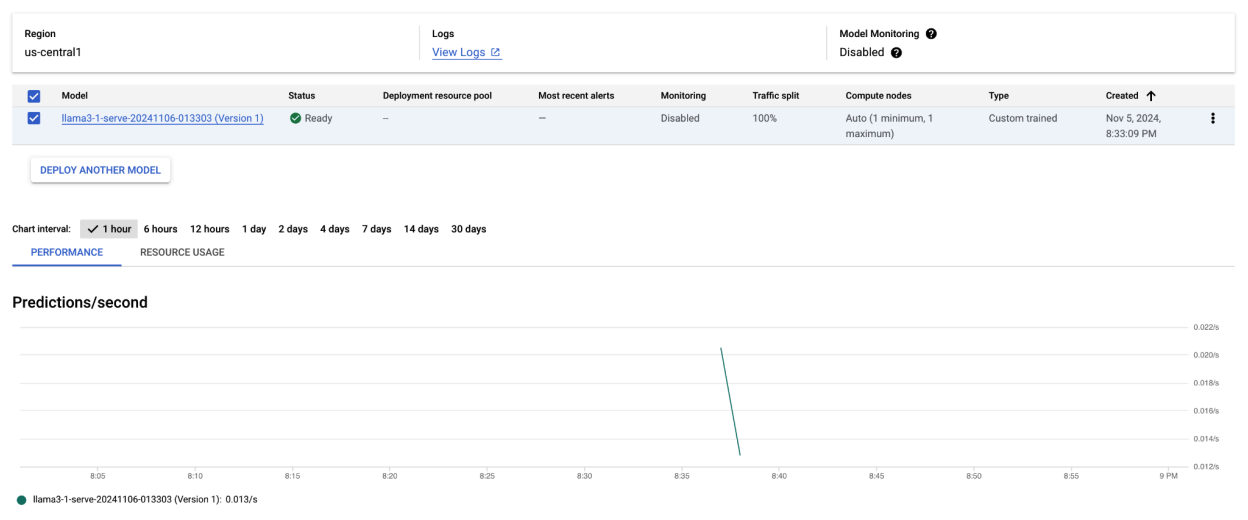 איור 4: נקודת קצה לפריסה של Llama 3.1 בלוח הבקרה של Vertex
איך יוצרים חיזויים באמצעות Llama 3.1 ב-Gemini Enterprise Agent Platform
אחרי שפורסים את המודל Llama 3.1 ב-Gemini Enterprise Agent Platform, אפשר להתחיל ליצור חיזויים על ידי שליחת פרומפטים טקסטואליים לנקודת הקצה. בקטע הזה מופיעה דוגמה ליצירת תשובות עם פרמטרים שונים שאפשר להתאים אישית כדי לשלוט בפלט.
שלב 1: מגדירים את ההנחיה והפרמטרים
בשלב הראשון, מגדירים את הפרומפט הטקסטואלי ואת הפרמטרים לדגימה כדי להנחות את המודל איך להגיב. אלה הפרמטרים העיקריים:
-
prompt: טקסט הקלט שהמודל צריך ליצור לו תשובה. לדוגמה, הנחיה = "מה זה מכונית?". -
max_tokens: המספר המקסימלי של טוקנים בפלט שנוצר. הקטנת הערך הזה יכולה לעזור למנוע בעיות של זמן קצוב לתפוגה. -
temperature: שולט באקראיות של החיזויים. ערכים גבוהים יותר (לדוגמה, 1.0) מגדילים את הגיוון, וערכים נמוכים יותר (לדוגמה, 0.5) גורמים לפלט להיות ממוקד יותר. -
top_p: מגביל את מאגר הדגימה להסתברות המצטברת הגבוהה ביותר. לדוגמה, אם מגדירים top_p = 0.9, המודל יתייחס רק לטוקנים שנמצאים ב-90% העליונים של מסת ההסתברות. -
top_k: מגביל את הדגימה ל-k הטוקנים הסבירים ביותר. לדוגמה, אם מגדירים top_k = 50, המערכת תדגום רק מ-50 הטוקנים המובילים. -
raw_response: אם הערך הוא True, הפונקציה מחזירה את הפלט הגולמי מהמודל. אם הערך הוא False, צריך להחיל עיצוב נוסף במבנה "Prompt:\n{prompt}\nOutput:\n{output}". -
lora_id(אופציונלי): הנתיב לקובצי המשקלים של LoRA כדי להחיל משקלים של Low-Rank Adaptation (LoRA). אפשר להשתמש בקטגוריה של Cloud Storage או בכתובת URL של מאגר Hugging Face. חשוב לדעת: זה יעבוד רק אם--enable-loraמוגדר בארגומנטים של הפריסה. Dynamic LoRA לא נתמך במודלים מולטי-מודאליים.
prompt = "What is a car?"
max_tokens = 50
temperature = 1.0
top_p = 1.0
top_k = 1
raw_response = False
lora_id = ""
שלב 2: שליחת בקשת החיזוי
עכשיו, כשהמכונה מוגדרת, אתם יכולים לשלוח את בקשת החיזוי לנקודת הקצה (endpoint) של Gemini Enterprise Agent Platform שנפרסה. בדוגמה הזו אפשר לראות איך לבצע חיזוי ולהדפיס את התוצאה:
response = endpoints["vllm_gpu"].predict(
    instances=instances, use_dedicated_endpoint=use_dedicated_endpoint
)

for prediction in response.predictions:
    print(prediction)
פלט לדוגמה
הנה דוגמה לתשובה שהמודל יכול לתת להנחיה "מה זה מכונית?":
Human: What is a car?
Assistant: A car, or a motor car, is a road-connected human-transportation system
used to move people or goods from one place to another.
הערות נוספות
- ניהול תוכן: כדי לוודא שהתוכן בטוח, אתם יכולים לנהל את הטקסט שנוצר באמצעות יכולות ניהול התוכן של Agent Platform.
- טיפול בזמן קצוב לתפוגה: אם נתקלים בבעיות כמו
ServiceUnavailable:
503
, כדאי לנסות להקטין את הפרמטרmax_tokens.
הגישה הזו מספקת דרך גמישה לאינטראקציה עם מודל Llama 3.1 באמצעות טכניקות דגימה שונות ומתאמי LoRA, כך שהיא מתאימה למגוון תרחישים לדוגמה, החל מיצירת טקסט למטרות כלליות ועד לתשובות ספציפיות למשימה.
פריסת מודלים מולטי-מודאליים של Llama 3.2 באמצעות vLLM
בקטע הזה נסביר איך להעלות מודלים של Llama 3.2 שנבנו מראש אל מרשם המודלים, ולפרוס אותם בנקודת קצה של Gemini Enterprise Agent Platform. הפריסה יכולה להימשך עד שעה, בהתאם לגודל המודל. מודלים של Llama 3.2 זמינים בגרסאות מולטי-מודאליות שתומכות בקלט של טקסט וגם של תמונות. vLLM תומך ב:
- פורמט של טקסט בלבד
- פורמט של תמונה אחת + טקסט
הפורמטים האלה הופכים את Llama 3.2 למתאים לאפליקציות שדורשות עיבוד של תמונות וטקסט.
שלב 1: בוחרים מודל לפריסה
מציינים את גרסת המודל של Llama 3.2 שרוצים לפרוס. בדוגמה הבאה נשתמש במודל Llama-3.2-11B-Vision, אבל אתם יכולים לבחור מבין האפשרויות הזמינות האחרות בהתאם לדרישות שלכם.
base_model_name = "Llama-3.2-11B-Vision"  # @param ["Llama-3.2-1B", "Llama-3.2-1B-Instruct", "Llama-3.2-3B", "Llama-3.2-3B-Instruct", "Llama-3.2-11B-Vision", "Llama-3.2-11B-Vision-Instruct", "Llama-3.2-90B-Vision", "Llama-3.2-90B-Vision-Instruct"]
hf_model_id = "meta-Llama/" + base_model_name
שלב 2: הגדרת חומרה ומשאבים
בוחרים חומרה שמתאימה לגודל המודל. ב-vLLM אפשר להשתמש במעבדים גרפיים שונים בהתאם לצורכי החישוב של המודל:
- מודלים של 1B ו-3B: משתמשים ב-NVIDIA L4 GPU.
- מודלים של 11B: משתמשים ב-NVIDIA A100 GPU.
- מודלים של 90B: משתמשים ב-NVIDIA H100 GPU.
בדוגמה הזו, הפריסה מוגדרת לפי המודל שנבחר:
if "3.2-1B" in base_model_name or "3.2-3B" in base_model_name:
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-8"
    accelerator_count = 1
elif "3.2-11B" in base_model_name:
    accelerator_type = "NVIDIA_TESLA_A100"
    machine_type = "a2-highgpu-1g"
    accelerator_count = 1
elif "3.2-90B" in base_model_name:
    accelerator_type = "NVIDIA_H100_80GB"
    machine_type = "a3-highgpu-8g"
    accelerator_count = 8
else:
    raise ValueError(f"Recommended GPU setting not found for: {base_model_name}.")
מוודאים שיש לכם את מכסת ה-GPU הנדרשת:
common_util.check_quota(
    project_id=PROJECT_ID,
    region=REGION,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    is_for_training=False,
)
שלב 3: פורסים את המודל באמצעות vLLM
הפונקציה הבאה מטפלת בפריסה של מודל Llama 3.2 ב-Gemini Enterprise Agent Platform. הוא מגדיר את הסביבה של המודל, את ניצול הזיכרון ואת הגדרות ה-vLLM כדי למלא בקשות ביעילות.
def deploy_model_vllm(
    model_name: str,
    model_id: str,
    service_account: str,
    base_model_id: str = None,
    machine_type: str = "g2-standard-8",
    accelerator_type: str = "NVIDIA_L4",
    accelerator_count: int = 1,
    gpu_memory_utilization: float = 0.9,
    max_model_len: int = 4096,
    dtype: str = "auto",
    enable_trust_remote_code: bool = False,
    enforce_eager: bool = False,
    enable_lora: bool = False,
    max_loras: int = 1,
    max_cpu_loras: int = 8,
    use_dedicated_endpoint: bool = False,
    max_num_seqs: int = 12,
    model_type: str = None,
) -> Tuple[aiplatform.Model, aiplatform.Endpoint]:
    """Deploys trained models with vLLM into Agent Platform."""
    endpoint = aiplatform.Endpoint.create(
        display_name=f"{model_name}-endpoint",
        dedicated_endpoint_enabled=use_dedicated_endpoint,
    )

    if not base_model_id:
        base_model_id = model_id

    vllm_args = [
        "python",
        "-m",
        "vllm.entrypoints.api_server",
        "--host=0.0.0.0",
        "--port=8080",
        f"--model={model_id}",
        f"--tensor-parallel-size={accelerator_count}",
        "--swap-space=16",
        f"--gpu-memory-utilization={gpu_memory_utilization}",
        f"--max-model-len={max_model_len}",
        f"--dtype={dtype}",
        f"--max-loras={max_loras}",
        f"--max-cpu-loras={max_cpu_loras}",
        f"--max-num-seqs={max_num_seqs}",
        "--disable-log-stats",
    ]

    if enable_trust_remote_code:
        vllm_args.append("--trust-remote-code")
    if enforce_eager:
        vllm_args.append("--enforce-eager")
    if enable_lora:
        vllm_args.append("--enable-lora")
    if model_type:
        vllm_args.append(f"--model-type={model_type}")

    env_vars = {
        "MODEL_ID": base_model_id,
        "DEPLOY_SOURCE": "notebook",
    }

    # HF_TOKEN is not a compulsory field and may not be defined.
    try:
        if HF_TOKEN:
            env_vars["HF_TOKEN"] = HF_TOKEN
    except NameError:
        pass

    model = aiplatform.Model.upload(
        display_name=model_name,
        serving_container_image_uri=VLLM_DOCKER_URI,
        serving_container_args=vllm_args,
        serving_container_ports=[8080],
        serving_container_predict_route="/generate",
        serving_container_health_route="/ping",
        serving_container_environment_variables=env_vars,
        serving_container_shared_memory_size_mb=(16 * 1024),
        serving_container_deployment_timeout=7200,
    )
    print(f"Deploying {model_name} on {machine_type} with {accelerator_count} {accelerator_type} GPU(s).")

    model.deploy(
        endpoint=endpoint,
        machine_type=machine_type,
        accelerator_type=accelerator_type,
        accelerator_count=accelerator_count,
        deploy_request_timeout=1800,
        service_account=service_account,
    )
    print("endpoint_name:", endpoint.name)

    return model, endpoint
שלב 4: מבצעים את הפריסה
מריצים את פונקציית הפריסה עם המודל וההגדרות שנקבעו. הפונקציה תחזיר גם את המודל וגם את המופעים של נקודת הקצה, שבהם אפשר להשתמש להסקת מסקנות.
model_name = common_util.get_job_name_with_datetime(prefix=f"{base_model_name}-serve-vllm")
models["vllm_gpu"], endpoints["vllm_gpu"] = deploy_model_vllm(
    model_name=model_name
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=machine_type,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    gpu_memory_utilization=gpu_memory_utilization,
    max_model_len=max_model_len,
    enforce_eager=True,
    use_dedicated_endpoint=use_dedicated_endpoint,
    max_num_seqs=max_num_seqs,
)
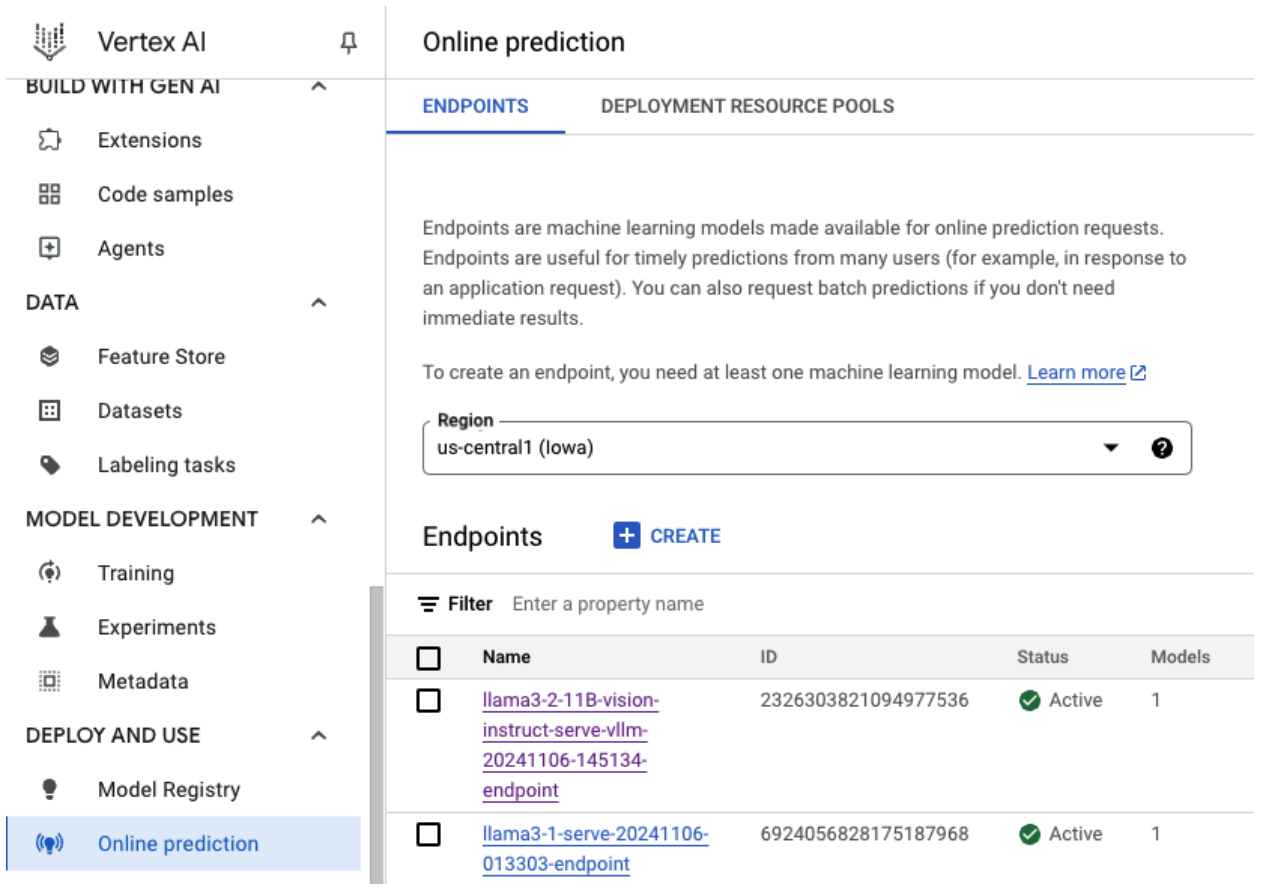 איור 5: נקודת קצה לפריסה של Llama 3.2 בלוח הבקרה של Vertex
בהתאם לגודל המודל, פריסת מודל חדש יכולה להימשך עד שעה. אפשר לבדוק את ההתקדמות של החיזוי אונליין.
הסקת מסקנות באמצעות vLLM ב-Gemini Enterprise Agent Platform באמצעות נתיב חיזוי שמוגדר כברירת מחדל
בקטע הזה נסביר איך להגדיר הסקה למודל Llama 3.2 Vision ב-Gemini Enterprise Agent Platform באמצעות נתיב החיזוי שמוגדר כברירת מחדל. תשתמשו בספריית vLLM כדי להציג את המודל בצורה יעילה, ותתקשרו איתו באמצעות הנחיה חזותית בשילוב עם טקסט.
כדי להתחיל, ודאו שנקודת הקצה של המודל פרוסה ומוכנה לחיזויים.
שלב 1: מגדירים את ההנחיה והפרמטרים
בדוגמה הזו, המודל מקבל כתובת URL של תמונה ופרומפט טקסטואלי, ומעבד אותן כדי ליצור תשובה.
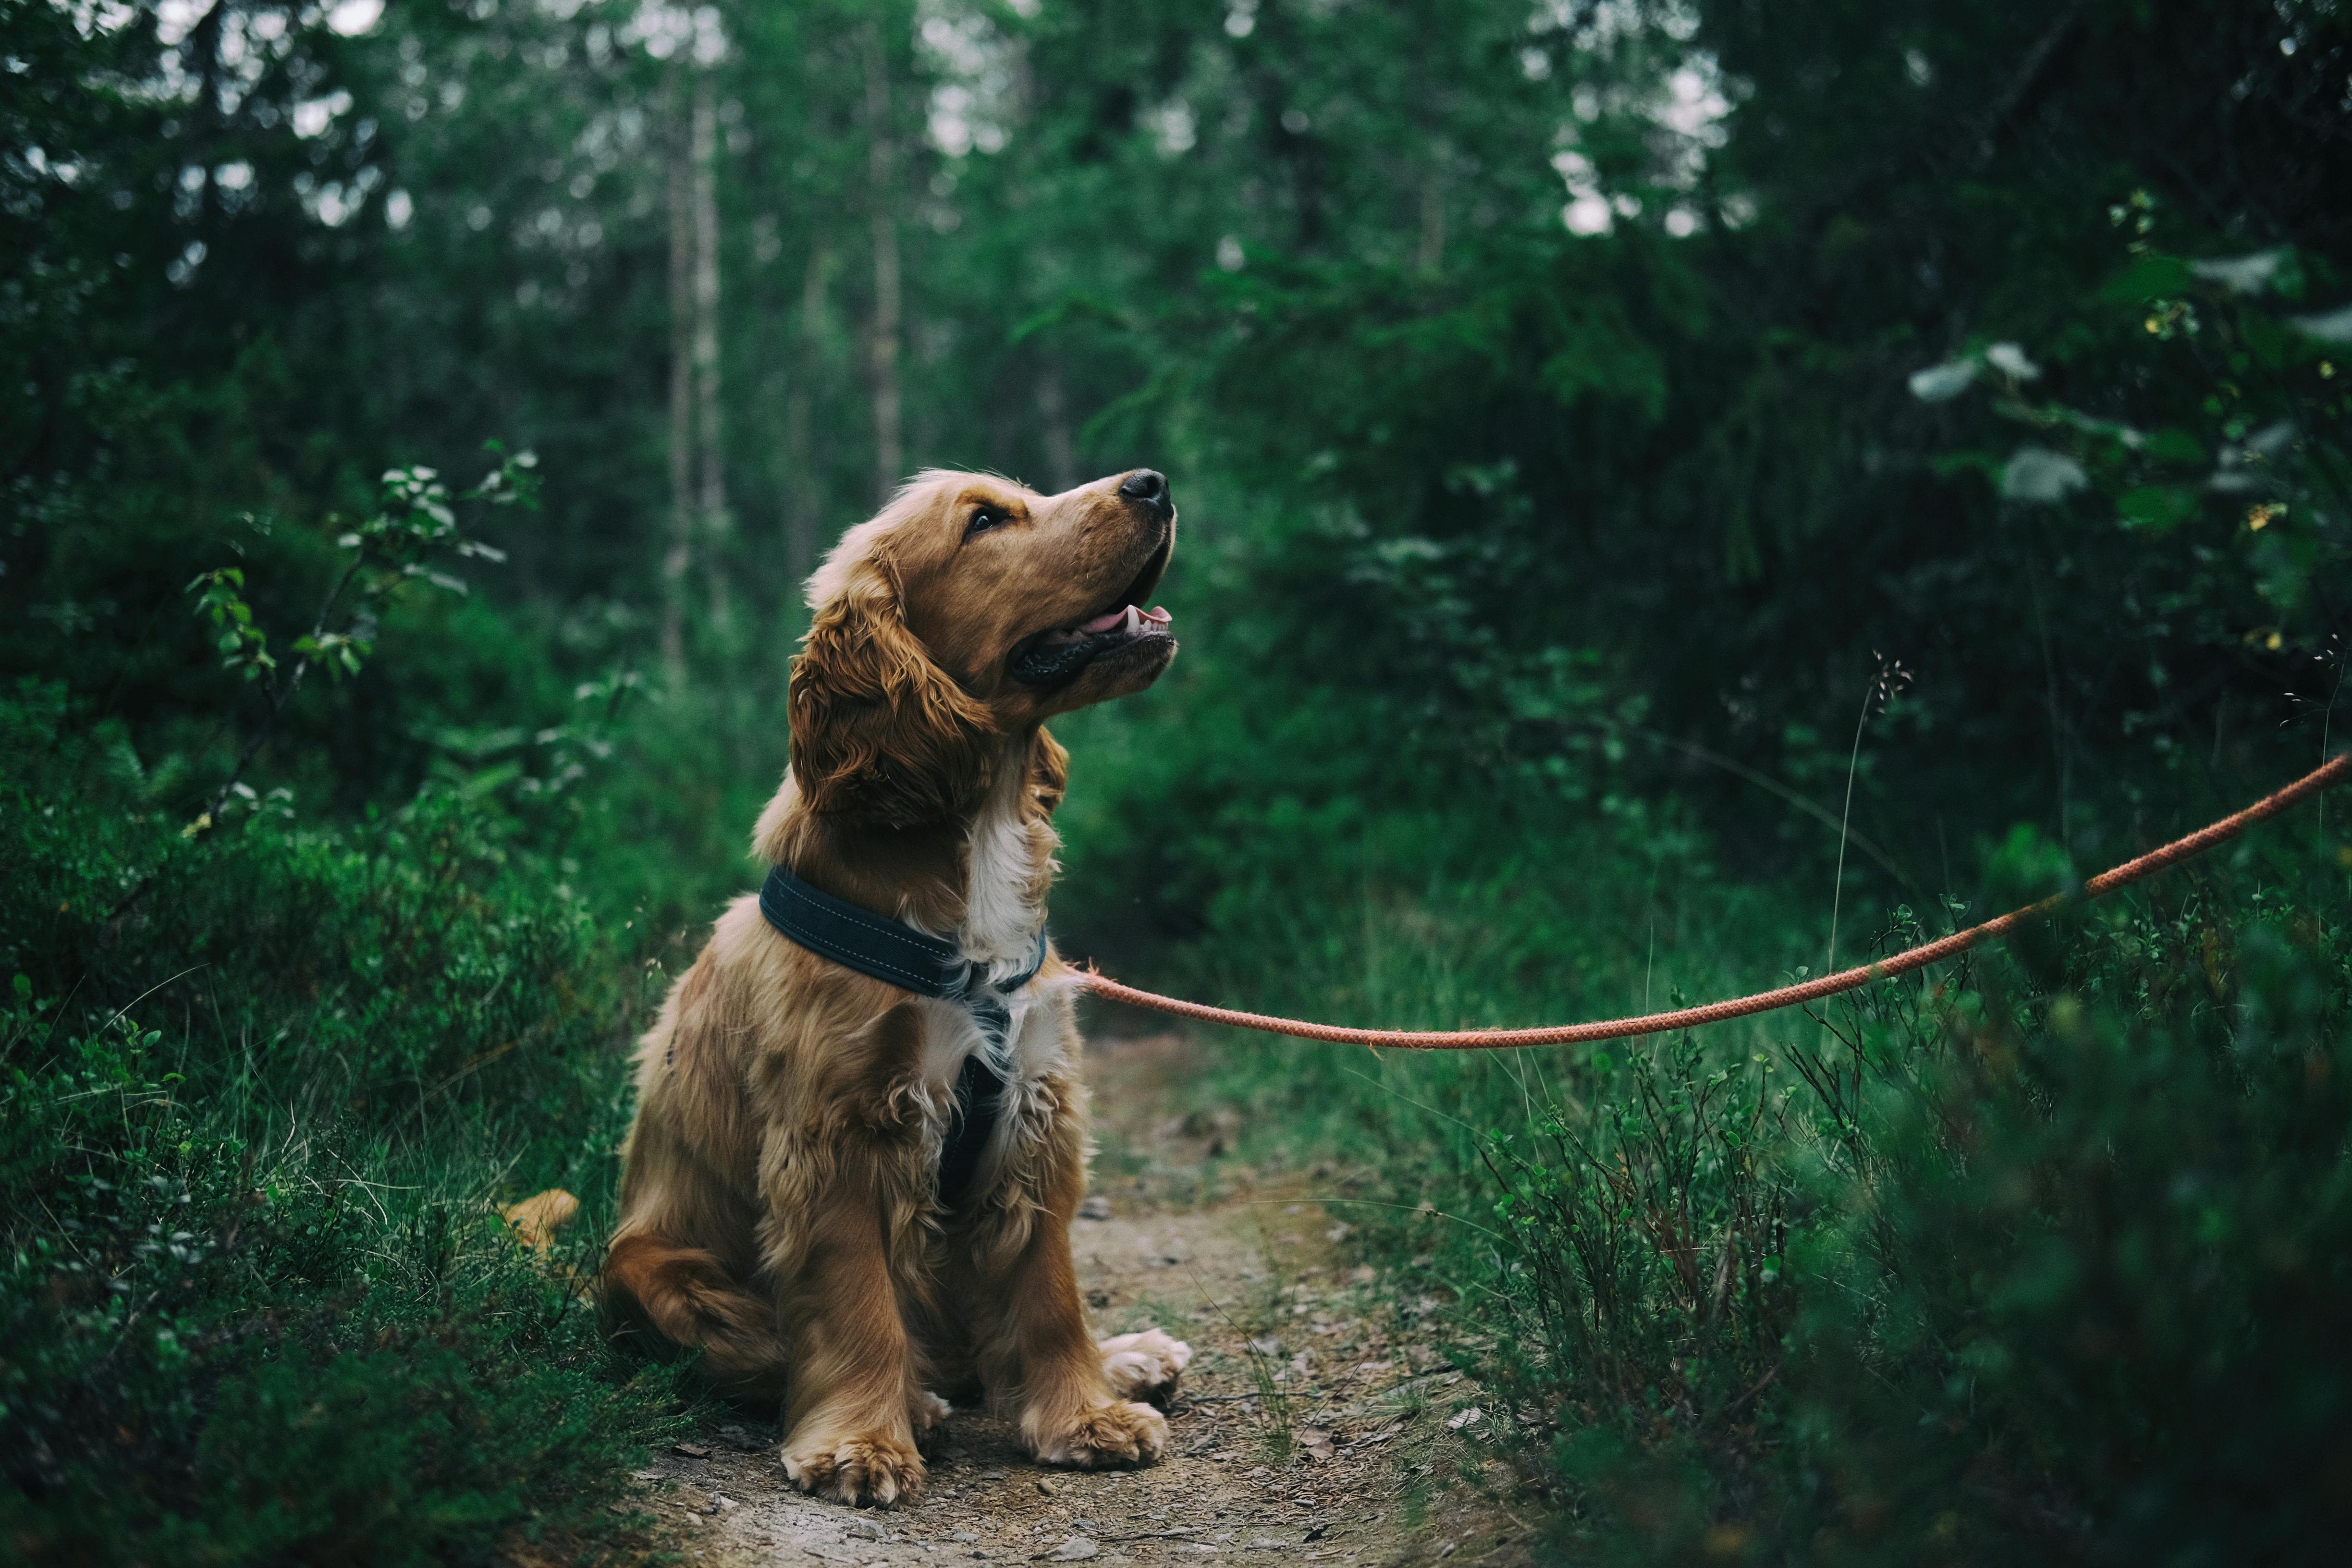 איור 6: דוגמה לקלט תמונה עבור מתן פרומפט ל-Llama 3.2
image_url = "https://images.pexels.com/photos/1254140/pexels-photo-1254140.jpeg"

raw_prompt = "This is a picture of"

# Reference prompt formatting guidelines here: https://www.Llama.com/docs/model-cards-and-prompt-formats/Llama3_2/#-base-model-prompt
prompt = f"<|begin_of_text|><|image|>{raw_prompt}"
שלב 2: מגדירים את הפרמטרים של החיזוי
כדי לשלוט בתשובה של המודל, אפשר לשנות את הפרמטרים הבאים:
max_tokens = 64

temperature = 0.5

top_p = 0.95
שלב 3: הכנת בקשת החיזוי
מגדירים את בקשת החיזוי עם כתובת ה-URL של התמונה, ההנחיה ופרמטרים אחרים.
instances = [
    {
        "prompt": prompt,
        "multi_modal_data": {"image": image_url},
        "max_tokens": max_tokens,
        "temperature": temperature,
        "top_p": top_p,
    },
]
שלב 4: יצירת החיזוי
שולחים את הבקשה לנקודת הקצה של Gemini Enterprise Agent Platform ומעבדים את התשובה:
response = endpoints["vllm_gpu"].predict(instances=instances)

for raw_prediction in response.predictions:
    prediction = raw_prediction.split("Output:")
    print(prediction[1])
אם נתקלים בבעיה של זמן קצוב לתפוגה (לדוגמה, ServiceUnavailable: 503 Took too
long to respond when processing), נסו להקטין את הערך של max_tokens למספר נמוך יותר, כמו 20, כדי לצמצם את זמן התגובה.
הסקה עם vLLM ב-Gemini Enterprise Agent Platform באמצעות OpenAI Chat Completion
בקטע הזה מוסבר איך לבצע הסקת מסקנות במודלים של Llama 3.2 Vision באמצעות OpenAI Chat Completions API ב-Gemini Enterprise Agent Platform. הגישה הזו מאפשרת לכם להשתמש ביכולות מולטי-מודאליות על ידי שליחת תמונות ופרומפטים טקסטואליים למודל כדי לקבל תשובות אינטראקטיביות יותר.
שלב 1: פריסת המודל Llama 3.2 Vision Instruct
מריצים את פונקציית הפריסה עם המודל וההגדרות שנקבעו. הפונקציה תחזיר גם את המופעים של המודל וגם את המופעים של נקודת הקצה, ואפשר להשתמש בהם להסקת מסקנות.
base_model_name = "Llama-3.2-11B-Vision-Instruct"
hf_model_id = f"meta-llama/{base_model_name}"
model_name = common_util.get_job_name_with_datetime(prefix=f"{base_model_name}-serve-vllm")
model, endpoint = deploy_model_vllm(
    model_name=model_name
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type="a2-highgpu-1g",
    accelerator_type="NVIDIA_TESLA_A100",
    accelerator_count=1,
    gpu_memory_utilization=0.9,
    max_model_len=4096,
    enforce_eager=True,
    max_num_seqs=12,
)
שלב 2: מגדירים את המשאב של נקודת הקצה
קודם כל, מגדירים את שם המשאב של נקודת הקצה לפריסה של Gemini Enterprise Agent Platform.
ENDPOINT_RESOURCE_NAME = "projects/{}/locations/{}/endpoints/{}".format(
    PROJECT_ID, REGION, endpoint.name
)
שלב 3: מתקינים את OpenAI SDK ואת ספריות האימות
כדי לשלוח בקשות באמצעות ה-SDK של OpenAI, צריך לוודא שהספריות הנדרשות מותקנות:
!pip install -qU openai google-auth requests
שלב 4: הגדרת פרמטרים של קלט להשלמת הצ'אט
מגדירים את כתובת ה-URL של התמונה ואת הפרומפט הטקסטואלי שיישלחו למודל. כדי לשלוט באורך התשובה וברמת הרנדומיזציה, משנים את הערכים של max_tokens ו-temperature בהתאמה.
user_image = "https://images.freeimages.com/images/large-previews/ab3/puppy-2-1404644.jpg"
user_message = "Describe this image?"
max_tokens = 50
temperature = 1.0
שלב 5: מגדירים אימות וכתובת URL בסיסית
אחזור פרטי הכניסה והגדרת כתובת ה-URL הבסיסית לבקשות API.
import google.auth
import openai

creds, project = google.auth.default()
auth_req = google.auth.transport.requests.Request()
creds.refresh(auth_req)

BASE_URL = (
    f"https://{REGION}-aiplatform.googleapis.com/v1beta1/{ENDPOINT_RESOURCE_NAME}"
)
try:
    if use_dedicated_endpoint:
        BASE_URL = f"https://{DEDICATED_ENDPOINT_DNS}/v1beta1/{ENDPOINT_RESOURCE_NAME}"
except NameError:
    pass
שלב 6: שליחת בקשה להשלמת צ'אט
באמצעות Chat Completions API של OpenAI, שולחים את התמונה ואת הפרומפט הטקסטואלי לנקודת הקצה של Gemini Enterprise Agent Platform:
client = openai.OpenAI(base_url=BASE_URL, api_key=creds.token)

model_response = client.chat.completions.create(
    model="",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "image_url", "image_url": {"url": user_image}},
                {"type": "text", "text": user_message},
            ],
        }
    ],
    temperature=temperature,
    max_tokens=max_tokens,
)

print(model_response)
(אופציונלי) שלב 7: התחברות מחדש לנקודת קצה קיימת
כדי להתחבר מחדש לנקודת קצה שנוצרה בעבר, משתמשים במזהה של נקודת הקצה. השלב הזה שימושי אם רוצים להשתמש שוב בנקודת קצה (endpoint) במקום ליצור אחת חדשה.
endpoint_name = ""
aip_endpoint_name = (
     f"projects/{PROJECT_ID}/locations/{REGION}/endpoints/{endpoint_name}"
)
endpoint = aiplatform.Endpoint(aip_endpoint_name)
ההגדרה הזו מאפשרת לעבור בצורה גמישה בין נקודות קצה חדשות וקיימות לפי הצורך, וכך לייעל את הבדיקה והפריסה.
הסרת המשאבים
כדי להימנע מחיובים שוטפים ולפנות משאבים, חשוב למחוק את המודלים שנפרסו, את נקודות הקצה ואת קטגוריית האחסון ששימשה לניסוי הזה (אם רוצים).
שלב 1: מחיקת נקודות קצה ומודלים
הקוד הבא יבטל את הפריסה של כל מודל וימחק את נקודות הקצה המשויכות:
# Undeploy model and delete endpoint
for endpoint in endpoints.values():
    endpoint.delete(force=True)

# Delete models
for model in models.values():
    model.delete()
שלב 2: (אופציונלי) מחיקת הקטגוריה של Cloud Storage
אם יצרתם קטגוריה של Cloud Storage במיוחד בשביל הניסוי הזה, אתם יכולים למחוק אותה על ידי הגדרת delete_bucket ל-True. השלב הזה הוא אופציונלי, אבל מומלץ אם אין יותר צורך בקטגוריה.
delete_bucket = False
if delete_bucket:
    ! gsutil -m rm -r $BUCKET_NAME
כך תבטיחו שכל המשאבים שבהם השתמשתם במדריך הזה יוסרו, ותצמצמו את העלויות המיותרות שקשורות לניסוי.
ניפוי באגים של בעיות נפוצות
בקטע הזה מוסבר איך לזהות ולפתור בעיות נפוצות שנתקלים בהן במהלך פריסת מודל vLLM והסקת מסקנות ב-Gemini Enterprise Agent Platform.
בדיקת היומנים
כדי לזהות את שורש הבעיה של כשלים בפריסה או התנהגות לא צפויה, בודקים את היומנים:
- עוברים למסוף החיזוי של Gemini Enterprise Agent Platform: נכנסים ל מסוף החיזוי של Gemini Enterprise Agent Platform במסוף Google Cloud .
- בחירת נקודת הקצה: לוחצים על נקודת הקצה שבה נתקלתם בבעיות. הסטטוס אמור לציין אם הפריסה נכשלה.
- הצגת יומנים: לוחצים על נקודת הקצה ואז עוברים לכרטיסייה Logs או לוחצים על View logs. כך תועברו ל-Cloud Logging, עם סינון להצגת יומנים ספציפיים לנקודת הקצה הזו ולפריסת המודל. אפשר גם לגשת ליומנים ישירות דרך שירות Cloud Logging.
- ניתוח היומנים: בודקים את הרשומות ביומן כדי למצוא הודעות שגיאה, אזהרות ומידע רלוונטי אחר. צפייה בחותמות זמן כדי לקשר בין רשומות ביומן לפעולות ספציפיות. חפשו בעיות שקשורות למגבלות של משאבים (זיכרון ומעבד), בעיות אימות או שגיאות בהגדרות.
בעיה נפוצה 1: שגיאת CUDA Out of Memory (OOM) במהלך הפריסה
שגיאות CUDA Out of Memory (OOM) מתרחשות כשהשימוש בזיכרון של המודל חורג מהקיבולת הזמינה של ה-GPU.
במודל של טקסט בלבד, השתמשנו בארגומנטים הבאים של המנוע:
base_model_name = "Meta-Llama-3.1-8B"
hf_model_id = f"meta-llama/{base_model_name}"
accelerator_type = "NVIDIA_L4"
accelerator_count = 1
machine_type = "g2-standard-12"
accelerator_count: int = 1
gpu_memory_utilization = 0.9
max_model_len = 4096
dtype = "auto"
max_num_seqs = 256
במקרה של המודל המולטי-מודאלי, השתמשנו בארגומנטים הבאים של המנוע:
base_model_name = "Llama-3.2-11B-Vision-Instruct"
hf_model_id = f"meta-llama/{base_model_name}"
accelerator_type = "NVIDIA_L4"
accelerator_count = 1
machine_type = "g2-standard-12"
accelerator_count: int = 1
gpu_memory_utilization = 0.9
max_model_len = 4096
dtype = "auto"
max_num_seqs = 12
אם פורסים את המודל המולטי-מודאלי עם max_num_seqs = 256, כמו שעשינו במקרה של מודל טקסט בלבד, יכולה להופיע השגיאה הבאה:
[rank0]: torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 3.91 GiB. GPU 0 has a total capacity of 39.38 GiB of which 3.76 GiB is free. Including non-PyTorch memory, this process has 0 bytes memory in use. Of the allocated memory 34.94 GiB is allocated by PyTorch, and 175.15 MiB is reserved by PyTorch but unallocated. If reserved but unallocated memory is large try setting PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True to avoid fragmentation. See documentation for Memory Management (https://pytorch.org/docs/stable/notes/cuda.html#environment-variables)
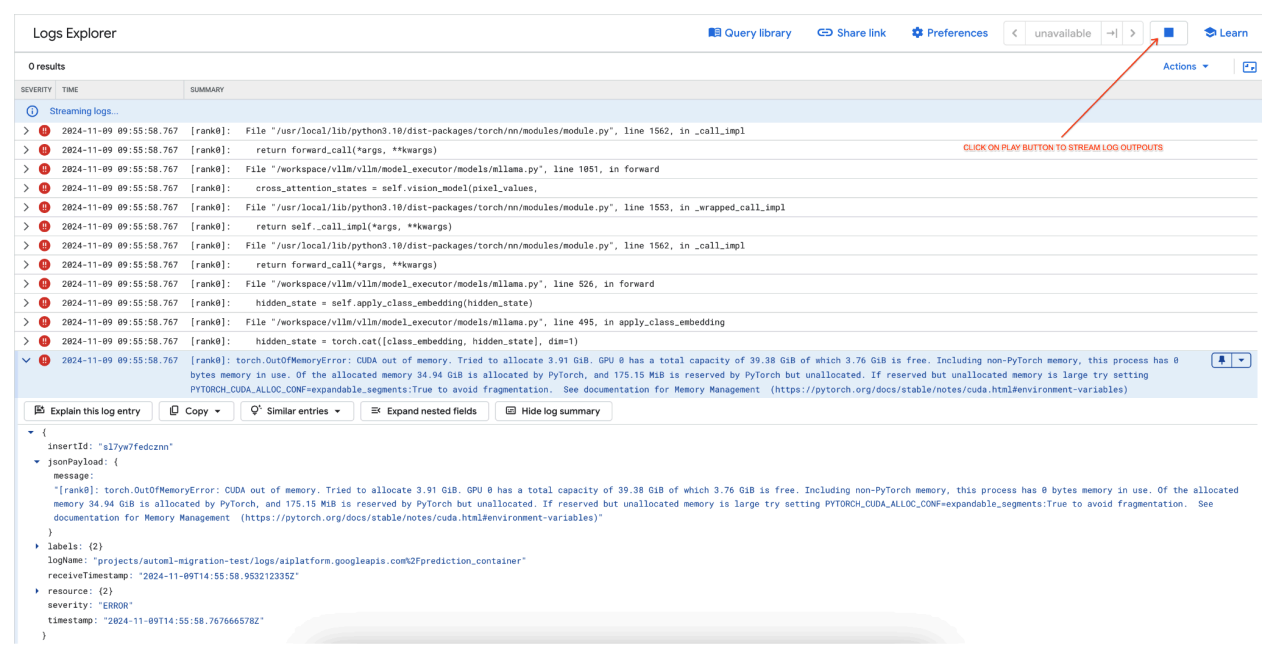 איור 7: יומן שגיאות של GPU מסוג Out of Memory (OOM)
הסבר על max_num_seqs וזיכרון GPU:
- הפרמטר
max_num_seqsמגדיר את המספר המקסימלי של בקשות בו-זמניות שהמודל יכול לטפל בהן. - כל רצף שהמודל מעבד צורך זיכרון GPU. השימוש הכולל בזיכרון הוא פרופורציונלי ל-
max_num_seqsכפול הזיכרון לכל רצף. - מודלים של טקסט בלבד (כמו Meta-Llama-3.1-8B) בדרך כלל צורכים פחות זיכרון לכל רצף מאשר מודלים מולטי-מודאליים (כמו Llama-3.2-11B-Vision-Instruct), שמעבדים גם טקסט וגם תמונות.
בודקים את יומן השגיאות (איור 8):
- ביומן מופיעה השגיאה
torch.OutOfMemoryErrorכשמנסים להקצות זיכרון ב-GPU. - השגיאה מתרחשת כי השימוש בזיכרון של המודל חורג מהקיבולת הזמינה של ה-GPU. ל-NVIDIA L4 GPU יש 24GB, ואם מגדירים את הפרמטר
max_num_seqsלערך גבוה מדי בשביל המודל המולטי-מודאלי, זה גורם לגלישה. - לפי היומן, כדאי להגדיר את
PYTORCH_CUDA_ALLOC_CONF=expandable_segments:Trueכדי לשפר את ניהול הזיכרון, אבל הבעיה העיקרית כאן היא שימוש גבוה בזיכרון.
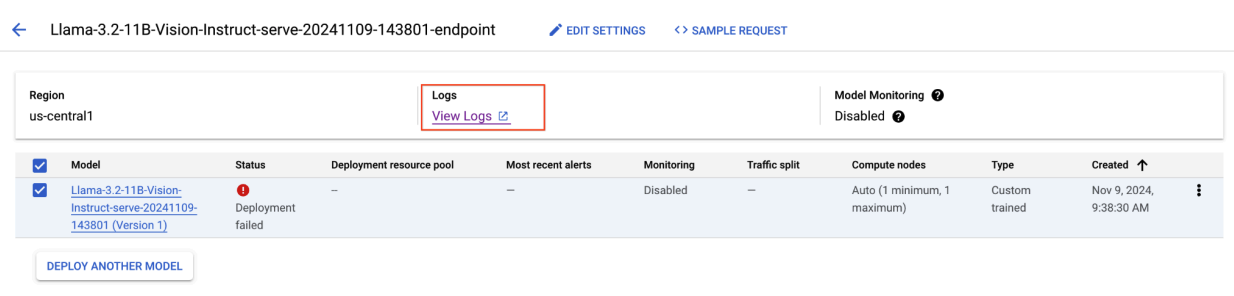 איור 8: פריסה שנכשלה של Llama 3.2
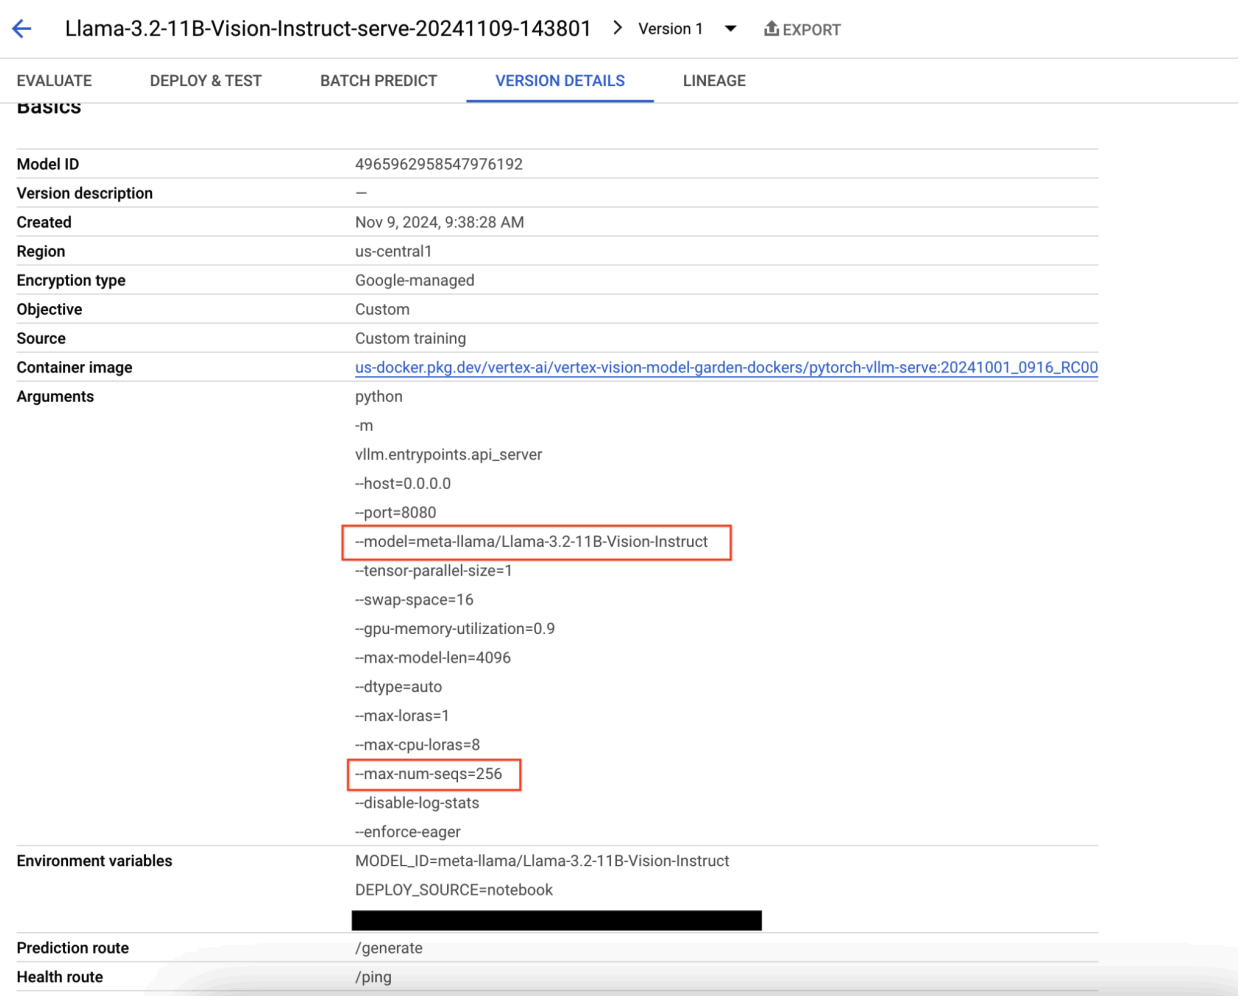 איור 9: חלונית הפרטים של גרסת המודל
כדי לפתור את הבעיה, נכנסים למסוף החיזוי של Gemini Enterprise Agent Platform ולוחצים על נקודת הקצה. הסטטוס אמור לציין שהפריסה נכשלה. לוחצים כדי לראות את היומנים. מוודאים שהערך של max-num-seqs הוא 256. הערך הזה גבוה מדי בשביל Llama-3.2-11B-Vision-Instruct. ערך מתאים יותר יהיה 12.
בעיה נפוצה 2: נדרש טוקן של Hugging Face
שגיאות בטוקן של Hugging Face מתרחשות כשהמודל מוגבל ודורש פרטי כניסה לאימות מתאימים כדי לגשת אליו.
בצילום המסך הבא מוצגת רשומה ביומן ב-Log Explorer של Google Cloud, עם הודעת שגיאה שקשורה לגישה למודל Meta LLaMA-3.2-11B-Vision שמתארח ב-Hugging Face. השגיאה מציינת שהגישה למודל מוגבלת, וצריך לבצע אימות כדי להמשיך. בהודעה מצוין במפורש: "Cannot access gated repository for URL", כלומר המודל מוגבל וצריך פרטי כניסה מתאימים כדי לגשת אליו. רשומת היומן הזו יכולה לעזור לפתור בעיות אימות כשעובדים עם משאבים מוגבלים במאגרים חיצוניים.
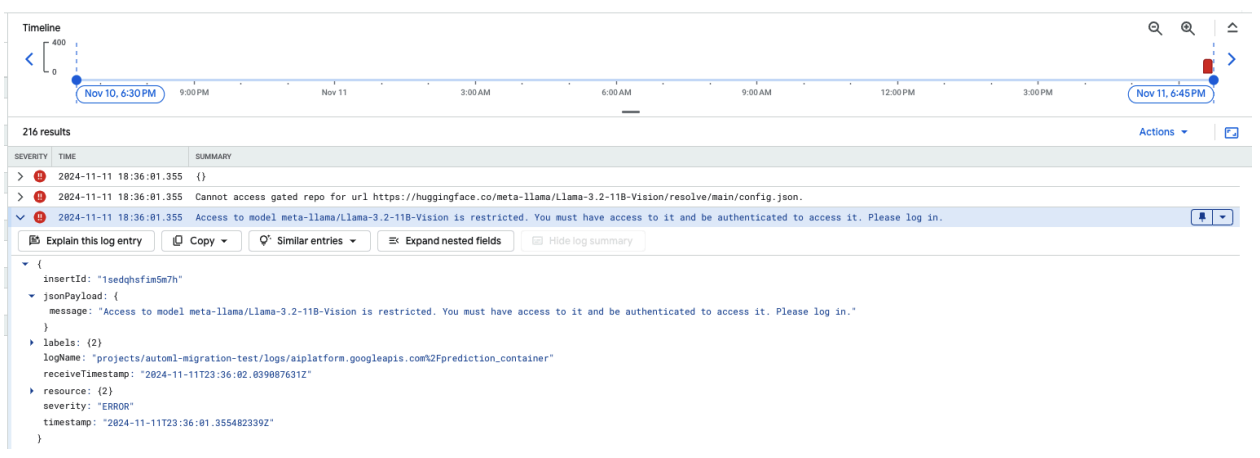 איור 10: שגיאה בטוקן של Hugging Face
כדי לפתור את הבעיה, צריך לאמת את ההרשאות של טוקן הגישה ל-Hugging Face. מעתיקים את הטוקן האחרון ופורסים נקודת קצה חדשה.
בעיה נפוצה 3: צריך תבנית צ'אט
שגיאות בתבנית הצ'אט מתרחשות כשלא ניתן יותר להשתמש בתבנית הצ'אט שמוגדרת כברירת מחדל, וצריך לספק תבנית צ'אט בהתאמה אישית אם היא לא מוגדרת ב-tokenizer.
בצילום המסך הזה מוצגת רשומת יומן ב-Log Explorer של Google Cloud, שבה מתרחשת ValueError בגלל שחסרה תבנית צ'אט בגרסה 4.44 של ספריית הטרנספורמרים. הודעת השגיאה מציינת שתבנית ברירת המחדל של הצ'אט כבר לא מותרת, וצריך לספק תבנית צ'אט בהתאמה אישית אם ה-tokenizer לא מגדיר תבנית. השגיאה הזו מדגישה שינוי שבוצע לאחרונה בספרייה, שמחייב הגדרה מפורשת של תבנית צ'אט. זה שימושי לניפוי באגים בבעיות שמתרחשות כשפורסים אפליקציות שמבוססות על צ'אט.
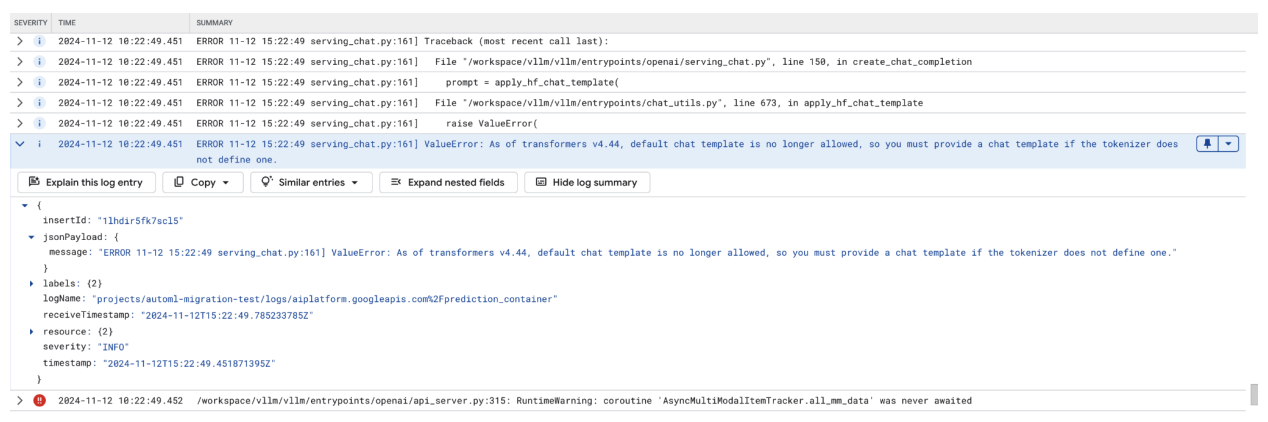 איור 11: נדרשת תבנית צ'אט
כדי לעקוף את זה, צריך לספק תבנית צ'אט במהלך הפריסה באמצעות הארגומנט --chat-template. אפשר למצוא תבניות לדוגמה במאגר הדוגמאות של vLLM.
בעיה נפוצה 4: אורך הרצף המקסימלי של המודל
שגיאות שקשורות לאורך הרצף המקסימלי של המודל מתרחשות כשאורך הרצף המקסימלי של המודל (4,096) גדול מהמספר המקסימלי של אסימונים שאפשר לאחסן במטמון KV (2,256).
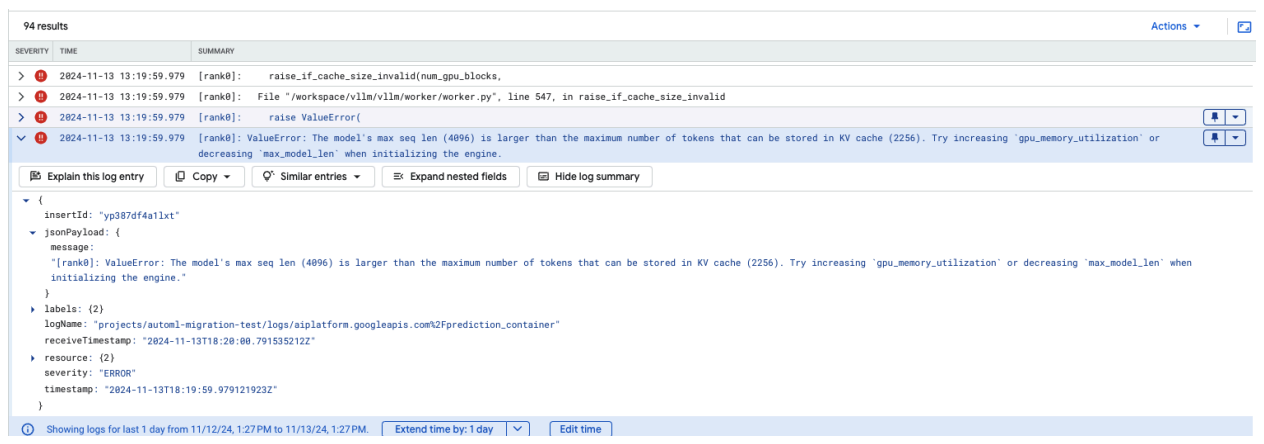 איור 12: Max Seq Length too Large
ValueError: אורך הרצף המקסימלי של המודל (4,096) גדול מהמספר המקסימלי של טוקנים שאפשר לאחסן במטמון KV (2,256). נסו להגדיל את gpu_memory_utilization או להקטין את max_model_len כשאתם מפעילים את המנוע.
כדי לפתור את הבעיה, מגדירים את max_model_len ל-2048, שהוא פחות מ-2256. פתרון נוסף לבעיה הזו הוא להשתמש ביותר מעבדי GPU או במעבדי GPU גדולים יותר. אם בוחרים להשתמש ביותר מעבדי GPU, צריך להגדיר את tensor-parallel-size בהתאם.
נתוני גרסה של קונטיינר vLLM ב-Model Garden
גרסאות עיקריות
vLLM רגיל
תאריך השקה |
ארכיטקטורה |
גרסת vLLM |
מזהה URI של מאגר |
|---|---|---|---|
| 17 ביולי 2025 | ARM |
v0.9.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250717_0916_arm_RC01 |
| 10 ביולי 2025 | x86 |
v0.9.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250710_0916_RC01 |
| 20 ביוני 2025 | x86 |
אחרי גרסה 0.9.1, commit |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250620_0916_RC01 |
| 11 ביוני 2025 | x86 |
v0.9.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250611_0916_RC01 |
| 2 ביוני 2025 | x86 |
v0.9.0 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250601_0916_RC01 |
| 6 במאי 2025 | x86 |
v0.8.5.post1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250506_0916_RC01 |
| 29 באפריל 2025 | x86 |
v0.8.4 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250429_0916_RC01, 20250430_0916_RC00_maas |
| 17 באפריל 2025 | x86 |
v0.8.4 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250417_0916_RC01 |
| 10 באפריל 2025 | x86 |
אחרי גרסה 0.8.3, commit |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250410_0917_RC01 |
| 7 באפריל 2025 | x86 |
v0.8.3 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250407_0917_RC01, 20250407_0917_RC0120250429_0916_RC00_maas |
| 7 באפריל 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250404_0916_RC01 |
| 5 באפריל 2025 | x86 |
אחרי גרסה 0.8.2, commit |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250405_1205_RC01 |
| 31 במרץ 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250401_0916_RC01 |
| 26 במרץ 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250327_0916_RC01 |
| 23 במרץ 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250324_0916_RC01 |
| 21 במרץ 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250321_0916_RC01 |
| 11 במרץ 2025 | x86 |
אחרי גרסה 0.7.3, commit |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250312_0916_RC01 |
| 3 במרץ 2025 | x86 |
v0.7.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250304_0916_RC01 |
| 14 בינואר 2025 | x86 |
v0.6.4.post1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250114_0916_RC00_maas |
| 2 בדצמבר 2024 | x86 |
v0.6.4.post1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20241202_0916_RC00_maas |
| 12 בנובמבר 2024 | x86 |
v0.6.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20241112_0916_RC00_maas |
| 16 באוקטובר 2024 | x86 |
v0.6.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20241016_0916_RC00_maas |
vLLM שעבר אופטימיזציה
תאריך השקה |
ארכיטקטורה |
מזהה URI של מאגר |
|---|---|---|
| 21 בינואר 2025 | x86 |
us-docker.pkg.dev/vertex-ai-restricted/vertex-vision-model-garden-dockers/pytorch-vllm-optimized-serve:20250121_0835_RC00 |
| 29 באוקטובר 2024 | x86 |
us-docker.pkg.dev/vertex-ai-restricted/vertex-vision-model-garden-dockers/pytorch-vllm-optimized-serve:20241029_0835_RC00 |
פריטי תוכן נוספים
הרשימה המלאה של גרסאות קונטיינר vLLM סטנדרטיות של VMG מופיעה בדף Artifact Registry.
גרסאות של vLLM-TPU בסטטוס ניסיוני מתויגות בתג <yyyymmdd_hhmm_tpu_experimental_RC00>.