


AlphaFold 3 は、Google DeepMind と Isomorphic Labs が開発したディープ ラーニング モデルです。タンパク質、DNA、RNA、リガンド、イオンの 3D 構造と相互作用を予測するように設計されています。このドキュメントでは、Gemini Enterprise Agent Platform の Model Garden を使用して AlphaFold 3 モデルをデプロイして使用する方法について説明します。
主な機能
Agent Platform に AlphaFold 3 をデプロイすると、高度な研究開発(R&D)と商用創薬ワークフローに必要な次の機能が提供されます。
商用利用: Model Garden の AlphaFold 3 は商用利用が可能です。
任意のカスタム リガンド: AlphaFold 3 は、SMILES 文字列または CIF 化学成分辞書(CCD)コードを使用して定義されたカスタム リガンドとともに、タンパク質、DNA、RNA の統合された共フォールディングをサポートしています。
ワークフローの柔軟性: Model Garden の AlphaFold 3 は、エンドツーエンドの完全なフォールディング パイプライン(データベース検索とモデル予測の組み合わせ)または推論のみのモードをサポートしています。推論のみのモードでは、事前に計算された MSA アライメントを提供して、実行時間と GPU 使用率を最適化できます。
考慮事項
ワークロードで AlphaFold 3 を評価する際は、次の制約に注意してください。
同時実行: AlphaFold 3 エンドポイントの同時実行上限は、ノードあたり 1 つです。同時実行数を増やすために、エンドポイントを複数のノードにスケーリングできます。別の予測がアクティブに実行されているときに予測リクエストが送信されると、リクエスト数がノード数より多い場合、エンドポイントは
HTTP 429 Too Many Requestsエラーで新しいリクエストを拒否します。トークンの上限: Agent Platform エンドポイントでの予測の最大時間は 60 分です。MSA 検索のオーバーヘッドは変動するため、A3 GPU でサポートされる最大シーケンス サイズは、約 4,500 個の生物学的トークン(アミノ酸、ヌクレオチド、リガンド原子など)のオーバーヘッドです。事前に計算されたアライメントを指定すると、MSA 検索の実行がバイパスされ、ハードウェアの上限である約 5,400 トークンまで複雑なフォールディングが可能になります。
ペイロードの上限: 標準の予測 REST リクエストのサイズ上限は 8 MB です。推論専用モードを使用する場合は、ペイロードの拒否を回避するために、大規模な事前計算済みアライメント(
.a3mファイル)をインライン文字列として埋め込むのではなく、Cloud Storage URI を使用して参照する必要があります。ネットワーク構成: 予測は完了までに最大 60 分かかる長時間実行オペレーションであるため、10 分の標準エンドポイント タイムアウト制限を回避するには、Private Service Connect(PSC)を使用してエンドポイントをデプロイする必要があります。
デプロイ手順
このセクションでは、 Google Cloud プロジェクトの Agent Platform が提供するエンドポイントに AlphaFold 3 をデプロイする方法について説明します。
始める前に
AlphaFold 3 をデプロイする前に、次のことを行う必要があります。
- モデルへのアクセスをリクエストします。
- GPU リソースを調達する。
- 必要な Identity and Access Management(IAM)権限を構成します。
- Agent Platform 管理者の IAM ロールを持つサービス アカウントを作成します。
- モデルのデプロイ中にサービス アカウントとして機能する
roles/iam.serviceAccountCreatorロールが IAM プリンシパルに付与されていることを確認します。
- リソース割り当てを確認します。
リソース要件
AlphaFold 3 には a3-highgpu-1g 仮想マシン(VM)が必要です。
デプロイする前に、 Google Cloud プロジェクトのターゲット デプロイ リージョンに、次のリソース用の十分な割り当てがあることを確認します。
アクセラレータ: 1 つ以上の
a3-highgpu-1gマシンタイプ。ローカル SSD: A3 VM には 750 GB のローカル SSD スペースがプロビジョニングされます。これは、参照配列データベース(UniProt、MGnify、Rfam)を永続的にキャッシュに保存するために必要です。これにより、すべての予測リクエストで遺伝子データベース検索(Jackhmmer/Nhmmer)中の低レイテンシ読み取りが可能になります。
Cloud Storage バケット
AlphaFold 3 では、提供された MSA ファイルを保存し、完全な予測出力をエクスポートするために、Cloud Storage バケットが必要です。リージョン間の転送を回避するには、エンドポイントと同じリージョンの Cloud Storage バケットを使用するか、マルチリージョン バケットを使用することをおすすめします。
Identity and Access Management ロール
参加する ID に次のロールを構成します。
モデルデプロイ担当者(IT 管理者とも呼ばれます): モデルをデプロイする ID には、エンドポイントを作成してデプロイを管理するための
roles/aiplatform.admin権限が必要です。サービス提供 ID: 推論の実行時に、AlphaFold 3 エンドポイントは、テナント プロジェクトのサービス アカウントを使用して、出力構造を Cloud Storage に直接書き込みます。対応するサービス アカウントには、ターゲット Cloud Storage バケットに対する
roles/storage.objectUserが必要です。モデルユーザー: 予測を開始するアカウントには、次のものが必要です。
roles/aiplatform.user: 予測リクエストをエンドポイントに送信します。roles/storage.objectUser。Cloud Storage バケット内の予測出力にアクセスします。
AlphaFold 3 をデプロイする
Agent Platform SDK を使用して、AlphaFold 3 を Google Cloud Dedicated エンドポイントまたは Private Service Connect エンドポイントとしてプログラムでデプロイします。GPU の可用性によっては、エンドポイントが推論の準備が整うまでに 10 ~ 15 分かかることがあります。
次の Python スニペットの例は、推論タイムアウトの拡張など、 Google Cloud プロジェクトにモデルをデプロイする方法を示しています。
import google.auth
from google.auth.transport.requests import AuthorizedSession
import vertexai
from vertexai import model_garden

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
MODEL_ID = "google/alphafold3@v3_0_4"
MACHINE_TYPE = "a3-highgpu-1g"

vertexai.init(project=PROJECT_ID, location=LOCATION)

# 1. Deploy Model Garden OpenModel to Dedicated Endpoint
af3_model = model_garden.OpenModel(MODEL_ID)
endpoint = af3_model.deploy(
    endpoint_display_name="af3-dedicated-ep",
    model_display_name="af3-on-mg",
    machine_type=MACHINE_TYPE,
    accelerator_type="NVIDIA_H100_80GB",
    accelerator_count=1,
    reservation_affinity_type="ANY_RESERVATION",
    use_dedicated_endpoint=True,
    accept_eula=True,
    min_replica_count=1,
    max_replica_count=1,
    serving_container_deployment_timeout=3600,
)

# 2. Update inference timeout to 3,600 seconds
credentials, _ = google.auth.default(
    scopes=["https://www.googleapis.com/auth/cloud-platform"]
)
session = AuthorizedSession(credentials)
url = f"https://{LOCATION}-aiplatform.googleapis.com/v1/{endpoint.resource_name}:update"
payload = {
    "endpoint": {
        "name": endpoint.resource_name,
        "clientConnectionConfig": {
            "inferenceTimeout": {
                "seconds": 3600
            }
        }
    }
}
response = session.post(url, json=payload)
response.raise_for_status()
print(f"Endpoint Resource Name: {endpoint.resource_name}")
API リファレンス
このセクションでは、エンドポイントのロケーション、URL 形式、パスパラメータ、リクエスト ペイロード スキーマについて説明します。
HTTP リクエスト
POST https://HOST/v1/projects/PROJECT_ID/locations/LOCATION/endpoints/ENDPOINT_ID:predict
次のように置き換えます。
HOST: サービス エンドポイント ホスト。これは、デプロイタイプが専用のパブリック エンドポイントか、Private Service Connect を使用するかによって異なります。PROJECT_ID: デプロイされたエンドポイントをホストしている Google Cloud プロジェクト ID。LOCATION: エンドポイントがデプロイされている Google Cloud リージョン(us-central1など)。ENDPOINT_ID: デプロイされた Agent Platform エンドポイントの固有識別子。
リクエストの本文
リクエストの本文には、次の JSON 構造のデータが含まれます。
{
  "instances": [
    {
      # The AlphaFold 3 input JSON - see the input documentation at
      # https://github.com/google-deepmind/alphafold3/blob/main/docs/input.md
    }
  ],
  "parameters": {
    "output_dir": "string",
    "dry_run": boolean,
    "run_data_pipeline": boolean,
    "force_output_dir": boolean,
    "resolve_msa_overlaps": boolean,
    "max_template_date": "string",
    "conformer_max_iterations": integer,
    "fix_standalone_glycans": boolean,
    "flash_attention_implementation": "string",
    "num_recycles": integer,
    "num_diffusion_samples": integer,
    "save_embeddings": boolean,
    "save_distogram": boolean,
    "compress_large_output_files": boolean,
    "num_seeds": integer
  }
}
最上位のリクエスト フィールド
| フィールド | タイプ | 説明 |
|---|---|---|
instances |
array |
必須。予測する生物学的配列構成のリスト。このリストには、1 つだけ要素を含める必要があります。0 個または複数の要素を渡すと、HTTP 422 Unprocessable
Entity エラーが発生します。instances 本文では、
AlphaFold 3 のドキュメントで公開されている仕様に従って入力を指定する必要があります。 |
parameters |
object |
省略可。予測実行を構成する実行パラメータ(dry_run、output_dir など)を含むオブジェクト。 |
パラメータ
AlphaFold 3 の実行フラグを構成します。
| フィールド | 種類 | デフォルト値 | 説明 |
|---|---|---|---|
dry_run |
boolean |
false |
省略可。true の場合、API はリクエストの検証を実行しますが、モデルの実行をバイパスして、すぐに空のレスポンスを返します。接続と構文のチェックに役立ちます。 |
run_data_pipeline |
boolean |
true |
省略可。true の場合、完全なパイプライン(MSA 検索と推論)を実行します。false の場合、推論のみを実行します(データベース検索をスキップします。事前に計算された MSA が必要です)。詳細については、
GitHub のドキュメントをご覧ください。
|
output_dir |
string |
null |
省略可。実行が成功すると、完全な未加工出力ファイル(CIF 構造、PAE、ランキング CSV を含む)がアップロードされる Cloud Storage URI(gs://bucket/path など)。 |
force_output_dir |
boolean |
false |
省略可。true の場合、指定された output_dir 内の既存のファイルを上書きできます。false の場合、Cloud Storage パスが空でないと、API はすぐに HTTP 400 Bad Request エラーを返します。これは、偶発的なデータ損失を防ぐためです。 |
resolve_msa_overlaps |
boolean |
true |
省略可。ペア設定されていない MSA をペア設定された MSA と重複除去するかどうか。ベスト プラクティスについては、GitHub AlphaFold 3 のドキュメントのガイドラインをご覧ください。 |
max_template_date |
string |
null |
省略可。考慮するテンプレートの最大リリース日(YYYY-MM-DD 形式、例: "2024-05-15")。形式が正しくない場合、HTTP 422 エラーで検証に失敗します。 |
conformer_max_iterations |
integer |
null |
省略可。RDKit コンフォーマー検索で実行する最大反復処理回数のオーバーライド。非負の整数(0 以上)にする必要があります。負の値の場合、HTTP 422 エラーで検証に失敗します。 |
fix_standalone_glycans |
boolean |
false |
省略可。スタンドアロンのグリカン位置の固定を有効にします。 |
flash_attention_implementation |
string |
null |
省略可。使用する Flash Attention バックエンドの実装。使用できる値は "triton"、"cudnn"、"xla" です。 |
num_recycles |
integer |
10 |
省略可。推論中に使用するリサイクル イテレーションの数。正の整数(0 より大きい整数)を指定する必要があります。トレードオフについては、ベスト プラクティスのセクションをご覧ください。 |
num_diffusion_samples |
integer |
5 |
省略可。生成する拡散サンプルの数。正の整数(0 より大きい整数)を指定する必要があります。トレードオフについては、ベスト プラクティスのセクションをご覧ください。 |
save_embeddings |
boolean |
false |
省略可。最終的なトランクの単一エンベディングとペア エンベディングを output_dir の場所に保存するかどうか。true の場合、エンベディングは seed-{SEED}_embeddings/ という名前のサブフォルダ(outputs_config_job_seed-50_embeddings.npz など)に .npz ファイルとして書き込まれます。 |
save_distogram |
boolean |
false |
省略可。最終的な予測ディストグラムを output_dir の場所に保存するかどうか。true の場合、エンベディングは seed-{SEED}_embeddings/ という名前のサブフォルダ(outputs_config_job_seed-50_embeddings.npz など)に .npz ファイルとして書き込まれます。 |
compress_large_output_files |
boolean |
false |
省略可。true の場合、zstandard を使用して大きな出力ファイル(mmCIF 構造と信頼度 JSON)を圧縮します。これにより、.cif と .json ではなく、.cif.zst と .json.zst の拡張子を持つファイルが出力されます。小さなファイル(ranking_scores.csv など)は圧縮されません。 |
num_seeds |
integer |
null |
省略可。推論に使用するランダムシードの数。一般に、再現性を確保するために、instances.modelSeeds フィールド内にシードを設定する必要があります。トレードオフについては、ベスト プラクティスのセクションをご覧ください。 |
レスポンス(出力)
このセクションでは、実行が成功したときに API レスポンスで返されるフィールドについて説明します。
レスポンスの本文
正常に実行されると、エンドポイントは標準の Agent Platform オンライン予測スキーマ形式でレスポンスを返します。
{
  "deployedModelId": "string",
  "model": "string",
  "modelDisplayName": "string",
  "modelVersionId": "string",
  "predictions": [
    {
      "structure_cif": "string",
      "plddt": [
        number
      ],
      "pae": [
        [
          number
        ]
      ],
      "summary": {
        "ptm": number,
        "iptm": number,
        "fraction_disordered": number,
        "has_clash": boolean,
        "ranking_score": number,
        "chain_pair_pae_min": [
          [
            number
          ]
        ],
        "chain_pair_iptm": [
          [
            number
          ]
        ],
        "chain_ptm": [
          number
        ],
        "chain_iptm": [
          number
        ],
        "chain_ids": [
          string
        ]
      },
      "output_dir": "string"
    }
  ]
}
最上位のレスポンス フィールド
| フィールド | タイプ | 説明 |
|---|---|---|
deployedModelId |
string |
Agent Platform エンドポイントにデプロイされたモデルの ID。 |
model |
string |
モデルの完全修飾リソース名。 |
modelDisplayName |
string |
デプロイされたモデルの表示名(常に "alphafold3")。 |
modelVersionId |
string |
デプロイされたモデルのバージョン ID。 |
predictions |
array |
予測結果のリスト。AlphaFold 3 の場合、この配列には予測結果オブジェクトが 1 つだけ含まれます。 |
予測結果の詳細(predictions[])
AlphaFold 3 予測エンドポイントは、上位候補の構造座標と信頼度指標を含む predictions 配列を含む HTTP 200 JSON レスポンスを返します。フィールドの定義と出力ファイルの仕様の詳細については、GitHub の AlphaFold 3 の公式ドキュメントをご覧ください。
リクエストで parameters.output_dir が指定されているかどうかに応じて、API レスポンスの出力構造が異なる場合があります。
HTTP レスポンスでの予測: インライン レスポンスは、グローバル サマリー指標(
summary)、3D 構造座標(structure_cif)、原子ごとの信頼度スコア(plddt)、2D 予測アライメント エラー マトリックス(pae)を HTTP JSON レスポンス ペイロード本文に直接返します。出力ディレクトリが指定されている場合、シリアル化のボトルネックを防ぐため、大きなペイロード フィールド(structure_cif、plddt、pae)は HTTP レスポンス ペイロードから省略されます(null)。代わりに、すべての未加工のモデル出力が、指定された Cloud Storage バケットに非同期でエクスポートされます。Cloud Storage バケットに保存されたアーティファクト: 出力ディレクトリ(
parameters.output_dir)が指定されている場合、包括的な予測結果が Cloud Storage にアップロードされます。出力フォルダには、GitHub の AlphaFold 3 ドキュメントで公開されている仕様に沿ったデータが含まれています。
予測の実行
Model Garden のデプロイにより、データ パイプラインやモデル推論など、エンドツーエンドの予測パイプラインを 1 回の API 呼び出しで簡単に実行できます。次の図は、AlphaFold 3 予測のアーキテクチャの概要を示しています。
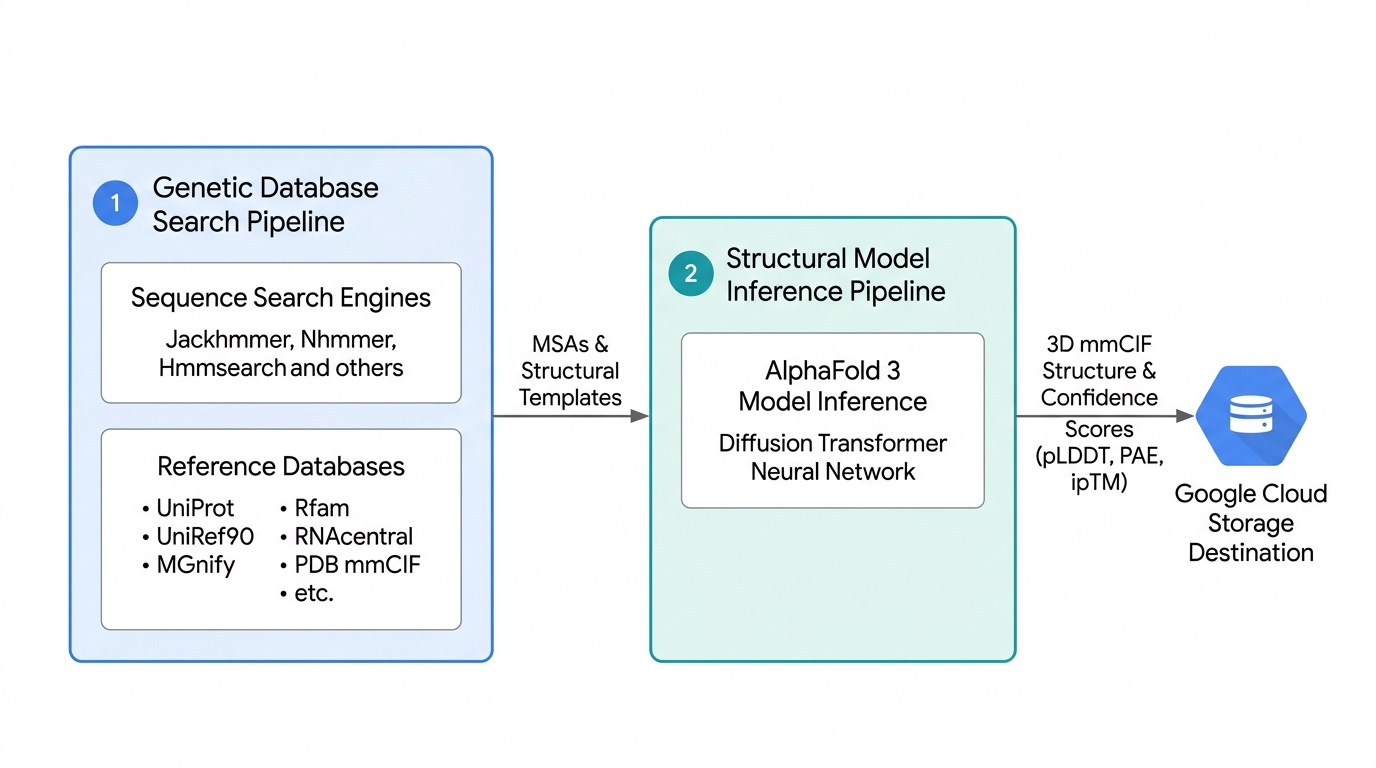
図 1. 予測パイプラインの完成
予測を実行する場合は、パラメータで Cloud Storage バケットを直接指定して、サンプルごとのサブディレクトリ、ランキング マニフェスト、未加工の出力など、未加工のデータセット全体をエクスポートすることを強くおすすめします。マルチシード サンプリング、ニューラル リサイクル、拡散軌跡、カスタム共有結合のパラメータ チューニングなど、構成可能なすべてのリクエスト フィールドの詳細については、API リファレンス セクションをご覧ください。
長時間実行されるフォールディング ジョブやバッチ パイプラインを起動する前に、ドライランを実行して、認証、IAM 権限、エンドポイント ネットワーク接続をすばやく確認できます。
予測オプション
ワークフローに応じて、AlphaFold 3 の処理は 4 つの異なる実行モードに分類できます。
ドライラン モード
予測パイプラインを開始せずに API 接続、認証、ネットワーキング、JSON スキーマを確認するには、parameters オブジェクトに "dry_run":
true を指定してリクエストを送信します。エンドポイントは、すべての検証ルーティン(Cloud Storage バケットの書き込み権限の確認やシーケンス文字の検証など)を実行しますが、実行をスキップして、空の予測レスポンスをすぐに返します。
ドライラン モードの Python スクリプトの例を次に示します。
from google.cloud import aiplatform

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Connect to Dedicated Endpoint
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define prediction payload
instances = [
    {
        "name": "preflight_check",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                }
            }
        ],
    }
]

parameters = {
    "dry_run": True,
}

# Execute prediction request
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)
print(response.predictions)
エンドツーエンドの予測モード
エンドツーエンドの予測を実行するには、未加工の生物学的配列(タンパク質、DNA、RNA、リガンド、PTM)を 1 つのリクエストで送信します。エンドポイントは、遺伝子データベース検索を自動的に実行し、その直後にモデル推論を実行します。これは、既存のアライメントがないフォールディング ジョブに推奨されます。
エンドツーエンドの予測モードの Python スクリプトの例を次に示します。
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/alphafold_output/"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "e2e_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
事前計算された MSA とテンプレートを使用した推論のみ
以前の実行で、またはモデル エンドポイントの外部で生成された、事前計算済みの MSA テンプレートと mmCIF テンプレートがすでに存在する場合があります。このようなシナリオでは、アライメントとテンプレートを指定して、リクエストを構造予測に直接ルーティングすることで、遺伝子データベースの検索を完全にバイパスできます。これにより、推論のレスポンス時間を大幅に短縮することもできます。この方法は、次のシナリオで推奨されます。
- 複数の異なる低分子リガンドを単一の静的タンパク質標的にドッキングする場合、MSA を再利用できます。
- 複数のランダムシードにわたって同じ分子配列を繰り返し実行し、構造の柔軟性をマッピングする。
- 非公開のゲノム データベースに対してオフラインでシーケンスをアライメントする。
- AlphaFold 3 向けに GPU リソースを最適化し、構造生成のみに集中する。
推論専用モードの Python スクリプトの例を次に示します。
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                    "unpairedMsaPath": "gs://YOUR_BUCKET_NAME/path/to/unpaired.a3m",
                    "pairedMsa": "",
                    "templates": [],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "run_data_pipeline": False,
    "output_dir": STORAGE_OUTPUT_DIR,
    "force_output_dir": True,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
MSA とテンプレートを使用せずに実行する
遺伝子データベース検索とテンプレート マッチングを完全にバイパスするオプションもあります。このモデルは、相同配列や共進化情報を使用せず、クエリ配列のみを使用して 3D 構造を予測します。このモードをトリガーするには、インスタンスの MSA パラメータ unpairedMsa と pairedMsa に空の文字列を指定し、templates に空のリストを指定します。また、パラメータで run_data_pipeline を false に設定します。これは、合成または操作された分子の設計や、進化的コンテキストがない場合の構造予測のテストに役立ちます。
AlphaFold 3 MSA とテンプレートなしで実行する Python スクリプトの例を次に示します。
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only_gcs_job"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_only_gcs_job",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1, 2, 3],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "unpairedMsa": "",
                    "pairedMsa": "",
                    "templates": [],
                }
            }
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
    "run_data_pipeline": False,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters,
    timeout=3600.0,
)

print(response.predictions)
詳細な仕様、エンティティ パラメータ、出力信頼度指標については、GitHub の AlphaFold 3 のドキュメントをご覧ください。
予測出力
AlphaFold 3 予測サービスには、予測出力を取得するための 2 つの補完的な配信メカニズムが用意されています。デフォルトでは、API レスポンスは、上位候補の予測結果をインラインで同期的に返します。必要に応じて、Cloud Storage ディレクトリを指定できます。
次のセクションでは、予測出力の概要について説明します。詳細については、GitHub の AlphaFold 3 のドキュメントをご覧ください。
インライン レスポンスと保存されたアーティファクト
AlphaFold 3 予測サービスは、次の 2 つの主要な出力パターンをサポートしています。
- インライン レスポンス: HTTP REST レスポンス ペイロード内で、上位候補の 3D 構造座標と信頼度指標のみを直接返します。これは、迅速なインタラクティブ プロトタイピングや単一シーケンス クエリに最適です。
- 保存されたアーティファクト(Cloud Storage): 出力ディレクトリを指定すると、完全なマルチサンプル データセットが Cloud Storage にエクスポートされます。これには、生成されたランダムシードと拡散サンプルごとに、個別の座標ファイル、信頼度 JSON、ディストグラム、エンベディング、サマリー指標が含まれます。本番環境のワークロード、コンフォメーション アンサンブルのマッピング、リクエスト ペイロード サイズの上限の回避には、Cloud Storage を使用することをおすすめします。
次の Python の例は、ダウンストリーム分析のために Cloud Storage から保存されたアーティファクトを取得する方法を示しています。
from google.cloud import storage

BUCKET_NAME = "your-bucket-name"
JOB_NAME = "my_alphafold_job"
STORAGE_PREFIX = f"af3_results/my_folder/{JOB_NAME}"

# Initialize Cloud Storage client
client = storage.Client(project="your-project-id")
bucket = client.bucket(BUCKET_NAME)

# Download the top-ranked 3D structure and global ranking ledger
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_model.cif").download_to_filename("model.cif")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_ranking_scores.csv").download_to_filename("ranking_scores.csv")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_summary_confidences.json").download_to_filename("summary.json")
AlphaFold 3 は生成拡散モデルを使用するため、予測を実行するたびに、シードとサンプリング軌跡にわたる候補 3D 構造のアンサンブルが生成されます。これらの候補実行を評価して比較すると、詳細な構造分析を行う前に予測出力を解釈するのに役立ちます。
完全なマルチサンプル アーティファクト データセットは、次の 3 つのコアファイルを使用して調査できます。
ranking_scores.csv: 生成されたすべての軌跡ペアとその複合ranking_scoreを一覧表示するメイン台帳。行は、スコアで事前に並べ替えられるのではなく、軌跡の実行順序(シードの昇順、サンプル インデックスの昇順)で保存されます。ユーザーはranking_scoreの降順で並べ替えて、候補のランクを特定する必要があります。summary_confidences.json: 上位候補のグローバル品質指標(pTM、ipTM、has_clash、fraction_disordered)が含まれます。サンプルごと
summary_confidences.json: 個々のseed-{SEED}_sample-{INDEX}/フォルダ内にあり、必要に応じて、特定の非トップ候補実行のチェーンレベルの pTM マトリックスと ipTM マトリックスを検査できます。
次の Python の例では、ranking_scores.csv と summary_confidences.json を解析して候補サンプルをランク付けし、上位候補の品質を検証します。
import csv
import json

print("=== Candidate Samples Ledger (ranking_scores.csv) ===")
with open("ranking_scores.csv", "r", newline="", encoding="utf-8") as f:
    rows = sorted(
        csv.DictReader(f), key=lambda x: float(x["ranking_score"]), reverse=True
    )

# Calculate column widths cleanly and readably
headers = list(rows[0].keys())
widths = {}
for col in headers:
    lengths = [len(col)] + [len(r[col]) for r in rows]
    widths[col] = max(lengths)

print("  ".join(col.rjust(widths[col]) for col in headers))
for r in rows:
    print("  ".join(r[col].rjust(widths[col]) for col in headers))

top = rows[0]
print(
    f"\nPromoted Top Candidate: Seed {int(top['seed'])}, Sample"
    f" {int(top['sample'])} (Score: {float(top['ranking_score']):.4f})"
)

print("\n=== Top Candidate Quality Validation (summary.json) ===")
with open("summary.json", "r", encoding="utf-8") as f:
    summary = json.load(f)

clash_str = (
    "DETECTED (FAIL)" if summary.get("has_clash") else "None Detected (PASS)"
)
print("Top Candidate Metrics:")
print(f"  • Ranking Score : {summary.get('ranking_score', 'N/A')}")
print(f"  • Global pTM    : {summary.get('ptm', 'N/A')}")
print(f"  • Interface ipTM: {summary.get('iptm', 'N/A')}")
print(f"  • Steric Clash  : {clash_str}")
保存されたファイルと mmCIF 属性の包括的なスキーマ仕様については、GitHub の AlphaFold 3 のドキュメントをご覧ください。また、EMBL-EBI の AlphaFold 3 予測の品質を評価する方法ガイドを参照して、予測の品質を評価する方法を理解してください。
ベスト プラクティス
以降のセクションでは、Agent Platform で AlphaFold 3 を使用する際のベスト プラクティスについて説明します。
リクエスト タイムアウトを軽減する
Agent Platform のエンドポイントでは、リクエストごとにデフォルトの最大実行タイムアウト(60 分)が適用されます。予測がタイムアウトせずに正常に完了するように、次のガイドラインに沿って対応してください。
- 1 つのリクエストで過剰なサンプリングを避ける: 1 回の API 呼び出しで、シードの広範なスイープや過度に高い逆拡散パラメータを初期化すると、実行時間が 60 分の上限を超える可能性があります。
- 大規模なスイープを分解する: 大規模なスタディの場合は、シードとパラメータ スイープを複数の小さな予測ペイロードに分割し、個別のジョブとして送信します。これにより、エンドポイントの自動スケーリング機能も活用できます。
MSA 検索をバイパスする
遺伝子データベース検索パイプラインは、AlphaFold パイプラインの中で最も時間のかかるフェーズです。同じシーケンスで反復予測を実行する場合(固定タンパク質ターゲットでリガンド スクリーニング スイープを実行する場合など)、データベース検索を完全にバイパスすることで、実行時間を大幅に最適化できます。
- MSA を抽出する: Cloud Storage 出力ディレクトリ(
output_dir)を指定して、最初のエンドツーエンドの予測を実行します。生成された{JOB_NAME}_data.jsonファイルを出力 Cloud Storage バケットからダウンロードします。 - 推論のみの予測を送信する: JSON ファイル内の
unpairedMsaフィールドとpairedMsaフィールドを見つけます。これらの MSA 文字列を抽出し、Cloud Storage URI を指すunpairedMsaPathとpairedMsaPathを使用して、後続の予測リクエストに渡します。
または、独自のインフラストラクチャで MSA 検索を実行し、事前計算された MSA テンプレートを予測リクエストに入力することもできます。
信頼度の低い実行を処理する
予測出力の信頼性指標が低い場合、回復不能な予測エラーとして扱うのではなく、ターゲットを絞った修正を試みることができます。特定のパラメータを最適化することで、代替の潜在軌道を探索できます。このセクションでは、信頼度の低い予測の場合に復元するためのアプローチをいくつか紹介します。
マルチシード サンプリングを使用する
AlphaFold 3 は、潜在空間のランダムノイズから 3D 座標の生成を初期化します。1 つの特定のシードで予測が送信されると、拡散軌跡は別のシードとは異なるパスをたどる可能性があります。シードの配列を渡すと、モデルは異なる状態から始まる軌跡をサンプリングします。
マルチシード サンプリングには、独立した実行全体で構造の一貫性を検証することと、機能的なコンフォメーション ダイナミクスをプローブすることという 2 つの重要な利点があります。たとえば、5 つのシードがすべて同じ 3D 座標に収束する場合、グローバル フォールドの信頼性は高くなります。逆に、異なるシードが異なる高信頼性の結合ポーズを生成する場合、アンサンブルは、オープンとクローズのアクティブ サイト ループや代替ドメイン スワップ ダイマーなど、生物学的に意味のあるコンフォメーション状態を明らかにしている可能性があります。
拡散軌道を拡張する
modelSeeds は潜在空間の開始ノイズ状態を変更しますが、num_diffusion_samples パラメータ(デフォルトは 5)は、逆拡散プロセス中にシードごとに生成される候補 3D 構造の数を制御します。柔軟なループ領域や浅い結合ポケットの場合、サンプリングを増やすと、各シードの候補プールが拡大します。これは、特定のループで局所的な信頼度スコアが低下(pLDDT < 70)しているものの、ドメイン全体のフォールドは信頼できる(pTM > 0.80)場合に特に効果的です。これにより、最初の実行で見逃されていた可能性のある、信頼性の高い候補構造を特定できる場合があります。
リサイクルの反復回数を増やす
拡散モジュールが 3D 座標を生成する前に、AlphaFold 3 はシーケンスとペアワイズ特徴を処理します。num_recycles パラメータは、中間構造表現とペアワイズ空間埋め込みがネットワークを介して繰り返しフィードバックされる回数を指定します。
大きな複雑な分子や、共進化シグナルが弱いターゲットの場合、num_recycles を増やすと、トランク ネットワークで追加の反復処理が行われ、拡散モジュールに入力を渡す前に、離れた鎖間の空間関係が解決されます。このアプローチは、個々のチェーンが高い局所的なフォールド信頼度(pLDDT > 70)を示しているにもかかわらず、非対角 PAE 行列が高いチェーン間の不確実性(> 15 Å)を示している場合に試すことができます。リサイクルを増やすと、予測の実行時間が直線的に増加するため、リサイクルは難しいインターフェース ターゲットに限定する必要があります。
カスタム アライメント パイプラインを使用する
AlphaFold 3 は、遺伝子データベース検索パイプラインを自動的に実行して MSA テンプレートを生成します。ユーザーは、unpairedMsaPath と pairedMsaPath を使用して Cloud Storage URI を使用して、.a3m 形式でプライベートな事前計算済みのカスタム アライメントを指定することもできます。深い MSA を提供すると、強力な共進化制約が提供され、信頼度の低い予測が信頼度の高いモデルに変換されることがよくあります。