


AlphaFold 3 è un modello di deep learning sviluppato da Google DeepMind e Isomorphic Labs. È progettato per prevedere le strutture 3D e le interazioni di proteine, DNA, RNA, ligandi e ioni. Questo documento descrive come eseguire il deployment e utilizzare il modello AlphaFold 3 utilizzando Model Garden su Gemini Enterprise Agent Platform.
Funzionalità chiave
Il deployment di AlphaFold 3 su Agent Platform offre le seguenti funzionalità necessarie per la ricerca e lo sviluppo (R&S) avanzati e i workflow commerciali di scoperta di farmaci:
Uso commerciale: AlphaFold 3 su Model Garden è disponibile per l'uso commerciale.
Ligandi personalizzati arbitrari: AlphaFold 3 supporta il co-folding unificato di proteine, DNA e RNA insieme a ligandi personalizzati definiti utilizzando stringhe SMILES o codici CIF Chemical Component Dictionary (CCD).
Flessibilità del flusso di lavoro: AlphaFold 3 su Model Garden supporta una pipeline di folding end-to-end completa (che combina la ricerca nel database e la previsione del modello) o una modalità di sola inferenza in cui puoi fornire allineamenti MSA precalcolati per ottimizzare il tempo di esecuzione e l'utilizzo della GPU.
Considerazioni
Quando valuti AlphaFold 3 per i workload, tieni presente i seguenti vincoli:
Concorrenza: l'endpoint AlphaFold 3 ha un limite di concorrenza di uno per nodo. Per una maggiore concorrenza, gli endpoint possono essere scalati su più nodi. Se viene inviata una richiesta di previsione mentre un'altra previsione è in esecuzione, l'endpoint rifiuta la nuova richiesta con un errore
HTTP 429 Too Many
Requests
se il numero di richieste è superiore al numero di nodi.Limiti di token: la durata massima della previsione sugli endpoint della piattaforma agente è di 60 minuti. A causa dell'overhead di ricerca MSA variabile, la dimensione massima della sequenza supportata sulle GPU A3 è di circa 4500 token biologici (come amminoacidi, nucleotidi o atomi di ligando). Fornendo allineamenti precalcolati, si evita l'esecuzione della ricerca MSA,il che consente un folding complesso fino al limite hardware di circa 5400 token.
Limiti del payload: le richieste REST di previsione standard hanno un limite di dimensioni di 8 MB. Se utilizzi la modalità solo inferenza, devi fare riferimento ad allineamenti precalcolati di grandi dimensioni (file
.a3m) utilizzando gli URI Cloud Storage anziché incorporarli come stringhe incorporate per evitare il rifiuto del payload.Configurazione di rete: poiché le previsioni sono operazioni a lunga esecuzione che possono richiedere fino a 60 minuti per essere completate, devi eseguire il deployment dell'endpoint solo con Private Service Connect (PSC) per bypassare i limiti di timeout standard degli endpoint di 10 minuti.
Istruzioni per il deployment
Questa sezione descrive in dettaglio il deployment di AlphaFold 3 in un endpoint fornito da Agent Platform in un progetto Google Cloud .
Prima di iniziare
Prima di eseguire il deployment di AlphaFold 3, devi:
- Richiedi l'accesso al modello.
- Acquisisci risorse GPU.
- Configura le autorizzazioni Identity and Access Management (IAM) richieste:
- Crea un account di servizio con il ruolo IAM Agent Platform Administrator.
- Assicurati che l'entità IAM disponga del ruolo
roles/iam.serviceAccountCreatorper agire come account di servizio durante il deployment del modello.
- Verifica le quote delle risorse.
Requisiti delle risorse
AlphaFold 3 richiede una macchina virtuale (VM) a3-highgpu-1g.
Prima del deployment, assicurati che il tuo progetto Google Cloud disponga di una quota sufficiente nella regione di deployment di destinazione per le seguenti risorse:
Acceleratori: almeno un tipo di macchina
a3-highgpu-1g.SSD locale: la VM A3 viene sottoposta a provisioning con 750 GB di spazio SSD locale. Questo è necessario per memorizzare nella cache in modo permanente i database delle sequenze di riferimento (UniProt, MGnify, Rfam), consentendo letture a bassa latenza durante le ricerche nei database genetici (Jackhmmer/Nhmmer) in tutte le richieste di previsione.
Bucket Cloud Storage
AlphaFold 3 richiede un bucket Cloud Storage per archiviare i file MSA forniti ed esportare gli output di previsione completi. Per evitare trasferimenti tra regioni, ti consigliamo di utilizzare un bucket Cloud Storage nella stessa regione dell'endpoint o un bucket multiregionale.
Ruoli di Identity and Access Management
Configura i seguenti ruoli per le identità partecipanti:
Deployer del modello (noto anche come amministratore IT): l'identità che esegue il deployment del modello richiede l'autorizzazione
roles/aiplatform.adminper creare endpoint e gestire i deployment.Identità di gestione: durante l'esecuzione dell'inferenza, gli endpoint AlphaFold 3 scrivono le strutture di output direttamente in Cloud Storage utilizzando il account di servizio del progetto tenant. Il account di servizio corrispondente richiede il ruolo
roles/storage.objectUsersul bucket Cloud Storage di destinazione.Utenti del modello: gli account che avviano le previsioni richiedono quanto segue:
roles/aiplatform.userper inviare richieste di previsione all'endpoint.roles/storage.objectUserper accedere agli output delle previsioni nel bucket Cloud Storage.
Esegui il deployment di AlphaFold 3
Esegui il deployment di AlphaFold 3 in modo programmatico utilizzando l'SDK Agent Platform come endpoint Google Cloud Dedicated o solo come endpoint Private Service Connect. A seconda della disponibilità della GPU, possono essere necessari 10-15 minuti prima che l'endpoint sia pronto per l'inferenza.
Di seguito è riportato uno snippet Python di esempio che mostra come eseguire il deployment del modello in un progetto Google Cloud , inclusa un'estensione del timeout di inferenza:
import google.auth
from google.auth.transport.requests import AuthorizedSession
import vertexai
from vertexai import model_garden

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
MODEL_ID = "google/alphafold3@v3_0_4"
MACHINE_TYPE = "a3-highgpu-1g"

vertexai.init(project=PROJECT_ID, location=LOCATION)

# 1. Deploy Model Garden OpenModel to Dedicated Endpoint
af3_model = model_garden.OpenModel(MODEL_ID)
endpoint = af3_model.deploy(
    endpoint_display_name="af3-dedicated-ep",
    model_display_name="af3-on-mg",
    machine_type=MACHINE_TYPE,
    accelerator_type="NVIDIA_H100_80GB",
    accelerator_count=1,
    reservation_affinity_type="ANY_RESERVATION",
    use_dedicated_endpoint=True,
    accept_eula=True,
    min_replica_count=1,
    max_replica_count=1,
    serving_container_deployment_timeout=3600,
)

# 2. Update inference timeout to 3,600 seconds
credentials, _ = google.auth.default(
    scopes=["https://www.googleapis.com/auth/cloud-platform"]
)
session = AuthorizedSession(credentials)
url = f"https://{LOCATION}-aiplatform.googleapis.com/v1/{endpoint.resource_name}:update"
payload = {
    "endpoint": {
        "name": endpoint.resource_name,
        "clientConnectionConfig": {
            "inferenceTimeout": {
                "seconds": 3600
            }
        }
    }
}
response = session.post(url, json=payload)
response.raise_for_status()
print(f"Endpoint Resource Name: {endpoint.resource_name}")
Riferimento API
Questa sezione descrive la posizione dell'endpoint, il formato dell'URL, i parametri di percorso e lo schema del payload della richiesta.
Richiesta HTTP
POST https://HOST/v1/projects/PROJECT_ID/locations/LOCATION/endpoints/ENDPOINT_ID:predict
Sostituisci quanto segue:
HOST: l'host dell'endpoint di servizio. Questo dipende dal fatto che il tipo di deployment sia un endpoint pubblico dedicato o utilizzi Private Service Connect.PROJECT_ID: l'ID progetto Google Cloud che ospita l'endpoint di cui è stato eseguito il deployment.LOCATION: la regione Google Cloud in cui è stato eseguito il deployment dell'endpoint (ad esempious-central1).ENDPOINT_ID: l'identificatore univoco dell'endpoint Agent Platform di cui è stato eseguito il deployment.
Corpo della richiesta
Il corpo della richiesta contiene dati con la seguente struttura JSON:
{
  "instances": [
    {
      # The AlphaFold 3 input JSON - see the input documentation at
      # https://github.com/google-deepmind/alphafold3/blob/main/docs/input.md
    }
  ],
  "parameters": {
    "output_dir": "string",
    "dry_run": boolean,
    "run_data_pipeline": boolean,
    "force_output_dir": boolean,
    "resolve_msa_overlaps": boolean,
    "max_template_date": "string",
    "conformer_max_iterations": integer,
    "fix_standalone_glycans": boolean,
    "flash_attention_implementation": "string",
    "num_recycles": integer,
    "num_diffusion_samples": integer,
    "save_embeddings": boolean,
    "save_distogram": boolean,
    "compress_large_output_files": boolean,
    "num_seeds": integer
  }
}
Campi di richiesta di primo livello
| Campo | Tipo | Descrizione |
|---|---|---|
instances |
array |
Obbligatorio. L'elenco delle configurazioni di sequenze biologiche da prevedere. Questo elenco deve contenere esattamente un elemento. Se passi zero o più di un elemento, viene generato un errore HTTP 422 Unprocessable
Entity. Il corpo instances deve specificare gli input in base alla specifica pubblicata nella
documentazione di AlphaFold 3.
|
parameters |
object |
Facoltativo. Un oggetto contenente i parametri di esecuzione per configurare l'esecuzione della previsione (ad esempio dry_run, output_dir).
|
Parametri
Configura i flag di esecuzione per l'esecuzione di AlphaFold 3.
| Campo | Tipo | Valore predefinito | Descrizione |
|---|---|---|---|
dry_run |
boolean |
false |
Facoltativo. Se true, l'API esegue la convalida della richiesta, ma ignora l'esecuzione del modello e restituisce immediatamente una risposta vuota. Utile per i controlli di connettività e sintassi.
|
run_data_pipeline |
boolean |
true |
Facoltativo. Se true, esegue la pipeline completa (ricerca MSA e inferenza). Se false, esegue solo l'inferenza (salta la ricerca nel database; richiede MSA precalcolati). Per ulteriori dettagli, consulta la
documentazione su GitHub.
|
output_dir |
string |
null |
Facoltativo. L'URI Cloud Storage (ad esempio gs://bucket/path) in cui vengono caricati i file di output non elaborati completi (tra cui strutture CIF, PAE e CSV di ranking) dopo l'esecuzione riuscita.
|
force_output_dir |
boolean |
false |
Facoltativo. Se true, consente di sovrascrivere i file esistenti
nella output_dir specificata. Se false, l'API restituisce immediatamente un errore HTTP 400 Bad Request se il percorso di Cloud Storage non è vuoto per evitare la perdita accidentale di dati.
|
resolve_msa_overlaps |
boolean |
true |
Facoltativo. Indica se deduplicare gli MSA non accoppiati rispetto a quelli accoppiati. Per le best practice, consulta le linee guida nella documentazione di AlphaFold 3 su GitHub. |
max_template_date |
string |
null |
Facoltativo. Data di rilascio massima del modello da considerare nel formato YYYY-MM-DD (ad esempio, "2024-05-15"). La convalida non va a buon fine con un errore HTTP 422 se la formattazione non è corretta.
|
conformer_max_iterations |
integer |
null |
Facoltativo. Override del numero massimo di iterazioni da eseguire per la ricerca di conformeri RDKit. Deve essere un numero intero non negativo (maggiore o uguale a zero). La convalida non va a buon fine con un errore HTTP 422 per i valori negativi.
|
fix_standalone_glycans |
boolean |
false |
Facoltativo. Consente la correzione della posizione dei glicani autonomi. |
flash_attention_implementation |
string |
null |
Facoltativo. Implementazione del backend di Flash Attention da utilizzare. I valori consentiti sono "triton", "cudnn", "xla".
|
num_recycles |
integer |
10 |
Facoltativo. Numero di iterazioni di riciclo da utilizzare durante l'inferenza. Deve essere un numero intero positivo (maggiore di zero). Consulta la sezione delle best practice per scoprire i compromessi. |
num_diffusion_samples |
integer |
5 |
Facoltativo. Numero di campioni di diffusione da generare. Deve essere un numero intero positivo (maggiore di zero). Consulta la sezione delle best practice per scoprire i compromessi. |
save_embeddings |
boolean |
false |
Facoltativo. Indica se salvare gli embedding finali singoli e di coppia del tronco nella posizione output_dir. Se true, gli embedding vengono scritti come file .npz in una sottocartella denominata seed-{SEED}_embeddings/ (ad esempio, outputs_config_job_seed-50_embeddings.npz).
|
save_distogram |
boolean |
false |
Facoltativo. Indica se salvare il distogramma previsto finale nella posizione output_dir. Se true, gli embedding vengono scritti come file .npz in una sottocartella denominata seed-{SEED}_embeddings/ (ad esempio, outputs_config_job_seed-50_embeddings.npz).
|
compress_large_output_files |
boolean |
false |
Facoltativo. Se true, comprime i file di output di grandi dimensioni (strutture mmCIF e JSON di confidenza) utilizzando zstandard. In questo modo vengono generati file con estensioni .cif.zst e .json.zst anziché .cif e .json. I file di piccole dimensioni (come ranking_scores.csv) rimangono non compressi.
|
num_seeds |
integer |
null |
Facoltativo. Numero di seed casuali da utilizzare per l'inferenza. In generale, devi impostare i seed all'interno del campo instances.modelSeeds per la riproducibilità. Consulta la
sezione delle best practice per scoprire i
compromessi.
|
Risposta (output)
Questa sezione descrive i campi restituiti nella risposta dell'API in caso di esecuzione corretta.
Corpo della risposta
In caso di esecuzione riuscita, l'endpoint restituisce la risposta nel formato dello schema di previsione online standard di Agent Platform:
{
  "deployedModelId": "string",
  "model": "string",
  "modelDisplayName": "string",
  "modelVersionId": "string",
  "predictions": [
    {
      "structure_cif": "string",
      "plddt": [
        number
      ],
      "pae": [
        [
          number
        ]
      ],
      "summary": {
        "ptm": number,
        "iptm": number,
        "fraction_disordered": number,
        "has_clash": boolean,
        "ranking_score": number,
        "chain_pair_pae_min": [
          [
            number
          ]
        ],
        "chain_pair_iptm": [
          [
            number
          ]
        ],
        "chain_ptm": [
          number
        ],
        "chain_iptm": [
          number
        ],
        "chain_ids": [
          string
        ]
      },
      "output_dir": "string"
    }
  ]
}
Campi di risposta di primo livello
| Campo | Tipo | Descrizione |
|---|---|---|
deployedModelId |
string |
L'ID del modello di cui è stato eseguito il deployment sull'endpoint Agent Platform. |
model |
string |
Il nome completo della risorsa del modello. |
modelDisplayName |
string |
Il nome visualizzato del modello di cui è stato eseguito il deployment (sempre "alphafold3").
|
modelVersionId |
string |
L'ID versione del modello di cui è stato eseguito il deployment. |
predictions |
array |
L'elenco dei risultati della previsione. Per AlphaFold 3, questo array contiene esattamente un oggetto del risultato della previsione. |
Dettagli dei risultati della previsione (predictions[])
L'endpoint di previsione di AlphaFold 3 restituisce una risposta JSON HTTP 200 contenente un array predictions con coordinate strutturali e metriche di affidabilità per il candidato con il ranking più alto. Per definizioni complete dei campi e specifiche dei file di output, consulta la documentazione ufficiale di AlphaFold 3 su GitHub.
A seconda che parameters.output_dir sia fornito o meno nella richiesta, la struttura di output nella risposta dell'API può variare:
Previsione nella risposta HTTP: la risposta in linea restituisce metriche di riepilogo globali (
summary), coordinate della struttura 3D (structure_cif), punteggi di affidabilità per atomo (plddt) e la matrice di errore allineato previsto 2D (pae) direttamente nel corpo del payload della risposta JSON HTTP. Quando viene specificata una directory di output, i campi di payload di grandi dimensioni (structure_cif,plddtepae) vengono omessi (null) dal payload della risposta HTTP per evitare colli di bottiglia della serializzazione. Tutti gli output del modello non elaborati vengono invece esportati in modo asincrono nel bucket Cloud Storage specificato.Artefatto salvato nel bucket Cloud Storage: quando viene specificata una directory di output (
parameters.output_dir), i risultati completi della previsione vengono caricati su Cloud Storage. La cartella di output contiene i dati in base alla specifica pubblicata nella documentazione di AlphaFold 3 su GitHub.
Fai previsioni
Il deployment di Model Garden semplifica l'esecuzione della pipeline di previsione end-to-end, inclusa la pipeline di dati e l'inferenza del modello in una singola chiamata API. Il seguente diagramma mostra l'architettura di alto livello delle previsioni di AlphaFold 3:
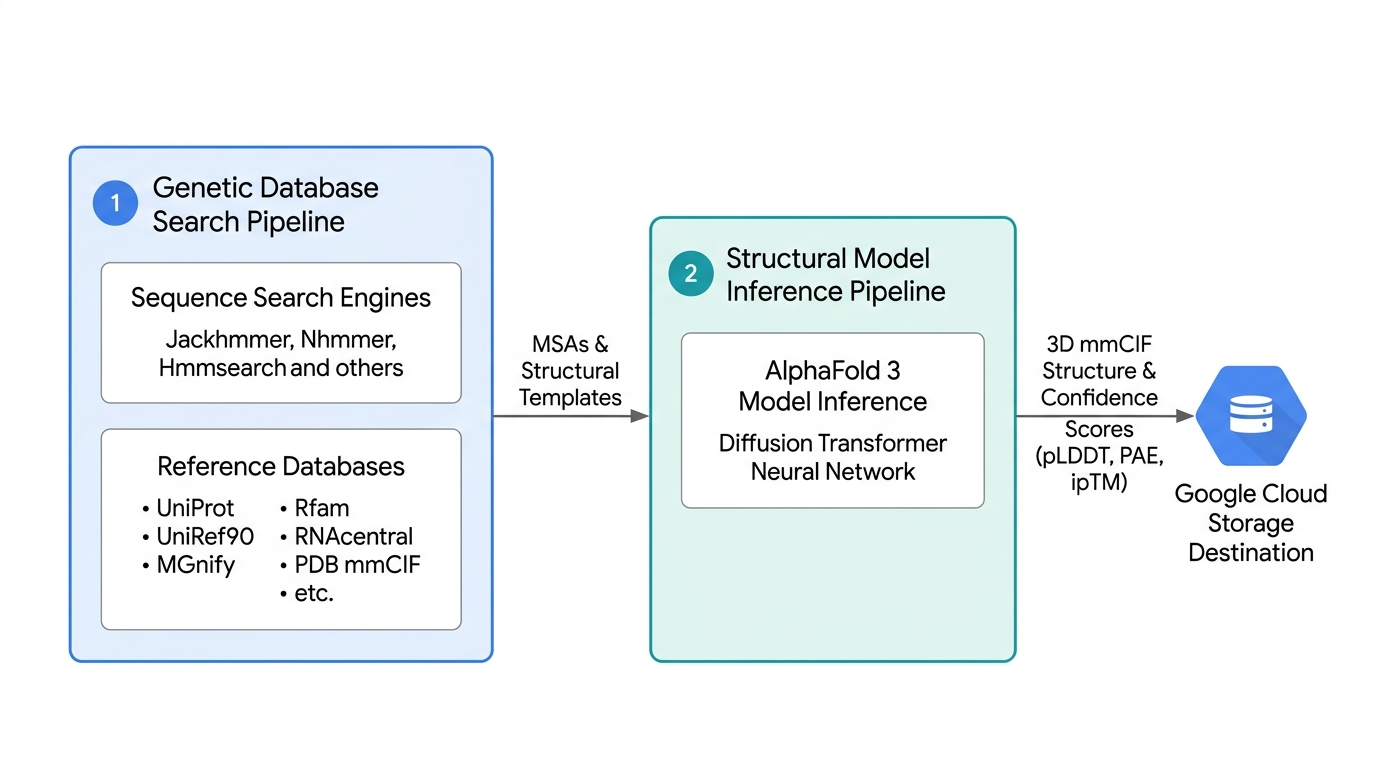
Fig. 1 Pipeline di previsione completa
Quando esegui le previsioni, ti consigliamo vivamente di fornire un bucket Cloud Storage direttamente nei parametri per esportare il set di dati non elaborati completo, incluse le sottodirectory per campione, i manifest di ranking e gli output non elaborati. Per un'analisi completa di tutti i campi di richiesta configurabili, inclusa l'ottimizzazione dei parametri per il campionamento multi-seed, il riciclo neurale, le traiettorie di diffusione e i legami covalenti personalizzati, consulta la sezione Riferimento API.
Prima di avviare job di folding o pipeline batch di lunga durata, puoi eseguire un dry run per verificare rapidamente l'autenticazione, le autorizzazioni IAM e la connettività di rete degli endpoint.
Opzioni di previsione
A seconda del workflow, l'elaborazione di AlphaFold 3 può essere organizzata in quattro modalità di esecuzione distinte:
- Modalità dry run
- Modalità di previsione end-to-end
- Solo inferenza con MSA e modelli precalcolati
- Esecuzione senza MSA e modelli
Modalità dry run
Per verificare la connettività, l'autenticazione, il networking e gli schemi JSON dell'API senza avviare la pipeline di previsione, puoi inviare una richiesta con "dry_run":
true nell'oggetto parameters. L'endpoint esegue tutte le routine di convalida (tra cui il controllo delle autorizzazioni in scrittura del bucket Cloud Storage e la convalida dei caratteri della sequenza), ma salta l'esecuzione, restituendo immediatamente una risposta di previsione vuota.
Di seguito è riportato uno script Python di esempio per la modalità dry run:
from google.cloud import aiplatform

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Connect to Dedicated Endpoint
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define prediction payload
instances = [
    {
        "name": "preflight_check",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                }
            }
        ],
    }
]

parameters = {
    "dry_run": True,
}

# Execute prediction request
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)
print(response.predictions)
Modalità di previsione end-to-end
Per eseguire la previsione end-to-end, invia sequenze biologiche non elaborate (proteine, DNA, RNA, ligandi e PTM) in un'unica richiesta. L'endpoint esegue automaticamente la ricerca nel database genetico, seguita immediatamente dall'inferenza del modello. Questa opzione è consigliata per i job di folding senza allineamenti preesistenti.
Di seguito è riportato uno script Python di esempio per la modalità di previsione end-to-end:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/alphafold_output/"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "e2e_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
Solo inferenza con MSA e modelli precalcolati
Potresti già avere MSA e template mmCIF precalcolati da un'esecuzione precedente o generati al di fuori dell'endpoint del modello. In questi scenari, la ricerca nel database genetico può essere ignorata completamente fornendo gli allineamenti e i modelli, indirizzando la richiesta direttamente alla previsione della struttura. In questo modo, è anche possibile ridurre in modo significativo il tempo di risposta dell'inferenza. Questo è il percorso consigliato nei seguenti scenari:
- Quando si esegue il docking di più ligandi di piccole molecole diversi rispetto a un singolo target proteico statico, gli MSA possono essere riutilizzati.
- Esecuzione della stessa sequenza di molecole su più seed casuali, in modo iterativo, per mappare la flessibilità strutturale.
- Allineamento delle sequenze offline con database genomici privati e non pubblici.
- Ottimizzazione delle risorse GPU per AlphaFold 3, per concentrarsi solo sulla generazione della struttura.
Di seguito è riportato uno script Python di esempio per la modalità solo inferenza:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                    "unpairedMsaPath": "gs://YOUR_BUCKET_NAME/path/to/unpaired.a3m",
                    "pairedMsa": "",
                    "templates": [],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "run_data_pipeline": False,
    "output_dir": STORAGE_OUTPUT_DIR,
    "force_output_dir": True,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
Esecuzione senza MSA e template
È anche possibile bypassare completamente la ricerca nel database genetico e la corrispondenza dei modelli. Il modello prevede la struttura 3D utilizzando solo la sequenza di query, senza sequenze omologhe o informazioni co-evolutive. Per attivare questa modalità, fornisci stringhe vuote per i parametri MSA unpairedMsa e pairedMsa e un elenco vuoto per templates nell'istanza e imposta run_data_pipeline su false nei parametri. Ciò può essere utile per la progettazione di molecole sintetiche o ingegnerizzate o per testare le previsioni strutturali in assenza di un contesto evolutivo.
Di seguito è riportato uno script Python di esempio per l'esecuzione di AlphaFold 3 senza MSA e senza template:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only_gcs_job"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_only_gcs_job",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1, 2, 3],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "unpairedMsa": "",
                    "pairedMsa": "",
                    "templates": [],
                }
            }
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
    "run_data_pipeline": False,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters,
    timeout=3600.0,
)

print(response.predictions)
Per specifiche dettagliate, parametri delle entità e metriche di affidabilità dell'output, consulta la documentazione di AlphaFold 3 su GitHub.
Output di previsione
Il servizio di previsione AlphaFold 3 fornisce due meccanismi di distribuzione complementari per il recupero degli output di previsione. Per impostazione predefinita, la risposta dell'API restituisce i risultati della previsione in linea in modo sincrono per il candidato con il ranking più alto. Facoltativamente, puoi specificare una directory Cloud Storage.
La sezione seguente fornisce una panoramica dell'output della previsione. Per ulteriori dettagli, consulta la documentazione di AlphaFold 3 su GitHub.
Risposta in linea e artefatti salvati
Il servizio di previsioni AlphaFold 3 supporta due pattern di output principali:
- Risposta in linea: restituisce le coordinate della struttura 3D e le metriche di affidabilità solo per il candidato con il ranking più alto direttamente all'interno del payload della risposta HTTP REST. Questa opzione è ideale per la prototipazione interattiva rapida o per le query a sequenza singola.
- Artefatti salvati (Cloud Storage): se specifichi una directory di output, il set di dati multi-campione completo viene esportato in Cloud Storage. Sono inclusi i singoli file di coordinate, i file JSON di confidenza, i distogrammi, gli embedding e le metriche di riepilogo per ogni seed casuale e campione di diffusione generati. L'utilizzo di Cloud Storage è consigliato per i workload di produzione, la mappatura degli insiemi conformazionali e l'aggiramento del limite di dimensioni del payload della richiesta.
Di seguito è riportato un esempio in Python di come recuperare gli artefatti salvati da Cloud Storage per l'analisi downstream:
from google.cloud import storage

BUCKET_NAME = "your-bucket-name"
JOB_NAME = "my_alphafold_job"
STORAGE_PREFIX = f"af3_results/my_folder/{JOB_NAME}"

# Initialize Cloud Storage client
client = storage.Client(project="your-project-id")
bucket = client.bucket(BUCKET_NAME)

# Download the top-ranked 3D structure and global ranking ledger
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_model.cif").download_to_filename("model.cif")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_ranking_scores.csv").download_to_filename("ranking_scores.csv")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_summary_confidences.json").download_to_filename("summary.json")
Poiché AlphaFold 3 utilizza un modello di diffusione generativo, ogni esecuzione di previsione genera un insieme di strutture 3D candidate tra seed e traiettorie di campionamento. La valutazione e il confronto di queste esecuzioni candidate possono aiutare a interpretare gli output di previsione prima di eseguire un'analisi strutturale dettagliata.
Puoi esaminare il set di dati completo degli artefatti multi-campione utilizzando tre file principali:
ranking_scores.csv: il registro principale che elenca ogni coppia di traiettorie generata e il relativoranking_scorecomposito. Le righe vengono salvate nell'ordine di esecuzione della traiettoria (ordinate per seed in ordine crescente, poi per indice di esempio in ordine crescente), non pre-ordinate per punteggio. Gli utenti devono ordinare in base aranking_scorein ordine decrescente per identificare i ranking dei candidati.summary_confidences.json: contiene metriche di qualità globali (pTM,ipTM,has_clash,fraction_disordered) per il candidato principale.Per-Sample
summary_confidences.json: si trova all'interno delle singole cartelleseed-{SEED}_sample-{INDEX}/, consentendoti di ispezionare le matrici pTM e ipTM a livello di catena per specifiche esecuzioni di candidati non principali, se necessario.
Il seguente esempio di Python analizza ranking_scores.csv e summary_confidences.json per classificare gli esempi candidati e convalidare la qualità dei candidati principali:
import csv
import json

print("=== Candidate Samples Ledger (ranking_scores.csv) ===")
with open("ranking_scores.csv", "r", newline="", encoding="utf-8") as f:
    rows = sorted(
        csv.DictReader(f), key=lambda x: float(x["ranking_score"]), reverse=True
    )

# Calculate column widths cleanly and readably
headers = list(rows[0].keys())
widths = {}
for col in headers:
    lengths = [len(col)] + [len(r[col]) for r in rows]
    widths[col] = max(lengths)

print("  ".join(col.rjust(widths[col]) for col in headers))
for r in rows:
    print("  ".join(r[col].rjust(widths[col]) for col in headers))

top = rows[0]
print(
    f"\nPromoted Top Candidate: Seed {int(top['seed'])}, Sample"
    f" {int(top['sample'])} (Score: {float(top['ranking_score']):.4f})"
)

print("\n=== Top Candidate Quality Validation (summary.json) ===")
with open("summary.json", "r", encoding="utf-8") as f:
    summary = json.load(f)

clash_str = (
    "DETECTED (FAIL)" if summary.get("has_clash") else "None Detected (PASS)"
)
print("Top Candidate Metrics:")
print(f"  • Ranking Score : {summary.get('ranking_score', 'N/A')}")
print(f"  • Global pTM    : {summary.get('ptm', 'N/A')}")
print(f"  • Interface ipTM: {summary.get('iptm', 'N/A')}")
print(f"  • Steric Clash  : {clash_str}")
Per specifiche complete dello schema dei file salvati e degli attributi mmCIF, consulta la documentazione di AlphaFold 3 su GitHub. Consulta anche la guida How to assess the quality of AlphaFold 3 predictions su EMBL-EBI per capire come valutare la qualità delle previsioni.
Best practice
Le sezioni seguenti descrivono le best practice per l'utilizzo di AlphaFold 3 su Agent Platform:
Mitiga i timeout delle richieste
Gli endpoint sulla piattaforma dell'agente applicano un timeout di esecuzione massimo predefinito di 60 minuti per richiesta. Per assicurarti che le previsioni vengano completate correttamente senza timeout, segui queste linee guida:
- Evita il sovracampionamento in una singola richiesta: l'inizializzazione di un'ampia gamma di seed o di parametri di diffusione inversa eccessivamente elevati in una singola chiamata API può far sì che il tempo di esecuzione superi il limite di 60 minuti.
- Scomponi le scansioni di grandi dimensioni: per gli studi su larga scala, suddividi i seed e le scansioni dei parametri in più payload di previsione più piccoli e inviali come job separati. In questo modo, puoi anche sfruttare le funzionalità di scalabilità automatica dell'endpoint.
Bypassa la ricerca MSA
La pipeline di ricerca nel database genetico è la fase che richiede più tempo della pipeline AlphaFold. Quando esegui previsioni iterative sulla stessa sequenza (ad esempio, esegui sweep di screening dei ligandi su un target proteico fisso), puoi ottimizzare notevolmente i tempi di esecuzione ignorando completamente la ricerca nel database:
- Estrai l'MSA: esegui una previsione end-to-end iniziale con una directory di output di Cloud Storage (
output_dir) specificata. Scarica il file{JOB_NAME}_data.jsongenerato dal bucket Cloud Storage di output. - Invia previsioni solo per l'inferenza: individua i campi
unpairedMsaepairedMsaall'interno del file JSON. Estrai queste stringhe MSA e passale alle richieste di previsione successive utilizzandounpairedMsaPathepairedMsaPathche puntano agli URI Cloud Storage.
In alternativa, puoi eseguire la ricerca MSA sulla tua infrastruttura e inserire i template MSA precalcolati nella richiesta di previsione.
Gestisci le esecuzioni con confidenza bassa
Quando gli output di previsione generano metriche di confidenza basse, anziché trattarli come errori di previsione irrecuperabili, puoi tentare una correzione mirata. L'ottimizzazione di parametri specifici ti consente di esplorare traiettorie latenti alternative. Questa sezione elenca alcuni approcci per il recupero in caso di previsioni con scarsa confidenza.
Utilizza il campionamento multi-seed
AlphaFold 3 inizializza la generazione di coordinate 3D dal rumore casuale nello spazio latente. Quando una previsione viene inviata con un singolo seed specifico, la traiettoria di diffusione potrebbe seguire un percorso diverso rispetto a un altro seed. Il passaggio di un array di seed forza il modello a campionare le traiettorie a partire da stati diversi.
Il campionamento multi-seed offre due vantaggi fondamentali: verifica la coerenza strutturale tra esecuzioni indipendenti ed esamina la dinamica conformazionale funzionale. Se, ad esempio, tutti e cinque i seed convergono in coordinate 3D identiche, puoi avere un'elevata confidenza nel fold globale. Al contrario, se seed diversi producono pose di legame distinte e ad alta confidenza, l'ensemble potrebbe rivelare stati conformazionali biologicamente significativi, come loop di siti attivi aperti o chiusi o dimeri alternativi con scambio di domini.
Espandi le traiettorie di diffusione
Mentre modelSeeds altera lo stato di rumore iniziale nello spazio latente, il parametro num_diffusion_samples (predefinito 5) controlla il numero di strutture 3D candidate generate per seed durante il processo di diffusione inversa. Per le regioni di loop flessibili o le tasche di legame poco profonde, l'aumento del campionamento espande il pool di candidati per ogni seed. Questo è particolarmente efficace quando i punteggi di confidenza locali diminuiscono in loop specifici (pLDDT < 70), mentre il fold complessivo del dominio rimane affidabile (pTM > 0,80). In questo modo, è possibile scoprire strutture candidate ad alta affidabilità che altrimenti non sarebbero state rilevate nella prima esecuzione.
Aumenta le iterazioni di riciclo
Prima che il modulo di diffusione generi le coordinate 3D, AlphaFold 3 elabora le caratteristiche delle sequenze e delle coppie. Il parametro num_recycles determina il numero di volte in cui le rappresentazioni della struttura intermedia e gli embedding spaziali a coppie vengono reinseriti in modo iterativo nella rete.
Per molecole complesse di grandi dimensioni o target con segnali co-evolutivi deboli, l'aumento di num_recycles fornisce alla rete trunk iterazioni aggiuntive per risolvere le relazioni spaziali tra catene distanti prima di passare gli input al modulo di diffusione. Questo approccio può essere tentato quando le matrici PAE fuori diagonale mostrano un'elevata incertezza tra le catene (> 15 Å) nonostante le singole catene mostrino un'elevata confidenza di ripiegamento locale (pLDDT > 70). Tieni presente che l'aumento dei ricicli aumenta in modo lineare il runtime di previsione, quindi deve essere riservato a target di interfaccia difficili.
Utilizza una pipeline di allineamento personalizzata
AlphaFold 3 esegue automaticamente la pipeline di ricerca nel database genetico per generare modelli MSA. Gli utenti possono anche fornire allineamenti personalizzati privati e precalcolati in formato .a3m utilizzando gli URI Cloud Storage con unpairedMsaPath e pairedMsaPath. Fornire MSA approfonditi fornisce forti vincoli co-evolutivi, convertendo spesso previsioni con bassa confidenza in modelli con alta confidenza.