


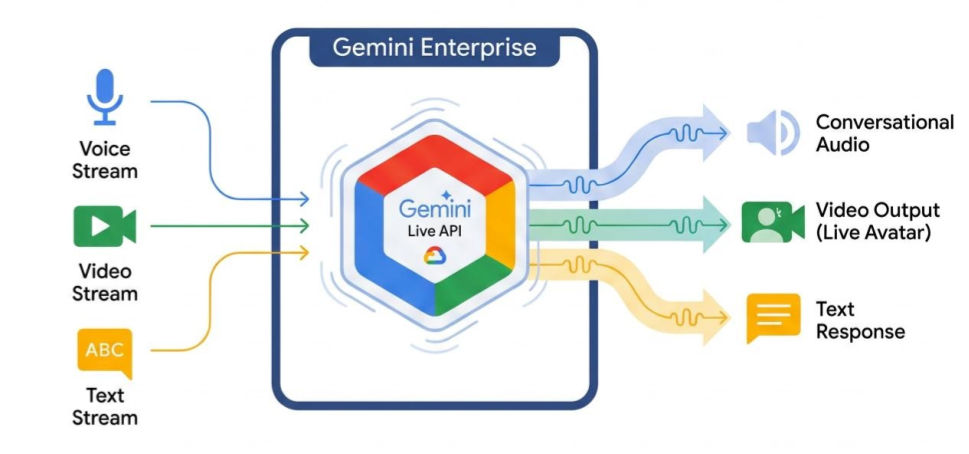
Die Gemini Live API ermöglicht Sprach- und Videointeraktionen mit geringer Latenz und in Echtzeit mit Gemini. Die Funktion verarbeitet kontinuierliche Audio-, Video- oder Textstreams und liefert sofortige, menschenähnliche gesprochene Antworten. So können Ihre Nutzer auf natürliche Weise mit dem Bot interagieren. Mit Live-Avataren können Sie mit einem menschenähnlichen Symbol interagieren, das sich mit den Sprachantworten synchronisiert. So wird die Interaktion mit Nutzern verbessert und persönlicher.
Gemini Live API in Agent Studio ausprobieren
Beispielanwendungsfälle
Mit der Gemini Live API können Sie Sprach- und Video-KI-Agenten in Echtzeit für eine Vielzahl von Branchen erstellen, darunter:
Markenbotschafter: Interaktive Markenbotschafter, die auf unternehmenseigenen Web-Properties oder in mobilen Anwendungen eingesetzt werden und auf autorisierten Abbildungen von Mitarbeitern oder bezahlten Talenten mit unterzeichneten Unternehmensfreigaben basieren.
E-Commerce und Einzelhandel: Shopping-Assistenten, die personalisierte Empfehlungen geben, und Support-Agenten, die Kundenprobleme lösen.
Gaming: Interaktive NPCs, In-Game-Hilfeassistenten und Echtzeitübersetzung von In-Game-Inhalten.
Schnittstellen der nächsten Generation: Sprach- und videobasierte Funktionen in Robotern, Smart Glasses und Fahrzeugen.
Gesundheitswesen: Navigationsanleitungen, die bei der Logistik von Einrichtungen und Pflege helfen.
Finanzdienstleistungen: Konversations-Agenten, die alltägliche Bankanfragen bearbeiten.
Bildung: KI-Mentoren und Lernbegleiter, die personalisierte Anleitungen und Feedback geben.
Wichtige Features
Die Gemini Live API bietet eine umfassende Reihe von Funktionen zum Erstellen leistungsstarker Sprach- und Video-Agents:
Hohe Audioqualität: Die Gemini Live API bietet natürliche, realistisch klingende Sprache in mehreren Sprachen.
Unterstützung mehrerer Sprachen: Unterhalten Sie sich in 24 unterstützten Sprachen.
Barge-in: Nutzer können das Modell jederzeit unterbrechen, um responsive Interaktionen zu starten.
Affektiver Dialog: Passt den Antwortstil und den Tonfall an die Ausdrucksweise des Nutzers an.
Toolnutzung: Integriert Tools wie Funktionsaufrufe und die Google Suche für dynamische Interaktionen.
Audio-Transkriptionen: Bietet Texttranskriptionen sowohl der Nutzereingabe als auch der Modellausgabe. Wenn Sie die Transkription als Endziel und nicht als Nebenkanal einer Unterhaltung verwenden möchten, lesen Sie den Abschnitt Gemini 3.5 Transcribe.
Proaktive Audioausgabe: Damit können Sie steuern, wann und in welchem Kontext das Modell antwortet.
Technische Spezifikationen
In der folgenden Tabelle sind die technischen Spezifikationen für die Gemini Live API aufgeführt:
| Kategorie | Details |
|---|---|
| Eingabemodalitäten | Audio (rohes 16-Bit-PCM-Audio, 16 kHz, Little Endian), Bilder/Video (JPEG, 1 FPS), Text |
| Ausgabemodalitäten | Audio (rohes 16‑Bit-PCM-Audio, 24 kHz, Little Endian), Text |
| Video (Live-Avatare) | Video (MP4) |
| Protokoll | Statusbehaftete WebSocket-Verbindung (WSS) |
Unterstützte Modelle
Die folgenden Modelle unterstützen die Gemini Live API. Wählen Sie das passende Modell für Ihre Interaktionsanforderungen aus.
| Modell-ID | Verfügbarkeit | Anwendungsfall | Wichtige Features |
|---|---|---|---|
gemini-3.8-live |
Allgemein verfügbar | Empfohlen. Sprachagenten mit niedriger Latenz. Unterstützt nahtloses Umschalten zwischen Sprachen. |
|
gemini-live-2.5-flash-native-audio |
Allgemein verfügbar | Empfohlen. Sprachagenten mit niedriger Latenz. Unterstützt nahtloses Umschalten zwischen Sprachen und emotionalen Ton. |
|
gemini-3.5-transcribe-live-preview |
Vorschau | Nur Sprache-zu-Text. Untertitelung in Echtzeit, Diktierfunktion und Anruftranskription. Gibt Text und nicht Audio zurück, sodass keine Unterhaltung stattfindet. |
|
Jetzt starten
Wählen Sie den Leitfaden aus, der Ihrer Entwicklungsumgebung entspricht:
Gen AI SDK-Tutorial
Stellen Sie mit dem Gen AI SDK eine Verbindung zur Gemini Live API her, um eine multimodale Echtzeitanwendung mit einem Python-Backend zu erstellen.
WebSocket-Tutorial
Stellen Sie über WebSockets eine Verbindung zur Gemini Live API her, um eine multimodale Echtzeitanwendung mit einem JavaScript-Frontend und einem Python-Backend zu erstellen.
ADK-Tutorial
Erstellen Sie einen Agenten und verwenden Sie das Agent Development Kit (ADK) Streaming, um Sprach- und Videokommunikation zu ermöglichen.
Einbindung in Partnerlösungen
Wenn Sie eine Integration mit einigen unserer Partner vornehmen möchten, haben diese Plattformen die Gemini Live API bereits über das WebRTC-Protokoll integriert, um die Entwicklung von Audio- und Videoanwendungen in Echtzeit zu optimieren.
LiveKit- und ADK-Referenzarchitektur
Für fortschrittliche, produktionsreife Sprachassistenten, die eine ausgefeilte Sitzungsorchestrierung, Weiterleitung und Multi-Agent-Delegierung erfordern, können Sie mit LiveKit (WebRTC) und der Gemini Live API über das Agent Development Kit (ADK) eine bidirektionale Integration mit geringer Latenz erstellen.
Mit dieser Architektur können Sie einen Orchestrator-Agenten bereitstellen, der die erste Kundeninteraktion übernimmt und Anfragen dynamisch an spezialisierte Sub-Agenten weiterleitet (z. B. Kontext mithilfe von transferAgent-Orchestration an einen Agenten für Flug- oder Hotelbuchungen delegiert).
Informationen zum Untersuchen und Bereitstellen dieses Referenzdesigns finden Sie in der offiziellen Implementierung der Referenzcodebasis auf GitHub.