


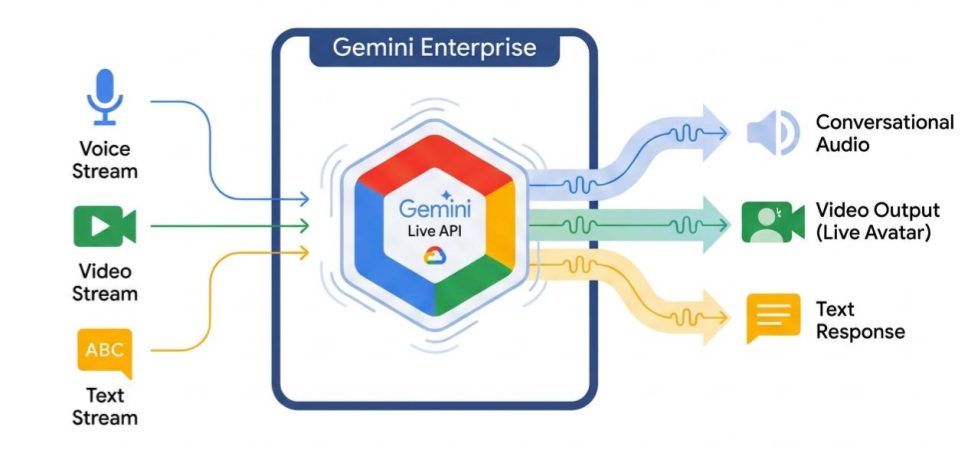
L'API Gemini Live consente interazioni vocali e video a bassa latenza e in tempo reale con Gemini. Elabora flussi continui di audio, video o testo per fornire risposte immediate e simili a quelle umane. In questo modo, gli utenti possono usufruire di un'esperienza conversazionale naturale. Gli avatar live aggiungono la possibilità di interagire con un'icona simile a un essere umano che si sincronizza con le risposte vocali, offrendo un'esperienza migliorata e personalizzata agli utenti.
Prova l'API Gemini Live in Agent Studio
Esempi di casi d'uso
L'API Gemini Live può essere utilizzata per creare agenti vocali e video in tempo reale per una varietà di settori, tra cui:
Ambasciatori aziendali brandizzati: rappresentanti interattivi del brand implementati su proprietà web aziendali o applicazioni mobile, generati da immagini di dipendenti autorizzati o talenti pagati con liberatorie aziendali eseguite.
E-commerce e vendita al dettaglio: assistenti per lo shopping che offrono consigli personalizzati e agenti di assistenza che risolvono i problemi dei clienti.
Gaming: personaggi non giocanti (PNG) interattivi, assistenti in-game e traduzione in tempo reale dei contenuti in-game.
Interfacce di nuova generazione: esperienze abilitate per voce e video in robotica, occhiali smart e veicoli.
Sanità: guide di navigazione che aiutano con la logistica di strutture e cure.
Servizi finanziari: agenti conversazionali che eseguono il triage delle richieste bancarie quotidiane.
Istruzione: mentori AI e compagni di apprendimento che forniscono istruzioni e feedback personalizzati.
Funzionalità principali
L'API Gemini Live offre un insieme completo di funzionalità per la creazione di agenti vocali e video robusti:
Qualità audio elevata: l'API Gemini Live offre una voce naturale e realistica in più lingue.
Supporto multilingue: comunica in 24 lingue supportate.
Interruzione: Gli utenti possono interrompere il modello in qualsiasi momento per interazioni reattive.
Dialogo empatico: Adatta lo stile e il tono della risposta in base all'espressione dell'input dell'utente.
Uso di strumenti: integra strumenti come le chiamate di funzione e la Ricerca Google per interazioni dinamiche.
Trascrizioni audio: Fornisce trascrizioni di testo sia dell'input utente che dell'output del modello. Per la trascrizione come obiettivo finale anziché come canale secondario di una conversazione, vedi Gemini 3.5 Transcribe.
Audio proattivo: consente di controllare quando e in quali contesti il modello risponde.
Specifiche tecniche
La tabella seguente descrive le specifiche tecniche dell'API Gemini Live:
| Categoria | Dettagli |
|---|---|
| Modalità di input | Audio (audio PCM a 16 bit non elaborato, 16 kHz, little-endian), immagini/video (JPEG 1 FPS), testo |
| Modalità di output | Audio (audio PCM a 16 bit non elaborato, 24 kHz, little-endian), testo |
| Video (avatar in tempo reale) | Video (mp4) |
| Protocollo | Connessione WebSocket con stato (WSS) |
Modelli supportati
I seguenti modelli supportano l'API Gemini Live. Seleziona il modello appropriato in base ai requisiti di interazione.
| ID modello | Disponibilità | Caso d'uso | Funzionalità principali |
|---|---|---|---|
gemini-3.8-live |
Disponibilità generale | Opzione consigliata. Agenti vocali a bassa latenza. Supporta il passaggio multilingue senza interruzioni. |
|
gemini-live-2.5-flash-native-audio |
Disponibilità generale | Opzione consigliata. Agenti vocali a bassa latenza. Supporta il passaggio multilingue senza interruzioni e il tono emotivo. |
|
gemini-3.5-transcribe-live-preview |
Anteprima | Solo conversione della voce in testo. Sottotitoli codificati in tempo reale, dettatura e trascrizione delle chiamate. Restituisce testo, non audio, quindi non può sostenere una conversazione. |
|
Inizia
Seleziona la guida che corrisponde al tuo ambiente di sviluppo:
Tutorial sull'SDK Gen AI
Connettiti all'API Gemini Live utilizzando l'SDK Gen AI per creare un'applicazione multimodale in tempo reale con un backend Python.
Tutorial su WebSocket
Connettiti all'API Gemini Live utilizzando WebSockets per creare un'applicazione multimodale in tempo reale con un frontend JavaScript e un backend Python.
Tutorial ADK
Crea un agente e utilizza lo streaming dell'Agent Development Kit (ADK) per attivare la comunicazione vocale e video.
Integrazioni con i partner
Se vuoi eseguire l'integrazione con alcuni dei nostri partner, queste piattaforme hanno già integrato l'API Gemini Live tramite il protocollo WebRTC per semplificare lo sviluppo di applicazioni audio e video in tempo reale.
Architettura di riferimento di LiveKit e ADK
Per gli assistenti vocali avanzati di livello di produzione che richiedono un'orchestrazione sofisticata delle sessioni, il routing e la delega multi-agente, puoi creare un'integrazione bidirezionale a bassa latenza utilizzando LiveKit (WebRTC) con l'API Gemini Live tramite Agent Development Kit (ADK).
Questa architettura ti consente di eseguire il deployment di un agente Orchestrator che gestisce l'interazione iniziale con il cliente e indirizza dinamicamente le richieste a subagenti specializzati (ad esempio, delegando il contesto a un agente di prenotazione di voli o hotel utilizzando l'orchestrazione transferAgent).
Per esplorare e implementare questo progetto di riferimento, consulta l'implementazione ufficiale del codebase di riferimento su GitHub.