


El modelo de incorporaciones multimodales genera vectores multidimensionales según la entrada que proporcionas, que puede incluir una combinación de datos de imagen, texto y video. Los vectores de incorporación se pueden usar para tareas posteriores como la clasificación de imágenes o la moderación de contenido de video.
Los vectores de incorporación de imágenes y texto se encuentran en el mismo espacio semántico con la misma dimensionalidad. En consecuencia, estos vectores se pueden usar indistintamente para los casos de uso como la búsqueda de imágenes por texto o de videos por imagen.
Para los casos de uso de embedding de texto, recomendamos usar la API de embedding de texto de Gemini Enterprise Agent Platform. Por ejemplo, la API de incorporación de texto podría ser mejor para la búsqueda semántica basada en texto, el agrupamiento en clústeres, el análisis de documentos de formato largo y otros casos de uso de recuperación de texto o búsqueda de respuestas. Para obtener más información, consulta Obtén incorporaciones de texto.
Modelos compatibles
Puedes obtener incorporaciones multimodales con los siguientes modelos:
gemini-embedding-2multimodalembedding@001
Prácticas recomendadas
Ten en cuenta los siguientes aspectos de entrada cuando uses el modelo de incorporaciones multimodales:
- Texto en imágenes: el modelo puede distinguir texto en imágenes, de manera similar al reconocimiento óptico de caracteres (OCR). Si necesitas distinguir entre una descripción del contenido de la imagen y el texto dentro de una imagen, considera usar la ingeniería de instrucciones para especificar el contenido de destino.
Por ejemplo, en lugar de solo “gato”, especifica “imagen de un gato” o “el texto gato”, según tu caso de uso.
el texto "gato"
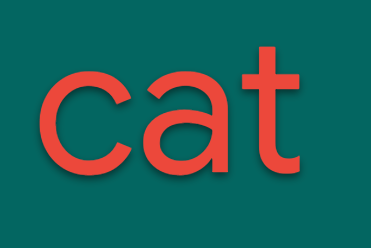
La palabra "gato" renderizada en una fuente grande y en negrita.
foto de un gato
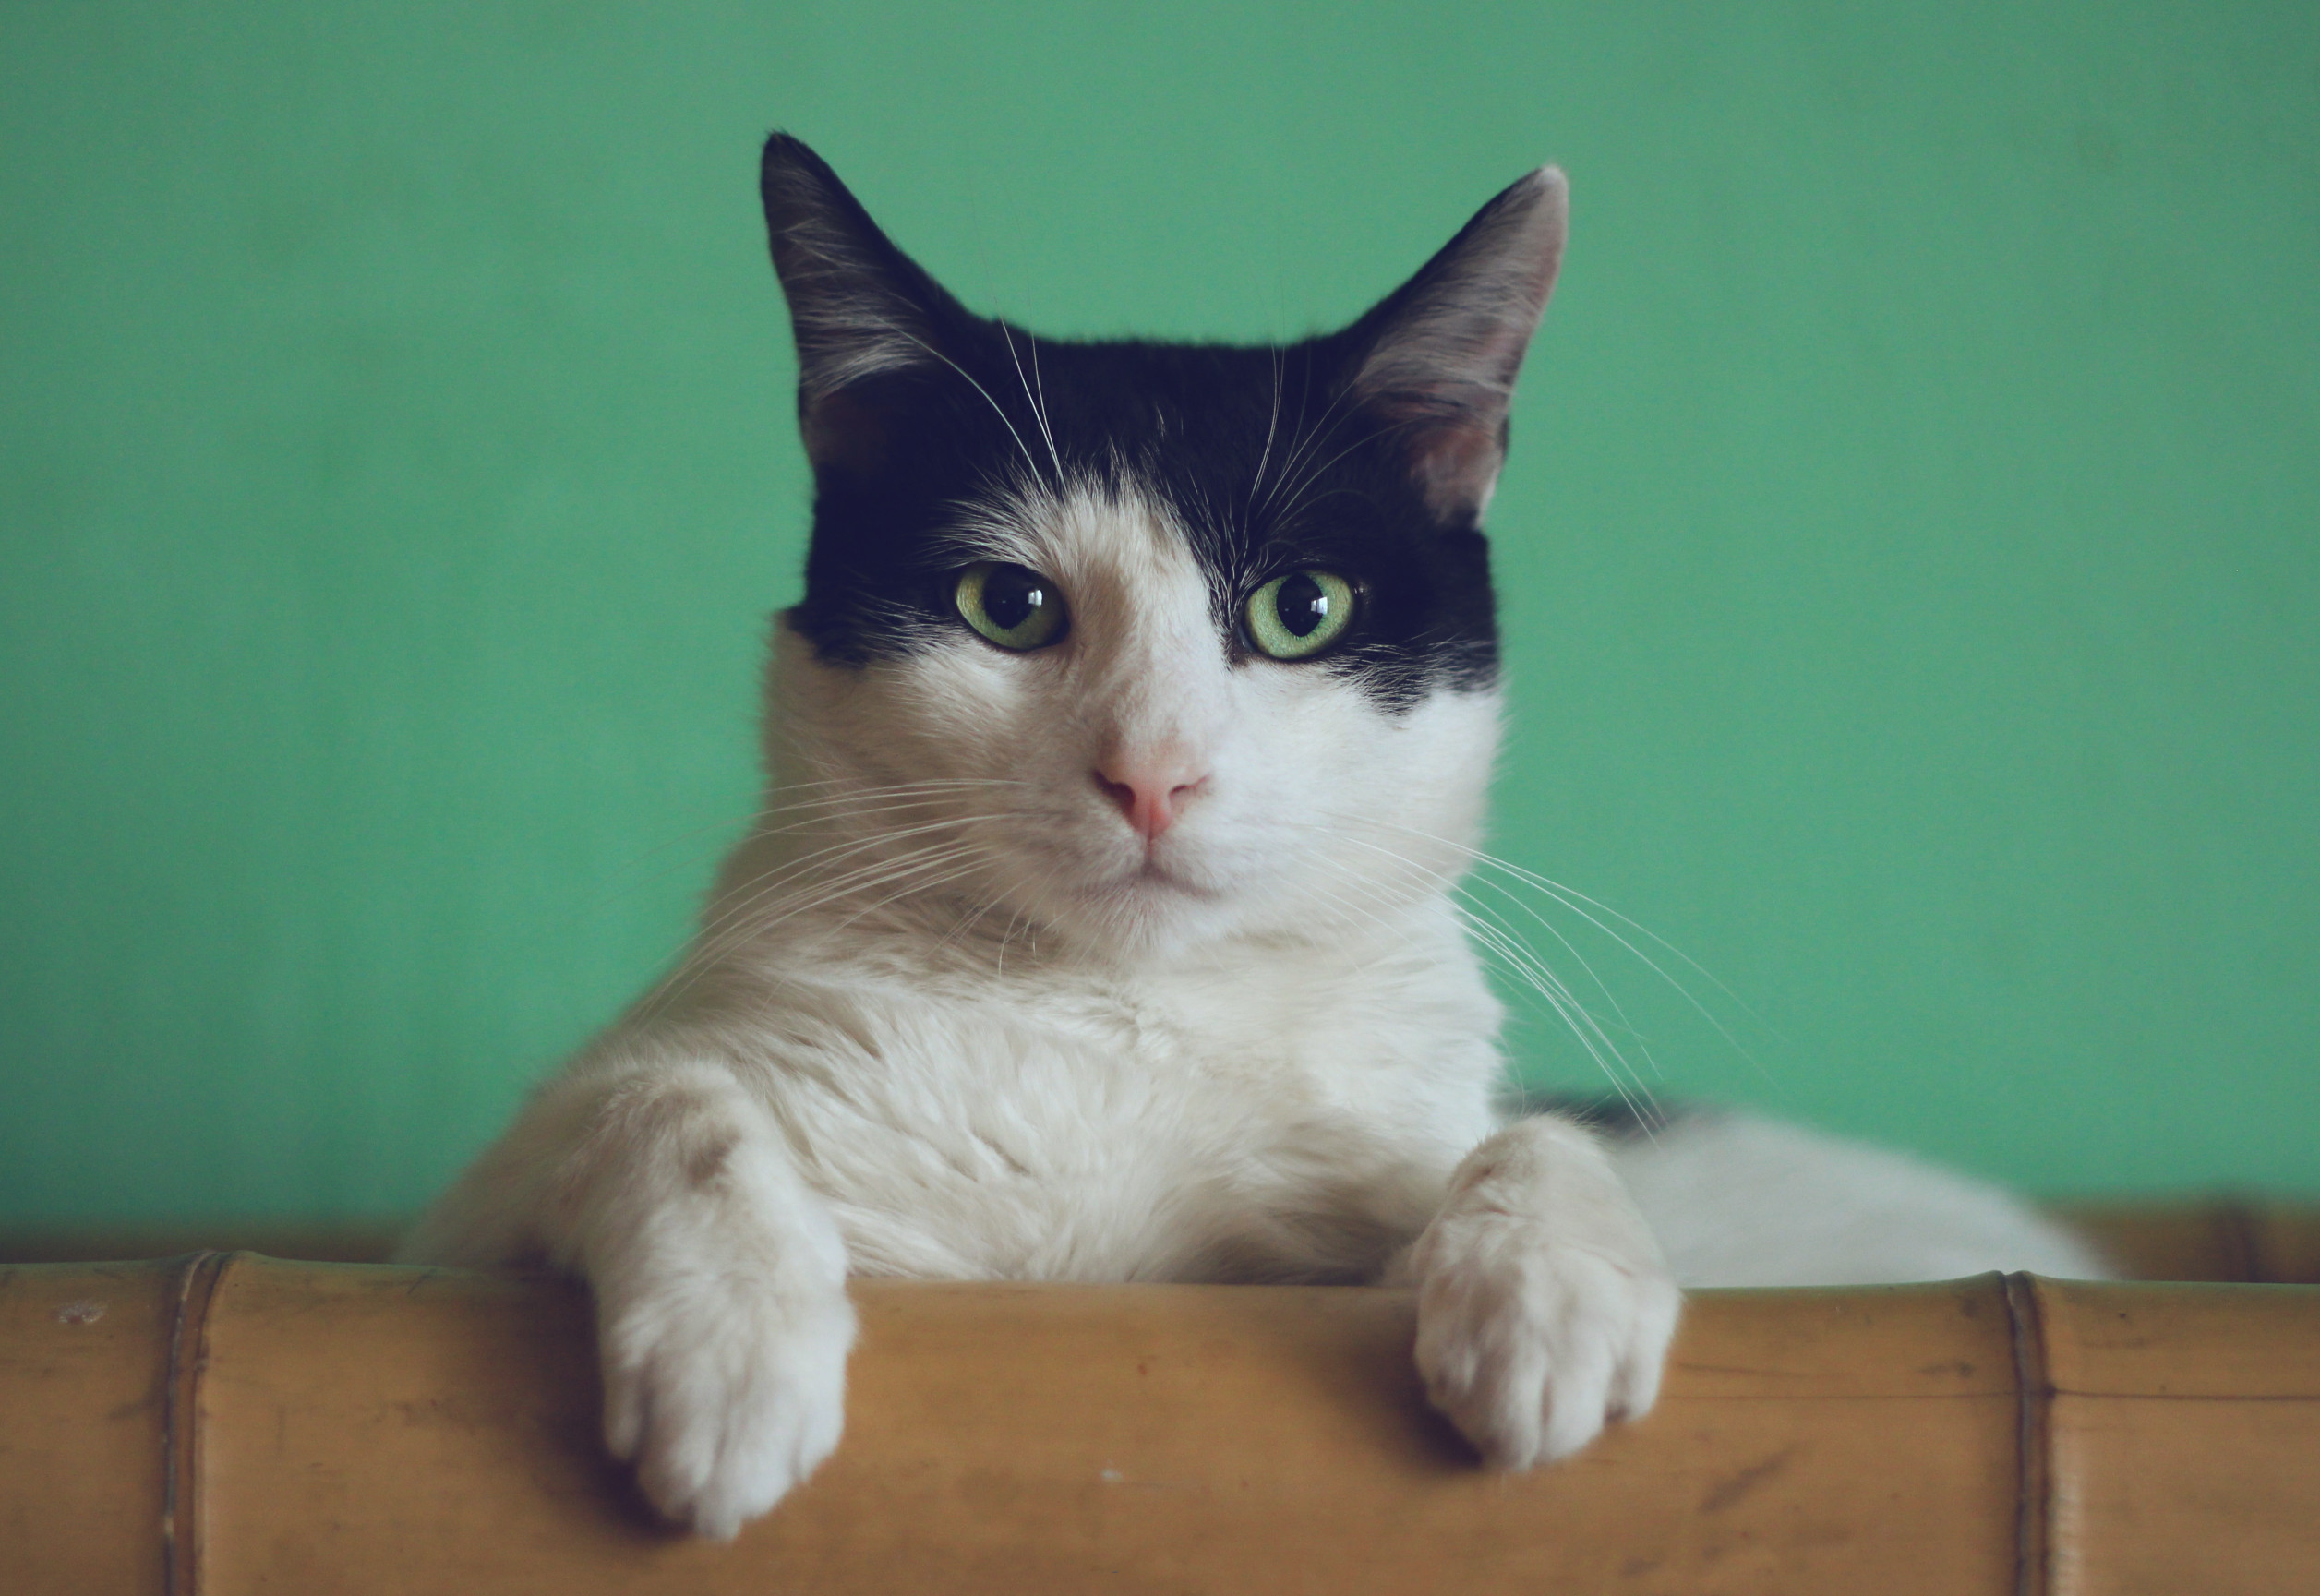
Crédito de la imagen: Manja Vitolic en Unsplash. - Similitudes de incorporación: el producto escalar de las incorporaciones no es una probabilidad calibrada. El producto escalar es una métrica de similitud y puede tener diferentes distribuciones de puntuación para diferentes casos de uso. Por lo tanto, evita usar un umbral de valor fijo para medir la calidad. En su lugar, usa enfoques de clasificación para la recuperación o usa sigmoide para la clasificación.
Utilizar gemini-embedding-2
El modelo gemini-embedding-2 acepta entradas intercaladas en las modalidades de imagen, texto, documento, audio y video.
Especifica instrucciones de tareas para mejorar el rendimiento
Puedes usar incorporaciones para una amplia variedad de tareas, desde la clasificación hasta la búsqueda de documentos. Especificar la instrucción de tarea correcta ayuda a optimizar las incorporaciones para las relaciones deseadas, lo que maximiza la precisión y la eficiencia.
En las siguientes tablas, se muestran ejemplos de cómo dar formato a las búsquedas y los documentos para casos de uso simétricos y asimétricos con el modelo gemini-embedding-2.
Casos de uso de recuperación (formato asimétrico)
| Caso de uso | Estructura de la consulta | Estructura del documento |
|---|---|---|
| Búsqueda | task: search result | query: {content} |
title: {title} | text: {content}Si no hay título, usa title: none. |
| Búsqueda de respuestas | task: question answering | query: {content} |
title: {title} | text: {content} |
| Verificación de datos | task: fact checking | query: {content} |
title: {title} | text: {content} |
| Recuperación de código | task: code retrieval | query: {content} |
title: {title} | text: {content} |
Casos de uso de entrada única (formato simétrico)
| Caso de uso | Estructura de entrada |
|---|---|
| Clasificación | task: classification | query: {content} |
| Agrupamiento en clústeres | task: clustering | query: {content} |
| Similitud semántica | task: sentence similarity | query: {content}No uses este método para la búsqueda o la recuperación. Está diseñado para la similitud textual semántica. |
Ejemplo de uso en Python
Python
# Generate embedding for a search query
def prepare_query(query):
    return f"task: search result | query: {query}"

# Generate embedding for a search document
def prepare_document(content, title=None):
    if title is None:
        title = "none"
    return f"title: {title} | text: {content}"

# Generate embedding for classification
def prepare_classification_input(content):
    return f"task: classification | query: {content}"
Uso de la API
Límites de API
Se aplican los siguientes límites cuando usas el modelo gemini-embedding-2.
| Límite | Valor y descripción |
|---|---|
| Datos de texto, imagen, documento, video y audio | |
| Límite de tokens de entrada | 8,192 tokens Las entradas que superen los 8,192 tokens se truncarán de forma silenciosa. Todas las modalidades comparten la ventana de contexto total de 8,192 tokens. Los tokens se cuentan de la siguiente manera por modalidad:
|
| Dimensionalidad de la salida | 3072 (valor predeterminado, se puede configurar con el parámetro output_dimensionality) |
| Límites de imágenes | 6 imágenes por solicitud |
| Formatos de imagen | JPEG, PNG, WebP, BMP, HEIC, HEIF, AVIF |
| Dimensiones de la imagen | Máximo de 16,384 × 16,384 píxeles por imagen |
| Límites de documentos | 1 archivo por solicitud, hasta 6 páginas Te recomendamos que uses 1 página por PDF para obtener la mejor calidad. |
| Formatos de documentos | |
| Datos de audio y video | |
| Límites de video | 1 video por solicitud, hasta 120 fotogramas El límite de 120 segundos se basa en el parámetro de configuración predeterminado de 1 FPS. La duración varía cuando configuras diferentes FPS: Duración = 120 / FPS. De forma predeterminada, la extracción de audio está inhabilitada para el video. Cuando se habilita la opción de extracción de pistas de audio, la duración está sujeta a la duración máxima de audio de 180 segundos, y la duración total del video está limitada tanto por el límite de audio como por la ventana de contexto de tokens (8,192 tokens). |
| Formatos de video | Contenedor: MOV o MP4 Códec: AV1, H264, H265 y VP9. |
| Límites de audio | 180 segundos por solicitud La compatibilidad con audio está optimizada para el habla. Es posible que el sonido y la música ambientales no se reproduzcan con la mejor calidad. |
| Formatos de audio | MP3 y WAV |
Duración del video con extracción de audio
Dado que todas las modalidades comparten la ventana de contexto total de 8,192 tokens, la duración máxima del video varía cuando habilitas audio_track_extraction:
| Modalidad | Recuento de tokens |
|---|---|
| Audio | 25 tokens por segundo |
| Fotograma | 66 tokens por fotograma |
| Marcas de tiempo | 10 tokens por segundo (dos marcas de tiempo por segundo con el formato "mm:ss") |
| FPS | Se determina según el parámetro de configuración de FPS (el valor predeterminado es 1). |
La duración total del video está limitada tanto por la compatibilidad de audio de 180 segundos como por la ventana de contexto de 8,192 tokens.
Ejemplo de cálculo:
Si procesas un video con una frecuencia de muestreo predeterminada de 1 FPS y habilitas la extracción de audio, sucederá lo siguiente:
- Tasa de consumo: Cada segundo de video consume 66 tokens (1 fotograma) + 25 tokens (1 segundo de audio) + 10 tokens (marcas de tiempo) = 101 tokens.
- Duración máxima: Con un límite de 8,192 tokens, la duración máxima es de aproximadamente 8192 / 101 ≈ 81 segundos.
Si la entrada excede la ventana de contexto, la parte excedida se truncará de forma silenciosa.
Obtén incorporaciones multimodales
REST
PROJECT_ID="YOUR_PROJECT_ID"
LOCATION="us"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://aiplatform.${LOCATION}.rep.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/publishers/google/models/gemini-embedding-2:embedContent" \
  -d '{
  "content": {
    "parts": [
      {
        "text": "Whats this"
      },
      {
        "file_data": {
          "mime_type": "video/mp4",
          "file_uri": "gs://cloud-samples-data/generative-ai/video/pixel8.mp4"
        }
      }
    ]
  }
}'
Python
from google import genai
from google.genai import types

# Initialize the client.
client = genai.Client(vertexai=True, project="YOUR_PROJECT_ID", location="us")

content = types.Content(
    parts=[
        types.Part.from_text(text="Audio AI"),
        types.Part.from_uri(
            file_uri="gs://cloud-samples-data/generative-ai/audio/Chirp-3-Docs-Dive.mp3",
            mime_type="audio/mpeg",
        ),
    ],
)

response = client.models.embed_content(
    model="gemini-embedding-2",
    contents=[content]
)

print(response.embeddings[0].values)
Ubicaciones
Una ubicación es una región que puedes especificar en una solicitud para controlar dónde se almacenan los datos en reposo. Para obtener una lista de las regiones disponibles, consulta Ubicaciones de Agent Platform.
Cuotas
Para consultar el límite de cuota de gemini-embedding-2, consulta Cuotas y límites del sistema de la IA generativa en Gemini Enterprise Agent Platform.
Dimensiones
Cuando usas el modelo gemini-embedding-2, puedes especificar dimensiones más bajas con el parámetro output_dimensionality en EmbedContentConfig.
En el siguiente ejemplo, se muestra un vector de 128 dimensiones. En el caso de gemini-embedding-2, los embeddings de salida ya están normalizados según la norma L2 para las dimensiones no predeterminadas (a diferencia de gemini-embedding-001).
Python
import numpy as np
from google import genai
from google.genai import types

# Initialize the client.
client = genai.Client(vertexai=True, project="YOUR_PROJECT_ID", location="us")

content = types.Content(
    parts=[
        types.Part.from_uri(
            file_uri="gs://cloud-samples-data/generative-ai/audio/Chirp-3-Docs-Dive.mp3",
            mime_type="audio/mpeg",
        ),
    ],
)

response = client.models.embed_content(
    model="gemini-embedding-2",
    contents=[content],
    config=types.EmbedContentConfig(output_dimensionality=128),
)

embedding_values_np = np.array(response.embeddings[0].values)

print(f"Embedding length: {len(embedding_values_np)}")
print(f"Norm of embedding: {np.linalg.norm(embedding_values_np):.6f}") # Should be very close to 1
Parámetros
La frecuencia de muestreo de video predeterminada es de 1 fotograma por segundo (FPS). Se pueden agregar parámetros adicionales con video_metadata:
Python
from google import genai
from google.genai import types

# Initialize the client.
client = genai.Client(vertexai=True, project="YOUR_PROJECT_ID", location="us")

content = types.Content(
    parts=[
        types.Part(
            file_data=types.FileData(
                file_uri="gs://cloud-samples-data/generative-ai/video/pixel8.mp4",
                mime_type="video/mp4",
            ),
            video_metadata=types.VideoMetadata(
                fps=0.5,
                start_offset="10s",
                end_offset="20s",
            ),
        ),
    ]
)

response = client.models.embed_content(
    model="gemini-embedding-2",
    contents=[content]
)

print(response.embeddings[0].values)
Hay opciones adicionales en EmbedContentConfig.
| Opción | Tipo | Descripción |
|---|---|---|
output_dimensionality |
int |
Reduce la dimensionalidad del embedding de salida. |
document_ocr |
bool |
Habilita el OCR para la entrada de documentos. |
audio_track_extraction |
bool |
Extrae el audio de la entrada de video. |
Utilizar multimodalembedding@001
Se aplican los siguientes límites cuando usas el modelo multimodalembedding@001 para las incorporaciones de imagen y texto:
| Límite | Valor y descripción |
|---|---|
| Datos de imágenes y texto | |
| Cantidad máxima de solicitudes a la API por minuto y por proyecto | De 120 a 600, según la región |
| Longitud máxima de texto | 32 tokens (~32 palabras) La longitud máxima de texto es de 32 tokens (aproximadamente 32 palabras). Si la entrada supera los 32 tokens, el modelo acorta de forma interna la entrada a esta longitud. |
| Idioma | Inglés |
| Formatos de imagen | BMP, GIF, JPG, PNG |
| Tamaño de la imagen | Imágenes codificadas en base64: 20 MB (cuando se transcodifica a PNG) Imágenes de Cloud Storage: 20 MB (formato de archivo original) El tamaño máximo de imagen aceptado es de 20 MB. Para evitar una mayor latencia de red, usa imágenes más pequeñas. Además, el modelo cambia el tamaño de las imágenes a una resolución de 512 x 512 píxeles. Por lo tanto, no necesitas proporcionar imágenes de mayor resolución. |
| Datos de video | |
| Audio compatible | N/A: El modelo no tiene en cuenta el contenido de audio cuando genera incorporaciones de video |
| Formatos de video | AVI, FLV, MKV, MOV, MP4, MPEG, MPG, WEBM y WMV |
| Duración máxima del video (Cloud Storage) | Sin límites. Sin embargo, solo se pueden analizar dos minutos de contenido a la vez. |
Antes de comenzar
- Accede a tu cuenta de Google Cloud . Si eres nuevo en Google Cloud, crea una cuenta para evaluar el rendimiento de nuestros productos en situaciones reales. Los clientes nuevos también obtienen $300 en créditos gratuitos para ejecutar, probar y, además, implementar cargas de trabajo.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Gemini Enterprise Agent Platform API.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Gemini Enterprise Agent Platform API.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Configura la autenticación para tu entorno.
Selecciona la pestaña que corresponda a la forma en que planeas usar las muestras de esta página:
Java
Para usar las muestras de Java de esta página en un entorno de desarrollo local, instala e inicializa la gcloud CLI y, luego, configura las credenciales predeterminadas de la aplicación con tus credenciales de usuario.
-
Instala Google Cloud CLI.
-
Si usas un proveedor de identidad (IdP) externo, primero debes acceder a gcloud CLI con tu identidad federada.
-
Después de inicializar gcloud CLI, actualízala y, luego, instala los componentes necesarios:
gcloud components update
gcloud components install beta
-
Si usas una shell local, crea credenciales de autenticación locales para tu cuenta de usuario:
gcloud auth application-default login
No es necesario que lo hagas si usas Cloud Shell.
Si se devuelve un error de autenticación y usas un proveedor de identidad (IdP) externo, confirma que accediste a la gcloud CLI con tu identidad federada.
Para obtener más información, consulta Configura ADC para un entorno de desarrollo local en la documentación de autenticación de Google Cloud .
Node.js
Para usar las muestras de Node.js de esta página en un entorno de desarrollo local, instala e inicializa la gcloud CLI y, luego, configura las credenciales predeterminadas de la aplicación con tus credenciales de usuario.
-
Instala Google Cloud CLI.
-
Si usas un proveedor de identidad (IdP) externo, primero debes acceder a gcloud CLI con tu identidad federada.
-
Después de inicializar gcloud CLI, actualízala y, luego, instala los componentes necesarios:
gcloud components update
gcloud components install beta
-
Si usas una shell local, crea credenciales de autenticación locales para tu cuenta de usuario:
gcloud auth application-default login
No es necesario que lo hagas si usas Cloud Shell.
Si se devuelve un error de autenticación y usas un proveedor de identidad (IdP) externo, confirma que accediste a la gcloud CLI con tu identidad federada.
Para obtener más información, consulta Configura ADC para un entorno de desarrollo local en la documentación de autenticación de Google Cloud .
Python
Para usar las muestras de Python de esta página en un entorno de desarrollo local, instala e inicializa la gcloud CLI y, luego, configura las credenciales predeterminadas de la aplicación con tus credenciales de usuario.
-
Instala Google Cloud CLI.
-
Si usas un proveedor de identidad (IdP) externo, primero debes acceder a gcloud CLI con tu identidad federada.
-
Después de inicializar gcloud CLI, actualízala y, luego, instala los componentes necesarios:
gcloud components update
gcloud components install beta
-
Si usas una shell local, crea credenciales de autenticación locales para tu cuenta de usuario:
gcloud auth application-default login
No es necesario que lo hagas si usas Cloud Shell.
Si se devuelve un error de autenticación y usas un proveedor de identidad (IdP) externo, confirma que accediste a la gcloud CLI con tu identidad federada.
Para obtener más información, consulta Configura ADC para un entorno de desarrollo local en la documentación de autenticación de Google Cloud .
REST
Para usar las muestras de la API de REST incluidas en esta página en un entorno de desarrollo local, debes usar las credenciales que proporciones a la gcloud CLI.
-
Instala Google Cloud CLI.
-
Si usas un proveedor de identidad (IdP) externo, primero debes acceder a gcloud CLI con tu identidad federada.
-
Después de inicializar gcloud CLI, actualízala y, luego, instala los componentes necesarios:
gcloud components update
gcloud components install beta
Para obtener más información, consulta Autentícate para usar REST en la documentación de autenticación de Google Cloud .
-
- Si deseas usar el SDK de Python, sigue las instrucciones en Instala el SDK de Agent Platform para Python. Si deseas obtener más información, consulta la documentación de referencia de la API de Python del SDK de Agent Platform.
- Es opcional. Revisa los precios de esta función. Los precios de las incorporaciones dependen del tipo de datos que envíes (como imagen o texto), y también dependen del modo que uses para ciertos tipos de datos (como Video Plus, Video Standard o Video Essential).
Ubicaciones
Una ubicación es una región que puedes especificar en una solicitud para controlar dónde se almacenan los datos en reposo. Para obtener una lista de las regiones disponibles, consulta Ubicaciones de Agent Platform.
Mensajes de error
En esta sección, se describen los mensajes de error comunes que puedes encontrar.
Error de cuota excedida
google.api_core.exceptions.ResourceExhausted: 429 Quota exceeded for
aiplatform.googleapis.com/online_prediction_requests_per_base_model with base
model: multimodalembedding. Please submit a quota increase request.
Si es la primera vez que recibes este error, usa la consola de Google Cloud para solicitar un ajuste de cuota para tu proyecto. Usa los siguientes filtros antes de solicitar el ajuste:
Service ID: aiplatform.googleapis.commetric: aiplatform.googleapis.com/online_prediction_requests_per_base_modelbase_model:multimodalembedding
Si ya enviaste una solicitud de ajuste de cuota, espera antes de enviar otra solicitud. Si necesitas aumentar aún más la cuota, repite la solicitud de ajuste de cuota con tu justificación para un ajuste de cuota sostenido.
Cómo especificar embeddings de menor dimensión
Según el modelo que se use, una solicitud de incorporación devuelve un vector de números de punto flotante de 1,408 o de 3,072. Puedes especificar embeddings de menor dimensión para los datos de texto y de imagen para optimizar la latencia y el almacenamiento, o la calidad. Los embeddings de menor dimensión reducen las necesidades de almacenamiento y proporcionan una latencia más baja para las tareas de embedding posteriores (como la búsqueda o la recomendación). Los embeddings de dimensiones más altas ofrecen mayor precisión para estas tareas, pero con mayores necesidades de almacenamiento y mayor latencia.
En la siguiente tabla, se ilustran las dimensiones inferiores predeterminadas y disponibles para cada modelo:
| Modelo | Dimensiones predeterminadas (prioridad más alta) | Dimensiones admitidas (rango) | Dimensiones inferiores recomendadas |
|---|---|---|---|
gemini-embedding-2 |
3072 | De 128 a 3,072 | 128, 768 o 1536 |
multimodalembedding@001 |
1408 | 128 a 1408 | 128, 256 o 512 |
Usa los siguientes ejemplos para generar incorporaciones con dimensiones más bajas:
REST
Se puede acceder a dimensiones más bajas agregando el campo parameters.dimension.
El parámetro acepta cualquiera de los valores de dimensión disponibles para el modelo.
Por ejemplo, puedes especificar 128, 256, 512 o 1408 cuando usas el modelo multimodalembedding@001. La respuesta incluye la incorporación de la dimensión especificada.
Antes de usar cualquiera de los datos de solicitud a continuación, realiza los siguientes reemplazos:
- PROJECT_ID: Tu Google Cloud ID del proyecto.
-
IMAGE_URI: Es el URI de Cloud Storage de la imagen objetivo para la que se obtendrán embeddings. Por ejemplo,
gs://my-bucket/embeddings/supermarket-img.png.También puedes proporcionar la imagen como una cadena de bytes codificada en Base64:
[...] "image": { "bytesBase64Encoded": "B64_ENCODED_IMAGE" } [...] -
TEXT: El texto de destino para el que se obtendrán las incorporaciones. Por ejemplo,
a cat -
EMBEDDING_DIMENSION: Es la cantidad de dimensiones del embedding. Los valores más bajos ofrecen una latencia menor cuando se usan estas incorporaciones para tareas posteriores, mientras que los valores más altos ofrecen una mejor precisión. Valores disponibles:
128,256,512y1408(predeterminado).
Método HTTP y URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict
Cuerpo JSON de la solicitud:
{
  "instances": [
    {
      "image": {
        "gcsUri": "IMAGE_URI"
      },
      "text": "TEXT"
    }
  ],
  "parameters": {
    "dimension": EMBEDDING_DIMENSION
  }
}
Para enviar tu solicitud, elige una de estas opciones:
curl
Guarda el cuerpo de la solicitud en un archivo llamado request.json y ejecuta el siguiente comando:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict"
PowerShell
Guarda el cuerpo de la solicitud en un archivo llamado request.json y ejecuta el siguiente comando:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict" | Select-Object -Expand Content
128 dimensiones:
{
  "predictions": [
    {
      "imageEmbedding": [
        0.0279239565,
        [...128 dimension vector...]
        0.00403284049
      ],
      "textEmbedding": [
        0.202921599,
        [...128 dimension vector...]
        -0.0365431122
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
256 dimensiones:
{
  "predictions": [
    {
      "imageEmbedding": [
        0.248620048,
        [...256 dimension vector...]
        -0.0646447465
      ],
      "textEmbedding": [
        0.0757875815,
        [...256 dimension vector...]
        -0.02749932
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
512 dimensiones:
{
  "predictions": [
    {
      "imageEmbedding": [
        -0.0523675755,
        [...512 dimension vector...]
        -0.0444030389
      ],
      "textEmbedding": [
        -0.0592851527,
        [...512 dimension vector...]
        0.0350437127
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Python
Go
Obtén embeddings de imagen y texto (multimodalembedding@001)
Usa las siguientes muestras de código para enviar una solicitud de incorporación con datos de imagen y texto. En los ejemplos, se muestra cómo enviar una solicitud con ambos tipos de datos, pero también puedes usar el servicio con un tipo de datos individual.
Obtén incorporaciones de imagen y texto
REST
Antes de usar cualquiera de los datos de solicitud a continuación, realiza los siguientes reemplazos:
- PROJECT_ID: Tu Google Cloud ID del proyecto.
-
TEXT: El texto de destino para el que se obtendrán las incorporaciones. Por ejemplo,
a cat - B64_ENCODED_IMG: la imagen de destino para la que se obtendrán incorporaciones. La imagen debe especificarse como una cadena de bytes codificada en base64.
Método HTTP y URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict
Cuerpo JSON de la solicitud:
{
  "instances": [
    {
      "text": "TEXT",
      "image": {
        "bytesBase64Encoded": "B64_ENCODED_IMG"
      }
    }
  ]
}
Para enviar tu solicitud, elige una de estas opciones:
curl
Guarda el cuerpo de la solicitud en un archivo llamado request.json y ejecuta el siguiente comando:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict"
PowerShell
Guarda el cuerpo de la solicitud en un archivo llamado request.json y ejecuta el siguiente comando:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict" | Select-Object -Expand Content
{
  "predictions": [
    {
      "textEmbedding": [
        0.010477379,
        -0.00399621,
        0.00576670747,
        [...]
        -0.00823613815,
        -0.0169572588,
        -0.00472954148
      ],
      "imageEmbedding": [
        0.00262696808,
        -0.00198890246,
        0.0152047109,
        -0.0103145819,
        [...]
        0.0324628279,
        0.0284924973,
        0.011650892,
        -0.00452344026
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Python
Si deseas obtener información para instalar o actualizar el SDK de Vertex AI para Python, consulta Instala el SDK de Vertex AI para Python. Para obtener más información, consulta la documentación de referencia de la API de Python.
Node.js
Antes de probar este ejemplo, sigue las instrucciones de configuración para Node.js que encontrarás en la guía de inicio rápido de Agent Platform sobre el uso de bibliotecas cliente. Para obtener más información, consulta la documentación de referencia de la API de Agent Platform Node.js.
Para autenticarte en Agent Platform, configura las credenciales predeterminadas de la aplicación. Para obtener más información, consulta Configura la autenticación para un entorno de desarrollo local.
Java
Antes de probar este ejemplo, sigue las instrucciones de configuración para Java que encontrarás en la guía de inicio rápido de Agent Platform sobre el uso de bibliotecas cliente. Para obtener más información, consulta la documentación de referencia de la API de Agent Platform Java.
Para autenticarte en Agent Platform, configura las credenciales predeterminadas de la aplicación. Para obtener más información, consulta Configura la autenticación para un entorno de desarrollo local.
Go
Antes de probar este ejemplo, sigue las instrucciones de configuración para Go que encontrarás en la guía de inicio rápido de Agent Platform sobre el uso de bibliotecas cliente. Para obtener más información, consulta la documentación de referencia de la API de Agent Platform Go.
Para autenticarte en Agent Platform, configura las credenciales predeterminadas de la aplicación. Para obtener más información, consulta Configura la autenticación para un entorno de desarrollo local.
Obtén embeddings de video, imagen o texto (multimodalembedding@001)
Cuando envías una solicitud de incorporación, puedes especificar solo un video de entrada o puedes especificar una combinación de datos de video, imágenes y texto.
Modos de incorporaciones de video
Existen tres modos que puedes usar con incorporaciones de video: Essential, Standard o
Plus. El modo corresponde a la densidad de las incorporaciones generadas, que se
puede especificar con la configuración interval_sec en la solicitud. Para cada intervalo
de video con duración interval_sec, se genera una incorporación. La duración mínima
del intervalo de video es de 4 segundos. Los intervalos superiores a 120 segundos
pueden afectar de forma negativa la calidad de las incorporaciones generadas.
Los precios de las incorporaciones de videos dependen del modo que uses. Para obtener más información, consulta Precios.
En la siguiente tabla, se resumen los tres modos que puedes usar para las incorporaciones de video:
| Modo | Cantidad máxima de incorporaciones por minuto | Intervalo de incorporación de video (valor mínimo) |
|---|---|---|
| Esencial | 4 | 15 Esto corresponde a: intervalSec >= 15 |
| Estándar | 8 | 8 Esto corresponde a: 8 <= intervalSec < 15 |
| Plus | 15 | 4 Esto corresponde a: 4 <= intervalSec < 8 |
Prácticas recomendadas para las incorporaciones de video
Ten en cuenta lo siguiente cuando envíes solicitudes de incorporación de video:
Para generar una sola incorporación durante los dos primeros minutos de un video de entrada de cualquier duración, usa la siguiente configuración
videoSegmentConfig:request.json:// other request body content "videoSegmentConfig": { "intervalSec": 120 } // other request body contentPara generar incorporaciones de video con una duración superior a dos minutos, puedes enviar varias solicitudes que especifiquen las horas de inicio y finalización en
videoSegmentConfig:request1.json:// other request body content "videoSegmentConfig": { "startOffsetSec": 0, "endOffsetSec": 120 } // other request body contentrequest2.json:// other request body content "videoSegmentConfig": { "startOffsetSec": 120, "endOffsetSec": 240 } // other request body contentObtén incorporaciones de video
Usa el siguiente ejemplo para obtener incorporaciones para contenido de video solamente.
REST
En el siguiente ejemplo, se usa un video ubicado en Cloud Storage. También puedes usar el campo video.bytesBase64Encoded para proporcionar una representación de string codificada en base64 del video.
Antes de usar cualquiera de los datos de solicitud a continuación, realiza los siguientes reemplazos:
- PROJECT_ID: Tu Google Cloud ID del proyecto.
-
VIDEO_URI: Es el URI de Cloud Storage del video objetivo del que deseas obtener los embeddings. Por ejemplo,
gs://my-bucket/embeddings/supermarket-video.mp4.También puedes proporcionar el video como una cadena de bytes codificada en Base64:
[...] "video": { "bytesBase64Encoded": "B64_ENCODED_VIDEO" } [...] -
videoSegmentConfig(START_SECOND, END_SECOND, INTERVAL_SECONDS). Opcional. Son los segmentos de video específicos (en segundos) para los que se generan las incorporaciones.Por ejemplo:
[...]
"videoSegmentConfig": {
  "startOffsetSec": 10,
  "endOffsetSec": 60,
  "intervalSec": 10
}
[...]
El uso de esta configuración especifica los datos de video de 10 a 60 segundos y genera incorporaciones para los siguientes intervalos de video de 10 segundos: [10, 20), [20, 30), [30, 40), [40, 50), [50, 60). Este intervalo de video (
"intervalSec": 10) se encuentra en el modo de incorporación de video Standard, y se te cobra la tarifa del modo Standard.Si omites
videoSegmentConfig, el servicio usa los siguientes valores predeterminados:"videoSegmentConfig": { "startOffsetSec": 0, "endOffsetSec": 120, "intervalSec": 16 }. Este intervalo de video ("intervalSec": 16) se encuentra en el modo de incorporación de video Essential, y se le cobra al usuario la tarifa del modo Essential.
Método HTTP y URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict
Cuerpo JSON de la solicitud:
{
  "instances": [
    {
      "video": {
        "gcsUri": "VIDEO_URI",
        "videoSegmentConfig": {
          "startOffsetSec": START_SECOND,
          "endOffsetSec": END_SECOND,
          "intervalSec": INTERVAL_SECONDS
        }
      }
    }
  ]
}
Para enviar tu solicitud, elige una de estas opciones:
curl
Guarda el cuerpo de la solicitud en un archivo llamado request.json y ejecuta el siguiente comando:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict"
PowerShell
Guarda el cuerpo de la solicitud en un archivo llamado request.json y ejecuta el siguiente comando:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict" | Select-Object -Expand Content
Respuesta (7 segundos de video, sin videoSegmentConfig especificada):
{
  "predictions": [
    {
      "videoEmbeddings": [
        {
          "endOffsetSec": 7,
          "embedding": [
            -0.0045467657,
            0.0258095954,
            0.0146885719,
            0.00945400633,
            [...]
            -0.0023291884,
            -0.00493789,
            0.00975185353,
            0.0168156829
          ],
          "startOffsetSec": 0
        }
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Respuesta (video de 59 segundos con la siguiente configuración de segmento de video: "videoSegmentConfig": { "startOffsetSec": 0, "endOffsetSec": 60, "intervalSec": 10 }):
{
  "predictions": [
    {
      "videoEmbeddings": [
        {
          "endOffsetSec": 10,
          "startOffsetSec": 0,
          "embedding": [
            -0.00683252793,
            0.0390476175,
            [...]
            0.00657121744,
            0.013023301
          ]
        },
        {
          "startOffsetSec": 10,
          "endOffsetSec": 20,
          "embedding": [
            -0.0104404651,
            0.0357737206,
            [...]
            0.00509833824,
            0.0131902946
          ]
        },
        {
          "startOffsetSec": 20,
          "embedding": [
            -0.0113538112,
            0.0305239167,
            [...]
            -0.00195809244,
            0.00941874553
          ],
          "endOffsetSec": 30
        },
        {
          "embedding": [
            -0.00299320649,
            0.0322436653,
            [...]
            -0.00993082579,
            0.00968887936
          ],
          "startOffsetSec": 30,
          "endOffsetSec": 40
        },
        {
          "endOffsetSec": 50,
          "startOffsetSec": 40,
          "embedding": [
            -0.00591270532,
            0.0368893594,
            [...]
            -0.00219071587,
            0.0042470959
          ]
        },
        {
          "embedding": [
            -0.00458270218,
            0.0368121453,
            [...]
            -0.00317760976,
            0.00595594104
          ],
          "endOffsetSec": 59,
          "startOffsetSec": 50
        }
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Python
Si deseas obtener información para instalar o actualizar el SDK de Vertex AI para Python, consulta Instala el SDK de Vertex AI para Python. Para obtener más información, consulta la documentación de referencia de la API de Python.
Go
Antes de probar este ejemplo, sigue las instrucciones de configuración para Go que encontrarás en la guía de inicio rápido de Agent Platform sobre el uso de bibliotecas cliente. Para obtener más información, consulta la documentación de referencia de la API de Agent Platform Go.
Para autenticarte en Agent Platform, configura las credenciales predeterminadas de la aplicación. Para obtener más información, consulta Configura la autenticación para un entorno de desarrollo local.
Obtén incorporaciones de imagen, texto y video
Usa el siguiente ejemplo para obtener incorporaciones para contenido de video, texto e imagen.
REST
En el siguiente ejemplo, se usan datos de imagen, texto y video. Puedes usar cualquier combinación de estos tipos de datos en el cuerpo de tu solicitud.
Además, este ejemplo usa un video ubicado en Cloud Storage. También puedes usar el campo video.bytesBase64Encoded para proporcionar una representación de string codificada en base64 del video.
Antes de usar cualquiera de los datos de solicitud a continuación, realiza los siguientes reemplazos:
- PROJECT_ID: Tu Google Cloud ID del proyecto.
-
TEXT: El texto de destino para el que se obtendrán las incorporaciones. Por ejemplo,
a cat -
IMAGE_URI: Es el URI de Cloud Storage de la imagen objetivo para la que se obtendrán embeddings. Por ejemplo,
gs://my-bucket/embeddings/supermarket-img.png.También puedes proporcionar la imagen como una cadena de bytes codificada en Base64:
[...] "image": { "bytesBase64Encoded": "B64_ENCODED_IMAGE" } [...] -
VIDEO_URI: Es el URI de Cloud Storage del video objetivo del que deseas obtener los embeddings. Por ejemplo,
gs://my-bucket/embeddings/supermarket-video.mp4.También puedes proporcionar el video como una cadena de bytes codificada en Base64:
[...] "video": { "bytesBase64Encoded": "B64_ENCODED_VIDEO" } [...] -
videoSegmentConfig(START_SECOND, END_SECOND, INTERVAL_SECONDS). Opcional. Son los segmentos de video específicos (en segundos) para los que se generan las incorporaciones.Por ejemplo:
[...]
  "videoSegmentConfig": {
    "startOffsetSec": 10,
    "endOffsetSec": 60,
    "intervalSec": 10
  }
  [...]
El uso de esta configuración especifica los datos de video de 10 a 60 segundos y genera incorporaciones para los siguientes intervalos de video de 10 segundos: [10, 20), [20, 30), [30, 40), [40, 50), [50, 60). Este intervalo de video (
"intervalSec": 10) se encuentra en el modo de incorporación de video Standard, y se te cobra la tarifa del modo Standard.Si omites
videoSegmentConfig, el servicio usa los siguientes valores predeterminados:"videoSegmentConfig": { "startOffsetSec": 0, "endOffsetSec": 120, "intervalSec": 16 }. Este intervalo de video ("intervalSec": 16) se encuentra en el modo de incorporación de video Essential, y se le cobra al usuario la tarifa del modo Essential.
Método HTTP y URL:
POST https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict
Cuerpo JSON de la solicitud:
{
  "instances": [
    {
      "text": "TEXT",
      "image": {
        "gcsUri": "IMAGE_URI"
      },
      "video": {
        "gcsUri": "VIDEO_URI",
        "videoSegmentConfig": {
          "startOffsetSec": START_SECOND,
          "endOffsetSec": END_SECOND,
          "intervalSec": INTERVAL_SECONDS
        }
      }
    }
  ]
}
Para enviar tu solicitud, elige una de estas opciones:
curl
Guarda el cuerpo de la solicitud en un archivo llamado request.json y ejecuta el siguiente comando:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict"
PowerShell
Guarda el cuerpo de la solicitud en un archivo llamado request.json y ejecuta el siguiente comando:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION/publishers/google/models/multimodalembedding@001:predict" | Select-Object -Expand Content
{
  "predictions": [
    {
      "textEmbedding": [
        0.0105433334,
        -0.00302835181,
        0.00656806398,
        0.00603460241,
        [...]
        0.00445805816,
        0.0139605571,
        -0.00170318608,
        -0.00490092579
      ],
      "videoEmbeddings": [
        {
          "startOffsetSec": 0,
          "endOffsetSec": 7,
          "embedding": [
            -0.00673126569,
            0.0248149596,
            0.0128901172,
            0.0107588246,
            [...]
            -0.00180952181,
            -0.0054573305,
            0.0117037306,
            0.0169312079
          ]
        }
      ],
      "imageEmbedding": [
        -0.00728622358,
        0.031021487,
        -0.00206603738,
        0.0273937676,
        [...]
        -0.00204976718,
        0.00321615417,
        0.0121978866,
        0.0193375275
      ]
    }
  ],
  "deployedModelId": "DEPLOYED_MODEL_ID"
}
Python
Si deseas obtener información para instalar o actualizar el SDK de Vertex AI para Python, consulta Instala el SDK de Vertex AI para Python. Para obtener más información, consulta la documentación de referencia de la API de Python.
Go
Antes de probar este ejemplo, sigue las instrucciones de configuración para Go que encontrarás en la guía de inicio rápido de Agent Platform sobre el uso de bibliotecas cliente. Para obtener más información, consulta la documentación de referencia de la API de Agent Platform Go.
Para autenticarte en Agent Platform, configura las credenciales predeterminadas de la aplicación. Para obtener más información, consulta Configura la autenticación para un entorno de desarrollo local.
¿Qué sigue?
- Lee el blog “Qué es la búsqueda multimodal: los 'LLM con visión' cambian los negocios”.
- Para obtener información sobre casos de uso de solo texto (la búsqueda semántica basada en texto, el agrupamiento en clústeres, el análisis de documentos de formato largo y otros casos de uso de recuperación de texto o búsqueda de respuestas), lee Obtén incorporaciones de texto.
- Explora más modelos previamente entrenados en Model Garden.
- Obtén información sobre las prácticas recomendadas de IA responsable y los filtros de seguridad en Gemini Enterprise Agent Platform.