


לפני שמריצים משימת חיפוש של ארכיטקטורה עצבית ב-Agent Platform כדי לחפש מודל אופטימלי, צריך להגדיר משימת פרוקסי. Stage1-search משתמש בייצוג קטן בהרבה של אימון מודל מלא, שבדרך כלל מסתיים תוך שעתיים. הייצוג הזה נקרא משימת proxy והוא מקטין באופן משמעותי את עלות החיפוש. במהלך החיפוש, כל ניסיון מאמן מודל באמצעות הגדרות משימת ה-proxy.
בקטעים הבאים מוסבר מה כולל תכנון משימות של שרת proxy:
- גישות ליצירת משימת proxy.
- דרישות למשימת פרוקסי טובה.
- איך משתמשים בשלושת הכלים לעיצוב משימות proxy כדי למצוא את משימת ה-proxy האופטימלית, שמפחיתה את עלות החיפוש תוך שמירה על איכות החיפוש.
גישות ליצירת משימת פרוקסי
יש שלוש גישות נפוצות ליצירת משימת פרוקסי, והן כוללות את האפשרויות הבאות:
- להשתמש בפחות שלבי אימון.
- שימוש במערך נתונים לאימון שעבר דגימת משנה.
- שימוש במודל מוקטן.
שימוש בפחות שלבי אימון
הדרך הכי פשוטה ליצור משימת proxy היא לצמצם את מספר שלבי האימון של המאמן ולדווח על הציון בחזרה לבקר על סמך האימון החלקי הזה.
שימוש במערך נתונים לאימון שעבר דילול
בקטע הזה מתואר השימוש במערך נתונים לאימון שעבר דילול, גם לחיפוש ארכיטקטורה וגם לחיפוש מדיניות הגדלה.
חיפוש אדריכלות
אפשר ליצור משימת פרוקסי באמצעות מערך נתוני אימון שעבר דילול במהלך חיפוש הארכיטקטורה. עם זאת, כשמבצעים דילול, חשוב לפעול לפי ההנחיות הבאות:
- לערבב את הנתונים באופן אקראי בין השברים.
- אם נתוני האימון לא מאוזנים, צריך לבחור מדגם משנה כדי לאזן אותם.
חיפוש מדיניות הרחבה באמצעות הרחבה אוטומטית
אפשר לדלג על הקטע הזה אם אתם לא מריצים חיפוש של מדיניות הרחבה בלבד, אלא רק חיפוש של ארכיטקטורה רגילה. כדי לחפש מדיניות הרחבה, משתמשים בהרחבה אוטומטית. מומלץ לבצע דגימת משנה של נתוני האימון ולהריץ אימון מלא, במקום לצמצם את מספר שלבי האימון. אימון מלא עם הרחבה משמעותית שומר על יציבות גבוהה יותר של הציונים. בנוסף, כדאי להשתמש בנתוני אימון מצומצמים כדי להפחית את עלות החיפוש.
משימת פרוקסי שמבוססת על מודל מוקטן
אפשר גם להקטין את המודל ביחס למודל הבסיסי כדי ליצור משימת proxy. האפשרות הזו יכולה להיות שימושית גם כשרוצים להפריד בין חיפוש של עיצובים של בלוקים לבין חיפוש של שינוי גודל.
עם זאת, כשמצמצמים את המודל ורוצים להשתמש באילוץ של זמן האחזור, צריך להשתמש באילוץ של זמן אחזור קצר יותר עבור המודל המצומצם. הערה: אפשר להקטין את מודל הבסיס ולמדוד את זמן הטעינה שלו כדי להגדיר את מגבלת זמן הטעינה המחמירה הזו.
במודל המוקטן, אפשר גם להקטין את כמות ההגדלה והרגולריזציה בהשוואה למודל הבסיסי המקורי.
דוגמאות למודל מוקטן
עבור משימות של ראייה ממוחשבת שבהן מתבצע אימון על תמונות, יש שלוש דרכים נפוצות לצמצום מודל:
- הקטנת רוחב המודל: מספר הערוצים.
- הפחתת עומק המודל: מספר השכבות וחזרות הבלוקים.
- הקטנת הגודל של תמונות האימון (כך שלא יוסרו תכונות) או חיתוך תמונות האימון אם הפעולה הזו מותרת במשימה.
מומלץ לקרוא: מאמר על EfficientNet מספק תובנות חשובות לגבי שינוי קנה מידה של מודלים למשימות של ראייה ממוחשבת. במאמר מוסבר גם איך שלושת סוגי שינוי קנה המידה קשורים זה לזה.
חיפוש Spinenet הוא דוגמה נוספת להרחבת מודלים שנעשה בה שימוש בחיפוש ארכיטקטורה עצבית ב-Agent Platform. בשלב 1 של החיפוש, המערכת מצמצמת את מספר הערוצים ואת גודל התמונה.
יצירת משימה באמצעות שילוב
הגישות פועלות באופן עצמאי, ואפשר לשלב ביניהן במידה שונה כדי ליצור משימת פרוקסי.
הדרישות למשימת פרוקסי טובה
כדי שמשימת פרוקסי תוכל להעניק תגמול יציב בחזרה לבקר ולשמור על איכות החיפוש, היא צריכה לעמוד בדרישות מסוימות.
מתאם הדירוג בין חיפוש בשלב 1 לבין אימון מלא בשלב 2
כשמשתמשים במשימת פרוקסי לחיפוש ארכיטקטורה עצבית ב-Agent Platform, הנחת יסוד מרכזית לחיפוש מוצלח היא שאם מודל א' מניב ביצועים טובים יותר ממודל ב' במהלך אימון משימת הפרוקסי בשלב 1, אז מודל א' מניב ביצועים טובים יותר ממודל ב' במהלך האימון המלא בשלב 2. כדי לאמת את ההנחה הזו, צריך להעריך את המתאם בין הדירוג של החיפוש בשלב 1 לבין התגמולים של האימון המלא בשלב 2 בכ-10 עד 20 מודלים במרחב החיפוש. המודלים האלה נקראים מודלים של מועמדים לקורלציה.
האיור הבא מציג דוגמה לקורלציה נמוכה (ציון הקורלציה = -0.03), ולכן משימת ה-proxy הזו לא מתאימה לחיפוש:

כל נקודה בתרשים מייצגת מודל של קורלציה פוטנציאלית.
ציר x מייצג את הציונים של המודלים אחרי אימון מלא בשלב 2, וציר y מייצג את הציונים של אותם מודלים במשימת פרוקסי בשלב 1.
לצפות בנקודה הגבוהה ביותר. המודל הזה קיבל את הציון הכי גבוה במשימת הפרוקסי (ציר y), אבל הביצועים שלו בשלב השני של האימון המלא (ציר x) נמוכים בהשוואה למודלים אחרים. לעומת זאת, באיור הבא מוצגת דוגמה לקורלציה טובה (ציון הקורלציה הוא 0.67), ולכן משימת ה-proxy הזו היא מועמדת טובה לחיפוש:

אם החיפוש כולל אילוץ של זמן אחזור, כדאי לוודא שיש קורלציה טובה גם בין ערכי זמן האחזור.
שימו לב שהתגמולים של המודלים המועמדים לקורלציה הם בטווח טוב, ויש דגימה סבירה של טווח התגמולים. אם לא, לא תוכלו להעריך את המתאם בין הדירוגים. לדוגמה, אם התגמולים בשלב 1 של כל המודלים המועמדים לקורלציה מתרכזים רק בשני ערכים: 0.9 ו-0.1, אז אין מספיק שונות בדגימה.
בדיקת השונות
דרישה נוספת ממשימת פרוקסי היא שלא יהיה הבדל גדול ברמת הדיוק או בציון זמן האחזור שלה כשחוזרים עליה מספר פעמים לאותו מודל בלי לבצע שינויים. אם זה קורה, המכשיר שולח אות רועש בחזרה לבקר. אנחנו מספקים כלי למדידת השונות הזו.
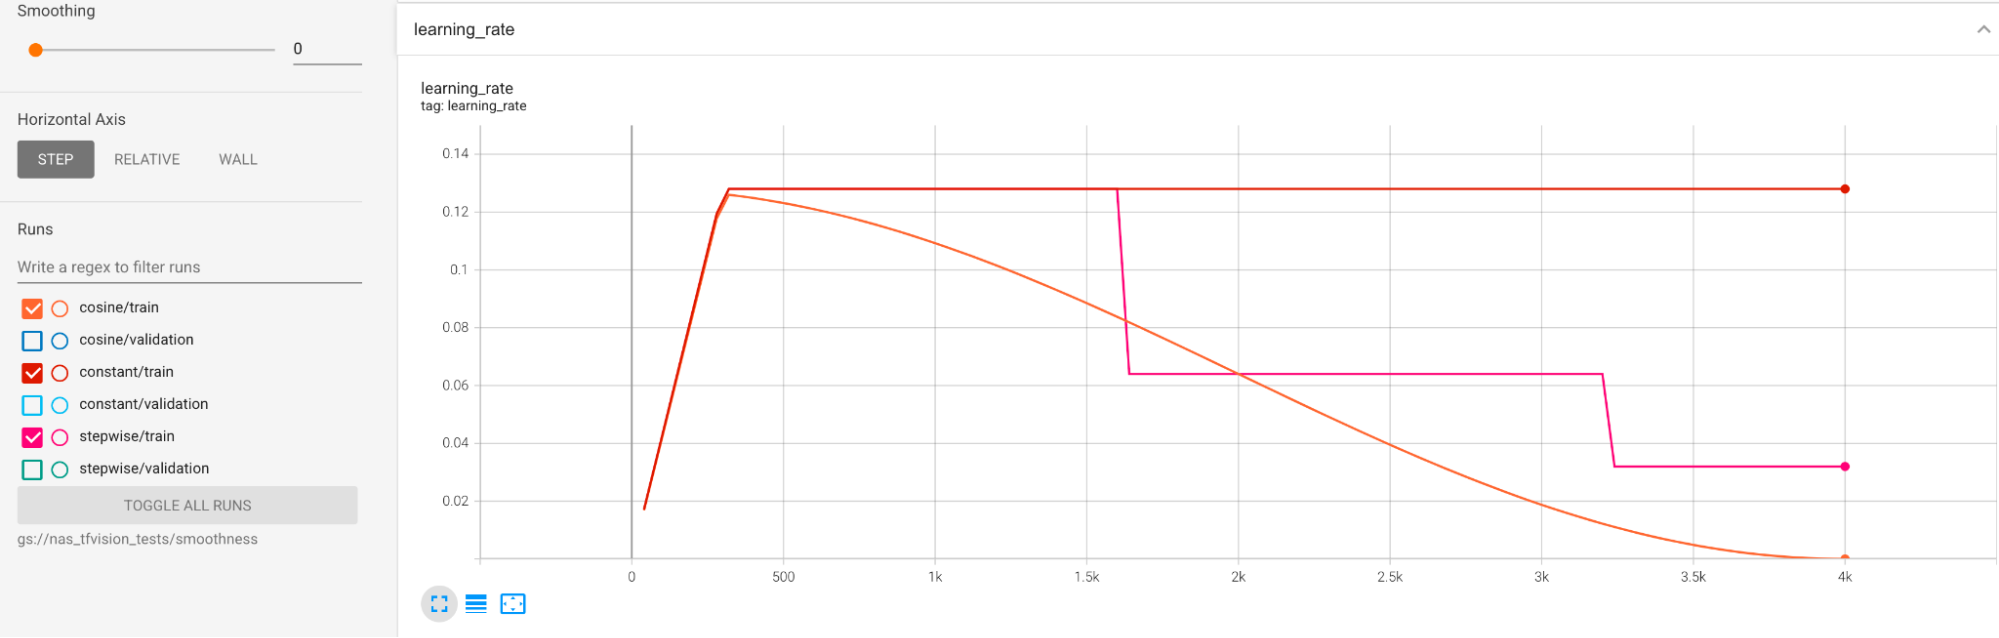
כדי לצמצם את השונות הגדולה במהלך האימון, מומלץ להשתמש בדוגמאות. אחת הדרכים היא להשתמש ב-cosine decay כלוח הזמנים של קצב הלמידה. בתרשים הבא מוצגות השוואה בין שלוש אסטרטגיות של קצב למידה:

הגרף התחתון מתאים לקצב למידה קבוע. אם הציון משתנה באופן משמעותי בסוף האימון, שינוי קטן במספר שלבי האימון המצומצם יכול לגרום לשינוי גדול בתגמול הסופי של משימת הפרוקסי. כדי שהתגמול של משימת ה-proxy יהיה יציב יותר, עדיף להשתמש בדעיכה של שיעור הלמידה לפי קוסינוס, כפי שמוצג בנתוני האימות התואמים בתרשים העליון. שימו לב שהגרף העליון הופך לחלק יותר לקראת סוף האימון. הגרף האמצעי מציג את הציון שמתאים לירידה הדרגתית של קצב הלמידה. הוא טוב יותר מהקצב הקבוע, אבל עדיין לא חלק כמו דעיכת הקוסינוס, וגם הוא דורש כוונון ידני.
לוחות הזמנים של קצב הלמידה מוצגים בהמשך:
החלקה נוספת
אם אתם משתמשים בהגדלה משמעותית של מערך הנתונים, יכול להיות שעקומת האימות לא תהיה חלקה מספיק עם דעיכת הקוסינוס. שימוש בהגדלה משמעותית מצביע על חוסר בנתוני אימון. במקרה כזה, לא מומלץ להשתמש בחיפוש ארכיטקטורה עצבית של פלטפורמת סוכנים, ואנחנו מציעים להשתמש במקום זאת בחיפוש עם הגדלה.
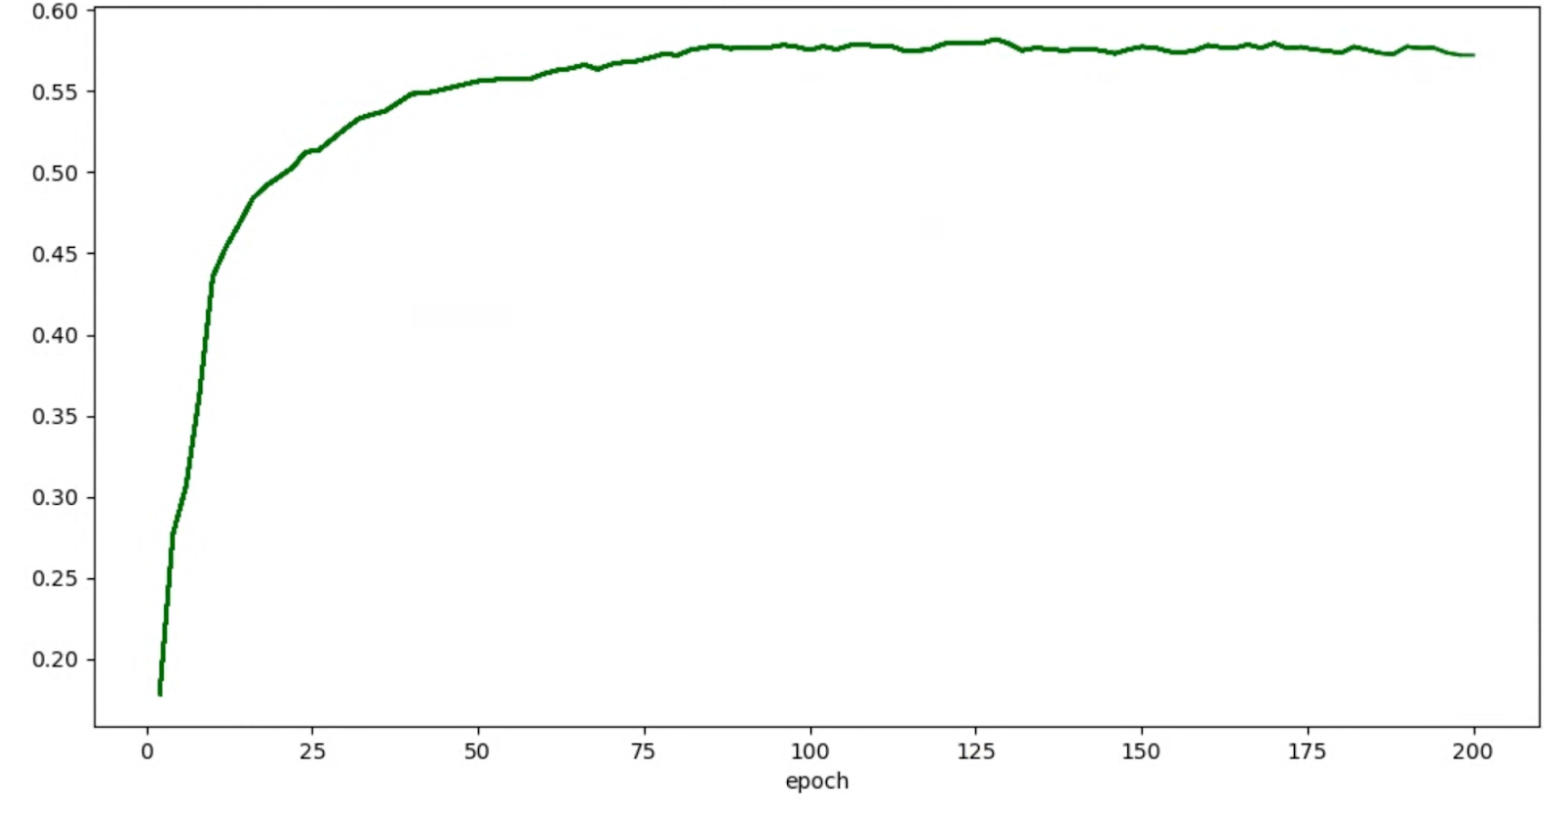
אם ההגדלה המשמעותית לא גורמת לבעיה, וכבר ניסיתם להשתמש בשיטת הדעיכה הקוסינוסית אבל אתם עדיין רוצים להשיג החלקה טובה יותר, אתם יכולים להשתמש בשיטה exponential-moving-average ל-TensorFlow-2 או בשיטה stochastic-weighted-averaging ל-PyTorch. דוגמה לשימוש באופטימיזציה של ממוצע נע אקספוננציאלי עם TensorFlow 2 זמינה בדוגמה הזו לקוד, ודוגמה לשימוש בממוצע משוקלל סטוכסטי זמינה בדוגמה הזו ל-PyTorch.
אם הגרפים של הדיוק או של התקופה בניסויים נראים כך:

אז אפשר להשתמש בטכניקות ההחלקה שצוינו למעלה (כמו ממוצע משוקלל סטוכסטי או ממוצע נע אקספוננציאלי) כדי לקבל גרף עקבי יותר כמו:
שגיאות שקשורות לזיכרון (OOM) ולקצב הלמידה
מרחב החיפוש של הארכיטקטורה יכול ליצור מודלים גדולים בהרבה מהמודל הבסיסי שלכם. יכול להיות ששיניתם את גודל האצווה של מודל הבסיס, אבל ההגדרה הזו עלולה להיכשל כשדוגמים מודלים גדולים יותר במהלך החיפוש, וכתוצאה מכך מתקבלות שגיאות OOM. במקרה כזה, צריך להקטין את גודל הקבוצה.
סוג השגיאה השני שמוצג הוא NaN (לא מספר). כדי לפתור את הבעיה, צריך להקטין את קצב הלמידה הראשוני או להוסיף חיתוך של הגרדיאנט.
כמו שצוין tutorial-2, אם יותר מ-20% מהמודלים של מרחב החיפוש מחזירים ציונים לא תקינים, החיפוש המלא לא יופעל. כלי התכנון של משימות הפרוקסי מספקים דרך להערכת שיעור הכשלים.
כלי עיצוב של משימות Proxy
בקטעים הקודמים מוסבר על העקרונות של עיצוב משימות פרוקסי. בקטע הזה מפורטים שלושה כלים לעיצוב משימות פרוקסי, שבאמצעותם אפשר למצוא באופן אוטומטי את משימת הפרוקסי האופטימלית על סמך גישות עיצוב שונות ועל סמך המשימה שעומדת בכל הדרישות.
שינויים נדרשים בקוד
קודם צריך לשנות קצת את קוד המאמן כדי שהוא יוכל ליצור אינטראקציה עם כלי העיצוב של משימות הפרוקסי במהלך תהליך איטרטיבי.
בדוגמה הבאה אפשר לראות איך זה נראה ב-tf_vision/train_lib.py. קודם צריך לייבא את הספרייה שלנו:
from google.cloud.visionsolutions.nas.proxy_task import proxy_task_utils
לפני שמתחיל מחזור אימון בלולאת האימון, כדאי לבדוק אם צריך להפסיק את האימון מוקדם, כי כלי העיצוב של משימות הפרוקסי רוצה שתשתמשו בספרייה שלנו:
if proxy_task_utils.get_stop_training(
    model_dir,
    end_training_cycle_step=<last-training-step-idx done so far>,
    total_training_steps=<total-training-steps>):
  break
אחרי שכל מחזור אימון בלולאת האימון מסתיים, צריך לעדכן את ציון הדיוק החדש, את שלבי ההתחלה והסיום של מחזור האימון, את משך מחזור האימון בשניות ואת סך שלבי האימון.
proxy_task_utils.update_trial_training_accuracy_metric(
      model_dir=model_dir,
      accuracy=<latest accuracy value>,
      begin_training_cycle_step=<beginning training step for this cycle>,
      end_training_cycle_step=<end training step for this cycle>,
      training_cycle_time_in_secs=<training cycle time (excluding validation)>,
      total_training_steps=<total-training-steps>)
שימו לב שזמן מחזור האימון לא צריך לכלול את הזמן של הערכת ציון האימות. חשוב לוודא שהמאמן מחשב את ציוני האימות בתדירות גבוהה (תדירות ההערכה) כדי שיהיה לכם מספיק מדגם של עקומת האימות. אם אתם משתמשים באילוץ השהיה, צריך לעדכן את מדד ההשהיה אחרי שמחשבים את ההשהיה:
proxy_task_utils.update_trial_training_latency_metric(
          model_dir=model_dir,
          latency=<measured_latency>)
כדי להשתמש בכלי לבחירת מודלים, צריך לטעון את נקודת הבדיקה הקודמת לאיטרציה הבאה. כדי לאפשר שימוש חוזר בנקודת בדיקה קודמת, מוסיפים דגל למאמן כמו שמוצג ב-tf_vision/cloud_search_main.py:
parser.add_argument(
      "--retrain_use_search_job_checkpoint",
      type=cloud_nas_utils.str_2_bool,
      default=False,
      help="True to use previous NAS search job checkpoint."
  )
טוענים את נקודת הבדיקה הזו לפני שמבצעים אימון של המודל:
if FLAGS.retrain_use_search_job_checkpoint:
    prev_checkpoint_dir = cloud_nas_utils.get_retrain_search_job_model_dir(
        retrain_search_job_trials=FLAGS.retrain_search_job_trials,
        retrain_search_job_dir=FLAGS.retrain_search_job_dir)
    logging.info("Setting checkpoint to %s.", prev_checkpoint_dir)
    # Now set your checkpoint using 'prev_checkpoint_dir'.
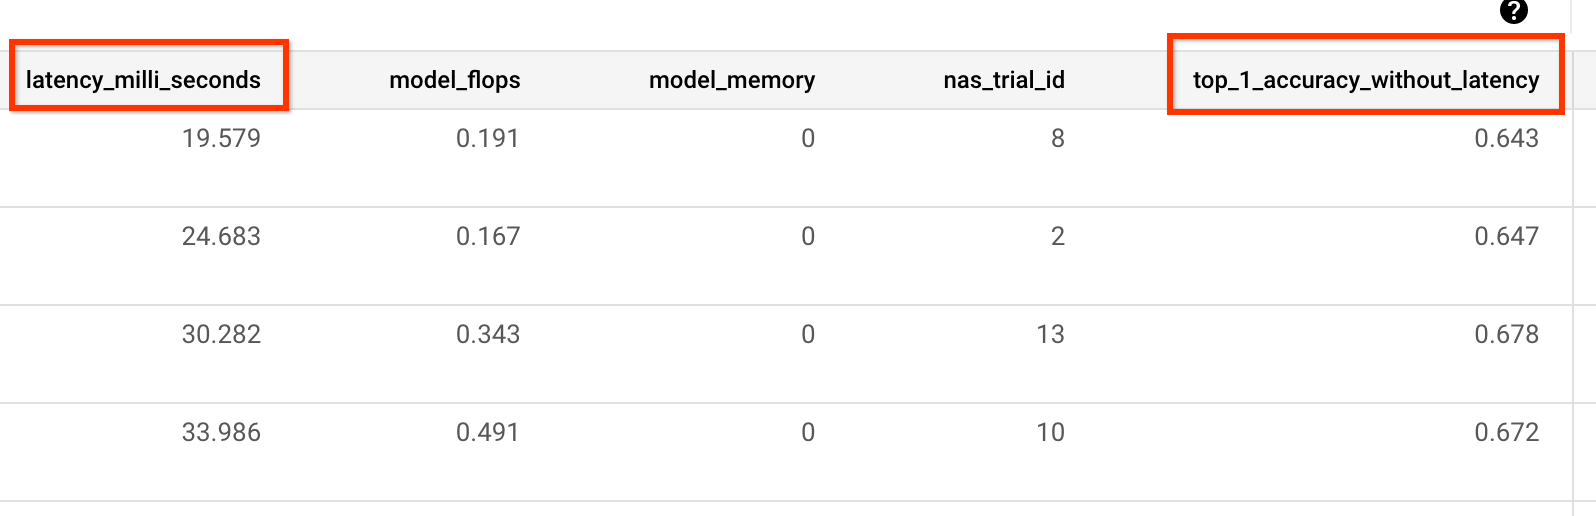
צריך גם את metric-id שמתאים לערכי הדיוק והחביון שדווחו על ידי המאמן. אם התגמול של המאמן (שכולל לפעמים שילוב של דיוק וחביון) שונה מהדיוק, חשוב לדווח גם על מדד הדיוק בלבד באמצעות other_metrics מהמאמן.
לדוגמה, בדוגמה הבאה מוצגים מדדי דיוק בלבד ומדדי זמן אחזור שדווחו על ידי הכלי לאימון מודלים מוכנים מראש:
מדידת השונות
אחרי שמשנים את קוד המאמן, השלב הראשון הוא מדידת השונות של המאמן. כדי למדוד את השונות, משנים את הגדרות הבסיס להכשרה באופן הבא:
- להקטין את מספר שלבי האימון כדי שהאימון יימשך כשעה אחת בלבד עם GPU אחד או שניים. אנחנו צריכים מדגם קטן של אימון מלא.
- להשתמש בשיעור למידה של דעיכה קוסינוסית ולהגדיר את השלבים שלו כך שיהיו זהים לשלבים המצומצמים האלה, כדי ששיעור הלמידה יהיה כמעט אפס לקראת הסוף.
כדי למדוד את השונות, הכלי בוחר מודל אחד ממרחב החיפוש, מוודא שאפשר להתחיל לאמן את המודל הזה בלי לקבל שגיאות OOM או NAN, מריץ חמש עותקים של המודל הזה עם ההגדרות שלכם למשך שעה בערך, ואז מדווח על השונות והחלקות של ציון האימון. העלות הכוללת של הפעלת הכלי הזה דומה בערך לעלות של הפעלת חמישה מודלים עם ההגדרות שלכם למשך שעה אחת בערך.
מריצים את הפקודה הבאה כדי להפעיל את משימת מדידת השונות (צריך חשבון שירות):
DATE="$(date '+%Y%m%d_%H%M%S')"
project_id=<your project-id>
# You can choose any unique docker id below.
trainer_docker_id=${USER}_trainer_${DATE}
trainer_docker_file=<path to your trainer dockerfile>
region=<your job region such as 'us-central1'>
search_space_module=<path to your search space module>
accelerator_type="NVIDIA_TESLA_V100"
num_gpus=2
# Your bucket should be for your project and in the same region as the job.
root_output_dir=<gs://your-bucket>

####### Variance measurement related parameters ######
proxy_task_variance_measurement_docker_id=${USER}_variance_measurement_${DATE}
# Use the service account that you set-up for your project.
service_account=<your service account>
job_name=<your job name>
############################################################

python3 vertex_nas_cli.py build \
--project_id=${project_id} \
--region=${region} \
--trainer_docker_id=${trainer_docker_id} \
--trainer_docker_file=${trainer_docker_file} \
--proxy_task_variance_measurement_docker_id=${proxy_task_variance_measurement_docker_id}

# The command below passes 'dummy' arguments for the training docker.
# You need to modify them for your own docker.
python3 vertex_nas_cli.py measure_proxy_task_variance \
--proxy_task_variance_measurement_docker_id=${proxy_task_variance_measurement_docker_id} \
--project_id=${project_id} \
--service_account=${service_account} \
--region=${region} \
--trainer_docker_id=${trainer_docker_id} \
--job_name=${job_name} \
--search_space_module=${search_space_module} \
--accelerator_type=${accelerator_type} \
--num_gpus=${num_gpus} \
--root_output_dir=${root_output_dir} \
--search_docker_flags \
dummy_trainer_flag1="dummy_trainer_val"
אחרי שתפעילו את משימת המדידה הזו של השונות, תקבלו קישור למשימה. השם של המשימה צריך להתחיל בקידומת Variance_Measurement. דוגמה לממשק משתמש של משימה:
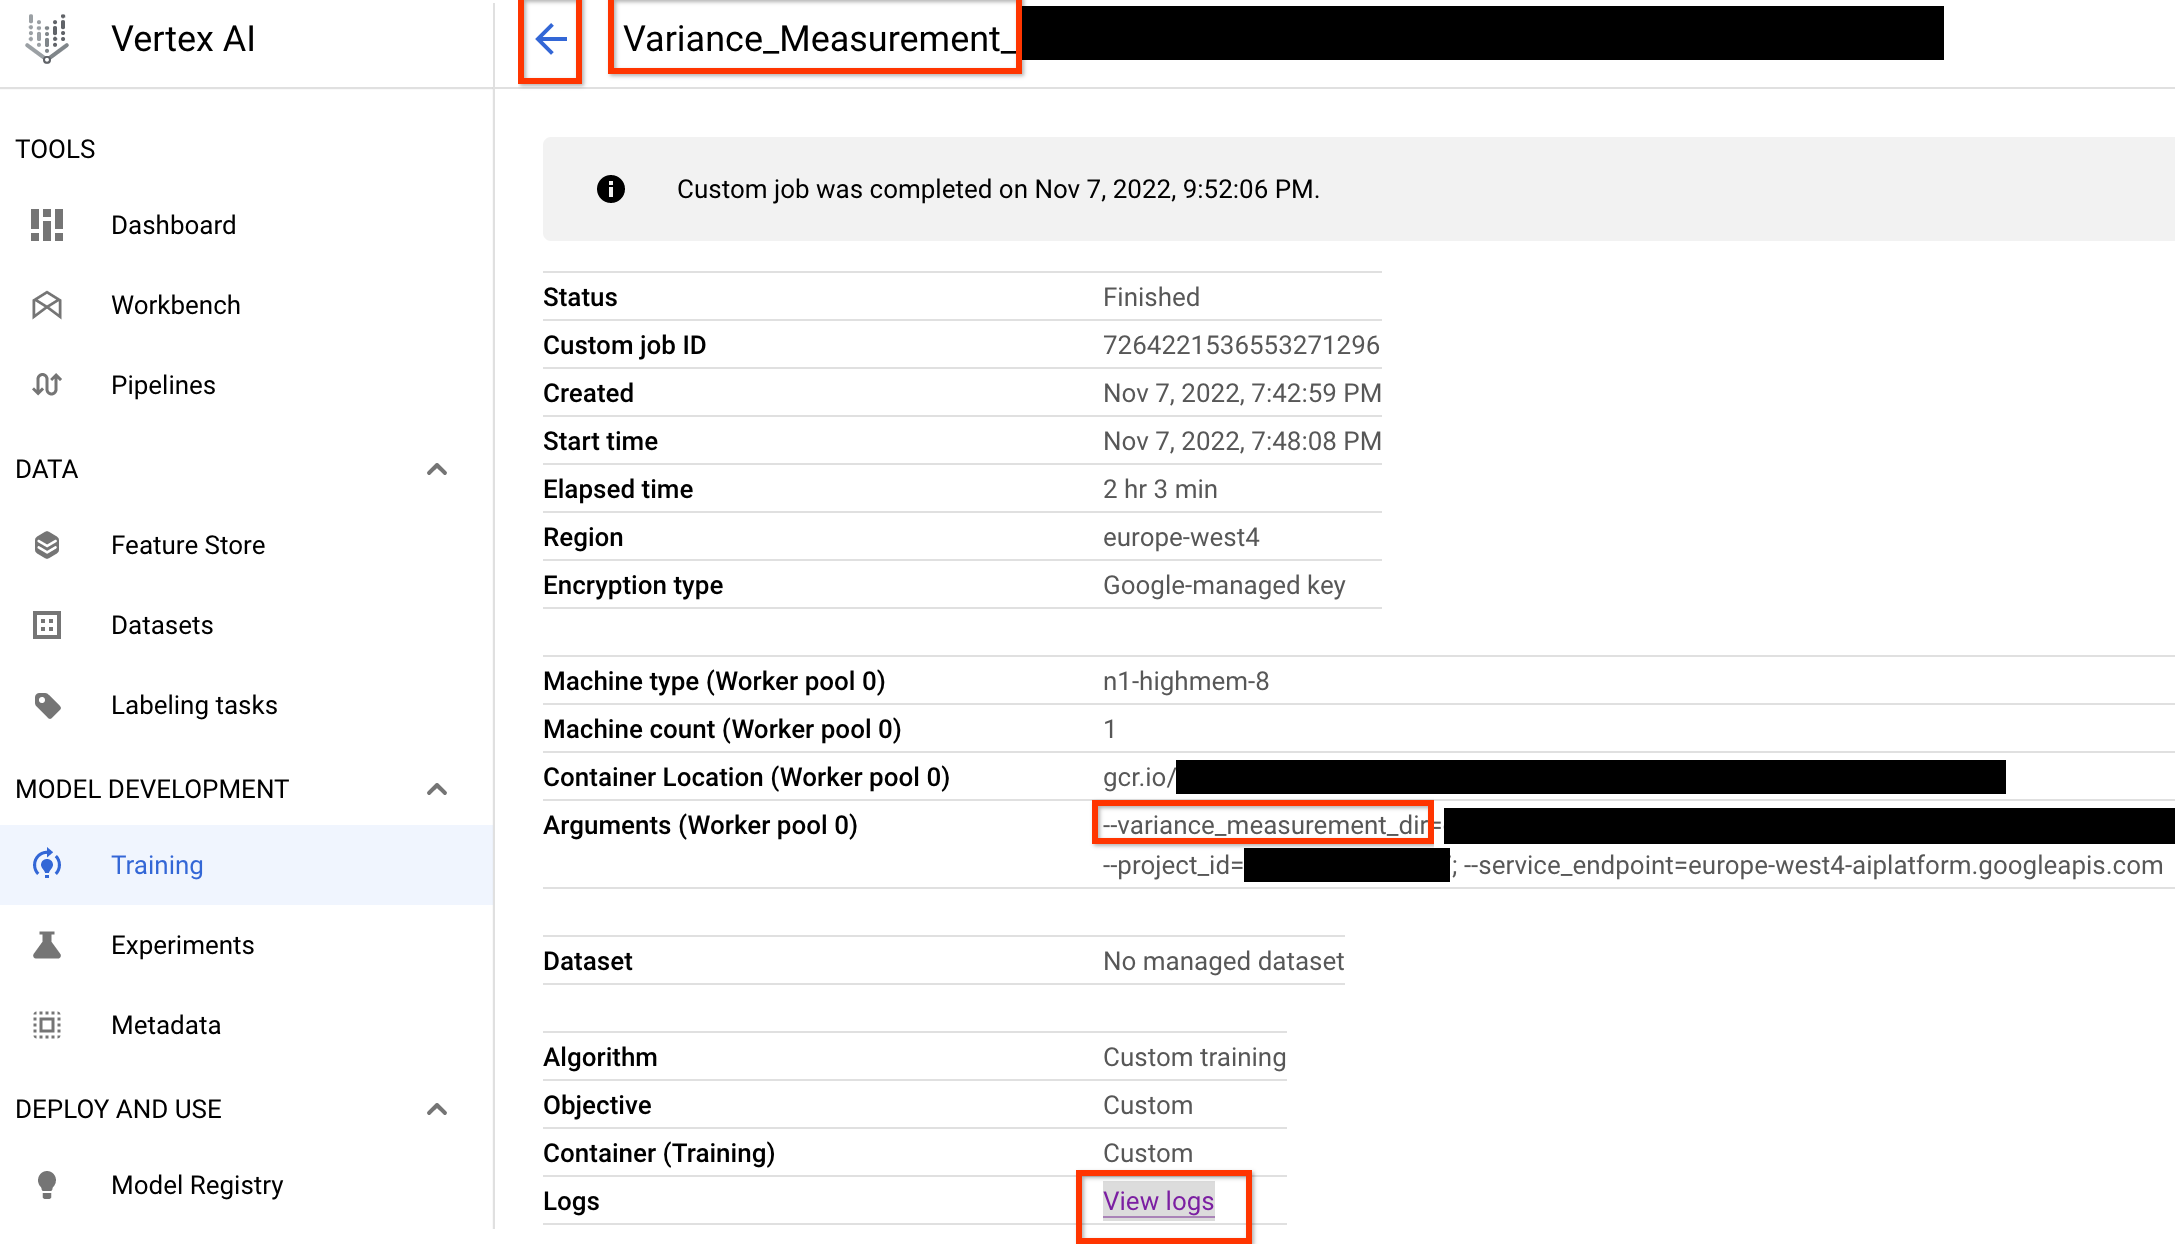
התיקייה variance_measurement_dir תכיל את כל התוצאות, ותוכלו לבדוק את היומנים בלחיצה על הקישור הצגת היומנים.
כברירת מחדל, המשימה הזו משתמשת במעבד אחד בענן כדי לפעול ברקע כמשימה בהתאמה אישית, ואז מפעילה ומנהלת משימות צאצא של NAS.
בקטע NAS jobs (משימות NAS), תופיע משימה בשם Find_workable_model_<your job name>. המשימה הזו תדגום את מרחב החיפוש כדי למצוא מודל אחד שלא יוצר שגיאות. אחרי שיימצא מודל כזה, משימת מדידת השונות תפעיל עוד משימת NAS <your job name>, שתריץ חמש עותקים של המודל הזה למספר שלבי האימון שהגדרתם קודם. אחרי שהאימון של המודלים האלה יסתיים, משימת מדידת השונות תמדוד את השונות וההחלקה של הניקוד ותדווח עליהן ביומנים שלה:
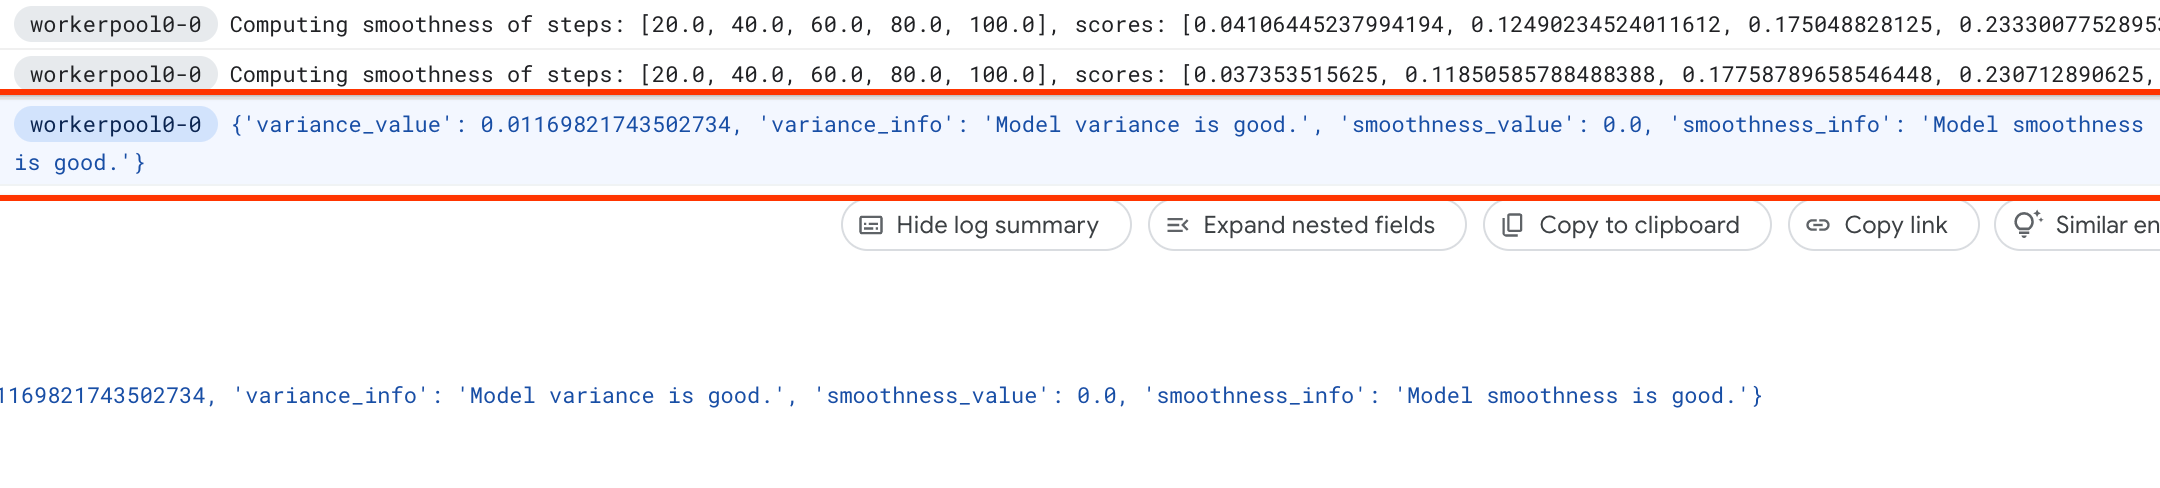
אם השונות גבוהה, אפשר לנסות את הטכניקות שמפורטות כאן.
בחירת מודל
אחרי שמוודאים שלמאמן אין שונות גבוהה, השלבים הבאים הם:
- כדי למצוא בערך 10 מודלים פוטנציאליים של קורלציה
- לחשב את ציוני האימון המלאים שלהם, שישמשו כנקודת השוואה כשבהמשך תחשבו ציוני קורלציה של משימות פרוקסי לאפשרויות שונות של משימות פרוקסי.
הכלי שלנו מוצא באופן אוטומטי ויעיל את המודלים האלה של מועמדים לקורלציה, ומוודא שיש להם פיזור טוב של ציונים גם מבחינת דיוק וגם מבחינת זמן האחזור, כדי שלחישוב הקורלציה העתידי יהיה בסיס טוב. לשם כך, הכלי מבצע את הפעולות הבאות:
- הכלי בוחר באופן אקראי
N_beginמודלים ממרחב החיפוש. בדוגמה הזו, נניח ש-N_begin. הכלי מאמן אותם במשך 1/30 מזמן האימון המלא.N_begin = 30 - דחייה של חמישה מתוך 30 מודלים שלא משפרים את הדיוק והחביון. האיור הבא מציג דוגמה לכך. המודלים שנדחו מוצגים כנקודות אדומות:
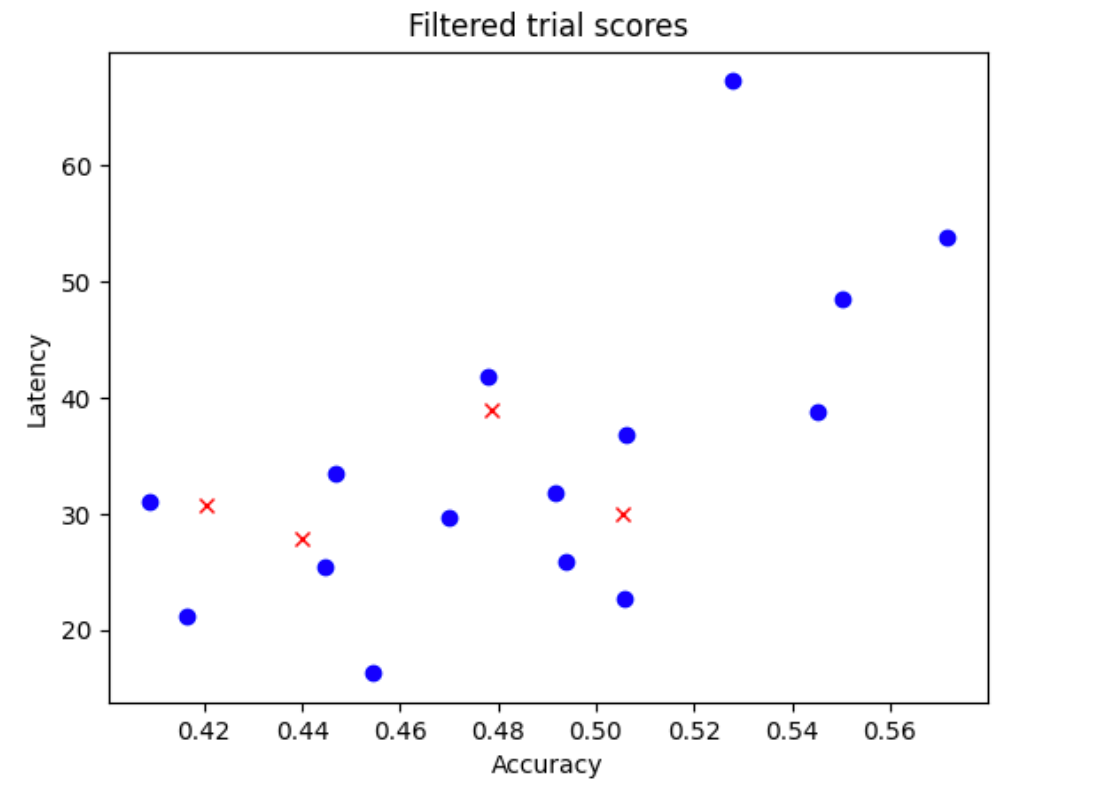
- מאמנים את 25 המודלים שנבחרו למשך 1/25 מזמן האימון המלא, ואז דוחים עוד 5 מודלים על סמך הציונים שהתקבלו עד עכשיו. חשוב לזכור שהאימון של 25 המודלים נמשך מנקודת הבדיקה הקודמת שלהם.
- חוזרים על התהליך הזה עד שנשארים רק
Nמודלים עם התפלגות טובה. - מאמנים את
Nהמודלים האחרונים עד לסיום.
הגדרת ברירת המחדל של N_begin היא 30, ואפשר למצוא אותה כ-START_NUM_MODELS
בקובץ proxy_task/proxy_task_model_selection_lib_constants.py.
הגדרת ברירת המחדל של N היא 10, ואפשר למצוא אותה כ-FINAL_NUM_MODELS בקובץ proxy_task/proxy_task_model_selection_lib_constants.py.
העלות הנוספת של תהליך בחירת המודל מחושבת באופן הבא:
= (30*1/30 + 25*1/25 + 20*1/20 + 15*1/15 + 10*(remaining-training-time-fraction)) * full-training-time
= (4 + 10*(0.81)) * full-training-time
~= 12 * full-training-time
עם זאת, צריך להקפיד על הגדרה מעל N=10. כלי החיפוש של משימות הפרוקסי יפעיל את המודלים האלה של N במקביל. לכן, צריך לוודא שיש לכם מספיק מכסת GPU בשביל זה. לדוגמה, אם משימת הפרוקסי משתמשת בשני GPU עבור מודל אחד, אז צריכה להיות לכם מכסה של לפחות 2*N GPU.
לגבי משימת בחירת המודל, צריך להשתמש באותו חלוקה של מערך הנתונים כמו במשימת האימון המלא בשלב 2, ובאותה הגדרת מאמן כמו באימון הבסיסי המלא.
עכשיו אפשר להריץ את המשימה של בחירת המודל באמצעות הפקודה הבאה (צריך חשבון שירות):
DATE="$(date '+%Y%m%d_%H%M%S')"
project_id=<your project-id>
# You can choose any unique docker id below.
trainer_docker_id=${USER}_trainer_${DATE}
trainer_docker_file=<path to your trainer dockerfile>
latency_calculator_docker_id=${USER}_model_selection_${DATE}
latency_calculator_docker_file=${USER}_latency_${DATE}
region=<your job region such as 'us-central1'>
search_space_module=<path to your search space module>
accelerator_type="NVIDIA_TESLA_V100"
num_gpus=2
# Your bucket should be for your project and in the same region as the job.
root_output_dir=<gs://your-bucket>
# Your latency computation device.
target_device_type="CPU"

####### Proxy task model-selection related parameters ######
proxy_task_model_selection_docker_id=${USER}_model_selection_${DATE}
# Use the service account that you set-up for your project.
service_account=<your service account>
job_name=<your job name>
# The value below depends on your accelerator quota. By default
# the model-selection job runs 30 trials. However, depending on
# your quota, you can choose to only run 10 trials in parallel at a time.
# However, lowering this number can increase the overall runtime for the job.
max_parallel_nas_trial=<num parallel trials>
# The value below is the 'metric-id' corresponding to the accuracy ONLY
# metric reported by your trainer. Note that this metric may
# be different from the 'reward'.
accuracy_metric_id=<set accuracy metric id used by your trainer>
latency_metric_id=<set latency metric id used by your trainer>
############################################################

python3 vertex_nas_cli.py build \
--project_id=${project_id} \
--region=${region} \
--trainer_docker_id=${trainer_docker_id} \
--trainer_docker_file=${trainer_docker_file} \
--latency_calculator_docker_id=${latency_calculator_docker_id} \
--latency_calculator_docker_file=${latency_calculator_docker_file} \
--proxy_task_model_selection_docker_id=${proxy_task_model_selection_docker_id}

# The command below passes 'dummy' arguments for trainer-docker
# and latency-docker. You need to modify them for your own docker.
python3 vertex_nas_cli.py select_proxy_task_models \
--service_account=${service_account} \
--proxy_task_model_selection_docker_id=${proxy_task_model_selection_docker_id} \
--project_id=${project_id} \
--region=${region} \
--trainer_docker_id=${trainer_docker_id} \
--job_name=${job_name} \
--max_parallel_nas_trial=${max_parallel_nas_trial} \
--accuracy_metric_id=${accuracy_metric_id} \
--latency_metric_id=${latency_metric_id} \
--search_space_module=${search_space_module} \
--accelerator_type=${accelerator_type} \
--num_gpus=${num_gpus} \
--root_output_dir=${root_output_dir} \
--latency_calculator_docker_id=${latency_calculator_docker_id} \
--latency_docker_flags \
dummy_latency_flag1="dummy_latency_val" \
--target_device_type=${target_device_type} \
--search_docker_flags \
dummy_trainer_flag1="dummy_trainer_val"
אחרי שמפעילים את פעולת הבקרה לבחירת מודל, מקבלים קישור לפעולה. שם הפעולה מתחיל בקידומת Model_Selection_. דוגמה לממשק משתמש של פעולה מוצגת בהמשך:
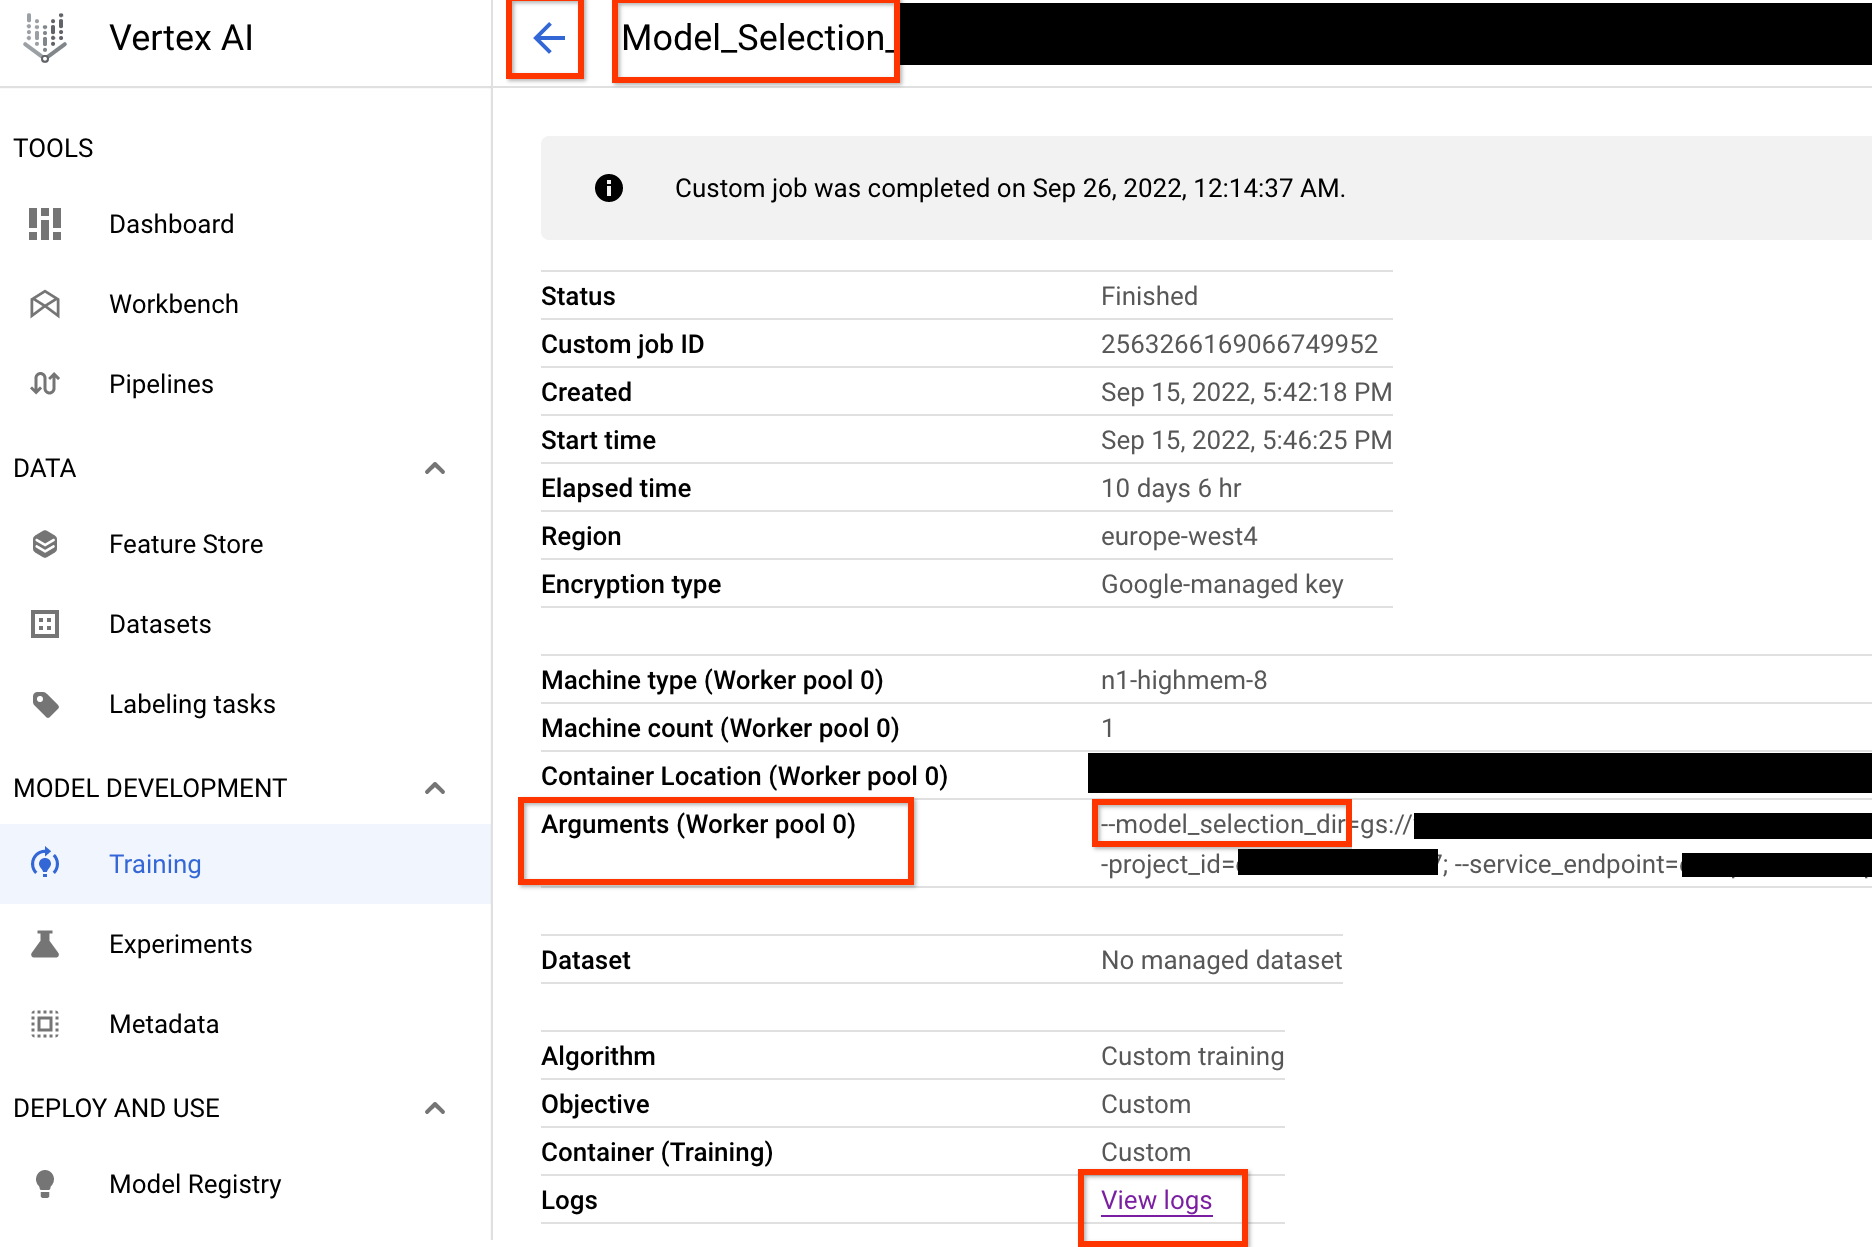
הפלט כולל את כל התוצאות.model_selection_dir כדי לבדוק את היומנים, לוחצים על הקישור View logs.
כברירת מחדל, העבודה של בקר בחירת המודל משתמשת במעבד אחד ב- Google Cloud כדי לפעול ברקע כעבודה בהתאמה אישית, ואז מפעילה ומנהלת עבודות NAS משניות לכל איטרציה של בחירת המודל.
לכל משימת NAS של ילד יש שם כמו <your_job_name>_iter_3 (חוץ מאיטרציה 0).
רק איטרציה אחת פועלת בכל פעם. בכל איטרציה, מספר המודלים (מספר הניסויים) קטן ומשך האימון גדל. בסוף כל איטרציה, כל משימת NAS שומרת קובץ gs://<job-output-dir>/search/filtered_trial_scores.png, שבו מוצג באופן ויזואלי אילו מודלים נדחו באיטרציה הזו.
אפשר גם להריץ את הפקודה הבאה:
gcloud storage cat gs://<path to 'model_selection_dir'>/MODEL_SELECTION_STATE.json
בדוח מוצג סיכום של האיטרציות והמצב הנוכחי של משימת בקר בחירת המודל, שם המשימה וקישורים לכל איטרציה:
{
  "start_num_models": 30,
  "final_num_models": 10,
  "num_models_to_remove_per_iter": 5,
  "accuracy_metric_id": "top_1_accuracy_without_latency",
  "latency_metric_id": "latency_milli_seconds",
  "iterations": [
    {
      "num_trials": 30,
      "trials_to_retrain": [
        "27",
        "16",
        ...,
        "14"
      ],
      "search_job_name": "projects/123456/locations/europe-west4/nasJobs/2111217356469436416",
      "search_job_link": "https://console.cloud.google.com/agent-platform/locations/europe-west4/training/2111217356469436416/cpu?project=my-project",
      "latency_calculator_job_name": "projects/123456/locations/europe-west4/customJobs/6909239809479278592",
      "latency_calculator_job_link": "https://console.cloud.google.com/agent-platform/locations/europe-west4/training/6909239809479278592/cpu?project=my-project",
      "desired_training_step_pct": 2.0
    },
    ...,
    {
      "num_trials": 15,
      "trials_to_retrain": [
        "14",
        ...,
        "5"
      ],
      "search_job_name": "projects/123456/locations/europe-west4/nasJobs/7045544066951413760",
      "search_job_link": "https://console.cloud.google.com/agent-platform/locations/europe-west4/training/7045544066951413760/cpu?project=my-project",
      "latency_calculator_job_name": "projects/123456/locations/europe-west4/customJobs/2790768318993137664",
      "latency_calculator_job_link": "https://console.cloud.google.com/agent-platform/locations/europe-west4/training/2790768318993137664/cpu?project=my-project",
      "desired_training_step_pct": 28.57936507936508
    },
    {
      "num_trials": 10,
      "trials_to_retrain": [],
      "search_job_name": "projects/123456/locations/europe-west4/nasJobs/2742864796394192896",
      "search_job_link": "https://console.cloud.google.com/agent-platform/locations/europe-west4/training/2742864796394192896/cpu?project=my-project",
      "latency_calculator_job_name": "projects/123456/locations/europe-west4/customJobs/1490864099985195008",
      "latency_calculator_job_link": "https://console.cloud.google.com/agent-platform/locations/europe-west4/training/1490864099985195008/cpu?project=my-project",
      "desired_training_step_pct": 101.0
    }
  ]
}
באיטרציה האחרונה מוצג המספר הסופי של מודלים להשוואה עם פיזור טוב של הציונים. המודלים האלה והציונים שלהם משמשים לחיפוש משימות פרוקסי בשלב הבא. אם טווח הציונים הסופי של הדיוק והחביון של המודלים להשוואה נראה טוב יותר או דומה למודל הבסיסי הקיים, זהו סימן טוב לגבי מרחב החיפוש. אם טווח הציונים הסופי של הדיוק והחביון גרוע משמעותית מהבסיס, כדאי לבדוק מחדש את מרחב החיפוש.
חשוב לדעת: אם יותר מ-20% מהניסיונות שלכם באיטרציה הראשונה נכשלים, צריך לבטל את משימת בחירת המודל ולזהות את שורש הבעיה. יכול להיות שיש בעיה במרחב החיפוש או בהגדרות של גודל הקבוצה וקצב הלמידה.
שימוש במכשיר זמן אחזור מקומי לבחירת מודל
כדי להשתמש במכשיר לחישוב זמן אחזור מקומי לבחירת מודל, מריצים את הפקודה select_proxy_task_models בלי הדגל latency docker והדגל latency-docker, כי לא רוצים להפעיל את latency docker ב- Google Cloud. לאחר מכן, משתמשים בפקודה run_latency_calculator_local שמתוארת במדריך 4 כדי להפעיל את המשימה של מחשבון זמן האחזור המקומי. במקום להעביר את הדגל --search_job_id, מעבירים את הדגל --controller_job_id עם מזהה המשימה המספרי של בחירת המודל שמתקבל אחרי שמריצים את הפקודה select_proxy_task_models.
המשכת העבודה של בקר בחירת המודל
במצבים הבאים צריך להפעיל מחדש את העבודה של כלי הבקרה לבחירת המודל:
- התהליך של בקר הבחירה של מודל האב מסתיים (מקרה נדיר).
- בטעות ביטלתם את העבודה של בקר בחירת המודל.
קודם כל, אל תבטלו את עבודת האיטרציה של NAS של הילד (הכרטיסייה NAS) אם היא כבר פועלת. לאחר מכן, כדי להמשיך את עבודת בקר בחירת המודל של ההורה, מריצים את הפקודה select_proxy_task_models כמו קודם, אבל הפעם מעבירים את הדגל --previous_model_selection_dir ומגדירים אותו לספריית הפלט של עבודת בקר בחירת המודל הקודמת. עבודת בקר בחירת המודל שהופעלה מחדש טוענת את המצב הקודם שלה מהספרייה וממשיכה לפעול כמו קודם.
חיפוש משימות שמוגדרות דרך שרת proxy
אחרי שמאתרים את המודלים שמועמדים לקורלציה ואת ציוני האימון המלא שלהם, השלב הבא הוא להשתמש בהם כדי להעריך את ציוני הקורלציה של בחירות שונות של משימות פרוקסי, ולבחור את משימת הפרוקסי האופטימלית. הכלי שלנו לחיפוש משימות של שרת proxy יכול למצוא באופן אוטומטי משימת שרת proxy, שמציעה את האפשרויות הבאות:
- העלות הכי נמוכה לחיפוש NAS.
- עומד בדרישת הסף המינימלית של המתאם אחרי שמספקים לו הגדרה של מרחב חיפוש של משימת proxy.
כדאי לזכור שיש שלושה מאפיינים נפוצים לחיפוש משימת פרוקסי אופטימלית, כולל:
- מספר מופחת של שלבי אימון.
- כמות מופחתת של נתוני אימון.
- הגודל של המודל השתנה.
אפשר ליצור מרחב חיפוש דיסקרטי של משימות proxy על ידי דגימת המימדים האלה, כמו שמוצג כאן:
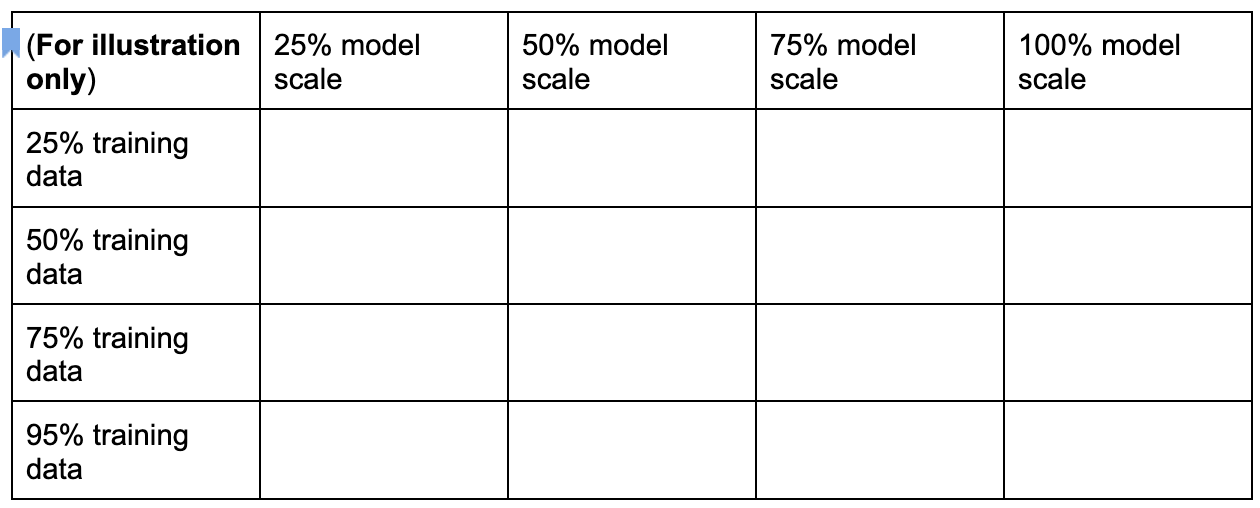
האחוזים שמופיעים למעלה הם רק הצעה משוערת ודוגמה. בפועל, אפשר לבחור כל אפשרות נפרדת. חשוב לשים לב שלא הוספנו את המימד training-steps (שלבי אימון) במרחב החיפוש שלמעלה. הסיבה לכך היא שכלי החיפוש של משימות הפרוקסי קובע את שלב האימון האופטימלי בהינתן בחירה של משימת פרוקסי. נניח שבחרתם במשימת פרוקסי [50% training data, 25% model scale]. צריך להגדיר את מספר שלבי האימון לאותו מספר כמו באימון הבסיסי המלא. כשמעריכים את משימת הפרוקסי הזו, כלי החיפוש של משימות הפרוקסי מפעיל אימון של מודלים של מועמדים לקורלציה, עוקב אחרי ציוני הדיוק הנוכחיים שלהם ומחשב באופן רציף את ציון הקורלציה של הדירוג (באמצעות הציונים הקודמים של האימון המלא של מודלי ההפניה):

לכן, כלי החיפוש של משימות ה-proxy יכול לעצור את האימון של משימות ה-proxy ברגע שמתקבל המתאם הרצוי (למשל 0.65), או גם לעצור מוקדם יותר אם חורגים ממכסת עלויות החיפוש (למשל מגבלה של 3 שעות לכל משימת proxy). לכן, אין צורך לחפש באופן מפורש את שלבי האימון. הכלי לחיפוש משימות פרוקסי מעריך כל משימת פרוקסי ממרחב החיפוש הנפרד שלכם כחיפוש Grid, ומספק לכם את האפשרות הטובה ביותר.
בהמשך מופיעה דוגמה להגדרה של מרחב חיפוש של משימות פרוקסי MnasNetmnasnet_proxy_task_config_generator, שמוגדרת בקובץ proxy_task/proxy_task_search_spaces.py, כדי להראות איך אפשר להגדיר מרחב חיפוש משלכם:
# MNasnet training-data size choices.
MNASNET_TRAINING_DATA_PCT_LIST = [25, 50, 75, 95]

# Training data path regex pattern.
_TRAINING_DATA_PATH_REGEX = r"gs://.*/.*"


def update_mnasnet_proxy_training_data(
    baseline_docker_args_map: Dict[str, Any],
    training_data_pct: int) -> Optional[Dict[str, Any]]:
  """Updates MNasnet baseline docker to use a certain training_data_pct."""
  proxy_task_docker_args_map = copy.deepcopy(baseline_docker_args_map)
  # Imagenet training data path looks like:
  # gs://<path to imagenet data>/train-00[0-7]??-of-01024.
  if not re.match(_TRAINING_DATA_PATH_REGEX,
                  baseline_docker_args_map["training_data_path"]):
    raise ValueError(
        "Training data path %s does not match the desired pattern." %
        baseline_docker_args_map["training_data_path"])

  root_path, _ = baseline_docker_args_map["training_data_path"].rsplit("/", 1)
  if training_data_% == 25:
    proxy_task_docker_args_map["training_data_path"] = os.path.join(
        root_path, "train-00[0-1][0-4]?-of-01024*")
  elif training_data_% == 50:
    proxy_task_docker_args_map["training_data_path"] = os.path.join(
        root_path, "train-00[0-4]??-of-01024*")
  elif training_data_% == 75:
    proxy_task_docker_args_map["training_data_path"] = os.path.join(
        root_path, "train-00[0-6][0-4]?-of-01024*")
  elif training_data_% == 95:
    proxy_task_docker_args_map["training_data_path"] = os.path.join(
        root_path, "train-00[0-8][0-4]?-of-01024*")
  else:
    logging.warning("Mnasnet training_data_% %d is not supported.",
                    training_data_pct)
    return None
  proxy_task_docker_args_map["validation_data_path"] = os.path.join(
      root_path, "train-009[0-4]?-of-01024")
  return proxy_task_docker_args_map


def mnasnet_proxy_task_config_generator(
    baseline_docker_args_map: Dict[str, Any]
) -> List[proxy_task_utils.ProxyTaskConfig]:
  """Returns a list of proxy-task configs to be evaluated for MNasnet.

  Args:
    baseline_docker_args_map: A set of baseline training-docker arguments in
      the form of a dictionary of {'key', val}. The different proxy-task
      configs to try can be built by modifying this baseline.

  Returns:
    A list of proxy-task configs to be evaluated for this
    proxy-task search space.
  """
  proxy_task_config_list = []
  # NOTE: Will not search over model-scale for MNasnet.
  for training_data_% in MNASNET_TRAINING_DATA_PCT_LIST:
    proxy_task_docker_args_map = update_mnasnet_proxy_training_data(
        baseline_docker_args_map=baseline_docker_args_map,
        training_data_pct=training_data_pct)
    if not proxy_task_docker_args_map:
      continue
    proxy_task_name = "mnasnet_proxy_training_data_pct_{}".format(
        training_data_pct)
    proxy_task_config_list.append(
        proxy_task_utils.ProxyTaskConfig(
            name=proxy_task_name, docker_args_map=proxy_task_docker_args_map))
  return proxy_task_config_list
בדוגמה הזו, אנחנו יוצרים מרחב חיפוש פשוט על training-data-percent
25, 50, 75 ו-95 (שימו לב שלא נעשה שימוש ב-100 אחוז נתוני אימון לחיפוש בשלב 1).
הפונקציה mnasnet_proxy_task_config_generator מקבלת תבנית בסיס משותפת של ארגומנטים של Docker לאימון, ואז משנה את הארגומנטים האלה לכל גודל נתונים לאימון של משימת proxy רצויה. לאחר מכן היא מחזירה רשימה של proxy-task-config שעוברת עיבוד מאוחר יותר על ידי כלי החיפוש proxy-task, אחת בכל פעם, באותו סדר. לכל הגדרת משימת proxy יש name ו-docker_args_map, שהוא מיפוי של מפתח/ערך לארגומנטים של משימת proxy ב-Docker.
אתם יכולים להגדיר בעצמכם את מרחב החיפוש בהתאם לדרישות שלכם, ולעצב בעצמכם מרחבי חיפוש של משימות פרוקסי, גם אם יש יותר משני ממדים של נתוני אימון מופחתים או של קנה מידה מופחת של המודל. עם זאת, לא מומלץ לחפש באופן מפורש שלבי אימון, כי זה יגרום לבזבוז של חישובים חוזרים. כדאי להשתמש בכלי לחיפוש משימות פרוקסי כדי לטפל בממד הזה.
בחיפוש הראשון שלכם אחר משימת פרוקסי, אתם יכולים לנסות לצמצם רק את נתוני האימון (בדיוק כמו בדוגמה MnasNet) ולדלג על צמצום קנה המידה של המודל, כי צמצום קנה המידה של המודל יכול לכלול כמה פרמטרים מעל image-size, num-filters או num-blocks.
ברוב המקרים, נתוני האימון המצומצמים (וחיפוש משתמע על פני שלבי אימון מצומצמים) מספיקים כדי למצוא משימת פרוקסי טובה.
מגדירים את מספר שלבי האימון למספר שמשמש באימון מלא של בסיס ההשוואה.
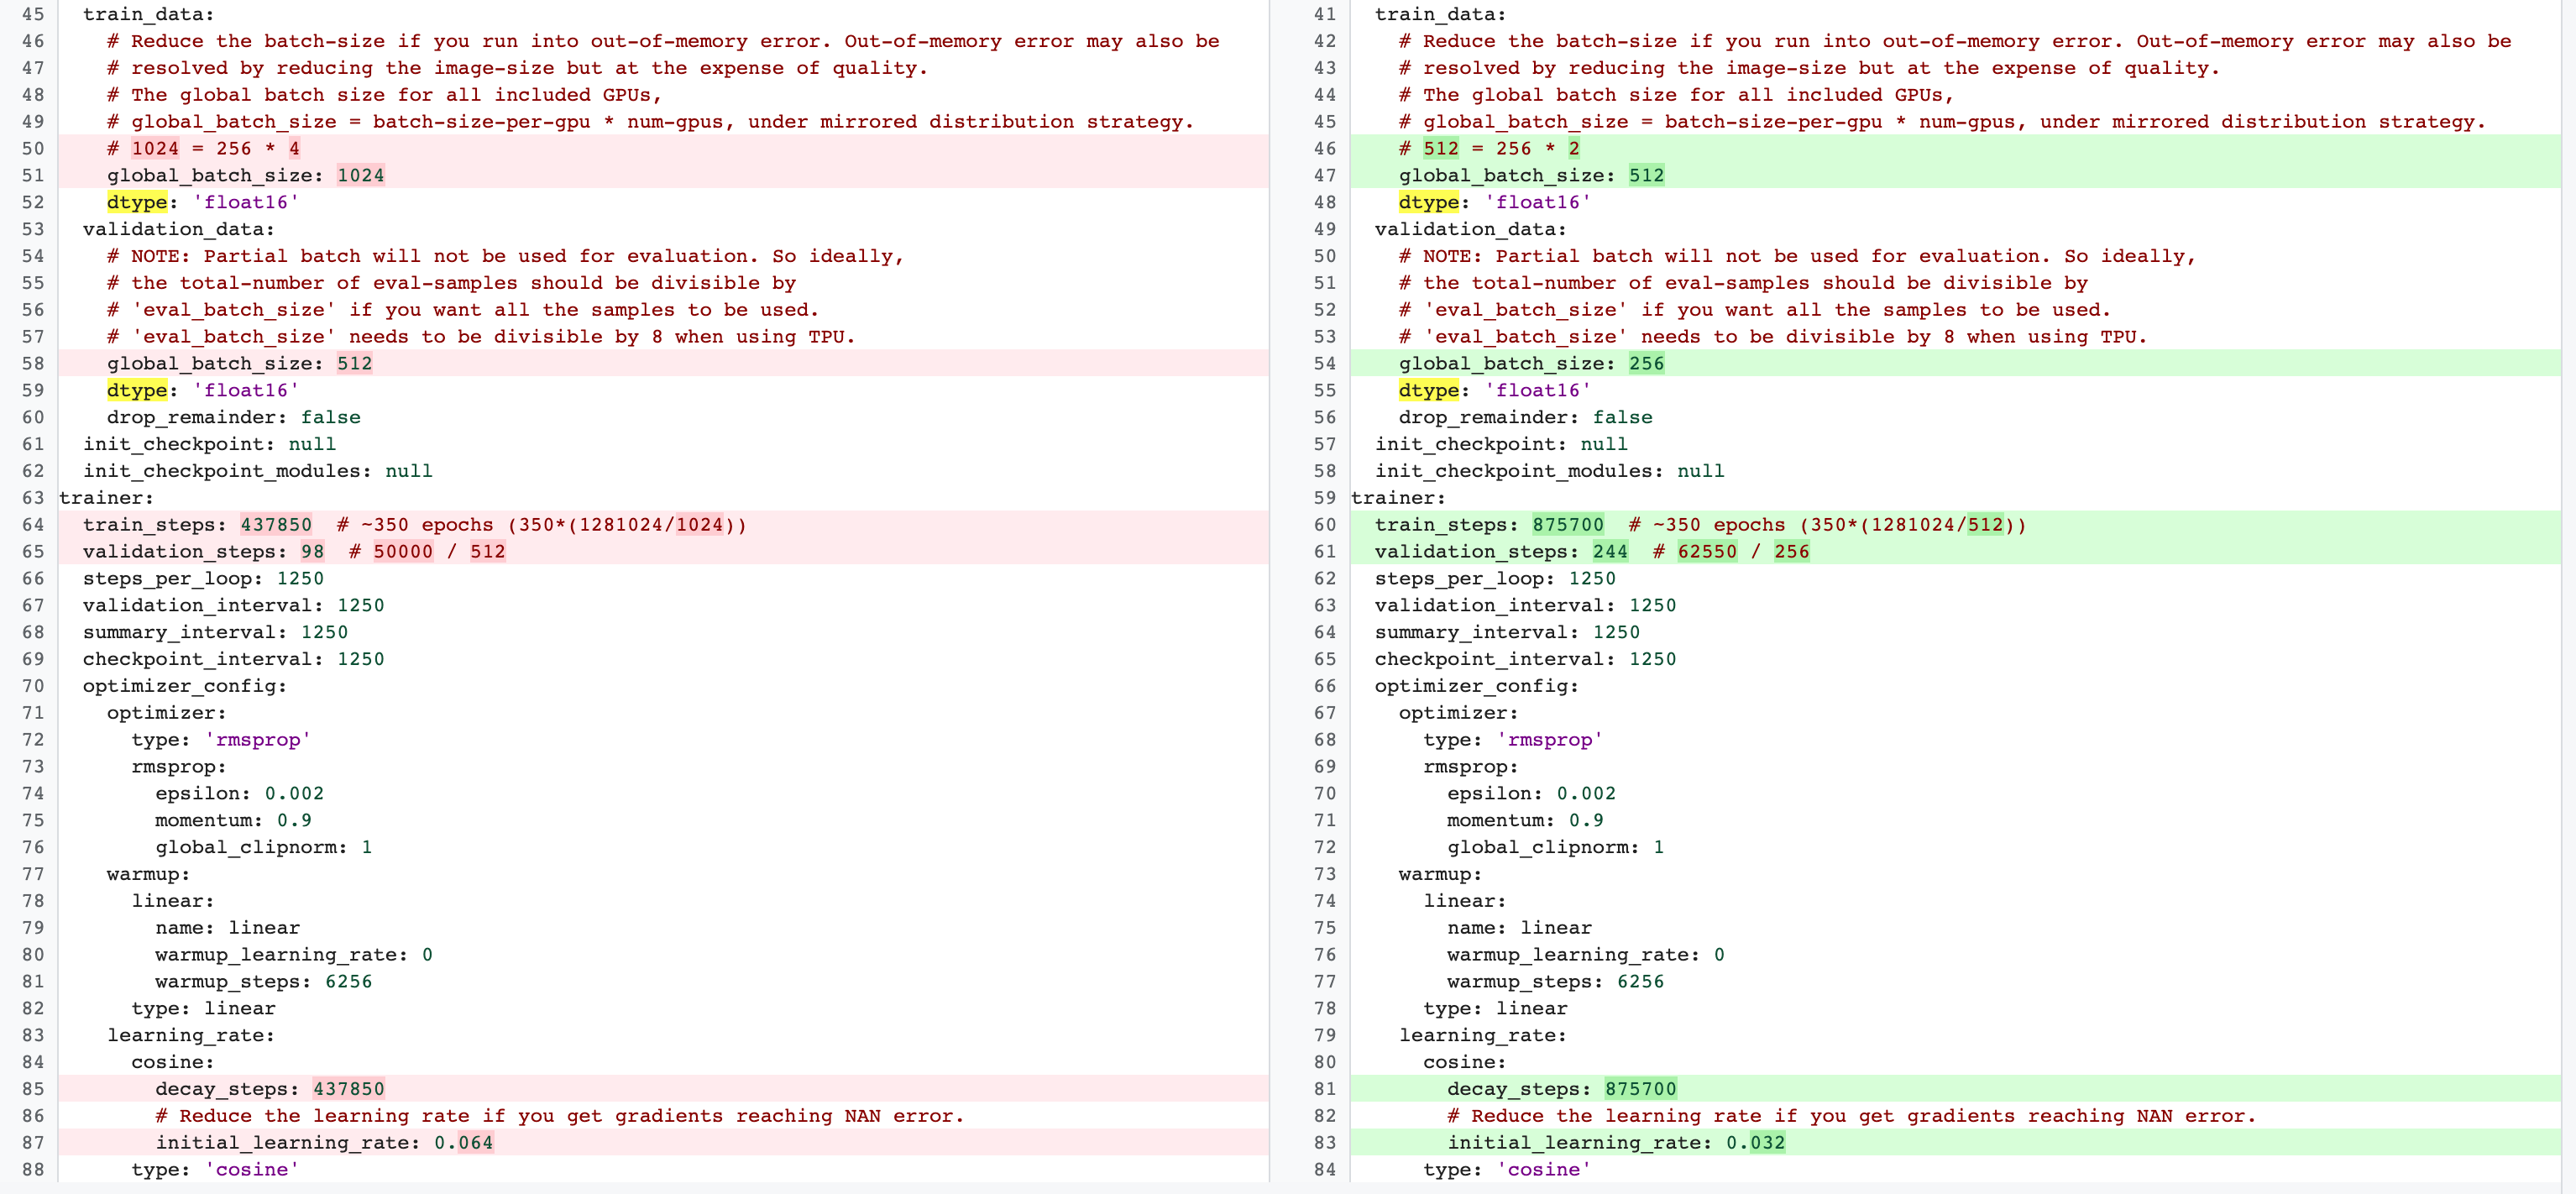
יש הבדלים בין ההגדרות של אימון מלא בשלב 2 לבין ההגדרות של אימון משימות פרוקסי בשלב 1. במשימת proxy, צריך להקטין את batch-size בהשוואה להגדרת האימון המלאה של קו הבסיס, כדי להשתמש רק ב-2 או ב-4 יחידות GPU.
בדרך כלל, אימון מלא משתמש ב-4, ב-8 או ביותר יחידות GPU, אבל משימת ה-proxy משתמשת רק ב-2 או ב-4 יחידות GPU.
הבדל נוסף הוא חלוקת הנתונים לאימון ולאימות.
לפניכם דוגמה לשינויים בהגדרות של MnasNet, שבהם נעשה מעבר מ-4 GPU לאימון מלא בשלב 2 ל-2 GPU וחלוקה שונה של אימות לחיפוש משימות של שרת proxy:
מריצים את הפקודה הבאה כדי להפעיל את המשימה של בקר החיפוש של ה-proxy (צריך חשבון שירות):
DATE="$(date '+%Y%m%d_%H%M%S')"
project_id=<your project-id>
# You can choose any unique docker id below.
trainer_docker_id=${USER}_trainer_${DATE}
trainer_docker_file=<path to your trainer dockerfile>
latency_calculator_docker_id=${USER}_model_selection_${DATE}
latency_calculator_docker_file=${USER}_latency_${DATE}
region=<your job region such as 'us-central1'>
search_space_module=<path to your NAS job search space module>
accelerator_type="NVIDIA_TESLA_V100"
num_gpus=2
# Your bucket should be for your project and in the same region as the job.
root_output_dir=<gs://your-bucket>
# Your latency computation device.
target_device_type="CPU"

####### Proxy task search related parameters ######
proxy_task_search_controller_docker_id=${USER}_proxy_task_search_${DATE}
job_name=<your job name>
# Path to your proxy task search space definition. For ex:
# 'proxy_task.proxy_task_search_spaces.mnasnet_proxy_task_config_generator'
proxy_task_config_generator_module=<path to your proxy task config generator module>
# The previous model-slection job provides the candidate-correlation-models
# and their scores.
proxy_task_model_selection_job_id=<Numeric job id of your previous model-selection>
# During proxy-task search, the proxy-task training is stopped
# when the following correlation score is achieved.
desired_accuracy_correlation=0.65
# During proxy-task search, the proxy-task training is stopped
# if the runtime exceeds this limit: 4 hrs.
training_time_hrs_limit=4
# The proxy-task is marked a good candidate only if the latency
# correlation is also above the required threshold.
# Note: This won't be used if you do not have a latency job.
desired_latency_correlation=0.65
# Early stop a proxy-task evaluation if you already have a better candidate.
# If False, evaluate all proxy-taask candidates.
early_stop_proxy_task_if_not_best=False
# Use the service account that you set-up for your project.
service_account=<your service account>
###################################################


python3 vertex_nas_cli.py build \
--project_id=${project_id} \
--region=${region} \
--trainer_docker_id=${trainer_docker_id} \
--trainer_docker_file=${trainer_docker_file} \
--latency_calculator_docker_id=${latency_calculator_docker_id} \
--latency_calculator_docker_file=${latency_calculator_docker_file} \
--proxy_task_search_controller_docker_id=${proxy_task_search_controller_docker_id}

# The command below passes 'dummy' arguments for trainer-docker
# and latency-docker. You need to modify them for your own docker.
python3 vertex_nas_cli.py search_proxy_task \
--service_account=${service_account} \
--proxy_task_search_controller_docker_id=${proxy_task_search_controller_docker_id} \
--proxy_task_config_generator_module=${proxy_task_config_generator_module} \
--proxy_task_model_selection_job_id=${proxy_task_model_selection_job_id} \
--proxy_task_model_selection_job_region=${region} \
--desired_accuracy_correlation={$desired_accuracy_correlation}\
--training_time_hrs_limit=${training_time_hrs_limit} \
--desired_latency_correlation=${desired_latency_correlation} \
--early_stop_proxy_task_if_not_best=${early_stop_proxy_task_if_not_best} \
--project_id=${project_id} \
--region=${region} \
--trainer_docker_id=${trainer_docker_id} \
--job_name=${job_name} \
--search_space_module=${search_space_module} \
--accelerator_type=${accelerator_type} \
--num_gpus=${num_gpus} \
--root_output_dir=${root_output_dir} \
--latency_calculator_docker_id=${latency_calculator_docker_id} \
--latency_docker_flags \
dummy_latency_flag1="dummy_latency_val" \
--target_device_type=${target_device_type} \
--search_docker_flags \
dummy_trainer_flag1="dummy_trainer_val"
אחרי שמפעילים את משימת בקר החיפוש של ה-proxy, מקבלים קישור למשימה. שם המשימה מתחיל בקידומת Search_controller_. דוגמה לממשק משתמש של משימה:
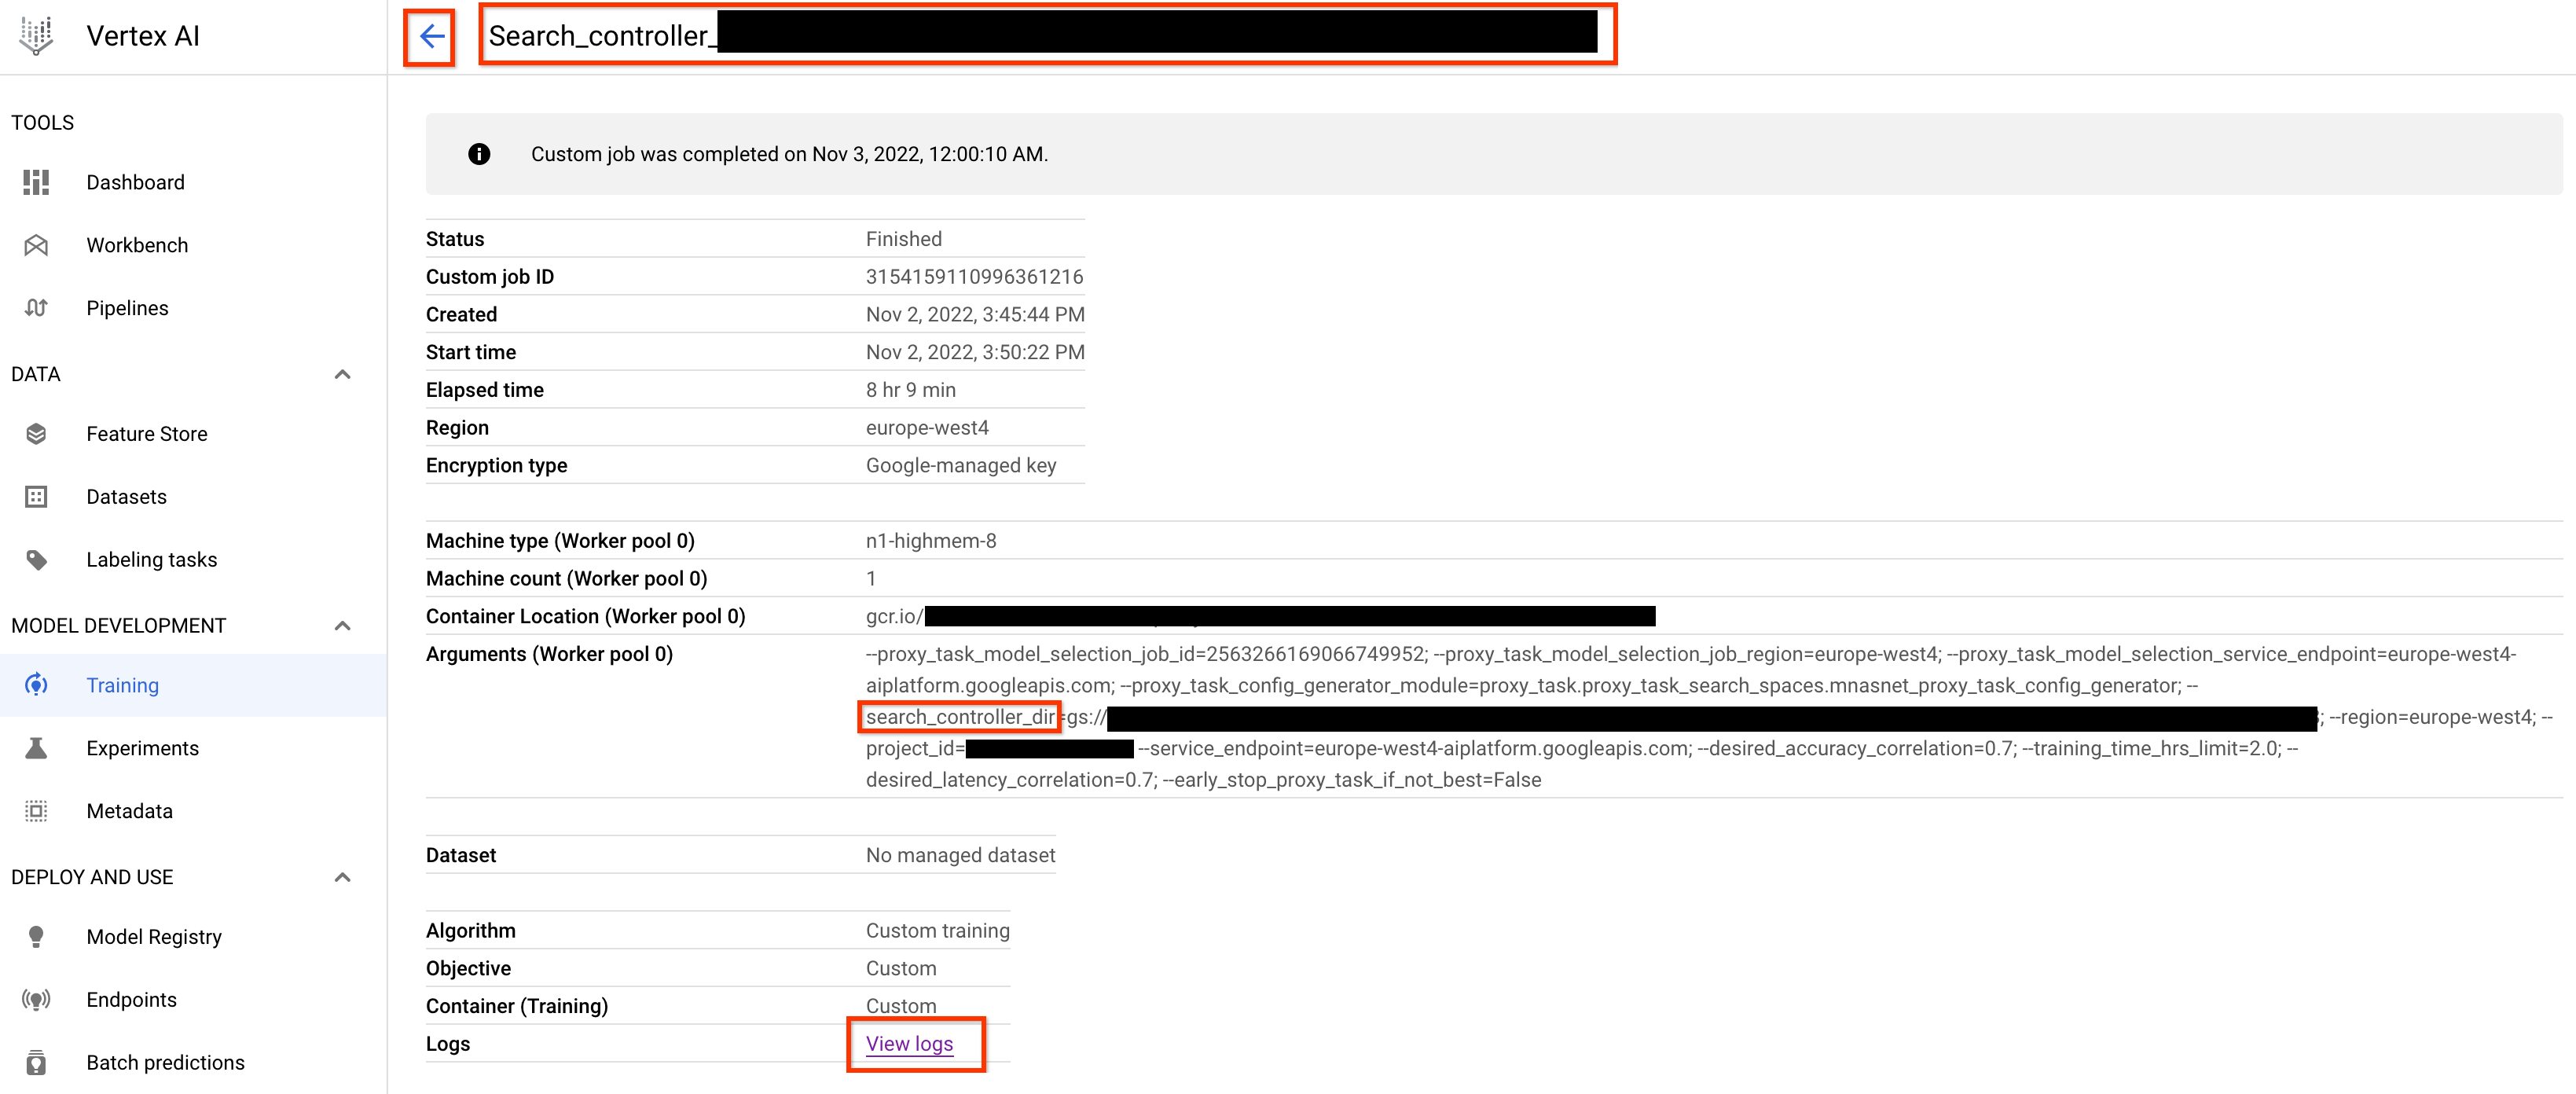
הפלט של הפקודה יופיע ב-search_controller_dir. אפשר לבדוק את היומנים בלחיצה על הקישור View logs. כברירת מחדל, העבודה הזו משתמשת במעבד אחד בענן כדי לפעול ברקע כעבודה בהתאמה אישית, ואז מפעילה ומנהלת עבודות של NAS צאצאות לכל הערכה של משימת proxy.
לכל משימת NAS של שרת proxy יש שם כמו ProxyTask_<your-job-name>_<proxy-task-name>, כאשר <proxy-task-name> הוא מה שמודול הגנרטור של הגדרות שרת ה-proxy מספק לכל משימת שרת proxy. רק הערכה אחת של שרת proxy מופעלת בכל פעם. אפשר גם להפעיל את הפקודה הבאה:
gcloud storage cat gs://<path to 'search_controller_dir'>/SEARCH_CONTROLLER_STATE.json
הפקודה הזו מציגה סיכום של כל ההערכות של משימות ה-proxy והמצב הנוכחי של משימת בקר החיפוש, שם המשימה וקישורים לכל הערכה:
{
  "proxy_tasks_map": {
    "mnasnet_proxy_training_data_pct_25": {
      "proxy_task_stats": {
        "training_steps": [
          1249,
          2499,
          ...,
          18749
        ],
        "accuracy_correlation_over_step": [
          -0.06666666666666667,
          -0.6,
          ...,
          0.7857142857142856
        ],
        "accuracy_correlation_p_value_over_step": [
          0.8618005952380953,
          0.016666115520282188,
          ...,
          0.005505952380952381
        ],
        "median_accuracy_over_step": [
          0.011478611268103123,
          0.04956454783678055,
          ...,
          0.32932570576667786
        ],
        "median_training_time_hrs_over_step": [
          0.11611097933475001,
          0.22913257125276987,
          ...,
          1.6682701704073444
        ],
        "latency_correlation": 0.9555555555555554,
        "latency_correlation_p_value": 5.5114638447971785e-06,
        "stopping_state": "Met desired correlation",
        "posted_stop_trials_message": true,
        "final_training_time_in_hours": 1.6675102778428197,
        "final_training_steps": 18512
      },
      "proxy_task_name": "mnasnet_proxy_training_data_pct_25",
      "search_job_name": "projects/123456/locations/europe-west4/nasJobs/4173661476642357248",
      "search_job_link": "https://console.cloud.google.com/agent-platform/locations/europe-west4/training/4173661476642357248/cpu?project=my-project",
      "latency_calculator_job_name": "projects/123456/locations/europe-west4/customJobs/8785347495069745152",
      "latency_calculator_job_link": "https://console.cloud.google.com/agent-platform/locations/europe-west4/training/8785347495069745152/cpu?project=my-project"
    },
    ...,
    "mnasnet_proxy_training_data_pct_95": {
      "proxy_task_stats": {
        "training_steps": [
          1249,
          ...,
          18749
        ],
        "accuracy_correlation_over_step": [
          -0.3333333333333333,
          ...,
          0.7857142857142856,
          -5.0
        ],
        "accuracy_correlation_p_value_over_step": [
          0.21637345679012346,
          ...,
          0.005505952380952381,
          -5.0
        ],
        "median_accuracy_over_step": [
          0.01120645459741354,
          ...,
          0.38238024711608887,
          -1.0
        ],
        "median_training_time_hrs_over_step": [
          0.11385884770307843,
          ...,
          1.5466042930547819,
          -1.0
        ],
        "latency_correlation": 0.9555555555555554,
        "latency_correlation_p_value": 5.5114638447971785e-06,
        "stopping_state": "Met desired correlation",
        "posted_stop_trials_message": true,
        "final_training_time_in_hours": 1.533235285929564,
        "final_training_steps": 17108
      },
      "proxy_task_name": "mnasnet_proxy_training_data_pct_95",
      "search_job_name": "projects/123456/locations/europe-west4/nasJobs/2341822328209408000",
      "search_job_link": "https://console.cloud.google.com/agent-platform/locations/europe-west4/training/2341822328209408000/cpu?project=my-project",
      "latency_calculator_job_name": "projects/123456/locations/europe-west4/customJobs/7575005095213924352",
      "latency_calculator_job_link": "https://console.cloud.google.com/agent-platform/locations/europe-west4/training/7575005095213924352/cpu?project=my-project"
    }
  },
  "best_proxy_task_name": "mnasnet_proxy_training_data_pct_75"
}
הפלט של proxy_tasks_map החנויות נשמר לכל הערכה של משימת פרוקסי, וbest_proxy_task_name נרשמת משימת הפרוקסי הטובה ביותר לחיפוש. כל רשומה של משימת פרוקסי כוללת נתונים נוספים כמו proxy_task_stats, שמתעדים את ההתקדמות של המתאם בין הדיוק, ערכי ה-p, דיוק חציוני וזמן אימון חציוני לאורך שלבי האימון. הוא גם מתעד את המתאם שקשור לזמן האחזור, אם רלוונטי, ומתעד את הסיבה להפסקת העבודה (למשל, חריגה ממגבלת זמן האימון) ואת שלב האימון שבו העבודה נעצרת. אפשר גם לראות את הנתונים הסטטיסטיים האלה כתרשימים. לשם כך, מעתיקים את התוכן של search_controller_dir לתיקייה המקומית על ידי הרצת הפקודה הבאה:
gcloud storage cp gs://<path to 'search_controller_dir'>/* /your/local/dir
ולבדוק את תמונות התרשים. לדוגמה, התרשים הבא מציג את המתאם של הדיוק לעומת זמן האימון עבור משימת ה-proxy הטובה ביותר:

החיפוש הסתיים ומצאת את ההגדרה הכי טובה של משימת proxy. עכשיו צריך לבצע את הפעולות הבאות:
- מגדירים את מספר שלבי האימון ל-
final_training_stepsשל משימת ה-proxy המנצחת. - מגדירים את השלבים של דעיכת הקוסינוס כך שיהיו זהים לערך
final_training_steps, כדי שקצב הלמידה יהיה כמעט אפס לקראת הסוף. - [אופציונלי] בסיום ההדרכה, מבצעים הערכה אחת של ציון האימות כדי לחסוך בעלויות של כמה הערכות.
שימוש במכשיר השהיה מקומי לחיפוש משימות של שרת proxy
כדי להשתמש במכשיר לחישוב זמן האחזור המקומי לחיפוש משימות של שרת proxy, מריצים את הפקודה search_proxy_task בלי הדגל latency docker והדגל latency-docker, כי לא רוצים להפעיל את latency docker ב- Google Cloud. לאחר מכן, מריצים את הפקודה run_latency_calculator_local שמתוארת במדריך 4 כדי להפעיל את העבודה של מחשבון זמן האחזור המקומי. במקום להעביר את הדגל --search_job_id, מעבירים את הדגל --controller_job_id עם מזהה העבודה המספרי של חיפוש משימות שרת ה-proxy שמתקבל אחרי שמריצים את הפקודה search_proxy_task.
המשך של עבודת בקר החיפוש של משימת ה-proxy
במצבים הבאים צריך להפעיל מחדש את העבודה של בקר החיפוש של משימות ה-proxy:
- התהליך של בקר החיפוש של משימת ה-proxy של ההורה מסתיים (מקרה נדיר).
- בטעות ביטלתם את המשימה של בקר החיפוש של משימת ה-proxy.
- אתם רוצים להרחיב את מרחב החיפוש של משימות הפרוקסי בהמשך (גם אחרי הרבה ימים).
קודם כל, אל תבטלו את עבודת האיטרציה של NAS של הילד (הכרטיסייה NAS)
אם היא כבר פועלת. לאחר מכן, כדי להמשיך את העבודה של בקר החיפוש של משימת ה-proxy של ההורה, מריצים את הפקודה search_proxy_task כמו קודם, אבל הפעם מעבירים את הדגל --previous_proxy_task_search_dir ומגדירים אותו לספריית הפלט של העבודה הקודמת של בקר החיפוש של משימת ה-proxy. משימת בקר החיפוש של ה-proxy שהופסקה ממשיכה לפעול כמו קודם, אחרי שהיא טוענת את המצב הקודם שלה מהספרייה.
בדיקות סופיות
שתי בדיקות סופיות למשימת ה-Proxy כוללות את טווח התגמול ושמירת הנתונים לניתוח אחרי החיפוש.
טווח התגמולים
התגמול שמדווח לבקר צריך להיות בטווח [1e-3, 10]. אם זה לא נכון, אפשר להגדיל באופן מלאכותי את התגמול כדי להשיג את היעד הזה.
שמירת נתונים לניתוח אחרי החיפוש
קוד משימת ה-proxy צריך לשמור מדדים ונתונים נוספים במיקום Cloud Storage, כדי שתוכלו לנתח את מרחב החיפוש בהמשך. Agent Platform Neural Architecture Search שלנו תומך רק בתיעוד של עד חמישה ערכים מסוג נקודה צפה (floating-point).other_metrics
כל המדדים הנוספים צריכים להישמר במיקום ב-Cloud Storage לצורך ניתוח מאוחר יותר.