


本頁面說明如何使用訓練好的預測模型建立預測。
如要建立預測,請直接向預測模型提出批次推論要求。指定輸入來源和輸出位置,以便儲存預測結果。
使用 AutoML 進行預測不適用於端點部署或線上推論。如要向預測模型要求線上推論,請使用預測適用的 Tabular Workflow。
您可以要求推論並附上說明 (也稱為特徵歸因),瞭解模型如何得出推論。本機特徵重要性值會指出各項特徵對推論結果的影響程度。如需概念總覽,請參閱「預測特徵歸因」。
事前準備
您必須先訓練預測模型,才能建立預測。詳情請參閱「訓練預測模型」。
輸入資料
批次推論要求的輸入資料,是模型用來建立預測的資料。您可以透過下列其中一種格式提供輸入資料:
- Cloud Storage 中的 CSV 物件
- BigQuery 資料表
建議您使用與訓練模型時相同的輸入資料格式。舉例來說,如果您使用 BigQuery 中的資料訓練模型,最好使用 BigQuery 資料表做為批次推論的輸入內容。Gemini Enterprise Agent Platform 會將所有 CSV 輸入欄位視為字串,因此混合訓練和輸入資料格式可能會導致錯誤。
資料來源必須包含表格型資料,其中包含用於訓練模型的所有資料欄 (順序不拘)。您可以加入訓練資料中沒有的資料欄,或訓練資料中有的資料欄,但排除用於訓練。這些額外資料欄會包含在輸出內容中,但不會影響預測結果。
輸入資料規定
預測模型的輸入內容必須符合下列規定:
- 時間欄中的所有值都必須存在且有效。
- 推論要求中使用的所有資料欄都必須存在於輸入資料中。如果資料欄空白或不存在,Agent Platform 會自動填補資料。
- 輸入資料和訓練資料的資料頻率必須相符。如果時間序列中缺少資料列,您必須根據適當的領域知識手動插入。
- 系統會從推論中移除時間戳記重複的時間序列。如要納入,請移除所有重複的時間戳記。
- 請提供每個時間序列的歷來資料,以便進行預測。為取得最準確的預測結果,資料量應等於模型訓練期間設定的脈絡窗口。舉例來說,如果情境視窗為 14 天,請提供至少 14 天的歷來資料。如果提供的資料較少,Agent Platform 會以空值填補資料。
- 預測會從時間序列的第一列 (依時間排序) 開始,目標欄中的值為空值。空值在時間序列中必須連續。舉例來說,如果目標資料欄是依時間排序,則單一時間序列不能有
1、2、null、3、4、null、null等值。如果是 CSV 檔案,Gemini Enterprise Agent Platform 會將空字串視為空值;如果是 BigQuery,則原生支援空值。
BigQuery 資料表
如果選擇 BigQuery 資料表做為輸入內容,請務必確保下列事項:
- BigQuery 資料來源資料表不得超過 100 GB。
- 如果資料表位於其他專案,您必須將
BigQuery Data Editor角色授予該專案中的 Agent Platform 服務帳戶。
CSV 檔案
如果選擇 Cloud Storage 中的 CSV 物件做為輸入內容,請務必確保下列事項:
- 資料來源開頭必須是含有資料欄名稱的標題列。
- 每個資料來源物件不得超過 10 GB。您可以新增多個檔案,總大小上限為 100 GB。
- 如果 Cloud Storage bucket 位於其他專案,您必須將
Storage Object Creator角色授予該專案中的 Agent Platform 服務帳戶。 - 所有字串都必須用雙引號 (") 括住。
輸出格式
批次推論要求的輸出格式不一定要與輸入格式相同。舉例來說,如果您使用 BigQuery 資料表做為輸入內容,可以將預測結果輸出至 Cloud Storage 中的 CSV 物件。
向模型提出批次推論要求
如要提出批次推論要求,可以使用 Google Cloud 控制台或 Agent Platform API。輸入資料來源可以是儲存在 Cloud Storage bucket 或 BigQuery 資料表中的 CSV 物件。視您提交的輸入資料量而定,批次推論工作可能需要一些時間才能完成。
Google Cloud 控制台
使用 Google Cloud 控制台要求批次推論。
- 前往 Google Cloud 控制台「Agent Platform」部分的「Batch inferences」(批次推論) 頁面。
- 按一下「建立」,開啟「新增批次推論」視窗。
- 在「Define your batch inference」(定義批次推論) 部分,完成下列步驟:
- 輸入批次推論的名稱。
- 在「Model name」(模型名稱),選取要用於這項批次推論的模型名稱。
- 在「Version」(版本) 部分,選取模型版本。
- 在「選取來源」部分,選取來源輸入資料是 Cloud Storage 中的 CSV 檔案,還是 BigQuery 中的資料表。
- 如果是 CSV 檔案,請指定 CSV 輸入檔案的 Cloud Storage 位置。
- 如果是 BigQuery 資料表,請指定資料表所在的專案 ID、BigQuery 資料集 ID,以及 BigQuery 資料表或檢視表 ID。
- 在「批次推論輸出」部分,選取「CSV」或「BigQuery」。
- 如果是 CSV,請指定 Gemini Enterprise Agent Platform 儲存輸出的 Cloud Storage bucket。
- 如果是 BigQuery,您可以指定專案 ID 或現有資料集:
- 如要指定專案 ID,請在「Google Cloud project ID」(Google Cloud 專案 ID) 欄位中輸入專案 ID。Gemini Enterprise Agent Platform 會為您建立新的輸出資料集。
- 如要指定現有資料集,請在「Google Cloud project ID」(Google Cloud 專案 ID) 欄位中輸入其 BigQuery 路徑,例如
bq://projectid.datasetid。
- 選用。如果輸出目的地是 BigQuery 或 Cloud Storage 上的 JSONL,除了推論之外,您還可以啟用特徵歸因。如要這麼做,請選取「Enable feature attributions for this model」(為這個模型啟用特徵歸因功能)。Cloud Storage 中的 CSV 不支援特徵歸因。瞭解詳情。
- 選用:批次推論的模型監控分析功能目前為預先發布版。請參閱必要條件,瞭解如何將偏誤偵測設定新增至批次推論工作。
- 按一下「為這項批次推論工作啟用模型監控功能」,將其切換為開啟。
- 選取「訓練資料來源」。輸入所選訓練資料來源的資料路徑或位置。
- 選用:在「Alert thresholds」(警告門檻) 下方,指定觸發警告的門檻。
- 在「Notification emails」(通知電子郵件) 部分,輸入一或多個電子郵件地址 (以半形逗號分隔),以便在模型超過快訊門檻時收到通知。
- 選用:在「Notification channels」(通知管道) 中,新增 Cloud Monitoring 管道,以便在模型超過快訊門檻時收到通知。您可以選取現有的 Cloud Monitoring 管道,或按一下「Manage notification channels」(管理通知管道) 建立新管道。控制台支援 PagerDuty、Slack 和 Pub/Sub 通知管道。
- 點選「建立」。
API:BigQuery
REST
您可以使用 batchPredictionJobs.create 方法要求批次推論。
使用任何要求資料之前,請先修改下列項目的值:
- LOCATION_ID:模型儲存及執行批次推論工作的區域。例如:
us-central1。 - PROJECT_ID:您的專案 ID。
- BATCH_JOB_NAME::批次工作的顯示名稱
- MODEL_ID:要用於推論的模型 ID
-
INPUT_URI:BigQuery 資料來源的參照。在表單中:
bq://bqprojectId.bqDatasetId.bqTableId
-
OUTPUT_URI:BigQuery 目的地 (推論寫入的位置) 的參照。指定專案 ID,並視需要指定現有資料集 ID。請使用下列格式:
bq://bqprojectId.bqDatasetId
bq://bqprojectId
- GENERATE_EXPLANATION:預設值為 false。設為 true 即可啟用特徵歸因。詳情請參閱「預測特徵歸因」。
HTTP 方法和網址:
POST https://LOCATION_ID-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION_ID/batchPredictionJobs
JSON 要求內文:
{
  "displayName": "BATCH_JOB_NAME",
  "model": "projects/PROJECT_ID/locations/LOCATION_ID/models/MODEL_ID",
  "inputConfig": {
    "instancesFormat": "bigquery",
    "bigquerySource": {
      "inputUri": "INPUT_URI"
    }
  },
  "outputConfig": {
    "predictionsFormat": "bigquery",
    "bigqueryDestination": {
      "outputUri": "OUTPUT_URI"
    }
  },
  "generate_explanation": GENERATE_EXPLANATION
}
如要傳送要求,請選擇以下其中一個選項:
curl
將要求主體儲存在名為 request.json 的檔案中,然後執行下列指令:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION_ID-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION_ID/batchPredictionJobs"
PowerShell
將要求主體儲存在名為 request.json 的檔案中,然後執行下列指令:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION_ID-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION_ID/batchPredictionJobs" | Select-Object -Expand Content
您應該會收到如下的 JSON 回覆:
{
  "name": "projects/PROJECT_ID/locations/LOCATION_ID/batchPredictionJobs/67890",
  "displayName": "batch_job_1 202005291958",
  "model": "projects/12345/locations/us-central1/models/5678",
  "state": "JOB_STATE_PENDING",
  "inputConfig": {
    "instancesFormat": "bigquery",
    "bigquerySource": {
      "inputUri": "INPUT_URI"
    }
  },
  "outputConfig": {
    "predictionsFormat": "bigquery",
    "bigqueryDestination": {
        "outputUri": bq://12345
    }
  },
  "dedicatedResources": {
    "machineSpec": {
      "machineType": "n1-standard-32",
      "acceleratorCount": "0"
    },
    "startingReplicaCount": 2,
    "maxReplicaCount": 6
  },
  "manualBatchTuningParameters": {
    "batchSize": 4
  },
  "outputInfo": {
    "bigqueryOutputDataset": "bq://12345.reg_model_2020_10_02_06_04
  }
  "state": "JOB_STATE_PENDING",
  "createTime": "2020-09-30T02:58:44.341643Z",
  "updateTime": "2020-09-30T02:58:44.341643Z",
}
Java
在試用這個範例之前,請先按照「使用用戶端程式庫的 Agent Platform 快速入門導覽課程」中的 Java 設定說明操作。
如要向 Agent Platform 進行驗證,請設定應用程式預設憑證。詳情請參閱「為本機開發環境設定驗證機制」。
在下列範例中,請將 INSTANCES_FORMAT 和 PREDICTIONS_FORMAT 替換為 `bigquery`。如要瞭解如何替換其他預留位置,請參閱本節的「REST & CMD LINE」分頁。Python
如要瞭解如何安裝或更新 Vertex AI SDK for Python,請參閱「安裝 Vertex AI SDK for Python」。詳情請參閱 Python API 參考文件。
API:Cloud Storage
REST
您可以使用 batchPredictionJobs.create 方法要求批次推論。
使用任何要求資料之前,請先修改下列項目的值:
- LOCATION_ID:模型儲存及執行批次推論工作的區域。例如:
us-central1。 - PROJECT_ID:
- BATCH_JOB_NAME::批次工作的顯示名稱
- MODEL_ID:要用於推論的模型 ID
-
URI:Cloud Storage bucket 的路徑 (URI),其中包含訓練資料。可以有多個。每個 URI 的格式如下:
gs://bucketName/pathToFileName
-
OUTPUT_URI_PREFIX:Cloud Storage 目的地路徑,推論結果會寫入該位置。Agent Platform 會將批次推論寫入這個路徑中,並加上時間戳記的子目錄。請將這個值設為採用下列格式的字串:
gs://bucketName/pathToOutputDirectory
- GENERATE_EXPLANATION:預設值為 false。設為 true 即可啟用特徵歸因。只有在輸出目的地為 JSONL 時,才能使用這個選項。 Cloud Storage 中的 CSV 不支援特徵歸因。詳情請參閱「預測特徵歸因」。
HTTP 方法和網址:
POST https://LOCATION_ID-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION_ID/batchPredictionJobs
JSON 要求內文:
{
  "displayName": "BATCH_JOB_NAME",
  "model": "projects/PROJECT_ID/locations/LOCATION_ID/models/MODEL_ID",
  "inputConfig": {
    "instancesFormat": "csv",
    "gcsSource": {
      "uris": [
        URI1,...
      ]
    },
  },
  "outputConfig": {
    "predictionsFormat": "csv",
    "gcsDestination": {
      "outputUriPrefix": "OUTPUT_URI_PREFIX"
    }
  },
  "generate_explanation": GENERATE_EXPLANATION
}
如要傳送要求,請選擇以下其中一個選項:
curl
將要求主體儲存在名為 request.json 的檔案中,然後執行下列指令:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://LOCATION_ID-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION_ID/batchPredictionJobs"
PowerShell
將要求主體儲存在名為 request.json 的檔案中,然後執行下列指令:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://LOCATION_ID-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/LOCATION_ID/batchPredictionJobs" | Select-Object -Expand Content
您應該會收到如下的 JSON 回覆:
{
  "name": "projects/PROJECT_ID/locations/LOCATION_ID/batchPredictionJobs/67890",
  "displayName": "batch_job_1 202005291958",
  "model": "projects/12345/locations/us-central1/models/5678",
  "state": "JOB_STATE_PENDING",
  "inputConfig": {
    "instancesFormat": "csv",
    "gcsSource": {
      "uris": [
        "gs://bp_bucket/reg_mode_test"
      ]
    }
  },
  "outputConfig": {
    "predictionsFormat": "csv",
    "gcsDestination": {
      "outputUriPrefix": "OUTPUT_URI_PREFIX"
    }
  },
  "dedicatedResources": {
    "machineSpec": {
      "machineType": "n1-standard-32",
      "acceleratorCount": "0"
    },
    "startingReplicaCount": 2,
    "maxReplicaCount": 6
  }
  "outputInfo": {
    "gcsOutputDataset": "OUTPUT_URI_PREFIX/prediction-batch_job_1 202005291958-2020-09-30T02:58:44.341643Z"
  }
  "state": "JOB_STATE_PENDING",
  "createTime": "2020-09-30T02:58:44.341643Z",
  "updateTime": "2020-09-30T02:58:44.341643Z",
}
Python
如要瞭解如何安裝或更新 Vertex AI SDK for Python,請參閱「安裝 Vertex AI SDK for Python」。詳情請參閱 Python API 參考文件。
擷取批次推論結果
Gemini Enterprise Agent Platform 會將批次推論的輸出內容傳送至您指定的目的地。目的地可以是 BigQuery 或 Cloud Storage。
不支援特徵歸因的 Cloud Storage 輸出。
BigQuery
輸出資料集
如果您使用 BigQuery,批次推論的輸出內容會儲存在輸出資料集中。如果您已向 Gemini Enterprise Agent Platform 提供資料集,資料集名稱 (BQ_DATASET_NAME) 就是您先前提供的名稱。如果您未提供輸出資料集,Gemini Enterprise Agent Platform 會為您建立一個。您可以按照下列步驟找出名稱 (BQ_DATASET_NAME):
- 前往 Google Cloud 控制台的 Gemini Enterprise Agent Platform「Batch inferences」(批次推論) 頁面。
- 選取您建立的推論。
-
輸出資料集會顯示在「Export location」(匯出位置)。資料集名稱的格式如下:
prediction_MODEL_NAME_TIMESTAMP
輸出資料表
輸出資料集包含下列三種輸出資料表中的一或多種:
-
推論表
這份資料表包含輸入資料中要求推論的每一列 (即 TARGET_COLUMN_NAME = null)。舉例來說,如果輸入內容包含 14 個目標資料欄的空值項目 (例如未來 14 天的銷售額),推論要求會傳回 14 個資料列,也就是每天的銷售額。如果推論要求超出模型的預測範圍,Gemini Enterprise Agent Platform 只會傳回預測範圍內的推論。
-
錯誤驗證表格
這個表格會針對批次推論前匯總階段發生的每個非重大錯誤,顯示一個資料列。每個非重大錯誤都對應到輸入資料中的一列,Agent Platform 無法傳回該列的預測結果。
-
錯誤表格
這個資料表會為批次推論期間發生的每個非重大錯誤建立一個資料列。每個非重大錯誤都對應到輸入資料中的一列,Agent Platform 無法傳回該列的預測結果。
預測表格
資料表名稱 (BQ_PREDICTIONS_TABLE_NAME) 是由「predictions_」加上批次推論工作開始的時間戳記組成:predictions_TIMESTAMP
如要擷取推論資料表,請按照下列步驟操作:
-
前往控制台的「BigQuery」頁面。
前往 BigQuery -
執行下列查詢:
SELECT * FROM BQ_DATASET_NAME.BQ_PREDICTIONS_TABLE_NAME
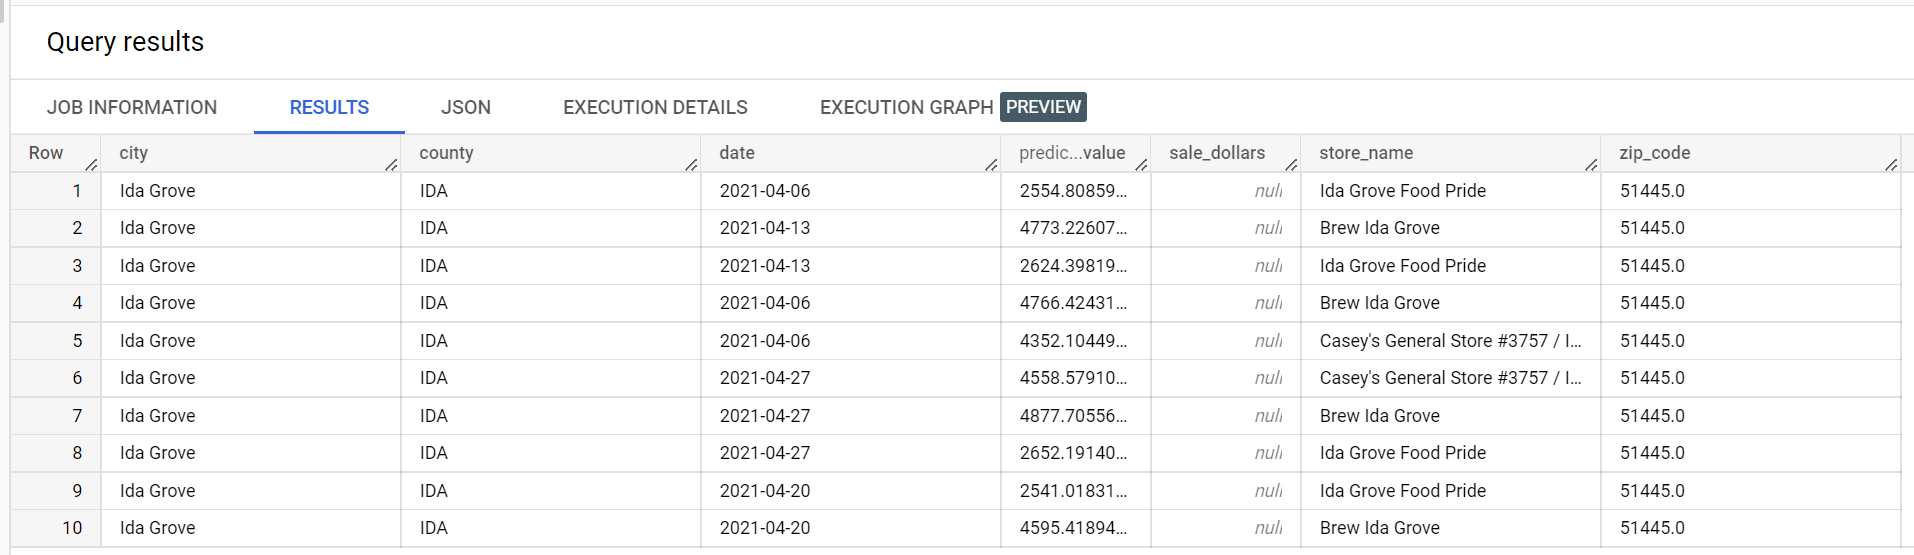
Gemini Enterprise Agent Platform 會將推論結果儲存在 predicted_TARGET_COLUMN_NAME.value 欄。
如果您使用 Temporal Fusion Transformer (TFT) 訓練模型,可以在 predicted_TARGET_COLUMN_NAME.tft_feature_importance 欄中找到 TFT 可解釋性輸出內容。
這個資料欄會進一步細分為以下項目:
context_columns:預測特徵,其情境視窗值會做為 TFT 長短期記憶 (LSTM) 編碼器的輸入內容。context_weights:與預測執行個體的各個context_columns相關聯的特徵重要性權重。horizon_columns:預測特徵,其預測時間範圍值會做為 TFT 長短期記憶 (LSTM) 解碼器的輸入內容。horizon_weights:與預測執行個體的各個horizon_columns相關聯的特徵重要性權重。attribute_columns:不隨時間變化的預測特徵。attribute_weights:與各attribute_columns相關聯的權重。
如果模型
已針對分位數損失進行最佳化,且分位數組合包含中位數,則 predicted_TARGET_COLUMN_NAME.value 是中位數的推論值。否則,predicted_TARGET_COLUMN_NAME.value 是集合中最低分位數的推論值。舉例來說,如果分位數組合為 [0.1, 0.5, 0.9],則 value 是分位數 0.5 的推論。如果分位數組合為 [0.1, 0.9],則 value 是分位數 0.1 的推論。
此外,Gemini Enterprise Agent Platform 會將分位數值和推論結果儲存在下列資料欄:
-
predicted_TARGET_COLUMN_NAME.quantile_values:分位數的值,在模型訓練期間設定。例如0.1、0.5和0.9。 -
predicted_TARGET_COLUMN_NAME.quantile_predictions:與分位數值相關聯的推論值。
如果模型使用機率推論,predicted_TARGET_COLUMN_NAME.value 會包含最佳化目標的最小化器。舉例來說,如果最佳化目標是 minimize-rmse,predicted_TARGET_COLUMN_NAME.value 會包含平均值。如果是 minimize-mae,predicted_TARGET_COLUMN_NAME.value 會包含中位數。
如果模型使用分位數機率推論,Gemini Enterprise Agent Platform 會將分位數值和推論儲存在下列資料欄:
-
predicted_TARGET_COLUMN_NAME.quantile_values:分位數的值,在模型訓練期間設定。例如0.1、0.5和0.9。 -
predicted_TARGET_COLUMN_NAME.quantile_predictions:與分位數值相關聯的推論值。
如果您啟用了特徵歸因,也可以在推論資料表中找到這些特徵。如要存取特徵 BQ_FEATURE_NAME 的歸因,請執行下列查詢:
SELECT explanation.attributions[OFFSET(0)].featureAttributions.BQ_FEATURE_NAME FROM BQ_DATASET_NAME.BQ_PREDICTIONS_TABLE_NAME
詳情請參閱「預測特徵歸因」。
錯誤驗證表格
資料表名稱 (BQ_ERRORS_VALIDATION_TABLE_NAME) 的格式為「errors_validation」加上批次推論工作開始的時間戳記:errors_validation_TIMESTAMP
-
前往控制台的「BigQuery」頁面。
前往 BigQuery -
執行下列查詢:
SELECT * FROM BQ_DATASET_NAME.BQ_ERRORS_VALIDATION_TABLE_NAME
- errors_TARGET_COLUMN_NAME
錯誤表格
資料表名稱 (BQ_ERRORS_TABLE_NAME) 是由「errors_」加上批次推論工作開始的時間戳記組成:errors_TIMESTAMP
-
前往控制台的「BigQuery」頁面。
前往 BigQuery -
執行下列查詢:
SELECT * FROM BQ_DATASET_NAME.BQ_ERRORS_TABLE_NAME
- errors_TARGET_COLUMN_NAME.code
- errors_TARGET_COLUMN_NAME.message
Cloud Storage
如果您指定 Cloud Storage 做為輸出目的地,批次推論要求的結果會以 CSV 物件的形式,傳回至指定 bucket 的新資料夾。資料夾名稱是模型名稱,前面加上「prediction-」,後面加上批次推論工作開始的時間戳記。您可以在模型的「Batch predictions」(批次預測) 分頁中找到 Cloud Storage 資料夾名稱。
Cloud Storage 資料夾包含兩種物件:-
推論物件
推論物件會命名為「predictions_1.csv」、「predictions_2.csv」等。其中包含含有資料欄名稱的標題列,以及每個傳回預測的資料列。推論值的數量取決於推論輸入和預測期。舉例來說,如果輸入內容包含 14 個目標資料欄的空值項目 (例如未來 14 天的銷售額),推論要求會傳回 14 列,也就是每天的銷售額。如果推論要求超出模型的預測期,Gemini Enterprise Agent Platform 只會傳回預測期內的推論。
預測值會傳回至名為「predicted_TARGET_COLUMN_NAME」的資料欄。如果是分位數預測,輸出資料欄會包含 JSON 格式的分位數推論和分位數值。
-
錯誤物件
錯誤物件的名稱為「errors_1.csv」、「errors_2.csv」等。 其中包含標頭列,以及輸入資料中 Agent Platform 無法傳回預測結果的每一列 (例如,不可為空值的特徵為空值)。
注意:如果結果很大,會分割成多個物件。
BigQuery 中的特徵歸因查詢範例
範例 1:判斷單一推論的歸因
請思考下列問題:
11 月 24 日,某家商店的產品廣告使預測銷售量增加了多少?
對應的查詢如下:
SELECT
  * EXCEPT(explanation, predicted_sales),
  ROUND(predicted_sales.value, 2) AS predicted_sales,
  ROUND(
    explanation.attributions[OFFSET(0)].featureAttributions.advertisement,
    2
  ) AS attribution_advertisement
FROM
  `project.dataset.predictions`
WHERE
  product = 'product_0'
  AND store = 'store_0'
  AND date = '2019-11-24'
範例 2:判斷全域特徵重要性
請思考下列問題:
各項特徵對整體預測銷售量的影響程度為何?
您可以彙整本機特徵重要性歸因,手動計算全域特徵重要性。對應的查詢如下:
WITH

/*
* Aggregate from (id, date) level attributions to global feature importance.
*/
attributions_aggregated AS (
 SELECT
   SUM(ABS(attributions.featureAttributions.date)) AS date,
   SUM(ABS(attributions.featureAttributions.advertisement)) AS advertisement,
   SUM(ABS(attributions.featureAttributions.holiday)) AS holiday,
   SUM(ABS(attributions.featureAttributions.sales)) AS sales,
   SUM(ABS(attributions.featureAttributions.store)) AS store,
   SUM(ABS(attributions.featureAttributions.product)) AS product,
 FROM
   project.dataset.predictions,
   UNNEST(explanation.attributions) AS attributions

),

/*
* Calculate the normalization constant for global feature importance.
*/
attributions_aggregated_with_total AS (
 SELECT
   *,
   date + advertisement + holiday + sales + store + product AS total
 FROM
   attributions_aggregated
)

/*
* Calculate the normalized global feature importance.
*/
SELECT
 ROUND(date / total, 2) AS date,
 ROUND(advertisement / total, 2) AS advertisement,
 ROUND(holiday / total, 2) AS holiday,
 ROUND(sales / total, 2) AS sales,
 ROUND(store / total, 2) AS store,
 ROUND(product / total, 2) AS product,
FROM
 attributions_aggregated_with_total
BigQuery 中的批次推論輸出內容範例
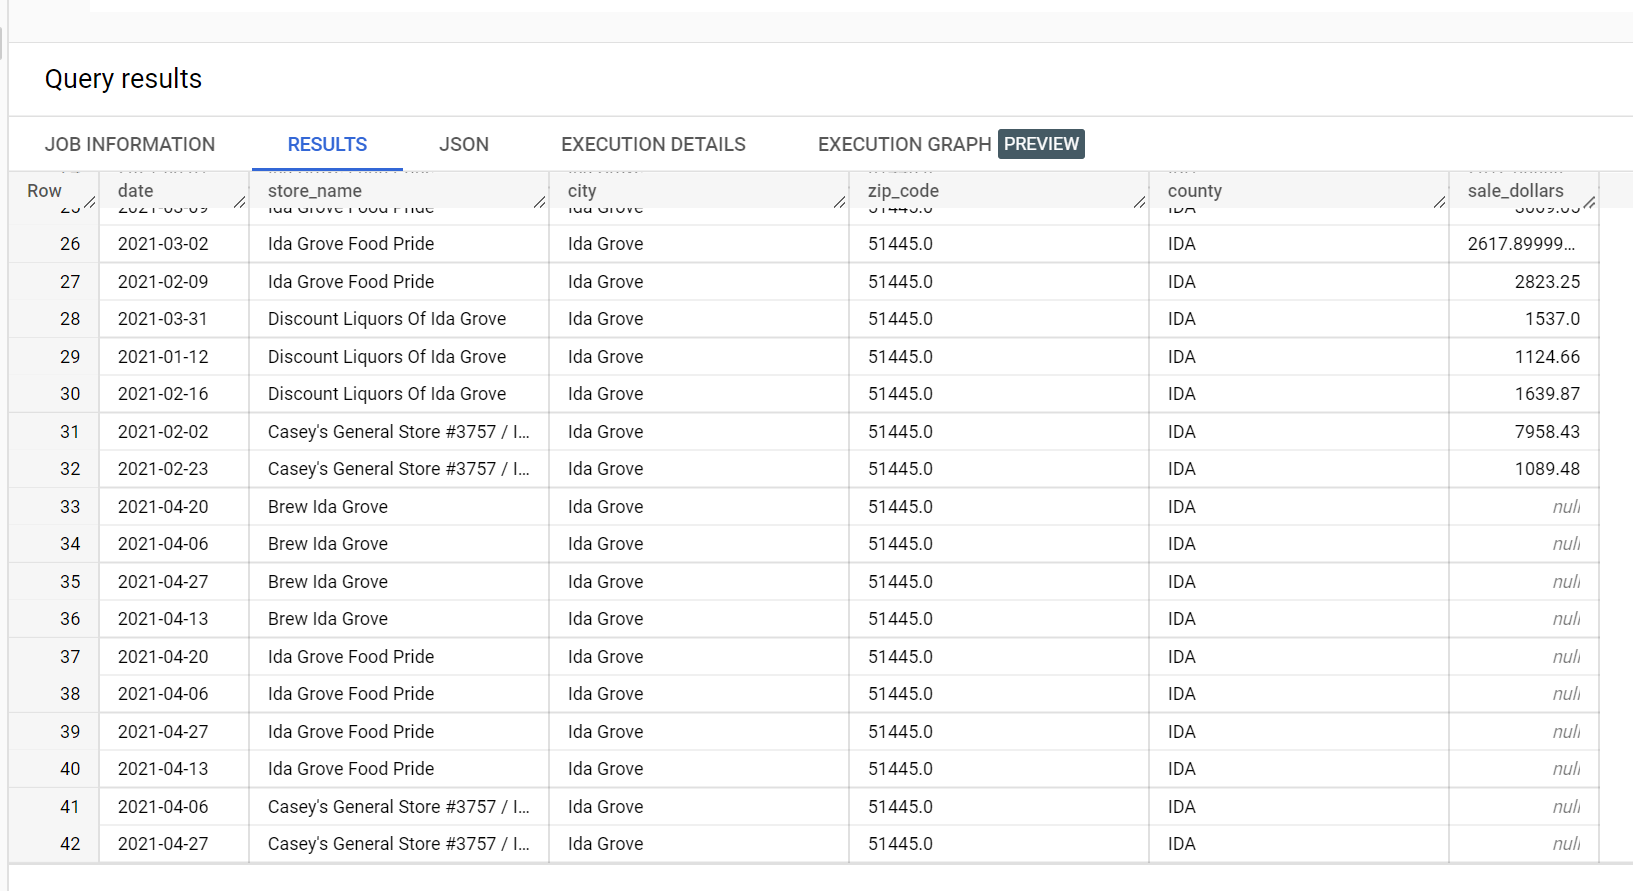
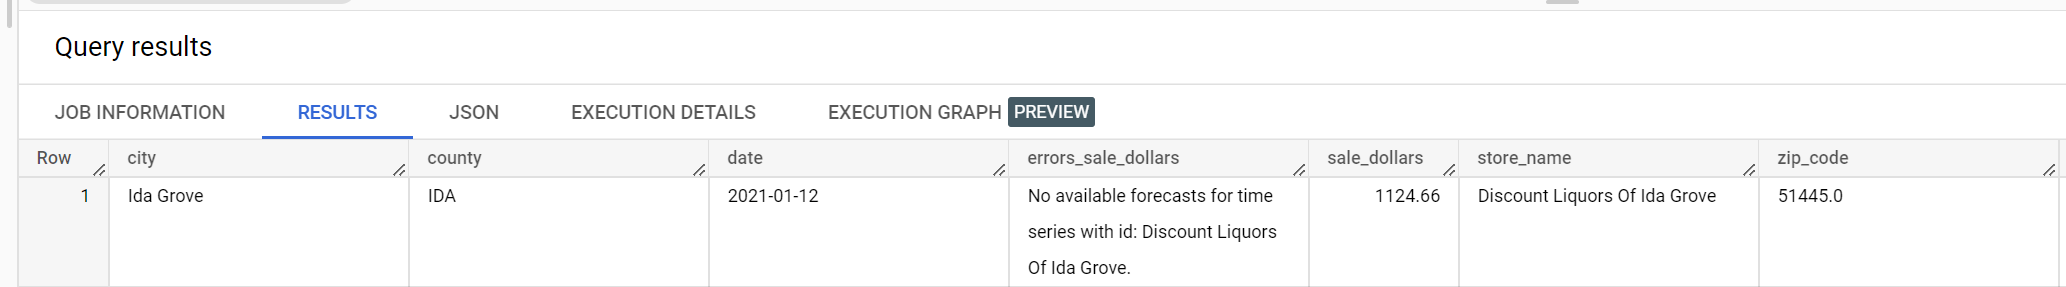
在酒類銷售的範例資料集中,「Ida Grove」市有四家商店:「Ida Grove Food Pride」、「Discount Liquors of Ida Grove」、「Casey's General Store #3757」和「Brew Ida Grove」。store_name 是 series identifier,四家商店中有三家要求推論目標欄 sale_dollars。由於未要求「Discount Liquors of Ida Grove」的預測,因此產生驗證錯誤。
以下是推論所用輸入資料集的摘錄:
以下是推論結果的擷取內容:
以下是驗證錯誤的摘要:
分位數損失最佳化模型的批次推論輸出內容範例
以下範例是分位數損失最佳化模型的批次推論輸出內容。在這個情境中,預測模型會預測每間商店未來 14 天的銷售量。
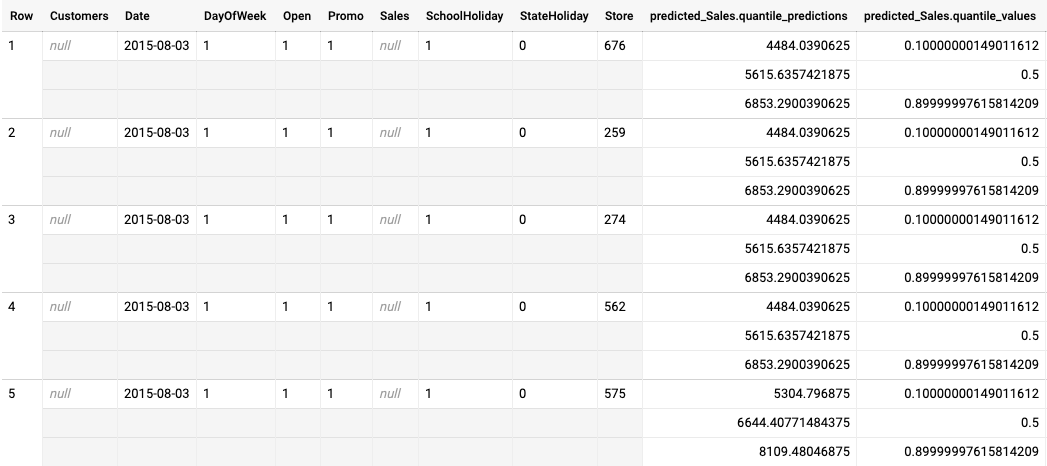
分位數值會顯示在 predicted_Sales.quantile_values 欄中。在本範例中,模型預測了 0.1、0.5 和 0.9 分位數的值。
推論值會顯示在 predicted_Sales.quantile_predictions 欄中。這是一組銷售值陣列,對應至 predicted_Sales.quantile_values 欄中的分位數值。在第一列中,我們可以看到銷售值低於 4484.04 的機率為 10%。銷售價值低於 5615.64 的機率為 50%。銷售價值低於 6853.29 的機率為 90%。第一列的推論結果為 5615.64,以單一值表示。