


בדף הזה מוסבר איך להגיש בקשות להסקת מסקנות באמצעות שרת NVIDIA Triton להסקת מסקנות, באמצעות Gemini Enterprise Agent Platform. שרת ההסקה NVIDIA Triton (Triton) הוא פתרון בקוד פתוח להצגת הסקות מבית NVIDIA, שעבר אופטימיזציה למעבדי CPU ו-GPU ומפשט את תהליך הצגת ההסקות.
NVIDIA Triton ב-Gemini Enterprise Agent Platform
ב-Gemini Enterprise Agent Platform אפשר לפרוס מודלים בשרת Triton להסקת מסקנות שפועל בקונטיינר בהתאמה אישית שפורסם על ידי NVIDIA GPU Cloud (NGC) – תמונת שרת Triton להסקת מסקנות של NVIDIA. קובצי האימג' של Triton מ-NVIDIA כוללים את כל החבילות וההגדרות הנדרשות שעומדות בדרישות של Gemini Enterprise Agent Platform לקובצי אימג' של קונטיינרים בהתאמה אישית. האימג' מכיל את שרת ההסקה של Triton עם תמיכה במודלים של TensorFlow, PyTorch, TensorRT, ONNX ו-OpenVINO. התמונה כוללת גם קצה עורפי של FIL (Forest Inference Library) שתומך בהפעלת מסגרות של למידת מכונה כמו XGBoost, LightGBM ו-Scikit-Learn.
Triton טוען את המודלים וחושף נקודות קצה (endpoint) של REST להסקה, לבדיקת תקינות ולניהול מודלים, שמשתמשות בפרוטוקולים סטנדרטיים של הסקה. כשפורסים מודל ב-Gemini Enterprise Agent Platform, Triton מזהה את הסביבות של Gemini Enterprise Agent Platform ומאמץ את הפרוטוקול של Vertex AI Inference לבדיקות תקינות ולבקשות להסקת מסקנות.
ברשימה הבאה מפורטות התכונות העיקריות ותרחישי השימוש של שרת ההסקה NVIDIA Triton:
- תמיכה בכמה מסגרות של למידת מכונה ולמידה עמוקה: Triton תומך בפריסה של כמה מודלים ובשילוב של מסגרות ופורמטים של מודלים – TensorFlow (SavedModel ו-GraphDef), PyTorch (TorchScript), TensorRT, ONNX, OpenVINO ורכיבי קצה עורפי של FIL לתמיכה במסגרות כמו XGBoost, LightGBM, Scikit-Learn וכל פורמט של מודל בהתאמה אישית ב-Python או ב-++C.
- הפעלה בו-זמנית של כמה מודלים: ב-Triton אפשר להפעיל בו-זמנית כמה מודלים, כמה מופעים של אותו מודל או גם וגם, באותו משאב מחשוב עם אפס או יותר מעבדי GPU.
- אנסמבל מודלים (שרשור או צינור עיבוד נתונים): אנסמבל Triton תומך בתרחישי שימוש שבהם כמה מודלים מורכבים כצינור עיבוד נתונים (או DAG, גרף אציקלי מכוון) עם טנזורים של קלט ופלט שמחוברים ביניהם. בנוסף, באמצעות קצה עורפי של Triton Python, אתם יכולים לכלול כל לוגיקה של עיבוד מקדים, עיבוד לאחר או בקרת זרימה שמוגדרת על ידי כתיבת סקריפט של לוגיקה עסקית (BLS).
- הרצה בקצוות עורפיים של CPU ו-GPU: ב-Triton יש תמיכה בהסקת מסקנות למודלים שנפרסו בצמתים עם מעבדי CPU ו-GPU.
- העברה דינמית של בקשות הסקה באצווה: במודלים שתומכים בהעברה באצווה, ל-Triton יש אלגוריתמים מובְנים לתזמון ולהעברה באצווה. האלגוריתמים האלה משלבים באופן דינמי בקשות הסקה נפרדות לקבוצות בצד השרת, כדי לשפר את תפוקת ההסקה ולהגביר את השימוש ב-GPU.
למידע נוסף על שרת ההסקה NVIDIA Triton, קראו את Triton.
קובצי אימג' זמינים של קונטיינר NVIDIA Triton
בטבלה הבאה מפורטים קובצי האימג' של Triton Docker שזמינים בקטלוג NVIDIA NGC. בוחרים קובץ אימג' בהתאם למסגרת המודל, לקצה העורפי ולגודל קובץ האימג' של הקונטיינר שבו אתם משתמשים.
xx ו-yy מתייחסים לגרסאות הראשיות והמשניות של Triton, בהתאמה.
| תמונת NVIDIA Triton | תמיכה |
|---|---|
xx.yy-py3 |
קונטיינר מלא עם תמיכה במודלים של TensorFlow, PyTorch, TensorRT, ONNX ו-OpenVINO |
xx.yy-pyt-python-py3 |
רק קצוות עורפיים של PyTorch ו-Python |
xx.yy-tf2-python-py3 |
רק קצוות עורפיים של TensorFlow 2.x ו-Python |
xx.yy-py3-min |
מתאימים אישית את מאגר Triton לפי הצורך |
תחילת העבודה: הצגת הסקות באמצעות NVIDIA Triton
בתרשים הבא מוצגת הארכיטקטורה הכללית של Triton ב-Vertex AI Inference:
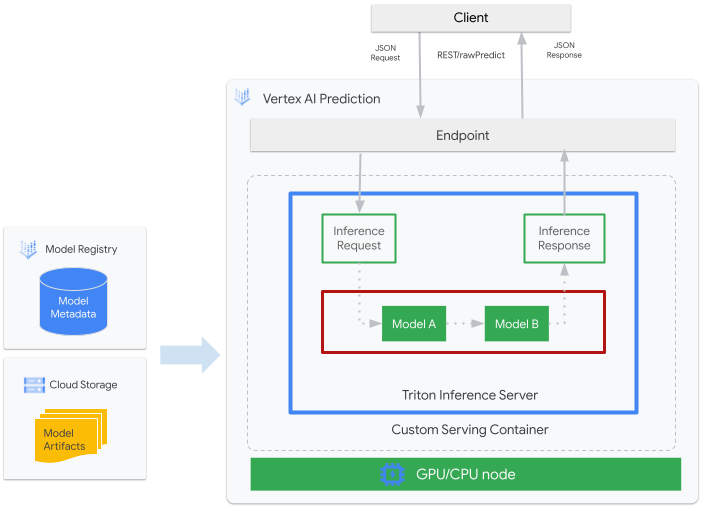
- מודל ML שמופעל על ידי Triton רשום במרשם המודלים של Gemini Enterprise Agent Platform. המטא-נתונים של המודל מפנים למיקום של פריטי המידע שנוצרו במודל ב-Cloud Storage, למאגר החוויות המוצגות בהתאמה אישית ולהגדרות שלו.
- המודל מ-Gemini Enterprise Agent Platform מרשם המודלים נפרס בנקודת קצה של Vertex AI Inference, שמריצה שרת Triton Inference כקונטיינר בהתאמה אישית בצומתי מחשוב עם מעבד (CPU) ומעבד גרפי (GPU).
- בקשות להסקת מסקנות מגיעות לשרת Triton להסקת מסקנות דרך נקודת קצה של Vertex AI Inference, ומנותבות למתזמן המתאים.
- ה-backend מבצע הסקה באמצעות הקלט שסופק בבקשות ה-batch ומחזיר תשובה.
- Triton מספק נקודות קצה לבדיקת תקינות (health endpoints) של מוכנות ופעילות, שמאפשרות לשלב את Triton בסביבות פריסה כמו Gemini Enterprise Agent Platform.
במדריך הזה נסביר איך משתמשים בקונטיינר בהתאמה אישית שמריץ שרת הסקה של NVIDIA Triton, כדי לפרוס מודל למידת מכונה (ML) ב-Gemini Enterprise Agent Platform שמספק הסקות אונליין. אתם פורסים קונטיינר שמריץ את Triton כדי להכניס לשימוש בסביבת הייצור הסקות ממודל זיהוי אובייקטים מ-TensorFlow Hub, שאומן מראש בקבוצת הנתונים COCO 2017. אחרי זה תוכלו להשתמש ב-Gemini Enterprise Agent Platform כדי לזהות אובייקטים בתמונה.
כדי להריץ את המדריך הזה ב-notebook:
פתיחה ב-Colab | פתיחה ב-Colab Enterprise | הצגה ב-GitHub | פתיחה ב-Vertex AI Workbench |לפני שמתחילים
- נכנסים לחשבון Google Cloud . אנחנו ממליצים למשתמשים חדשים ב- Google Cloud ליצור חשבון כדי שיוכלו להעריך את הביצועים של המוצרים שלנו בתרחישים מהעולם האמיתי. לקוחות חדשים מקבלים בחינם גם קרדיט בשווי 300$ להרצה, לבדיקה ולפריסה של עומסי העבודה.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Agent Platform API and Artifact Registry API APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
מפעילים את Cloud Shell במסוף Google Cloud .
בחלק התחתון של מסוף Google Cloud יתחיל סשן של Cloud Shell ותופיע הודעה של שורת הפקודה. Cloud Shell היא סביבת מעטפת שבה ה-CLI של Google Cloud מותקן ומוגדרים ערכים לפרויקט הקיים. הסשן יופעל תוך כמה שניות.
במדריך הזה מומלץ להשתמש ב-Cloud Shell כדי ליצור אינטראקציה עם Google Cloud. אם אתם רוצים להשתמש במעטפת Bash אחרת במקום ב-Cloud Shell, בצעו את ההגדרות הנוספות הבאות:
-
התקינו את ה-CLI של Google Cloud.
-
אם אתם משתמשים בספק זהויות חיצוני (IdP), קודם אתם צריכים להיכנס ל-CLI של gcloud באמצעות המאגר המאוחד לניהול זהויות.
-
כדי לאתחל את ה-CLI של gcloud, הריצו את הפקודה הבאה:
gcloud init - פועלים לפי ההוראות במאמרי העזרה של Artifact Registry כדי להתקין את Docker.
יצירה ודחיפה של קובץ האימג' של הקונטיינר
כדי להשתמש בקונטיינר בהתאמה אישית, צריך לציין קובץ אימג' של קונטיינר Docker שעומד בדרישות של קונטיינר בהתאמה אישית. בקטע הזה מוסבר איך ליצור את קובץ האימג' של הקונטיינר ולהעביר אותו ל-Artifact Registry.
הורדת פריטי מידע שנוצרו על ידי המודל
פריטי מידע שנוצרו בתהליך הפיתוח של המודל הם קבצים שנוצרים באימון של למידת מכונה, ואפשר להשתמש בהם כדי להציג הסקות. הם מכילים, לכל הפחות, את המבנה ואת המשקלים של מודל ה-ML המאומן. הפורמט של פריטי המידע שנוצרו בתהליך הפיתוח של המודל תלוי ב-framework של למידת המכונה שמשמש לאימון.
במדריך הזה, במקום לאמן מודל מאפס, תורידו מ-TensorFlow Hub את המודל לזיהוי אובייקטים שאומן באמצעות מערך הנתונים COCO 2017.
כדי להציג את הפורמט TensorFlow SavedModel, צריך לארגן את מאגר המודלים של Triton במבנה הבא:
└── model-repository-path
       └── model_name
              ├── config.pbtxt
              └── 1
                  └── model.savedmodel
                        └── <saved-model-files>
הקובץ config.pbtxt מתאר את הגדרת המודל. כברירת מחדל, צריך לספק את קובץ התצורה של המודל שמכיל את ההגדרות הנדרשות. עם זאת, אם מפעילים את Triton עם האפשרות --strict-model-config=false, במקרים מסוימים Triton יכול ליצור באופן אוטומטי את הגדרת המודל, ואין צורך לספק אותה באופן מפורש.
באופן ספציפי, מודלים של TensorRT, TensorFlow SavedModel ו-ONNX לא דורשים קובץ תצורה של מודל, כי Triton יכול להפיק את כל ההגדרות הנדרשות באופן אוטומטי. בכל שאר סוגי המודלים צריך לספק קובץ תצורה של המודל.
# Download and organize model artifacts according to the Triton model repository spec
mkdir -p models/object_detector/1/model.savedmodel/
curl -L "https://tfhub.dev/tensorflow/faster_rcnn/resnet101_v1_640x640/1?tf-hub-format=compressed" | \
    tar -zxvC ./models/object_detector/1/model.savedmodel/
ls -ltr ./models/object_detector/1/model.savedmodel/
אחרי שמורידים את המודל באופן מקומי, מאגר המודלים יהיה מאורגן כך:
./models
└── object_detector
    └── 1
        └── model.savedmodel
            ├── saved_model.pb
            └── variables
                ├── variables.data-00000-of-00001
                └── variables.index
העתקת פריטי מידע שנוצרו על ידי המודל לקטגוריה של Cloud Storage
פריטי המידע שנוצרו מהמודל שהורדתם, כולל קובץ התצורה של המודל, נשלחים לקטגוריה של Cloud Storage שצוינה על ידי MODEL_ARTIFACTS_REPOSITORY. אפשר להשתמש בהם כשיוצרים את משאב המודל של Gemini Enterprise Agent Platform.
gcloud storage cp ./models/object_detector MODEL_ARTIFACTS_REPOSITORY/ --recursive
יצירת מאגר ב-Artifact Registry
יוצרים מאגר ב-Artifact Registry כדי לאחסן את קובץ האימג' של הקונטיינר שתיצרו בקטע הבא.
מפעילים בפרויקט את שירות Artifact Registry API.
gcloud services enable artifactregistry.googleapis.com
מריצים את הפקודה הבאה במעטפת כדי ליצור מאגר ב-Artifact Registry:
gcloud artifacts repositories create getting-started-nvidia-triton \
    --repository-format=docker \
    --location=LOCATION_ID \
    --description="NVIDIA Triton Docker repository"
מחליפים את LOCATION_ID באזור שבו Artifact Registry מאחסן את קובץ האימג' של הקונטיינר. בהמשך תצטרכו ליצור משאב מודל של Gemini Enterprise Agent Platform בנקודת קצה (endpoint) של מיקום שתואמת לאזור הזה, אז בחרו אזור שבו ל-Gemini Enterprise Agent Platform יש נקודת קצה של מיקום, כמו us-central1.
אחרי שהפעולה מסתיימת, הפקודה מדפיסה את הפלט הבא:
Created repository [getting-started-nvidia-triton].
יצירת קובץ האימג' של הקונטיינר
חברת NVIDIA מספקת קובצי אימג' של Docker כדי ליצור קובץ אימג' של קונטיינר שמריץ את Triton, ותואם לדרישות של קונטיינר בהתאמה אישית של פלטפורמת Gemini Enterprise Agent Platform לצורך הצגת מודעות. אפשר למשוך את קובץ האימג' באמצעות docker ולתייג את הנתיב ב-Artifact Registry שאליו קובץ האימג' יידחף.
NGC_TRITON_IMAGE_URI="nvcr.io/nvidia/tritonserver:22.01-py3"
docker pull $NGC_TRITON_IMAGE_URI
docker tag $NGC_TRITON_IMAGE_URI LOCATION_ID-docker.pkg.dev/PROJECT_ID/getting-started-nvidia-triton/vertex-triton-inference
מחליפים את מה שכתוב בשדות הבאים:
- LOCATION_ID: האזור של מאגר Artifact Registry, כמו שצוין בקטע הקודם
- PROJECT_ID: מזהה הפרויקט ב-Google Cloud
יכול להיות שהפקודה תפעל במשך כמה דקות.
הכנת קובץ מטען ייעודי (payload) לבדיקת בקשות להסקת מסקנות
כדי לשלוח לשרת של הקונטיינר בקשת הסקה, מכינים את המטען הייעודי (payload) עם קובץ תמונה לדוגמה באמצעות Python. מריצים את הסקריפט הבא ב-Python כדי ליצור את קובץ המטען הייעודי (payload):
import json
import requests

# install required packages before running
# pip install pillow numpy --upgrade
from PIL import Image
import numpy as np

# method to generate payload from image url
def generate_payload(image_url):
    # download image from url and resize
    image_inputs = Image.open(requests.get(image_url, stream=True).raw)
    image_inputs = image_inputs.resize((200, 200))

    # convert image to numpy array
    image_tensor = np.asarray(image_inputs)
    # derive image shape
    image_shape = [1] + list(image_tensor.shape)

    # create payload request
    payload = {
        "id": "0",
        "inputs": [
            {
                "name": "input_tensor",
                "shape": image_shape,
                "datatype": "UINT8",
                "parameters": {},
                "data": image_tensor.tolist(),
            }
        ],
    }

    # save payload as json file
    payload_file = "instances.json"
    with open(payload_file, "w") as f:
        json.dump(payload, f)
    print(f"Payload generated at {payload_file}")

    return payload_file

if __name__ == '__main__':
  image_url = "https://github.com/tensorflow/models/raw/master/research/object_detection/test_images/image2.jpg"
  payload_file = generate_payload(image_url)
סקריפט Python יוצר מטען ייעודי (payload) ומדפיס את התגובה הבאה:
Payload generated at instances.json
הפעלת מאגר הנתונים באופן מקומי (אופציונלי)
לפני שמעבירים את קובץ האימג' של הקונטיינר ל-Artifact Registry כדי להשתמש בו עם Gemini Enterprise Agent Platform, אפשר להריץ אותו כקונטיינר בסביבה המקומית כדי לוודא שהשרת פועל כמו שצריך:
כדי להריץ את קובץ האימג' של הקונטיינר באופן מקומי, מריצים את הפקודה הבאה במעטפת:
docker run -t -d -p 8000:8000 --rm \
  --name=local_object_detector \
  -e AIP_MODE=True \
  LOCATION_ID-docker.pkg.dev/PROJECT_ID/getting-started-nvidia-triton/vertex-triton-inference \
  --model-repository MODEL_ARTIFACTS_REPOSITORY \
  --strict-model-config=false
מחליפים את הערכים הבאים, כמו שעשיתם בקטע הקודם:
- LOCATION_ID: האזור של מאגר Artifact Registry, כמו שצוין בקטע הקודם.
- PROJECT_ID: המזהה של Google Cloud. פרויקט
- MODEL_ARTIFACTS_REPOSITORY: הנתיב ב-Cloud Storage שבו נמצאים פריטי המידע שנוצרו מהמודל.
הפקודה הזו מריצה קונטיינר במצב מנותק, וממפה את היציאה
8000של הקונטיינר ליציאה8000של הסביבה המקומית. התמונה של Triton מ-NGC מגדירה את Triton לשימוש ביציאה8000.כדי לשלוח לשרת של הקונטיינר בדיקת תקינות, מריצים את הפקודה הבאה במעטפת:
curl -s -o /dev/null -w "%{http_code}" http://localhost:8000/v2/health/readyאם הפעולה מצליחה, השרת מחזיר את קוד הסטטוס
200.מריצים את הפקודה הבאה כדי לשלוח לשרת של הקונטיינר בקשת הסקה באמצעות המטען הייעודי (payload) שנוצר קודם, ולקבל תגובות הסקה:
curl -X POST \
    -H "Content-Type: application/json" \
    -d @instances.json \
    localhost:8000/v2/models/object_detector/infer |
       jq -c '.outputs[] | select(.name == "detection_classes")'
הבקשה הזו משתמשת באחת מתמונות הבדיקה שכלולות בדוגמה לזיהוי אובייקטים של TensorFlow.
אם הפעולה מצליחה, השרת מחזיר את ההסקה הבאה:
{"name":"detection_classes","datatype":"FP32","shape":[1,300],"data":[38,1,...,44]}כדי לעצור את הקונטיינר, מריצים את הפקודה הבאה במעטפת:
docker stop local_object_detector

העברת קובץ האימג' של הקונטיינר ל-Artifact Registry
מגדירים את Docker כדי לגשת ל-Artifact Registry. אחר כך מעבירים את קובץ האימג' של הקונטיינר למאגר ב-Artifact Registry.
כדי לתת להתקנה המקומית של Docker הרשאה לשלוח ל-Artifact Registry באזור שבחרתם, מריצים את הפקודה הבאה במעטפת:
gcloud auth configure-docker LOCATION_ID-docker.pkg.dev- מחליפים את LOCATION_ID באזור שבו יצרתם את המאגר בקטע הקודם.
כדי להעביר את קובץ האימג' של הקונטיינר ל-Artifact Registry, מריצים את הפקודה הבאה במעטפת:
docker push LOCATION_ID-docker.pkg.dev/PROJECT_ID/getting-started-nvidia-triton/vertex-triton-inferenceמחליפים את הערכים הבאים, כמו שעשיתם בקטע הקודם:
- LOCATION_ID: האזור של מאגר Artifact Registry, כמו שצוין בקטע הקודם.
- PROJECT_ID: מזהה הפרויקט ב-Google Cloud.
פריסת המודל
בקטע הזה יוצרים מודל ונקודת קצה, ואז פורסים את המודל בנקודת הקצה.
יצירת מודל
כדי ליצור משאב Model שמשתמש בקונטיינר בהתאמה אישית שמריץ את Triton, משתמשים בפקודה gcloud ai models upload.
לפני שיוצרים את המודל, כדאי לקרוא את המאמר הגדרות של קונטיינרים בהתאמה אישית כדי להבין אם צריך לציין את השדות האופציונליים sharedMemorySizeMb, startupProbe ו-healthProbe בקונטיינר.
gcloud ai models upload \
    --region=LOCATION_ID \
    --display-name=DEPLOYED_MODEL_NAME \
    --container-image-uri=LOCATION_ID-docker.pkg.dev/PROJECT_ID/getting-started-nvidia-triton/vertex-triton-inference \
    --artifact-uri=MODEL_ARTIFACTS_REPOSITORY \
    --container-args='--strict-model-config=false'
- LOCATION_ID: האזור שבו אתם משתמשים ב-Agent Platform.
- PROJECT_ID: מזהה הפרויקט ב-Google Cloud
-
DEPLOYED_MODEL_NAME: שם ל-
DeployedModel. אפשר להשתמש בשם המוצג שלModelגם בשבילDeployedModel.
הארגומנט --container-args='--strict-model-config=false' מאפשר ל-Triton ליצור את הגדרות המודל באופן אוטומטי.
יצירת נקודת קצה (endpoint)
כדי להשתמש במודל להצגת הסקות אונליין, צריך לפרוס אותו בנקודת קצה (endpoint). אם אתם פורסים מודל בנקודת קצה קיימת, אתם יכולים לדלג על השלב הזה. בדוגמה הבאה משתמשים בפקודה gcloud ai endpoints create:
gcloud ai endpoints create \
    --region=LOCATION_ID \
    --display-name=ENDPOINT_NAME
מחליפים את מה שכתוב בשדות הבאים:
- LOCATION_ID: האזור שבו אתם משתמשים ב-Agent Platform.
- ENDPOINT_NAME: השם המוצג של נקודת הקצה.
יכול להיות שיעברו כמה שניות עד שהכלי Google Cloud CLI ייצור את נקודת הקצה.
פריסת המודל בנקודת קצה (endpoint)
אחרי שנקודת הקצה מוכנה, פורסים את המודל בנקודת הקצה. כשפורסים מודל בנקודת קצה, השירות משייך משאבים פיזיים למודל שמריץ את Triton כדי להציג הסקות אונליין.
בדוגמה הבאה השתמשנו בפקודה gcloud ai endpoints deploy-model כדי לפרוס את Model ב-endpoint שמריץ את Triton ב-GPU, כדי להאיץ את הצגת ההסקה בלי לפצל את התנועה בין כמה משאבי DeployedModel:
ENDPOINT_ID=$(gcloud ai endpoints list \ --region=LOCATION_ID\ --filter=display_name=ENDPOINT_NAME\ --format="value(name)") MODEL_ID=$(gcloud ai models list \ --region=LOCATION_ID\ --filter=display_name=DEPLOYED_MODEL_NAME\ --format="value(name)") gcloud ai endpoints deploy-model $ENDPOINT_ID \ --region=LOCATION_ID\ --model=$MODEL_ID \ --display-name=DEPLOYED_MODEL_NAME\ --machine-type=MACHINE_TYPE\ --min-replica-count=MIN_REPLICA_COUNT\ --max-replica-count=MAX_REPLICA_COUNT\ --accelerator=count=ACCELERATOR_COUNT,type=ACCELERATOR_TYPE\ --traffic-split=0=100
מחליפים את מה שכתוב בשדות הבאים:
- LOCATION_ID: האזור שבו אתם משתמשים ב-Agent Platform.
- ENDPOINT_NAME: השם המוצג של נקודת הקצה.
-
DEPLOYED_MODEL_NAME: שם ל-
DeployedModel. אפשר להשתמש בשם המוצג שלModelגם בשבילDeployedModel. -
MACHINE_TYPE: אופציונלי. משאבי המכונה שמשמשים לכל צומת בפריסה הזו. הגדרת ברירת המחדל היא
n1-standard-2. מידע נוסף על סוגי מכונות - MIN_REPLICA_COUNT: המספר המינימלי של הצמתים לפריסה הזו. אפשר להגדיל או להקטין את מספר הצמתים בהתאם לעומס ההסקה, עד למספר המקסימלי של הצמתים, אבל אף פעם לא פחות מהמספר הזה.
- MAX_REPLICA_COUNT: המספר המקסימלי של הצמתים בפריסה הזו. אפשר להגדיל או להקטין את מספר הצמתים בהתאם לעומס ההסקה, עד למספר הצמתים הזה, ולא פחות ממספר הצמתים המינימלי.
ACCELERATOR_COUNT: מספר המאיצים שצריך לצרף לכל מכונה שמריצה את המשימה. בדרך כלל הערך הוא 1. אם לא מציינים ערך, ברירת המחדל היא 1.
ACCELERATOR_TYPE: ניהול הגדרות המאיץ להצגת GPU. כשפורסים מודל עם סוגי מכונות של Compute Engine, אפשר גם לבחור מאיץ GPU ולציין את הסוג שלו. האפשרויות הן
nvidia-tesla-a100,nvidia-tesla-p100,nvidia-tesla-p4,nvidia-tesla-t4ו-nvidia-tesla-v100.
יכול להיות שיעברו כמה שניות עד ש-Google Cloud CLI יפרוס את המודל בנקודת הקצה. אחרי שהמודל נפרס, הפקודה הזו מדפיסה את הפלט הבא:
Deployed a model to the endpoint xxxxx. Id of the deployed model: xxxxx.
קבלת הסקות אונליין מהמודל שנפרס
כדי להפעיל את המודל דרך נקודת הקצה של Vertex AI Inference, צריך להגדיר את בקשת ההסקה באמצעות אובייקט JSON סטנדרטי של בקשת הסקה
או אובייקט JSON של בקשת הסקה עם סיומת בינארית
, ולשלוח בקשה לנקודת הקצה של REST rawPredict ב-Gemini Enterprise Agent Platform.
בדוגמה הבאה משתמשים בפקודה gcloud ai endpoints raw-predict:
ENDPOINT_ID=$(gcloud ai endpoints list \
    --region=LOCATION_ID \
    --filter=display_name=ENDPOINT_NAME \
    --format="value(name)")

gcloud ai endpoints raw-predict $ENDPOINT_ID \
    --region=LOCATION_ID \
    --http-headers=Content-Type=application/json \
    --request=@instances.json
מחליפים את מה שכתוב בשדות הבאים:
- LOCATION_ID: האזור שבו אתם משתמשים ב-Agent Platform.
- ENDPOINT_NAME: השם המוצג של נקודת הקצה.
נקודת הקצה מחזירה את התגובה הבאה לבקשה תקינה:
{
    "id": "0",
    "model_name": "object_detector",
    "model_version": "1",
    "outputs": [{
        "name": "detection_anchor_indices",
        "datatype": "FP32",
        "shape": [1, 300],
        "data": [2.0, 1.0, 0.0, 3.0, 26.0, 11.0, 6.0, 92.0, 76.0, 17.0, 58.0, ...]
    }]
}
הסרת המשאבים
כדי להימנע מחיובים נוספים ב-Gemini Enterprise Agent Platform וב-Artifact Registry, מחקו את המשאבים ב- Google Cloud שיצרתם במהלך המדריך הזה:
כדי לבטל את הפריסה של המודל מנקודת הקצה ולמחוק את נקודת הקצה, מריצים את הפקודה הבאה במעטפת:
ENDPOINT_ID=$(gcloud ai endpoints list \
    --region=LOCATION_ID \
    --filter=display_name=ENDPOINT_NAME \
    --format="value(name)")

DEPLOYED_MODEL_ID=$(gcloud ai endpoints describe $ENDPOINT_ID \
    --region=LOCATION_ID \
    --format="value(deployedModels.id)")

gcloud ai endpoints undeploy-model $ENDPOINT_ID \
    --region=LOCATION_ID \
    --deployed-model-id=$DEPLOYED_MODEL_ID

gcloud ai endpoints delete $ENDPOINT_ID \
    --region=LOCATION_ID \
    --quiet
מחליפים את LOCATION_ID באזור שבו יצרתם את המודל בקטע הקודם.
כדי למחוק את המודל, מריצים את הפקודה הבאה במעטפת:
MODEL_ID=$(gcloud ai models list \
    --region=LOCATION_ID \
    --filter=display_name=DEPLOYED_MODEL_NAME \
    --format="value(name)")

gcloud ai models delete $MODEL_ID \
    --region=LOCATION_ID \
    --quiet
מחליפים את LOCATION_ID באזור שבו יצרתם את המודל בקטע הקודם.
כדי למחוק את המאגר ב-Artifact Registry ואת קובץ האימג' של הקונטיינר שבתוכו, מריצים את הפקודה הבאה במעטפת:
gcloud artifacts repositories delete getting-started-nvidia-triton \
  --location=LOCATION_ID \
  --quiet
מחליפים את LOCATION_ID באזור שבו יצרתם את מאגר Artifact Registry בקטע הקודם.
המאמרים הבאים
- במדריכים של NVIDIA Triton notebook מוסבר בהרחבה על דפוסי פריסה עם שרת ההסקה NVIDIA Triton ב-Gemini Enterprise Agent Platform.