אימון מודל באמצעות קוד מוכן מראש לעיבוד נתונים: מחברת
קל לארגן דפים בעזרת אוספים
אפשר לשמור ולסווג תוכן על סמך ההעדפות שלך.
מדעני נתונים משתמשים בדרך כלל בתהליך העבודה הבא: מאמנים מודל באופן מקומי (ב-Notebook), מתעדים את הפרמטרים, מתעדים את מדדי סדרת הזמנים של האימון ב-Vertex AI TensorBoard ומתעדים את מדדי ההערכה.
כמדען נתונים, אני רוצה שתהיה לי אפשרות לעשות שימוש חוזר בקוד לעיבוד מראש של נתונים שאחרים בחברה שלי כתבו, כדי לפשט את כל ה-data wrangling המורכב שאנחנו עושים ולהפוך אותו לתהליך סטנדרטי. אני רוצה שתהיה לי אפשרות:
שימוש בספריית עיבוד מקדים של נתונים ב-Python כדי לנקות קבוצת נתונים בזיכרון (Pandas Dataframe) ב-notebook.
לאמן מודל באמצעות Keras (שוב ב-notebook).
Notebook: ניסויים במודלים עם נתונים שעברו עיבוד מראש
ב-notebook "יצירת שושלת של Vertex AI Experiments לאימון בהתאמה אישית", תלמדו איך לשלב קוד עיבוד מראש ב-Vertex AI Experiments.
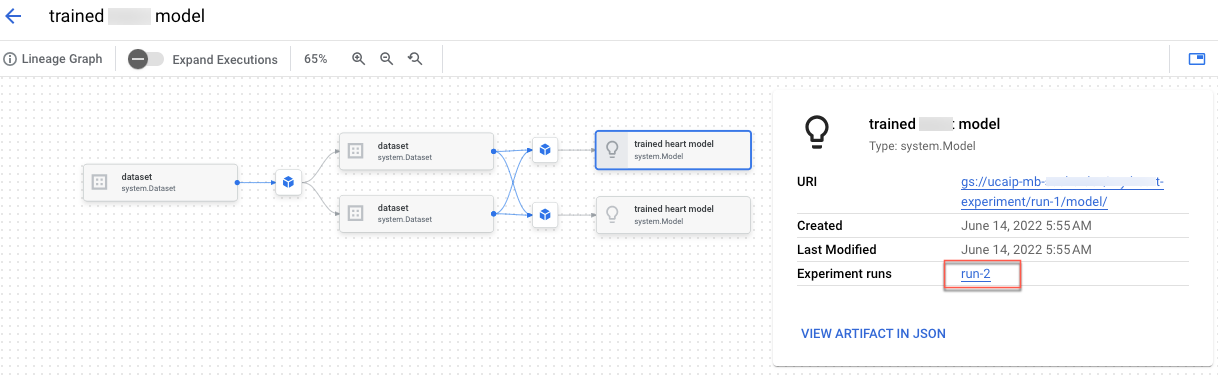
בנוסף, תבנו את שושלת הניסוי שמאפשרת לתעד, לנתח, לנפות באגים ולבדוק מטא-נתונים וארטיפקטים שנוצרו במהלך תהליך ה-ML.
אפשר לראות את שושלת היוחסין של פריט המידע במסוף Google Cloud .
[[["התוכן קל להבנה","easyToUnderstand","thumb-up"],["התוכן עזר לי לפתור בעיה","solvedMyProblem","thumb-up"],["סיבה אחרת","otherUp","thumb-up"]],[["התוכן קשה להבנה","hardToUnderstand","thumb-down"],["שגיאות בקוד לדוגמה או במידע","incorrectInformationOrSampleCode","thumb-down"],["חסרים לי פרטים או דוגמאות","missingTheInformationSamplesINeed","thumb-down"],["בעיה בתרגום","translationIssue","thumb-down"],["סיבה אחרת","otherDown","thumb-down"]],["עדכון אחרון: 2026-10-30 (שעון UTC)."],[],[]]