


總覽
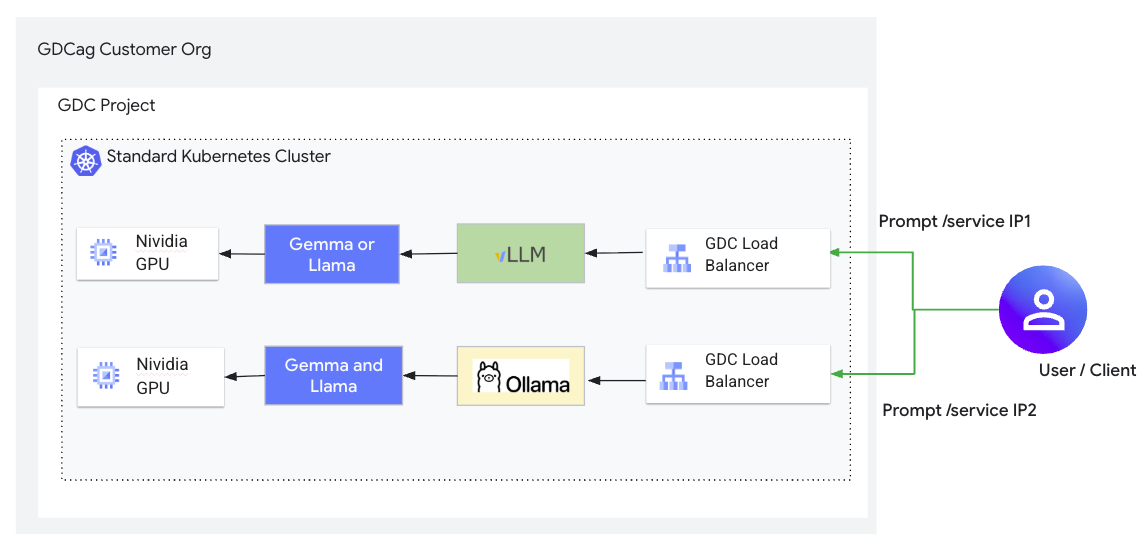
本文提供逐步說明,協助您在 Google Distributed Cloud (GDC) 實體隔離環境中,部署開放權重的大型語言模型 (LLM),例如 Gemma、Llama 和 DeepSeek。內容涵蓋如何使用 vLLM 進行高輸送量服務,以及如何使用 Ollama 簡化操作,並運用 GDC 平台的功能,包括 Kubernetes、Harbor 和 GPU 資源。
架構
這項解決方案會將容器化 LLM 服務後端 (vLLM、Ollama) 部署為使用者叢集內的部署項目。模型權重會儲存在永久磁碟區,並從 Harbor 登錄檔中的映像檔填入。LoadBalancer 類型的 Kubernetes 服務會公開後端的 API。專案網路政策可確保這些服務的存取安全。
事前準備
請確認符合下列必要條件:
- GDC 氣隙版本 1.15.1 以上。
- 建立使用者叢集時,資源 (CPU、記憶體、GPU) 充足。
- 至少須有 1 個 NVIDIA A100 GPU。
- 可存取且可用的 Harbor 執行個體。
kubectl和gdcloudCLI,並設定存取使用者叢集。- 已安裝 Docker 用戶端,並設定為推送至 Harbor。
- 已授予必要的 IAM 權限 (例如「命名空間管理員」、「叢集開發人員」**)。
- 如果使用封閉式模型,請設定 Hugging Face 帳戶並完成驗證。
第 1 節:一般設定
1.1 建立映像檔提取密鑰
如要在 GDC 實體隔離方案中為容器工作負載設定映像檔提取密碼,您需要建立 Kubernetes docker-registry 密碼,其中包含存取私人 Harbor 專案的憑證。然後在部署規格中參照這個密碼。
如要以程式輔助方式存取私人 Harbor 專案中的映像檔,請使用 Harbor 機器人帳戶。
請按照下列步驟設定映像檔提取密鑰:
建立 Harbor 機器人帳戶:
- 前往 Harbor 執行個體 UI。
- 前往 Harbor 專案。
- 選取「機器人帳戶」分頁標籤。
- 按一下「New Robot Account」。
- 為權杖命名 (例如
oss-llm-puller),並授予必要權限 (至少要有 pull 存取權),直到權杖過期為止。 - 安全地儲存機器人帳戶名稱 (例如
robot$oss-llm-puller) 和提供的密鑰權杖。
向 Harbor 驗證 Docker:
在已安裝 Docker 且可透過網路存取 Harbor 登錄檔的電腦上,使用機器人帳戶憑證登入:
export INSTANCE_URL="HARBOR_INSTANCE_URL"
# for example, harbor1-project1.org1.zone1.google.gdc.com

export ROBOT_NAME="ROBOT_ACCOUNT_NAME"
# for example, robot\$oss-llm-puller (note how we escape the $ character)

export ROBOT_SECRET="ROBOT_ACCOUNT_SECRET"

docker login ${INSTANCE_URL} --username ${ROBOT_NAME} --password ${ROBOT_SECRET}
建立 Kubernetes 映像檔提取密鑰:
使用 kubectl 在專案命名空間中建立 docker-registry 類型的祕密,並使用上一個步驟中更新的 Docker 設定檔:
# Log in into GDC environment using the next commands
gdcloud auth login --login-config-cert WEB_TLS_CERT_PATH
gdcloud clusters get-credentials KUBERNETES_CLUSTER
kubectl config set-context --current --namespace=NAMESPACE

export SECRET_NAME="OSS_LLM_PULL_SECRET"
export NAMESPACE="PROJECT_NAMESPACE"
# Assuming default Docker config path. Adjust if necessary.
export DOCKER_CONFIG_PATH="$HOME/.docker/config.json"

kubectl create secret docker-registry ${SECRET_NAME} \
      --from-file=.dockerconfigjson=${DOCKER_CONFIG_PATH} \
      -n ${NAMESPACE}
第 2 節:使用 vLLM 部署
2.1 取得 vLLM Docker 映像檔
在可連上網際網路的電腦上,提取 vLLM Docker 映像檔,然後轉移至 Harbor 專案:
# Pull and Tag vLLM (v0.13.0 recommended for stability)
docker pull vllm/vllm-openai:v0.13.0
docker tag vllm/vllm-openai:v0.13.0 HARBOR_URL/PROJECT/vllm-openai:v0.13.0
docker push HARBOR_URL/PROJECT/vllm-openai:v0.13.0
將 HARBOR_URL 和 PROJECT 替換成 Harbor 執行個體網址和專案名稱。
2.2 在 PVC 中準備模型權重
建立 YAML 檔案 (例如 model-pvc.yaml):
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: model-pvc
spec:
  accessModes:
  - ReadWriteOnce
  resources:
    requests:
      storage: 500Gi
  storageClassName: standard-rwo
  volumeMode: Filesystem
套用 PVC:kubectl apply -f model-pvc.yaml
從 Hugging Face 下載權重:
hf auth login
hf download google/gemma-3-4b-it
使用輔助 Pod (例如 helper-pod.yaml) 將權重轉移至 PVC。
確認 Harbor 中有 busybox 映像檔。
# Push busybox if not present
docker pull busybox:latest
docker tag busybox HARBOR_URL/PROJECT/busybox:latest
docker push HARBOR_URL/PROJECT/busybox:latest

# Contents of helper-pod.yaml
apiVersion: v1
kind: Pod
metadata:
  name: model-uploader
spec:
  containers:
  - name: uploader
    image: HARBOR_URL/PROJECT/busybox:latest
    command: ["sleep", "3600"]
    volumeMounts:
    - name: model-data
      mountPath: /data
  imagePullSecrets:
  - name: oss-llm-pull-secret
  volumes:
  - name: model-data
    persistentVolumeClaim:
      claimName: model-pvc
套用 Pod 並複製檔案:
kubectl apply -f helper-pod.yaml
# Wait for pod to be Running
kubectl cp ~/.cache/huggingface/hub/ NAMESPACE/model-uploader:/data/
kubectl delete pod model-uploader
2.3 部署 vLLM 後端
建立部署檔案 vllm-gemma-3-4b-it-deployment.yaml:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: gemma-3-4b-it
  labels:
    app: gemma-3-4b-it
spec:
  replicas: 1
  selector:
    matchLabels:
      app: gemma-3-4b-it
  template:
    metadata:
      labels:
        app: gemma-3-4b-it
    spec:
      volumes:
      - name: cache-volume
        persistentVolumeClaim:
          claimName: model-pvc
      - name: shm
        emptyDir:
          medium: Memory
          sizeLimit: "16Gi"
      containers:
      - name: gemma-3-4b-it
        image: HARBOR_URL/PROJECT/vllm-openai:v0.13.0
        command: ["python3"]
        args: [
          "-m",
          "vllm.entrypoints.openai.api_server",
          "--model",
          "google/gemma-3-4b-it",
          "--max-model-len",
          "32768",
          "--enforce-eager"
        ]
        env:
        - name: HF_HUB_OFFLINE
          value: "1"
        - name: HF_HOME
          value: "/model"
        - name: NCCL_P2P_DISABLE
          value: "1"
        - name: NCCL_IB_DISABLE
          value: "1"
        - name: BORINGSSL_FIPS
          value: "0"
        - name: OPENSSL_FIPS
          value: "0"
        - name: OPENSSL_CONF
          value: "/dev/null"
        - name: FIPS_SIG
          value: "off"
        ports:
        - containerPort: 8000
        securityContext:
          privileged: true
          runAsUser: 0
        resources:
          limits:
            nvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE: 1
            cpu: "8"
            memory: "64Gi"
          requests:
            nvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE: 1
            cpu: "8"
            memory: "32Gi"
        volumeMounts:
        - name: cache-volume
          mountPath: /model
        - name: shm
          mountPath: /dev/shm
      imagePullSecrets:
      - name: oss-llm-pull-secret
建立服務檔案 vllm-gemma-3-4b-it-service.yaml:
apiVersion: v1
kind: Service
metadata:
  name: gemma-3-4b-it
  namespace: NAMESPACE
spec:
  ports:
  - name: http-gemma-3-4b-it
    port: 80
    protocol: TCP
    targetPort: 8000
  selector:
    app: gemma-3-4b-it
  sessionAffinity: None
  type: LoadBalancer
套用設定:
kubectl apply -f vllm-gemma-3-4b-it-deployment.yaml
kubectl apply -f vllm-gemma-3-4b-it-service.yaml
2.4 設定網路政策
套用 ProjectNetworkPolicy 資源,允許輸入流量進入 vLLM 服務通訊埠 (8000)。建立 vllm-netpol.yaml:
apiVersion: networking.gdc.goog/v1
kind: ProjectNetworkPolicy
metadata:
  name: allow-vllm-ingress
  namespace: NAMESPACE
spec:
  subject:
    subjectType: UserWorkload
  policyType: Ingress
  ingress:
  - from:
    - ipBlock:
        cidr: 0.0.0.0/0 # Restrict this in production
    ports:
    - protocol: TCP
      port: 8000
套用政策:kubectl apply -f vllm-netpol.yaml
第 3 節:使用 Ollama 部署
3.1 準備 Dockerfile
建立 Dockerfile,使用預先載入的模型建構 Ollama 映像檔:
FROM ubuntu

RUN apt-get update && apt-get install -y --no-install-recommends curl ca-certificates zstd
RUN curl -fsSL https://ollama.com/install.sh -o install.sh
RUN chmod +x install.sh
RUN ./install.sh && \
    rm -rf /var/lib/apt/lists/*

# Pre-pull gemma3 model
RUN ollama serve & \
    sleep 5 && \
    curl --retry 10 --retry-connrefused -s http://localhost:11434 || true && \
    ollama pull gemma3:latest && \
    pkill ollama || true

EXPOSE 11434
CMD ["ollama", "serve"]
3.2 建構及推送映像檔
建構及推送映像檔:
docker build -t ollama-gemma3 .
docker tag ollama-gemma3 HARBOR_URL/PROJECT/ollama-gemma3:latest
docker push HARBOR_URL/PROJECT/ollama-gemma3:latest
3.3 部署 Ollama 後端
建立 ollama-gemma3.yaml:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ollama-gemma3
  namespace: NAMESPACE
  labels:
    app: ollama-gemma3
spec:
  replicas: 1
  selector:
    matchLabels:
      app: ollama-gemma3
  template:
    metadata:
      labels:
        app: ollama-gemma3
    spec:
      containers:
      - name: ollama-gemma3
        image: HARBOR_URL/PROJECT/ollama-gemma3:latest
        env:
        - name: OLLAMA_HOST
          value: "0.0.0.0"
        imagePullPolicy: Always
        ports:
        - containerPort: 11434
        securityContext:
          privileged: true
          runAsUser: 0
        resources:
          limits:
            nvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE: 1
          requests:
            nvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE: 1
      imagePullSecrets:
      - name: oss-llm-pull-secret
---
apiVersion: v1
kind: Service
metadata:
  name: ollama-gemma3
  namespace: NAMESPACE
spec:
  type: LoadBalancer
  selector:
    app: ollama-gemma3
  ports:
  - name: ollama-gemma3-port
    port: 11434
    protocol: TCP
    targetPort: 11434
套用資訊清單:kubectl apply -f ollama-gemma3.yaml
3.4 設定網路政策
建立 ollama-netpol.yaml:
apiVersion: networking.gdc.goog/v1
kind: ProjectNetworkPolicy
metadata:
  name: allow-ollama-ingress
  namespace: NAMESPACE
spec:
  subject:
    subjectType: UserWorkload
  policyType: Ingress
  ingress:
  - from:
    - ipBlock:
        cidr: 0.0.0.0/0 # Restrict this for production.
    ports:
    - protocol: TCP
      port: 11434
套用政策:kubectl apply -f ollama-netpol.yaml
第 4 節:驗證
檢查 Pod 狀態、服務 IP 位址,並使用 curl 將測試推論要求傳送至 vLLM 和 Ollama 的 LoadBalancer IP 位址,驗證部署作業。
確認所有容器和服務都已Running:
# Login into GDC air-gapped using the next commands
gdcloud auth login --login-config-cert WEB_TLS_CERT_PATH
gdcloud clusters get-credentials KUBERNETES_CLUSTER
kubectl config set-context --current --namespace=NAMESPACE

# Pods
kubectl get pods

# Services
kubectl get services
測試 vLLM:
export VLLM_IP=$(kubectl get service gemma-3-4b-it -n NAMESPACE -o jsonpath='{.status.loadBalancer.ingress[*].ip}')
curl http://${VLLM_IP}/v1/chat/completion \
  -H "Content-Type: application/json" \
  -d '{
    "model": "google/gemma-3-4b-it",
    "messages": [
      {"role": "user", "content": "What is Google Distributed Cloud air-gapped?"}
    ],
    "max_tokens": 100
  }'
測試 Ollama:
export OLLAMA_IP=$(kubectl get service ollama-gemma3 -n NAMESPACE -o jsonpath='{.status.loadBalancer.ingress[*].ip}')
# Check if Ollama is running
curl http://${OLLAMA_IP}:11434
# Send a completion request
curl -X POST http://${OLLAMA_IP}:11434/v1/completions \
-H "Content-Type: application/json" \
-d '{
  "model": "gemma3:latest",
  "prompt": "Google Distributed Cloud air-gapped is a",
  "max_tokens": 128,
  "temperature": 0.90,
  "stream": false
}'
第 5 節:操作和疑難排解
5.1 vLLM 作業
檢查記錄:kubectl logs -f -n NAMESPACE
查詢內部狀態 (來自偵錯 Pod):
wget -qO- http://gemma-3-4b-it/v1/models
wget -qO- http://gemma-3-4b-it/health
5.2 Ollama 作業
存取 CLI:kubectl exec -it -n NAMESPACE -- sh
Pod 內:ollama list、ollama ps
5.3 資源調度
使用 Ollama 後端擴充解決方案
垂直
- 為成為瓶頸的 LLM 分配較大的 GPU 區塊,直到您使用完整的 GPU 為止。
- 如果想使用較大的 LLM (例如 405B 參數 LLM,而非 7B 參數 LLM),以提高回覆準確度,可能需要多個 GPU 才能順利執行。
- 如果模型適用於多個 GPU,則會因 GPU 間的通訊而產生延遲。
水平
- 視需要部署任意數量的 Ollama Pod,在特定 LLM 上達到目標處理量。
- 如要達成這個目標,請在對應的 Ollama 部署 YAML 檔案中增加 replica 數量。
- Kubernetes 服務 (LoadBalancer 類型) 會在端點 (即 Pod) 之間分配程式碼輔助要求,並透過公開的外部 IP 傳回各自的回應。
- 請注意,Continue 外掛程式的每個功能只會指向一個 IP 位址。
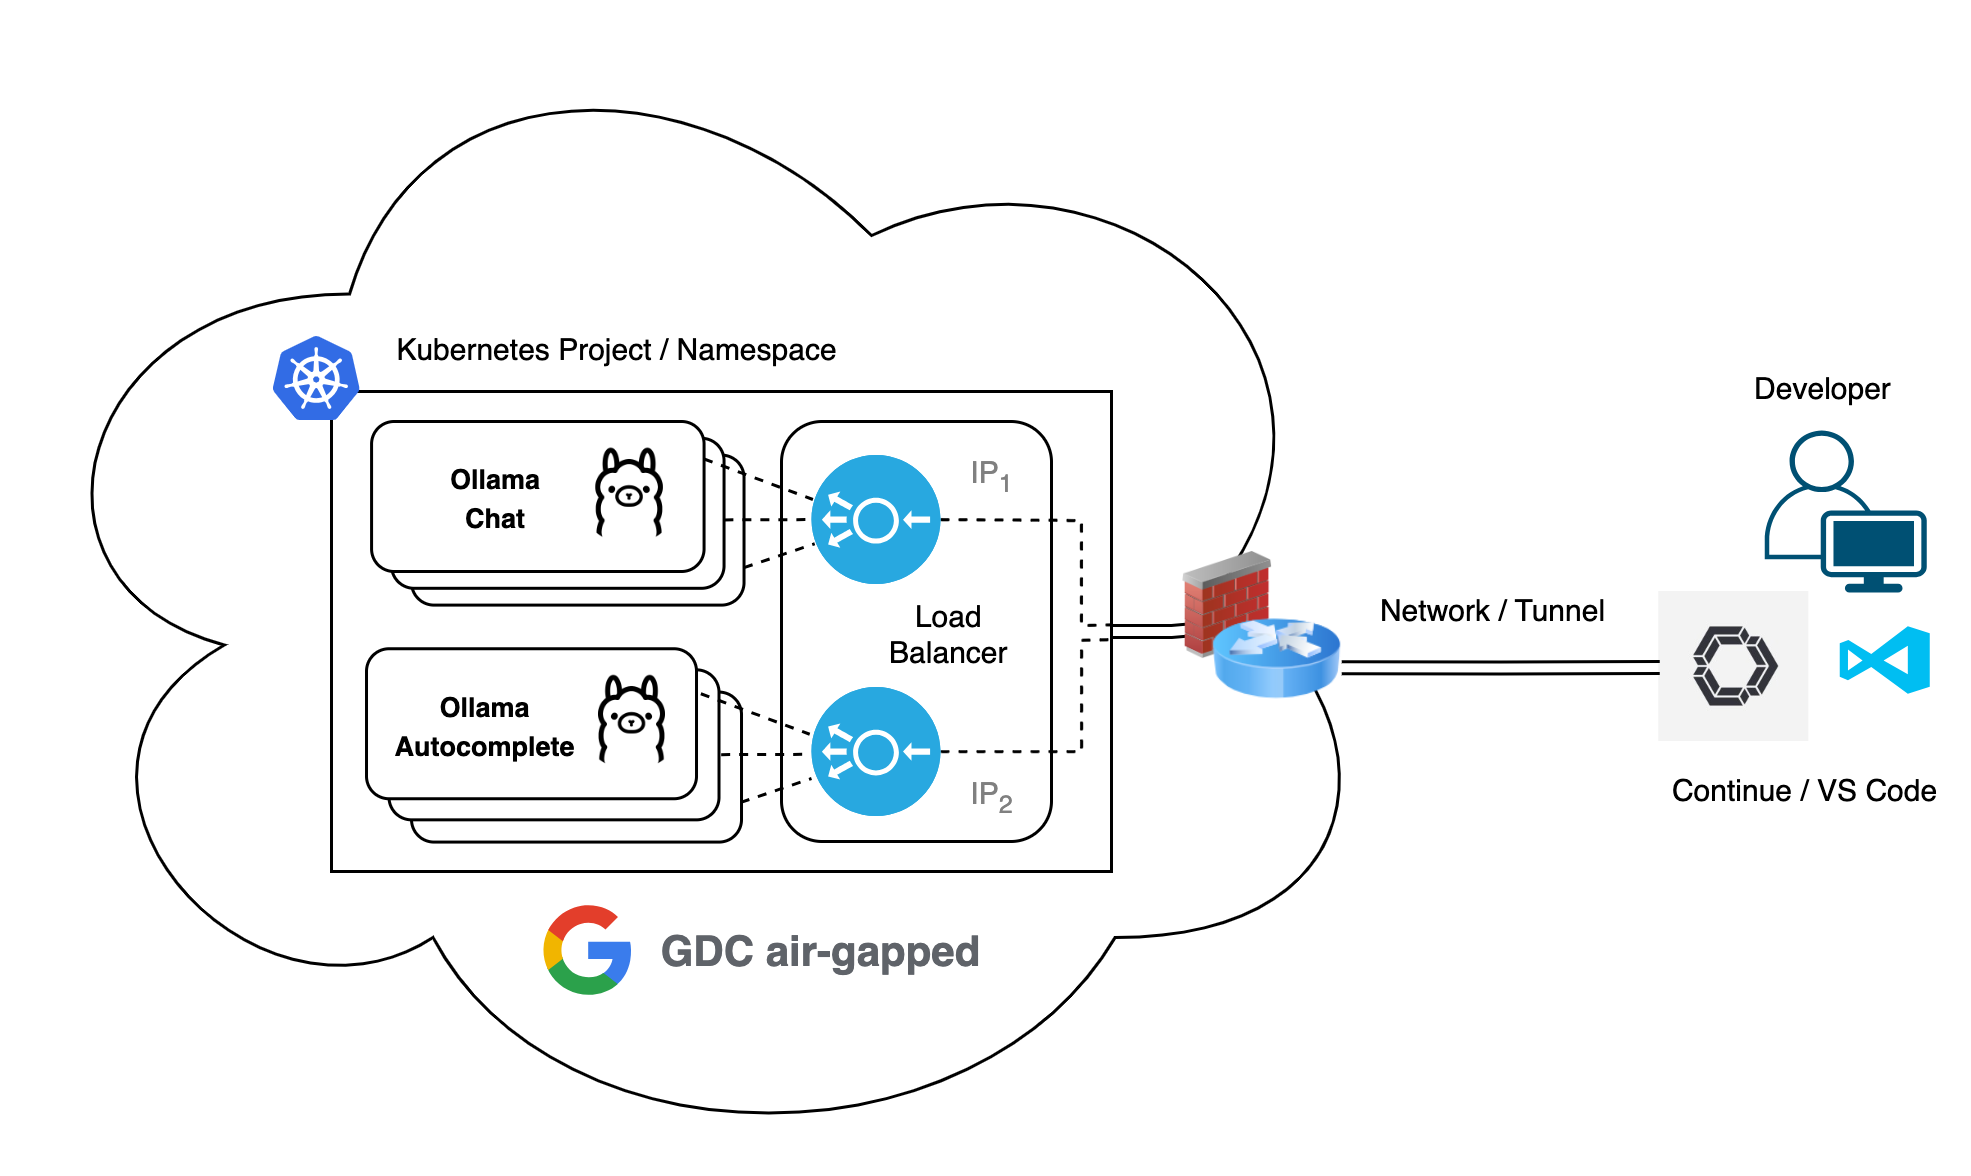
如要在 GDC vLLM 後端中擴充 air-gapped 環境,可以採用類似 Ollama 的策略,著重於硬體資源分配和 Pod 複製。
使用 vLLM 後端擴充解決方案
垂直
- 升級 GPU 分配:如果推論處理量 (權杖/秒) 成為瓶頸,請分配較大的 GPU 區塊,直到使用完整的 NVIDIA A100 GPU 為止。
- 多 GPU 設定:對於無法容納在單一 80 GB A100 記憶體中的大型模型 (例如 700 億到 4050 億個參數),您必須使用張量平行處理技術,擴充至多個 GPU。
- 延遲考量:請注意,跨越多個 GPU 的模型可能會發生與 GPU 間通訊相關的輕微負擔 (例如 NCCL 同步)。
水平
- 透過副本提高輸送量:如要處理相同模型的大量並行使用者要求,請在 vLLM 部署 YAML 中增加副本數量。
- 專屬模型執行個體:vLLM 是設計為單一模型服務引擎,且會在初始化時釘選 KV 快取記憶體,因此您必須為要代管的每個不同 LLM 部署一組獨立的 Pod。
- 負載平衡:GDC Kubernetes 服務 (類型為 LoadBalancer) 會自動將傳入的推論要求,分配給與該服務相關聯的所有正常 vLLM Pod 端點。
5.4 疑難排解
常見錯誤和解決方法。
| 錯誤 | 緩解措施 |
|---|---|
| FIPS SELFTEST FAILURE | 如果 BoringSSL 等程式庫缺少完整性簽章,就會發生這種情況。如要修正這個問題,請設定 BORINGSSL_FIPS=0,並使用官方 vLLM 映像檔 |
| 體重載入停滯 | 檢查小型 PVC 是否有 IOPS 節流。初始化效能模型時,需要 500 GiB 的磁碟區。 |
| 連線遭拒 | 確認 PNP 明確允許 targetPort (8000/8080)。GDC 防火牆不會自動授予 Load Balancer VIP 後端通訊埠的存取權。 |