


問題の説明
エアギャップ環境で大規模言語モデル(LLM)を実行する組織では、モデル エンドポイントが急速に蓄積されます。Google Distributed Cloud(GDC)エアギャップで提供されるすべてのオープン ウェイト モデル(GDC エアギャップでのオープン ウェイト モデルの設定に関するコンパニオン ガイドセットを参照)は、独自の Kubernetes Service、独自のアドレス、独自の認証情報、独自の運用ライフサイクルを公開します。アプリケーション開発者とエージェント開発者はアーキテクチャ サイロに閉じこもり、モデルごとに 1 つのエンドポイントをハードコードし、モデルの反復ごとに統合を書き換えることになります。この断片化により、技術的負債が生じ、ミッション クリティカルな複数ステップのエージェント ワークロードのデプロイが遅くなります。
標準のネットワーキング レイヤも「AI ブラインド」です。従来のロードバランサは推論トラフィックを汎用 HTTP として扱い、リクエストの model フィールドを読み取ったり、レイテンシの影響を受けやすいワークロードを優先したり、リクエストではなくトークンを考慮したり、関連する KV キャッシュをすでに保持しているモデルサーバー レプリカにリクエストを転送したりすることはできません。コストの高いエアギャップ GPU クラスタでは、ハードウェアの利用率が低下し、投資収益率が低下します。GDC 上の Gemini はマネージド フロンティア モデルを提供しますが、セルフホストのオープン ウェイト モデルと組み合わせるお客様は、データ主権を損なうことなくクラウドのような俊敏性を提供する推論レイヤが必要です。リクエスト、プロンプト、モデルの重みは GDC の境界を越えてはなりません。
提案するソリューション
このドキュメントでは、GDC エアギャップ環境でセルフマネージド AI ゲートウェイのリファレンス アーキテクチャについて説明します。これは、すべてのモデルに対して 1 つの OpenAI 互換エンドポイントをアプリケーションに提供し、各リクエストを適切なバックエンドに転送する、安全で一元化された推論レイヤです。リファレンス実装は Kubernetes Gateway API をベースに構築されています。Envoy Gateway は Gateway API の実装(コントロール プレーンと Envoy プロキシ データプレーン)であり、Envoy Agent Router(以前の Envoy AI Gateway)は AI 固有のリクエスト処理(リクエスト本文からのモデル抽出、リクエストとレスポンスの変換、アップストリーム認証、トークン アカウンティング、必要に応じてトークンベースのレート制限)で拡張されています。Gateway API 推論拡張機能は、モデルサーバー認識エンドポイント選択(InferencePool とエンドポイント選択)を追加して、GPU 容量を効率的に使用できるようにします。すべてのアーティファクトは GDC 組織の Harbor レジストリにステージングされ、スタック全体が外部接続なしで標準クラスタで実行されます。
含まれるもの: このアーキテクチャは、標準クラスタでの Envoy Gateway と Envoy Agent Router のデプロイ、統合された OpenAI 互換エンドポイントを公開する Gateway API リソース(GatewayClass、Gateway)と Envoy Agent Router リソース(AIGatewayRoute、AIServiceBackend、BackendSecurityPolicy、GatewayConfig)、model フィールドの本文ベースのルーティング、モデル認識ロード バランシング用の Gateway API 推論拡張機能(InferencePool、InferenceObjective、エンドポイント ピッカー)、Redis を使用したトークンベースのレート制限(省略可)、ゲートウェイでの TLS 終端、ネットワーク ポリシー(NetworkPolicy / ProjectNetworkPolicy)、Harbor でのエアギャップ アーティファクト管理を対象としています。ゲートウェイの背後にあるモデル提供バックエンド(Ollama、vLLM)は、コンパニオン ガイドの GDC エアギャップでのオープン ウェイト モデルの設定に従ってデプロイされます。
含まれないもの: このアーキテクチャでは、マネージド AI ゲートウェイ プロダクト、モデル自体のデプロイとチューニング(コンパニオン ガイドセット)、モデルのファインチューニング、非 LLM GenAI モダリティ、エージェントからツールへのトラフィック(MCPRoute)、商用サポート対象のゲートウェイ ディストリビューションは対象外です。Gemini on GDC はマネージド プロダクト機能です。プロビジョニングは範囲外です。このバージョンのガイドセットでは、セルフホストのオープン ウェイト モデルを使用してゲートウェイを検証します。
対象読者: このドキュメントの主な対象読者は、標準クラスタでのゲートウェイのデプロイと運用を担当するプラットフォーム管理者と、エアギャップ環境内で AI プラットフォームを設計するテクニカル アーキテクトです。統合エンドポイントを使用するアプリケーション デベロッパーは、リクエストのルーティング方法を理解することでメリットを得られる二次的なユーザーです。
アーキテクチャ
このソリューションは、GDC エアギャップ組織の標準クラスタで完全に実行されます。サービスレイヤでは、Kubernetes Gateway API が構成モデルを標準化します。AI ゲートウェイ コントロール プレーン(Envoy Gateway コントローラと Envoy Agent Router コントローラ)は、Gateway API と Envoy Agent Router リソースを読み取り、データプレーンを構成します。データプレーンは、リクエスト エントリ ポイント(タイプ LoadBalancer の Service を介して公開)である Envoy プロキシ Deployment と、プロキシ Pod でサイドカーとして実行され、AI 固有のロジックを実行する Envoy Agent Router 外部プロセッサです。アプリケーション レイヤでは、顧客のワークロード(アプリケーションとエージェント)がプロキシに AI リクエストを送信し(1)、プロキシがリクエストを外部プロセッサに渡します。外部プロセッサはモデル名を抽出し、リクエストを変換してトークンの使用量を記録します(2)。プロキシは、バランスの取れたトラフィックを選択したモデルの推論 Pod に転送し(3)、モデルはインフラストラクチャ レイヤの GPU ノードで実行されます(4)。モデル提供バックエンドは、AIServiceBackend(OpenAI 互換の Service)または としてゲートウェイに接続されます。InferencePool のエンドポイント選択機能は、リクエストごとに最適なレプリカを選択します。コンテナ イメージと Helm チャートは Harbor から pull されます。
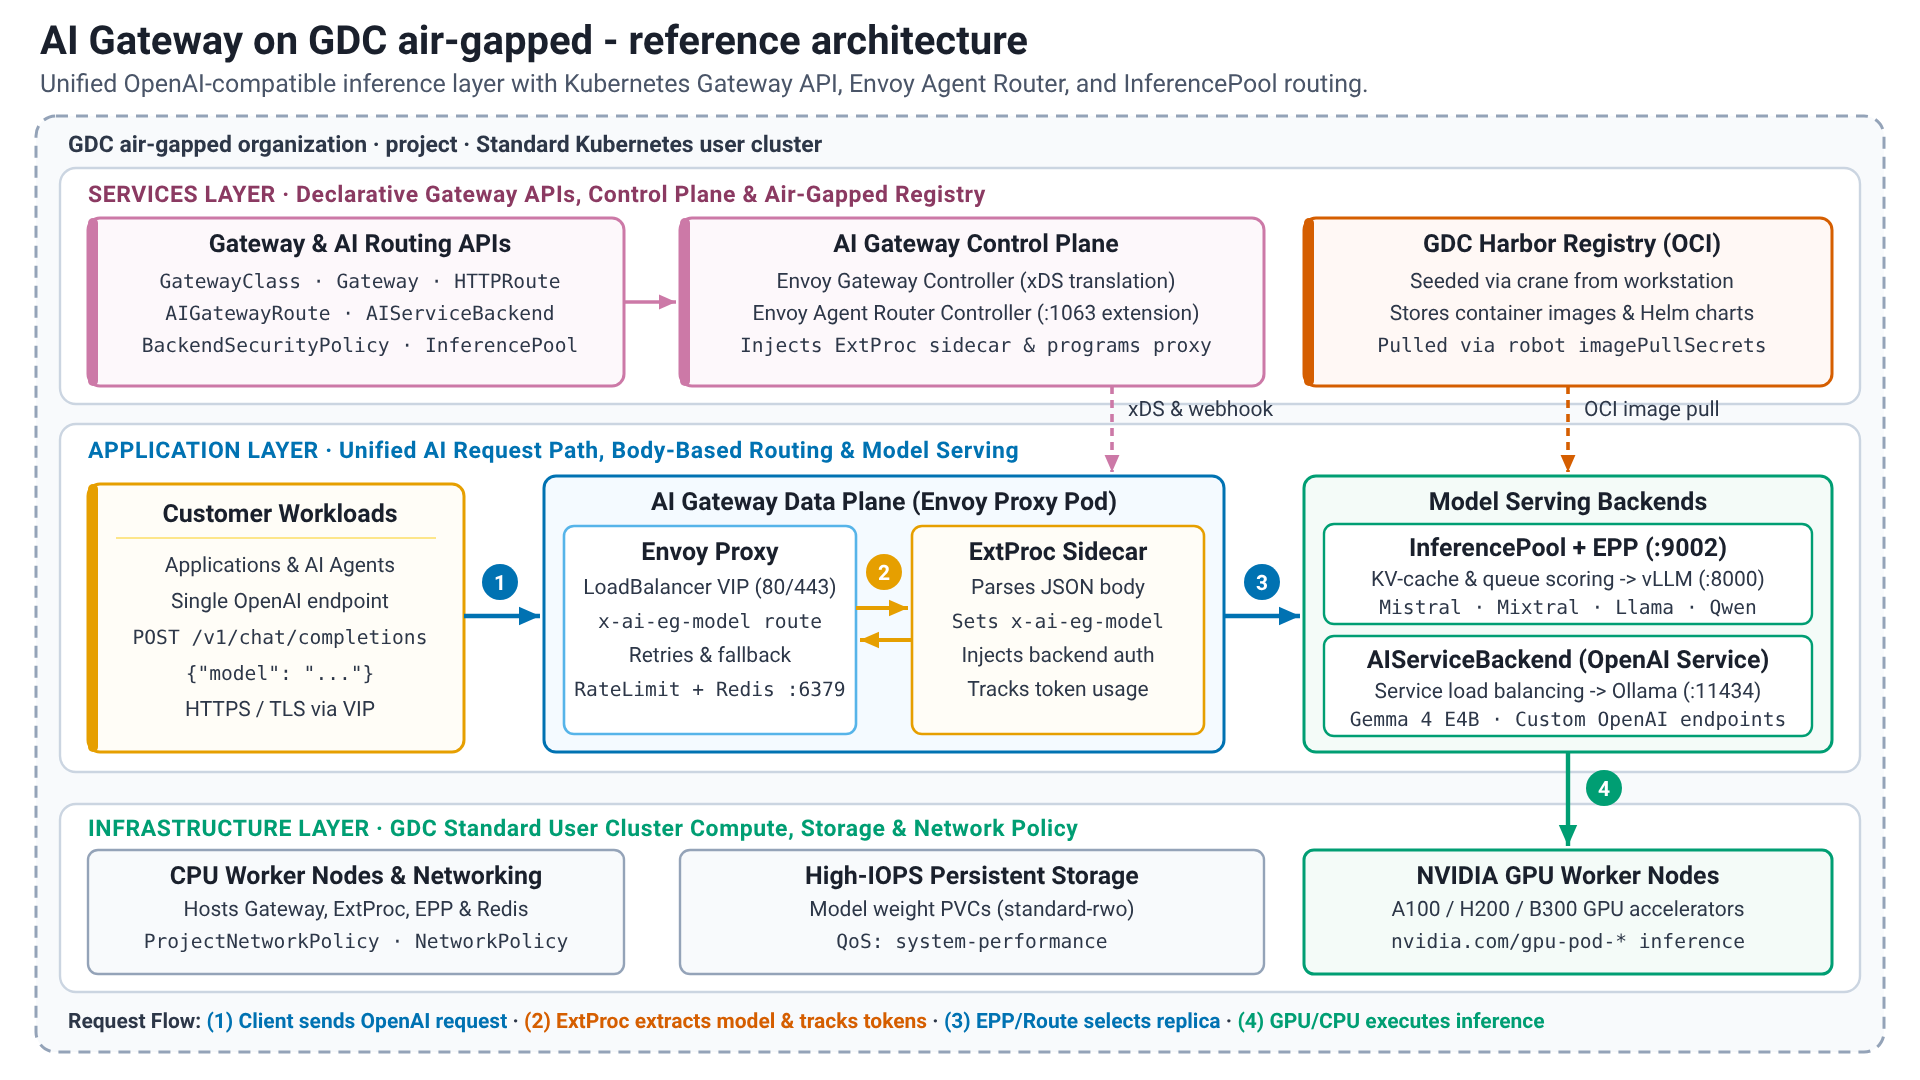
ソリューション コンポーネント
このソリューションでは、次のコンポーネントを使用します。
| ソリューション コンポーネント | 責任 | データフロー | インターフェース |
|---|---|---|---|
| Kubernetes Gateway API | 上り(内向き)とルーティングの標準的なロール指向のリソースモデル: GatewayClass(プラットフォームが所有)、Gateway(リスナー、TLS)、ルートリソース(アプリケーション チームが所有)。ベンダー固有のアノテーションのない Ingress API の後継。 |
宣言型構成のみ。リソースはコントローラによって監視され、リクエスト トラフィックは伝送されません。 | Kubernetes API(gateway.networking.k8s.io/v1)。CRD は Envoy Gateway CRD チャートからインストールされます。 |
| Envoy Gateway コントローラ(コントロール プレーン) | Gateway API を実装します。Gateway ごとに 1 つの Envoy プロキシ Deployment と LoadBalancer Service をプロビジョニングし、ルートとポリシー(BackendTrafficPolicy、SecurityPolicy、EnvoyExtensionPolicy、Backend、EnvoyProxy)を xDS 構成に変換し、構成されている場合はグローバル レート制限サービスを実行し、拡張機能マネージャーを介して Envoy エージェント ルーター拡張機能サーバーを呼び出して、InferencePool バックエンドを変換に追加します。 |
Kubernetes API を監視し、xDS 構成をプロキシに push します。リクエスト トラフィックはありません。 | Kubernetes API(watch)、プロキシへの xDS gRPC、拡張機能サーバーへの gRPC(ポート 1063)。 |
| Envoy エージェント ルーター コントローラ(コントロール プレーン) | aigateway.envoyproxy.io/v1beta1 リソース、AIGatewayRoute(抽出されたモデル名のルーティング ルール)、AIServiceBackend(API スキーマを含むバックエンド)、BackendSecurityPolicy(アップストリーム認証情報)、GatewayConfig(Gateway ごとの外部プロセッサ設定)を Envoy Gateway リソースに調整し、外部プロセッサ サイドカーを Envoy プロキシ Pod に挿入して、Envoy Gateway で使用される拡張機能サーバーを提供します。 |
構成のみ。 | Kubernetes API、gRPC 拡張機能サーバー(ポート 1063)、サイドカー インジェクション用の変更型アドミッション Webhook。 |
| Envoy プロキシ(データプレーン) | リクエスト エントリ ポイント: TLS を終端し、リスナーとルートを照合し、バックエンド エンドポイント間でロード バランシングを行い、レート制限とタイムアウトを適用し、再試行して代替バックエンドにフォールバックし、アクセスログと指標を出力します。 | LoadBalancer VIP(80/443)でクライアント リクエストを受信し、すべての AI リクエストについて外部プロセッサに問い合わせ、選択したバックエンド エンドポイント(Service またはエンドポイント選択ツールで選択された Pod)にリクエストを転送し、レスポンスをクライアントにストリーミングします。 |
クライアントへの HTTP/HTTPS(OpenAI 互換 API)、サイドカーとエンドポイント ピッカーへの ext_proc gRPC、バックエンドへの HTTP、レート制限サービスへの gRPC。 |
| Envoy エージェント ルーターの外部プロセッサ(ExtProc) | OpenAI 互換のリクエスト本文を解析し、model フィールドをルーティング ヘッダー x-ai-eg-model に抽出し、モデル名のオーバーライドを適用し、クライアント API スキーマとバックエンド API スキーマ間でリクエストとレスポンスのペイロードを変換し、BackendSecurityPolicy で定義されたアップストリーム認証情報を挿入し、レスポンスからトークン使用量(入力、出力、合計)を抽出し、トークンベースのレート制限と指標に使用される動的メタデータに格納します。 |
Envoy プロキシ Pod のサイドカー コンテナ。ストリーミング レスポンスを含むリクエストとレスポンスの本文を処理します。 |
Envoy ext_proc gRPC、Prometheus 指標エンドポイント。 |
| Gateway API 推論拡張機能(InferencePool + エンドポイント ピッカー) | InferencePool(inference.networking.k8s.io/v1)は、1 つのモデルサーバー デプロイの Pod(ラベルセレクタ、ターゲット ポート(8000 など))をグループ化し、その Endpoint Picker(EPP)を参照します。InferenceObjective(v1alpha2)は、モデルまたは目標ごとに優先度を割り当てます。EPP は、モデルサーバーの指標(リクエスト キューの深さ、KV キャッシュ使用率、読み込まれた LoRA アダプタ)をスクレイピングし、リクエストごとにエンドポイントを選択します。 |
プロキシはリクエスト ヘッダーを使用して EPP(ext_proc、ポート 9002)を呼び出します。EPP は使用するエンドポイントで応答します。プロキシはその Pod にリクエストを転送します。 |
Kubernetes API(CRD)、gRPC ext_proc(9002)、モデルサーバーの Prometheus スクレイピング。 |
| Redis(省略可) | Envoy レート制限サービスのバッキング ストア: すべてのプロキシ レプリカでリクエストベースとトークンベースの制限に共有カウンタを使用します。グローバル レート制限が構成されている場合にのみ必要です。 | レート制限サービスは、制限されたリクエストごとにポート 6379 のカウンタを読み取ってインクリメントします。 | Redis プロトコル(6379)。クラスタにデプロイされた Redis 8.10、または既存の Redis インスタンス。 |
| モデル提供バックエンド(Ollama / vLLM) | ゲートウェイの背後でオープンウェイト モデルを提供する。コンパニオン ガイド「GDC エアギャップでオープンウェイト モデルを設定する」でデプロイされています。AIServiceBackend(OpenAI 互換の Service(Ollama など))または InferencePool(Endpoint Picker がスコアリングする指標を公開するモデルサーバー(vLLM など))としてアタッチされます。 |
プロキシから転送されたリクエストを受信し、GPU ノード(または小規模モデルの機能評価用の CPU)で推論を実行して、OpenAI 互換のレスポンスを返します。 | OpenAI 互換の REST API: ポート 8000 の vLLM、ポート 11434 の Ollama。エンドポイント ピッカー用の Prometheus 指標(vLLM)。 |
| Harbor | ソリューションのコンテナ イメージ(Envoy プロキシ、Envoy Gateway、Envoy Agent Router コントローラと外部プロセッサ、レート制限サービス、Endpoint Picker、Redis)と Helm チャート(OCI アーティファクト)を保存します。 | アーティファクトは、インターネットにアクセスできるワークステーションから seed_registry.sh(crane)を使用して公開レジストリから Harbor にコピーされます。クラスタは、イメージ pull シークレットを使用してロボット アカウントでイメージを pull し、チャートは helm template を使用して Harbor からレンダリングされます。 |
OCI Distribution API、Harbor UI、ロボット アカウント。 |
| Standard クラスタと GPU ノード | すべてのゲートウェイ コンポーネント(CPU ノードで十分)と推論 Pod(ノードから検出されたアクセラレータ リソースを含む GPU ノード)をホストします。LoadBalancer VIP、モデルの重みの永続ストレージ、ネットワーク ポリシーの適用を提供します。 |
基盤となるプラットフォーム。リクエストは Gateway の LoadBalancer VIP を介して入力され、クラスタ ネットワーク内に留まります。 |
Kubernetes API、GDC ネットワーキング API(networking.gdc.goog/v1 ProjectNetworkPolicy)、GDC コンソール、プラットフォーム管理者の gdcloud。 |
特長と機能
このリファレンス アーキテクチャは、次のコア機能を提供します。
- OpenAI 互換の統合エンドポイント: アプリケーションは、ゲートウェイの背後で提供されるすべてのモデルに対して 1 つのアドレス(
/v1/chat/completions、/v1/modelsなど)を呼び出します。- コンポーネント:
Gateway、AIGatewayRoute、Envoy プロキシ、外部プロセッサ。 - 責任: 安定した仮想 IP の公開、TLS の終了、OpenAI 互換のリクエスト形式の受け入れと、必要に応じたバックエンド スキーマへの変換。
- インターフェース: HTTPS REST(JSON、ストリーミング用のサーバー送信イベントを含む)。
- コンポーネント:
- 本文ベース(モデル対応)ルーティング: ゲートウェイはリクエスト本文の
modelフィールドを読み取り、クライアントサイドのエンドポイント ロジックなしで、一致するバックエンドにリクエストをルーティングします。- コンポーネント: 外部プロセッサ、
x-ai-eg-model、AIServiceBackend、InferencePoolで一致するAIGatewayRouteルール。 - 責任: モデル名の抽出、ルートルールの照合、モデルの名前変更(
modelNameOverride)、重み付けによるトラフィックの分割、優先度による代替バックエンドへのフォールバック。 - インターフェース: Kubernetes API(
aigateway.envoyproxy.io/v1beta1)。
- コンポーネント: 外部プロセッサ、
- モデルサーバー認識ロード バランシング:
InferencePoolへのリクエストは、ラウンド ロビンではなく、キューが最も短く、最も有用な KV キャッシュを持つレプリカに送信されます。- コンポーネント: Gateway API 推論拡張機能(
InferencePool、InferenceObjective、エンドポイント ピッカー)。 - 責任: モデルサーバーの指標のスクレイピング、エンドポイントのスコアリング(キューの深さ、KV キャッシュ使用率、プレフィックス キャッシュ アフィニティ、LoRA アダプタ)、負荷時の目標ごとの優先順位の尊重。
- インターフェース: Kubernetes API(
inference.networking.k8s.io/v1、inference.networking.x-k8s.io/v1alpha2)、ext_proc gRPC(9002)。
- コンポーネント: Gateway API 推論拡張機能(
- アップストリームの認証ポリシーとセキュリティ ポリシー: 認証情報を必要とするバックエンドの認証情報は、ゲートウェイによって挿入され、アプリケーションに配布されることはありません。
- コンポーネント:
BackendSecurityPolicy、Envoy GatewaySecurityPolicy、TLS リスナー。 - 責任: バックエンドへの API キーの挿入、
Gatewayでのクライアント TLS の終端、必要に応じたクライアント認証と認可ポリシーの適用。 - インターフェース: ポリシーで参照される Kubernetes
Secret。
- コンポーネント:
- トークンベースのレート制限(省略可): 使用量はリクエストだけでなく、トークンでも測定されます。
- コンポーネント: 外部プロセッサ(
llmRequestCosts)、Envoy GatewayBackendTrafficPolicy(グローバル レート制限)、レート制限サービス、Redis。 - 責任: すべてのレスポンスから入力トークン、出力トークン、合計トークンを抽出し、リクエスト費用として付加し、すべてのプロキシ レプリカでユーザーごとまたはモデルごとの予算を適用します。
- インターフェース: Kubernetes API、Redis(6379)。
- コンポーネント: 外部プロセッサ(
- トラフィック管理: 標準の Gateway API 機能が AI トラフィックに適用されます。
- コンポーネント:
Gateway、HTTPRoute、AIGatewayRoute、BackendTrafficPolicy。 - 責任: ホスト、パス、ヘッダーに基づく照合、長い世代に適したタイムアウト、再試行、重み付けされたトラフィック分割、バックエンド間の優先度ベースのフォールバック。
- インターフェース: Kubernetes API。
- コンポーネント:
- オブザーバビリティ: リクエスト、レイテンシ、トークンの指標はすべてのモデルで使用できます。
- コンポーネント: Envoy プロキシ アクセスログと統計情報、外部プロセッサ指標(トークン使用量、リクエスト時間、最初のトークンまでの時間)、エンドポイント ピッカー指標。
- 責任: GDC オブザーバビリティ スタックまたはお客様が管理する Prometheus がスクレイピングできる Prometheus 形式の指標と構造化されたアクセスログを公開します。
- インターフェース: Prometheus 指標エンドポイント、標準出力ログ。
- エアギャップ アーティファクト管理: すべてのイメージとグラフは、インストール前に Harbor でステージングされます。
- コンポーネント: Harbor、
seed_registry.sh、ロボット アカウント、イメージ プル シークレット、EnvoyProxyリソース(プロキシ イメージとプル シークレット)。 - 責任: 接続されたワークステーションからのイメージと OCI Helm チャートのシード、バージョンの固定、
helm templateを使用したチャートのオフライン レンダリング。 - インターフェース: OCI Distribution API、Kubernetes API。
- コンポーネント: Harbor、
アーキテクチャの原則
- 標準優先: ゲートウェイは Kubernetes Gateway API とその推論拡張機能を使用して構成され、アプリケーションに対して OpenAI 互換の API を使用するため、アプリケーション、ルート、バックエンドはゲートウェイ実装間で移植性を維持します。
- セキュリティ優先: すべてのコンポーネントとデータは、GDC エアギャップの境界内に存在します。TLS は
Gatewayで終端され、バックエンド認証情報はゲートウェイによって挿入され、ネットワーク アクセスはNetworkPolicyオブジェクトとProjectNetworkPolicyオブジェクトで制限されます。 - データ主権: プロンプト、レスポンス、モデルの重み、使用状況データは、お客様の GDC 組織から離れることはありません。運用に外部接続は必要ありません。
- 関心の分離: ロール指向の Gateway API により、プラットフォーム管理者は
GatewayClass、Gateway、TLS、ネットワーク ポリシーを所有し、アプリケーション チームは独自の名前空間でAIGatewayRoute、AIServiceBackend、InferencePoolリソースを所有できます。 - 制御プレーンとデータプレーンの分離: コントローラは構成の変換のみを行います。リクエスト パスは、Envoy プロキシ、その外部プロセッサ サイドカー、エンドポイント ピッカーで構成されます。コントローラが再起動しても、トラフィックの処理は継続されます。
- オープンで柔軟: このアーキテクチャでは、オープンソース ソフトウェア(Envoy Gateway、Envoy Agent Router、Gateway API Inference Extension、Ollama、vLLM)が全体で使用されており、同じ Gateway API リソースを代替実装で提供できます。
- スケーラビリティとパフォーマンス: データプレーンは、プロキシ レプリカを追加することで水平方向にスケーリングし、CPU とメモリを調整することで垂直方向にスケーリングします。モデルサーバー対応のロード バランシングにより、個々のレプリカに過負荷をかけることなく、GPU を飽和状態に保ちます。
- エンドユーザー エクスペリエンスの簡素化: 各モデルに 1 つのエンドポイント、1 つの API 形式、1 つの認証情報を使用することで、モデルのデプロイから使用までのパスが短縮されます。
- 復元性: Kubernetes のヘルスチェックとレプリケーション、Envoy の再試行、バックエンド間の優先度ベースのフォールバックにより、個々のモデル レプリカで障害が発生した場合でも、エンドポイントを利用可能な状態に保ちます。
考慮事項
- スケーラビリティとパフォーマンス:
- ゲートウェイ コンポーネントは CPU 専用のワークロードです。
Gatewayの Envoy プロキシDeploymentは、レプリカ数(EnvoyProxyリソース)を増やすことで水平方向にスケーリングし、CPU とメモリのリクエストを増やすことで垂直方向にスケーリングします。外部プロセッサによる本文の検査には、リクエストとレスポンスのサイズに比例した CPU コストがかかります。ストリーミング レスポンスは増分処理されます。 - モデルサーバー認識ロード バランシングは、
InferencePoolとして接続されたバックエンドにのみ適用されます。AIServiceBackendとして接続されたバックエンドは、プロキシによってServiceのエンドポイント間でロード バランシングされます。 - ゲートウェイは GPU 容量を追加しません。スループットとレイテンシはモデルサーバーによって制限されます。コンパニオン ガイド セット(高スループットの vLLM、使いやすさと CPU のみの評価のための Ollama)を使用して、モデルのデプロイのサイズを設定します。
- 長い生成には、一般的な HTTP API よりも長いリクエストとアイドル タイムアウトが必要です。クライアントではなく、ルートとポリシーで構成します。
- ゲートウェイ コンポーネントは CPU 専用のワークロードです。
- リソース管理:
- すべてのゲートウェイ コンポーネントは CPU ノードで実行され、アクセラレータは必要ありません。次の表に、機能的なデプロイの目安となるサイズを示します。リファレンス実装では、正確なリクエストと制限が設定されます。本番環境の値は、リクエスト率とペイロード サイズによって異なります。
- 次のポート表に、ネットワーク ポリシーで許可する必要があるすべてのポートを示します。
- GPU プランニングはモデルのデプロイに属します。アクセラレータ リソース名は、コンパニオン ガイドセットで説明されているように、ノードから検出されます。
ゲートウェイ コンポーネントの目安となるサイズ設定(CPU のみ)
| コンポーネント | レプリカ | CPU(リクエスト) | メモリ(リクエスト) | メモ |
|---|---|---|---|---|
| Envoy Gateway コントローラ | 1 | 100m ~ 500m | 256Mi ~ 1Gi | コントロール プレーン(リクエストパスに含まれない) |
| Envoy エージェント ルーター コントローラ | 1 | 100m ~ 500m | 256Mi ~ 512Mi | コントロール プレーンと拡張機能サーバー |
Envoy プロキシ Pod(プロキシ + 外部プロセッサ サイドカー) |
Gateway あたり 1 ~ 2 個 |
500m–2 | 512 Mi ~ 2 Gi | リクエスト率とペイロード サイズでスケーリングする |
| エンドポイント ピッカー | InferencePool あたり 1 個 |
100m ~ 500m | 256Mi ~ 512Mi | モデルサーバーの指標をスクレイピングする |
| レート制限サービス(省略可) | 1 | 100m ~ 500m | 256Mi ~ 512Mi | グローバル レート制限のみ |
| Redis(省略可) | 1 | 100m ~ 500m | 256Mi ~ 1Gi | グローバル レート制限のみ |
ネットワーク ポート
| ポート | コンポーネント | 目的 |
|---|---|---|
| 80 / 443 | Envoy プロキシ(Gateway 個のリスナー) |
LoadBalancer VIP の HTTP / HTTPS エントリ ポイント |
| 1063 | Envoy エージェント ルーター コントローラ(拡張機能サーバー) | Envoy Gateway 拡張機能マネージャーからの gRPC 呼び出し |
| 9002 | エンドポイント ピッカー | Envoy プロキシからの ext_proc gRPC 呼び出し |
| 6379 | Redis | レート制限カウンタ |
| 8000 | vLLM | モデルサーバーの OpenAI 互換 API と指標 |
| 11434 | Ollama | Ollama とモデルサーバーの OpenAI 互換 API |
- 可用性と信頼性:
- プロキシと外部プロセッサは同じ
Podで実行されます。LoadBalancerServiceの背後にある複数のレプリカは個々のPodの障害をマスクし、コントローラはトラフィックを中断することなく再起動できます。 AIGatewayRouteルールでは、優先度を指定して複数のバックエンドをリストできます。これにより、バックエンドが異常な場合に、ゲートウェイが別のレプリカ セットまたはモデルサーバーにフォールバックします。- エンドポイント ピッカーはプールごとの
Deploymentです。使用できない場合、そのInferencePoolへのリクエストは、復帰するまで失敗します。リソース リクエストと準備状況プローブを使用して実行し、データ プレーン コンポーネントのようにモニタリングします。 - Redis はレート制限カウンタのみを保持します。Redis の停止はルーティングではなく、レート制限に影響します。
- プロキシと外部プロセッサは同じ
- 運用の複雑さ:
- Envoy Gateway、Envoy Agent Router、Gateway API Inference Extension のバージョンを揃える: テスト済みの組み合わせ(Envoy Gateway 1.8.4、Envoy Agent Router 1.1.0、Gateway API Inference Extension 1.5.0)で 3 つをまとめてアップグレードします。
- エアギャップ ライフサイクル: アップグレードごとにすべてのイメージとグラフが Harbor に再シードされます。
EnvoyProxyリソースとグラフ値は、レジストリと pull シークレットを固定します。 - 2 つの構成レイヤ(プラットフォーム所有の
GatewayClass/Gateway/EnvoyProxyとチーム所有のAIGatewayRoute/AIServiceBackend/InferencePool)。新しいモデルのオンボーディングとは、新しいゲートウェイではなく、ルートルールとバックエンドを追加することです。 - モニタリング: リクエスト率、レイテンシ(最初のトークンまでの時間を含む)、モデルごとおよびコンシューマーごとのトークン使用量、Endpoint Picker のスコアリング、モデルサーバーの GPU 使用率。
InferenceObjectiveはまだアルファ版の API(v1alpha2)です。Inference Extension のリリース間でスキーマの変更が予想されます。
- セキュリティとコンプライアンス:
- ソリューション全体が GDC のエアギャップ セキュリティ境界内で動作します。
- ネットワーク ポリシーは必須です。名前空間
NetworkPolicyは、プロキシからモデルサーバー ポート(8000、11434)とエンドポイント ピッカー(9002)へのトラフィックを許可します。ProjectNetworkPolicyは、コンシューマーがプロジェクトの外部に存在する場合に、クライアント トラフィックをLoadBalancerVIP に許可します。 - TLS は、Kubernetes
Secretに保存されている証明書を使用してGatewayで終端されます。クライアントはゲートウェイ エンドポイントのみを参照します。 - アップストリーム認証情報(モデルサーバーで必要な API キーなど)は、
BackendSecurityPolicyで参照されるSecretに保存され、ゲートウェイによって挿入されるため、アプリケーションがバックエンド認証情報を保持することはありません。 - トークンベースのレート制限により、コンシューマーまたはモデルごとに高価な GPU 容量の使用量が制限されます。
- Harbor ロボット アカウントと Kubernetes イメージ pull シークレットにより、コンテナ イメージへの安全なアクセスが確保されます。ロール指向の Gateway API RBAC により、プラットフォームとアプリケーションの責任が分離されます。
設計上の意思決定
このリファレンス アーキテクチャでは、次の重要な設計上の決定が行われています。
決定 1: AI ゲートウェイの実装: Envoy Gateway 上のオープンソース Envoy Agent Router と代替ディストリビューション
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| AI ゲートウェイは、自己管理型のオープンソース オプションから商用サポート付きのサービスまで、実行可能な代替手段を備えた主要なアーキテクチャ オプションです。(a)Envoy Gateway 上の Envoy エージェント ルーター(オープンソース)、(b)kgateway と agentgateway(LLM プロバイダ トラフィック、MCP ツール、エージェント間の通信を 1 つのデータプレーンで処理するオープンソースの Gateway API 実装。必要に応じて solo.io からベンダー サポートを利用可能)、(c)商用サポート付きのプレミアム オプションとしての agentgateway 用の Solo Enterprise。 | リファレンス実装では、Envoy Gateway でオープンソースの Envoy Agent Router を使用します。代替案は、同じ Gateway API リソースの背後にある有効な選択肢のままです。専用のベンダー サポートが必要な本番環境には、商用サポート付きのディストリビューションをおすすめします。 | オープンソースの利点: 軽量で標準に準拠している、高性能な L7 ルーティング、ライセンス料金なし。有料サービスに移行する前にソリューションを評価するのに最適です。Envoy Agent Router は、このガイドセットで検証済みのオプションです。オープンソースのデメリット: サポートはソリューション チームとコミュニティ主導のベスト エフォート型であり、コア本番環境の要件を満たせない可能性があります。プレミアムのメリット: ゲートウェイのライフサイクルに関するエンタープライズ サポート契約、高度なエージェント機能(多くの場合)。Premium のデメリット: 有料のライセンスまたはサポート契約と、ベンダーとの追加の関係。 |
決定 2: 推論拡張機能を使用した Kubernetes Gateway API と Ingress または独自のゲートウェイ API
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| 推論エンドポイントは、以前の Ingress API、ゲートウェイ固有の構成形式、または Kubernetes Gateway API を使用して公開できます。モデル認識ロード バランシングでは、モデルサーバー プールとその優先度を記述する方法も必要です。 | このソリューションは、Envoy Gateway によって実装される Kubernetes Gateway API(GatewayClass、Gateway、ルート)と、モデル認識ルーティング用の Gateway API 推論拡張機能(InferencePool、InferenceObjective、エンドポイント ピッカー)を標準化します。 |
Gateway API は、Ingress の後継となる Kubernetes 標準であり、ロール指向(プラットフォーム チームとアプリケーション チーム)で、実装間で移植可能です。Inference Extension は、モデルサーバーを認識したルーティング(キューの深さ、KV キャッシュ、優先度)のコミュニティ標準であり、Envoy Agent Router でそのままサポートされています。代替のゲートウェイ ディストリビューションは同じ API を実装しているため、Decision 1 は可逆性を維持しています。 |
決定 3: OpenAI 互換リクエストの model フィールドに基づく本文ベースのルーティングを統合エンドポイントとして使用する
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
アプリケーションは、モデルごとに 1 つのエンドポイント(ホストベースまたはパスベース)、クライアントによって設定されたカスタム ヘッダー、またはすべての OpenAI 互換リクエストにすでに含まれている model フィールドを使用してモデルをアドレス指定できます。 |
ゲートウェイは、model フィールドで 1 つの OpenAI 互換エンドポイントとルートを公開します。外部プロセッサは、それを x-ai-eg-model ヘッダーに抽出し、AIGatewayRoute ルールはそのヘッダーと照合します。 |
既存の OpenAI 互換クライアントと SDK は変更なしで動作し、1 つの文字列を変更するだけでモデルを切り替えることができます。エンドポイント、認証情報、モデルの配置は、アプリケーションを変更することなく変更できます。同じルールを使用して、トラフィック分割、フォールバック、モデル名のオーバーライドのために、モデル名を複数のバックエンドにマッピングできます。 |
決定 4: Harbor へのエアギャップ アーティファクトのシードとオンデマンド プル
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| アップストリーム インストールでは、コンテナ イメージを公開レジストリから pull し、Helm チャートを OCI アーティファクトとしてオンデマンドで pull します。これは、エアギャップ環境では不可能です。 | すべてのコンテナ イメージ(Envoy プロキシ、Envoy Gateway、Envoy Agent Router コントローラと外部プロセッサ、レート制限サービス、Endpoint Picker、Redis)と Envoy Gateway および Envoy Agent Router Helm チャートは、seed_registry.sh(crane)を使用して Harbor プロジェクトにシードされます。チャートは Harbor の helm template を使用してオフラインでレンダリングされ、EnvoyProxy リソースとチャート値は Harbor レジストリと pull シークレットを固定します。 |
バージョンごとに 1 つの再現可能で監査可能なシード処理ステップ。クラスタは外部接続を必要としません。バージョン固定により、アップグレードが明示的になり、元に戻せるようになります。 |
決定 5: Redis を使用したトークンベースのレート制限(オプション)とリクエストベースの制限のみ
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| GPU 容量はリクエストごとではなくトークンごとに消費されます。リクエスト数の上限では、共有モデルを非常に大きなプロンプトや長い生成から保護できません。Envoy Gateway のグローバル レート制限には、共有カウンタ ストアが必要です。 | トークンベースのレート制限は、アーキテクチャのオプション機能です。外部プロセッサは、リクエストごとの入力トークン、出力トークン、合計トークン(llmRequestCosts)を記録し、BackendTrafficPolicy は予算を適用し、Redis インスタンス(クラスタまたは既存のインスタンスにデプロイされた Redis 8.10)はカウンタを保存します。レート制限のないデプロイには Redis は必要ありません。 |
使用量は費用を反映する単位で測定され、予算はすべてのプロキシ レプリカで一貫して適用されます。依存関係は、割り当てを必要とするお客様のみが支払います。 |
決定 6: トポロジ: 標準クラスタの専用 Namespace にゲートウェイ コントロール プレーンとデータプレーン、アプリケーション Namespace にモデル
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| Gateway は、専用クラスタ、すべてのアプリケーション Namespace、またはモデルの横にある標準クラスタごとに 1 回実行できます。GDC エアギャップのオープンウェイト モデルは、標準クラスタにデプロイされます(コンパニオン ガイド セット)。 | Envoy Gateway と Envoy Agent Router のコントロール プレーンと Envoy プロキシのデータプレーンは、モデルをホストする標準クラスタの専用 Namespace で実行されます。AIGatewayRoute、AIServiceBackend、InferencePool、モデル デプロイはアプリケーション Namespace に存在し、Namespace 間で参照されます。 |
リクエストは、プロキシとモデル Pod(レイテンシが最も短く、追加のロードバランサがない)の間でクラスタ ネットワーク内に留まります。プラットフォーム管理者はゲートウェイ Namespace を所有し、アプリケーション チームはルートとモデルを所有します。Endpoint Picker はモデルサーバーを直接スクレイピングできます。中央サーバー ゲートウェイに転送するプロジェクトごとのクライアント ゲートウェイは、マルチプロジェクト消費のためのこのトポロジの拡張機能のままです。 |
前提条件と制限事項
- GDC エアーギャップ 1.16.2-hf1 以降の環境は、Kubernetes v1.32.13-gke.400 以降を実行する標準クラスタで使用できます。
- モデル サービング バックエンドに十分なハードウェア リソース(特に GPU)が存在します。ゲートウェイ コンポーネント自体は CPU ノードで実行されます。実際のモデルには GPU が必要です。Ollama の小さなモデルは、機能評価のみを目的として CPU で実行できます。
- Harbor インスタンスが設定されてアクセス可能であり、インターネット アクセスと GDC 環境(Harbor と Kubernetes API)への接続を備えたワークステーションが、イメージとグラフのシードに使用できる。
- ユーザーに必要な権限(プロジェクト ロール Harbor インスタンス閲覧者と標準クラスタ管理者、クラスタ スコープのインストール(CRD、
GatewayClass、Namespace)の標準クラスタに対するStandardClusterRoleBindingcluster-adminロール)がある。リファレンス実装をご覧ください。 - モデル提供バックエンドは OpenAI 互換の API を公開します。
InferencePoolとして接続されたバックエンドは、Endpoint Picker が依存する vLLM 互換の指標も公開します。 - 制限事項: オープンソース コンポーネント(Envoy Gateway、Envoy Agent Router、Gateway API 推論拡張機能)のサポートは、ソリューション チームによるベスト エフォートです。専用のベンダー サポートには、商用サポート対象のディストリビューションが必要です(決定 1)。
- 制限事項:
InferenceObjectiveはアルファ版 API(inference.networking.x-k8s.io/v1alpha2)であり、推論拡張機能のリリース間で変更される可能性があります。 - 制限事項: プロジェクト外のコンシューマーには
GatewayとProjectNetworkPolicyのLoadBalancerVIP が必要です。プロジェクト内では、クラスタ内クライアントまたはkubectl port-forwardがゲートウェイServiceに直接アクセスできます。 - 制限事項: Gemini on GDC、モデルのファインチューニング、非 LLM GenAI モデル、マルチノード モデル サービングは、このバージョンのソリューションの対象外です。
ユーザーフロー
以下は、GDC エアギャップ上の AI ゲートウェイの包括的なユーザーフローです。まず、アプリケーション デベロッパーが依存するリクエスト パス、次にプラットフォーム管理者が従う設定パスです。
1. デベロッパー リクエストのパス
アプリケーションまたはエージェントに必要なのは、ゲートウェイ エンドポイント、ゲートウェイでクライアント認証情報が強制されている場合はその認証情報、モデル名のみです。
- リクエストを送信する: アプリケーションは、OpenAI 互換のサービスを呼び出す場合と同様に、モデル(
"model": "gemma"など)を指定する OpenAI 互換の JSON 本文を使用して、ゲートウェイ エンドポイントでPOST /v1/chat/completionsを呼び出します。 - ゲートウェイに入力します。リクエストは
GatewayのLoadBalancerVIP に到達します。Envoy プロキシは TLS を終端し、リスナーとルートを照合します。 - 本文を処理する: プロキシはリクエストを Envoy Agent Router 外部プロセッサに渡し、プロセッサは本文を解析し、モデル名を
x-ai-eg-modelヘッダーに抽出し、ペイロードが異なる場合はバックエンド スキーマに変換します。 - バックエンドを選択する: モデル名に一致する
AIGatewayRouteルールは、AIServiceBackend(OllamaServiceなど)またはInferencePool(vLLM レプリカ セットなど)を選択します。InferencePoolの場合、エンドポイント ピッカーは、キューが最も短く、KV キャッシュの一致が最も高いレプリカを選択します。 - 転送して応答:
BackendSecurityPolicyが適用されると、プロキシは上流の認証情報を挿入し、選択したPodにリクエストを転送し、レスポンスをストリーミングして戻します。これにより、外部プロセッサはトークンの使用状況を記録し、指標と、構成されている場合はトークンベースのレート制限に反映させることができます。 - モデルの切り替え: 別のモデルを使用するには、デベロッパーが
model文字列を変更します。新しいエンドポイント、認証情報、クライアント ライブラリは必要ありません。
2. プラットフォーム管理者の設定パス
- Harbor にアーティファクトをシードする: Harbor ロボット アカウントを作成し、インターネットにアクセスできるワークステーションから
seed_registry.shを使用して、コンテナ イメージと Envoy Gateway および Envoy Agent Router Helm チャートを Harbor にコピーします。 - Envoy ゲートウェイをインストールする:
helm templateを使用して Harbor から CRD とコントローラ チャートをレンダリングし、ゲートウェイ Namespace に適用します。プロキシ イメージと pull シークレットを固定するEnvoyProxyリソースを作成し、基本的なGatewayClass、Gateway、HTTPRouteを使用してコントローラを検証します。 - Envoy エージェント ルーターをインストールする: Envoy エージェント ルーター CRD と Gateway API Inference Extension CRD をインストールし、Envoy エージェント ルーター コントローラをデプロイして、拡張サーバー(ポート 1063)を呼び出し、
InferencePoolバックエンドを受け入れるように Envoy Gateway を再構成します。必要に応じて、Redis をデプロイし、グローバル レート制限サービスを有効にします。 - ゲートウェイを公開する: HTTP リスナーと HTTPS リスナー(TLS 証明書
Secret)を使用してGatewayClassとGatewayを作成し、LoadBalancerVIP を待ってから、プロジェクト外のコンシューマーにProjectNetworkPolicyを適用します。 - モデルをアタッチする: コンパニオン ガイドセットを使用してモデル サービング バックエンドをデプロイし、OpenAI 互換の
ServiceとInferencePoolのAIServiceBackendリソースと、vLLM 互換のレプリカセットの Endpoint Picker リソースを、NamespaceNetworkPolicyオブジェクトとともに作成します。 - ルートを公開する: モデル名(本文ベースのルーティング)ごとに 1 つのルールを含む
AIGatewayRouteを作成し、必要に応じて、上流の認証情報とトークン予算のBackendSecurityPolicyオブジェクトとBackendTrafficPolicyオブジェクトを作成します。 - 検証と運用: VIP(または
kubectl port-forwardフォールバック)を介して/v1/modelsと/v1/chat/completionsを呼び出し、プロキシ、外部プロセッサ、エンドポイント ピッカーの指標を確認して、エンドポイント名とモデル名をアプリケーション チームに渡します。プロキシ レプリカとモデル デプロイを個別にスケーリングします。Envoy Gateway、Envoy Agent Router、推論拡張機能を一緒にアップグレードします。
詳細な手順については、Envoy エージェント ルーターのリファレンス実装と Envoy エージェント ルーターを使用した本文ベースのルーティングのユーザーガイドをご覧ください。
その他の教材
- Envoy エージェント ルーターのリファレンス実装
- Envoy エージェント ルーター ユーザーガイドを使用した本文ベースのルーティング
- オープンウェイト LLM リファレンス アーキテクチャ
- Envoy Agent Router のドキュメント
- Envoy Gateway
- Kubernetes Gateway API
- Gateway API 推論拡張機能
- Google Distributed Cloud エアギャップのドキュメント