


エアギャップ環境で運用している組織は、大規模言語モデル(LLM)の変革力を必要としているにもかかわらず、厳格なセキュリティ プロトコルにより外部のクラウドベースの API に接続することが厳しく禁止されているという大きな課題に直面しています。このギャップを埋めるには、Google Distributed Cloud(GDC)のエアギャップ インフラストラクチャでオープンウェイト モデルを直接ホストして管理できる、堅牢で自己完結型のエコシステムが必要です。このローカル デプロイは、絶対的なデータ主権を維持し、機密情報が物理的な施設から漏洩しないようにするために不可欠です。安全な実行環境をローカル推論エンジンと統合することで、ユーザーは高度な AI 機能を活用しながら、データ、モデルの重み、内部セキュリティ ポスチャーに対する完全な管理権限を維持できます。
GDC の Gemini は、強力なマネージド フロンティア機能を提供しますが、お客様は多くの場合、Gemma 4 や Llama 4 などのオープンウェイト モデルをデプロイして、粒度と制御を高めています。エアギャップ GDC 環境にオープンウェイト モデルをデプロイすると、マネージドの独自サービスよりも大幅なコスト削減が可能です。モデルの重みを所有することで、組織は繰り返し発生するトークンあたりの API 料金を削減できます。これは、大量の自動ワークロードでは非常に高額になる可能性があります。さらに、オープンソース モデルでは量子化(4 ビットや 8 ビットなど)が可能になり、エッジで小規模で安価なハードウェア フットプリントで高性能な推論を実行できます。この垂直最適化と、追加のライセンス費用なしで複数の内部アプリケーション間でインフラストラクチャを共有できる機能により、持続的な大規模推論オペレーションの総所有コスト(TCO)が大幅に削減されます。
提案するソリューション
このドキュメントでは、Google Distributed Cloud(GDC)のエアギャップ環境にオープン ウェイトの大規模言語モデル(LLM)をデプロイして管理するためのリファレンス アーキテクチャの概要について説明します。多くの企業、特に規制の厳しい業界の企業は、データの主権とセキュリティに関する厳しい要件のため、クラウドベースの LLM API を使用できません。このアーキテクチャは、独自の安全な GDC インスタンス内で強力な LLM をローカルで実行する必要性に対応しています。
含まれるもの: このアーキテクチャは、vLLM または Ollama サービング バックエンドを使用してオープンソース LLM(Gemma、Llama、DeepSeek など)をデプロイする方法について説明します。これには、オーケストレーションに Kubernetes を使用すること、アーティファクト ストレージに Harbor を使用すること、モデルの重みに永続ボリュームを使用すること、ネットワーク セキュリティにプロジェクト ネットワーク ポリシーを使用することが含まれます。
含まれないもの: このアーキテクチャは、マネージド AI Gateway サービス、Google の Gemini などの独自のモデル、モデルのファインチューニング プロセス、画像生成などの他のモダリティの GenAI モデルを対象としていません。これらの機能については、別のガイドで説明します。
対象読者: このドキュメントの主な対象読者は、GDC でのサービスのデプロイと管理を担当するプラットフォーム管理者と、エアギャップ環境内で AI ソリューションを設計するテクニカル アーキテクトです。デプロイされたモデルを操作するエンドユーザーとデベロッパーは、基盤となる構造を理解することでメリットを得られるセカンダリ オーディエンスです。
リファレンス アーキテクチャ
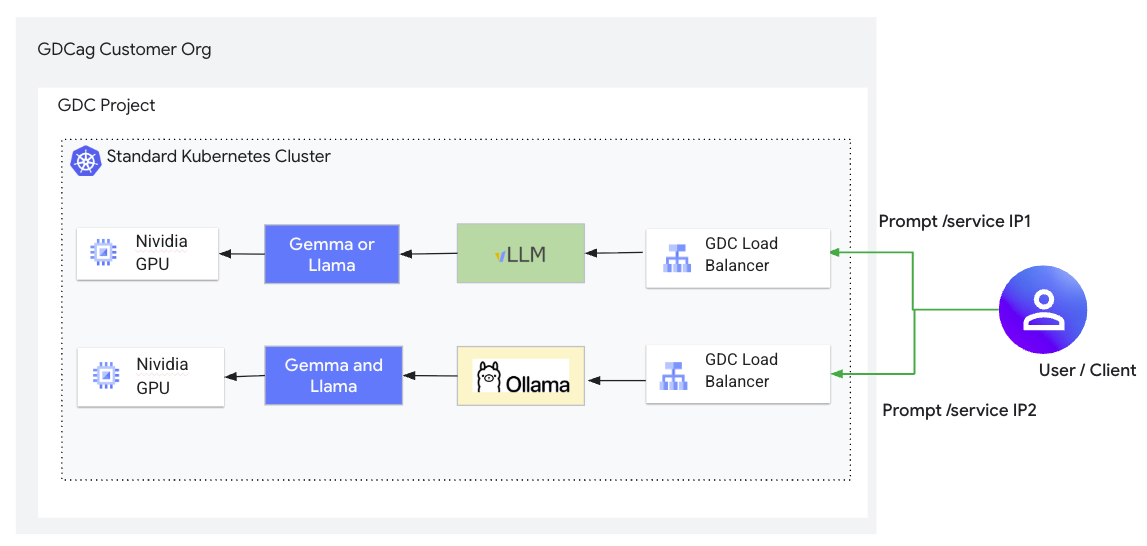
ソリューション コンポーネント
このソリューションは、次のコンポーネントを活用しています。
| ソリューション コンポーネント | 責任 | データフロー | インターフェース |
|---|---|---|---|
| GDC エアギャップ カスタマー ゾーン | Kubernetes クラスタ、ネットワーキング、ストレージ インフラストラクチャをホストする | 基盤プラットフォーム | IO のインフラストラクチャ管理インターフェース。プラットフォーム管理者とユーザー向けの Kubernetes API |
| ロードバランサ | LLM サービング Pod(vLLM、Ollama)を Kubernetes クラスタ外のトラフィックに公開し、安定した IP アドレスを提供します。 | 外部クライアント リクエストは、LoadBalancer の外部 IP に送信されます。LoadBalancer は、Service のセレクタに基づいて、正常なバックエンド Pod(vLLM または Ollama)にリクエストを分散します。 | Kubernetes Service API。GDC 環境内にネットワーク ロードバランサを自動的にプロビジョニングします。 |
| vLLM | 高スループットの LLM 推論サービング。PagedAttention などの手法を使用して、低レイテンシ向けに最適化されています。通常、インスタンスごとに 1 つのモデルをサービングします。 | クライアントから HTTP 推論リクエストを受信します。マウントされた PVC からモデルの重みを読み込みます。接続された GPU で計算を実行します。生成されたテキストを含む HTTP レスポンスを返します。 | 推論用の OpenAI 互換の RESTful API。JSON リクエストを受け入れます。 |
| Ollama | LLM 推論サービング。使いやすさを重視し、単一インスタンス内で複数のモデルを管理するように設計されています(ただし、一度にアクティブになるのは 1 つのみです)。 | HTTP 推論リクエストを受信します。モデルを読み込みます(多くの場合、コンテナ イメージ内にバンドルされているか、エアギャップがない場合は初回使用時にプルされます)。GPU で計算を実行します。HTTP レスポンスを返します。モデルは、一定期間使用されないとアンロードされます。 | Ollama RESTful API は JSON リクエストを受け入れます。CLI もあります。 |
| Nvidia GPU / MIG | LLM 推論用のハードウェア アクセラレーションを提供します。 | LLM バックエンド(vLLM、Ollama)は、推論を高速化するために、負荷の高いモデル計算(行列乗算など)を GPU にオフロードします。MIG を使用すると、単一の GPU をパーティショニングして、複数の小規模なモデル インスタンスで使用できます。 | Kubernetes のリソースタイプ(nvidia.com/gpu など)として公開されます。Pod はこれらのリソースをリクエストします。 |
| Harbor | vLLM、Ollama、ヘルパー Pod(busybox など)のコンテナ イメージを安全に保存して管理します。 | コンテナ イメージは、ビルド環境(インターネット アクセスが可能なワークステーションなど)から Harbor に push されます。Kubernetes ノードは、これらのイメージを Harbor から pull してコンテナを実行します。 | Docker Registry API。Kubernetes ノードは Harbor と連携して、Pod の作成時にイメージを pull します。ユーザーは Docker CLI または Harbor UI を使用してイメージを push します。 |
| 永続ボリュームの要求 | Pod のライフサイクルから切り離された LLM モデルの重み付けに永続ストレージを提供します。 | モデルファイルは Persistent Volume にコピーされます(ヘルパー Pod と kubectl cp を使用するなど)。vLLM サーバーは、起動時にこのマウントされたボリュームからモデルの重みを読み取ります。通常、Ollama はイメージ内にモデルをバンドルするため、この設定では Ollama モデルのストレージに PVC が使用されることはあまりありません。 |
Kubernetes ストレージ API。YAML で定義され、ボリュームとして Pod にマウントされます。 |
| プロジェクト ネットワーク ポリシー | ネットワーク分離を適用し、プロジェクト/Namespace レベルでトラフィック フローを制御します。承認されたトラフィックのみが LLM サービスに到達できるようにします。 | Namespace 内の Pod との間で送受信されるネットワーク トラフィックが検査されます。ポリシー ルールは、通常、送信元 IP 範囲や他のラベルに基づいて、LLM サービスポート(vLLM の場合は 8000、Ollama の場合は 11434 など)への接続が許可されるかどうかを決定します。 | Kubernetes networking.gdc.goog/v1 API。YAML で定義されます。 |
特長と機能
このリファレンス アーキテクチャは、次のコア機能を提供します。
- オープン ウェイト LLM サービング: さまざまなオープン ウェイト モデル(Gemma、Llama、DeepSeek など)のホスティングと推論を可能にします。
- コンポーネント: LLM サービング バックエンド(vLLM、Ollama)、Kubernetes Deployment/Pod。
- 責任: モデルの重みの読み込み、推論プロセスの管理、ハードウェア アクセラレータでのモデルの実行、エンドポイントの公開。
- インターフェース: 推論リクエスト用の REST API(vLLM 用の OpenAI 互換、Ollama 用の組み込み API)。通常は JSON を使用します。
- Bring Your Own Model(BYOM): ユーザーは、選択したオープン ウェイト LLM をエアギャップ環境にインポートしてデプロイできます。
- コンポーネント: Harbor、永続ボリュームの要求、Kubernetes。
- 責任: コンテナ イメージとモデルの重みを安全に保存します。モデルを環境に転送して、サービング エンジンからアクセスできるようにするメカニズム。
- インターフェース: Docker Registry API(Harbor 用)、Kubernetes API(PVC とボリューム マウント用)。
- ハードウェア アクセラレーション推論: GDC クラスタ内の NVIDIA GPU を活用して、LLM 推論を効率的に実行します。
- コンポーネント: NVIDIA GPU、Kubernetes、デバイス プラグイン。
- 責任: GPU リソースを持つノードで Pod をスケジューリングします。LLM バックエンド コンテナに GPU ハードウェアを公開します。パーティショニング用のマルチインスタンス GPU(MIG)をサポートします。
- インターフェース: Kubernetes API(
nvidia.com/gpuなどの GPU リソースをリクエストするため)。
- ネットワーク制御アクセス: LLM 推論エンドポイントへのアクセスが GDC 環境内で制御され、分離されるようにします。
- コンポーネント: Kubernetes Service(LoadBalancer)、ProjectNetworkPolicy。
- 責任: 安定した IP を使用して推論サービスを公開します。送信元、宛先、ポートに基づいて LLM バックエンドへのトラフィックを許可または拒否するネットワーク ルールを定義して適用する。
- インターフェース: Kubernetes API(Service と ProjectNetworkPolicy 用)。
- スケーラブルなサービング: 需要に基づいて容量を調整できます。
- コンポーネント: Kubernetes Deployment。
- 責任: LLM バックエンド Pod のレプリカ数を増やして、水平方向のスケーリングを有効にします。リソース リクエスト/上限を調整することによる垂直スケーリング。
- インターフェース: Kubernetes API(Deployment レプリカとリソースの管理用)。
アーキテクチャの原則
- セキュリティ優先: すべてのコンポーネントとデータは GDC エアギャップ境界内に存在するため、最大限のデータ セキュリティと制御が確保されます。ネットワーク アクセスは ProjectNetworkPolicies を使用して制限されます。
- データ主権: お客様はモデルとデータを完全に制御できます。運用に外部接続は必要ありません。
- オープンで柔軟: このアーキテクチャは、オープンソースのサービング バックエンド(vLLM、Ollama)を活用し、さまざまなオープン ウェイトの LLM をサポートしています。これにより、お客様は推論エンジンを選択でき、ベンダー ロックインを回避できます。
- コンポーネントの分離: モデル ストレージ(PVC)、イメージ管理(Harbor)、推論サービング(vLLM/Ollama Pod)などの主要な関数は個別のコンポーネントであるため、独立した管理と更新が可能です。
- スケーラビリティとパフォーマンス: Pod レプリカの数を増やして水平方向にスケーリングし、CPU/GPU リソースを調整して垂直方向にスケーリングするように設計されており、パフォーマンスの要求を満たします。vLLM は、高スループット、低レイテンシのシナリオで選択されます。
- リソースの最適化: NVIDIA マルチインスタンス GPU(MIG)をサポートし、小規模なモデルが GPU リソースを効率的に共有できるようにして、ハードウェアの使用率を最大化します。
- 標準インターフェース: オーケストレーション、デプロイ、サービス公開の Kubernetes 標準に基づいて構築されています。推論エンドポイントは REST API を提供します。vLLM は OpenAI との互換性を提供します。
- 復元力: Kubernetes のヘルスチェックとレプリケーションを活用して、サービスの可用性を確保します。
考慮事項
- スケーラビリティとパフォーマンス:
- 水平スケーリングは、vLLM と Ollama の両方の Kubernetes Deployment でレプリカの数を増やすことで実現されます。
- 垂直スケーリングでは、CPU/メモリの割り当てを増やし、GPU スライスを大きくします(最大で GPU 全体)。
- vLLM はインスタンスごとに 1 つのモデルをサービングするため、追加のモデルには新しいデプロイが必要になります。Ollama は複数のモデルを管理できますが、一度に実行できるのは 1 つだけです。
- PVC のサイズはモデルの読み込み時間に大きな影響を与えます。IOPS が高い場合は 500 GiB 以上をおすすめします。
- リソース管理:
- GPU リソースの慎重な計画が不可欠です。NVIDIA MIG を使用して、小規模なモデル用に GPU をパーティショニングし、使用率を向上させることができます。
- 推論とモデル管理の両方のオーバーヘッドを処理するために、十分な CPU とメモリを割り当てる必要があります。
- モデルサイズに対応し、パフォーマンスを確保するために、PVC に十分なストレージをプロビジョニングする必要があります。
- 可用性と信頼性:
- Kubernetes Deployment には、自己修復とローリング アップデートの機能があります。
- LoadBalancer Service は、正常な Pod 間でトラフィックを分散し、個々の Pod の障害をマスクします。
- モデルの重みを PVC に保存すると、Pod の再起動後も永続性が確保されます。
- 運用の複雑さ:
- Harbor でさまざまなバックエンドとバージョンのコンテナ イメージを管理する。
- モデルの重みをエアギャップ環境に安全に転送する手順。
- 各モデルとバックエンドの Kubernetes マニフェスト(Deployment、Service、PVC、ネットワーク ポリシー)の作成と管理。
- GPU 使用率、推論レイテンシ、エラー率をモニタリングします。
- セキュリティとコンプライアンス:
- ソリューション全体が GDC のエアギャップ セキュリティ境界内で動作します。
- 厳格なネットワーク分離を適用し、LLM エンドポイントへのアクセスを制御するには、ProjectNetworkPolicies が必須です。
- Harbor ロボット アカウントと Kubernetes イメージ pull シークレットにより、コンテナ イメージへの安全なアクセスが保証されます。
- 転送中のデータは、Kubernetes ネットワーク ポリシーとプラットフォーム レベルの暗号化で保護できます。PVC の保存データは、GDC ストレージの暗号化に依存します。
設計上の意思決定
このリファレンス アーキテクチャでは、次の重要な設計上の決定が行われています。
決定 1: vLLM と Ollama の両方を提供するのか、1 つの推論モデルのみを提供するのか
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| 推論レイヤとして VLLM と Ollama のいずれか 1 つのみを提供するか、両方を提供します。 | パフォーマンス、API 互換性、モデル管理の容易さに関する要件はユーザーやユースケースによって異なるため、両方を提供することにしました。 | vLLM は、本番環境アプリケーションに適した高スループット、低レイテンシのサービングと OpenAI API の互換性を提供します。Ollama は、セットアップが簡単で、複数のモデルの管理が容易で、ユーザー フレンドリーなインターフェースを備えているため、開発やテストに適しています。両方をサポートすることで、柔軟性が高まります。 |
決定 2: vLLM モデル ストレージに永続ストレージとオブジェクト ストレージのどちらを使用するか
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| vLLM では、モデルの重みが実行時にファイル システムに存在する必要があります。エアギャップ環境では、モデルをオンデマンドでダウンロードできません。 | 永続ボリューム クレームを使用すると、モデルの可用性が確保され、初回読み込み後の起動時間が短縮されますが、通常はヘルパー Pod を使用して PVC を入力する初期手順が必要になります。 | Persistent Volume Claim は、vLLM Pod のライフサイクルから切り離された、大規模なモデルファイル用の復元力と永続ストレージ レイヤを提供します。これにより、Pod の起動時にモデルをすばやく読み込むことができます。 |
決定 3: Ollama Docker イメージ内のモデルのバンドルとスタンドアロン イメージ
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| Ollama はモデルをダウンロードできますが、これにはインターネット アクセスが必要です。エアギャップ環境ではインターネット アクセスは利用できません。 | イメージをバンドルすると、外部呼び出しが不要になるため、エアギャップ環境でのランタイム オペレーションが簡素化されます。ただし、モデルを更新または追加するには、Docker イメージを再構築して Harbor に再プッシュする必要があります。 | モデルを事前にダウンロードして Docker イメージをビルドすると、Ollama は必要なモデルをオフラインで使用できるようになります。 |
決定 4: LoadBalancer サービスを使用して vLLM と Ollama を公開するか、ロードバランサを使用しないか
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| LLM API は、GDC 環境内のアプリケーションからアクセスできる必要があります。 | サービス公開の標準的な Kubernetes アプローチであるロードバランサを使用してサービスを公開することに決定しましたが、このアプローチは GDC プラットフォームの LoadBalancer プロビジョニングに依存しています。 | LoadBalancer タイプの Kubernetes Service は、LLM バックエンドを公開するための標準的で信頼性の高い方法を提供し、安定した IP アドレスを提供して負荷を分散します。 |
決定 5: 必須の ProjectNetworkPolicy を適用する
| コンテキスト | 重要な決定事項 | 根拠 |
|---|---|---|
| GDC エアギャップ デプロイでは、セキュリティと分離が重要です。 | ProjectNetworkPolicy は、ネットワーク ポリシーの慎重な定義が必要であるにもかかわらず、デプロイされた LLM サービスのセキュリティ ポスチャーを大幅に強化するため、適用することにしました。 | ProjectNetworkPolicies は、Namespace レベルでネットワーク分離を適用する Kubernetes ネイティブな方法を提供し、承認されたトラフィックのみが LLM サービスに到達できるようにします。 |
前提条件と制限事項
- GDC エアギャップ 1.15.1+ 環境が利用可能
- 標準クラスタに十分なハードウェア リソース(特に GPU)が存在する。
- Harbor インスタンスが設定され、アクセス可能である。
- ユーザーに必要な権限(Namespace Admin、Cluster Developer)がある。
- モデルが選択したサービング バックエンド(vLLM/Ollama)と互換性がある。
ユーザーフロー(エンドツーエンドの手順)
以下は、Google Distributed Cloud(GDC)のエアギャップ環境にオープン ウェイトの大規模言語モデル(LLM)をデプロイするための包括的なユーザーフローです。フローは、共通設定、2 つのデプロイ パス(vLLM と Ollama)、最終検証に分かれています。
1. 一般的な設定: イメージ管理
LLM をデプロイする前に、GDC 環境がプライベート Harbor レジストリからコンテナ イメージを pull する方法を構成する必要があります。
- Harbor ロボット アカウントを作成する: Harbor UI でロボット アカウントを生成し、「pull」権限を付与します。
- Docker を認証する: ネットワーク アクセス権のあるマシンから、ロボット アカウントの認証情報を使用して Harbor にログインします。
- Kubernetes Secret を作成する:
kubectlを使用して GDC プロジェクトの Namespace に docker-registry Secret を作成し、クラスタで使用する Harbor 認証情報を保存します。
2. デプロイパス A: vLLM(高スループット)
このパスは、Gemma-3 などのパフォーマンス重視のモデルのサービングにおすすめします。
- イメージを取得する: インターネットから vLLM Docker イメージを pull し、ローカルの Harbor レジストリ用にタグ付けして、Harbor に push します。
- モデル ストレージを準備する:
- モデルの重みを保存する 500 GiB の Persistent Volume Claim(PVC)を作成します。
- インターネットに接続されたマシンで Hugging Face から重みをダウンロードします。
- 一時的な「ヘルパー Pod」と
kubectl cpを使用して、これらの重みを GDC 環境内の PVC に転送します。
- バックエンドをデプロイする: vLLM イメージを参照し、モデルの重み PVC をマウントする Kubernetes Deployment マニフェストを適用します。
- サービスを公開する: vLLM API の外部 IP を提供する
LoadBalancerサービスを作成します。 - セキュア ネットワーク:
ProjectNetworkPolicyを適用して、サービスポート(通常は 8000)で上り(内向き)トラフィックを許可します。
3. デプロイパス B: Ollama(使いやすさ)
このパスは、モデルの重みがバンドルされているか、イメージにプリロードされている簡略化された設定に焦点を当てています。
- カスタム イメージをビルドする: Ollama をインストールし、
RUNコマンドを使用して特定のモデル(gemma3など)をイメージレイヤに「事前取得」する Dockerfile を作成します。 - Harbor に push: イメージをローカルでビルドし、限定公開の Harbor レジストリに push します。
- デプロイと公開: Ollama Deployment と
LoadBalancerサービスを作成します。 - セキュア ネットワーク: Ollama ポート(11434)に
ProjectNetworkPolicyを適用します。
4. 検証とテスト
デプロイが完了したら、サービスが機能していることを確認します。
- ステータスを確認する: Pod が「実行中」で、サービスに外部 IP アドレスが割り当てられていることを確認します。
- テスト推論:
- vLLM: OpenAI 互換の
/v1/chat/completionsエンドポイントを使用して、vLLMLoadBalancerIP アドレスにcurlリクエストを送信します。 - Ollama: Ollama
LoadBalancerIP アドレスの/v1/completionsエンドポイントにcurlリクエストを送信します。
- vLLM: OpenAI 互換の
5. 運用とスケーリング
- 垂直スケーリング: GPU スライスを増やすか、大規模なモデル用にマルチ GPU 構成に移行します。
- 水平スケーリング: デプロイ内のレプリカの数を増やして、より多くの同時ユーザー リクエストを処理します。
- トラブルシューティング:
kubectl logsを使用してログをモニタリングし、FIPS セルフテストの失敗やネットワーク ポリシーの制限などの一般的な問題を確認します。