


תיאור הבעיה
ארגונים שמריצים מודלי שפה גדולים (LLM) בסביבות עם air gap צוברים במהירות נקודות קצה של מודלים: כל מודל משקלים פתוחים שמופעל ב-Google Distributed Cloud עם air gap (ראו את המדריך הנלווה בנושא מודלים של משקלים פתוחים ב-GDC עם air gap) חושף את Kubernetes Service משלו, כתובת משלו, פרטי כניסה משלו ומחזור חיים תפעולי משלו.
מפתחי אפליקציות וסוכנים מוצאים את עצמם בבידוד ארכיטקטוני, מקודדים באופן קשיח נקודת קצה אחת לכל מודל וכותבים מחדש שילובים עם כל איטרציה של מודל. הפיצול הזה יוצר חוב טכני ומאט את הפריסה של עומסי עבודה קריטיים למשימה, מבוססי-סוכן ורב-שלביים.
גם שכבות רשת רגילות הן 'עיוורות ל-AI': מאזן עומסים רגיל מתייחס לתנועת נתונים של הסקה כמו ל-HTTP כללי, ולא יכול לקרוא את השדה model של בקשה, לתת עדיפות לעומסי עבודה שרגישים לזמן האחזור, להתחשב בטוקנים במקום בבקשות או להפנות בקשה לשרת העתק של המודל שכבר מכיל את מטמון ה-KV הרלוונטי. באשכולות GPU עם מרווח אוויר בעלות גבוהה, זה מוביל לניצול חלקי של החומרה ולהחזר השקעה נמוך. Gemini on GDC מספק מודלים מנוהלים מתקדמים, אבל לקוחות שמשלבים אותם עם מודלים בקוד פתוח שמתארחים באופן עצמאי צריכים שכבת הסקה שמציעה גמישות כמו בענן בלי לפגוע בריבונות הנתונים: אף בקשה, הנחיה או משקל של מודל לא יכולים לצאת מגבולות GDC.
הצעה לפתרון
במאמר הזה מתוארת ארכיטקטורת ההפניה של שער AI בניהול עצמי ב-GDC עם air gap: שכבת היסק מאובטחת ומרוכזת שנותנת לאפליקציות נקודת קצה אחת שתואמת ל-OpenAI לכל המודלים, ומנתבת כל בקשה לבק-אנד הנכון. ההטמעה לדוגמה מבוססת על Kubernetes Gateway API: Envoy Gateway היא הטמעה של Gateway API (מישור הבקרה ומישור הנתונים של Envoy proxy), ו-Envoy Agent Router (לשעבר Envoy AI Gateway) מרחיב אותה עם עיבוד בקשות ספציפי ל-AI: חילוץ מודלים מגוף הבקשה, תרגום בקשות ותגובות, אימות במעלה הזרם, ניהול אסימונים, ואופציונלית, הגבלת קצב מבוססת אסימונים. התוסף Gateway API
Inference מוסיף בחירת נקודות קצה שמודעת לשרת המודלים (InferencePool
ו-Endpoint Picker) כדי להשתמש ביכולות ה-GPU בצורה יעילה. כל הארטיפקטים מועברים לרישום ב-Harbor של ארגון GDC, והמערך כולו פועל באשכול רגיל ללא קישוריות חיצונית.
מה כלול: הארכיטקטורה הזו כוללת פריסה של Envoy Gateway ו-Envoy Agent Router באשכול רגיל, משאבי Gateway API (GatewayClass, Gateway) ומשאבי Envoy Agent Router (AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, GatewayConfig) שחושפים נקודת קצה מאוחדת שתואמת ל-OpenAI, ניתוב מבוסס-גוף בשדה model, תוסף Gateway API Inference (InferencePool, InferenceObjective, Endpoint Picker) לאיזון עומסים מבוסס-מודל, הגבלת קצב אופציונלית מבוססת-טוקן עם Redis, סיום TLS בשער, מדיניות רשת (NetworkPolicy / ProjectNetworkPolicy) וניהול ארטיפקטים מבודד ב-Harbor. העורפים (backends) של מודלים שמשרתים בקשות מאחורי השער (Ollama, vLLM) נפרסים באמצעות מדריך נלווה להגדרת מודלים עם משקלים פתוחים ב-GDC ללא חיבור לאינטרנט.
מה לא נכלל: הארכיטקטורה הזו לא כוללת מוצר של שער AI מנוהל, פריסה וכוונון של המודלים עצמם (ערכת מדריכים נלווים), כוונון של מודלים, שיטות של AI גנרטיבי שאינן מבוססות על מודלים גדולים של שפה (LLM), תנועה של סוכנים לכלים (MCPRoute) או הפצות של שערים עם תמיכה מסחרית. Gemini ב-GDC הוא יכולת מנוהלת של המוצר. הקצאת המשאבים שלו לא נכללת בהיקף של המדריך הזה, ובגרסה הזו של המדריך מבוצעת אימות של השער באמצעות מודלים בקוד פתוח שמתארחים באופן עצמאי.
קהל: קהל היעד העיקרי של המסמך הזה כולל את מנהלי הפלטפורמה שאחראים על פריסת השער והפעלתו באשכול רגיל, ואת הארכיטקטים הטכניים שתפקידם לתכנן פלטפורמות AI בסביבה עם פער אוויר. מפתחי אפליקציות שמשתמשים בנקודת הקצה המאוחדת הם קהל משני שיכול להפיק תועלת מהבנה של אופן ניתוב הבקשות שלהם.
ארכיטקטורה
הפתרון פועל כולו באשכול רגיל של ארגון GDC עם air gap. בשכבת השירותים, תקן Kubernetes Gateway API מבצע סטנדרטיזציה של מודל ההגדרה. מישור הבקרה של שער ה-AI (הבקר של Envoy Gateway והבקר של Envoy Agent Router) קורא את משאבי Gateway API ו-Envoy Agent Router ומגדיר את מישור הנתונים: פרוקסי Envoy Deployment שהוא נקודת הכניסה לבקשה (חשוף דרך Service מסוג LoadBalancer) ומעבד חיצוני של Envoy Agent Router שפועל כ-Sidecar בפרוקסי Pod ומבצע את הלוגיקה הספציפית ל-AI. בשכבת האפליקציה, עומסי עבודה של לקוחות (אפליקציות וסוכנים) שולחים בקשת AI לשרת ה-proxy (1), שרת ה-proxy מעביר את הבקשה למעבד החיצוני, ששולף את שם המודל, מתרגם את הבקשה ומתעד את השימוש באסימונים (2), שרת ה-proxy מעביר את התנועה המאוזנת אל Podההסקה של המודל שנבחר (3), והמודל פועל בצמתי ה-GPU של שכבת התשתית (4). העורפים של שרת המודלים מצורפים לשער כ-AIServiceBackend (כל Service שתואם ל-OpenAI) או כ-InferencePool, שבו Endpoint Picker בוחר את העותק המשוכפל הכי טוב לכל בקשה. קובצי אימג' של קונטיינרים וטבלאות Helm נמשכים מ-Harbor.
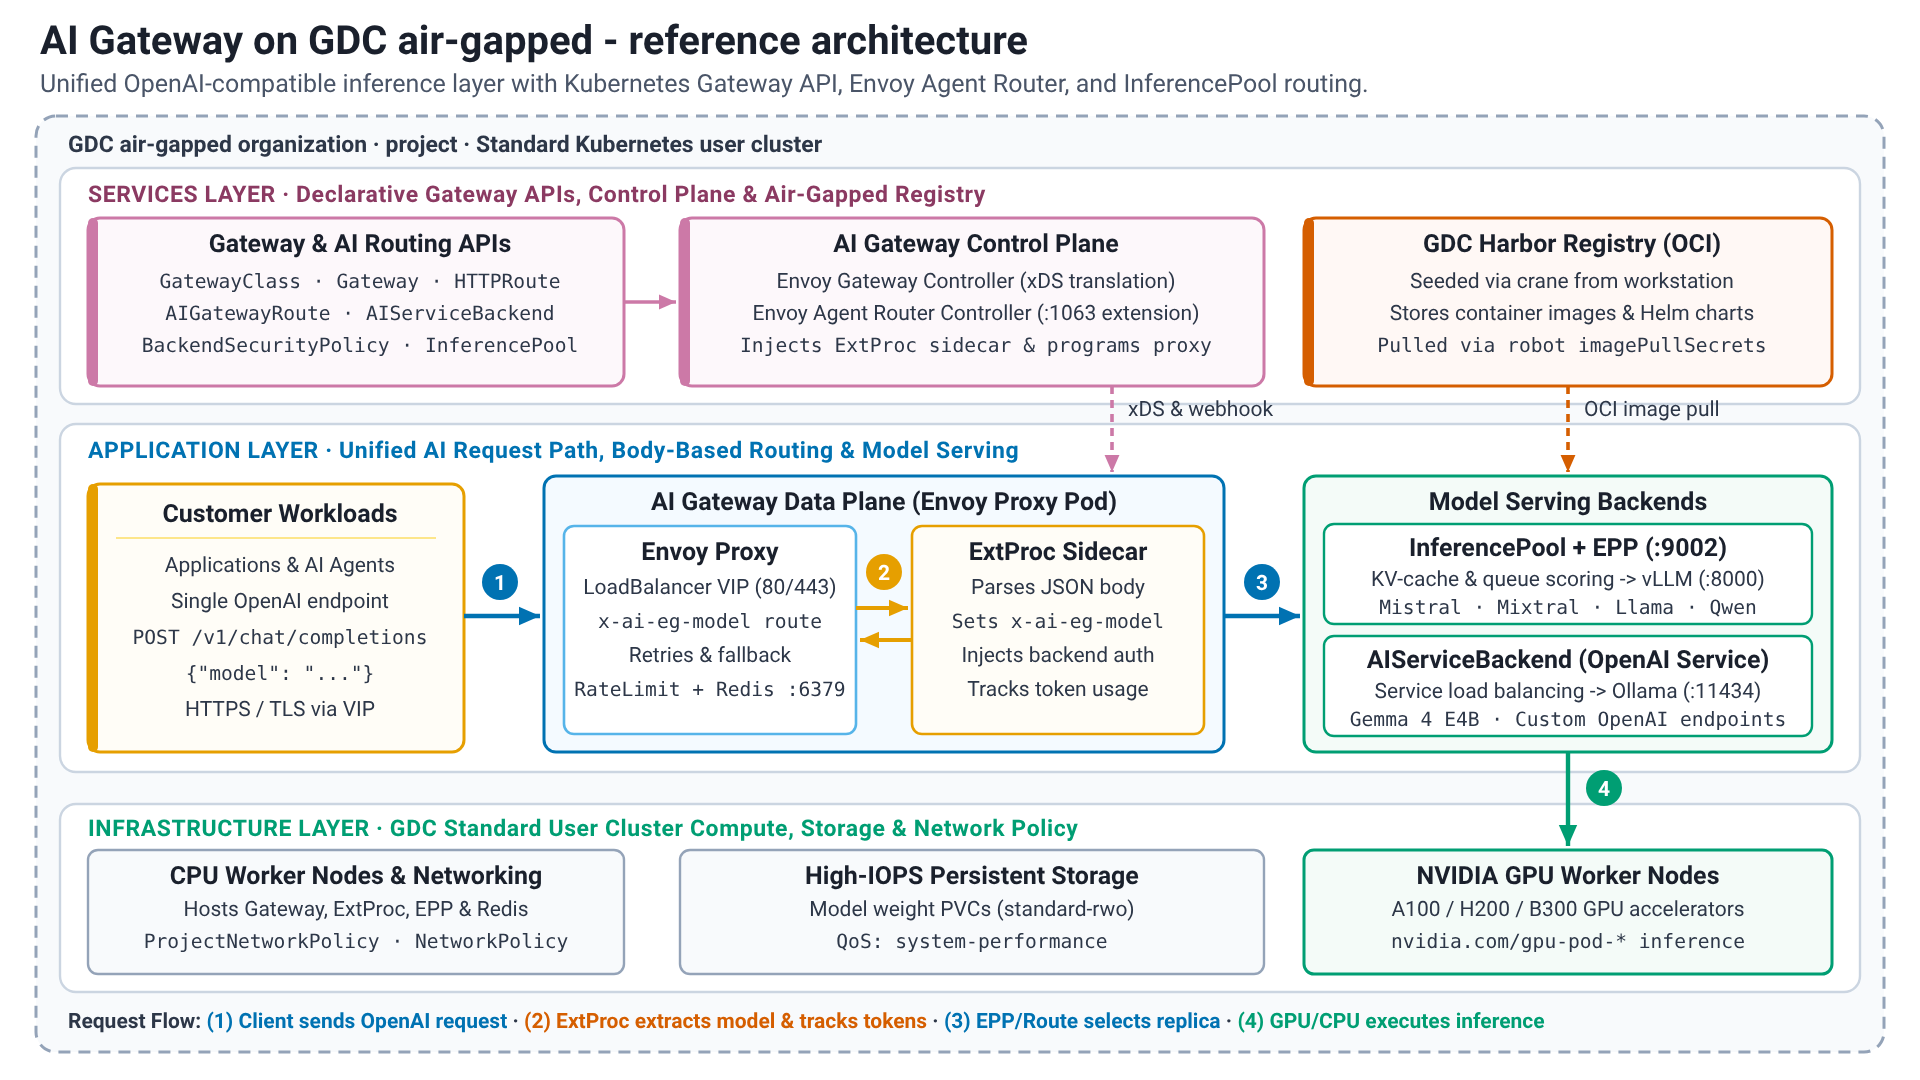
רכיבי הפתרון
הפתרון משתמש ברכיבים הבאים:
| רכיב הפתרון | תחומי האחריות | זרימת נתונים | ממשקים |
|---|---|---|---|
| Kubernetes Gateway API | מודל משאבים סטנדרטי ומבוסס-תפקידים לכניסה ולניתוב: GatewayClass (בבעלות הפלטפורמה), Gateway (מאזינים, TLS) ומשאבי ניתוב (בבעלות צוותי האפליקציה). הגרסה החדשה של Ingress API, ללא הערות ספציפיות לספק. |
ההגדרה היא הצהרתית בלבד. הבקרים עוקבים אחרי המשאבים, ולא מעבירים תנועת בקשות. | Kubernetes API (gateway.networking.k8s.io/v1); ה-CRD מותקנים מתרשים ה-CRD של Envoy Gateway. |
| Envoy Gateway controller (control plane) | מטמיע את Gateway API: מקצה Envoy proxy אחד Deployment ו-LoadBalancer Service לכל Gateway, מתרגם מסלולים ומדיניות (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) להגדרת xDS, מפעיל את שירות הגבלת הקצב הגלובלי כשהוא מוגדר, וקורא לשרת Envoy Agent Router extension דרך מנהל התוספים שלו כדי להוסיף קצה עורפי InferencePool לתרגום. |
הכלי עוקב אחרי Kubernetes API ושולח את הגדרת xDS אל ה-proxies; אין תנועת בקשות. | Kubernetes API (watch), xDS gRPC אל ה-proxies, gRPC אל שרת התוסף (יציאה 1063). |
| Envoy Agent Router controller (control plane) | מבצעת התאמה בין משאבי aigateway.envoyproxy.io/v1beta1, AIGatewayRoute (כללי ניתוב בשם המודל שחולץ), AIServiceBackend (קצה עורפי עם סכימת ה-API שלו), BackendSecurityPolicy (פרטי כניסה של שרתים במעלה הזרם) ו-GatewayConfig (הגדרות של מעבד חיצוני לכל Gateway) למשאבי Envoy Gateway, מחדירה את מעבד הצד החיצוני ל-Envoy proxy Pods ומגישה את שרת התוסף שמשמש את Envoy Gateway. |
הגדרה בלבד. | Kubernetes API, שרת הרחבות gRPC (יציאה 1063), webhook לשינוי הרשאות לצורך הזרקת sidecar. |
| Envoy proxy (data plane) | נקודת הכניסה לבקשה: מסיימת את TLS, מתאימה בין מאזינים ומסלולים, מבצעת איזון עומסים בין נקודות קצה (endpoint) בקצה העורפי, אוכפת מגבלות קצב וזמני קצוב, מנסה שוב וחוזר לקצה עורפי חלופי, ופולטת יומני גישה ומדדים. | מקבל בקשות מלקוחות ב-LoadBalancer VIP (80/443), מתייעץ עם המעבד החיצוני לגבי כל בקשת AI, מעביר את הבקשה לנקודת הקצה שנבחרה בעורף (Service או Pod שנבחרו על ידי הכלי לבחירת נקודות קצה) ומזרים את התשובה בחזרה ללקוח. |
HTTP/HTTPS ללקוחות (API שתואם ל-OpenAI), ext_proc gRPC ל-Sidecar ול-Endpoint Picker, HTTP לשרתי הקצה העורפיים, gRPC לשירות הגבלת הקצב. |
| מעבד חיצוני (ExtProc) של נתב Envoy Agent | מנתח את גוף הבקשה שתואם ל-OpenAI, מחלץ את השדה model לכותרת הניתוב x-ai-eg-model, מחיל שינויים בשמות המודלים, מתרגם את נתוני הבקשה והתגובה בין סכימת ה-API של הלקוח לבין סכימת ה-API של השרת העורפי, מוסיף את פרטי הכניסה של ה-upstream שמוגדרים על ידי BackendSecurityPolicy, ומחלץ את השימוש בטוקנים (קלט, פלט, סך הכול) מהתגובה למטא-נתונים דינמיים שמשמשים להגבלת קצב מבוססת-טוקנים ולמדדים. |
מאגר Sidecar ב-Envoy proxy Pod; מעבד גופי בקשות ותשובות, כולל תשובות בסטרימינג. |
Envoy ext_proc gRPC; נקודת קצה של מדדי Prometheus. |
| Gateway API Inference Extension (InferencePool + Endpoint Picker) | InferencePool (inference.networking.k8s.io/v1) מקבץ את ה-Pod של פריסת שרת מודל אחד (למשל, בורר תוויות, יציאת יעד 8000) ומפנה ל-Endpoint Picker (EPP). InferenceObjective (v1alpha2) מקצה עדיפות לכל מודל או יעד. ה-EPP סורק את מדדי שרת המודל (עומק תור הבקשות, ניצול מטמון KV, מתאמי LoRA שנטענו) ובוחר את נקודת הקצה לכל בקשה. |
הפרוקסי קורא ל-EPP (ext_proc, יציאה 9002) עם כותרות הבקשה. ה-EPP עונה עם נקודת הקצה לשימוש. הפרוקסי מעביר את הבקשה לנקודת הקצה Pod. |
Kubernetes API (CRD), gRPC ext_proc (9002), Prometheus scrape של שרתי המודלים. |
| Redis (אופציונלי) | מאגר הנתונים של שירות הגבלת הקצב של Envoy: מונים משותפים למגבלות מבוססות-בקשות ומבוססות-אסימונים בכל העותקים של ה-proxy. נדרש רק אם מוגדרת הגבלת קצב גלובלית. | שירות הגבלת הקצב קורא את המונים ומגדיל אותם ביציאה 6379 לכל בקשה מוגבלת. | פרוטוקול Redis (6379). Redis 8.10 שפרוס באשכול, או מכונת Redis קיימת. |
| שרתי קצה עורפיים לפרסום מודלים (Ollama / vLLM) | הגשת מודלים פתוחים מאחורי השער; פריסה באמצעות מדריך ההגדרות הנלווה בנושא מודלים פתוחים ב-GDC עם פער אוויר. מצורף כ-AIServiceBackend (כל Service שתואם ל-OpenAI, למשל Ollama) או כ-InferencePool (שרתי מודלים כמו vLLM שחושפים את המדדים שמשמשים את הכלי לבחירת נקודות קצה לדירוג). |
מקבל את הבקשות שמועברות מהפרוקסי, מריץ הסקה בצמתי ה-GPU (או ב-CPU להערכה פונקציונלית עם מודלים קטנים) ומחזיר את התגובה שתואמת ל-OpenAI. | API בארכיטקטורת REST שתואם ל-OpenAI: vLLM ביציאה 8000, Ollama ביציאה 11434; מדדי Prometheus (vLLM) עבור Endpoint Picker. |
| Harbor | מאחסן את קובצי האימג' של הקונטיינרים (Envoy proxy, Envoy Gateway, Envoy Agent Router controller ומעבד חיצוני, שירות הגבלת קצב, Endpoint Picker, Redis) ואת תרשימי Helm (ארטיפקטים של OCI) של הפתרון. | פריטי מידע מועתקים מהמאגרים הציבוריים אל Harbor באמצעות seed_registry.sh (crane) מתחנת עבודה עם גישה לאינטרנט. האשכול שולף תמונות באמצעות חשבון רובוט דרך סודות שאיבת תמונות, והתרשימים מוצגים מ-Harbor באמצעות helm template. |
OCI Distribution API; ממשק המשתמש של Harbor וחשבונות רובוט. |
| אשכול סטנדרטי וצמתים של מעבדים גרפיים | מארח את כל רכיבי השער (מספיקים צמתי CPU) ואת ההסקה Pods (צמתי GPU עם משאבי המאיץ שזוהו מהצמתים). השירות מספק LoadBalancer כתובות IP וירטואליות, אחסון מתמיד למשקלי המודל ולאכיפת מדיניות רשת ב-Kubernetes. |
פלטפורמה בסיסית; הבקשות נכנסות דרך LoadBalancer ה-VIP של Gateway ונשארות בתוך רשת האשכול. |
Kubernetes API, ממשקי API של GDC לניהול רשת (networking.gdc.goog/v1 ProjectNetworkPolicy), מסוף GDC ו-gdcloud לאדמין של הפלטפורמה. |
תכונות ויכולות
ארכיטקטורת ההפניה הזו מספקת את היכולות הבסיסיות הבאות:
- נקודת קצה מאוחדת שתואמת ל-OpenAI: אפליקציות קוראות לכתובת אחת (
/v1/chat/completions,/v1/modelsוכו') לכל מודל שמופעל מאחורי השער.- רכיבים:
Gateway, AIGatewayRoute, שרת proxy של Envoy, מעבד חיצוני. - תחומי אחריות: חשיפת כתובת IP וירטואלית יציבה, סיום TLS, קבלת פורמט הבקשה שתואם ל-OpenAI והמרתו לסכימת ה-Backend כשצריך.
- ממשקים: HTTPS REST (JSON, כולל אירועים שנשלחים מהשרת לסטרימינג).
- רכיבים:
- ניתוב שמבוסס על גוף הבקשה (מודע למודל): שער הגישה קורא את השדה
modelשל גוף הבקשה ומנתב את הבקשה אל ה-Backend התואם בלי לוגיקה של נקודת קצה בצד הלקוח.- רכיבים: מעבד חיצוני, התאמת כללים ב-
AIGatewayRouteעלx-ai-eg-model,AIServiceBackend,InferencePool. - תחומי אחריות: חילוץ שם המודל, התאמה לכללי ניתוב, שינוי שם של מודלים (
modelNameOverride), פיצול תנועה לפי משקל וחזרה לשרתי קצה עורפיים חלופיים לפי עדיפות. - ממשקים: Kubernetes API (
aigateway.envoyproxy.io/v1beta1).
- רכיבים: מעבד חיצוני, התאמת כללים ב-
- איזון עומסים עם מודעות לשרת המודל: בקשות ל-
InferencePoolנשלחות לרפליקה עם התור הקצר ביותר ומטמון ה-KV הכי שימושי, במקום בשיטת סדר סיבובי.- רכיבים: Gateway API Inference Extension (
InferencePool,InferenceObjective, Endpoint Picker). - תחומי אחריות: גירוד מדדים של שרת מודל, נקודות קצה של ניקוד (עומק התור, ניצול מטמון KV, קרבה למטמון קידומת, מתאמי LoRA), כיבוד סדרי עדיפויות לכל מטרה תחת עומס.
- ממשקים: Kubernetes API (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), ext_proc gRPC (9002).
- רכיבים: Gateway API Inference Extension (
- מדיניות אבטחה ואימות במעלה הזרם: שער הכניסה מחדיר פרטי כניסה למערכות עורפיות שדורשות אותם, והפרטים האלה אף פעם לא מופצים לאפליקציות.
- רכיבים:
BackendSecurityPolicy, Envoy GatewaySecurityPolicy, מאזיני TLS. - אחריות: הוספת מפתחות API לשרתי הקצה העורפיים, סיום TLS של הלקוח ב-
Gateway, אכיפת מדיניות אימות והרשאה של הלקוח כשנדרש. - ממשקים: Kubernetes
Secrets שאליהם מתייחסים הכללים.
- רכיבים:
- הגבלת קצב יצירת הבקשות על בסיס טוקנים (אופציונלי): השימוש נמדד בטוקנים, ולא רק בבקשות.
- רכיבים: מעבד חיצוני (
llmRequestCosts), Envoy GatewayBackendTrafficPolicy(מגבלת קצב גלובלית), שירות מגבלת קצב, Redis. - אחריות: חילוץ של נתוני קלט, פלט וסך כל הטוקנים מכל תגובה, צירוף שלהם כעלויות בקשה, אכיפה של תקציבים לכל צרכן או לכל מודל בכל העותקים של ה-proxy.
- ממשקים: Kubernetes API, Redis (6379).
- רכיבים: מעבד חיצוני (
- ניהול תנועה: היכולות הרגילות של Gateway API חלות על תנועת נתונים מבוססת-AI.
- רכיבים:
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - אחריות: התאמה לפי מארח, נתיב וכותרת, פסק זמן שמתאים ליצירה ארוכה, ניסיונות חוזרים, פיצול תנועה משוקלל ומעבר חזרה בין קצה עורפי לקצה עורפי על סמך עדיפות.
- ממשקים: Kubernetes API.
- רכיבים:
- יכולת צפייה: מדדים של בקשות, חביון וטוקנים זמינים לכל מודל.
- רכיבים: יומני גישה ונתונים סטטיסטיים של שרת proxy של Envoy, מדדים של מעבד חיצוני (שימוש בטוקנים, משך הבקשה, הזמן עד הטוקן הראשון), מדדים של Endpoint Picker.
- תחומי אחריות: חשיפת מדדים בפורמט Prometheus ויומני גישה מובנים שניתן לגרד מהם נתונים באמצעות חבילת כלי התצפית של GDC או באמצעות Prometheus בניהול הלקוח.
- ממשקים: נקודות קצה של מדדי Prometheus, יומנים של פלט סטנדרטי.
- ניהול ארטיפקטים ב-Air-gap: כל תמונה וכל תרשים עוברים הכנה ב-Harbor לפני ההתקנה.
- רכיבים: Harbor,
seed_registry.sh, חשבונות רובוט, סודות של משיכת תמונות,EnvoyProxyמשאב (תמונת proxy וסוד משיכה). - תחומי אחריות: הפצת תמונות וגרפים של OCI Helm מתחנת עבודה מחוברת, הצמדת גרסאות, עיבוד גרפים אופליין באמצעות
helm template. - ממשקי API: OCI Distribution API, Kubernetes API.
- רכיבים: Harbor,
עקרונות אדריכליים
- קודם כל סטנדרטים: השער מוגדר באמצעות Kubernetes Gateway API ותוסף ההסקה שלו, והוא מתקשר עם ה-API שתואם ל-OpenAI באפליקציות, כך שהאפליקציות, המסלולים והעורפים נשארים ניידים בין יישומי השער.
- אבטחה לפני הכול: כל הרכיבים והנתונים נמצאים בתוך הגבול של GDC שמוגן על ידי בידוד פיזי. ה-TLS מסתיים ב-
Gateway, פרטי הכניסה של ה-backend מוזרקים על ידי השער, והגישה לרשת מוגבלת באמצעות אובייקטים שלNetworkPolicyו-ProjectNetworkPolicy. - ריבונות נתונים: פרומפטים, תשובות, משקלי מודלים ונתוני שימוש אף פעם לא יוצאים מהארגון של הלקוח ב-GDC. לא נדרש חיבור חיצוני כדי להשתמש בשירות.
- הפרדה בין תחומים: Gateway API מבוסס-תפקידים מאפשר לאדמין של הפלטפורמה להיות הבעלים של
GatewayClass,Gateway, TLS ומדיניות הרשת, בעוד שצוותי האפליקציות הם הבעלים של משאביAIGatewayRoute,AIServiceBackendו-InferencePoolבמרחבי השמות שלהם. - מישור בקרה ומישור נתונים מופרדים: בקרי התעבורה מתרגמים רק את ההגדרה. נתיב הבקשה מורכב מ-Envoy proxy, ממעבד חיצוני של sidecar ומ-Endpoint Picker, שממשיכים להעביר תנועה אם בקרי התעבורה מופעלים מחדש.
- פתוח וגמיש: הארכיטקטורה משתמשת בתוכנות קוד פתוח (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension, Ollama, vLLM) ואפשר להשתמש באותם משאבי Gateway API ביישומים חלופיים.
- מדרגיות וביצועים: מישור הנתונים מתרחב אופקית על ידי הוספת עותקים משוכפלים של שרת proxy, ואנכית על ידי התאמת המעבד וזיכרון הגישה האקראית (RAM). איזון עומסים שמודע לשרת המודל שומר על ניצול מלא של יחידות העיבוד הגרפי (GPU) בלי להעמיס יתר על המידה על עותקים משוכפלים בודדים.
- חוויית משתמש קצה פשוטה יותר: נקודת קצה אחת, פורמט API אחד ואישורי גישה אחדים לכל מודל מקצרים את הדרך מפריסת המודל לשימוש בו.
- עמידות: בדיקות התקינות והשכפול של Kubernetes, הניסיונות החוזרים של Envoy והמעבר לגיבוי בין קצה עורפי לקצה עורפי על סמך עדיפות, שומרים על הזמינות של נקודת הקצה כשעותקים של מודלים נפרדים נכשלים.
לתשומת ליבכם
- יכולת הרחבה וביצועים:
- רכיבי השער הם עומסי עבודה שמתבססים רק על CPU. פרוקסי Envoy
DeploymentשלGatewayמתרחב אופקית על ידי הגדלת מספר העותקים שלו (משאבEnvoyProxy) ואנכית על ידי הגדלת בקשות ה-CPU והזיכרון. הבדיקה של גוף הבקשה על ידי המעבד החיצוני כרוכה בעלויות CPU שפרופורציונליות לגודל הבקשה והתגובה. תגובות שמועברות בסטרימינג מעובדות באופן מצטבר. - איזון עומסים עם מודעות לשרת המודל חל רק על קצה עורפי שמצורף כ-
InferencePool. קצה עורפי שמצורף כ-AIServiceBackendמאוזן על ידי ה-proxy בין נקודות הקצה של ה-Serviceשלו. - השער לא מוסיף קיבולת GPU: התפוקה והחביון מוגבלים על ידי שרתי המודל. כדאי להתאים את גודל הפריסות של המודלים באמצעות ערכת המדריכים הנלווית (vLLM לתפוקה גבוהה, Ollama לשימוש קל ולהערכה ב-CPU בלבד).
- יצירות ארוכות דורשות פרקי זמן ארוכים יותר להמתנה בין בקשות ולחוסר פעילות מאשר ממשקי API רגילים של HTTP. לכן, צריך להגדיר אותם במסלולים ובמדיניות ולא בלקוחות.
- רכיבי השער הם עומסי עבודה שמתבססים רק על CPU. פרוקסי Envoy
- ניהול משאבים:
- כל רכיבי השער פועלים בצמתי CPU ולא נדרש מאיץ. בטבלה הבאה מפורטים גדלים משוערים לפריסה פונקציונלית. ההטמעה לדוגמה מגדירה את הבקשות והמגבלות המדויקות. הערכים בסביבת הייצור תלויים בקצב הבקשות ובגדלים של נתוני התשלום.
- בטבלת היציאות שבהמשך מפורטות כל היציאות שצריכות להיות פתוחות במדיניות הרשת.
- תכנון ה-GPU שייך לפריסות המודלים: שמות משאבי ההאצה מתגלים מהצמתים כפי שמתואר במדריך הנלווה.
הערכה לגבי גודל הרכיבים של השער (מעבד בלבד)
| רכיב | עותקים | מעבד (בקשה) | זיכרון (בקשה) | הערות |
|---|---|---|---|---|
| Envoy Gateway controller | 1 | 100 מ' עד 500 מ' | 256Mi–1Gi | מישור הבקרה; לא נמצא בנתיב הבקשה |
| Envoy Agent Router controller | 1 | 100 מ' עד 500 מ' | 256Mi–512Mi | מישור הבקרה ושרת התוסף |
Envoy proxy Pod (proxy + external processor sidecar) |
1-2 לכל Gateway |
500 מ'–2 | 512Mi–2Gi | התאמה לקצב הבקשות ולגודל המטען הייעודי (payload) |
| כלי לבחירת נקודת קצה | 1 לכל InferencePool |
100 מ' עד 500 מ' | 256Mi–512Mi | שליפת מדדים משרת המודל |
| שירות הגבלת קצב (אופציונלי) | 1 | 100 מ' עד 500 מ' | 256Mi–512Mi | רק עם הגבלת קצב גלובלית |
| Redis (אופציונלי) | 1 | 100 מ' עד 500 מ' | 256Mi–1Gi | רק עם הגבלת קצב גלובלית |
יציאות רשת
| יציאה | רכיב | מטרה |
|---|---|---|
| 80 / 443 | שרת proxy של Envoy (Gateway listeners) |
נקודת כניסה ל-HTTP או ל-HTTPS ב-LoadBalancer VIP |
| 1063 | בקר נתב Envoy Agent (שרת הרחבה) | שיחות gRPC ממנהל התוספים של Envoy Gateway |
| 9002 | כלי לבחירת נקודת קצה | שיחות ext_proc gRPC משרת ה-proxy של Envoy |
| 6379 | Redis | המונים של הגבלת קצב של יצירת בקשות |
| 8000 | vLLM | API תואם ל-OpenAI ומדדים של שרת המודל |
| 11434 | Ollama | Ollama ו-API תואם ל-OpenAI של שרת המודלים |
- זמינות ומהימנות:
- הפרוקסי והמעבד החיצוני פועלים באותו
Pod. כמה עותקים מאחורי המסכהLoadBalancerServiceמסתירים כשלים בודדים ב-Pod, והבקרי יכולים להפעיל מחדש בלי להפריע לתעבורה. - כללי
AIGatewayRouteיכולים לכלול רשימה של כמה שרתים עורפיים עם עדיפויות, כך שאם שרת עורפי לא תקין, שער הגישה יחזור לקבוצת עותקים או לשרת מודלים אחר. - הכלי לבחירת נקודת קצה הוא
Deploymentלכל מאגר. אם הוא לא זמין, הבקשות ל-InferencePoolהזה נכשלות עד שהוא חוזר לפעולה. מריצים אותו עם בקשות למשאבים ובדיקות מוכנות, ועוקבים אחריו כמו אחרי רכיב של מישור הנתונים. - Redis מחזיק רק מוני הגבלת קצב; הפסקת שירות של Redis משפיעה על הגבלת קצב, ולא על ניתוב.
- הפרוקסי והמעבד החיצוני פועלים באותו
- מורכבות תפעולית:
- התאמה בין הגרסאות של Envoy Gateway, Envoy Agent Router ותוסף ההסקה של Gateway API: צריך לשדרג את שלושתם יחד עם השילוב שנבדק (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, Gateway API Inference Extension 1.5.0).
- מחזור חיים עם בידוד פיזי: כל תמונה ותרשים נזרעים מחדש ב-Harbor בכל שדרוג. משאב
EnvoyProxyוערכי התרשים מצמידים את המרשם ואת סוד המשיכה. - שתי שכבות הגדרה:
GatewayClass/Gateway/EnvoyProxyבבעלות הפלטפורמה ו-AIGatewayRoute/AIServiceBackend/InferencePoolבבעלות הצוות. צירוף מודל חדש אומר הוספת כלל מסלול וקצה עורפי, לא שער חדש. - מעקב: קצב הבקשות, זמן האחזור (כולל הזמן עד לקבלת הטוקן הראשון), השימוש בטוקנים לכל מודל ולכל צרכן, הניקוד של הכלי לבחירת נקודות קצה וניצול ה-GPU של שרתי המודלים.
-
InferenceObjectiveהוא עדיין ממשק API בשלב אלפא (v1alpha2). יכול להיות שיהיו שינויים בסכימה בין גרסאות של Inference Extension.
- אבטחה ותאימות:
- הפתרון כולו פועל בתוך היקף האבטחה של GDC שמופרד פיזית מהרשת.
- מדיניות הרשת היא חובה: מרחב השמות
NetworkPolicyמאפשר תנועה מהפרוקסי ליציאות של שרת המודל (8000, 11434) ול-Endpoint Picker (9002), ומרחב השמותProjectNetworkPolicyמאפשר תנועה של לקוחות ל-VIP LoadBalancerכשצרכנים נמצאים מחוץ לפרויקט. - ה-TLS מסתיים ב-
Gatewayעם אישור שמאוחסן ב-Secretשל Kubernetes. הלקוחות רואים רק את נקודת הקצה של השער. - פרטי כניסה של שרתים במעלה הזרם (לדוגמה, מפתח API שנדרש על ידי שרת מודלים) מאוחסנים ב-
Secretשאליהם מתבצעת הפניה על ידיBackendSecurityPolicyומוזרקים על ידי השער, כך שאפליקציות אף פעם לא מחזיקות בפרטי כניסה של הבק-אנד. - הגבלת קצב יצירת הבקשות מבוססת-טוקנים, ומגבילה את צריכת הקיבולת היקרה של ה-GPU לכל צרכן או לכל מודל.
- חשבונות רובוט של Harbor וסודות למשיכת תמונות של Kubernetes מבטיחים גישה מאובטחת לתמונות של קונטיינרים. RBAC של Gateway API מבוסס-תפקידים מפריד בין האחריות של הפלטפורמה לבין האחריות של האפליקציה.
החלטות עיצוביות
ההחלטות העיקריות הבאות התקבלו לגבי ארכיטקטורת ההפניה הזו:
החלטה 1: הטמעה של שער AI: נתב Envoy Agent בקוד פתוח ב-Envoy Gateway לעומת הפצות חלופיות
| הקשר | החלטה חשובה | הסבר |
|---|---|---|
| שער ה-AI הוא הבחירה האדריכלית העיקרית עם חלופות אפשריות, מאפשרויות קוד פתוח בניהול עצמי ועד להצעות נתמכות מסחרית: (א) נתב Envoy Agent ב-Envoy Gateway (קוד פתוח), (ב) kgateway ו-agentgateway (הטמעות של Gateway API בקוד פתוח שמטפלות גם בתעבורה של ספקי LLM, בכלי MCP ובתקשורת בין סוכנים במטוס נתונים אחד, עם אפשרות לתמיכה מסחרית מ-solo.io), (ג) Solo Enterprise ל-agentgateway כאפשרות פרימיום נתמכת מסחרית. | ההטמעה לדוגמה משתמשת ב-Envoy Agent Router בקוד פתוח ב-Envoy Gateway. החלופות האלה עדיין תקפות מאחורי אותם משאבי Gateway API. מומלץ להשתמש בהפצה מסחרית נתמכת בסביבות ייצור שדורשות תמיכה ייעודית מהספק. | יתרונות של קוד פתוח: קל משקל ועומד בתקנים, ניתוב ברמה 7 עם ביצועים גבוהים, ללא דמי רישוי, אידיאלי להערכת הפתרון לפני שמתחייבים למינוי בתשלום. האפשרות שמאומתת בסדרת המדריכים הזו היא Envoy Agent Router. חסרונות של קוד פתוח: התמיכה ניתנת על ידי צוות הפתרונות והקהילה, והיא לא תמיד מספקת לסביבות ייצור מרכזיות. היתרונות של פרימיום: הסכמי תמיכת Enterprise למחזור החיים של השער, ולעתים קרובות, יכולות אג'נטיות מתקדמות. חסרונות של Premium: נדרש הסכם רישוי או הסכם תמיכה בתשלום, ונוצר קשר נוסף עם ספק. |
החלטה 2: Kubernetes Gateway API עם Inference Extension לעומת Ingress או API של שער קנייני
| הקשר | החלטה חשובה | הסבר |
|---|---|---|
| אפשר לחשוף נקודות קצה של הסקה באמצעות Ingress API מהדור הקודם, פורמט הגדרה ספציפי לשער או Kubernetes Gateway API. בנוסף, כדי להשתמש באיזון עומסים שמודע למודל, צריך דרך לתאר את מאגרי שרתי המודלים והעדיפויות שלהם. | הפתרון מתבסס על Kubernetes Gateway API (GatewayClass, Gateway, routes) שהוטמע על ידי Envoy Gateway, ועל Gateway API Inference Extension (InferencePool, InferenceObjective, Endpoint Picker) לניתוב מודע למודל. |
Gateway API הוא התקן של Kubernetes שמחליף את Ingress, הוא מבוסס-תפקידים (צוותי פלטפורמה לעומת צוותי אפליקציות) ונייד בין הטמעות. התוסף Inference הוא התקן הקהילתי לניתוב מודלים (עומק התור, מטמון KV, עדיפויות) והוא נתמך על ידי Envoy Agent Router באופן מיידי. הפצות שער חלופיות מיישמות את אותם ממשקי API, מה שמאפשר לבטל את ההחלטה 1. |
החלטה 3: ניתוב מבוסס-גוף בשדה model של בקשות שתואמות ל-OpenAI כנקודת הקצה המאוחדת
| הקשר | החלטה חשובה | הסבר |
|---|---|---|
אפליקציות יכולות לפנות למודלים דרך נקודת קצה אחת לכל מודל (מבוססת-מארח או מבוססת-נתיב), דרך כותרת מותאמת אישית שהוגדרה על ידי הלקוח או דרך השדה model שכל בקשה שתואמת ל-OpenAI כבר מכילה. |
השער חושף נקודת קצה אחת שתואמת ל-OpenAI ומסלולים בשדה model: המעבד החיצוני מחלץ אותה לכותרת x-ai-eg-model והכללים AIGatewayRoute תואמים לכותרת הזו. |
לקוחות וערכות SDK קיימים שתואמים ל-OpenAI פועלים ללא שינוי, ומעבר בין מודלים מתבצע על ידי שינוי מחרוזת אחת. נקודות קצה, פרטי כניסה ומיקום המודל יכולים להשתנות בלי שיהיה צורך לבצע שינויים באפליקציות. אותם כללים יכולים למפות שם של מודל לכמה קצוות עורפיים לצורך פיצול תנועה, מעבר לגיבוי או ביטול של שם המודל. |
החלטה 4: העברה של ארטיפקטים עם פערים (air-gapped) אל Harbor לעומת שליפות לפי דרישה
| הקשר | החלטה חשובה | הסבר |
|---|---|---|
| ההתקנה של upstream שולפת קובצי אימג' של קונטיינרים ממאגרי מידע ציבוריים ומתרשימי Helm כארטיפקטים של OCI על פי דרישה, וזה בלתי אפשרי בסביבה מבודדת. | כל תמונות הקונטיינר (Envoy proxy, Envoy Gateway, Envoy Agent Router controller ומעבד חיצוני, שירות הגבלת קצב, Endpoint Picker, Redis) ותרשימי ה-Helm של Envoy Gateway ו-Envoy Agent Router מוזנים לפרויקט Harbor עם seed_registry.sh (crane), התרשימים מעובדים אופליין עם helm template מ-Harbor, והמשאב EnvoyProxy וערכי התרשים מצמידים את מאגר Harbor ואת סוד המשיכה. |
שלב אחד של זריעת נתונים שניתן לחזור עליו ולבדוק אותו לכל גרסה. לא נדרשת קישוריות חיצונית לאשכול. הצמדת גרסה הופכת את השדרוגים לברורים ולניתנים לביטול. |
החלטה 5: הגבלת קצב אופציונלית מבוססת-טוקן עם Redis לעומת הגבלות מבוססות-בקשה בלבד
| הקשר | החלטה חשובה | הסבר |
|---|---|---|
| הקיבולת של ה-GPU נצרכת לכל טוקן, ולא לכל בקשה. הגבלה של מספר הבקשות לא יכולה להגן על מודל משותף מפני כמה הנחיות גדולות מאוד או יצירות ארוכות. הגבלת קצב גלובלית ב-Envoy Gateway צריכה מאגר משותף של מוני נתונים. | הגבלת קצב יצירת הבקשות על בסיס טוקנים היא תכונה אופציונלית בארכיטקטורה: המעבד החיצוני מתעד את הקלט, הפלט והטוקנים הכוללים לכל בקשה (llmRequestCosts), BackendTrafficPolicy אוכף את התקציב ומופע Redis (גרסה Redis 8.10, שנפרס באשכול או במופע קיים) מאחסן את המונים. לא צריך Redis לפריסות ללא הגבלת קצב. |
השימוש נמדד ביחידה שמשקפת את העלות, התקציבים נאכפים באופן עקבי בכל העותקים של ה-proxy, והלקוחות משלמים על התלות רק אם הם צריכים מכסות. |
החלטה 6: טופולוגיה: בקרה על שער ומטוס נתונים במרחב שמות ייעודי של אשכול רגיל, מודלים במרחבי שמות של אפליקציות
| הקשר | החלטה חשובה | הסבר |
|---|---|---|
| השער יכול לפעול באשכול ייעודי, בכל מרחב שמות של אפליקציה או פעם אחת לכל אשכול רגיל לצד המודלים שהוא מציג. מודלים פתוחים עם משקלים ב-GDC עם air gap נפרסים באשכולות רגילים (סט מדריכים נלווים). | מישור הבקרה של Envoy Gateway ושל Envoy Agent Router ומישור הנתונים של Envoy proxy פועלים במרחב שמות ייעודי של האשכול הרגיל שמארח את המודלים; AIGatewayRoute, AIServiceBackend, InferencePool ופריסות המודלים נמצאות במרחבי השמות של האפליקציות, וההפניות אליהן מתבצעות בין מרחבי השמות. |
הבקשות נשארות בתוך רשת האשכול בין ה-proxy לבין המודלים Pods (החביון הכי נמוך, ללא איזון עומסים נוסף), לאדמין של הפלטפורמה יש בעלות על מרחב השמות של השער, לצוותי האפליקציות יש בעלות על המסלולים והמודלים שלהם, והכלי לבחירת נקודות קצה יכול לסרוק את שרתי המודלים ישירות. שער לקוח לכל פרויקט שמעביר נתונים לשער שרת מרכזי הוא הרחבה של הטופולוגיה הזו לשימוש בכמה פרויקטים. |
הנחות ומגבלות
- סביבת GDC עם air gap בגרסה 1.16.2-hf1 ואילך זמינה עם אשכול רגיל שפועל ב-Kubernetes בגרסה v1.32.13-gke.400 ואילך.
- יש מספיק משאבי חומרה (במיוחד מעבדים גרפיים) עבור שרתי הקצה של המודל. רכיבי השער עצמם פועלים בצמתי CPU. מודלים אמיתיים צריכים GPU. מודלים קטנים ב-Ollama יכולים לפעול ב-CPU רק לצורך הערכה פונקציונלית.
- מוגדר מופע של Harbor שאפשר לגשת אליו, ויש תחנת עבודה עם גישה לאינטרנט וקישוריות לסביבת GDC (Harbor ו-Kubernetes API) שזמינה להוספת תמונות ותרשימים.
- למשתמשים יש את ההרשאות הנדרשות: התפקידים בפרויקט Harbor Instance Viewer ו-Standard Cluster Admin, בנוסף ל-
StandardClusterRoleBindingלתפקידcluster-adminבאשכול הרגיל להתקנה בהיקף האשכול (CRD, GatewayClass, מרחבי שמות). אפשר לעיין בהטמעה לדוגמה. - הקצה העורפי של פרסום המודל מספק API שתואם ל-OpenAI. הקצה העורפי שמחובר כ-
InferencePoolמספק גם מדדים שתואמים ל-vLLM, ש-Endpoint Picker מסתמך עליהם. - מגבלה: התמיכה ברכיבים בקוד פתוח (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension) היא תמיכה מסוג best effort של צוות הפתרונות. תמיכה ייעודית של ספק מחייבת הפצה עם תמיכה מסחרית (החלטה 1).
- מגבלה:
InferenceObjectiveהוא API בגרסת אלפא (inference.networking.x-k8s.io/v1alpha2) והוא עשוי להשתנות בין גרסאות של התוסף Inference. - מגבלה: נדרשים
LoadBalancerVIP עבורGatewayו-ProjectNetworkPolicyעבור צרכנים מחוץ לפרויקט. בתוך הפרויקט, לקוחות בתוך האשכול אוkubectl port-forwardיכולים להגיע ישירות לשערService. - מגבלה: Gemini ב-GDC, כוונון עדין של מודלים, מודלים של AI גנרטיבי שאינם LLM ופרסום מודלים מרובי צמתים לא נכללים בהיקף גרסה זו של הפתרון.
מסלול המשתמש באפליקציה
בהמשך מופיע מסלול המשתמש מקיף של שער ה-AI ב-GDC עם air gap: קודם נתיב הבקשה שמפתח אפליקציות מסתמך עליו, ואז נתיב ההגדרה שאדמין הפלטפורמה פועל לפיו.
1. נתיב הבקשה של המפתח
אפליקציה או סוכן צריכים רק את נקודת הקצה של השער, את פרטי הכניסה של הלקוח אם השער אוכף אותם ואת שם המודל.
- שליחת הבקשה: האפליקציה קוראת ל-
POST /v1/chat/completionsבנקודת הקצה של השער עם גוף JSON שתואם ל-OpenAI, שבו מצוין שם המודל (לדוגמה,"model": "gemma"), בדיוק כמו שהיא קוראת לכל שירות שתואם ל-OpenAI. - הבקשה מגיעה לשער: הבקשה מגיעה ל-
LoadBalancerVIP שלGateway; פרוקסי Envoy מסיים את ה-TLS ומתאים את המאזין ואת המסלול. - עיבוד הגוף: ה-proxy מעביר את הבקשה למעבד החיצוני של נתב Envoy Agent, שמנתח את הגוף, מחלץ את שם המודל לכותרת
x-ai-eg-modelומתרגם את מטען הייעודי (payload) לסכימה של ה-backend אם היא שונה. - Select the backend: הכלל
AIGatewayRouteשתואם לשם המודל בוחרAIServiceBackend(לדוגמה, OllamaService) אוInferencePool(לדוגמה, קבוצת העתקים של vLLM). במקרה שלInferencePool, הכלי לבחירת נקודת קצה בוחר את ההעתק עם התור הקצר ביותר וההתאמה הכי טובה למטמון KV. - העברה ותגובה: שרת ה-Proxy מוסיף פרטי כניסה במעלה הזרם כשמתבצעת בקשה של
BackendSecurityPolicy, מעביר את הבקשה אלPodשנבחר, מעביר את התשובה בחזרה ומאפשר למעבד החיצוני לתעד את השימוש באסימון, שמשמש להזנת המדדים, וכשהוא מוגדר, להגבלת הקצב שמבוססת על אסימונים. - החלפת מודלים: כדי להשתמש במודל אחר, המפתח משנה את
modelהמחרוזת. לא צריך נקודת קצה, פרטי כניסה או ספריית לקוח חדשים.
2. נתיב ההגדרה של אדמין הפלטפורמה
- הוספת ארטיפקטים ל-Harbor: יוצרים את חשבונות הרובוט של Harbor, ואז מעתיקים את תמונות הקונטיינר ואת תרשימי ה-Helm של Envoy Gateway ו-Envoy Agent Router ל-Harbor באמצעות
seed_registry.shמתחנת עבודה עם גישה לאינטרנט. - Install Envoy Gateway: Render the CRD and controller charts from Harbor
with
helm templateand apply them in the gateway namespace; create theEnvoyProxyresource that pins the proxy image and pull secret and verify the controller with a basicGatewayClass,GatewayandHTTPRoute. - התקנת Envoy Agent Router: מתקינים את Envoy Agent Router CRDs ואת Gateway API Inference Extension CRDs, פורסים את בקר Envoy Agent Router ומגדירים מחדש את Envoy Gateway כדי לקרוא לשרת התוסף שלו (יציאה 1063) וכדי לקבל קצה עורפי של
InferencePool. אפשר גם לפרוס את Redis ולהפעיל את שירות הגבלת הקצב הגלובלי. - חשיפת השער: יוצרים את
GatewayClassואתGatewayעם מאזינים ל-HTTP ול-HTTPS (אישור TLSSecret), מחכים ל-LoadBalancerVIP ומחילים אתProjectNetworkPolicyעל צרכנים מחוץ לפרויקט. - צירוף מודלים: פורסים את העורפים של שרת המודלים באמצעות ערכת המדריכים הנלווים, ואז יוצרים משאבי
AIServiceBackendעבורServiceשתואמים ל-OpenAI ו-InferencePoolמשאבי Endpoint Picker עבור קבוצות רפליקות שתואמות ל-vLLM, יחד עם אובייקטים של מרחב השמותNetworkPolicy. - פרסום המסלול: יוצרים את
AIGatewayRouteעם כלל אחד לכל שם של מודל (ניתוב מבוסס-גוף) ובמקומות שנדרש, אובייקטים שלBackendSecurityPolicyושלBackendTrafficPolicyעבור פרטי כניסה במעלה הזרם ותקציבי אסימונים. - אימות והפעלה: מתקשרים אל
/v1/modelsו-/v1/chat/completionsדרך כתובת ה-VIP (אוkubectl port-forwardגיבוי), בודקים את מדדי ה-proxy, המעבד החיצוני והכלי לבחירת נקודות קצה, ומעבירים את נקודת הקצה ואת שמות המודלים לצוותי האפליקציות. אפשר להרחיב את העותקים של ה-proxy ואת פריסות המודלים באופן עצמאי, ולשדרג את Envoy Gateway, את Envoy Agent Router ואת Inference Extension ביחד.
השלבים המפורטים מופיעים בהטמעה לדוגמה של Envoy Agent Router ובמדריך למשתמש בנושא ניתוב מבוסס-גוף עם Envoy Agent Router.
חומרים נוספים
- יישום לדוגמה של Envoy Agent Router
- ניתוב מבוסס-גוף עם מדריך למשתמש ב-Envoy Agent Router
- ארכיטקטורת הפניה של מודלים גדולים של שפה (LLM) במשקל פתוח
- מאמרים בנושא Envoy Agent Router
- Envoy Gateway
- Kubernetes Gateway API
- Gateway API Inference Extension
- מסמכי תיעוד של Google Distributed Cloud במודל Air-gapped