


ארגונים שפועלים בסביבות מבודדות (air-gapped) ניצבים בפני אתגר משמעותי: הם צריכים את היכולות המתקדמות של מודלים גדולים של שפה (LLM), אבל אסור להם להתחבר לממשקי API חיצוניים מבוססי-ענן בגלל פרוטוקולי אבטחה מחמירים. כדי לגשר על הפער הזה, הלקוחות האלה צריכים מערכת אקולוגית חזקה ועצמאית שיכולה לארח ולנהל מודלים פתוחים ישירות בתשתית המבודדת שלהם ב-Google Distributed Cloud (GDC). הפריסה המקומית הזו חיונית לשמירה על ריבונות הנתונים המוחלטת, כדי להבטיח שמידע רגיש לא ייצא מהמתחם הפיזי. שילוב של סביבות ביצוע מאובטחות עם מנועי הסקה מקומיים מאפשר למשתמשים ליהנות מיכולות מתקדמות של AI, תוך שמירה על שליטה אדמיניסטרטיבית מלאה בנתונים, במשקלים של המודלים ובמצב האבטחה הפנימי שלהם.
Gemini ב-GDC מספק יכולות מתקדמות ומנוהלות, אבל לקוחות רבים בוחרים לפרוס מודלים עם משקלים פתוחים כמו Gemma 4 או Llama 4 כדי לקבל גרנולריות ושליטה גבוהות יותר. פריסה של מודלים פתוחים ב-GDC בסביבות מבודדות מציעה יתרונות משמעותיים בעלויות בהשוואה לשירותים קנייניים מנוהלים. הבעלות על משקלי המודל מאפשרת לארגונים להימנע מעמלות חוזרות על כל טוקן ב-API, שיכולות להיות גבוהות מדי בעומסי עבודה אוטומטיים בהיקף גדול. בנוסף, מודלים בקוד פתוח מאפשרים קוונטיזציה (למשל, 4 ביט או 8 ביט), וכך מאפשרים להריץ חשיבה רציונלית בביצועים גבוהים על חומרה קטנה וזולה יותר בקצה. האופטימיזציה האנכית הזו, בשילוב עם היכולת לשתף תשתית בין כמה אפליקציות פנימיות בלי עלויות רישוי נוספות, מובילה לעלות כוללת של בעלות (TCO) נמוכה משמעותית עבור פעולות הסקה מתמשכות בקנה מידה גדול.
הצעה לפתרון
במסמך הזה מפורטת ארכיטקטורת העזר לפריסה ולניהול של מודלים גדולים של שפה (LLM) עם משקלים פתוחים בסביבות מבודדות של Google Distributed Cloud (GDC). לקוחות רבים, במיוחד בתחומים עם רגולציה מחמירה, לא יכולים להשתמש בממשקי API של מודלים גדולים של שפה (LLM) מבוססי-ענן בגלל דרישות מחמירות בנוגע לריבונות נתונים ולאבטחה. הארכיטקטורה הזו נותנת מענה לצורך בהרצת מודלים גדולים של שפה (LLM) באופן מקומי בתוך מופע GDC מאובטח משלהם.
מה כלול: הארכיטקטורה הזו כוללת פריסה של מודלים של LLM בקוד פתוח (כמו Gemma, Llama, DeepSeek) באמצעות קצה עורפי (backend) של vLLM או Ollama. הוא כולל שימוש ב-Kubernetes לארגון, ב-Harbor לאחסון ארטיפקטים, בנפחי אחסון מתמיד למשקלי מודלים ובכללי מדיניות של רשת הפרויקט לאבטחת הרשת.
מה לא כלול: הארכיטקטורה הזו לא כוללת שירותים מנוהלים של AI Gateway, מודלים קנייניים כמו Gemini של Google, תהליכי כוונון עדין של מודלים או מודלים של AI גנרטיבי למודולציות אחרות כמו יצירת תמונות. התכונות האלה יוסברו במדריכים נפרדים.
למי מיועד המסמך: קהל היעד העיקרי של המסמך הזה כולל מנהלי פלטפורמות שאחראים על פריסה וניהול של שירותים ב-GDC, וארכיטקטים טכניים שמתכננים פתרונות AI בסביבה מבודדת. משתמשי קצה ומפתחים שיבצעו אינטראקציות עם המודלים שנפרסו הם קהלים משניים שיכולים להפיק תועלת מהבנת המבנה הבסיסי.
תרשים עזר לארכיטקטורה
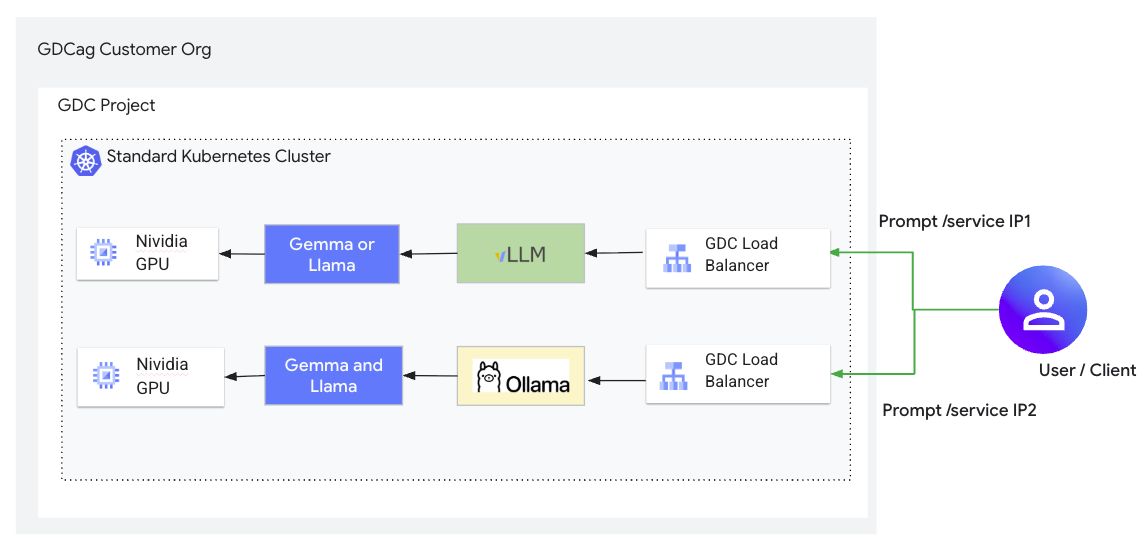
רכיבי הפתרון
הפתרון מבוסס על הרכיבים הבאים:
| רכיב הפתרון | תחומי אחריות | זרימת נתונים | ממשקים |
|---|---|---|---|
| אזור לקוחות עם air gap ב-GDC | מארח את אשכולות Kubernetes, את הרשת ואת תשתית האחסון | פלטפורמה בסיסית | ממשקים לניהול התשתית של ה-IO. Kubernetes API לאדמינים ולמשתמשים בפלטפורמה |
| מאזן עומסים | חשיפת קבוצות ה-Pod של שירות ה-LLM (vLLM, Ollama) לתעבורת נתונים מחוץ לאשכול Kubernetes, ומתן כתובת IP יציבה. | בקשות של לקוחות חיצוניים נשלחות לכתובת ה-IP החיצונית של איזון העומסים. מאזן העומסים מחלק את הבקשות בין פודים תקינים של קצה עורפי (vLLM או Ollama) על סמך הסלקטור של השירות | Kubernetes Service API. הקצאת משאבים אוטומטית של מאזן עומסי רשת בסביבת GDC. |
| vLLM | הצגת מסקנות של מודלים גדולים של שפה (LLM) עם תפוקה גבוהה. אופטימיזציה לזמן אחזור נמוך באמצעות טכניקות כמו PagedAttention. בדרך כלל משרת מודל אחד לכל מופע. | מקבל בקשות HTTP להסקת מסקנות מלקוחות. טוען את משקלי המודל מ-PVC שצורף. מבצע חישובים במעבדי GPU שמצורפים. מחזירה תשובות HTTP עם טקסט שנוצר. | API תואם ל-OpenAI בארכיטקטורת REST להסקת מסקנות. מקבל בקשות JSON. |
| Ollama | הפעלת מסקנות של מודלים גדולים של שפה (LLM), שנועדה להיות קלה לשימוש ולניהול של כמה מודלים במופע יחיד (אבל רק מודל אחד פעיל בכל פעם) | מקבל בקשות HTTP להסקת מסקנות. טוען מודלים (לרוב כלולים בתוך קובץ אימג' של קונטיינר או נמשכים בשימוש הראשון אם לא עם air gap). מבצע חישובים ב-GPU. מחזירה תגובות HTTP. המודלים מוסרים מהזיכרון אחרי תקופה של חוסר פעילות. | ממשק ה-API של Ollama בארכיטקטורת REST מקבל בקשות JSON. יש גם ממשק CLI. |
| Nvidia GPUs / MIG | שיפור המהירות באמצעות חומרה להסקת מסקנות של LLM. | הקצה העורפי של ה-LLM (vLLM, Ollama) מעביר את חישובי המודל האינטנסיביים (כמו כפל מטריצות) למעבדי ה-GPU כדי להאיץ את הסקת המסקנות. MIG מאפשרת לחלק GPU יחיד כך שישמש כמה מופעים קטנים יותר של מודלים. | המשאבים האלה נחשפים כסוג משאב ב-Kubernetes (למשל, nvidia.com/gpu). הפודים מבקשים את המשאבים האלה |
| Harbor | אחסון וניהול מאובטחים של קובצי אימג' של קונטיינרים ל-vLLM, ל-Ollama ולכל פוד עזר (כמו busybox) | קובצי אימג' של קונטיינרים נדחפים מסביבת build (למשל, תחנת עבודה עם גישה לאינטרנט) אל Harbor. צמתי Kubernetes מושכים את התמונות האלה מ-Harbor כדי להריץ קונטיינרים. | Docker Registry API. צמתים של Kubernetes מתקשרים עם Harbor כדי לשלוף תמונות במהלך יצירת הפוד. המשתמשים יוצרים אינטראקציה עם Docker CLI או עם Harbor UI כדי להעלות תמונות. |
| בקשות לדיסק אחסון מתמיד (Persistent Volume Claims) | מספק אחסון מתמיד למשקלים של מודלים של LLM, ללא תלות במחזורי החיים של ה-Pod. | קובצי המודל מועתקים לנפח אחסון קבוע (למשל, באמצעות pod של עזר ו-kubectl cp). שרת vLLM קורא את משקלי המודל מהנפח הזה שטוען בהפעלה. בדרך כלל, Ollama מאגד מודלים בתוך התמונה, ולכן PVC פחות נפוץ לאחסון מודלים של Ollama בהגדרה הזו. |
Kubernetes storage API. מוגדרים ב-YAML ומצורפים לפודים כנפחים. |
| Project Network Policy | הוא אוכף בידוד רשת ושולט בזרימת התנועה ברמת הפרויקט או מרחב השמות. התכונה הזו מוודאת שרק תנועה מורשית יכולה להגיע לשירותי ה-LLM. | תנועת הרשת אל הפודים ובחזרה מהם בתוך מרחב השמות נבדקת. כללי המדיניות קובעים אם חיבורים ליציאות של שירות ה-LLM (למשל, 8000 ל-vLLM, 11434 ל-Ollama) מותרים, בדרך כלל על סמך טווחי כתובות IP של המקור או תוויות אחרות. | Kubernetes networking.gdc.goog/v1 API. מוגדר ב-YAML. |
תכונות ויכולות
ארכיטקטורת ההפניה הזו מספקת את היכולות הבסיסיות הבאות:
- פרסום מודלים גדולים של שפה (LLM) עם משקלים פתוחים: מאפשר אירוח והיקש של מודלים שונים עם משקלים פתוחים (לדוגמה, Gemma, Llama, DeepSeek).
- רכיבים: LLM Serving Backends (vLLM, Ollama), Kubernetes Deployments/Pods.
- תחומי אחריות: טעינת משקלי המודל, ניהול תהליך ההסקה, הפעלת מודלים במאיצי חומרה וחשיפת נקודות קצה.
- ממשקי API: ממשקי API בארכיטקטורת REST (תואמים ל-OpenAI עבור vLLM, API מובנה עבור Ollama) לבקשות הסקה, בדרך כלל באמצעות JSON.
- הבאת מודל משלך (BYOM): משתמשים יכולים לייבא ולפרוס מודלים של LLM עם משקלים פתוחים שהם בוחרים בסביבה עם פער אוויר.
- רכיבים: Harbor, Persistent Volume Claims, Kubernetes.
- אחריות: אחסון מאובטח של קובצי אימג' של קונטיינרים ומשקלים של מודלים. מנגנון להעברת מודלים לסביבה ולהנגשתם למנועי ההצגה.
- ממשקים: Docker Registry API (ל-Harbor), Kubernetes API (ל-PVC ולחיבורי נפח).
- הסקת מסקנות בהאצת חומרה: שימוש במעבדים גרפיים (GPU) של NVIDIA באשכול GDC כדי להריץ הסקת מסקנות של מודלים גדולים של שפה (LLM) ביעילות.
- רכיבים: יחידות GPU של NVIDIA, Kubernetes, Device Plugins.
- תחומי אחריות: תזמון של פודים בצמתים עם משאבי GPU. חשיפה של חומרת GPU לקונטיינרים של העורף של מודל שפה גדול (LLM). תמיכה ב-Multi-Instance GPU (MIG) לחלוקה למחיצות.
- ממשקים: Kubernetes API (לשליחת בקשות למשאבי GPU כמו
nvidia.com/gpu).
- גישה מבוקרת לרשת: הגישה לנקודות הקצה של מסקנות מודל שפה גדול (LLM) מבוקרת ומבודדת בסביבת GDC.
- רכיבים: שירותי Kubernetes (LoadBalancer), ProjectNetworkPolicy.
- אחריות: חשיפת שירותי הסקה באמצעות כתובת IP קבועה. הגדרת כללי רשת ואכיפה שלהם כדי לאפשר או לדחות תעבורת נתונים לשרתי הקצה העורפי של מודלי ה-LLM על סמך המקור, היעד והיציאות.
- ממשקים: Kubernetes API (לשירותים ול-ProjectNetworkPolicy).
- הגשה ניתנת להרחבה: מאפשרת להתאים את הקיבולת בהתאם לביקוש.
- רכיבים: פריסות Kubernetes.
- תחומי אחריות: הפעלת הרחבה אופקית על ידי הגדלת מספר הרפליקות של פודים בעורף של LLM. הגדלת הקיבולת האנכית על ידי התאמת בקשות/הגבלות של משאבים.
- ממשקים: Kubernetes API (לניהול של עותקים משוכפלים של פריסות ומשאבים).
עקרונות אדריכליים
- קודם כול אבטחה: כל הרכיבים והנתונים נמצאים בתוך הגבול של GDC עם air gap, כדי להבטיח אבטחת נתונים ושליטה מקסימלית. הגישה לרשת מוגבלת באמצעות ProjectNetworkPolicies.
- ריבונות נתונים: הלקוחות שומרים על שליטה מלאה במודלים ובנתונים שלהם, ולא נדרש קישור חיצוני כדי להפעיל אותם.
- פתוח וגמיש: הארכיטקטורה מתבססת על קצה עורפי (backend) של שרתים בקוד פתוח (vLLM, Ollama) ותומכת במגוון מודלים גדולים של שפה (LLM) עם משקלים פתוחים, כך שהלקוחות יכולים לבחור את מנוע ההיסק המתאים להם ולא להיות תלויים בספק מסוים.
- הפרדה בין רכיבים: פונקציות מרכזיות כמו אחסון מודלים (PVC), ניהול תמונות (Harbor) והסקת מסקנות (vLLM/Ollama pods) הן רכיבים נפרדים, שמאפשרים ניהול ועדכונים עצמאיים.
- מדרגיות וביצועים: נועד להרחבה אופקית על ידי הגדלת מספר העותקים של ה-pod, ולהרחבה אנכית על ידי התאמת משאבי המעבד או המעבד הגרפי כדי לעמוד בדרישות הביצועים. vLLM נבחר לתרחישים של תפוקה גבוהה וזמן אחזור נמוך.
- אופטימיזציה של משאבים: תמיכה ב-NVIDIA Multi-Instance GPU (MIG) כדי לאפשר למודלים קטנים יותר לשתף משאבי GPU ביעילות, ולמקסם את השימוש בחומרה.
- ממשקי סטנדרט: מבוססים על תקני Kubernetes לתזמור, לפריסה ולחשיפה של שירותים. נקודות קצה של הסקת מסקנות מספקות ממשקי API ל-REST, ו-vLLM מציע תאימות ל-OpenAI.
- חוסן (resilience): המערכת משתמשת בבדיקות תקינות ובשכפול של Kubernetes כדי להבטיח את זמינות השירות.
לתשומת ליבכם
- יכולת הרחבה וביצועים:
- כדי לבצע הרחבה אופקית, מגדילים את מספר העותקים של הפריסה ב-Kubernetes גם עבור vLLM וגם עבור Ollama.
- הגדלת הקיבולת האנכית כוללת הקצאה של יותר מעבד (CPU) או זיכרון, ופרוסות גדולות יותר של GPU, עד לשימוש במעבדי GPU מלאים.
- vLLM מציג מודל אחד לכל מופע, ולכן נדרשות פריסות חדשות למודלים נוספים. Ollama יכול לנהל כמה מודלים, אבל הוא מריץ רק אחד בכל פעם.
- הגודל של ה-PVC משפיע באופן משמעותי על זמני הטעינה של המודל. מומלץ להשתמש ב-500GiB ומעלה כדי להשיג IOPS גבוה.
- ניהול משאבים:
- תכנון קפדני של משאבי ה-GPU הוא חיוני. אפשר להשתמש ב-NVIDIA MIG כדי לחלק את ה-GPU למודלים קטנים יותר, וכך לשפר את הניצול.
- צריך להקצות מספיק מעבד (CPU) וזיכרון כדי לטפל בהסקה ובתקורה של ניהול המודל.
- צריך להקצות נפח אחסון מספיק ל-PVC כדי להתאים לגדלים של המודלים ולהבטיח את הביצועים.
- זמינות ומהימנות:
- פריסות Kubernetes מספקות יכולות של תיקון עצמי ועדכון בהדרגה (rolling).
- שירותי LoadBalancer מחלקים את התנועה בין פודים תקינים, ומסתירים כשלים בפודים ספציפיים.
- אחסון משקלי המודל ב-PVC מבטיח את המשכיות שלהם גם אחרי הפעלה מחדש של הפוד.
- מורכבות תפעולית:
- ניהול תמונות של קונטיינרים עבור גרסאות שונות של קצה עורפי ב-Harbor.
- הליכים להעברה מאובטחת של משקלי המודל לסביבה מבודדת.
- יצירה וניהול של מניפסטים של Kubernetes (פריסות, שירותים, PVC, מדיניות רשת) לכל מודל ולכל קצה עורפי.
- מעקב אחרי ניצול ה-GPU, זמן האחזור של ההסקה ושיעורי השגיאות.
- אבטחה ותאימות:
- הפתרון כולו פועל בתוך היקף האבטחה של GDC שמופרד פיזית מהרשת.
- חובה להשתמש ב-ProjectNetworkPolicies כדי לאכוף בידוד רשת קפדני ולשלוט בגישה לנקודות הקצה של מודלי ה-LLM.
- חשבונות רובוט של Harbor וסודות משיכת תמונות של Kubernetes מבטיחים גישה מאובטחת לקובצי אימג' של קונטיינרים.
- אפשר להגן על נתונים במעבר באמצעות מדיניות רשת של Kubernetes והצפנה ברמת הפלטפורמה. הנתונים באחסון ב-PVC מבוססים על הצפנת האחסון ב-GDC.
החלטות עיצוביות
ההחלטות העיקריות הבאות התקבלו לגבי ארכיטקטורת ההפניה הזו:
החלטה 1: להציע גם vLLM וגם Ollama לעומת הצעה של מודל הסקה אחד בלבד
| הקשר | החלטה חשובה | הסבר |
|---|---|---|
| אפשר להציע רק אחת משתי האפשרויות לשכבות של הסקת מסקנות: VLLM ו-Ollama, או להציע את שתיהן. | החלטנו להציע את שניהם כי למשתמשים שונים ולתרחישי שימוש שונים יש דרישות שונות לגבי ביצועים, תאימות ל-API וניהול קל של המודל. | vLLM מספק שירות עם תפוקה גבוהה, זמן אחזור נמוך ותאימות ל-OpenAI API, ומתאים לאפליקציות בסביבת ייצור. Ollama מציעה הגדרה פשוטה יותר, ניהול קל יותר של כמה מודלים וממשק ידידותי למשתמש, ולכן היא מתאימה יותר לפיתוח ולניסויים. התמיכה בשני הפורמטים האלה מאפשרת גמישות. |
החלטה 2: שימוש באחסון קבוע לעומת אחסון אובייקטים לאחסון מודל vLLM
| הקשר | החלטה חשובה | הסבר |
|---|---|---|
| vLLM דורש שמשקלי המודל יהיו במערכת הקבצים בזמן הריצה. בסביבה מבודדת, אי אפשר להוריד מודלים לפי דרישה. | שימוש ב-Persistent Volume Claims (תביעות לשימוש בנפח אחסון קבוע) מבטיח את זמינות המודל ומשפר את זמן ההפעלה אחרי הטעינה הראשונית, אבל הוא דורש שלב ראשוני לאכלוס ה-PVC, שבדרך כלל כולל פוד עזר | תביעות של נפח אחסון מתמשך מספקות שכבת אחסון עמידה ומתמשכת לקובצי מודלים גדולים, שמופרדת ממחזור החיים של פוד vLLM. כך המודלים נטענים במהירות כשה-pod מתחיל לפעול. |
החלטה 3: חבילות של מודלים בתוך קובצי אימג' של Ollama Docker לעומת קובצי אימג' עצמאיים
| הקשר | החלטה חשובה | הסבר |
|---|---|---|
| Ollama יכול להוריד מודלים, אבל זה דורש גישה לאינטרנט, שלא זמינה בסביבות מבודדות | הוחלט לארוז את קובצי האימג'ים כדי לפשט את פעולת זמן הריצה בסביבה עם air gap, כי לא נדרשות קריאות חיצוניות. עם זאת, כדי לעדכן או להוסיף מודלים, צריך לבנות מחדש את קובץ האימג' של Docker ולדחוף אותו מחדש ל-Harbor. | יצירת קובץ אימג' של Docker עם המודלים שהורדו מראש מבטיחה ש-Ollama יופעל עם המודלים הנדרשים שזמינים במצב אופליין. |
החלטה 4: חשיפת vLLM ו-Ollama באמצעות שירותי LoadBalancer לעומת חשיפה ללא מאזן עומסים
| הקשר | החלטה חשובה | הסבר |
|---|---|---|
| אפליקציות בסביבת GDC צריכות להיות מסוגלות לגשת לממשקי LLM API. | הוחלט לחשוף שירותים באמצעות מאזן עומסים, כי זו הגישה הסטנדרטית של Kubernetes לחשיפת שירותים. עם זאת, הגישה הזו מסתמכת על הקצאת LoadBalancer של פלטפורמת GDC. | שירותי Kubernetes מסוג LoadBalancer מספקים שיטה סטנדרטית ואמינה לחשיפת קצה העורפי של מודלים גדולים של שפה (LLM), ומספקים כתובת IP יציבה ומפיצים את העומס. |
החלטה 5: אכיפה של ProjectNetworkPolicy חובה
| הקשר | החלטה חשובה | הסבר |
|---|---|---|
| אבטחה ובידוד הם קריטיים בפריסות של GDC עם air gap. | הוחלט לאכוף את ProjectNetworkPolicy כי הוא משפר באופן משמעותי את מצב האבטחה של שירותי ה-LLM שנפרסו, גם אם הוא מחייב הגדרה מדויקת של מדיניות הרשת | ProjectNetworkPolicies מספקות דרך מקורית ב-Kubernetes לאכוף בידוד רשת ברמת מרחב השמות, כדי להבטיח שרק תנועה מורשית תוכל להגיע לשירותי ה-LLM. |
הנחות ומגבלות
- סביבת GDC עם air gap בגרסה 1.15.1 ואילך זמינה
- יש מספיק משאבי חומרה (במיוחד מעבדים גרפיים) באשכול הרגיל.
- מוגדר מופע של Harbor שאפשר לגשת אליו.
- למשתמשים יש את ההרשאות הנדרשות (אדמין במרחב שמות, מפתח אשכול).
- המודלים תואמים למערכות העורפיות שנבחרו להצגת המודלים (vLLM/Ollama).
מסלול המשתמש באפליקציה (שלבים מקצה לקצה)
התרשים הבא מציג תהליך מקיף לפריסה של מודלי שפה גדולים (LLM) עם משקלים פתוחים בסביבות מבודדות של Google Distributed Cloud (GDC). התהליך מחולק להגדרה משותפת, לשני נתיבי פריסה (vLLM ו-Ollama) ולאימות סופי.
1. הגדרה נפוצה: ניהול תמונות
לפני שמפעילים מודל LLM, צריך להגדיר איך סביבת GDC תמשוך קובצי אימג' של קונטיינרים ממאגר Harbor הפרטי.
- יצירת חשבון רובוט ב-Harbor: יוצרים חשבון רובוט בממשק המשתמש של Harbor ומעניקים לו הרשאות pull.
- אימות Docker: משתמשים בפרטי הכניסה של חשבון הרובוט כדי להיכנס ל-Harbor ממכונה עם גישה לרשת.
- יצירת סוד של Kubernetes: יוצרים סוד של docker-registry במרחב השמות של פרויקט GDC באמצעות
kubectlכדי לאחסן את פרטי הכניסה האלה של Harbor לשימוש האשכול.
2. נתיב פריסה א': vLLM (תפוקה גבוהה)
הנתיב הזה מומלץ להצגת מודלים שמתמקדים בביצועים, כמו Gemma-3.
- השגת קובץ אימג' של Docker: משיכת קובץ אימג' של Docker של vLLM מהאינטרנט, תיוג שלו עבור רישום Harbor המקומי והעברה שלו בדחיפה ל-Harbor.
- הכנת אחסון המודל:
- יוצרים בקשה (PVC) לנפח אחסון מתמיד (PV) של 500GiB לאחסון משקלי המודל.
- מורידים משקלים מ-Hugging Face במחשב שמחובר לאינטרנט.
- משתמשים ב-
kubectl cpוב-'pod עזר' זמני כדי להעביר את המשקלים האלה אל ה-PVC בסביבת GDC.
- פריסת ה-Backend: מפעילים מניפסט של פריסת Kubernetes שמפנה לתמונת vLLM ומטמיע את ה-PVC של משקל המודל.
- חשיפת השירות: יוצרים שירות
LoadBalancerכדי לספק כתובת IP חיצונית ל-vLLM API. - רשת מאובטחת: צריך להחיל
ProjectNetworkPolicyכדי לאפשר תעבורת נתונים נכנסת ביציאת השירות (בדרך כלל 8000).
3. נתיב פריסה ב': Ollama (קלות שימוש)
הנתיב הזה מתמקד בהגדרה פשוטה שבה משקלי המודל מאוגדים או נטענים מראש בתמונה.
- יצירת קובץ אימג' בהתאמה אישית: יוצרים קובץ Docker שמתקין את Ollama ומשתמש בפקודה
RUNכדי לבצע מראש משיכה של מודלים ספציפיים (למשל,gemma3) לשכבות של קובץ האימג'. - דחיפה ל-Harbor: יוצרים את האימג' באופן מקומי ודוחפים אותו למאגר הפרטי שלכם ב-Harbor.
- פריסה וחשיפה: יוצרים פריסת Ollama ושירות
LoadBalancer. - רשת מאובטחת: צריך להחיל
ProjectNetworkPolicyעבור יציאת Ollama (11434).
4. אימות ובדיקה
אחרי הפריסה, השלבים האחרונים כוללים אימות של תפקוד השירותים.
- בדיקת הסטטוס: מוודאים שהסטטוס של הפודים הוא 'פועל' ושכתובות IP חיצוניות הוקצו לשירותים.
- בדיקת מסקנות:
- vLLM: שולחים בקשת
curlלכתובת ה-IP של vLLMLoadBalancerבאמצעות נקודת הקצה/v1/chat/completionsשתואמת ל-OpenAI. - Ollama: שולחים בקשת
curlלכתובת ה-IP של OllamaLoadBalancerלנקודת הקצה/v1/completions.
- vLLM: שולחים בקשת
5. פעולות והתאמה לעומס (scaling)
- שינוי קנה מידה אנכי: הגדלת פרוסות ה-GPU או מעבר להגדרות של כמה יחידות GPU עבור מודלים גדולים יותר.
- הרחבה אופקית: הגדלת מספר העותקים של הפריסה כדי לטפל ביותר בקשות משתמשים בו-זמנית.
- פתרון בעיות: אפשר לעקוב אחרי היומנים באמצעות
kubectl logsולבדוק אם יש בעיות נפוצות כמו כשלים בבדיקה העצמית של FIPS או הגבלות של מדיניות רשת ב-Kubernetes.