


Problembeschreibung
Bei Organisationen, die Large Language Models (LLMs) in Air-Gap-Umgebungen ausführen, sammeln sich schnell Modellendpunkte an: Jedes Open-Weight-Modell, das in Google Distributed Cloud (GDC) Air-Gap bereitgestellt wird (siehe die zugehörige Anleitung Open-Weight-Modelle in GDC Air-Gap), hat einen eigenen Kubernetes-Service, eine eigene Adresse, eigene Anmeldedaten und einen eigenen Betriebslebenszyklus.
Anwendungs- und Agent-Entwickler arbeiten in Architektursilos und codieren einen Endpunkt pro Modell fest. Bei jeder Modelliteration müssen sie Integrationen neu schreiben. Diese Fragmentierung führt zu technischen Schulden und verlangsamt die Bereitstellung von unternehmenskritischen, mehrstufigen agentischen Arbeitslasten.
Standardnetzwerkschichten sind auch „KI-blind“: Ein herkömmlicher Load-Balancer behandelt Inferenz-Traffic wie generisches HTTP und kann das Feld model einer Anfrage nicht lesen, latenzempfindliche Arbeitslasten nicht priorisieren, Tokens anstelle von Anfragen berücksichtigen oder eine Anfrage an die Modellserver-Replica weiterleiten, die bereits den relevanten KV-Cache enthält. In kostspieligen, air-gapped GPU-Clustern führt dies zu einer Unterauslastung der Hardware und einem schlechten Return on Investment. Gemini on GDC bietet zwar verwaltete Frontier-Modelle, aber Kunden, die sie mit selbst gehosteten Open-Weight-Modellen kombinieren, benötigen eine Inferenzebene, die Cloud-ähnliche Agilität bietet, ohne die Datenhoheit zu beeinträchtigen: Keine Anfrage, kein Prompt und kein Modellgewicht darf die GDC-Grenze verlassen.
Vorgeschlagene Lösung
In diesem Dokument wird die Referenzarchitektur für ein selbstverwaltetes KI-Gateway in GDC mit Air Gap beschrieben: eine sichere, zentralisierte Inferenzebene, die Anwendungen einen OpenAI-kompatiblen Endpunkt für alle Modelle bietet und jede Anfrage an das richtige Backend weiterleitet. Die Referenzimplementierung basiert auf der Kubernetes Gateway API: Envoy Gateway ist die Gateway API-Implementierung (Steuerungsebene und Envoy-Proxy-Datenebene) und Envoy Agent Router (früher Envoy AI Gateway) erweitert sie um KI-spezifische Anforderungsverarbeitung: Modellextraktion aus dem Anfragetext, Anfrage- und Antwortübersetzung, Upstream-Authentifizierung, Tokenabrechnung und optional tokenbasiertes Ratenlimit. Die Gateway API Inference Extension fügt die modellserverfähige Endpunktauswahl (InferencePool und Endpoint Picker) hinzu, damit die GPU-Kapazität effizient genutzt wird. Alle Artefakte werden in der Harbor-Registrierung der GDC-Organisation bereitgestellt und der gesamte Stack wird in einem Standardcluster ohne externe Verbindung ausgeführt.
Enthaltene Komponenten:Diese Architektur umfasst die Bereitstellung von Envoy Gateway und Envoy Agent Router in einem Standardcluster, die Gateway API-Ressourcen (GatewayClass, Gateway) und Envoy Agent Router-Ressourcen (AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, GatewayConfig), die einen einheitlichen OpenAI-kompatiblen Endpunkt, Body-basiertes Routing für das Feld model, die Gateway API Inference Extension (InferencePool, InferenceObjective, Endpoint Picker) für modellbasierten Lastenausgleich, optionales tokenbasiertes Ratenlimit mit Redis, TLS-Terminierung am Gateway, Netzwerkrichtlinien (NetworkPolicy / ProjectNetworkPolicy) und die Air-Gap-Artefaktverwaltung in Harbor bereitstellen. Die Backends für die Modellbereitstellung hinter dem Gateway (Ollama, vLLM) werden mit der Begleitanleitung „Open Weight Models on GDC“ (Offene Gewichtsmodelle auf GDC) in einer Air-Gap-Umgebung bereitgestellt.
Nicht enthalten:Diese Architektur umfasst kein verwaltetes KI-Gateway-Produkt, die Bereitstellung und Optimierung der Modelle selbst (Begleitleitfaden), die Optimierung von Modellen, nicht auf LLMs basierende GenAI-Modalitäten, den Agent-zu-Tool-Traffic (MCPRoute) oder kommerziell unterstützte Gateway-Distributionen. Gemini on GDC ist eine verwaltete Produktfunktion. Die Bereitstellung ist nicht Gegenstand dieses Leitfadens. In dieser Version des Leitfadens wird das Gateway mit selbst gehosteten Open-Weight-Modellen validiert.
Zielgruppe:Die primäre Zielgruppe für dieses Dokument umfasst Plattformadministratoren, die für die Bereitstellung und den Betrieb des Gateways in einem Standardcluster verantwortlich sind, sowie technische Architekten, die KI-Plattformen in der Air-Gap-Umgebung entwerfen. Anwendungsentwickler, die den einheitlichen Endpunkt verwenden, sind eine sekundäre Zielgruppe, die davon profitiert, wenn sie wissen, wie ihre Anfragen weitergeleitet werden.
Architektur
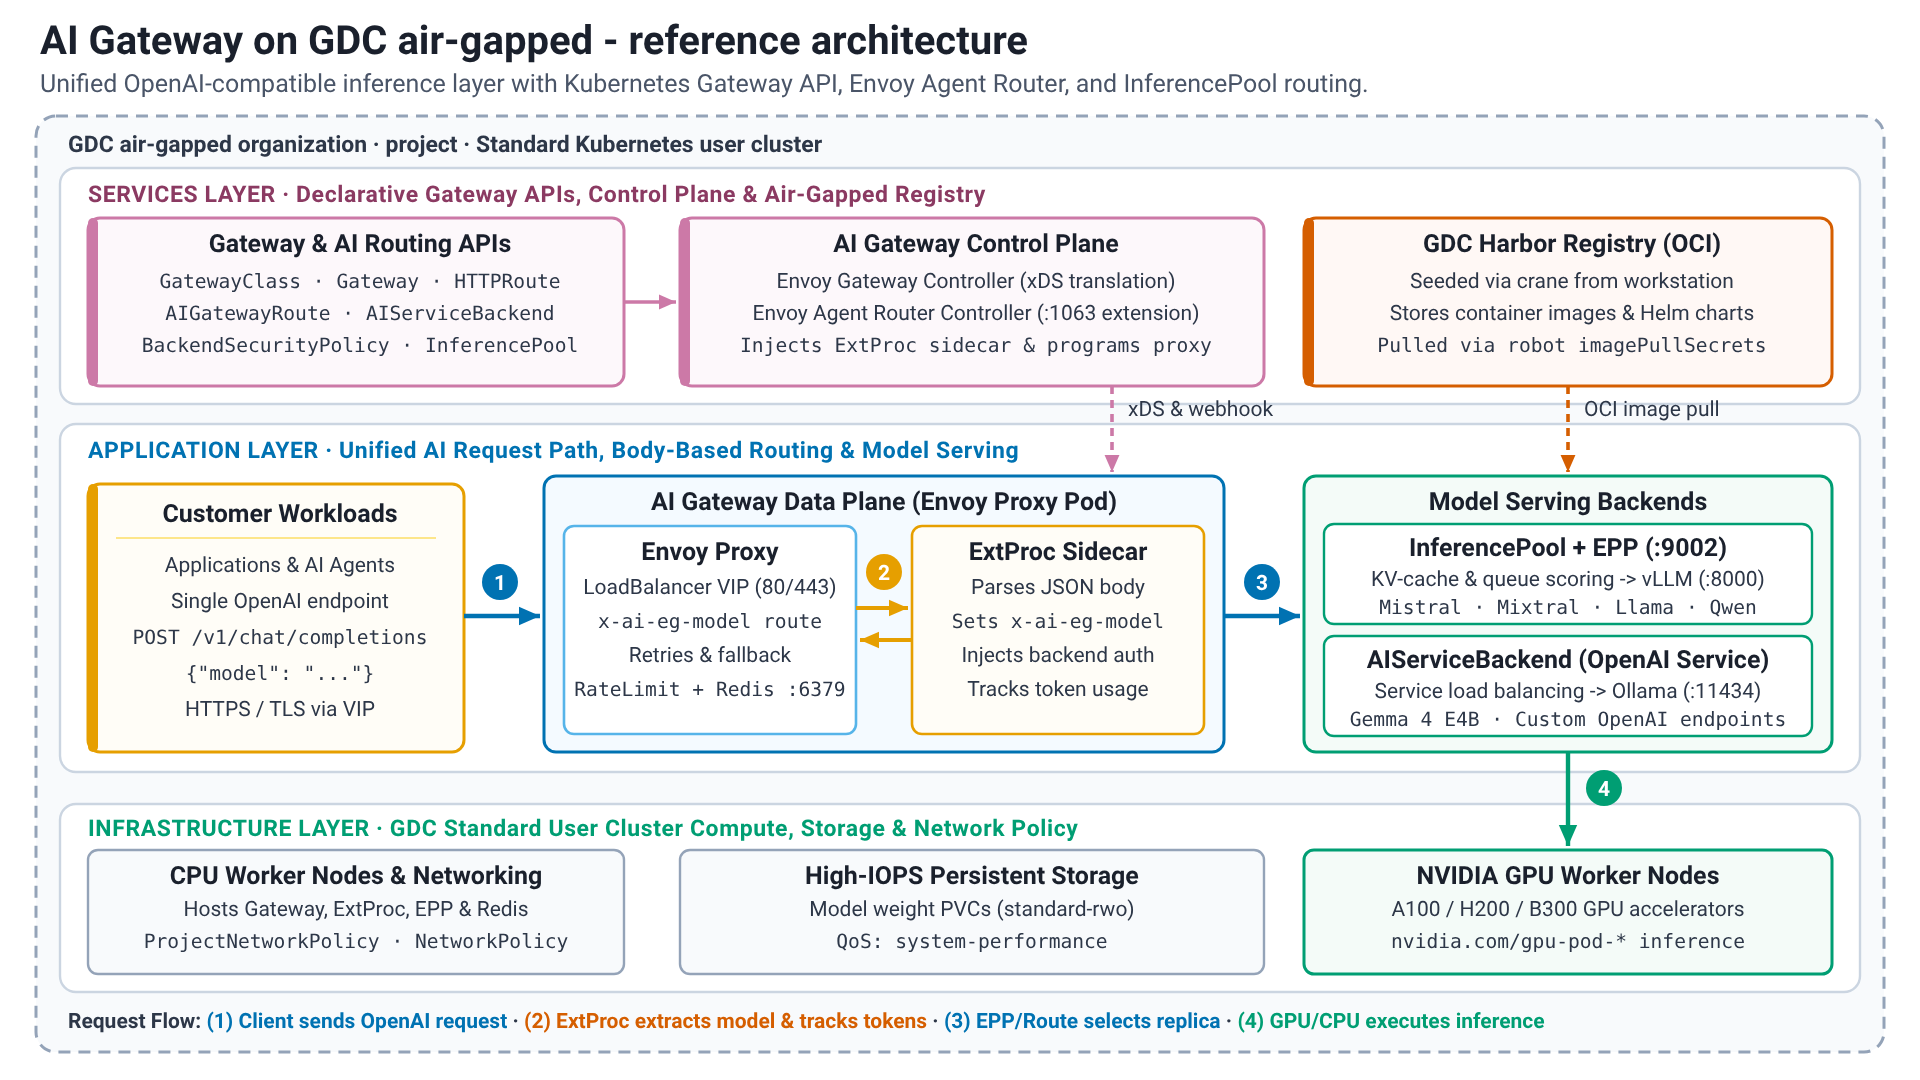
Die Lösung wird vollständig in einem Standardcluster der GDC mit Air Gap-Organisation ausgeführt. In der Services-Ebene standardisiert die Kubernetes Gateway API das Konfigurationsmodell. Die Steuerungsebene des KI-Gateways (der Envoy Gateway-Controller und der Envoy Agent Router-Controller) liest die Gateway API- und Envoy Agent Router-Ressourcen und konfiguriert die Datenebene: einen Envoy-Proxy Deployment, der der Anfrage-Einstiegspunkt ist (über ein Service vom Typ LoadBalancer verfügbar gemacht), und den externen Prozessor des Envoy Agent Router, der als Sidecar im Proxy Pod ausgeführt wird und die KI-spezifische Logik ausführt. In der Anwendungsschicht senden Kunden-Workloads (Anwendungen und Agents) eine KI-Anfrage an den Proxy (1). Der Proxy übergibt die Anfrage an den externen Prozessor, der den Modellnamen extrahiert, die Anfrage übersetzt und die Tokennutzung aufzeichnet (2). Der Proxy leitet den ausgeglichenen Traffic an die Inferenz-Pods des ausgewählten Modells weiter (3) und das Modell wird auf den GPU-Knoten der Infrastrukturschicht ausgeführt (4). Modellbereitstellungs-Back-Ends werden entweder als AIServiceBackend (ein beliebiger OpenAI-kompatibler Service) oder als InferencePool an das Gateway angehängt, wobei der Endpoint Picker die beste Replika pro Anfrage auswählt. Container-Images und Helm-Diagramme werden aus Harbor abgerufen.
Lösungskomponenten
Die Lösung verwendet die folgenden Komponenten:
| Lösungskomponente | Verantwortlichkeiten | Datenfluss | Schnittstellen |
|---|---|---|---|
| Kubernetes Gateway API | Standardmäßiges, rollenorientiertes Ressourcenmodell für Ingress und Routing: GatewayClass (im Besitz der Plattform), Gateway (Listener, TLS) und Routenressourcen (im Besitz von Anwendungsteams). Nachfolger der Ingress API ohne anbieterspezifische Annotationen. |
Nur deklarative Konfiguration; die Ressourcen werden von den Controllern überwacht und es gibt keinen Anfragetraffic. | Kubernetes API (gateway.networking.k8s.io/v1); die CRDs werden über das Envoy Gateway-CRD-Diagramm installiert. |
| Envoy Gateway-Controller (Steuerungsebene) | Implementiert die Gateway API: Stellt einen Envoy-Proxy Deployment und LoadBalancer Service pro Gateway bereit, übersetzt Routen und Richtlinien (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) in die xDS-Konfiguration, führt den globalen Ratenbegrenzungsservice aus, wenn er konfiguriert ist, und ruft den Envoy Agent Router-Erweiterungsserver über den Erweiterungsmanager auf, damit InferencePool-Back-Ends der Übersetzung hinzugefügt werden. |
Überwacht die Kubernetes API und überträgt die xDS-Konfiguration an die Proxys. Es gibt keinen Anfragetraffic. | Kubernetes API (watch), xDS gRPC für die Proxys, gRPC für den Erweiterungsserver (Port 1063). |
| Envoy Agent Router-Controller (Steuerungsebene) | Gleicht die aigateway.envoyproxy.io/v1beta1-Ressourcen, AIGatewayRoute (Routingregeln für den extrahierten Modellnamen), AIServiceBackend (ein Backend mit seinem API-Schema), BackendSecurityPolicy (Upstream-Anmeldedaten) und GatewayConfig (Einstellungen für externe Prozessoren pro Gateway) mit Envoy Gateway-Ressourcen ab, fügt die Sidecar-Datei für externe Prozessoren in die Envoy-Proxy-Pods ein und stellt den von Envoy Gateway verwendeten Erweiterungsserver bereit. |
Nur Konfiguration. | Kubernetes API, gRPC-Erweiterungsserver (Port 1063), Mutating Admission-Webhook für die Sidecar-Injektion. |
| Envoy-Proxy (Datenebene) | Einstiegspunkt für Anfragen: Beendet TLS, gleicht Listener und Routen ab, führt einen Lastenausgleich zwischen Back-End-Endpunkten durch, erzwingt Ratenbegrenzungen und Zeitüberschreitungen, versucht es noch einmal und greift auf alternative Back-Ends zurück. Außerdem werden Zugriffsprotokolle und Messwerte ausgegeben. | Empfängt Clientanfragen auf der LoadBalancer-VIP (80/443), fragt für jede KI-Anfrage den externen Prozessor ab, leitet die Anfrage an den ausgewählten Backend-Endpunkt (ein Service oder das vom Endpoint Picker ausgewählte Pod) weiter und streamt die Antwort zurück an den Client. |
HTTP/HTTPS für Clients (OpenAI-kompatible API), ext_proc-gRPC für den Sidecar und den Endpoint Picker, HTTP für die Backends, gRPC für den Ratenbegrenzungsdienst. |
| Envoy Agent Router External Processor (ExtProc) | modelx-ai-eg-modelDer Anfrage- und Antwort-Payload wird zwischen dem Client-API-Schema und dem Backend-API-Schema übersetzt. Außerdem werden die von BackendSecurityPolicy definierten Upstream-Anmeldedaten eingefügt und die Tokennutzung (Eingabe, Ausgabe, insgesamt) aus der Antwort in dynamische Metadaten extrahiert, die für die tokenbasierte Ratenbegrenzung und ‑messung verwendet werden. |
Sidecar-Container im Envoy-Proxy Pod; verarbeitet Anfrage- und Antwort-Bodys, einschließlich gestreamter Antworten. |
Envoy ext_proc gRPC; Prometheus-Messwerte-Endpunkt. |
| Gateway API Inference Extension (InferencePool + Endpoint Picker) | InferencePool (inference.networking.k8s.io/v1) gruppiert die Pods einer Modellserverbereitstellung (Label-Selektor, Zielport, z. B. 8000) und verweist auf den zugehörigen Endpoint Picker (EPP). Mit InferenceObjective (v1alpha2) wird jedem Modell oder Zielvorhaben eine Priorität zugewiesen. Der EPP ruft die Messwerte des Modell-Servers (Tiefe der Anfrage-Warteschlange, KV-Cache-Nutzung, geladene LoRA-Adapter) ab und wählt für jede Anfrage den Endpunkt aus. |
Der Proxy ruft das EPP (ext_proc, Port 9002) mit den Anfrageheadern auf. Das EPP antwortet mit dem zu verwendenden Endpunkt. Der Proxy leitet die Anfrage an diesen Pod weiter. |
Kubernetes API (CRDs), gRPC ext_proc (9002), Prometheus-Scraping der Modellserver. |
| Redis (optional) | Backing Store des Envoy-Ratenbegrenzungsdienstes: Gemeinsame Zähler für anfrage- und tokenbasierte Limits für alle Proxy-Replikate. Nur erforderlich, wenn die globale Ratenbegrenzung konfiguriert ist. | Der Ratenbegrenzungsservice liest und erhöht Zähler auf Port 6379 für jede eingeschränkte Anfrage. | Redis-Protokoll (6379). Redis 8.10, das im Cluster bereitgestellt wird, oder eine vorhandene Redis-Instanz. |
| Backend für die Modellbereitstellung (Ollama / vLLM) | Stellen Sie die Open-Weight-Modelle hinter dem Gateway bereit, die mit der Begleitanleitung „Open-Weight-Modelle in GDC mit Air Gap bereitstellen“ bereitgestellt wurden. Als AIServiceBackend (alle OpenAI-kompatiblen Service, z. B. Ollama) oder als InferencePool (Modellserver wie vLLM, die die Messwerte bereitstellen, anhand derer der Endpoint Picker die Punktzahl berechnet). |
Die weitergeleiteten Anfragen vom Proxy empfangen, Inferenzen auf den GPU-Knoten (oder auf der CPU für die funktionale Auswertung mit kleinen Modellen) ausführen und die OpenAI-kompatible Antwort zurückgeben. | OpenAI-kompatible REST API: vLLM an Port 8000, Ollama an Port 11434; Prometheus-Messwerte (vLLM) für die Endpunktauswahl. |
| Harbor | Hier werden die Container-Images (Envoy-Proxy, Envoy Gateway, Envoy Agent Router-Controller und externer Prozessor, Ratenbegrenzungsservice, Endpoint Picker, Redis) und die Helm-Diagramme (OCI-Artefakte) der Lösung gespeichert. | Artefakte werden mit seed_registry.sh (crane) von einer Workstation mit Internetzugang aus den öffentlichen Registries in Harbor kopiert. Der Cluster ruft Images mit einem Robot-Konto über Image-Pull-Secrets ab und die Diagramme werden mit helm template aus Harbor gerendert. |
OCI Distribution API; Harbor-Benutzeroberfläche und Roboterkonten. |
| Standardcluster und GPU-Knoten | Hier werden alle Gateway-Komponenten gehostet (CPU-Knoten reichen aus) und die Pod-Inferenz (GPU-Knoten mit den von den Knoten erkannten Beschleunigerressourcen). Bietet LoadBalancer VIPs, nichtflüchtigen Speicher für die Modellgewichte und die Durchsetzung der Netzwerkrichtlinien. |
Fundamentale Plattform: Anfragen gehen über den LoadBalancer-VIP des Gateway ein und verbleiben im Clusternetzwerk. |
Kubernetes API, GDC-Netzwerk-APIs (networking.gdc.goog/v1 ProjectNetworkPolicy), GDC-Konsole und gdcloud für den Plattformadministrator. |
Funktionen
Diese Referenzarchitektur bietet die folgenden Kernfunktionen:
- Einheitlicher OpenAI-kompatibler Endpunkt:Anwendungen rufen für jedes Modell, das hinter dem Gateway bereitgestellt wird, eine Adresse auf (
/v1/chat/completions,/v1/modelsusw.).- Komponenten:
Gateway,AIGatewayRoute, Envoy-Proxy, externer Prozessor. - Aufgaben:Eine stabile virtuelle IP-Adresse bereitstellen, TLS beenden, das OpenAI-kompatible Anfrageformat akzeptieren und es bei Bedarf in das Backend-Schema übersetzen.
- Schnittstellen:HTTPS REST (JSON, einschließlich Server-Sent Events für Streaming).
- Komponenten:
- Textkörperbasiertes (modellbezogenes) Routing:Das Gateway liest das Feld
modeldes Anfragetextkörpers und leitet die Anfrage ohne clientseitige Endpunktlogik an das passende Backend weiter.- Komponenten:Externer Prozessor,
AIGatewayRoute-Regeln, die mitx-ai-eg-model,AIServiceBackendundInferencePoolübereinstimmen. - Aufgaben:Modellname extrahieren, Routenregeln abgleichen, Modelle umbenennen (
modelNameOverride), Traffic nach Gewicht aufteilen und nach Priorität auf alternative Back-Ends zurückgreifen. - Schnittstellen:Kubernetes API (
aigateway.envoyproxy.io/v1beta1).
- Komponenten:Externer Prozessor,
- Modellserver-basiertes Load Balancing:Anfragen an eine
InferencePoolwerden nicht im Round-Robin-Verfahren, sondern an das Replikat mit der kürzesten Warteschlange und dem nützlichsten KV-Cache gesendet.- Komponenten:Gateway API Inference Extension (
InferencePool,InferenceObjective, Endpoint Picker). - Aufgaben:Messwerte des Scraping-Modellservers, Scoring-Endpunkte (Warteschlangenlänge, KV-Cache-Nutzung, Prefix-Cache-Affinität, LoRA-Adapter), Berücksichtigung von Prioritäten pro Ziel unter Last.
- Schnittstellen:Kubernetes API (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), ext_proc gRPC (9002).
- Komponenten:Gateway API Inference Extension (
- Upstream-Authentifizierungs- und Sicherheitsrichtlinien:Anmeldedaten für Back-Ends, für die sie erforderlich sind, werden vom Gateway eingefügt und nie an die Anwendungen verteilt.
- Komponenten:
BackendSecurityPolicy, Envoy GatewaySecurityPolicy, TLS-Listener. - Verantwortlichkeiten:API-Schlüssel in die Back-Ends einfügen, Client-TLS am
Gatewaybeenden, Client-Authentifizierungs- und Autorisierungsrichtlinien bei Bedarf erzwingen. - Schnittstellen:Kubernetes-
Secrets, auf die in den Richtlinien verwiesen wird.
- Komponenten:
- Tokenbasierte Ratenbegrenzung (optional): Die Nutzung wird in Tokens gemessen, nicht nur in Anfragen.
- Komponenten:Externer Prozessor (
llmRequestCosts), Envoy GatewayBackendTrafficPolicy(globale Ratenbegrenzung), Ratenbegrenzungsdienst, Redis. - Verantwortlichkeiten:Eingabe-, Ausgabe- und Gesamtzahl der Tokens aus jeder Antwort extrahieren, als Anfragekosten anhängen, Budgetbeschränkungen pro Nutzer oder pro Modell für alle Proxy-Replikate erzwingen.
- Schnittstellen:Kubernetes API, Redis (6379).
- Komponenten:Externer Prozessor (
- Traffic-Verwaltung:Die Standardfunktionen der Gateway API gelten für KI-Traffic.
- Komponenten:
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - Aufgaben:Host-, pfad- und headerbasierter Abgleich, Timeouts für lange Generierungen, Wiederholungsversuche, gewichtete Traffic-Aufteilung und prioritätsbasierte Fallback-Funktion zwischen Back-Ends.
- Schnittstellen:Kubernetes API.
- Komponenten:
- Beobachtbarkeit:Für jedes Modell sind Messwerte für Anfragen, Latenz und Tokens verfügbar.
- Komponenten:Envoy-Proxy-Zugriffsprotokolle und ‑Statistiken, Messwerte für externe Prozessoren (Tokennutzung, Anfragedauer, Zeit bis zum ersten Token), Endpoint Picker-Messwerte.
- Verantwortlichkeiten:Bereitstellung von Messwerten im Prometheus-Format und strukturierten Zugriffsprotokollen, die vom GDC-Beobachtbarkeits-Stack oder einem vom Kunden verwalteten Prometheus extrahiert werden können.
- Schnittstellen:Prometheus-Messwertendpunkte, Standardausgabelogs.
- Air-gapped Artifact Management:Jedes Image und Diagramm wird vor der Installation in Harbor bereitgestellt.
- Komponenten:Harbor,
seed_registry.sh, Roboterkonten, Secrets zum Abrufen von Images,EnvoyProxy-Ressource (Proxy-Image und Pull-Secret). - Verantwortlichkeiten:Seeding von Bildern und OCI-Helm-Diagrammen von einer verbundenen Workstation, Anpinnen von Versionen, Rendern von Diagrammen offline mit
helm template. - Schnittstellen:OCI Distribution API, Kubernetes API.
- Komponenten:Harbor,
Architekturprinzipien
- Standards First: Das Gateway wird über die Kubernetes Gateway API und ihre Inference Extension konfiguriert und spricht die OpenAI-kompatible API für Anwendungen. Anwendungen, Routen und Back-Ends bleiben also über Gateway-Implementierungen hinweg portierbar.
- Security First: Alle Komponenten und Daten befinden sich innerhalb der Air-Gap-Grenze des GDC. TLS wird bei
Gatewaybeendet, Backend-Anmeldedaten werden vom Gateway eingefügt und der Netzwerkzugriff wird mitNetworkPolicy- undProjectNetworkPolicy-Objekten eingeschränkt. - Datenhoheit: Prompts, Antworten, Modellgewichte und Nutzungsdaten verlassen niemals die GDC-Organisation des Kunden. Für den Betrieb ist keine externe Verbindung erforderlich.
- Trennung von Zuständigkeiten: Mit der rollenorientierten Gateway API kann der Plattformadministrator die
GatewayClass-,Gateway-, TLS- und Netzwerkrichtlinien verwalten, während die Anwendungsteams ihreAIGatewayRoute-,AIServiceBackend- undInferencePool-Ressourcen in ihren eigenen Namespaces verwalten. - Entkoppelte Steuerungs- und Datenebene: Controller übersetzen nur die Konfiguration. Der Anfragepfad besteht aus dem Envoy-Proxy, seinem externen Prozessor-Sidecar und dem Endpoint Picker. Diese Komponenten stellen weiterhin Traffic bereit, wenn ein Controller neu gestartet wird.
- Offen und flexibel: Die Architektur verwendet durchgehend Open-Source-Software (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension, Ollama, vLLM). Dieselben Gateway API-Ressourcen können von alternativen Implementierungen bereitgestellt werden.
- Skalierbarkeit und Leistung: Die Datenebene wird horizontal skaliert, indem Proxy-Replikate hinzugefügt werden, und vertikal, indem CPU und Arbeitsspeicher angepasst werden. Das Load-Balancing mit Modellserver sorgt dafür, dass die GPUs ausgelastet sind, ohne einzelne Replikate zu überlasten.
- Vereinfachte Endnutzererfahrung: Ein Endpunkt, ein API-Format und ein Anmeldedatum für jedes Modell verkürzen den Weg von der Modellbereitstellung bis zur Nutzung.
- Resilienz: Kubernetes-Systemdiagnosen und -Replikation, Envoy-Wiederholungen und prioritätsbasierte Fallback-Mechanismen zwischen Back-Ends sorgen dafür, dass der Endpunkt verfügbar bleibt, wenn einzelne Modellreplikate ausfallen.
Hinweise
- Skalierbarkeit und Leistung:
- Die Gateway-Komponenten sind reine CPU-Arbeitslasten. Der Envoy-Proxy
DeploymenteinesGatewaywird horizontal skaliert, indem die Anzahl der Replikate (EnvoyProxy-Ressource) erhöht wird, und vertikal, indem die CPU- und Arbeitsspeicheranforderungen erhöht werden. Die Untersuchung des Inhalts durch den externen Prozessor kostet CPU proportional zur Größe von Anfrage und Antwort. Streaming-Antworten werden inkrementell verarbeitet. - Das Load-Balancing mit Modellserver-Unterstützung gilt nur für Backends, die als
InferencePoolangehängt sind. Backends, die alsAIServiceBackendangehängt sind, werden vom Proxy über die Endpunkte ihresServiceper Load-Balancing verteilt. - Das Gateway fügt keine GPU-Kapazität hinzu: Durchsatz und Latenz werden durch die Modellserver begrenzt. Passen Sie die Modellbereitstellungen mit dem zugehörigen Leitfaden an (vLLM für hohen Durchsatz, Ollama für Benutzerfreundlichkeit und reine CPU-Bewertung).
- Für lange Generierungen sind längere Zeitüberschreitungen für Anfragen und Leerlaufzeiten als bei typischen HTTP-APIs erforderlich. Konfigurieren Sie sie für die Routen und Richtlinien und nicht für die Clients.
- Die Gateway-Komponenten sind reine CPU-Arbeitslasten. Der Envoy-Proxy
- Ressourcenverwaltung:
- Alle Gateway-Komponenten werden auf CPU-Knoten ausgeführt und benötigen keinen Beschleuniger. Die folgende Tabelle enthält Richtwerte für die Dimensionierung einer funktionalen Bereitstellung. In der Referenzimplementierung werden die genauen Anfragen und Limits festgelegt. Die Produktionswerte hängen von der Anforderungsrate und den Nutzlastgrößen ab.
- In der folgenden Porttabelle sind alle Ports aufgeführt, die in den Netzwerkrichtlinien zugelassen werden müssen.
- Die GPU-Planung gehört zu den Modellbereitstellungen: Die Namen der Beschleunigerressourcen werden von den Knoten ermittelt, wie im zugehörigen Leitfaden beschrieben.
Ungefähre Dimensionierung der Gateway-Komponenten (nur CPU)
| Komponente | Replikate | CPU (Anfrage) | Arbeitsspeicher (Anfrage) | Hinweise |
|---|---|---|---|---|
| Envoy Gateway-Controller | 1 | 100–500 m | 256 Mi–1 Gi | Steuerungsebene; nicht im Anfragepfad |
| Envoy Agent Router-Controller | 1 | 100–500 m | 256 Mi–512 Mi | Steuerungsebene und Erweiterungsserver |
Envoy-Proxy Pod (Proxy + Sidecar für externen Prozessor) |
1–2 pro Gateway |
500 m–2 | 512 Mi–2 Gi | Mit Anforderungsrate und Nutzlastgröße skalieren |
| Endpunktauswahl | 1 pro InferencePool |
100–500 m | 256 Mi–512 Mi | Ruft die Messwerte des Modell-Servers ab. |
| Ratenbegrenzungsservice (optional) | 1 | 100–500 m | 256 Mi–512 Mi | Nur mit globaler Ratenbegrenzung |
| Redis (optional) | 1 | 100–500 m | 256 Mi–1 Gi | Nur mit globaler Ratenbegrenzung |
Netzwerkports
| Port | Komponente | Zweck |
|---|---|---|
| 80 / 443 | Envoy-Proxy (Gateway-Listener) |
HTTP-/HTTPS-Einstiegspunkt auf der LoadBalancer-VIP |
| 1063 | Envoy-Agent-Router-Controller (Erweiterungsserver) | gRPC-Aufrufe vom Envoy Gateway-Erweiterungsmanager |
| 9002 | Endpunktauswahl | ext_proc-gRPC-Aufrufe vom Envoy-Proxy |
| 6379 | Redis | Zähler für Ratenbegrenzungen |
| 8000 | vLLM | OpenAI-kompatible API und Messwerte des Modell-Servers |
| 11434 | Ollama | Ollama- und OpenAI-kompatible API des Modellservers |
- Verfügbarkeit und Zuverlässigkeit:
- Der Proxy und der externe Prozessor werden in derselben
Podausgeführt. Mehrere Replikate hinter derLoadBalancerServicemaskieren einzelnePod-Fehler und die Controller können neu gestartet werden, ohne den Traffic zu unterbrechen. - In
AIGatewayRoute-Regeln können mehrere Backends mit Prioritäten aufgeführt werden, sodass das Gateway auf ein anderes Replikatset oder einen anderen Modellserver zurückgreift, wenn ein Backend fehlerhaft ist. - Die Endpunktauswahl ist
Deployment-spezifisch. Wenn sie nicht verfügbar ist, schlagen Anfragen an diesenInferencePoolfehl, bis sie wieder verfügbar ist. Führen Sie sie mit Ressourcenanforderungen und Bereitschaftstests aus und überwachen Sie sie wie eine Komponente der Datenebene. - In Redis werden nur Zähler für die Ratenbegrenzung gespeichert. Ein Redis-Ausfall wirkt sich auf die Ratenbegrenzung, nicht auf das Routing aus.
- Der Proxy und der externe Prozessor werden in derselben
- Operative Komplexität:
- Versionsabstimmung zwischen Envoy Gateway, Envoy Agent Router und der Gateway API Inference Extension: Führen Sie ein Upgrade der drei Komponenten gleichzeitig mit der getesteten Kombination durch (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, Gateway API Inference Extension 1.5.0).
- Air-gapped-Lebenszyklus: Jedes Image und Diagramm wird bei jedem Upgrade in Harbor neu gesät. Die
EnvoyProxy-Ressource und die Diagrammwerte fixieren die Registry und das Pull-Secret. - Zwei Konfigurationsebenen:
GatewayClass/Gateway/EnvoyProxy(im Besitz der Plattform) undAIGatewayRoute/AIServiceBackend/InferencePool(im Besitz des Teams). Beim Onboarding eines neuen Modells werden eine Routingregel und ein Backend hinzugefügt, nicht ein neues Gateway. - Monitoring: Anforderungsrate, Latenz (einschließlich der Zeit bis zum ersten Token), Tokennutzung pro Modell und pro Nutzer, Endpoint Picker-Bewertung und GPU-Auslastung der Modellserver.
InferenceObjectiveist noch eine Alpha-API (v1alpha2). Es ist daher mit Schemaänderungen zwischen den Versionen der Inference Extension zu rechnen.
- Sicherheit und Compliance:
- Die gesamte Lösung wird innerhalb des Air-Gap-Sicherheitsperimeters des GDC betrieben.
- Netzwerkrichtlinien sind obligatorisch: Ein Namespace
NetworkPolicylässt Traffic vom Proxy zu den Modell-Server-Ports (8000, 11434) und zum Endpoint Picker (9002) zu. EinProjectNetworkPolicylässt Client-Traffic zumLoadBalancer-VIP zu, wenn sich Nutzer außerhalb des Projekts befinden. - TLS wird am
Gatewaymit einem Zertifikat beendet, das in einem Kubernetes-Secretgespeichert ist. Clients sehen immer nur den Gateway-Endpunkt. - Upstream-Anmeldedaten (z. B. ein von einem Modell-Server benötigter API-Schlüssel) werden in
Secrets gespeichert, auf die von einemBackendSecurityPolicyverwiesen wird, und vom Gateway eingefügt. Anwendungen enthalten also nie Backend-Anmeldedaten. - Durch die tokenbasierte Ratenbegrenzung wird der Verbrauch von teurer GPU-Kapazität pro Nutzer oder pro Modell begrenzt.
- Harbor-Roboterkonten und Kubernetes-Image-Pull-Secrets sorgen für sicheren Zugriff auf Container-Images. Die rollenorientierte Gateway API RBAC trennt die Verantwortlichkeiten für Plattform und Anwendung.
Designentscheidungen
Für diese Referenzarchitektur wurden die folgenden wichtigen Designentscheidungen getroffen:
Entscheidung 1: Implementierung des KI-Gateways: Open-Source-Envoy-Agent-Router auf Envoy Gateway im Vergleich zu alternativen Distributionen
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Das KI-Gateway ist die primäre Architekturoption mit praktikablen Alternativen, von selbstverwalteten Open-Source-Optionen bis hin zu kommerziell unterstützten Angeboten: (a) Envoy Agent Router auf Envoy Gateway (Open Source), (b) kgateway und agentgateway (Open-Source-Gateway API-Implementierungen, die auch LLM-Anbieter-Traffic, MCP-Tools und die Kommunikation zwischen Agenten in einer Datenebene verarbeiten, optional mit Anbietersupport von solo.io), (c) Solo Enterprise für agentgateway als kommerziell unterstützte Premium-Option. | In der Referenzimplementierung wird der Open-Source-Envoy Agent Router auf Envoy Gateway verwendet. Die Alternativen bleiben gültige Optionen hinter denselben Gateway-API-Ressourcen. Für Produktionsumgebungen, die dedizierten Anbietersupport erfordern, wird eine kommerziell unterstützte Distribution empfohlen. | Vorteile von Open Source: schlank und standardkonform, leistungsstarkes L7-Routing, keine Lizenzgebühren, ideal, um die Lösung zu testen, bevor Sie sich für ein kostenpflichtiges Angebot entscheiden. Envoy Agent Router ist die in dieser Anleitung validierte Option. Nachteile von Open Source: Der Support erfolgt auf Best-Effort-Basis durch das Solutions-Team und die Community. Das ist möglicherweise nicht ausreichend für Produktionsumgebungen. Premium-Vorteile: Enterprise-Supportvereinbarungen für den Gateway-Lebenszyklus und oft erweiterte agentische Funktionen. Nachteile von Premium: kostenpflichtige Lizenz- oder Supportvereinbarung und zusätzliche Anbieterbeziehung. |
Entscheidung 2: Kubernetes Gateway API mit der Inference Extension im Vergleich zu Ingress oder einer proprietären Gateway API
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Inferenzendpunkte können mit der alten Ingress API, einem gatewayspezifischen Konfigurationsformat oder der Kubernetes Gateway API bereitgestellt werden. Für das modellbewusste Load-Balancing ist außerdem eine Möglichkeit erforderlich, Modellserverpools und ihre Prioritäten zu beschreiben. | Die Lösung basiert auf der Kubernetes Gateway API (GatewayClass, Gateway, Routen), die von Envoy Gateway implementiert wird, und auf der Gateway API Inference Extension (InferencePool, InferenceObjective, Endpoint Picker) für das modellbasierte Routing. |
Die Gateway API ist der Kubernetes-Standard, der Ingress ablöst. Sie ist rollenorientiert (Plattform- und Anwendungsteams) und über Implementierungen hinweg portierbar. Die Inference Extension ist der Community-Standard für das Modellserver-bewusste Routing (Warteschlangentiefe, KV-Cache, Prioritäten) und wird vom Envoy Agent Router sofort unterstützt. Die alternativen Gateway-Distributionen implementieren dieselben APIs, wodurch Entscheidung 1 rückgängig gemacht werden kann. |
Entscheidung 3: Textkörperbasiertes Routing für das Feld model von OpenAI-kompatiblen Anfragen als einheitlicher Endpunkt
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
Anwendungen können Modelle über einen Endpunkt pro Modell (host- oder pfadbasiert), über einen vom Client festgelegten benutzerdefinierten Header oder über das Feld model adressieren, das bereits in jeder OpenAI-kompatiblen Anfrage enthalten ist. |
Das Gateway macht einen OpenAI-kompatiblen Endpunkt und Routen im Feld model verfügbar: Der externe Prozessor extrahiert ihn in den Header x-ai-eg-model und die AIGatewayRoute-Regeln stimmen mit diesem Header überein. |
Vorhandene OpenAI-kompatible Clients und SDKs funktionieren unverändert und Modelle können durch Ändern eines Strings gewechselt werden. Endpunkte, Anmeldedaten und Modellplatzierung können geändert werden, ohne dass Anwendungen angepasst werden müssen. Mit denselben Regeln kann ein Modellname mehreren Backends für die Aufteilung des Traffics, Fallback oder Überschreibungen des Modellnamens zugeordnet werden. |
Entscheidung 4: Air-gapped Artifact Seeding in Harbor im Vergleich zu On-Demand-Pulls
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Bei der Upstream-Installation werden Container-Images aus öffentlichen Registries und Helm-Diagramme als OCI-Artefakte bei Bedarf abgerufen. Das ist in einer Air-Gap-Umgebung nicht möglich. | Alle Container-Images (Envoy-Proxy, Envoy Gateway, Envoy Agent Router-Controller und externer Prozessor, Ratenbegrenzungsservice, Endpoint Picker, Redis) sowie die Helm-Diagramme für Envoy Gateway und Envoy Agent Router werden in ein Harbor-Projekt mit seed_registry.sh (crane) eingefügt. Diagramme werden offline mit helm template aus Harbor gerendert. Die EnvoyProxy-Ressource und die Diagrammwerte fixieren die Harbor-Registrierung und das Pull-Secret. |
Ein wiederholbarer, prüfbarer Seeding-Schritt pro Version; der Cluster benötigt nie eine externe Verbindung; durch das Anpinnen von Versionen werden Upgrades explizit und reversibel. |
Entscheidung 5: Optionale tokenbasierte Ratenbegrenzung mit Redis im Vergleich zu nur anfragebasierten Limits
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Die GPU-Kapazität wird pro Token und nicht pro Anfrage verbraucht. Ein Limit für die Anzahl der Anfragen kann ein gemeinsam genutztes Modell nicht vor einigen sehr großen Prompts oder langen Generierungen schützen. Für die globale Ratenbegrenzung in Envoy Gateway ist ein gemeinsamer Zählerspeicher erforderlich. | Die tokenbasierte Ratenbegrenzung ist eine optionale Funktion der Architektur: Der externe Prozessor erfasst Eingabe-, Ausgabe- und Gesamttokens pro Anfrage (llmRequestCosts), ein BackendTrafficPolicy setzt das Budget durch und eine Redis-Instanz (Redis 8.10, im Cluster bereitgestellt oder eine vorhandene Instanz) speichert die Zähler. Für Bereitstellungen ohne Ratenbegrenzung ist Redis nicht erforderlich. |
Die Nutzung wird in der Einheit gemessen, die die Kosten widerspiegelt. Budgets werden für alle Proxy-Repliken einheitlich durchgesetzt und die Abhängigkeit wird nur von Kunden bezahlt, die Kontingente benötigen. |
Entscheidung 6: Topologie: Gateway-Steuerung und Datenebene in einem dedizierten Namespace eines Standardclusters, Modelle in Anwendungs-Namespaces
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Das Gateway kann in einem dedizierten Cluster, in jedem Anwendungs-Namespace oder einmal pro Standardcluster neben den Modellen ausgeführt werden, vor denen es steht. Offene Gewichtungsmodelle in GDC Air-Gapped werden in Standardclustern bereitgestellt (Begleitdokument). | Die Steuerungsebene von Envoy Gateway und Envoy Agent Router sowie die Datenebene des Envoy-Proxys werden in einem dedizierten Namespace des Standardclusters ausgeführt, der die Modelle hostet. AIGatewayRoute, AIServiceBackend, InferencePool und die Modellbereitstellungen befinden sich in den Anwendungs-Namespaces und werden namespaceübergreifend referenziert. |
Anfragen bleiben im Clusternetzwerk zwischen dem Proxy und den Modellen Pod (geringste Latenz, keine zusätzlichen Load Balancer), der Plattformadministrator ist für den Gateway-Namespace verantwortlich, während Anwendungsteams für ihre Routen und Modelle verantwortlich sind, und der Endpoint Picker kann die Modellserver direkt abrufen. Ein Client-Gateway pro Projekt, das an ein zentrales Server-Gateway weiterleitet, ist eine Erweiterung dieser Topologie für die Nutzung in mehreren Projekten. |
Annahmen und Einschränkungen
- Die GDC-Umgebung ohne Internetverbindung 1.16.2-hf1 oder höher ist mit einem Standardcluster verfügbar, auf dem Kubernetes v1.32.13-gke.400 oder höher ausgeführt wird.
- Es sind genügend Hardwareressourcen (insbesondere GPUs) für die Back-Ends für die Modellbereitstellung vorhanden. Die Gateway-Komponenten selbst werden auf CPU-Knoten ausgeführt. Für echte Modelle sind GPUs erforderlich. Kleine Modelle in Ollama können nur für die funktionale Bewertung auf der CPU ausgeführt werden.
- Eine Harbor-Instanz ist eingerichtet und zugänglich und eine Workstation mit Internetzugang und Verbindung zur GDC-Umgebung (Harbor und Kubernetes API) ist zum Seeden von Images und Diagrammen verfügbar.
- Nutzer haben die erforderlichen Berechtigungen: Projektrollen „Harbor Instance Viewer“ und „Standard Cluster Admin“ sowie eine
StandardClusterRoleBindingcluster-admin-Rolle für den Standardcluster für die clusterbezogene Installation (CRDs,GatewayClass, Namespaces). Weitere Informationen finden Sie in der Referenzimplementierung. - Die Back-Ends für die Modellbereitstellung stellen eine OpenAI-kompatible API bereit. Back-Ends, die als
InferencePoolangehängt sind, stellen auch die vLLM-kompatiblen Messwerte bereit, auf die sich die Endpunktauswahl stützt. - Einschränkung:Der Support für die Open-Source-Komponenten (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension) wird vom Solutions-Team nach bestem Bemühen bereitgestellt. Für dedizierten Anbietersupport ist eine kommerziell unterstützte Distribution erforderlich (Entscheidung 1).
- Einschränkung:
InferenceObjectiveist eine Alpha-API (inference.networking.x-k8s.io/v1alpha2) und kann sich zwischen den Releases der Inference Extension ändern. - Einschränkung:Für Nutzer außerhalb des Projekts sind eine
LoadBalancer-VIP für dieGatewayund eineProjectNetworkPolicyerforderlich. Innerhalb des Projekts können In-Cluster-Clients oderkubectl port-forwarddas GatewayServicedirekt erreichen. - Einschränkung:Gemini auf GDC, Modellabstimmung, GenAI-Modelle, die nicht auf LLMs basieren, und die Modellbereitstellung mit mehreren Knoten sind für diese Version der Lösung nicht vorgesehen.
User-Flow
Im Folgenden finden Sie einen umfassenden Nutzerablauf für das KI-Gateway in GDC mit Air Gap: Zuerst der Anfragepfad, auf den sich ein Anwendungsentwickler verlässt, dann der Einrichtungspfad, den der Plattformadministrator befolgt.
1. Entwickleranfragepfad
Eine Anwendung oder ein Agent benötigt lediglich den Gateway-Endpunkt, ein Client-Anmeldedaten, falls das Gateway diese erzwingt, und den Modellnamen.
- Anfrage senden:Die Anwendung ruft
POST /v1/chat/completionsam Gateway-Endpunkt mit einem OpenAI-kompatiblen JSON-Text auf, in dem das Modell (z. B."model": "gemma") angegeben ist. Dies entspricht dem Aufruf eines beliebigen OpenAI-kompatiblen Dienstes. - Eingang am Gateway:Die Anfrage erreicht die
LoadBalancer-VIP desGateway. Der Envoy-Proxy beendet TLS und gleicht den Listener und die Route ab. - Body verarbeiten:Der Proxy übergibt die Anfrage an den externen Prozessor „Envoy Agent Router“, der den Body parst, den Modellnamen in den
x-ai-eg-model-Header extrahiert und die Nutzlast in das Backend-Schema übersetzt, falls es sich unterscheidet. - Back-End auswählen:Die
AIGatewayRoute-Regel, die mit dem Modellnamen übereinstimmt, wählt einAIServiceBackend(z. B. das Ollama-Service) oder einInferencePool(z. B. ein vLLM-Replikatset) aus. Für einInferencePoolwählt der Endpoint Picker das Replikat mit der kürzesten Warteschlange und der besten KV-Cache-Übereinstimmung aus. - Weiterleiten und antworten:Der Proxy fügt Upstream-Anmeldedaten ein, wenn eine
BackendSecurityPolicyangewendet wird, leitet die Anfrage an die ausgewähltePodweiter, streamt die Antwort zurück und ermöglicht es dem externen Prozessor, die Tokennutzung aufzuzeichnen, die in die Messwerte und, falls konfiguriert, in das tokenbasierte Ratenlimit einfließt. - Modelle wechseln:Wenn ein Entwickler ein anderes Modell verwenden möchte, ändert er den
model-String. Es sind kein neuer Endpunkt, keine neuen Anmeldedaten und keine neue Clientbibliothek erforderlich.
2. Einrichtungspfad für Plattformadministrator
- Artefakte in Harbor übertragen:Erstellen Sie die Harbor-Roboterkonten und kopieren Sie dann die Container-Images und die Envoy Gateway- und Envoy Agent Router-Helm-Charts mit
seed_registry.shvon einer Workstation mit Internetzugang in Harbor. - Envoy Gateway installieren:Rendern Sie die CRD- und Controller-Diagramme aus Harbor mit
helm templateund wenden Sie sie im Gateway-Namespace an. Erstellen Sie dieEnvoyProxy-Ressource, die das Proxy-Image und das Pull-Secret festlegt, und prüfen Sie den Controller mit einem einfachenGatewayClass,GatewayundHTTPRoute. - Envoy Agent Router installieren:Installieren Sie die Envoy Agent Router-CRDs und die Gateway API Inference Extension-CRDs, stellen Sie den Envoy Agent Router-Controller bereit und konfigurieren Sie Envoy Gateway neu, um den Erweiterungsserver (Port 1063) aufzurufen und
InferencePool-Backends zu akzeptieren. Optional können Sie Redis bereitstellen und den globalen Ratenbegrenzungsservice aktivieren. - Gateway verfügbar machen:Erstellen Sie die
GatewayClassund dieGatewaymit HTTP- und HTTPS-Listenern (TLS-ZertifikatSecret), warten Sie auf dieLoadBalancer-VIP und wenden Sie dieProjectNetworkPolicyfür Nutzer außerhalb des Projekts an. - Modelle anhängen:Stellen Sie die Backends für die Modellbereitstellung mit dem Begleitleitfaden bereit und erstellen Sie dann
AIServiceBackend-Ressourcen für OpenAI-kompatibleServices undInferencePoolsowie Endpoint Picker-Ressourcen für vLLM-kompatible Replikatsätze zusammen mit den Namespace-NetworkPolicy-Objekten. - Route veröffentlichen:Erstellen Sie die
AIGatewayRoutemit einer Regel pro Modellname (Body-basiertes Routing) und bei BedarfBackendSecurityPolicy- undBackendTrafficPolicy-Objekte für Upstream-Anmeldedaten und Token-Budgets. - Validieren und ausführen:Rufen Sie
/v1/modelsund/v1/chat/completionsüber die VIP (oder einenkubectl port-forward-Fallback) auf, prüfen Sie die Messwerte für Proxy, externen Prozessor und Endpoint Picker und geben Sie die Endpunkt- und Modellnamen an die Anwendungsteams weiter. Skalieren Sie Proxy-Replikate und Modellbereitstellungen unabhängig voneinander. Führen Sie Upgrades für Envoy Gateway, Envoy Agent Router und die Inference Extension gemeinsam durch.
Eine detaillierte Anleitung finden Sie in der Envoy Agent Router-Referenzimplementierung und im Nutzerhandbuch für textkörperbasiertes Routing mit Envoy Agent Router.
Zusätzliches Material
- Envoy Agent Router-Referenzimplementierung
- Textkörperbasiertes Routing mit dem Envoy Agent Router – Nutzerhandbuch
- Referenzarchitektur für LLMs mit offenem Gewicht
- Dokumentation zum Envoy Agent Router
- Envoy Gateway
- Kubernetes Gateway API
- Gateway API Inference Extension
- Dokumentation zu Google Distributed Cloud mit Air Gap