


Unternehmen, die in Air-Gap-Umgebungen arbeiten, stehen vor einer großen Herausforderung: Sie benötigen die transformative Kraft von Large Language Models (LLMs), dürfen aber aufgrund strenger Sicherheitsprotokolle keine Verbindung zu externen cloudbasierten APIs herstellen. Um diese Lücke zu schließen, benötigen diese Kunden ein robustes, in sich geschlossenes Ökosystem, das in der Lage ist, Modelle mit offenem Gewicht direkt in ihrer Google Distributed Cloud (GDC) mit Air Gap zu hosten und zu verwalten. Diese lokale Bereitstellung ist unerlässlich, um die absolute Datenhoheit zu wahren und sicherzustellen, dass vertrauliche Informationen niemals das physische Gelände verlassen. Durch die Integration sicherer Ausführungsumgebungen mit lokalen Inferenz-Engines können Nutzer fortschrittliche KI-Funktionen nutzen und gleichzeitig die volle administrative Kontrolle über ihre Daten, Modellgewichte und den internen Sicherheitsstatus behalten.
Gemini on GDC bietet leistungsstarke, verwaltete Frontier-Funktionen. Kunden setzen jedoch häufig Open-Weight-Modelle wie Gemma 4 oder Llama 4 ein, um eine höhere Granularität und Kontrolle zu erreichen. Die Bereitstellung von Open-Weight-Modellen in GDC-Umgebungen mit Air Gap bietet erhebliche Kostenvorteile gegenüber verwalteten proprietären Diensten. Da die Organisationen die Modellgewichte besitzen, entfallen wiederkehrende API-Gebühren pro Token, die bei automatisierten Arbeitslasten mit hohem Volumen unerschwinglich werden können. Außerdem ermöglichen Open-Source-Modelle die Quantisierung (z. B. 4-Bit oder 8-Bit), sodass leistungsstarke Inferenz auf kleineren, kostengünstigeren Hardware-Footprints am Edge ausgeführt werden kann. Diese vertikale Optimierung in Kombination mit der Möglichkeit, die Infrastruktur für mehrere interne Anwendungen ohne zusätzliche Lizenzkosten zu nutzen, führt zu deutlich niedrigeren Gesamtbetriebskosten (TCO) für nachhaltige, umfangreiche Inferenzvorgänge.
Vorgeschlagene Lösung
In diesem Dokument wird die Referenzarchitektur für die Bereitstellung und Verwaltung von Large Language Models (LLMs) mit offenem Gewicht in GDC-Umgebungen (Google Distributed Cloud) mit Air Gap beschrieben. Viele Kunden, insbesondere in stark regulierten Branchen, können cloudbasierte LLM-APIs aufgrund strenger Anforderungen an Datensouveränität und Sicherheit nicht verwenden. Diese Architektur erfüllt die Anforderung, leistungsstarke LLMs lokal in einer eigenen sicheren GDC-Instanz auszuführen.
Was ist enthalten? Diese Architektur umfasst die Bereitstellung von Open-Source-LLMs (z. B. Gemma, Llama, DeepSeek) mit den Serving-Backends vLLM oder Ollama. Dazu gehören die Verwendung von Kubernetes für die Orchestrierung, Harbor für die Artefaktspeicherung, nichtflüchtige Volumes für Modellgewichte und Projektnetzwerkrichtlinien für die Netzwerksicherheit.
Nicht enthalten:Diese Architektur umfasst keine verwalteten AI Gateway-Dienste, proprietären Modelle wie Gemini von Google, Prozesse zur Feinabstimmung von Modellen oder GenAI-Modelle für andere Modalitäten wie die Bilderstellung. Diese Funktionen werden in separaten Leitfäden behandelt.
Zielgruppe:Die primäre Zielgruppe für dieses Dokument umfasst Plattformadministratoren, die für die Bereitstellung und Verwaltung von Diensten auf GDC verantwortlich sind, sowie technische Architekten, die KI-Lösungen in der Air-Gap-Umgebung entwickeln. Endnutzer und Entwickler, die mit den bereitgestellten Modellen interagieren, sind sekundäre Zielgruppen, die von einem Verständnis der zugrunde liegenden Struktur profitieren.
Referenzarchitektur
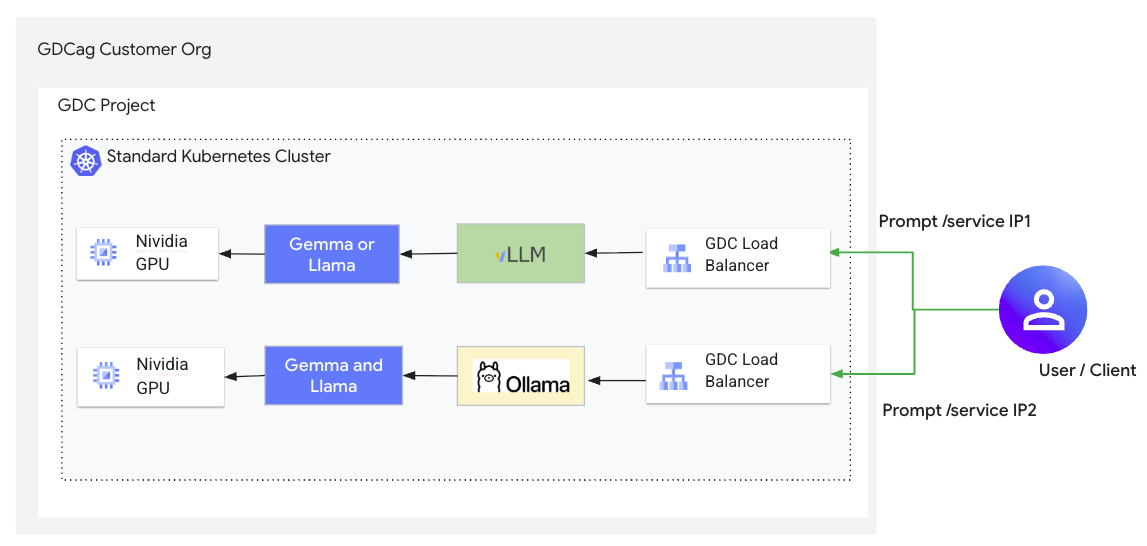
Lösungskomponenten
Die Lösung nutzt die folgenden Komponenten:
| Lösungskomponente | Verantwortlichkeiten | Datenfluss | Schnittstellen |
|---|---|---|---|
| GDC-Kundenzone mit Air Gap | Hostet die Kubernetes-Cluster, das Netzwerk und die Speicherinfrastruktur | Grundlegende Plattform | Schnittstellen für die Infrastrukturverwaltung für den IO. Kubernetes API für Plattformadministratoren und Nutzer |
| Load Balancer | Macht die LLM-Serving-Pods (vLLM, Ollama) für Traffic von außerhalb des Kubernetes-Clusters verfügbar und stellt eine stabile IP-Adresse bereit. | Externe Clientanfragen werden an die externe IP-Adresse des Load Balancers gesendet. Der LoadBalancer verteilt die Anfragen basierend auf dem Selektor des Dienstes auf die fehlerfreien Backend-Pods (vLLM oder Ollama). | Kubernetes Service API. Stellt automatisch einen Network Load Balancer in der GDC-Umgebung bereit. |
| vLLM | LLM-Inferenz mit hohem Durchsatz bereitstellen. Optimiert für niedrige Latenz durch Techniken wie PagedAttention. In der Regel wird ein Modell pro Instanz bereitgestellt. | Empfängt HTTP-Inferenzanfragen von Clients. Lädt Modellgewichte aus dem bereitgestellten PVC. Führt Berechnungen auf angehängten GPUs aus. Gibt HTTP-Antworten mit generiertem Text zurück. | OpenAI-kompatible RESTful-API für die Inferenz. Akzeptiert JSON-Anfragen. |
| Ollama | LLM-Inferenzbereitstellung, die auf Benutzerfreundlichkeit ausgelegt ist und die Verwaltung mehrerer Modelle in einer einzelnen Instanz ermöglicht (es ist jedoch immer nur ein Modell aktiv) | Empfängt HTTP-Inferenzanfragen. Lädt Modelle (oft im Container-Image gebündelt oder beim ersten Gebrauch abgerufen, wenn nicht Air-Gap-geschützt). Führt Berechnungen auf GPUs aus. Gibt HTTP-Antworten zurück. Modelle werden nach einer gewissen Zeit der Inaktivität entladen. | Die RESTful API von Ollama akzeptiert JSON-Anfragen. Außerdem ist eine CLI verfügbar. |
| Nvidia-GPUs / MIG | Hardwarebeschleunigung für LLM-Inferenz bereitstellen | Die LLM-Back-Ends (vLLM, Ollama) lagern die rechenintensiven Modellberechnungen (Matrixmultiplikationen usw.) auf die GPUs aus, um die Inferenz zu beschleunigen. Mit MIG kann eine einzelne GPU partitioniert werden, um von mehreren kleineren Modellinstanzen verwendet zu werden. | Als Ressourcentyp in Kubernetes verfügbar gemacht (z. B. nvidia.com/gpu). Pods fordern diese Ressourcen an. |
| Harbor | Container-Images für vLLM, Ollama und alle Hilfspods (z. B. busybox) werden sicher gespeichert und verwaltet. | Container-Images werden aus einer Build-Umgebung (z.B. einer Workstation mit Internetzugang) in Harbor übertragen. Kubernetes-Knoten rufen diese Images aus Harbor ab, um Container auszuführen. | Docker Registry API. Kubernetes-Knoten interagieren mit Harbor, um Images beim Erstellen von Pods abzurufen. Nutzer interagieren mit der Docker-Befehlszeile oder der Harbor-Benutzeroberfläche, um Images zu übertragen. |
| Persistent Volume Claims | Bietet nichtflüchtigen Speicher für LLM-Modellgewichte, der vom Lebenszyklus von Pods entkoppelt ist. | Modelldateien werden in das nichtflüchtige Volume kopiert, z.B. mit einem Hilfspod und kubectl cp. Der vLLM-Server liest beim Start Modellgewichte aus diesem bereitgestellten Volume. Ollama bündelt Modelle in der Regel im Image. Daher sind PVCs für die Speicherung von Ollama-Modellen in dieser Konfiguration weniger üblich. |
Kubernetes Storage API. Sie werden in YAML definiert und als Volumes in Pods bereitgestellt. |
| Projektnetzwerkrichtlinie | Erzwingt die Netzwerkisolation und steuert den Trafficfluss auf Projekt-/Namespace-Ebene. Sorgt dafür, dass nur autorisierter Traffic die LLM-Dienste erreichen kann. | Der Netzwerkverkehr zu und von Pods im Namespace wird geprüft. Die Richtlinienregeln legen fest, ob Verbindungen zu den LLM-Dienstports (z. B. 8000 für vLLM, 11434 für Ollama) zulässig sind. Dies basiert in der Regel auf Quell-IP-Bereichen oder anderen Labels. | Kubernetes-API networking.gdc.goog/v1. In YAML definiert. |
Funktionen
Diese Referenzarchitektur bietet die folgenden Kernfunktionen:
- Bereitstellung von Open-Weight-LLMs:Ermöglicht das Hosting und die Inferenz verschiedener Open-Weight-Modelle (z. B. Gemma, Llama, DeepSeek).
- Komponenten:LLM-Serving-Back-Ends (vLLM, Ollama), Kubernetes-Bereitstellungen/-Pods.
- Aufgaben:Modellgewichte laden, den Inferenzprozess verwalten, Modelle auf Hardwarebeschleunigern ausführen und Endpunkte bereitstellen.
- Schnittstellen:REST APIs (OpenAI-kompatibel für vLLM, integrierte API für Ollama) für Inferenzanfragen, in der Regel mit JSON.
- Bring Your Own Model (BYOM): Nutzer können ihre ausgewählten Open-Weight-LLMs in die Air-Gap-Umgebung importieren und bereitstellen.
- Komponenten:Harbor, Anforderungen nichtflüchtiger Volumes, Kubernetes.
- Aufgaben:Sichere Speicherung von Container-Images und Modellgewichten. Mechanismus zum Übertragen von Modellen in die Umgebung und zum Bereitstellen für die Bereitstellungs-Engines.
- Schnittstellen:Docker Registry API (für Harbor), Kubernetes API (für PVCs und Volume-Mounts).
- Hardwarebeschleunigte Inferenz:Nutzt NVIDIA-GPUs im GDC-Cluster, um LLM-Inferenzen effizient auszuführen.
- Komponenten:NVIDIA-GPUs, Kubernetes, Geräte-Plug-ins.
- Aufgaben:Pods auf Knoten mit GPU-Ressourcen planen. GPU-Hardware für die LLM-Backend-Container verfügbar machen. Unterstützt Multi-Instanz-GPU (MIG) für die Partitionierung.
- Schnittstellen:Kubernetes API (zum Anfordern von GPU-Ressourcen wie
nvidia.com/gpu).
- Netzwerkgesteuerter Zugriff:Der Zugriff auf die LLM-Inferenz-Endpunkte wird innerhalb der GDC-Umgebung gesteuert und isoliert.
- Komponenten:Kubernetes-Dienste (LoadBalancer), ProjectNetworkPolicy.
- Verantwortlichkeiten:Bereitstellung von Inferenzdiensten über eine stabile IP-Adresse. Netzwerkregeln definieren und erzwingen, um Traffic zu den LLM-Backends basierend auf Quelle, Ziel und Ports zuzulassen oder abzulehnen.
- Schnittstellen:Kubernetes API (für Services und ProjectNetworkPolicy).
- Skalierbare Bereitstellung:Die Kapazität kann je nach Bedarf angepasst werden.
- Komponenten:Kubernetes-Deployments.
- Aufgaben:Horizontale Skalierung durch Erhöhen der Anzahl von Replikaten für die LLM-Backend-Pods aktivieren. Vertikale Skalierung durch Anpassen von Ressourcenanforderungen/-limits.
- Schnittstellen:Kubernetes API (zur Verwaltung von Deployment-Replikaten und ‑Ressourcen).
Architekturprinzipien
- Sicherheit an erster Stelle: Alle Komponenten und Daten befinden sich innerhalb der Air-Gap-Grenze des GDC, was für maximale Datensicherheit und ‑kontrolle sorgt. Der Netzwerkzugriff ist durch ProjectNetworkPolicies eingeschränkt.
- Datenhoheit: Kunden behalten die volle Kontrolle über ihre Modelle und Daten. Für den Betrieb ist keine externe Verbindung erforderlich.
- Offen und flexibel: Die Architektur nutzt Open-Source-Serving-Back-Ends (vLLM, Ollama) und unterstützt eine Vielzahl von LLMs mit offenem Gewicht. So haben Kunden die Wahl und vermeiden eine Anbieterabhängigkeit für die Inferenz-Engine.
- Entkopplung von Komponenten: Wichtige Funktionen wie die Modellspeicherung (PVCs), die Bildverwaltung (Harbor) und die Bereitstellung von Inferenzanfragen (vLLM-/Ollama-Pods) sind separate Komponenten, die unabhängig voneinander verwaltet und aktualisiert werden können.
- Skalierbarkeit und Leistung: vLLM ist für Szenarien mit hohem Durchsatz und niedriger Latenz konzipiert und kann sowohl horizontal durch Erhöhen der Anzahl der Pod-Replikate als auch vertikal durch Anpassen der CPU-/GPU-Ressourcen skaliert werden, um Leistungsanforderungen zu erfüllen.
- Ressourcenoptimierung: Unterstützt NVIDIA Multi-Instance GPU (MIG), damit kleinere Modelle GPU-Ressourcen effizient gemeinsam nutzen können, wodurch die Hardwareauslastung maximiert wird.
- Standardschnittstellen: Basieren auf Kubernetes-Standards für Orchestrierung, Bereitstellung und Dienstbereitstellung. Inferenzendpunkte bieten REST APIs, wobei vLLM OpenAI-kompatibel ist.
- Resilienz: Nutzt Kubernetes-Systemdiagnosen und ‑Replikation, um die Verfügbarkeit von Diensten zu gewährleisten.
Hinweise
- Skalierbarkeit und Leistung:
- Die horizontale Skalierung wird erreicht, indem die Anzahl der Replikate im Kubernetes-Deployment für vLLM und Ollama erhöht wird.
- Beim vertikalen Skalieren werden mehr CPU/Arbeitsspeicher und größere GPU-Slices bis hin zu vollständigen GPUs zugewiesen.
- vLLM stellt ein Modell pro Instanz bereit. Für zusätzliche Modelle sind neue Bereitstellungen erforderlich. Ollama kann mehrere Modelle verwalten, führt aber immer nur eines gleichzeitig aus.
- Die PVC-Größe wirkt sich erheblich auf die Ladezeiten des Modells aus. Für hohe IOPS werden mindestens 500 GiB empfohlen.
- Ressourcenverwaltung:
- Eine sorgfältige Planung der GPU-Ressourcen ist unerlässlich. Mit NVIDIA MIG können GPUs für kleinere Modelle partitioniert werden, wodurch die Auslastung verbessert wird.
- Es muss ausreichend CPU und Arbeitsspeicher zugewiesen werden, um sowohl den Aufwand für die Inferenz als auch für die Modellverwaltung zu bewältigen.
- Für PVCs muss ausreichend Speicherplatz bereitgestellt werden, um die Modellgrößen zu berücksichtigen und die Leistung zu gewährleisten.
- Verfügbarkeit und Zuverlässigkeit:
- Kubernetes-Deployments bieten Funktionen für die Selbstheilung und Rolling Updates.
- LoadBalancer-Dienste verteilen den Traffic auf fehlerfreie Pods und maskieren so einzelne Pod-Fehler.
- Durch das Speichern von Modellgewichten auf PVCs wird die Persistenz bei Pod-Neustarts sichergestellt.
- Operative Komplexität:
- Container-Images für verschiedene Backends und Versionen in Harbor verwalten.
- Verfahren für die sichere Übertragung von Modellgewichten in die Air-Gap-Umgebung.
- Erstellen und Verwalten von Kubernetes-Manifesten (Deployments, Services, PVCs, Netzwerkrichtlinien) für jedes Modell und Back-End.
- GPU-Auslastung, Inferenzlatenz und Fehlerraten überwachen.
- Sicherheit und Compliance:
- Die gesamte Lösung wird innerhalb des Air-Gap-Sicherheitsperimeters des GDC betrieben.
- ProjectNetworkPolicies sind erforderlich, um eine strenge Netzwerkisolation zu erzwingen und den Zugriff auf die LLM-Endpunkte zu steuern.
- Harbor-Roboterkonten und Kubernetes-Image-Pull-Secrets sorgen für sicheren Zugriff auf Container-Images.
- Daten bei der Übertragung können durch Kubernetes-Netzwerkrichtlinien und Verschlüsselung auf Plattformebene geschützt werden. Ruhende Daten auf PVCs basieren auf der GDC-Speicherverschlüsselung.
Designentscheidungen
Für diese Referenzarchitektur wurden die folgenden wichtigen Designentscheidungen getroffen:
Entscheidung 1: Sowohl vLLM als auch Ollama anbieten oder nur ein Inferenzmodell anbieten
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Bieten Sie nur eine der beiden Optionen für Inferenzebenen an: VLLM und Ollama oder beide. | Wir haben uns entschieden, beide anzubieten, da unterschiedliche Nutzer und Anwendungsfälle unterschiedliche Anforderungen an Leistung, API-Kompatibilität und einfache Modellverwaltung haben. | vLLM bietet einen hohen Durchsatz, eine niedrige Latenz und OpenAI API-Kompatibilität, was es für Produktionsanwendungen geeignet macht. Ollama bietet eine einfachere Einrichtung, eine leichtere Verwaltung mehrerer Modelle und eine benutzerfreundliche Oberfläche, die sich besser für die Entwicklung und das Experimentieren eignet. Die Unterstützung beider Optionen bietet Flexibilität. |
Entscheidung 2: Nichtflüchtigen Speicher im Vergleich zum Objektspeicher für die Speicherung von vLLM-Modellen verwenden
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Für vLLM müssen Modellgewichte zur Laufzeit im Dateisystem vorhanden sein. In einer Air-Gap-Umgebung können Modelle nicht bei Bedarf heruntergeladen werden. | Die Verwendung von PersistentVolumeClaims sorgt für die Verfügbarkeit des Modells und verkürzt die Startzeit nach dem ersten Laden. Allerdings ist ein erster Schritt zum Auffüllen des PVC erforderlich, der in der Regel einen Hilfspod umfasst. | PersistentVolumeClaims bieten eine robuste und dauerhafte Speicherebene für große Modelldateien, die vom vLLM-Pod-Lebenszyklus entkoppelt ist. So können Modelle beim Start des Pods schnell geladen werden. |
Entscheidung 3: Modelle in Ollama-Docker-Images im Vergleich zu eigenständigen Images bündeln
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Ollama kann Modelle herunterladen, dazu ist jedoch Internetzugriff erforderlich, der in Air-Gap-Umgebungen nicht verfügbar ist. | Es wurde entschieden, die Bilder zu bündeln, um den Laufzeitbetrieb in der Air-Gap-Umgebung zu vereinfachen, da keine externen Aufrufe erforderlich sind. Wenn jedoch Modelle aktualisiert oder hinzugefügt werden sollen, muss das Docker-Image neu erstellt und in Harbor übertragen werden. | Wenn Sie das Docker-Image mit den vorab heruntergeladenen Modellen erstellen, wird sichergestellt, dass Ollama mit den erforderlichen Modellen offline gestartet wird. |
Entscheidung 4: vLLM und Ollama mit LoadBalancer-Diensten oder ohne Load Balancer bereitstellen
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| LLM-APIs müssen für Anwendungen in der GDC-Umgebung zugänglich sein. | Es wurde entschieden, Dienste über einen Load-Balancer bereitzustellen, da dies der Standardansatz von Kubernetes für die Dienstbereitstellung ist. Dieser Ansatz basiert jedoch auf der Bereitstellung von Load-Balancern auf der GDC-Plattform. | Kubernetes-Dienste vom Typ „LoadBalancer“ bieten eine standardmäßige, zuverlässige Methode zum Bereitstellen der LLM-Back-Ends, indem sie eine stabile IP-Adresse bereitstellen und die Last verteilen. |
Entscheidung 5: Erzwingen der obligatorischen ProjectNetworkPolicy
| Kontext | Wichtige Entscheidung | Begründung |
|---|---|---|
| Sicherheit und Isolation sind in GDC-Airgap-Bereitstellungen von entscheidender Bedeutung. | Es wurde beschlossen, die ProjectNetworkPolicy zu erzwingen, da sie den Sicherheitsstatus der bereitgestellten LLM-Dienste erheblich verbessert, auch wenn sie eine sorgfältige Definition von Netzwerkrichtlinien erfordert. | ProjectNetworkPolicies bieten eine Kubernetes-native Möglichkeit, die Netzwerkisolation auf Namespace-Ebene zu erzwingen. So kann sichergestellt werden, dass nur autorisierter Traffic die LLM-Dienste erreichen kann. |
Annahmen und Einschränkungen
- GDC mit Air Gap 1.15.1+ ist verfügbar
- Im Standardcluster sind genügend Hardwareressourcen (insbesondere GPUs) vorhanden.
- Die Harbor-Instanz ist eingerichtet und zugänglich.
- Nutzer haben die erforderlichen Berechtigungen (Namespace-Administrator, Cluster-Entwickler).
- Die Modelle sind mit den ausgewählten Serving-Backends (vLLM/Ollama) kompatibel.
User-Flow (End-to-End-Schritte)
Im Folgenden finden Sie einen umfassenden Nutzerablauf für die Bereitstellung von Large Language Models (LLMs) mit offenem Gewicht in Google Distributed Cloud (GDC) in Umgebungen ohne Internetverbindung. Der Ablauf ist in die allgemeine Einrichtung, zwei Bereitstellungspfade (vLLM und Ollama) und die endgültige Validierung unterteilt.
1. Gängige Einrichtung: Bildverwaltung
Bevor Sie ein LLM bereitstellen, müssen Sie konfigurieren, wie die GDC-Umgebung Container-Images aus Ihrer privaten Harbor-Registry abruft.
- Harbor-Robot-Konto erstellen:Generieren Sie ein Robot-Konto in der Harbor-Benutzeroberfläche und erteilen Sie ihm „pull“-Berechtigungen.
- Docker authentifizieren:Verwenden Sie die Anmeldedaten des Roboterkontos, um sich von einem Computer mit Netzwerkzugriff in Harbor anzumelden.
- Kubernetes-Secret erstellen:Erstellen Sie mit
kubectlein docker-registry-Secret im Namespace Ihres GDC-Projekts, um diese Harbor-Anmeldedaten für die Verwendung durch den Cluster zu speichern.
2. Bereitstellungspfad A: vLLM (hoher Durchsatz)
Dieser Pfad wird für die Bereitstellung leistungsstarker Modelle wie Gemma-3 empfohlen.
- Image abrufen:Das vLLM-Docker-Image aus dem Internet abrufen, für die lokale Harbor-Registry taggen und in Harbor übertragen.
- Modellspeicher vorbereiten:
- Erstellen Sie eine PVC (PersistentVolumeClaim) mit einer Größe von 500 GiB zum Speichern von Modellgewichten.
- Gewichtungen von Hugging Face auf einem mit dem Internet verbundenen Computer herunterladen.
- Verwenden Sie einen temporären „Helper-Pod“ und
kubectl cp, um diese Gewichte in den PVC in der GDC-Umgebung zu übertragen.
- Backend bereitstellen:Wenden Sie ein Kubernetes-Deployment-Manifest an, das auf das vLLM-Image verweist und den PVC für das Modellgewicht einbindet.
- Dienst freigeben:Erstellen Sie einen
LoadBalancer-Dienst, um eine externe IP-Adresse für die vLLM-API bereitzustellen. - Sicheres Netzwerk:Wenden Sie eine
ProjectNetworkPolicyan, um eingehenden Traffic am Dienstport (in der Regel 8000) zuzulassen.
3. Bereitstellungspfad B: Ollama (Benutzerfreundlichkeit)
Bei diesem Ansatz wird die Einrichtung vereinfacht, indem Modellgewichte gebündelt oder in das Image vorab geladen werden.
- Benutzerdefiniertes Image erstellen:Erstellen Sie ein Dockerfile, in dem Ollama installiert wird und mit dem bestimmte Modelle (z.B.
gemma3) mit dem BefehlRUNin die Image-Ebenen „vorgezogen“ werden. - Per Push an Harbor übertragen:Erstellen Sie das Image lokal und übertragen Sie es per Push in Ihre private Harbor-Registry.
- Bereitstellen und freigeben:Erstellen Sie ein Ollama-Deployment und einen
LoadBalancer-Dienst. - Sicheres Netzwerk:Wenden Sie eine
ProjectNetworkPolicyfür den Ollama-Port (11434) an.
4. Validierung und Tests
Nach der Bereitstellung müssen Sie noch prüfen, ob die Dienste funktionieren.
- Status prüfen:Prüfen Sie, ob die Pods ausgeführt werden und den Diensten externe IP-Adressen zugewiesen wurden.
- Test Inference (Testinferenz):
- vLLM:Senden Sie eine
curl-Anfrage an dieLoadBalancer-IP-Adresse von vLLM über den OpenAI-kompatiblen/v1/chat/completions-Endpunkt. - Ollama:Senden Sie eine
curl-Anfrage an dieLoadBalancer-IP-Adresse von Ollama an den/v1/completions-Endpunkt.
- vLLM:Senden Sie eine
5. Betrieb und Skalierung
- Vertikale Skalierung:Erhöhen Sie die Anzahl der GPU-Slices oder wechseln Sie zu Konfigurationen mit mehreren GPUs für größere Modelle.
- Horizontale Skalierung:Erhöhen Sie die Anzahl der Replikate im Deployment, um mehr gleichzeitige Nutzeranfragen zu verarbeiten.
- Fehlerbehebung:Überwachen Sie die Logs mit
kubectl logsund suchen Sie nach häufigen Problemen wie FIPS-Selbsttestfehlern oder Einschränkungen durch Netzwerkrichtlinien.