


Dieses Dokument enthält eine detaillierte Anleitung zum Konfigurieren von Body-Based Routing (BBR) für Large Language Model (LLM)-Traffic mit Envoy Agent Router (früher Envoy AI Gateway) in Google Distributed Cloud (GDC) Air-Gap-Umgebungen. Beim Body-basierten Routing prüft das Gateway die JSON-Nutzlast einer OpenAI-kompatiblen Anfrage, extrahiert das Feld model in den Header x-ai-eg-model und leitet die Anfrage an das Backend weiter, das dieses Modell bereitstellt: ein InferencePool, dessen Endpoint Picker (EPP) das beste Replikat anhand von Echtzeitmesswerten wie Warteschlangentiefe und KV-Cache-Auslastung auswählt, oder ein Standard-AIServiceBackend.
In der Anleitung werden zwei simulierte vLLM-Modellserver (meta-llama/Llama-3.1-8B-Instruct und Qwen/Qwen3-32B, die vom llm-d-Inferenzsimulator bereitgestellt werden, sodass kein Beschleuniger erforderlich ist), ein InferencePool mit einem Endpunktauswahl pro Modell, ein simuliertes OpenAI-kompatibles Backend und ein einzelner AIGatewayRoute, der nach Modellname weiterleitet, bereitgestellt. In einem optionalen Abschnitt wird ein echtes offenes Gewichtungsmodell, das mit Ollama bereitgestellt wird, aus den zugehörigen Leitfäden zu offenen Gewichtungsmodellen in GDC mit Air Gap zur selben Route hinzugefügt.
Architektur
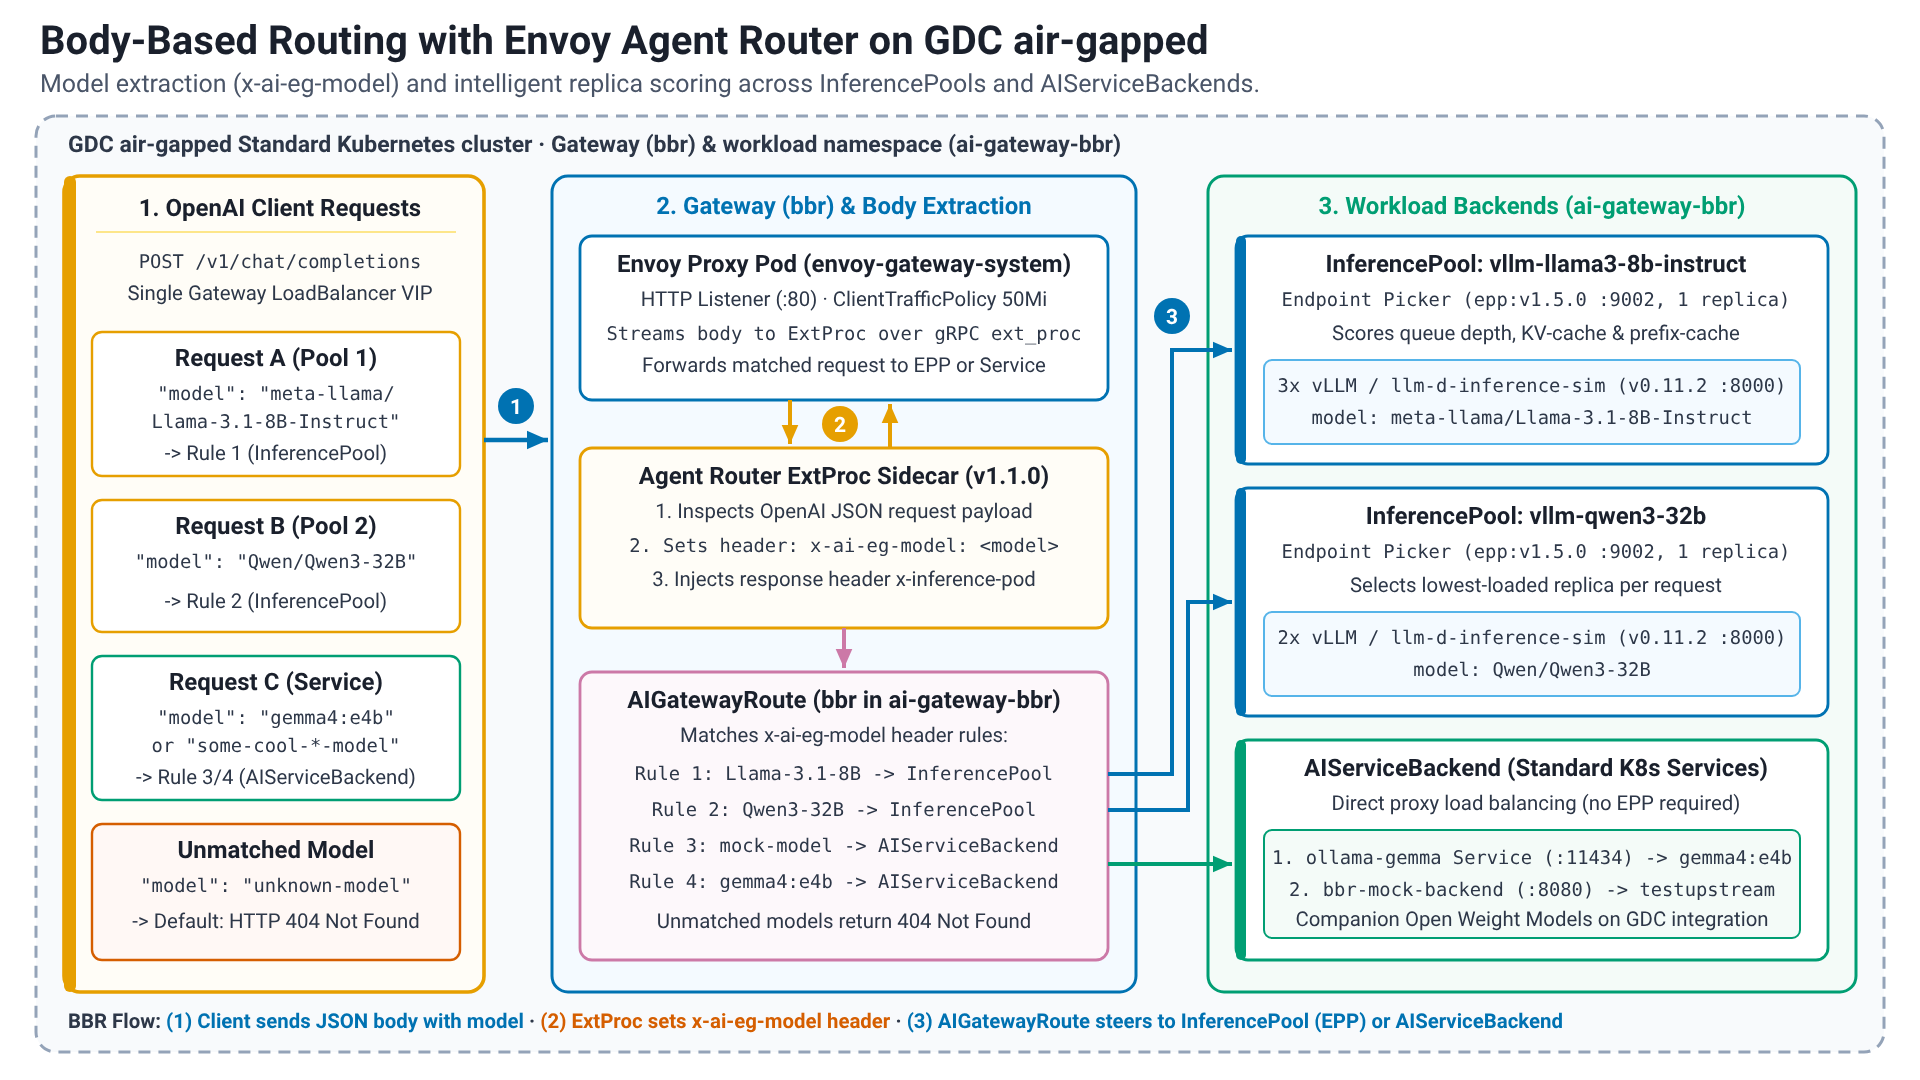
Ein Gateway der GatewayClass, die von der Referenzimplementierung erstellt wurde, stellt einen HTTP-Listener bereit. Der Envoy Agent Router fügt seinen externen Prozessor in den Envoy-Proxy Pod des Gateway ein. Der Prozessor parst jeden Anfragetext und legt den Routing-Header fest. Der AIGatewayRoute gleicht diesen Header ab und leitet die Anfrage entweder an einen InferencePool (eine Gruppe von Modellserver-Pods, die nach Label ausgewählt werden und denen ein Endpoint Picker Deployment vorgeschaltet ist, den der Proxy pro Anfrage konsultiert) oder an einen AIServiceBackend weiter, der auf einen Kubernetes-Service verweist. Alle Ressourcen in diesem Leitfaden befinden sich in einem Arbeitslast-Namespace. Die Proxy-Pods selbst werden im Envoy Gateway-Namespace ausgeführt.
Hinweis
Prüfen Sie, ob die Referenzimplementierung des Envoy-Agent-Routers über die Workstation bereitgestellt wurde und Sie Zugriff auf das Verzeichnis gdcag-solutions/ai-gateway/envoy haben.
Identity and Access Management
Prüfen Sie, ob die erforderlichen IAM-Konten, -Rollen und -Berechtigungen richtig konfiguriert sind.
GDC-Nutzerrollen für das Projekt:
- Standard-Clusteradministrator (
standard-cluster-admin)
GDC-Nutzerrolle für den Standardcluster:
StandardClusterRoleBindingfür diecluster-adminStandardClusterRole(erstellt von einem IAM-Projektadministrator, siehe Abschnitt Identity and Access Management der Referenzimplementierung)
Workstation
Führen Sie alle Befehle in dieser Anleitung auf einer Workstation mit den erforderlichen Tools und der erforderlichen Verbindung zur Umgebung und zum Internet aus, sofern in einem Schritt nichts anderes angegeben ist.
Erstellen Sie die Verzeichnisstruktur für das Nutzerhandbuch:
mkdir -p ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.dErstellen Sie die Konfigurationsdatei für die Nutzerhandbuch-Umgebung:
cat << 'EOF' > ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.d/bbr.sh && echo "Successfully created." || echo "Failed to create!"
# Workload
export GDCS_WORKLOAD_NAMESPACE="ai-gateway-bbr"
export GDCS_BBR_GATEWAY_NAME="bbr"

# Simulated model servers (llm-d inference simulator, no accelerator required)
export GDCS_INFERENCE_SIM_IMAGE_TAG="v0.11.2"
export GDCS_BBR_MODEL_1_NAME="meta-llama/Llama-3.1-8B-Instruct"
export GDCS_BBR_MODEL_1_POOL="vllm-llama3-8b-instruct"
export GDCS_BBR_MODEL_1_REPLICAS="3"
export GDCS_BBR_MODEL_2_NAME="Qwen/Qwen3-32B"
export GDCS_BBR_MODEL_2_POOL="vllm-qwen3-32b"
export GDCS_BBR_MODEL_2_REPLICAS="2"

# Endpoint Picker (Gateway API Inference Extension)
export GDCS_EPP_IMAGE_TAG="${GDCS_GATEWAY_API_INFERENCE_EXTENSION_VERSION}"
export GDCS_EPP_CHART_VERSION="${GDCS_GATEWAY_API_INFERENCE_EXTENSION_VERSION}"

# Mock OpenAI-compatible backend (traditional AIServiceBackend)
export GDCS_BBR_MOCK_MODEL_NAME="some-cool-self-hosted-model"
EOF
Erstellen Sie die Loader-Datei für die Nutzerhandbuch-Umgebung:
cat << 'EOF' > ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.sh && echo "Successfully created." || echo "Failed to create!"
source "${HOME}/gdcag-solutions/ai-gateway/envoy/env.sh"

export GDCS_USER_GUIDE_HOME="${HOME}/gdcag-solutions/ai-gateway/envoy/bbr"
echo "GDCS_USER_GUIDE_HOME=${GDCS_USER_GUIDE_HOME}"

# Sourced in dependency order
source "${GDCS_USER_GUIDE_HOME}/env.d/bbr.sh"

if [[ -f "${GDCS_USER_GUIDE_HOME}/env.d/ollama.sh" ]]; then
  source "${GDCS_USER_GUIDE_HOME}/env.d/ollama.sh"
fi
EOF
Bearbeiten und prüfen Sie die Umgebungsdatei mit Ihrem bevorzugten Editor:
${EDITOR:-vi} ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.d/bbr.shRufen Sie die Umgebungsdatei auf:
source ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.sh
Prüfen Sie, ob die Umgebungsvariablen festgelegt wurden:
echo "GDCS_USER_GUIDE_HOME=${GDCS_USER_GUIDE_HOME}"
echo "GDCS_HARBOR_PROJECT_URI=${GDCS_HARBOR_PROJECT_URI}"
Cluster
Clusteranmeldedaten abrufen:
gdcloud clusters get-credentials "${GDC_STANDARD_CLUSTER_NAME}" \
--project="${GDC_PROJECT}" \
--standard \
--zone="${GDC_ZONE}"
Prüfen Sie die Verbindung zum Cluster:
kubectl get nodes -L node.cluster.private.gdc.goog/machine-classPrüfen Sie, ob der
GatewayClassder Referenzimplementierung „Akzeptiert“ ist:kubectl get gatewayclass "${GDCS_GATEWAY_CLASS_NAME}"
Implementierung
Die Implementierung stellt die zusätzlichen Artefakte bereit, stellt die simulierten Modellserver mit ihren Inferenzpools und Endpoint Pickers bereit, fügt ein simuliertes Backend hinzu und erstellt schließlich die Gateway und die AIGatewayRoute.
Artefaktmigration
Definieren Sie die Liste der erforderlichen Container-Images für diesen Leitfaden:
declare -a GDCS_REGISTRY_IMAGES=(
  "ghcr.io/llm-d/llm-d-inference-sim:${GDCS_INFERENCE_SIM_IMAGE_TAG}"
  "registry.k8s.io/gateway-api-inference-extension/epp:${GDCS_EPP_IMAGE_TAG}"
)
export SERIALIZED_IMAGES=$(declare -p GDCS_REGISTRY_IMAGES)
Übertragen Sie die erforderlichen Container-Images per Seed an Artifact Registry:
${GDCS_IMPLEMENTATION_HOME}/seed_registry.shDefinieren Sie die Liste der erforderlichen Helm-Diagramme für diese Anleitung:
declare -a GDCS_REGISTRY_CHARTS=(
  "registry.k8s.io/gateway-api-inference-extension/charts/inferencepool:${GDCS_EPP_CHART_VERSION}"
)
export SERIALIZED_CHARTS=$(declare -p GDCS_REGISTRY_CHARTS)
Übertragen Sie die erforderlichen Helm-Diagramme in die Artifact Registry:
${GDCS_IMPLEMENTATION_HOME}/seed_charts.shPrüfen Sie, ob die Images und das Diagramm in Harbor verfügbar sind:
crane ls "${GDCS_HARBOR_PROJECT_URI}/llm-d/llm-d-inference-sim"
crane ls "${GDCS_HARBOR_PROJECT_URI}/gateway-api-inference-extension/epp"
helm show chart "${GDCS_HARBOR_CHART_OCI_URI}/gateway-api-inference-extension/charts/inferencepool" --version "${GDCS_EPP_CHART_VERSION}" | grep -E '^(name|version):'
Namespace
Erstellen Sie den Namespace:
kubectl create namespace "${GDCS_WORKLOAD_NAMESPACE}" \
--dry-run=client \
--output=yaml | kubectl apply -f -
Fügen Sie die
imagePullSecrethinzu:kubectl create secret docker-registry "${GDCS_HARBOR_K8S_PULL_SECRET}" \ --dry-run=client \ --from-file=.dockerconfigjson=${GDCS_HARBOR_K8S_DOCKER_CONFIG}/config.json \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ --output=yaml | kubectl apply -f -
Simulierte Modellserver
Jeder simulierte Modellserver ist ein Deployment des llm-d-Inferenzsimulators, der die OpenAI-kompatible API und Messwerte von vLLM auf Port 8000 bereitstellt und mit zufälligen Sätzen antwortet. Das Label app der Pods ist der Selektor der entsprechenden InferencePool.
Erstellen Sie das Manifest für den ersten simulierten Modellserver:
cat <<EOF > "${GDCS_USER_GUIDE_HOME}/${GDCS_BBR_MODEL_1_POOL}-sim.yaml" && echo "Successfully created." || echo "Failed to create!"
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ${GDCS_BBR_MODEL_1_POOL}
  labels:
    app: ${GDCS_BBR_MODEL_1_POOL}
    inference.networking.k8s.io/engine-type: vllm
spec:
  replicas: ${GDCS_BBR_MODEL_1_REPLICAS}
  selector:
    matchLabels:
      app: ${GDCS_BBR_MODEL_1_POOL}
  template:
    metadata:
      labels:
        app: ${GDCS_BBR_MODEL_1_POOL}
        inference.networking.k8s.io/engine-type: vllm
    spec:
      containers:
        - name: vllm-sim
          image: ${GDCS_HARBOR_PROJECT_URI}/llm-d/llm-d-inference-sim:${GDCS_INFERENCE_SIM_IMAGE_TAG}
          imagePullPolicy: IfNotPresent
          args:
            - --model
            - ${GDCS_BBR_MODEL_1_NAME}
            - --port
            - "8000"
            - --max-loras
            - "2"
            - --lora-modules
            - '{"name": "food-review-1"}'
          env:
            - name: POD_NAME
              valueFrom:
                fieldRef:
                  fieldPath: metadata.name
            - name: NAMESPACE
              valueFrom:
                fieldRef:
                  fieldPath: metadata.namespace
          ports:
            - containerPort: 8000
              name: http
              protocol: TCP
          readinessProbe:
            httpGet:
              path: /health
              port: 8000
            periodSeconds: 5
          resources:
            limits:
              memory: 256Mi
            requests:
              cpu: 50m
              memory: 64Mi
      imagePullSecrets:
        - name: ${GDCS_HARBOR_K8S_PULL_SECRET}
EOF
Wenden Sie das Manifest für den ersten simulierten Modellserver an:
kubectl apply \
--filename="${GDCS_USER_GUIDE_HOME}/${GDCS_BBR_MODEL_1_POOL}-sim.yaml" \
--namespace="${GDCS_WORKLOAD_NAMESPACE}"
Erstellen Sie das Manifest für den zweiten simulierten Modellserver:
cat <<EOF > "${GDCS_USER_GUIDE_HOME}/${GDCS_BBR_MODEL_2_POOL}-sim.yaml" && echo "Successfully created." || echo "Failed to create!"
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ${GDCS_BBR_MODEL_2_POOL}
  labels:
    app: ${GDCS_BBR_MODEL_2_POOL}
    inference.networking.k8s.io/engine-type: vllm
spec:
  replicas: ${GDCS_BBR_MODEL_2_REPLICAS}
  selector:
    matchLabels:
      app: ${GDCS_BBR_MODEL_2_POOL}
  template:
    metadata:
      labels:
        app: ${GDCS_BBR_MODEL_2_POOL}
        inference.networking.k8s.io/engine-type: vllm
    spec:
      containers:
        - name: vllm-sim
          image: ${GDCS_HARBOR_PROJECT_URI}/llm-d/llm-d-inference-sim:${GDCS_INFERENCE_SIM_IMAGE_TAG}
          imagePullPolicy: IfNotPresent
          args:
            - --model
            - ${GDCS_BBR_MODEL_2_NAME}
            - --port
            - "8000"
            - --max-loras
            - "2"
            - --lora-modules
            - '{"name": "food-review-1"}'
          env:
            - name: POD_NAME
              valueFrom:
                fieldRef:
                  fieldPath: metadata.name
            - name: NAMESPACE
              valueFrom:
                fieldRef:
                  fieldPath: metadata.namespace
          ports:
            - containerPort: 8000
              name: http
              protocol: TCP
          readinessProbe:
            httpGet:
              path: /health
              port: 8000
            periodSeconds: 5
          resources:
            limits:
              memory: 256Mi
            requests:
              cpu: 50m
              memory: 64Mi
      imagePullSecrets:
        - name: ${GDCS_HARBOR_K8S_PULL_SECRET}
EOF
Wenden Sie das Manifest für den zweiten simulierten Modellserver an:
kubectl apply \
--filename="${GDCS_USER_GUIDE_HOME}/${GDCS_BBR_MODEL_2_POOL}-sim.yaml" \
--namespace="${GDCS_WORKLOAD_NAMESPACE}"
Warten Sie, bis die simulierten Modellserver verfügbar sind:
watch --color --interval 5 --no-title \
"kubectl get deployments --selector='inference.networking.k8s.io/engine-type' \
--namespace=${GDCS_WORKLOAD_NAMESPACE} | GREP_COLORS='mt=01;92' egrep --color=always -e '^' -e '${GDCS_BBR_MODEL_1_REPLICAS}/${GDCS_BBR_MODEL_1_REPLICAS}' -e '${GDCS_BBR_MODEL_2_REPLICAS}/${GDCS_BBR_MODEL_2_REPLICAS}'"
Inferenzpools und Endpunktauswahl
Das Helm-Diagramm inferencepool der Gateway API Inference Extension erstellt pro Modell die InferencePool, die Endpunktauswahl Deployment und Service (gRPC-Port 9002), die Plug-in-Konfiguration (queue-scorer, kv-cache-utilization-scorer, prefix-cache-scorer) und die RBAC im Namespace, die die Auswahl benötigt, um Pods und InferencePools zu beobachten.
Erstellen Sie die freigegebene Helm-Wertedatei für die Endpunktauswahl. Das Diagramm hat keinen Secret-Wert für das Image-Pull, daher wird das Secret nach der Installation dem
Deploymenthinzugefügt:cat <<EOF > "${GDCS_USER_GUIDE_HOME}/epp-values.yaml" && echo "Successfully created." || echo "Failed to create!" inferenceExtension: image: pullPolicy: IfNotPresent registry: ${GDCS_HARBOR_PROJECT_URI} repository: gateway-api-inference-extension/epp tag: ${GDCS_EPP_IMAGE_TAG} replicas: 1 resources: limits: memory: 4Gi requests: cpu: 500m memory: 1Gi inferencePool: modelServerType: vllm targetPorts: - number: 8000 provider: name: none EOFInstallieren Sie die
InferencePoolund die Endpunktauswahl für das erste Modell:helm upgrade --install "${GDCS_BBR_MODEL_1_POOL}" "${GDCS_HARBOR_CHART_OCI_URI}/gateway-api-inference-extension/charts/inferencepool" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ --set "inferencePool.modelServers.matchLabels.app=${GDCS_BBR_MODEL_1_POOL}" \ --values="${GDCS_USER_GUIDE_HOME}/epp-values.yaml" \ --version="${GDCS_EPP_CHART_VERSION}"Installieren Sie den
InferencePoolund die Endpunktauswahl für das zweite Modell:helm upgrade --install "${GDCS_BBR_MODEL_2_POOL}" "${GDCS_HARBOR_CHART_OCI_URI}/gateway-api-inference-extension/charts/inferencepool" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ --set "inferencePool.modelServers.matchLabels.app=${GDCS_BBR_MODEL_2_POOL}" \ --values="${GDCS_USER_GUIDE_HOME}/epp-values.yaml" \ --version="${GDCS_EPP_CHART_VERSION}"Fügen Sie die
imagePullSecretdenDeployments der Endpunktauswahl hinzu. Der Patch startet einen neuen Roll-out mit dem Secret:for pool in "${GDCS_BBR_MODEL_1_POOL}" "${GDCS_BBR_MODEL_2_POOL}"; do kubectl patch deployment "${pool}-epp" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ --patch="{\"spec\":{\"template\":{\"spec\":{\"imagePullSecrets\":[{\"name\":\"${GDCS_HARBOR_K8S_PULL_SECRET}\"}]}}}}" doneWarten Sie, bis die Endpunktauswahl verfügbar ist:
watch --color --interval 5 --no-title \
"kubectl get deployments --selector='inference.networking.k8s.io/igw-mode=inferencepool' \
--namespace=${GDCS_WORKLOAD_NAMESPACE} | GREP_COLORS='mt=01;92' egrep --color=always -e '^' -e '1/1     1            1'"
Prüfen Sie, ob die
InferencePools vorhanden sind:kubectl get inferencepools \ --namespace="${GDCS_WORKLOAD_NAMESPACE}"Die Ausgabe sieht etwa so aus:
NAME                      AGE
vllm-llama3-8b-instruct   1m
vllm-qwen3-32b            1m
Erstellen Sie das Manifest für die
InferenceObjectives. Ein Ziel bindet eine Priorität an einenInferencePool. Die Endpunktauswahl bevorzugt höhere Prioritäten, wenn der Pool ausgelastet ist:cat <<EOF > "${GDCS_USER_GUIDE_HOME}/inferenceobjectives.yaml" && echo "Successfully created." || echo "Failed to create!" apiVersion: inference.networking.x-k8s.io/v1alpha2 kind: InferenceObjective metadata: name: ${GDCS_BBR_MODEL_1_POOL} spec: poolRef: name: ${GDCS_BBR_MODEL_1_POOL} priority: 10 --- apiVersion: inference.networking.x-k8s.io/v1alpha2 kind: InferenceObjective metadata: name: ${GDCS_BBR_MODEL_2_POOL} spec: poolRef: name: ${GDCS_BBR_MODEL_2_POOL} priority: 5 EOFWenden Sie das Manifest für die
InferenceObjective-Ressourcen an:kubectl apply \ --filename="${GDCS_USER_GUIDE_HOME}/inferenceobjectives.yaml" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}"
Mock-Backend
Erstellen Sie das Manifest für das simulierte OpenAI-kompatible Backend und den zugehörigen
AIServiceBackend. Er steht für jeden Modellserver, der als einfacher Kubernetes-Serviceanstelle einesInferencePooladressiert wird:cat <<EOF > "${GDCS_USER_GUIDE_HOME}/mock-backend.yaml" && echo "Successfully created." || echo "Failed to create!" apiVersion: aigateway.envoyproxy.io/v1beta1 kind: AIServiceBackend metadata: name: mock-backend spec: schema: name: OpenAI backendRef: name: mock-backend kind: Backend group: gateway.envoyproxy.io --- apiVersion: gateway.envoyproxy.io/v1alpha1 kind: Backend metadata: name: mock-backend spec: endpoints: - fqdn: hostname: mock-backend.${GDCS_WORKLOAD_NAMESPACE}.svc.cluster.local port: 80 --- apiVersion: apps/v1 kind: Deployment metadata: name: mock-backend spec: replicas: 1 selector: matchLabels: app: mock-backend template: metadata: labels: app: mock-backend spec: containers: - name: testupstream image: ${GDCS_HARBOR_PROJECT_URI}/envoyproxy/ai-gateway-testupstream:${GDCS_ENVOY_AGENT_ROUTER_VERSION} imagePullPolicy: IfNotPresent ports: - containerPort: 8080 env: - name: TESTUPSTREAM_ID value: test readinessProbe: httpGet: path: /health port: 8080 initialDelaySeconds: 1 periodSeconds: 1 imagePullSecrets: - name: ${GDCS_HARBOR_K8S_PULL_SECRET} --- apiVersion: v1 kind: Service metadata: name: mock-backend spec: selector: app: mock-backend ports: - protocol: TCP port: 80 targetPort: 8080 type: ClusterIP EOFWenden Sie das Manifest für das Mock-Backend an:
kubectl apply \
--filename="${GDCS_USER_GUIDE_HOME}/mock-backend.yaml" \
--namespace="${GDCS_WORKLOAD_NAMESPACE}"
Gateway und Route
Erstellen Sie das Manifest für den
Gatewayund den zugehörigenClientTrafficPolicy. Das Pufferlimit wird vom Standardwert von 32 KiB erhöht, da der externe Prozessor den Anfragetext puffert:cat <<EOF > "${GDCS_USER_GUIDE_HOME}/gateway.yaml" && echo "Successfully created." || echo "Failed to create!" apiVersion: gateway.networking.k8s.io/v1 kind: Gateway metadata: name: ${GDCS_BBR_GATEWAY_NAME} spec: gatewayClassName: ${GDCS_GATEWAY_CLASS_NAME} listeners: - name: http protocol: HTTP port: 80 --- apiVersion: gateway.envoyproxy.io/v1alpha1 kind: ClientTrafficPolicy metadata: name: ${GDCS_BBR_GATEWAY_NAME}-buffer-limit spec: targetRefs: - group: gateway.networking.k8s.io kind: Gateway name: ${GDCS_BBR_GATEWAY_NAME} connection: bufferLimit: 50Mi EOFWenden Sie das Manifest für
Gatewayan:kubectl apply \ --filename="${GDCS_USER_GUIDE_HOME}/gateway.yaml" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}"Erstellen Sie das Manifest für den
AIGatewayRoute. Jede Regel entspricht demx-ai-eg-model-Header, den der externe Prozessor aus dem Feldmodeldes Anfragetexts ableitet:cat <<EOF > "${GDCS_USER_GUIDE_HOME}/aigatewayroute.yaml" && echo "Successfully created." || echo "Failed to create!" apiVersion: aigateway.envoyproxy.io/v1beta1 kind: AIGatewayRoute metadata: name: ${GDCS_BBR_GATEWAY_NAME} spec: parentRefs: - name: ${GDCS_BBR_GATEWAY_NAME} kind: Gateway group: gateway.networking.k8s.io rules: - matches: - headers: - type: Exact name: x-ai-eg-model value: ${GDCS_BBR_MODEL_1_NAME} backendRefs: - group: inference.networking.k8s.io kind: InferencePool name: ${GDCS_BBR_MODEL_1_POOL} - matches: - headers: - type: Exact name: x-ai-eg-model value: ${GDCS_BBR_MODEL_2_NAME} backendRefs: - group: inference.networking.k8s.io kind: InferencePool name: ${GDCS_BBR_MODEL_2_POOL} - matches: - headers: - type: Exact name: x-ai-eg-model value: ${GDCS_BBR_MOCK_MODEL_NAME} backendRefs: - name: mock-backend EOFWenden Sie das Manifest für
AIGatewayRoutean:kubectl apply \ --filename="${GDCS_USER_GUIDE_HOME}/aigatewayroute.yaml" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}"Warten Sie, bis die
Gatewayprogrammiert ist:watch --color --interval 5 --no-title \ "kubectl get gateway/${GDCS_BBR_GATEWAY_NAME} \ --namespace=${GDCS_WORKLOAD_NAMESPACE} | GREP_COLORS='mt=01;92' egrep --color=always -e '^' -e 'True'"Prüfen Sie, ob der
AIGatewayRouteakzeptiert wurde:kubectl get aigatewayroute/${GDCS_BBR_GATEWAY_NAME} \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ --output=jsonpath='{range .status.conditions[*]}{.type}={.status} {.message}{"\n"}{end}'Die Ausgabe sieht etwa so aus:
Accepted=True AI Gateway Route is accepted
Validierung
Starten Sie die Portweiterleitung an den Envoy-
ServicedesGateway:export ENVOY_SERVICE=$(kubectl get service --namespace="${GDCS_ENVOY_GATEWAY_NAMESPACE}" --selector="gateway.envoyproxy.io/owning-gateway-namespace=${GDCS_WORKLOAD_NAMESPACE},gateway.envoyproxy.io/owning-gateway-name=${GDCS_BBR_GATEWAY_NAME}" --output=jsonpath='{.items[0].metadata.name}') echo "ENVOY_SERVICE=${ENVOY_SERVICE}" kubectl port-forward "service/${ENVOY_SERVICE}" \ --namespace="${GDCS_ENVOY_GATEWAY_NAMESPACE}" 8888:80 & PF_PID=$! sleep 2Senden Sie eine Anfrage für das erste Modell. In den Antwortheadern wird der von der Endpunktauswahl ausgewählte
Podangezeigt:curl http://127.0.0.1:8888/v1/chat/completions \ --data '{"model": "'${GDCS_BBR_MODEL_1_NAME}'", "messages": [{"role": "user", "content": "Say this is a test."}]}' \ --dump-header - \ --header "Content-Type: application/json" \ --no-progress-meter \ --show-error | grep -E -i '^(HTTP|x-inference-pod|x-inference-port)|"model"|"content"'Die Ausgabe sieht etwa so aus:
HTTP/1.1 200 OK
x-inference-port: 8000
x-inference-pod: vllm-llama3-8b-instruct-...
  "model": "meta-llama/Llama-3.1-8B-Instruct",
        "content": "..."
Senden Sie eine Anfrage für das zweite Modell:
curl http://127.0.0.1:8888/v1/chat/completions \
--data '{"model": "'${GDCS_BBR_MODEL_2_NAME}'", "messages": [{"role": "user", "content": "Say this is a test."}]}' \
--dump-header - \
--header "Content-Type: application/json" \
--no-progress-meter \
--show-error | grep -E -i '^(HTTP|x-inference-pod|x-inference-port)|"model"|"content"'
Die Ausgabe sieht etwa so aus:
HTTP/1.1 200 OK
x-inference-port: 8000
x-inference-pod: vllm-qwen3-32b-...
  "model": "Qwen/Qwen3-32B",
        "content": "..."
Senden Sie eine Anfrage für das Modell, das vom simulierten Backend bereitgestellt wird:
curl http://127.0.0.1:8888/v1/chat/completions \
--data '{"model": "'${GDCS_BBR_MOCK_MODEL_NAME}'", "messages": [{"role": "user", "content": "Say this is a test."}]}' \
--dump-header - \
--header "Content-Type: application/json" \
--no-progress-meter \
--show-error | grep -E -i '^(HTTP|testupstream-id|x-model)|"content"'
Die Ausgabe sieht etwa so aus:
HTTP/1.1 200 OK
testupstream-id: test
x-model: some-cool-self-hosted-model
        "content": "..."
Senden Sie eine Anfrage für ein Modell, das von keiner Regel bedient wird. Das Gateway lehnt sie ab, anstatt sie weiterzuleiten:
curl http://127.0.0.1:8888/v1/chat/completions \
--data '{"model": "unknown-model", "messages": [{"role": "user", "content": "Say this is a test."}]}' \
--header "Content-Type: application/json" \
--no-progress-meter \
--show-error \
--write-out '\nHTTP %{http_code}\n'
Die Ausgabe sieht etwa so aus:
...
HTTP 404
Senden Sie mehrere Anfragen für das erste Modell und prüfen Sie, ob die Endpunktauswahl sie auf die Replikate des Pools verteilt:
for i in $(seq 1 6); do
  curl http://127.0.0.1:8888/v1/chat/completions \
  --data '{"model": "'${GDCS_BBR_MODEL_1_NAME}'", "messages": [{"role": "user", "content": "Request '${i}'"}]}' \
  --dump-header - \
  --header "Content-Type: application/json" \
  --no-progress-meter \
  --output /dev/null \
  --show-error | grep -i '^x-inference-pod'
done | sort | uniq -c
Beenden Sie die Portweiterleitung:
kill -9 ${PF_PID}
An ein Open-Weights-Modell weiterleiten
In diesem optionalen Abschnitt wird der Route ein echtes Modell hinzugefügt: das Gemma 4 E4B-Modell, das mit Ollama bereitgestellt wird, wie im begleitenden Leitfaden Gemma 4 E4B mit Ollama auf GDC mit Air Gap – Nutzerhandbuch beschrieben. Ollama stellt eine OpenAI-kompatible API bereit, sodass es als AIServiceBackend angehängt wird, dessen Backend auf die clusterinterne Service des Ollama-Deployment verweist. Alle anderen OpenAI-kompatiblen Modellserver, z. B. die vLLM-Deployment der begleitenden Leitfäden, können auf dieselbe Weise angehängt werden.
Erstellen Sie die Ollama-Backend-Konfigurationsdatei. Der Name und der Namespace von
Servicestammen aus dem Ollama-Nutzerhandbuch:cat << 'EOF' > ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.d/ollama.sh && echo "Successfully created." || echo "Failed to create!" # Open weight model backend (Ollama user guide) export GDCS_BBR_OLLAMA_MODEL_NAME="BBR_OLLAMA_MODEL_NAME" export GDCS_BBR_OLLAMA_SERVICE_NAME="BBR_OLLAMA_SERVICE_NAME" export GDCS_BBR_OLLAMA_SERVICE_NAMESPACE="BBR_OLLAMA_SERVICE_NAMESPACE" export GDCS_BBR_OLLAMA_SERVICE_PORT="80" EOFErsetzen Sie Folgendes:
BBR_OLLAMA_MODEL_NAME: der Ollama-Modellname (GDCS_OLLAMA_MODEL im Ollama-Nutzerhandbuch).BBR_OLLAMA_SERVICE_NAME: der Name des Ollama-Dienstes (GDCS_OLLAMA_MODEL_KUBERNETES im Ollama-Nutzerhandbuch).BBR_OLLAMA_SERVICE_NAMESPACE: der Ollama-Namespace (GDCS_WORKLOAD_NAMESPACE des Ollama-Nutzerhandbuchs).
Rufen Sie die Umgebungsdatei auf:
source ${HOME}/gdcag-solutions/ai-gateway/envoy/bbr/env.shPrüfen Sie, ob der Ollama-
Serviceinnerhalb des Clusters über den Namen erreichbar ist:kubectl get service "${GDCS_BBR_OLLAMA_SERVICE_NAME}" \ --namespace="${GDCS_BBR_OLLAMA_SERVICE_NAMESPACE}"Erstellen Sie das Manifest für den Ollama-
AIServiceBackend:cat <<EOF > "${GDCS_USER_GUIDE_HOME}/ollama-backend.yaml" && echo "Successfully created." || echo "Failed to create!" apiVersion: aigateway.envoyproxy.io/v1beta1 kind: AIServiceBackend metadata: name: ollama-backend spec: schema: name: OpenAI backendRef: name: ollama-backend kind: Backend group: gateway.envoyproxy.io --- apiVersion: gateway.envoyproxy.io/v1alpha1 kind: Backend metadata: name: ollama-backend spec: endpoints: - fqdn: hostname: ${GDCS_BBR_OLLAMA_SERVICE_NAME}.${GDCS_BBR_OLLAMA_SERVICE_NAMESPACE}.svc.cluster.local port: ${GDCS_BBR_OLLAMA_SERVICE_PORT} EOFWenden Sie das Manifest für den Ollama-
AIServiceBackendan:kubectl apply \ --filename="${GDCS_USER_GUIDE_HOME}/ollama-backend.yaml" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}"Fügen Sie der
AIGatewayRouteeine Regel für das Ollama-Modell hinzu und wenden Sie sie an:cat <<EOF >> "${GDCS_USER_GUIDE_HOME}/aigatewayroute.yaml" && echo "Successfully added." || echo "Failed to add!" - matches: - headers: - type: Exact name: x-ai-eg-model value: ${GDCS_BBR_OLLAMA_MODEL_NAME} backendRefs: - name: ollama-backend EOF kubectl apply \ --filename="${GDCS_USER_GUIDE_HOME}/aigatewayroute.yaml" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}"Senden Sie eine Anfrage für das Ollama-Modell über das Gateway. Es dauert einige Sekunden, bis die Routenänderung aus dem vorherigen Schritt den Proxy erreicht. Daher wird die Anfrage bei vorübergehenden Fehlern wiederholt. Auf CPU-Clustern antwortet das Modell langsam, daher sind fünf Minuten zulässig:
export ENVOY_SERVICE=$(kubectl get service --namespace="${GDCS_ENVOY_GATEWAY_NAMESPACE}" --selector="gateway.envoyproxy.io/owning-gateway-namespace=${GDCS_WORKLOAD_NAMESPACE},gateway.envoyproxy.io/owning-gateway-name=${GDCS_BBR_GATEWAY_NAME}" --output=jsonpath='{.items[0].metadata.name}')

kubectl port-forward "service/${ENVOY_SERVICE}" \
--namespace="${GDCS_ENVOY_GATEWAY_NAMESPACE}" 8888:80 &
PF_PID=$!

sleep 2

curl http://127.0.0.1:8888/v1/chat/completions \
--data '{"model": "'${GDCS_BBR_OLLAMA_MODEL_NAME}'", "messages": [{"role": "user", "content": "Explain Google Distributed Cloud air-gapped in one sentence."}], "max_tokens": 256}' \
--fail-with-body \
--header "Content-Type: application/json" \
--max-time 300 \
--no-progress-meter \
--output "${GDCS_USER_GUIDE_HOME}/ollama-response.json" \
--retry 5 \
--retry-all-errors \
--retry-delay 5 \
--show-error \
--write-out 'HTTP %{http_code} in %{time_total}s\n'

jq '{model, system_fingerprint, finish_reason: .choices[0].finish_reason, content: .choices[0].message.content, reasoning: ((.choices[0].message.reasoning // "") | .[0:160])}' "${GDCS_USER_GUIDE_HOME}/ollama-response.json"

kill -9 ${PF_PID}
Die Ausgabe sieht etwa so aus:
HTTP 200 in 41.2s
{
  "model": "gemma4:e4b",
  "system_fingerprint": "fp_ollama",
  "finish_reason": "length",
  "content": "",
  "reasoning": "Here's a thinking process to construct the one-sentence explanation: ..."
}
Vorgänge
Day-Two-Aufgaben für die Route und ihre Back-Ends.
Gateway außerhalb des Clusters freigeben
- Der Envoy-
ServiceeinesGatewayhat standardmäßig den TypLoadBalancerund erhält eine externe IP-Adresse vom GDC-Load-Balancer (kubectl get service "${ENVOY_SERVICE}" --namespace="${GDCS_ENVOY_GATEWAY_NAMESPACE}"). Traffic von außerhalb des Projekts erfordert zusätzlich eineProjectNetworkPolicy(networking.gdc.goog/v1), die im Projekt-Namespace von einem Project NetworkPolicy-Administrator erstellt wird. Weitere Informationen finden Sie unter Projektnetzwerkrichtlinien konfigurieren.
Modell skalieren
- Skalieren Sie den Modellserver
Deployment(kubectl scale deployment/${GDCS_BBR_MODEL_1_POOL} --replicas=<n> --namespace="${GDCS_WORKLOAD_NAMESPACE}"). DerInferencePoolwählt die neuenPods automatisch aus und der Endpoint Picker beginnt mit der Bewertung, sobald sie bereit sind.
Planungsprioritäten ändern
- Bearbeiten Sie die
priorityeinerInferenceObjectiveund wenden Sie dieinferenceobjectives.yamlnoch einmal an. Die Endpunktauswahl entfernt zuerst niedrigere Prioritäten, wenn der Pool gesättigt ist.
Endpunktauswahl ansehen
- Der Picker stellt Prometheus-Messwerte auf Port 9090 seines
Service(kubectl port-forward service/${GDCS_BBR_MODEL_1_POOL}-epp 9090:9090 --namespace="${GDCS_WORKLOAD_NAMESPACE}", danncurl http://127.0.0.1:9090/metrics) bereit und seine Planungsentscheidungen werden mit der Ausführlichkeit--v=4(inferenceExtension.flags.v: 4inepp-values.yaml) protokolliert.
Endpunktauswahl aktualisieren
- Fügen Sie das neue
epp-Image und dasinferencepool-Diagramm hinzu, aktualisieren SieGDCS_GATEWAY_API_INFERENCE_EXTENSION_VERSIONin der Umgebungsdatei der Referenzimplementierung, führen Sie dieselbenhelm upgrade --install-Befehle aus und wenden Sie denimagePullSecret-Patch noch einmal an.
Fehlerbehebung
| Symptom | Wahrscheinliche Ursache | Aktion |
|---|---|---|
Endpunktauswahl Pod in ImagePullBackOff |
Der Patch imagePullSecret wurde nicht angewendet oder das Image epp wurde nicht bereitgestellt. |
Führen Sie den Patch-Schritt noch einmal aus: crane ls "${GDCS_HARBOR_PROJECT_URI}/gateway-api-inference-extension/epp". |
AIGatewayRoute zeigt Accepted=False mit einer Nachricht über InferencePool an |
InferencePool ist im Namespace nicht vorhanden oder Envoy Gateway kann inferencepools nicht lesen. |
kubectl get inferencepools --namespace="${GDCS_WORKLOAD_NAMESPACE}"; prüfen Sie die ClusterRoleBinding envoy-gateway-inferencepool-reader aus der Referenzimplementierung. |
Anfragen für ein Poolmodell geben 503 zurück. |
Keine bereite Pod entspricht der Poolauswahl oder die Auswahl ist nicht bereit |
kubectl get pods --selector=app=${GDCS_BBR_MODEL_1_POOL} --namespace="${GDCS_WORKLOAD_NAMESPACE}"; kubectl logs deployment/${GDCS_BBR_MODEL_1_POOL}-epp --namespace="${GDCS_WORKLOAD_NAMESPACE}". |
Anfragen geben 404 für ein Modell mit einer Regel zurück |
Der model-Wert im Text unterscheidet sich von der Regel (x-ai-eg-model ist genau passend, Groß-/Kleinschreibung beachten) |
Vergleichen Sie den Anfragetext mit dem value der Regel; kubectl get aigatewayroute ${GDCS_BBR_GATEWAY_NAME} --namespace="${GDCS_WORKLOAD_NAMESPACE}" --output=yaml. |
Anfrage mit einem großen Prompt wird mit 413 abgelehnt |
Pufferlimit für den Anfragetext zu klein | Erhöhe connection.bufferLimit in ClientTrafficPolicy. |
| Zeitüberschreitung bei Ollama-Anfrage | Das Modell wird auf der CPU geladen oder generiert. Der NetworkPolicy des Ollama-Namespace lässt den Proxy nicht zu. |
Versuchen Sie es mit einem längeren --max-time noch einmal. Prüfen Sie, ob der Ollama-NetworkPolicy eingehenden Traffic auf Port 11434 aus dem Envoy Gateway-Namespace zulässt. |
Bereinigen
Entfernen Sie die Route, das Gateway und die Backends:
kubectl delete \
--filename="${GDCS_USER_GUIDE_HOME}/aigatewayroute.yaml" \
--filename="${GDCS_USER_GUIDE_HOME}/gateway.yaml" \
--filename="${GDCS_USER_GUIDE_HOME}/mock-backend.yaml" \
--filename="${GDCS_USER_GUIDE_HOME}/inferenceobjectives.yaml" \
--ignore-not-found \
--namespace="${GDCS_WORKLOAD_NAMESPACE}"

kubectl delete \
--filename="${GDCS_USER_GUIDE_HOME}/ollama-backend.yaml" \
--ignore-not-found \
--namespace="${GDCS_WORKLOAD_NAMESPACE}" 2>/dev/null || true
Deinstallieren Sie die Endpoint Picker und entfernen Sie die simulierten Modellserver:
helm uninstall "${GDCS_BBR_MODEL_1_POOL}" --namespace="${GDCS_WORKLOAD_NAMESPACE}"
helm uninstall "${GDCS_BBR_MODEL_2_POOL}" --namespace="${GDCS_WORKLOAD_NAMESPACE}"

kubectl delete \
--filename="${GDCS_USER_GUIDE_HOME}/${GDCS_BBR_MODEL_1_POOL}-sim.yaml" \
--filename="${GDCS_USER_GUIDE_HOME}/${GDCS_BBR_MODEL_2_POOL}-sim.yaml" \
--ignore-not-found \
--namespace="${GDCS_WORKLOAD_NAMESPACE}"
Löschen Sie den Namespace:
kubectl delete namespace "${GDCS_WORKLOAD_NAMESPACE}"
Zusätzliche Materialien
- InferencePool-Unterstützung | Envoy-Agent-Router
- Anleitung zu AIGatewayRoute und InferencePool | Envoy Agent Router
- Gateway API Inference Extension
- llm-d-Inferenzsimulator
- Projektbezogene Netzwerkrichtlinien konfigurieren | Google Distributed Cloud mit Air Gap
- Referenzarchitektur für AI Gateway
- Referenzimplementierung für Envoy-Agent-Router