


Puoi utilizzare un glossario per definire la terminologia specifica del tuo dominio. Con un glossario, puoi aggiungere coppie di termini, tra cui un termine nella lingua di origine e uno nella lingua di destinazione. Le coppie di termini garantiscono che il servizio Vertex AI Translation traduca la tua terminologia in modo coerente.
Di seguito sono riportati alcuni esempi di casi in cui puoi definire le voci del glossario:
- Nomi dei prodotti: identifica i nomi dei prodotti per mantenerli nella traduzione. Ad esempio, Google Home deve essere tradotto come Google Home.
- Parole ambigue: specifica il significato di parole vaghe e omonimi. Ad esempio, pesca può indicare un'attività o un frutto.
- Prestiti linguistici: chiarisci il significato delle parole adottate da un'altra lingua. Ad esempio, bouillabaisse in francese rimane bouillabaisse in italiano, un piatto a base di stufato di pesce.
I termini di un glossario possono essere singole parole (chiamate anche token) o brevi frasi, in genere di meno di cinque parole. Vertex AI Translation ignora le voci del glossario corrispondenti se le parole sono parole d'arresto.
Vertex AI Translation offre i seguenti metodi di glossario disponibili in Google Distributed Cloud (GDC) con air gap:
| Metodo | Descrizione |
|---|---|
CreateGlossary |
Crea un glossario. |
GetGlossary |
Restituisce un glossario archiviato. |
ListGlossaries |
Restituisce un elenco di glossari in un progetto. |
DeleteGlossary |
Elimina un glossario che non ti serve più. |
Prima di iniziare
Prima di creare un glossario per definire la terminologia per la traduzione, devi avere un progetto denominato translation-glossary-project. La risorsa personalizzata del progetto deve essere simile all'esempio seguente:
  apiVersion: resourcemanager.gdc.goog/v1
  kind: Project
  metadata:
    labels:
      atat.config.google.com/clin-number: CLIN_NUMBER
      atat.config.google.com/task-order-number: TASK_ORDER_NUMBER
    name: translation-glossary-project
    namespace: platform
Per ottenere le autorizzazioni necessarie per utilizzare un glossario, chiedi all'amministratore del progetto IAM di concederti i seguenti ruoli nello spazio dei nomi del progetto:
- AI Translation Developer: ottieni il ruolo AI Translation Developer (
ai-translation-developer) per accedere al servizio Vertex AI Translation. - Project Bucket Admin: ottieni il ruolo Project Bucket Admin (
project-bucket-admin) per gestire i bucket di archiviazione e gli oggetti al loro interno, in modo da poter creare e caricare file.
Per saperne di più sui prerequisiti, consulta Configura un progetto di traduzione.
Crea un file di glossario
Devi creare un file di glossario per archiviare i termini della lingua di origine e della lingua di destinazione. Questa sezione contiene i due diversi layout del glossario che puoi utilizzare per definire i termini.
La tabella seguente descrive i limiti supportati su Distributed Cloud per i file di glossario:
| Descrizione | Limite |
|---|---|
| Massima dimensione del file | 10,4 milioni (10.485.760) di byte UTF-8 |
| Lunghezza massima di un termine del glossario | 1024 byte UTF-8 |
| Numero massimo di risorse di glossario per un progetto | 10.000 |
Scegli uno dei seguenti layout per il file del glossario:
- Glossario unidirezionale: specifica la traduzione prevista per una coppia di termini di origine e di destinazione in una lingua specifica. I glossari unidirezionali supportano i formati file TSV, CSV e TMX.
- Glossario di insiemi di termini equivalenti: specifica la traduzione prevista in più lingue in ogni riga. I glossari degli insiemi di termini equivalenti supportano i formati file CSV.
Glossario unidirezionale
L'API Vertex AI Translation accetta valori delimitati da tabulazioni (TSV) e valori separati da virgole (CSV). Ogni riga contiene una coppia di termini separati da una tabulazione (\t) o da una virgola (,) per questi formati file.
L'API Vertex AI Translation accetta anche il formato Translation Memory eXchange (TMX), un formato XML standard per fornire le coppie di termini di origine e di destinazione della traduzione. I file di input supportati sono in un formato basato su TMX versione 1.4.
Gli esempi seguenti mostrano la struttura richiesta per i formati file TSV, CSV e TMX dei glossari unidirezionali:
TSV e CSV
La seguente immagine mostra due colonne in un file TSV o CSV. La prima colonna contiene il termine nella lingua di origine e la seconda colonna contiene il termine nella lingua di destinazione.
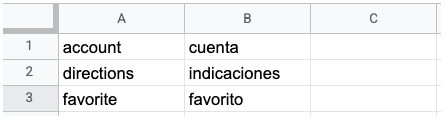
Non includere una riga di intestazione in un file TSV o CSV unidirezionale; la prima riga deve contenere i dati dei termini. La richiesta di glossario rende il file disponibile per l'API Vertex AI Translation.
TMX
L'esempio seguente illustra la struttura richiesta in un file TMX:
<?xml version='1.0' encoding='utf-8'?>
<!DOCTYPE tmx SYSTEM "tmx14.dtd">
<tmx version="1.4">
  <header segtype="sentence" o-tmf="UTF-8" adminlang="en" srclang="en" datatype="PlainText"/>
  <body>
    <tu>
      <tuv xml:lang="en">
        <seg>account</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>cuenta</seg>
      </tuv>
    </tu>
    <tu>
      <tuv xml:lang="en">
        <seg>directions</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>indicaciones</seg>
      </tuv>
    </tu>
  </body>
</tmx>
Se il file contiene tag XML non mostrati in questo esempio, l'API Vertex AI Translation li ignora.
Includi i seguenti elementi nel file TMX per assicurarti che l'API Vertex AI Translation lo elabori correttamente:
<header>: identifica la lingua di origine utilizzando l'attributosrclang.<tu>: includi una coppia di elementi<tuv>con la stessa lingua di origine e di destinazione. Questi elementi<tuv>sono conformi a quanto segue:- Ogni elemento
<tuv>identifica la lingua del testo contenuto utilizzando l'attributoxml:lang. Utilizza i codici ISO-639-1 per identificare le lingue di origine e di destinazione. Consulta l'elenco delle lingue supportate e i relativi codici lingua. - Se un elemento
<tu>contiene più di due elementi<tuv>, l'API Vertex AI Translation elabora solo il primo elemento<tuv>che corrisponde alla lingua di origine e il primo elemento<tuv>che corrisponde alla lingua di destinazione. Il servizio ignora il resto degli elementi<tuv>. - Se un elemento
<tu>non ha una coppia corrispondente di elementi<tuv>, l'API Vertex AI Translation ignora l'elemento<tu>non valido.
- Ogni elemento
<seg>: rappresentano stringhe di testo generalizzate. L'API Vertex AI Translation esclude i tag di markup da un elemento<seg>prima di elaborare il file. Se un elemento<tuv>contiene più elementi<seg>, l'API Vertex AI Translation concatena il testo in un unico elemento separando le stringhe di testo con uno spazio.
Dopo aver identificato i termini del glossario nel glossario unidirezionale, carica il file in un bucket di archiviazione e rendilo disponibile per l'API Vertex AI Translation creando e importando un glossario.
Glossario di insiemi di termini equivalenti
L'API Vertex AI Translation accetta file di glossario per insiemi di termini equivalenti utilizzando il formato CSV. Per definire insiemi di termini equivalenti, crea un file CSV a più colonne in cui ogni riga contiene un singolo termine del glossario in più lingue. Consulta l'elenco delle lingue supportate e i relativi codici lingua.
L'immagine seguente mostra un esempio di file CSV a più colonne. Ogni riga rappresenta un termine del glossario e ogni colonna rappresenta una traduzione del termine in lingue diverse.
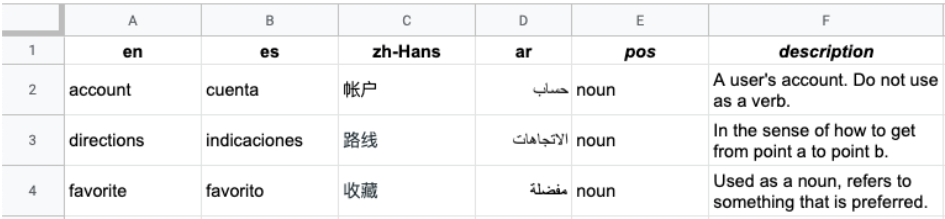
L'intestazione è la prima riga del file, che identifica la lingua di ogni colonna. La riga di intestazione utilizza i codici lingua standard ISO-639-1 o BCP-47. L'API Vertex AI Translation non utilizza le informazioni sulla parte del discorso (pos) e i valori di posizione specifici non vengono convalidati.
Ogni riga successiva contiene i termini del glossario equivalenti nelle lingue identificate nell'intestazione. Puoi lasciare vuote le colonne corrispondenti se il termine non è disponibile in tutte le lingue.
Dopo aver identificato i termini del glossario nell'insieme di termini equivalenti, carica il file in un bucket di archiviazione e rendilo disponibile per l'API Vertex AI Translation creando e importando un glossario.
Carica il file del glossario in un bucket di archiviazione
Segui questi passaggi per caricare il file del glossario in un bucket di archiviazione:
- Configura la CLI gdcloud per l'archiviazione di oggetti.
Crea un bucket di archiviazione nello spazio dei nomi del progetto. Utilizza una classe di archiviazione
Standard.Puoi creare il bucket di archiviazione eseguendo il deployment di una risorsa
Bucketnello spazio dei nomi del progetto:apiVersion: object.gdc.goog/v1 kind: Bucket metadata: name: glossary-bucket namespace: translation-glossary-project spec: description: bucket for translation glossary storageClass: Standard bucketPolicy: lockingPolicy: defaultObjectRetentionDays: 90Concedi le autorizzazioni
readsul bucket e le autorizzazioniget,listewatchsusecretsnello spazio dei nomi del progetto ai service account (ai-translation-system-saeg-vai-translation-sie-sa) utilizzati dal servizio Vertex AI Translation.Segui questi passaggi per creare il ruolo e l'associazione dei ruoli utilizzando risorse personalizzate sul server API di gestione. Un utente che dispone già delle autorizzazioni
secretsdeve applicare queste risorse, altrimenti la richiesta non va a buon fine conattempting to grant RBAC permissions not currently held:Crea il ruolo eseguendo il deployment di una risorsa
Rolenello spazio dei nomi del progetto:apiVersion: rbac.authorization.k8s.io/v1 kind: Role metadata: name: ai-translation-glossary-reader namespace: translation-glossary-project rules: - apiGroups: - object.gdc.goog resources: - buckets verbs: - read-object - apiGroups: - "" resources: - secrets verbs: - get - list - watchCrea l'associazione dei ruoli eseguendo il deployment di una risorsa
RoleBindingnello spazio dei nomi del progetto:apiVersion: rbac.authorization.k8s.io/v1 kind: RoleBinding metadata: name: ai-translation-glossary-reader-rolebinding namespace: translation-glossary-project roleRef: apiGroup: rbac.authorization.k8s.io kind: Role name: ai-translation-glossary-reader subjects: - kind: ServiceAccount name: ai-translation-system-sa namespace: g-vai-translation-sie - kind: ServiceAccount name: g-vai-translation-sie-sa namespace: g-vai-translation-sie
Carica il file del glossario nel bucket di archiviazione che hai creato. Per saperne di più, consulta Carica e scarica oggetti di archiviazione nei progetti.
Crea un glossario
Il metodo CreateGlossary crea un glossario e restituisce l'identificatore all'operazione a lunga esecuzione che genera il glossario.
Per creare un glossario, sostituisci quanto segue prima di utilizzare i dati della richiesta:
ENDPOINT: l'endpoint Vertex AI Translation che utilizzi per la tua organizzazione. Per saperne di più, visualizza lo stato del servizio e gli endpoint.PROJECT_ID: il tuo ID progetto.BUCKET_NAME: il nome del bucket di archiviazione in cui si trova il file del glossario.GLOSSARY_FILENAME: il nome del file del glossario nel bucket di archiviazione.
Di seguito è riportata la sintassi di una richiesta HTTP per creare un glossario:
POST https://ENDPOINT/v3/projects/PROJECT_ID/glossaries
In base al file del glossario che hai creato, scegli una delle seguenti opzioni per creare un glossario:
Unidirezionale
Per creare un glossario unidirezionale, specifica una coppia di lingue (language_pair) con una lingua di origine (source_language_code) e una lingua di destinazione (target_language_code).
Per creare un glossario unidirezionale:
Salva il seguente corpo della richiesta in un file JSON denominato
request.json:{ "language_pair": { "source_language_code": "SOURCE_LANGUAGE", "target_language_code": "TARGET_LANGUAGE" }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }Sostituisci quanto segue:
SOURCE_LANGUAGE: il codice lingua della lingua di origine del glossario. Consulta l'elenco delle lingue supportate e i relativi codici lingua.TARGET_LANGUAGE: il codice lingua della lingua di destinazione del glossario. Consulta l'elenco delle lingue supportate e i relativi codici lingua.
Effettua la richiesta. Gli esempi seguenti utilizzano un metodo API REST e la riga di comando, ma puoi anche utilizzare le librerie client per creare un glossario unidirezionale.
curl
curl -X POST \
-H "Authorization: Bearer TOKEN" \
-H "Content-Type: application/json; charset=utf-8" \
-d @request.json \
"https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
Sostituisci TOKEN con
il token di autenticazione
che hai ottenuto.
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }
Invoke-WebRequest
  -Method POST
  -Headers $headers
  -ContentType: "application/json; charset=utf-8"
  -InFile request.json
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
Sostituisci TOKEN con
il token di autenticazione
che hai ottenuto.
Python
Installa l'ultima versione della libreria client di Vertex AI Translation.
Imposta le variabili di ambiente richieste in uno script Python.
Aggiungi il seguente codice allo script Python che hai creato:
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    source_lang_code="SOURCE_LANGUAGE", target_lang_code="TARGET_LANGUAGE"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_pair": {"source_language_code": source_lang_code,
                              "target_language_code": target_lang_code},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
Sostituisci quanto segue:
SOURCE_LANGUAGE: il codice lingua della lingua di origine del glossario. Consulta l'elenco delle lingue supportate e i relativi codici lingua.TARGET_LANGUAGE: il codice lingua della lingua di destinazione del glossario. Consulta l'elenco delle lingue supportate e i relativi codici lingua.CERT_NAME: il nome del file del certificato dell'autorità di certificazione (CA), ad esempioorg-1-trust-bundle-ca.cert. Per ulteriori informazioni, consulta Genera il file del certificato CA del bundle di attendibilità in un ambiente di sviluppo.
Salva lo script Python.
Esegui lo script Python:
python SCRIPT_NAMESostituisci
SCRIPT_NAMEcon il nome che hai assegnato allo script Python, ad esempioglossary.py.
Per saperne di più sul metodo projects.glossaries.create, consulta il Riferimento API REST di Vertex AI Translation.
Dovresti ricevere una risposta JSON simile alla seguente:
{
"name": "projects/PROJECT_ID/operations/OPERATION_ID",
"metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
Nella risposta:
OPERATION_ID: l'ID assegnato dal server dell'operazione a lunga esecuzione che crea il glossario. Il servizio restituisce questo ID nel camponamedella risposta oppure puoi trovarlo chiamandoprojects.operations.list. Puoi passareprojects/PROJECT_ID/operations/OPERATION_IDaprojects.operations.getper controllare lo stato dell'operazione di creazione del glossario.GLOSSARY_ID: l'ID del glossario assegnato dal server (Gseguito da cifre), che utilizzi nelle richieste di recupero, traduzione ed eliminazione.
Insieme di termini equivalenti
Per creare un glossario di insiemi di termini equivalenti, specifica un insieme di lingue (language_codes_set) con i codici lingua (language_codes) del glossario.
Per creare un glossario di insiemi di termini equivalenti:
Salva il seguente corpo della richiesta in un file JSON denominato
request.json:{ "language_codes_set": { "language_codes": ["LANGUAGE_CODE_1", "LANGUAGE_CODE_2", "LANGUAGE_CODE_3" ] }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }Sostituire
LANGUAGE_CODE_1,LANGUAGE_CODE_2eLANGUAGE_CODE_3con i codici delle lingue del glossario. Consulta l'elenco delle lingue supportate e i relativi codici lingua.Effettua la richiesta:
curl
curl -X POST \
    -H "Authorization: Bearer TOKEN" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d @request.json \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
Sostituisci TOKEN con
il token di autenticazione
che hai ottenuto.
Dovresti ricevere una risposta JSON simile alla seguente:
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
Nella risposta:
OPERATION_ID: l'ID assegnato dal server dell'operazione a lunga esecuzione che crea il glossario. Il servizio restituisce questo ID nel camponamedella risposta oppure puoi trovarlo chiamandoprojects.operations.list. Puoi passareprojects/PROJECT_ID/operations/OPERATION_IDaprojects.operations.getper controllare lo stato dell'operazione di creazione del glossario.GLOSSARY_ID: l'ID del glossario assegnato dal server (Gseguito da cifre), che utilizzi nelle richieste di recupero, traduzione ed eliminazione.
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
  -Method POST `
  -Headers $headers `
  -ContentType: "application/json; charset=utf-8" `
  -InFile request.json `
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
Sostituisci TOKEN con
il token di autenticazione
che hai ottenuto.
Dovresti ricevere una risposta JSON simile alla seguente:
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
Nella risposta:
OPERATION_ID: l'ID assegnato dal server dell'operazione a lunga esecuzione che crea il glossario. Il servizio restituisce questo ID nel camponamedella risposta oppure puoi trovarlo chiamandoprojects.operations.list. Puoi passareprojects/PROJECT_ID/operations/OPERATION_IDaprojects.operations.getper controllare lo stato dell'operazione di creazione del glossario.GLOSSARY_ID: l'ID del glossario assegnato dal server (Gseguito da cifre), che utilizzi nelle richieste di recupero, traduzione ed eliminazione.
Python
Installa l'ultima versione della libreria client di Vertex AI Translation.
Imposta le variabili di ambiente richieste in uno script Python.
Aggiungi il seguente codice allo script Python che hai creato:
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    lang_1="LANGUAGE_CODE_1", lang_2="LANGUAGE_CODE_2"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_codes_set": {"language_codes": [lang_1, lang_2]},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
Sostituisci quanto segue:
LANGUAGE_CODE_1eLANGUAGE_CODE_2: i codici delle lingue nel glossario. Consulta l'elenco delle lingue supportate e i relativi codici lingua.CERT_NAME: il nome del file del certificato dell'autorità di certificazione (CA), ad esempioorg-1-trust-bundle-ca.cert. Per ulteriori informazioni, consulta Genera il file del certificato CA del bundle di attendibilità in un ambiente di sviluppo.
Salva lo script Python.
Esegui lo script Python:
python SCRIPT_NAMESostituisci
SCRIPT_NAMEcon il nome che hai assegnato allo script Python, ad esempioglossary.py.
Per saperne di più sul metodo projects.glossaries.create, consulta il Riferimento API REST di Vertex AI Translation.
A seconda delle dimensioni del file del glossario, la creazione di un glossario richiede in genere meno di 10 minuti. Puoi recuperare lo stato di questa operazione per sapere quando è terminata.
Recupera un glossario
Il metodo GetGlossary restituisce un glossario archiviato. Se il glossario non esiste, l'output restituisce il valore NOT_FOUND. Per chiamare il metodo GetGlossary, specifica l'ID progetto e l'ID glossario. Entrambi i metodi CreateGlossary e ListGlossaries restituiscono l'ID del glossario. L'API Vertex AI Translation accetta solo richieste HTTPS.
Ad esempio, le seguenti richieste restituiscono informazioni su un glossario specifico nel tuo progetto:
curl
curl -X GET \
   -H "Authorization: Bearer TOKEN" \
   "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
Sostituisci TOKEN con
il token di autenticazione
che hai ottenuto.
Python
from google.cloud import translate_v3 as translate
from google.api_core.client_options import ClientOptions

def get_glossary(creds, name="projects/PROJECT_ID/glossaries/GLOSSARY_ID"):
    """Get a glossary by its full name. The service assigns the glossary ID."""
    client = translate.TranslationServiceClient(
        credentials=creds, client_options=ClientOptions(api_endpoint="ENDPOINT:443"))
    response = client.get_glossary(name=name)
    print(f"Glossary name: {response.name}")
Passa le credenziali di Distributed Cloud (creds) configurate con il pubblico https://ENDPOINT:443, come mostrato in Traduci testo.
Per saperne di più sul metodo get_glossary, consulta la libreria client Python.
Recupera un elenco dei glossari
Il metodo ListGlossaries restituisce un elenco di risorse Glossary in un progetto, ciascuna contenente il name completo (projects/PROJECT_ID/glossaries/GLOSSARY_ID). Se il progetto non contiene glossari, l'output restituisce {}. Se il progetto non esiste, l'output restituisce il valore NOT_FOUND. Per chiamare il metodo ListGlossaries, specifica l'ID progetto e l'endpoint Vertex AI Translation.
L'API Vertex AI Translation accetta solo richieste HTTPS.
Ad esempio, la seguente richiesta restituisce i glossari nel tuo progetto:
curl -X GET \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries?page_size=10"
Sostituisci TOKEN con
il token di autenticazione
che hai ottenuto.
Elimina un glossario
Il metodo DeleteGlossary elimina un glossario. Se il glossario non esiste, l'output restituisce il valore NOT_FOUND. Per chiamare il metodo DeleteGlossary, specifica l'ID progetto, l'ID glossario e l'endpoint Vertex AI Translation.
Entrambi i metodi CreateGlossary e ListGlossaries restituiscono l'ID del glossario. L'API Vertex AI Translation accetta solo richieste HTTPS.
Ad esempio, la seguente richiesta elimina un glossario dal tuo progetto:
curl -X DELETE \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
Sostituisci TOKEN con
il token di autenticazione
che hai ottenuto.