


במסמך הזה מתוארת ארכיטקטורת הפניה לחברות ביטוח בריאות שרוצות להפוך לאוטומטיות את תהליכי הטיפול בבקשות לאישור מראש (PA) ולשפר את תהליכי הבדיקה שלהן לניצול (UR) באמצעות Google Cloud. הוא מיועד למפתחי תוכנה ולאדמינים של תוכניות בארגונים האלה. הארכיטקטורה הזו עוזרת לספקי תוכניות בריאות לצמצם את העלויות האדמיניסטרטיביות, לשפר את היעילות ולשפר את תהליך קבלת ההחלטות באמצעות אוטומציה של הכנסת נתונים ושל חילוץ תובנות מטפסים קליניים. היא גם מאפשרת להם להשתמש במודלים של AI כדי ליצור הנחיות והמלצות.
ארכיטקטורה
בתרשים הבא מתוארת ארכיטקטורה וגישה לאוטומציה של תהליך הטמעת הנתונים ולאופטימיזציה של תהליך הבדיקה של ניהול השימוש (UM). הגישה הזו מבוססת על שירותי נתונים ו-AI ב- Google Cloud.
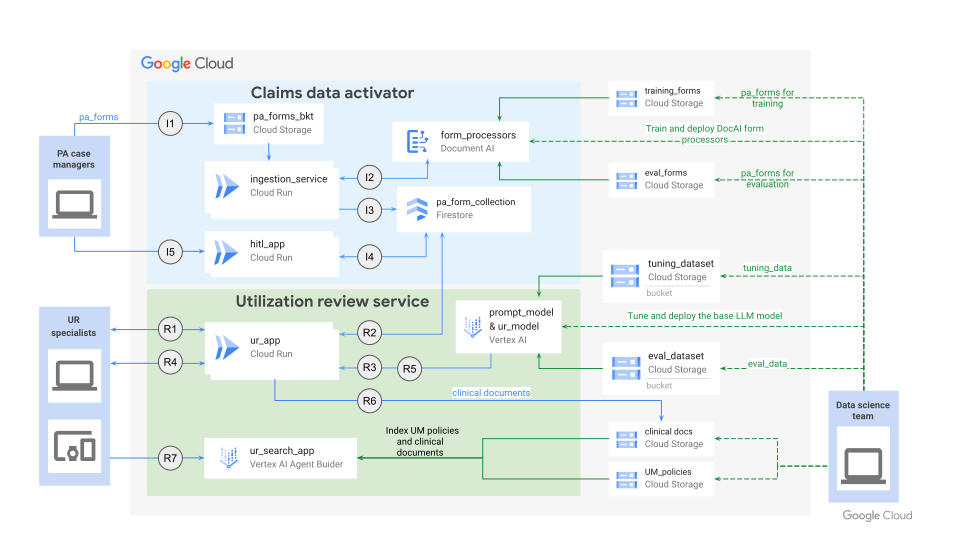
הארכיטקטורה שלמעלה מכילה שני זרמי נתונים, שנתמכים על ידי מערכות המשנה הבאות:
- הפעלת נתונים של תלונות (CDA), שחולצת נתונים ממקורות לא מובְנים, כמו טפסים ומסמכים, ומזינה אותם למסד נתונים בפורמט מובְנה שקריא למכונה. ב-CDA מיושם תהליך של הטמעת נתונים כדי להטמיע טפסים של בקשות לגישה לנתונים.
- שירות לבדיקת ניצול (UR), שמשלב נתונים של בקשות PA, מסמכי מדיניות והנחיות אחרות לטיפול כדי ליצור המלצות. שירות ה-UR מיישם את זרימת הנתונים כדי לבדוק בקשות ל-PA באמצעות AI גנרטיבי.
בקטעים הבאים מתוארים זרימות הנתונים האלה.
זרימת הנתונים ב-CDA
בתרשים הבא מוצגת זרימת הנתונים בתהליך של שימוש ב-CDA כדי להזין טפסים של בקשות לגישה למידע אישי.
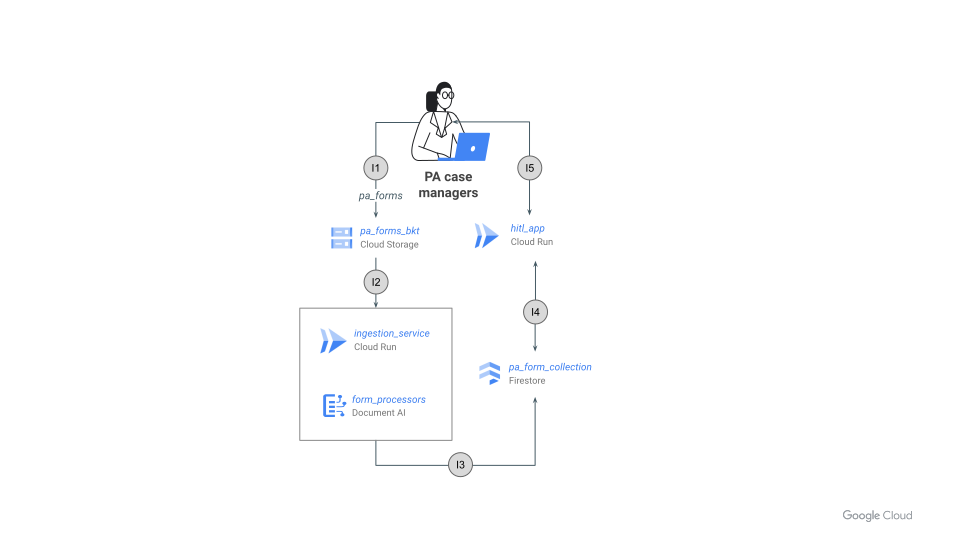
כפי שמוצג בתרשים הקודם, מנהל הטיפול בבקשות PA מתקשר עם רכיבי המערכת כדי להזין, לאמת ולעבד את בקשות ה-PA. מנהלי המקרים של PA הם אנשים מצוות התפעול העסקי שאחראים על קבלת בקשות PA. רצף האירועים הוא כזה:
- מנהלי הטיפול בבקשות לאישור מראש מקבלים את טופסי הבקשה לאישור מראש (
pa_forms) מספק שירותים רפואיים ומעלים אותם לקטגוריה של Cloud Storage (pa_forms_bkt). - שירות
ingestion_serviceמאזין לשינויים בדליpa_forms_bkt. שירותingestion_serviceאוסף טפסיםpa_formsממאגרpa_forms_bkt. השירות מזהה את מעבדי Document AI שהוגדרו מראש, שנקראיםform_processors. מעבדי הנתונים האלה מוגדרים לעיבוד הטפסיםpa_forms.ingestion_serviceהשירות מחלץ מידע מהטפסים באמצעות המעבדים.form_processorsהנתונים שחולצו מהטפסים הם בפורמט JSON. - שירות
ingestion_serviceכותב את המידע שחולץ עם ציוני מהימנות ברמת השדה לאוסף מסד הנתונים של Firestore, שנקראpa_form_collection. - אפליקציית
hitl_appשולפת את המידע (JSON) עם ציוני מהימנות ממסד הנתונים שלpa_form_collection. האפליקציה מחשבת את ציון המהימנות ברמת המסמך מתוך ציוני המהימנות ברמת השדה, שזמינים בפלט של מודלים ללמידת מכונה (ML) שלform_processors. - אפליקציית
hitl_appמציגה את המידע שחולץ עם ציוני רמת סמך ברמת השדה והמסמך למנהלי ניהול בקשות התמיכה של PA, כדי שהם יוכלו לבדוק ולתקן את המידע אם הערכים שחולצו לא מדויקים. מנהלי תיקים של PA יכולים לעדכן את הערכים השגויים ולשמור את המסמך במסד הנתוניםpa_form_collection.
זרימת הנתונים בשירות UR
התרשים הבא מציג את זרימת הנתונים בשירות UR.
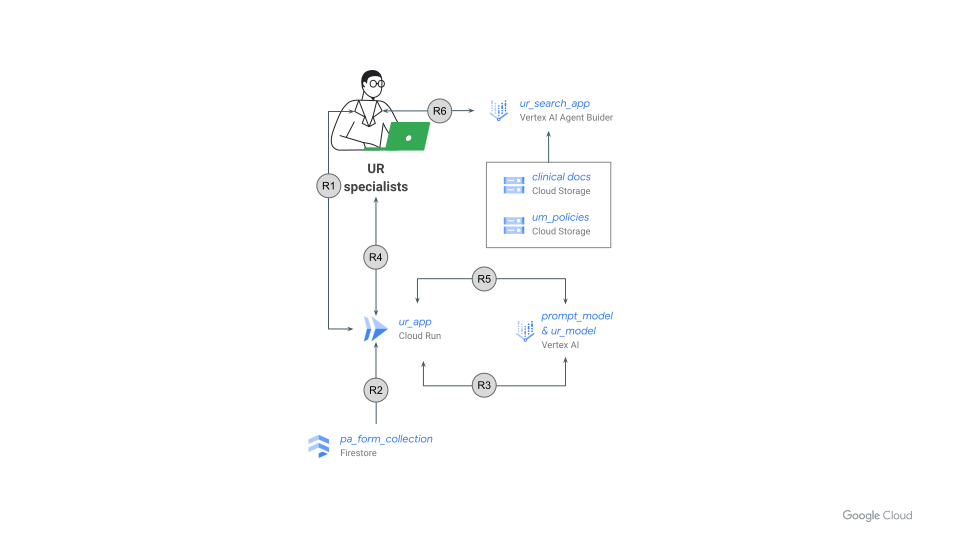
כפי שמוצג בתרשים הקודם, מומחי ה-UR מקיימים אינטראקציה עם רכיבי המערכת כדי לבצע בדיקה קלינית של בקשות ה-PA. מומחי ה-UR הם בדרך כלל אחיות או רופאים עם ניסיון בתחום קליני ספציפי, שעובדים בחברות לביטוח בריאות. הטיפול בבקשות לגישה למידע אישי וההפניה שלהן לא נכללים בתהליך העבודה שמתואר בקטע הזה.
רצף האירועים הוא כזה:
- אפליקציית
ur_appמציגה למומחי UR רשימה של בקשות PA וסטטוס הבדיקה שלהן. הסטטוס שמוצג הואin_queue,in_progressאוcompleted. - הרשימה נוצרת על ידי אחזור הנתונים של
pa_form informationממסד הנתוניםpa_form_collection. מומחה ה-UR פותח בקשה בלחיצה על פריט מהרשימה שמוצגת באפליקצייתur_app. אפליקציית
ur_appשולחת את נתוניpa_form informationלמודלprompt_model. הוא משתמש ב-Gemini API של Agent Platform כדי ליצור פרומפט שדומה להנחיה הבאה:Review a PA request for {medication|device|medical service} for our member, {Patient Name}, who is {age} old, {gender} with {medical condition}. The patient is on {current medication|treatment list}, has {symptoms}, and has been diagnosed with {diagnosis}.ההנחיה שנוצרה מוצגת באפליקציית
ur_appלמומחי UR לבדיקה ולמשוב. מומחי UR יכולים לעדכן את ההנחיה בממשק המשתמש ולשלוח אותה לאפליקציה.אפליקציית
ur_appשולחת את ההנחיה למודלur_modelעם בקשה ליצירת המלצה. המודל יוצר תשובה וחוזר לאפליקציה. האפליקציה מציגה את התוצאה המומלצת למומחים של UR.מומחי ה-UR יכולים להשתמש באפליקציה
ur_search_appכדי לחפש אתclinical documents,care guidelinesו-plan policy documents. האפליקציותclinical documents,care guidelinesוגםplan policy documentsעוברות אינדוקס מראש וזמינות לאפליקצייתur_search_app.
רכיבים
הארכיטקטורה כוללת את הרכיבים הבאים:
קטגוריות של Cloud Storage. שירותי האפליקציות של UM דורשים את הקטגוריות הבאות של Cloud Storage בפרויקט Google Cloud :
-
pa_forms_bkt: קטגוריה להעלאת טפסים של הרשאות גישה שצריכים אישור. -
training_forms: קטגוריה לאחסון טפסים היסטוריים של PA לצורך אימון מעבדי הטפסים של DocAI. -
eval_forms: קטגוריה לאחסון טפסים של PA לצורך הערכת הדיוק של מעבדי הטפסים של DocAI. -
tuning_dataset: מאגר (bucket) להחזקת הנתונים שנדרשים לכוונון מודל השפה הגדול (LLM). -
eval_dataset: קטגוריה לאחסון הנתונים שנדרשים להערכת ה-LLM. -
clinical_docs: מאגר לאחסון המסמכים הקליניים שהספקים שולחים כקבצים מצורפים לטופסי אישור מראש או לאחר מכן לתמיכה בבקשה לאישור מראש. המסמכים האלה מאונדקסים על ידי אפליקציית החיפוש בשירות חיפוש מבוסס סוכנים. -
um_policies: קטגוריה להכללת מסמכים בנושא הצורך הרפואי והנחיות לטיפול, מסמכי מדיניות של תוכניות ביטוח בריאות והנחיות לכיסוי. המסמכים האלה נוספים לאינדקס על ידי אפליקציית החיפוש בשירות חיפוש מבוסס סוכנים.
-
form_processors: המעבדים האלה אומנו לחילוץ מידע מטפסים שלpa_forms.
pa_form_collection: מאגר נתונים של Firestore לאחסון המידע שחולץ כמסמכי JSON באוסף מסד הנתונים של NoSQL.
ingestion_service: מיקרו-שירות שקורא את המסמכים מהקטגוריה, מעביר אותם לנקודות הקצה של DocAI לצורך ניתוח, ומאחסן את הנתונים שחולצו באוסף של מסד נתונים ב-Firestore.
hitl_app: מיקרו-שירות (אפליקציית אינטרנט) שמביא ומציג ערכי נתונים שחולצו מ-pa_forms. בנוסף, הוא מציג את ציון רמת הסמך שדווח על ידי מעבדי הטפסים (מודלים של ML) למנהל התיק של PA, כדי שהוא יוכל לבדוק, לתקן ולשמור את המידע במאגר הנתונים.
ur_app: מיקרו-שירות (אפליקציית אינטרנט) שמומחי UR יכולים להשתמש בו כדי לבדוק את בקשות ה-PA באמצעות AI גנרטיבי. הוא משתמש במודל שנקראprompt_modelכדי ליצור הנחיה. המיקרו-שירות מעביר את הנתונים שחולצו מטפסים שלpa_formsלמודלprompt_modelכדי ליצור הנחיה. ההנחיה שנוצרה מועברת למודלur_modelכדי לקבל המלצה לגבי פנייה.מודלים גדולים של שפה (LLM) שעברו התאמה רפואית ב-Agent Platform: ב-Agent Platform יש מגוון של מודלים בסיסיים של AI גנרטיבי שאפשר להתאים כדי להפחית את העלות ואת זמן האחזור. המודלים שבהם נעשה שימוש בארכיטקטורה הזו הם:
-
prompt_model: מתאם ב-LLM שמכוונן ליצירת הנחיות על סמך הנתונים שחולצו מ-pa_forms. -
ur_model: מתאם ב-LLM שמכוון ליצירת טיוטת המלצה על סמך הפרומפט שהוזן.
-
ur_search_app: אפליקציית חיפוש שמבוססת על Agent Search ומיועדת למומחי UR כדי למצוא מידע רלוונטי ומותאם אישית במסמכים קליניים, במדיניות UM ובקווים מנחים לגבי כיסוי.
המוצרים שהשתמשו בהם
הארכיטקטורה הזו כוללת את המוצרים הבאים: Google Cloud
- Gemini Enterprise Agent Platform: פלטפורמה מקיפה שמאפשרת לכם ליצור, לנהל, לבצע אופטימיזציה ולהתאים לעומס (scale) סוכני AI ברמה שמתאימה לארגונים.
- Agent Search: פלטפורמה שמאפשרת ליצור ולפרוס סוכנים ויישומים מבוססי-AI ברמה ארגונית.
- Document AI: פלטפורמה לעיבוד מסמכים שמקבלת נתונים לא מובְנים ממסמכים והופכת אותם לנתונים מובְנים.
- Firestore: מסד נתונים מסוג NoSQL לאחסון מסמכים שמיועד להתאמה לעומס (automatic scaling), לביצועים גבוהים ולפיתוח אפליקציות בקלות.
- Cloud Run: פלטפורמת מחשוב ללא שרת שמאפשרת להריץ קונטיינרים ישירות על גבי התשתית הניתנת להרחבה של Google.
- Cloud Storage: מאגר אובייקטים ללא הגבלה בעלות נמוכה, לשימוש עם סוגים שונים של נתונים. אפשר לגשת לנתונים מתוך Google Cloudומחוץ לה, והם משוכפלים במיקומים שונים כדי ליצור יתירות.
- Cloud Logging: מערכת לניהול יומנים בזמן אמת עם אחסון, חיפוש, ניתוח והתראות.
- Cloud Monitoring: שירות שמאפשר לראות את הביצועים, הזמינות והתקינות של האפליקציות והתשתית שלכם.
תרחיש שימוש
UM הוא תהליך שמשמש חברות ביטוח בריאות בעיקר בארצות הברית, אבל תהליכים דומים (עם כמה שינויים) משמשים בשוק ביטוחי הבריאות ברחבי העולם. המטרה של UM היא להבטיח שהמטופלים יקבלו את הטיפול המתאים במסגרת הנכונה, בזמן האופטימלי ובעלות הנמוכה ביותר האפשרית. בנוסף, UM עוזרת להבטיח שהטיפול הרפואי יהיה יעיל, אפקטיבי ותואם לסטנדרטים של טיפול מבוסס-ראיות. PA הוא כלי לניהול שימוש שנדרש בו אישור מחברת הביטוח לפני שהמטופל מקבל טיפול רפואי.
תהליך ניהול השימוש (UM) שחברות רבות משתמשות בו הוא מחסום לקבלת טיפול בזמן. התהליך הזה יקר, גוזל זמן ודורש יותר מדי עבודה אדמיניסטרטיבית. היא גם מסובכת, ידנית ואיטית. התהליך הזה משפיע באופן משמעותי על היכולת של תוכנית הבריאות לנהל ביעילות את איכות הטיפול ולשפר את חוויית הספק והחברים. עם זאת, אם החברות האלה ישנו את תהליך ה-UM שלהן, הן יוכלו לעזור להבטיח שהמטופלים יקבלו טיפול איכותי וחסכוני. אופטימיזציה של תהליך ה-UR מאפשרת לתוכניות ביטוח בריאות להפחית את העלויות ואת דחיות הבקשות באמצעות עיבוד מהיר של בקשות PA, וכך לשפר את החוויה של המטופלים והספקים. הגישה הזו עוזרת להפחית את העומס האדמיניסטרטיבי על ספקי שירותי הבריאות.
כשתוכניות ביטוח בריאות מקבלות בקשות לאישור מראש, מנהלי הטיפול בבקשות לאישור מראש יוצרים בקשות במערכת לניהול בקשות כדי לעקוב אחרי הבקשות, לנהל אותן ולטפל בהן. חלק ניכר מהבקשות האלה מתקבלות בפקס ובדואר, עם מסמכים קליניים מצורפים. עם זאת, חברות הביטוח הרפואי לא יכולות לגשת בקלות למידע שבטפסים ובמסמכים האלה כדי לבצע ניתוח נתונים ולקבל תובנות עסקיות. התהליך הנוכחי של הזנת מידע ידנית מהמסמכים האלה למערכות לניהול פניות הוא לא יעיל, הוא גוזל זמן והוא עלול להוביל לשגיאות.
אוטומציה של תהליך קליטת הנתונים מאפשרת לתוכניות ביטוח בריאות להפחית את העלויות, את השגיאות בהזנת הנתונים ואת העומס האדמיניסטרטיבי על הצוות. חילוץ מידע חשוב מטפסים וממסמכים קליניים מאפשר לחברות ביטוח בריאות לזרז את תהליך אישור השימוש.
שיקולים בתכנון
בקטע הזה מוסבר איך להשתמש בארכיטקטורת ההפניה הזו כדי לפתח ארכיטקטורה אחת או יותר שיעזרו לכם לעמוד בדרישות הספציפיות שלכם בנוגע לאבטחה, לאמינות, ליעילות תפעולית, לעלות ולביצועים.
אבטחה, פרטיות ותאימות
בקטע הזה מפורטים הגורמים שכדאי לקחת בחשבון כשמשתמשים בארכיטקטורת ההפניה הזו כדי לתכנן ולבנות ארכיטקטורה ב-Google Cloud שעוזרת לעמוד בדרישות האבטחה, הפרטיות והתאימות.
בארצות הברית, חוק היבילות ואחריות הדיווח של ביטוח בריאות (HIPAA, כולל התיקונים, לרבות Health Information Technology for Economic and Clinical Health Act – חוק HITECH) מחייב עמידה בדרישות של כלל האבטחה, כלל הפרטיות וכלל הודעת הפרצה של HIPAA. Google Cloud תומך בתאימות ל-HIPAA, אבל בסופו של דבר, אתם אחראים להערכת התאימות שלכם ל-HIPAA. האחריות לעמידה בדרישות HIPAA היא אחריות משותפת לכם ול-Google. אם הארגון שלכם כפוף ל-HIPAA ואתם רוצים להשתמש במוצרים כלשהם Google Cloudשל Google בקשר למידע רפואי מוגן (PHI), אתם צריכים לעיין בהסכם השותף העסקי (BAA) של Google ולאשר אותו. המוצרים של Google שמכוסים בהסכם BAA עומדים בדרישות של HIPAA ותואמים לאישורי ISO/IEC 27001, 27017 ו-27018 ולדוח SOC 2 שלנו.
לא כל מודלי ה-LLM שמתארחים ב-Model Garden תומכים ב-HIPAA. הערכה ושימוש במודלים גדולים של שפה (LLM) שתומכים ב-HIPAA.
כדי להעריך איך מוצרי Google יכולים לעזור לכם לעמוד בדרישות התאימות ל-HIPAA, תוכלו לעיין בדוחות הביקורת של צד שלישי במרכז המשאבים בנושא תאימות.
מומלץ ללקוחות לשקול את הנקודות הבאות כשבוחרים תרחישי שימוש ב-AI, ולתכנן את השימוש בהתאם:
- פרטיות נתונים: פלטפורמת Google Cloud Agent Platform ו-Document AI לא משתמשות בנתוני לקוחות, בשימוש בחבילת הגלישה, בתוכן או במסמכים כדי לשפר או לאמן את מודלי הבסיס. אתם יכולים לשפר את המודלים הבסיסיים באמצעות הנתונים והמסמכים שלכם בתוך הדייר המאובטח שלכם ב- Google Cloud.
- ספריות לקוח של שרת Firestore משתמשות בניהול זהויות והרשאות גישה (IAM) כדי לנהל את הגישה למסד הנתונים. מידע על האבטחה והפרטיות ב-Firebase זמין במאמר פרטיות ואבטחה ב-Firebase.
- כדי לעזור לכם לאחסן מידע אישי רגיש, אפשר להצפין תמונות של שירותים
ingestion_service,hitl_appו-ur_appבאמצעות מפתחות הצפנה בניהול הלקוח (CMEK) או לשלב אותן עם Secret Manager. - Agent Platform מיישמת Google Cloud אמצעי בקרה לאבטחה כדי לעזור לכם לאבטח את המודלים ואת נתוני האימון. חלק מאמצעי האבטחה לא נתמכים בתכונות ה-AI הגנרטיבי ב-Agent Platform. מידע נוסף זמין במאמרים בנושא אמצעי אבטחה לשירותי למידת מכונה ואמצעי אבטחה ל-AI גנרטיבי.
- מומלץ להשתמש ב-IAM כדי להטמיע את העקרונות של הרשאות מינימליות והפרדת תפקידים במשאבי ענן. אפשר להשתמש באמצעי הבקרה הזה כדי להגביל את הגישה ברמת הפרויקט, התיקייה או מערך הנתונים.
- ב-Cloud Storage הנתונים מאוחסנים באופן אוטומטי במצב מוצפן. מידע נוסף על שיטות נוספות להצפנת נתונים זמין במאמר אפשרויות להצפנת נתונים.
המוצרים של Google פועלים בהתאם לעקרונות של AI אחראי.
עקרונות והמלצות אבטחה שספציפיים לעומסי עבודה של AI ו-ML מפורטים במאמר AI and ML perspective: Security ב-Well-Architected Framework.
אמינות
בקטע הזה מתוארים גורמים עיצוביים שכדאי לקחת בחשבון כשבונים תשתית אמינה להפוך את תהליך הטיפול בבקשות PA לאוטומטי.
Document AI form_processors הוא שירות אזורי. הנתונים מאוחסנים באופן סינכרוני בכמה אזורים בתוך אזור מסוים. תעבורת הנתונים מאוזנת אוטומטית בין האזורים. אם מתרחש הפסקת חשמל באזור, הנתונים לא אובדים1. אם מתרחש הפסקת שירות באזור מסוים, השירות לא זמין עד ש-Google פותרת את הבעיה.
אפשר ליצור קטגוריות של Cloud Storage באחד משלושת המיקומים הבאים: אזורי, אזורי כפול או רב-אזורי, באמצעות קטגוריות pa_forms_bkt, training_forms, eval_forms, tuning_dataset, eval_dataset, clinical_docs או um_policies. נתונים שמאוחסנים בדליים אזוריים משוכפלים באופן סינכרוני בכמה אזורים בתוך אזור. כדי להשיג זמינות גבוהה יותר, אפשר להשתמש בקטגוריות בשני אזורים או במספר אזורים, שבהן הנתונים משוכפלים באופן אסינכרוני בין האזורים.
ב-Firestore, המידע שחולץ ממסד הנתונים pa_form_collection יכול להיות מפוזר בין כמה מרכזי נתונים, כדי להבטיח יכולת הרחבה ואמינות ברמה הגלובלית.
השירותים של Cloud Run, ingestion_service,hitl_app ו-ur_app, הם שירותים אזוריים. הנתונים מאוחסנים באופן סינכרוני בכמה אזורים בתוך אזור מסוים. התעבורה מאוזנת אוטומטית בין האזורים. אם מתרחש הפסקת חשמל באזור, משימות Cloud Run ממשיכות לפעול והנתונים לא אובדים. אם מתרחש שיבוש באזור, המשימות של Cloud Run מפסיקות לפעול עד ש-Google תפתור את השיבוש. יכול להיות שמשימות או משימות משנה ספציפיות ב-Cloud Run ייכשלו. כדי לטפל בכשלים כאלה, אפשר להשתמש בניסיונות חוזרים של משימות ובשמירת נקודות ביקורת. מידע נוסף זמין במאמר בנושא שיטות מומלצות לניסיונות חוזרים של משימות ולנקודות ביקורת.
במאמר טיפים כלליים לפיתוח ב-Cloud Run מפורטות כמה שיטות מומלצות לשימוש ב-Cloud Run.
Agent Platform היא פלטפורמה מקיפה וידידותית למשתמש ללמידת מכונה, שמספקת סביבה מאוחדת למחזור החיים של למידת מכונה, מהכנת הנתונים ועד לפריסת המודל ולמעקב אחריו.
עקרונות והמלצות בנושא מהימנות שספציפיים לעומסי עבודה של AI ו-ML מפורטים במאמר AI and ML perspective: Reliability (נקודת מבט על AI ו-ML: מהימנות) ב-Well-Architected Framework.
הוזלת עלויות
בקטע הזה מפורטות הנחיות לאופטימיזציה של העלות של יצירה והפעלה של ארכיטקטורה לאוטומציה של עיבוד בקשות PA ולשיפור תהליכי ה-UR. ניהול קפדני של השימוש במשאבים ובחירה של רמות שירות מתאימות יכולים להשפיע באופן משמעותי על העלות הכוללת.
סוגי אחסון ב-Cloud Storage: כדאי להשתמש בסוגי אחסון שונים (Standard, Nearline, Coldline או Archive) בהתאם לתדירות הגישה לנתונים. Nearline, Coldline ו-Archive הם פתרונות חסכוניים יותר לנתונים שניגשים אליהם בתדירות נמוכה יותר.
כללי מדיניות בנושא מחזור החיים של Cloud Storage: הטמעת כללי מדיניות בנושא מחזור החיים כדי להעביר אובייקטים באופן אוטומטי לסוגי אחסון (storage class) בעלות נמוכה יותר או למחוק אותם על סמך הגיל ודפוסי הגישה.
התמחור של Document AI מבוסס על מספר המעבדים שנפרסו ועל מספר הדפים שעובדו על ידי המעבדים של Document AI. כמה נקודות שכדאי לחשוב עליהן:
- אופטימיזציה של מעבדים: ניתוח של דפוסי עומס עבודה כדי לקבוע את המספר האופטימלי של מעבדי Document AI לפריסה. אל תקצו יותר מדי משאבים.
- ניהול נפח הדפים: עיבוד מראש של מסמכים כדי להסיר דפים מיותרים או לבצע אופטימיזציה של הרזולוציה יכול לעזור להפחית את עלויות העיבוד.
התמחור של Firestore מבוסס על פעילות שקשורה למסמכים, לרשומות אינדקס, לאחסון שבו נעשה שימוש במסד הנתונים ולכמות רוחב הפס ברשת. כמה נקודות שכדאי לחשוב עליהן:
- בניית מודל נתונים: כדאי לתכנן את מודל הנתונים כך שמספר רשומות האינדקס יהיה מינימלי, ולאחר מכן לבצע אופטימיזציה של דפוסי השאילתות כדי לשפר את היעילות.
- רוחב פס ברשת: מעקב ואופטימיזציה של השימוש ברשת כדי להימנע מחיובים עודפים. מומלץ לשמור במטמון נתונים שמתבצעת אליהם גישה לעיתים קרובות.
החיובים ב-Cloud Run מחושבים על סמך השימוש במעבד (CPU) על פי דרישה, הזיכרון ומספר הבקשות. חשוב לחשוב היטב על הקצאת המשאבים. הקצאת משאבי מעבד (CPU) וזיכרון על סמך מאפייני עומס העבודה. כדאי להשתמש בהתאמה אוטומטית לעומס כדי להתאים את המשאבים באופן דינמי לפי הביקוש.
Agent Platform בדרך כלל יש חיוב על מודלים של שפה גדולה (LLM) על סמך הקלט והפלט של הטקסט או המדיה. מספר הטוקנים של הקלט והפלט משפיע ישירות על העלויות של מודל שפה גדול (LLM). אופטימיזציה של הפרומפטים ושל תהליך יצירת התשובות כדי לשפר את היעילות.
חיפוש מבוסס סוכנים: העלויות של מנוע החיפוש תלויות בתכונות שבהן אתם משתמשים. כדי לעזור לכם לנהל את העלויות, תוכלו לבחור מבין שלוש האפשרויות הבאות:
- Search Standard Edition, שמציע יכולות חיפוש לא מובנות.
- מהדורת Search Enterprise, שמציעה יכולות חיפוש לא מובנה וחיפוש באתרים.
- תוסף LLM לחיפוש, שמציע סיכום ויכולות חיפוש רב-שלבי.
כדי לבצע אופטימיזציה של העלויות, אפשר גם להיעזר בשיקולים הנוספים הבאים:
- מעקב והתראות: הגדרת Cloud Monitoring והתראות חיוב כדי לעקוב אחרי העלויות ולקבל התראות כשהשימוש חורג מספי העלויות.
- דוחות עלויות: כדאי לעיין באופן קבוע בדוחות עלויות במסוףGoogle Cloud כדי לזהות מגמות ולבצע אופטימיזציה של השימוש במשאבים.
- כדאי לשקול הנחות תמורת התחייבות לשימוש: אם יש לכם עומסי עבודה צפויים, כדאי להתחייב לשימוש במשאבים האלה לתקופה מסוימת כדי לקבל מחירים מוזלים.
אם תביאו בחשבון את הגורמים האלה ותיישמו את האסטרטגיות המומלצות, תוכלו לנהל ולבצע אופטימיזציה של העלות של הפעלת ארכיטקטורת הפעולות האוטומטיות של PA ו-UR ב- Google Cloudבצורה יעילה.
עקרונות והמלצות לאופטימיזציה של עלויות שספציפיים לעומסי עבודה של AI ו-ML מפורטים במאמר AI and ML perspective: Cost optimization ב-Well-Architected Framework.
פריסה
קוד ההטמעה לדוגמה של הארכיטקטורה הזו זמין במסגרת רישוי קוד פתוח. הארכיטקטורה שהקוד הזה מיישם היא אב-טיפוס, ויכול להיות שהיא לא כוללת את כל התכונות והאבטחה שנדרשות לפריסה בסביבת ייצור. כדי ליישם את ארכיטקטורת העזר הזו ולהרחיב אותה כך שתתאים יותר לדרישות שלכם, מומלץ לפנות אל Google Cloud Consulting.
קוד לתחילת הדרך לארכיטקטורת ההפניה הזו זמין במאגרי ה-Git הבאים:
- מאגר git של CDA: המאגר הזה מכיל סקריפטים של פריסת Terraform להקצאת משאבים בתשתית ולפריסה של קוד האפליקציה.
- מאגר Git של שירות UR: במאגר הזה יש דוגמאות קוד לשירות UR.
אפשר לבחור באחת משתי האפשרויות הבאות להטמעה של תמיכה ושירותים לארכיטקטורת ההפניה הזו:
- פונים אל Google Cloud Consulting.
- כדאי לפנות אל שותף שיצר חבילת מוצרים באמצעות המוצרים ורכיבי הפתרון שמתוארים בארכיטקטורה הזו.
המאמרים הבאים
- תשתית RAG ל-AI גנרטיבי באמצעות Agent Platform ו-חיפוש וקטורי
- תשתית RAG ל-AI גנרטיבי באמצעות Agent Platform ו-AlloyDB ל-PostgreSQL
- תשתית RAG ל-AI גנרטיבי באמצעות GKE ו-Cloud SQL
- תשתית RAG ל-AI גנרטיבי באמצעות Gemini Enterprise ו-Agent Platform
- תשתית GraphRAG ל-AI גנרטיבי באמצעות Agent Platform ו-Spanner Graph
- Google Cloud אפשרויות להצגת תשובות מ-AI גנרטיבי שמבוססות על מקורות מידע
- אופטימיזציה של אפליקציות Python ל-Cloud Run
- סקירה כללית של עקרונות והמלצות לארכיטקטורה שספציפיים לעומסי עבודה של AI ו-ML ב- Google Cloudזמינה בפרספקטיבה של AI ו-ML ב-Well-Architected Framework.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
Author: Dharmesh Patel | Industry Solutions Architect, Healthcare
תורמי תוכן אחרים:
- Ben Swenka | Key Enterprise Architect
- Emily Qiao | AI/ML Customer Engineer
- Luis Urena | Developer Relations Engineer
- פרני מיטל | מנהל קבוצת מוצרים
- Lakshmanan Sethu | מנהל חשבונות טכני
-
מידע נוסף על שיקולים ספציפיים לאזור זמין במאמר מיקום גיאוגרפי ואזורים. ↩