


במאמר הזה מוצגת ארכיטקטורה לדוגמה שאפשר להשתמש בה כדי לתכנן את התשתית לאפליקציית AI גנרטיבי עם יצירה משולבת-אחזור (RAG) באמצעות Gemini Enterprise ו-Gemini Enterprise Agent Platform. בארכיטקטורה לדוגמה הזו מוסבר איך להשתמש בשירותים מנוהלים ולפרוס נציג AI אחד כדי להפעיל תהליך נתונים של RAG מקצה לקצה. Gemini Enterprise היא פלטפורמה מאוחדת לתזמור סוכנים בכל הארגון. פלטפורמת הסוכנים מאיצה את הפיתוח והפריסה של סוכנים בהתאמה אישית, ומספקת מאגרי נתונים מנוהלים כדי לאפשר אחזור יעיל ל-RAG.
המסמך הזה מיועד לאדריכלים, למפתחים ולאדמינים של אפליקציות מבוססות-AI גנרטיבי. ההנחה במאמר היא שיש לכם הבנה בסיסית במושגים שקשורים ל-AI, ללמידת מכונה (ML) ולמודלים גדולים של שפה (LLM). במסמך הזה לא מוסבר איך לעצב ולפתח אפליקציית AI גנרטיבי. במאמר פיתוח אפליקציה של AI גנרטיבי מוסבר איך לתכנן אפליקציה.
ארכיטקטורה
התרשים הבא מציג תצוגה ברמה גבוהה של הארכיטקטורה שמוצגת במסמך הזה:
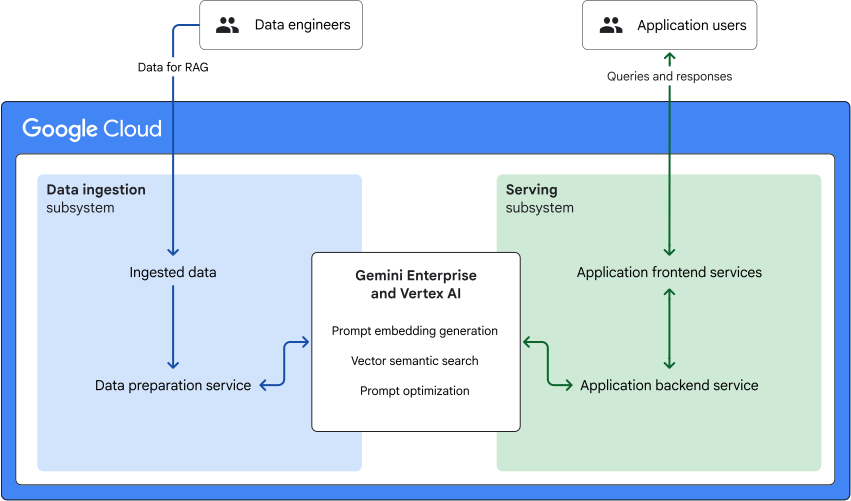
לארכיטקטורה שבתרשים הקודם יש שתי תת-מערכות: הטמעת נתונים והצגת נתונים.
- תת-המערכת להטמעת נתונים מטמיעה ומכינה נתונים ממקורות חיצוניים לשימוש ב-RAG. תת-המערכת יוצרת הטמעות לנתונים שהוכנסו, ומשתמשת בהן כדי ליצור ולתחזק אינדקס וקטורי שניתן לחיפוש במאגר נתונים מנוהל.
- תת-מערכת להצגה מכילה את שירותי הקצה הקדמי ושירותי הקצה העורפי של אפליקציית ה-AI הגנרטיבי.
- השירות לקצה הקדמי מטפל בתהליך השאילתה והתגובה עם משתמשי האפליקציה, ומעביר את השאילתות לשירות לקצה העורפי.
- שירות הקצה העורפי משתמש ב-Gemini Enterprise וב-Agent Platform כדי ליצור ולפרוס את סוכן ה-AI שינהל את תהליך ה-RAG. התהליך הזה משתמש בנתוני הווקטורים שנוספו לאינדקס כדי ליצור תשובות שמבוססות על ההקשר ועומדות במסנני הבטיחות של AI אחראי.
התרשים הבא מציג תצוגה מפורטת של הארכיטקטורה:
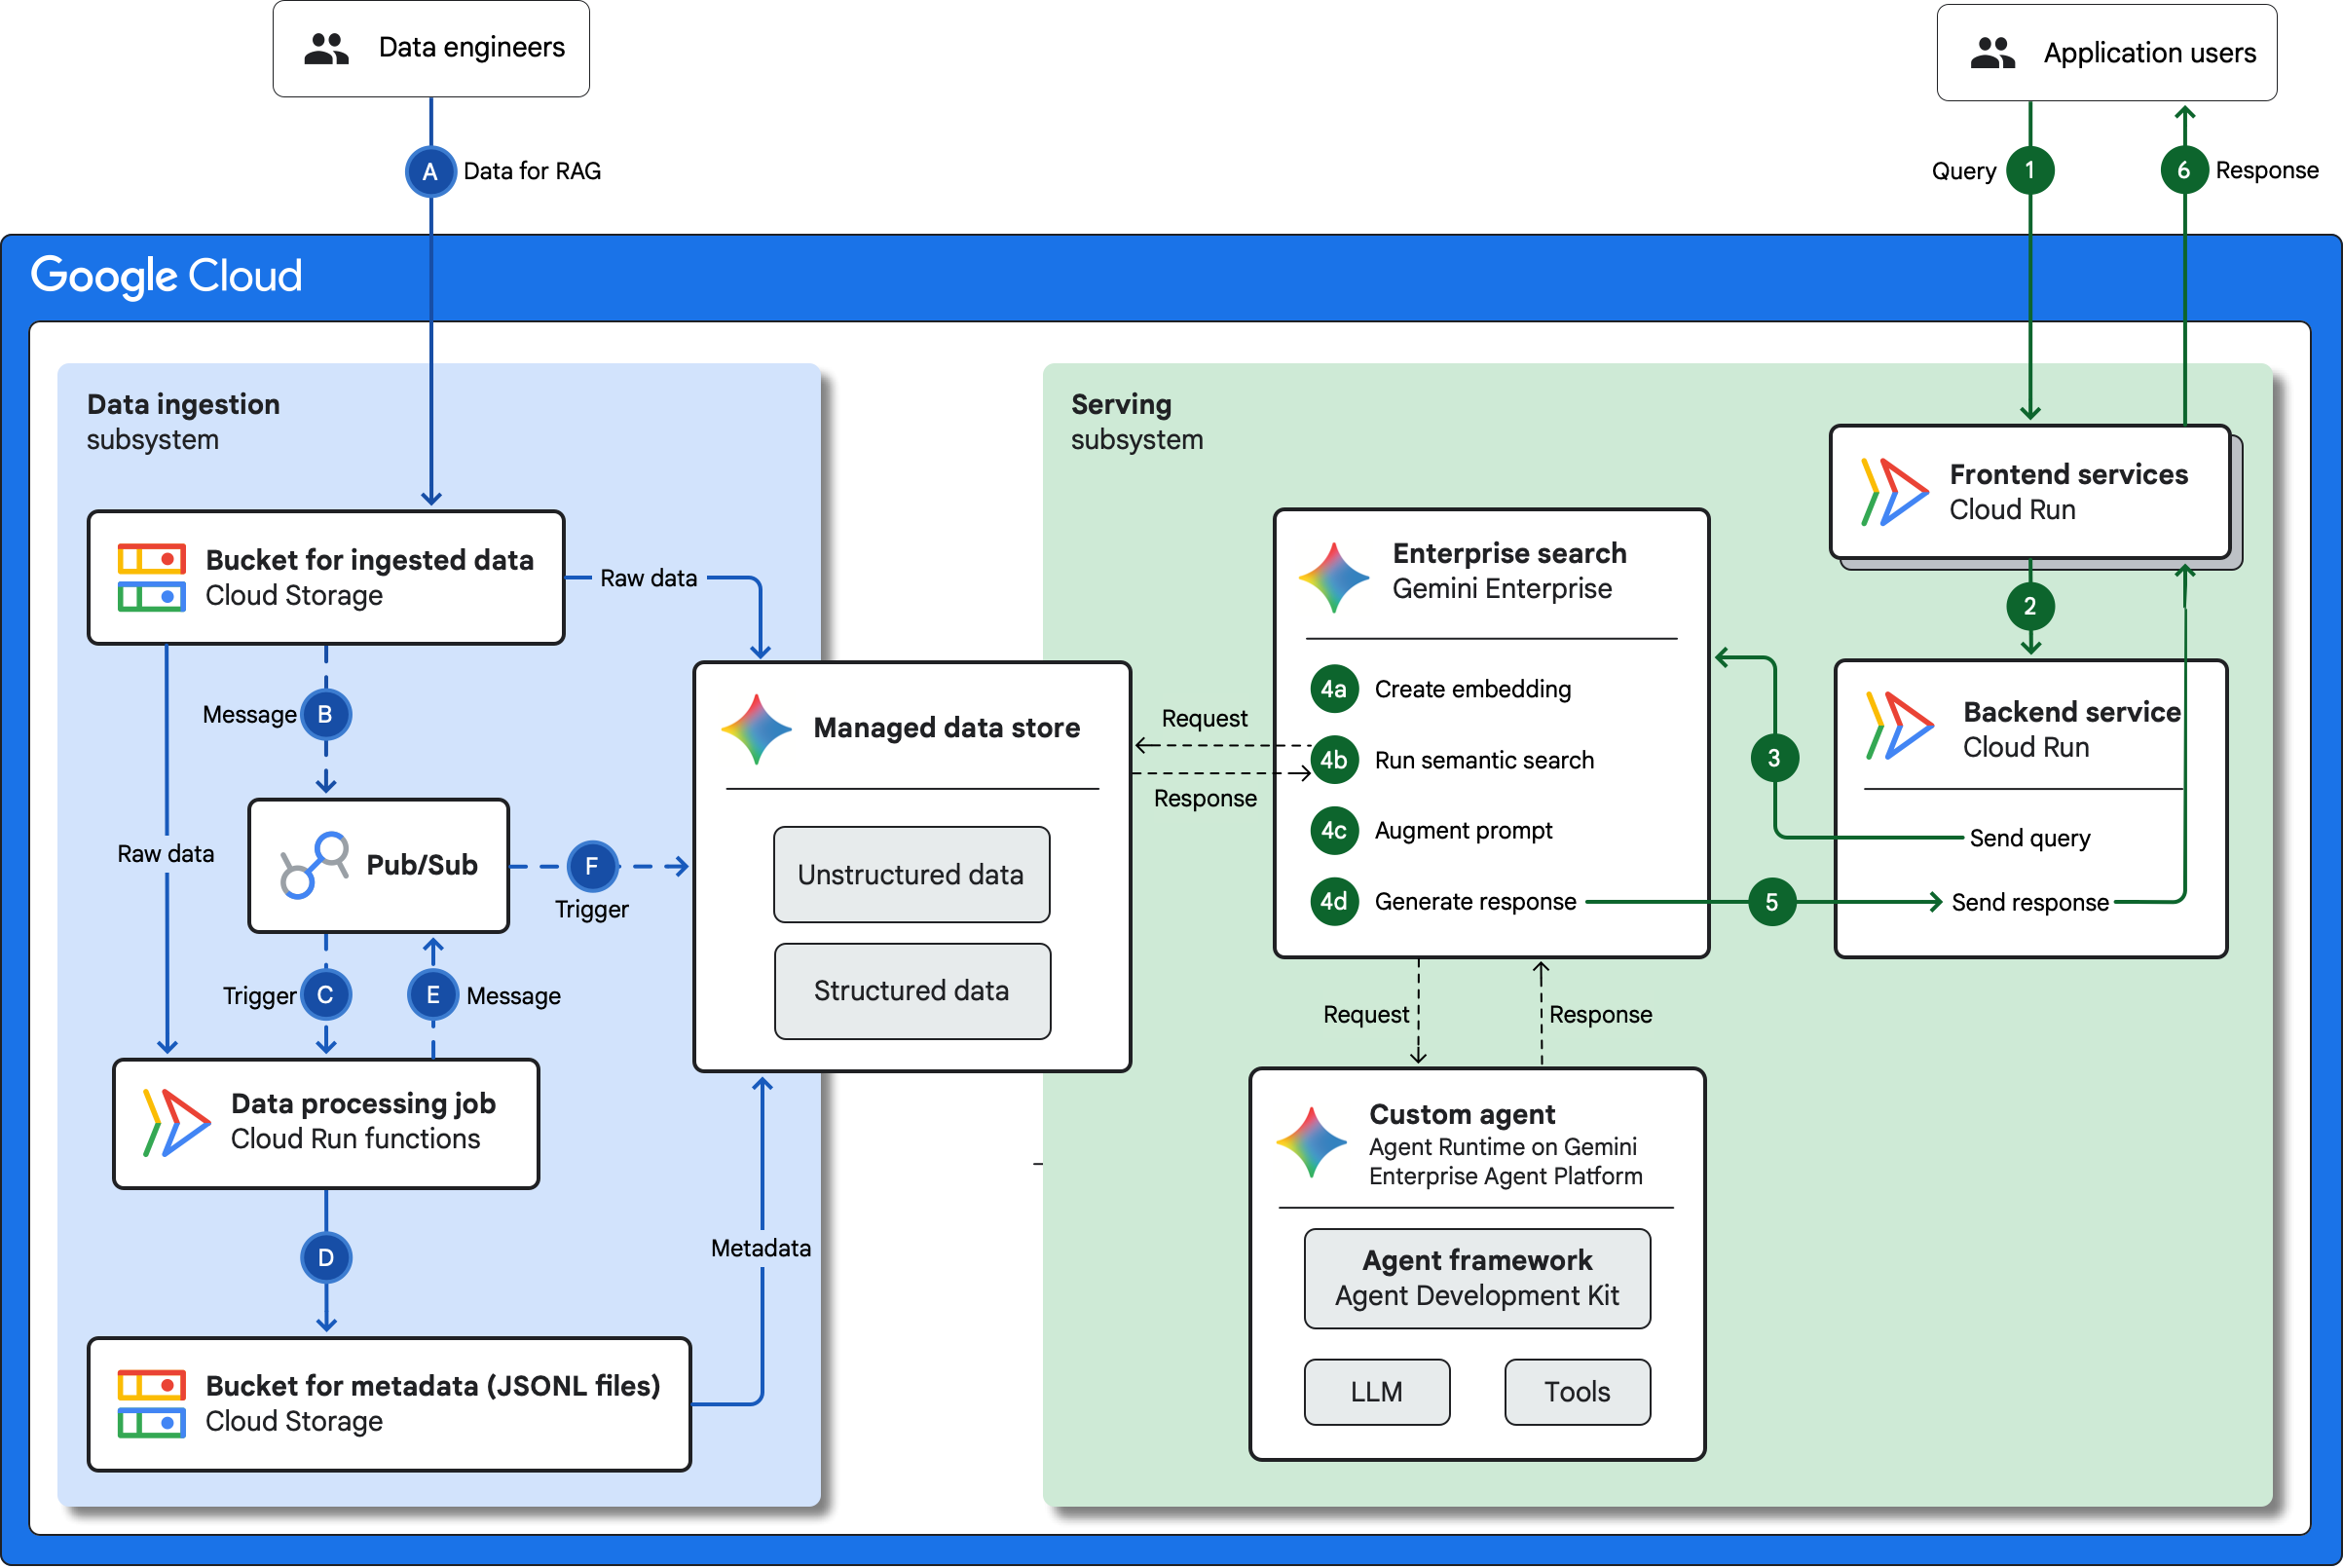
בקטעים הבאים מתואר זרם הנתונים בכל תת-מערכת בתרשים הארכיטקטורה שלמעלה.
מערכת משנה להטמעת נתונים
תת-המערכת להטמעת נתונים מטמיעה נתונים ממקורות חיצוניים ומכינה אותם ל-RAG. אלה השלבים בתהליך הטמעת הנתונים והכנתם:
- מהנדסי מערכות מידע מעלים נתונים ממקורות חיצוניים לקטגוריה של Cloud Storage. המקורות החיצוניים יכולים להיות אפליקציות, מסדי נתונים או שירותי סטרימינג.
- בסיום, Cloud Storage מפרסם הודעה בנושא Pub/Sub.
- הנושא ב-Pub/Sub מפעיל משימת עיבוד בפונקציות Cloud Run.
- פונקציות Cloud Run מעבדות את הנתונים הגולמיים על ידי יצירה ואחסון של המטא-נתונים כקובצי JSON Lines (JSONL). קובצי ה-JSONL מאוחסנים בקטגוריה נפרדת של Cloud Storage.
- בסיום, פונקציות Cloud Run מפרסמות הודעה בנושא Pub/Sub.
- הנושא ב-Pub/Sub מפעיל פונקציית Cloud Run במורד הזרם שקוראת ל-method
documents.importשל Discovery Engine API כדי להתחיל משימת ייבוא במאגר הנתונים המנוהל ב-Gemini Enterprise. משימת הייבוא שולפת את הנתונים והמטא-נתונים הגולמיים שנקלטו מהקטגוריות של Cloud Storage, ואז מנתחת את הנתונים ומחלקת אותם לחלקים כדי שאפשר יהיה לאחזר אותם ביעילות במהלך ההצגה. Gemini Enterprise יוצר באופן אוטומטי הטמעות וקטורים בלי שצריך להגדיר שום דבר.
תת-מערכת להצגת מודעות
תת-המערכת להצגת מודעות מטפלת בתהליך של שאילתה-תגובה בין אפליקציית ה-AI הגנרטיבי לבין המשתמשים שלה. אלה השלבים בתהליך הצגת המודעות:
- משתמש באפליקציה שולח שאילתה דרך אחד משירותי ממשק המשתמש של Cloud Run. אתם יכולים להתאים אישית את השירותים האלה לחוויות שונות, כמו ממשק משתמש של צ'אט בוט, דף חיפוש או אפליקציה לנייד.
- שירות ממשק המשתמש מקבל את השאילתה ומעביר אותה לשירות מרכזי של Cloud Run לקצה העורפי. ה-backend הזה מספק נקודת קצה (endpoint) אחת ומאוחדת שתומכת בכל הלקוחות השונים של ה-frontend. שירות הקצה העורפי גם מבצע עיבוד מקדים נדרש, שיכול לכלול בניית מסננים לשאילתת החיפוש. הגישה הזו שומרת על שקיפות הלוגיקה בממשקי הקצה.
- שירות הקצה העורפי שולח את הבקשה המוכנה ל-Gemini Enterprise באמצעות נקודת קצה ל-API של Gemini Enterprise כדי להתחיל את תהליך העבודה של RAG.
- כדי לעבד את השאילתה, Gemini Enterprise משתמש בחיפוש הפנים-ארגוני ובסוכן בהתאמה אישית כדי לבצע את המשימות הבאות:
- יוצרים הטמעה של השאילתה של המשתמש.
- מבצעים חיפוש סמנטי בנתונים שנוספו לאינדקס במאגר הנתונים המנוהל כדי למצוא את המידע הכי רלוונטי.
- הרחבת השאילתה המקורית באמצעות הנתונים שאוחזרו ממאגר הנתונים המנוהל, כדי ליצור הנחיה מפורטת עם הקשר.
- ליצור תשובה סופית שמבוססת על ההנחיה המורחבת.
- Gemini Enterprise שולח את התשובה שנוצרה לשירות לקצה העורפי של Cloud Run.
- שירות הקצה העורפי מחזיר את התשובה הסופית לשירות הקצה הקדמי ששלח את הבקשה המקורית. שירות החזית מציג את התשובה למשתמש באפליקציה.
המוצרים שהשתמשו בהם
ארכיטקטורת העזר הזו משתמשת במוצרי Google Cloud הבאים:
- Gemini Enterprise: פלטפורמה מאובטחת ומנוהלת לפריסה ולניהול של סוכני AI בארגון.
- Gemini Enterprise Agent Platform: פלטפורמה מקיפה שמאפשרת לפתח, להרחיב, לנהל ולשפר סוכני AI ברמה שמתאימה לארגונים.
- Agent Runtime ב-Gemini Enterprise Agent Platform: פלטפורמה שמאפשרת להריץ, לנהל ולהרחיב סוכני AI בסביבת הייצור.
- Cloud Run: פלטפורמת מחשוב בלי שרת (serverless computing) שמאפשרת להריץ קונטיינרים ישירות בתשתית של Google, שניתנת להתאמה לעומס.
- פונקציות Cloud Run: פלטפורמת מחשוב בלי שרת (serverless computing) שמאפשרת להריץ פונקציות למטרה יחידה ישירות ב- Google Cloud.
- Pub/Sub: שירות אסינכרוני וניתן להתאמה להעברת הודעות, שמפריד בין השירותים שיוצרים את ההודעות לבין השירותים שמעבדים אותן.
- Cloud Storage: מאגר אובייקטים בעלות נמוכה וללא הגבלה, לסוגי נתונים שונים. אפשר לגשת לנתונים מתוך Google Cloudומחוץ לו, והם משוכפלים במיקומים שונים כדי ליצור יתירות.
תרחישים לדוגמה
הארכיטקטורה הזו מיועדת לתרחישים ארגוניים שבהם אפליקציית ה-AI הגנרטיבי צריכה גישה למידע העדכני ביותר, ודורשת הבנה מעמיקה של ההקשר כדי לספק תשובות מדויקות.
הארכיטקטורה כוללת תת-מערכת מותאמת אישית להטמעת נתונים, כדי לענות על שתי דרישות ארגוניות עיקריות:
- זמינות נתונים בזמן אמת: צינור עיבוד הנתונים מבוסס-האירועים מעבד נתונים חדשים ברגע שהם זמינים בארגון, למשל מדריך מוצר חדש או דוח מעודכן. הצינור גם הופך את המידע לזמין במאגר הנתונים המנוהל. העיצוב הזה עוזר לצמצם את חוסר העדכניות של המידע, כי הוא עוזר לצמצם את העיכוב בין הזמינות של הנתונים לבין השימוש בהם.
- חיפוש הקשרי מועשר: משימת העיבוד בהתאמה אישית מאפשרת לארגון להחיל לוגיקה עסקית משלו כדי להעשיר את הנתונים במטא-נתונים חשובים. פונקציית Cloud Run יכולה לתייג כל מסמך במאפיינים ספציפיים כמו קו מוצרים, מחבר, מיקום או סוג מסמך. המטא-נתונים העשירים האלה עוזרים לסוכן לצמצם את החיפוש ולתת תשובות מדויקות יותר, בהתאם להקשר.
RAG היא שיטה יעילה לשיפור איכות הפלט שנוצר ממודל שפה גדול (LLM). בקטע הזה מפורטות דוגמאות לתרחישים שבהם אפשר להשתמש באפליקציות של AI גנרטיבי עם יכולות RAG.
המלצות מותאמות אישית על מוצרים
אתר קניות אונליין יכול להשתמש בצ'אט בוט שמבוסס על LLM כדי לעזור ללקוחות למצוא מוצרים או לקבל עזרה שקשורה לקניות. אפשר להוסיף לשאלות של המשתמש נתונים היסטוריים על דפוסי הקנייה והאינטראקציה שלו עם האתר. הנתונים יכולים לכלול ביקורות ומשובים של משתמשים שמאוחסנים במאגר נתונים לא מובנים, או מדדים שקשורים לחיפוש שמאוחסנים במחסן נתונים לצורכי ניתוח התנהגות המשתמשים. לאחר מכן, מודל ה-LLM יכול לעבד את השאלה המורחבת כדי ליצור תשובות מותאמות אישית שיכולות להיות מושכות ומשכנעות יותר למשתמש.
מערכות סיוע קליניות
רופאים בבתי חולים צריכים לבדוק ולסכם את המידע הרפואי של המטופלים כדי לקבל החלטות מושכלות לגבי הטיפול. אפליקציית AI גנרטיבי שמשתמשת במודל בסיס רפואי כמו MedGemma יכולה לעזור לרופאים לסכם הערות קליניות ולבדוק את ההקשר הרפואי. התשובות שהאפליקציה יוצרת יכולות להיות מעוגנות בנתונים בסיכומי מצב בריאותי היסטוריים של מטופלים, על ידי הוספת הקשר לפרומפטים באמצעות נתונים ממסד הנתונים של התיקים הרפואיים האלקטרוניים (EHR) של בית החולים או ממאגר ידע חיצוני כמו PubMed.
מחקר משפטי יעיל
מחקר משפטי מבוסס-AI גנרטיבי מאפשר לעורכי דין לשלוח במהירות שאילתות על כמויות גדולות של חוקים ופסקי דין, כדי לזהות תקדימים משפטיים רלוונטיים או לסכם מושגים משפטיים מורכבים. כדי לשפר את תוצאות המחקר, אפשר להוסיף להנחיות של עורך הדין נתונים שאוחזרו ממאגר המידע הקנייני של משרד עורכי הדין, שכולל חוזים, תכתובות משפטיות קודמות ורשומות פנימיות של תיקים. הגישה הזו עוזרת ליצור תשובות שרלוונטיות לתחום המשפטי שבו עורך הדין מתמחה.
חלופות לעיצוב
בקטע הזה מוצגות גישות עיצוב חלופיות שאפשר להשתמש בהן באפליקציית ה-AI הגנרטיבי עם יכולות RAG ב- Google Cloud.
חלופות לתשתית AI
במאמר AI גנרטיבי עם RAG מפורטים מדריכים לתכנון ופריסה של אפליקציות AI גנרטיבי עם RAG ב- Google Cloud.
אפשרויות לאירוח אפליקציות
בארכיטקטורה שמוצגת במסמך הזה, Cloud Run מארח את אפליקציית ה-AI הגנרטיבי ואת עיבוד הנתונים. Cloud Run היא פלטפורמה מנוהלת שמתמקדת במפתחים. אתם יכולים גם לפרוס את האפליקציה ב-Agent Runtime ב-Gemini Enterprise Agent Platform, באשכולות של Google Kubernetes Engine (GKE) או במכונות וירטואליות של Compute Engine.
כדי לבחור מארח לאפליקציה, כדאי לשקול את היתרונות והחסרונות הבאים בין גמישות ההגדרה לבין מאמץ הניהול:
- באפשרות Cloud Run ללא שרת (serverless), אתם פורסים את השירותים בהתאמה אישית בסביבה מנוהלת שהוגדרה מראש. כדי לארח את השירותים בחזית ואת הלוגיקה המותאמת אישית בקצה העורפי לעיבוד מקדים של בקשות, הארכיטקטורה הזו דורשת יכולת לפרוס אפליקציות בהתאמה אישית.
- כשמשתמשים באפשרות Agent Runtime, משתמשים בפלטפורמה מנוהלת לחלוטין שמיועדת להצגת סוכנים. Agent Runtime מפחית את התקורה של הניהול ומספק שילוב הדוק עם Gemini Enterprise.
- במכונות וירטואליות של Compute Engine ובקונטיינרים של GKE, אתם אחראים לניהול משאבי המחשוב הבסיסיים, אבל יש לכם יותר גמישות ושליטה בהגדרות האישיות.
במאמרים הבאים תוכלו לקרוא מידע נוסף על בחירת שירות מתאים לאירוח אפליקציות:
אפשרויות אחרות לתשתית
במאמר בחירת מודלים ותשתית לאפליקציית ה-AI הגנרטיבי מפורט מידע על אפשרויות תשתית אחרות, מודלים נתמכים ושיטות קרקוע שאפשר להשתמש בהן לאפליקציות של AI גנרטיבי ב-Google Cloud.
שיקולים שקשורים לעיצוב
בקטע הזה מוסבר איך לפתח ארכיטקטורת AI גנרטיבי עם יכולות RAG ב- Google Cloud , שעומדת בדרישות הספציפיות שלכם בנושאי אבטחה ותאימות, אמינות, עלות וביצועים. ההנחיות בקטע הזה הן חלקיות. בהתאם לדרישות הספציפיות של אפליקציית ה-AI הגנרטיבי ו Google Cloud המוצרים והתכונות שבהם אתם משתמשים, יכול להיות שתצטרכו להביא בחשבון גורמי תכנון ופשרות נוספים.
במאמר נקודת המבט של AI ו-ML ב-Well-Architected Framework מפורטים עקרונות והמלצות לארכיטקטורה שספציפיים לעומסי עבודה של AI ו-ML ב- Google Cloud.
אבטחה, פרטיות ותאימות
בקטע הזה מתוארים שיקולים והמלצות לתכנון טופולוגיה ב- Google Cloud שעומדת בדרישות האבטחה והתאימות של עומס העבודה.
כדי לקרוא על עקרונות והמלצות לאבטחה שספציפיים לעומסי עבודה של AI ו-ML, קראו את המאמר נקודת מבט על AI ו-ML: אבטחה ב-Well-Architected Framework.
Agent Platform
פלטפורמת Agent תומכת באמצעי בקרה לאבטחה שאתם יכולים להשתמש בהם כדי לעמוד בדרישות שלכם לגבי מיקום אחסון הנתונים, הצפנת נתונים, אבטחת רשת ו-Access Transparency. Google Cloudמידע נוסף זמין במשאבי העזרה הבאים:
- אמצעי בקרה לאבטחה של שירותי למידת מכונה
- אמצעי אבטחה ל-AI גנרטיבי
- פלטפורמת Agent ואפס שמירת נתונים
- הפעלת Access Transparency ב-Gemini Enterprise
- בקרות תאימות ואבטחה עבור Gemini Enterprise
- תאימות ב-Gemini Enterprise
- מחיקת נתונים ב- Google Cloud.
מודלים של AI גנרטיבי עלולים ליצור תשובות פוגעניות, במיוחד אם מבקשים מהם במפורש ליצור תשובות כאלה. כדי לשפר את הבטיחות ולמנוע שימוש לרעה, אתם יכולים להגדיר מסנני תוכן שיחסמו תשובות פוגעניות. מידע נוסף זמין במאמר מסנני בטיחות ותוכן.
Cloud Run
כברירת מחדל, Cloud Run מצפין נתונים באמצעותGoogle-owned and Google-managed encryption keys. כדי להגן על הקונטיינרים באמצעות מפתחות בשליטתכם, אתם יכולים להשתמש במפתחות הצפנה בניהול הלקוח (CMEK). מידע נוסף מופיע במאמר שימוש במפתחות הצפנה בניהול הלקוח.
כדי לוודא שרק קובצי אימג' מורשים של קונטיינרים נפרסים ב-Cloud Run, אתם יכולים להשתמש ב-Binary Authorization.
בעזרת Cloud Run אתם יכולים לעמוד בדרישות לגבי מיקום אחסון הנתונים. פונקציות Cloud Run פועלות באזור שנבחר.
Cloud Storage
כברירת מחדל, הנתונים שמאוחסנים ב-Cloud Storage מוצפנים באמצעות Google-owned and Google-managed encryption keys. במקרה הצורך, אתם יכולים להשתמש במפתחות CMEK או במפתחות משלכם שאתם מנהלים באמצעות שיטת ניהול חיצונית, כמו מפתחות הצפנה באספקת הלקוח (CSEK). מידע נוסף מופיע במאמר אפשרויות להצפנת נתונים.
ב-Cloud Storage יש שתי שיטות שבאמצעותן אפשר לתת למשתמשים גישה לקטגוריות ולאובייקטים: ניהול זהויות והרשאות גישה (IAM) ורשימות של בקרת גישה (ACL). ברוב המקרים, מומלץ להשתמש ב-IAM, שמאפשר להעניק הרשאות ברמת הקטגוריה והפרויקט. למידע נוסף, קראו את הסקירה הכללית על בקרת גישה.
יכול להיות שהנתונים שאתם טוענים לתת-המערכת של הטמעת הנתונים דרך Cloud Storage כוללים מידע רגיש. אתם יכולים להשתמש ב-Sensitive Data Protection כדי לגלות, לסווג ולהסיר פרטים מזהים ממידע רגיש. מידע נוסף זמין במאמר שימוש ב-Sensitive Data Protection עם Cloud Storage.
בעזרת Cloud Storage אתם יכולים לעמוד בדרישות לגבי מיקום אחסון הנתונים. הנתונים מאוחסנים או משוכפלים ב-Cloud Storage באזור שציינתם.
Pub/Sub
כברירת מחדל, Pub/Sub מצפין את כל ההודעות, כולל הודעות במנוחה והודעות במעבר, באמצעותGoogle-owned and Google-managed encryption keys. ב-Pub/Sub אפשר להשתמש במפתחות CMEK להצפנת הודעות בשכבת האפליקציה. מידע נוסף זמין במאמר הגדרת הצפנת הודעות.
אם יש לכם דרישות לגבי מיקום אחסון הנתונים, כדי לוודא שנתוני ההודעות מאוחסנים במיקומים ספציפיים, אתם יכולים להגדיר כללי מדיניות לאחסון הודעות.
אמינות
בקטע הזה מתוארים שיקולים והמלצות לתכנון, לבנייה ולהפעלה של תשתית אמינה לפריסה ב- Google Cloud.
במאמר נקודת מבט על AI ו-ML: אמינות ב-Well-Architected Framework מפורטים עקרונות והמלצות לאמינות שספציפיים לעומסי עבודה של AI ו-ML.
Agent Platform
פלטפורמת Agent תומכת במיקום אחסון הנתונים במנוחה. פלטפורמת Agent מאחסנת את נתוני המקור, כולל נתונים ל-RAG במאגר הנתונים המנוהל, בGoogle Cloud מיקום שבחרתם. ההפרדה הזו בין העיבוד לאחסון היא היבט בסיסי של האופן שבו הפלטפורמה מספקת גם אמינות גבוהה וגם תאימות.
Cloud Run
Cloud Run הוא שירות אזורי שמפיץ באופן אוטומטי מכונות של שירותים ללא שמירת מצב (stateless) בין כמה אזורים בתוך אזור, ומאזן את העומסים ביניהם. אם יש הפסקה זמנית בשירות באזור מסוים, שירותי Cloud Run ופונקציות Cloud Run ממשיכים לפעול בלי הפרעה. כדי להשיג חוסן מפני הפסקות אזוריות, אתם יכולים לפרוס שירותי Cloud Run בכמה אזורים מאחורי מאזן עומסים חיצוני גלובלי של אפליקציות (ALB). מידע נוסף זמין במאמר הצגת תנועה ממספר אזורים.
בתת-המערכת של הטמעת הנתונים, פונקציות Cloud Run מבוססות-אירועים עלולות לחוות כשלים זמניים או לקבל אירועים כפולים בגלל מסירה לפחות פעם אחת. כדי לטפל בתרחישים האלה בצורה מהימנה, כדאי להשתמש בשיטות המומלצות הבאות:
- תכננו פונקציות אידמפוטנטיות כדי שעיבוד מחדש של אירוע יניב את אותה תוצאה בלי ליצור רשומות כפולות.
- כדי להתאושש משגיאות זמניות במורד הזרם, מגדירים ניסיונות חוזרים של פונקציות מבוססות-אירועים עם השהיה מעריכית לפני ניסיון חוזר (exponential backoff) בטריגר של Pub/Sub.
- מגדירים נושא להודעות ללא מוצא ב-Pub/Sub כדי לבודד הודעות שהעיבוד שלהן נכשל שוב ושוב, לבדיקה נפרדת ולהפעלה מחדש.
Cloud Storage
אפשר ליצור קטגוריות של Cloud Storage באחד משלושה סוגי מיקומים: אזורי, שני אזורים או מספר אזורים. בנתונים שבקטגוריות אזוריות, Cloud Storage יוצר רפליקה של הנתונים באופן סינכרוני בכמה אזורים בתוך אזור. כדי להגביר את הזמינות, אתם יכולים להשתמש בקטגוריות בשני אזורים או במספר אזורים, שבהן Cloud Storage משכפל נתונים באופן אסינכרוני בין אזורים. חשוב לוודא שהבחירה שלכם תואמת לדרישות התאימות.
הוזלת עלויות
בקטע הזה מוסבר איך לבצע אופטימיזציה של עלויות ההגדרה וההפעלה של טופולוגיית Google Cloud שאתם בונים באמצעות ארכיטקטורת העזר הזו.
במאמר נקודת מבט על AI ו-ML: אופטימיזציה של עלויות ב-Well-Architected Framework, תוכלו לקרוא על עקרונות והמלצות לאופטימיזציה של עלויות שספציפיות לעומסי עבודה של AI ו-ML.
Agent Platform
מודל ה-AI הבסיסי שהנציג מפעיל יכול להשפיע ישירות על עלות השימוש בנציג הזה. התמחור מחושב לפי מספר הטוקנים של הקלט והפלט בכל בקשה. מידע נוסף זמין במאמר מכסות ומגבלות מערכת של AI גנרטיבי ב-Agent Platform ובGoogle Cloud מחשבון העלויות.
כדי לדעת איך לצמצם את מספר האסימונים כדי להפחית את העלות, קראו את הסקירה הכללית על שמירת הקשר במטמון.
Cloud Run
כדי לייעל את העלות של שירותי Cloud Run ופונקציות Cloud Run, כדאי להשתמש בהמלצות הבאות:
- הגדרות חיוב: בוחרים הגדרת חיוב מתאימה לפי דפוס התנועה. כדאי להשתמש בחיוב מבוסס-בקשה (ברירת המחדל) לעומסי עבודה לא סדירים או עם שיאים – כמו פונקציות Cloud Run מבוססות-אירועים בצינור עיבוד הנתונים – כדי לשלם על המעבד (CPU) והזיכרון רק בזמן עיבוד הבקשות. בשירותי Cloud Run עם תנועה יציבה וצפויה, כדאי לשקול חיוב מבוסס-מכונה, שמבטל את העמלה לכל בקשה ומחייב בתעריף נמוך יותר לשנייה של מחשוב.
- מעבד (CPU), זיכרון ובו-זמניות: מתחילים עם הקצאות ברירת המחדל של המעבד (CPU) והזיכרון, ומשנים את מגבלת המעבד (CPU) ואת מגבלת הזיכרון בהתאם לניצול המשאבים בפועל. כוונו את מספר הבקשות המקסימלי בו-זמנית לכל מכונה, כדי שפחות מכונות יוכלו לטפל בבקשות בו-זמניות שקשורות לקלט/פלט (כמו המתנה לתגובות מהמודל או תגובות מה-API).
- מגבלות התאמה לעומס של מכונות: מגדירים את מספר המכונות המקסימלי כדי להגביל את עלויות ההתאמה לעומס במהלך עליות חדות ובלתי צפויות בתנועה, ומאזנים את מספר המכונות המינימלי בהתאם לדרישות של זמן האחזור בהפעלה קרה.
- הנחות תמורת התחייבות לשימוש: אם אתם יכולים לחזות את דרישות המחשוב של עומסי העבודה ב-Cloud Run, אתם יכולים להוזיל את העלויות באמצעות הנחות תמורת התחייבות לשימוש ב-Cloud Run.
מידע נוסף זמין במאמר שיטות מומלצות לאופטימיזציה של עלויות בשירותי Cloud Run.
Cloud Storage
לקטגוריה של Cloud Storage שמשמשת לטעינת נתונים לתת-המערכת של הטמעת הנתונים, בוחרים סוג אחסון מתאים על סמך הדרישות של שמירת הנתונים ותדירות הגישה של עומסי העבודה. לדוגמה, אתם יכולים לבחור בסוג האחסון Standard ולהשתמש בניהול מחזור החיים של אובייקטים כדי לשלוט בעלויות האחסון. ניהול מחזור החיים של אובייקטים משנמך באופן אוטומטי אובייקטים לסוג אחסון (storage class) זול יותר, או מוחק אובייקטים על סמך תנאים שאתם מגדירים.
אופטימיזציה של הביצועים
בקטע הזה מתוארים שיקולים והמלצות לתכנון טופולוגיה ב- Google Cloud שעומדת בדרישות הביצועים של עומסי העבודה שלכם.
במאמר נקודת מבט של AI ו-ML: אופטימיזציה של ביצועים ב-Well-Architected Framework, תוכלו לקרוא על עקרונות והמלצות לאופטימיזציה של ביצועים שספציפיים לעומסי עבודה של AI ו-ML.
Gemini Enterprise
כדי לצמצם את זמן האחזור במהלך הצגת המודעות, אפשר להעביר תשובות בסטרימינג על ידי שליחת תשובות מהמודל לפני שהנציג יוצר את הפלט המלא. כך אפשר לעבד את הפלט בזמן אמת, לעדכן מיד את ממשק המשתמש ולבצע משימות אחרות בו-זמנית. הסטרימינג משפר את התגובה הנתפסת ויוצר חוויית משתמש אינטראקטיבית יותר. מידע נוסף זמין במאמר קבלת תוצאות חיפוש באמצעות StreamAssist.
כשאתם יוצרים ורושמים סוכנים בהתאמה אישית ב-Agent Development Kit (ADK) ב-Agent Runtime, כדאי לצמצם את מספר הדילוגים בין סוכנים, את מספר הפעמים שהסוכן משתמש בכלים ואת מספר הפעמים שהוא מסכם את המידע, כדי להפחית את זמן האחזור הכולל. למידע נוסף, קראו את המאמר שיטות מומלצות לביצועים ולאמינות.
Cloud Run
לשנות את הקצאות המעבד (CPU) והקצאות הזיכרון לשירותי Cloud Run ולפונקציות Cloud Run, בהתאם לדרישות הביצועים של עומס העבודה. כדי לצמצם את זמן האחזור של ההפעלה במצב התחלתי (cold start) כשמבצעים התאמה לעומס (scaling) מאפס, מפעילים את האצת המעבד בזמן אתחול כדי לספק באופן זמני מעבד נוסף בזמן האתחול של מכונות מאגר, או מגדירים מספר מינימלי של מכונות כדי לשמור על המכונות במצב חם. מידע נוסף זמין במאמרים הגדרת מגבלות מעבד (CPU) לשירותים והגדרת מגבלות זיכרון לשירותים.
Cloud Storage
כדי להעלות קבצים גדולים, אתם יכולים להשתמש בשיטה שנקראת העלאות מורכבות מקבילות. באסטרטגיה הזו, הקובץ הגדול מפוצל לחלקים. מעלים את החלקים ל-Cloud Storage במקביל, ואז Cloud Storage מרכיב מחדש את הנתונים ב- Google Cloud. העלאות מורכבות מקבילות יכולות להיות מהירות יותר מהעלאות רגילות, אם יש לכם רוחב פס מספיק ברשת ומהירות דיסק מספקת. עם זאת, לאסטרטגיה הזו יש כמה מגבלות והשלכות על העלויות. מידע נוסף מופיע במאמר העלאות מורכבות במקביל.
פריסה
כדי לפרוס את ארכיטקטורת העזר הזו, משתמשים בדוגמה של Terraform שזמינה ב-GitHub. מידע נוסף זמין במאמר תשתית RAG לאפליקציות של AI גנרטיבי באמצעות Gemini Enterprise ו-Agent Platform.
המאמרים הבאים
- איך Gemini Enterprise מחלק מסמכים ל-RAG
- איך מארחים אפליקציות וסוכני AI ב-Cloud Run
- מידע ולמידה על שיטות מומלצות לשימוש אחראי ב-AI ומסנני בטיחות ב-Agent Platform
- מידע על אסטרטגיות להנחיות למודלים גדולים של שפה (LLM)
- במאמר נקודת המבט של AI ו-ML ב-Well-Architected Framework מפורטים עקרונות והמלצות לארכיטקטורה שספציפיים לעומסי עבודה של AI ו-ML ב- Google Cloud.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחברת: סמנתה הי | כותבת טכנית
תורמים אחרים:
- דיפאק מייקל | מהנדס לקוחות מומחה לרשתות
- קומאר דהנגופאל | מפתח פתרונות למוצרים שונים
- מארק שלאגנהאוף | כותב טכני, רשתות
- ויקטור מורנו | מנהל מוצר, Cloud Networking
- Yehia Elshater | ארכיטקט פתרונות שטח, AI גנרטיבי, Google Cloud
- Paarth Mahajan | מומחה רשת, Google Cloud