


המסמך הזה הוא החלק השלישי בסדרה שעוסקת בתוכנית התאוששות מאסון (DR) ב- Google Cloud. בחלק הזה נדון בתרחישים של גיבוי ושחזור נתונים.
הסדרה כוללת את החלקים הבאים:
- מדריך להכנת תוכנית התאוששות מאסון (DR)
- אבני הבניין של תוכנית התאוששות מאסון (DR)
- תרחישים של תוכנית התאוששות מאסון (DR) לנתונים (המסמך הזה)
- תרחישים של תוכנית התאוששות מאסון (DR) לאפליקציות
- תכנון תוכנית התאוששות מאסון (DR) לעומסי עבודה שמוגבלים למיקום
- תרחישים לדוגמה של תוכנית התאוששות מאסון (DR): אפליקציות לניתוח נתונים שמוגבלות למיקום מסוים
- תכנון תוכנית התאוששות מאסון (DR) להפסקות זמניות בתשתית הענן
מבוא
בתוכניות ההתאוששות מאסון צריך לציין איך אפשר למנוע אובדן נתונים בזמן אסון. המונח נתונים מתייחס כאן לשני תרחישים. גיבוי ושחזור של מסד נתונים, נתוני יומן וסוגי נתונים אחרים מתאימים לאחד מהתרחישים הבאים:
- גיבויי נתונים. גיבוי נתונים בלבד כולל העתקה של כמות נתונים נפרדת ממקום אחד למקום אחר. גיבויים נוצרים כחלק מתוכנית שחזור, כדי לשחזר נתונים פגומים ולהחזיר אותם למצב תקין וידוע ישירות בסביבת הייצור, או כדי לשחזר נתונים בסביבת ה-DR אם סביבת הייצור מושבתת. בדרך כלל, לגיבויי נתונים יש RTO קטן עד בינוני ו-RPO קטן.
- גיבויים של מסדי נתונים. גיבויים של מסדי נתונים הם קצת יותר מורכבים, כי בדרך כלל הם כוללים שחזור לנקודת זמן מסוימת. לכן, בנוסף לשיקולים לגבי הגיבוי והשחזור של מסד הנתונים, ולווידוא שמערכת מסד הנתונים לשחזור משקפת את הגדרות הייצור (אותה גרסה, הגדרות דיסק משוכפלות), צריך גם לשקול איך לגבות את יומני העסקאות. במהלך השחזור, אחרי שמשחזרים את הפונקציונליות של מסד הנתונים, צריך להחיל את הגיבוי האחרון של מסד הנתונים ואז את יומני הטרנזקציות ששוחזרו וגובו אחרי הגיבוי האחרון. בגלל הגורמים המורכבים שקשורים למערכות של מסדי נתונים (למשל, הצורך להתאים בין הגרסאות של מערכות הייצור והשחזור), כדי להשיג ערכי RTO ו-RPO קטנים יותר, כדאי לאמץ גישה שמתעדפת זמינות גבוהה כדי לצמצם את הזמן שנדרש לשחזור ממצב שעלול לגרום לחוסר זמינות של שרת מסד הנתונים.
כשמריצים עומסי עבודה בסביבת הייצור ב- Google Cloud, אפשר להשתמש במערכת שמופצת באופן גלובלי, כך שאם משהו משתבש באזור אחד, האפליקציה ממשיכה לספק שירות גם אם הזמינות שלה פחות נרחבת. למעשה, האפליקציה הזו מפעילה את תוכנית ה-DR שלה.
בהמשך המאמר נציג דוגמאות לתכנון תרחישים לנתונים ולמסדי נתונים, שיעזרו לכם לעמוד ביעדי ה-RTO וה-RPO.
סביבת הייצור היא מקומית (on-premises)
בתרחיש הזה, סביבת הייצור היא מקומית, ותוכנית ההתאוששות מאסון כוללת שימוש ב- Google Cloud כאתר ההתאוששות.
גיבוי ושחזור נתונים
יש כמה אסטרטגיות שאפשר להשתמש בהן כדי להטמיע תהליך לגיבוי קבוע של נתונים מקומית ב- Google Cloud. בקטע הזה נסקור שניים מהפתרונות הנפוצים ביותר.
פתרון 1: גיבוי ב-Cloud Storage באמצעות משימה מתוזמנת
התבנית הזו משתמשת באבני הבניין הבאות של התאוששות מאסון:
- Cloud Storage
אפשרות אחת לגיבוי נתונים היא ליצור משימה מתוזמנת שמריצה סקריפט או אפליקציה כדי להעביר את הנתונים ל-Cloud Storage. אפשר להפוך את תהליך הגיבוי ל-Cloud Storage לאוטומטי באמצעות פקודת ה-CLI של Google Cloud gcloud storage או באמצעות אחת מספריות הלקוח של Cloud Storage.
לדוגמה, הפקודה הבאה של gcloud storage מעתיקה את כל הקבצים מספריית המקור לקטגוריה שצוינה.
gcloud storage cp -r SOURCE_DIRECTORY gs://BUCKET_NAME
מחליפים את SOURCE_DIRECTORY בנתיב לספריית קובצי המקור ואת BUCKET_NAME בשם שבוחרים לקטגוריה.
השם צריך לעמוד בדרישות לשמות של קטגוריות.
בשלבים הבאים מוסבר איך להטמיע תהליך גיבוי ושחזור באמצעות הפקודה gcloud storage.
- מתקינים את
gcloud CLIבמחשב המקומי שמשמש להעלאת קובצי הנתונים. - יוצרים קטגוריה כיעד לגיבוי הנתונים.
- יצירה של חשבון שירות.
- יוצרים מדיניות IAM כדי להגביל את הגישה לקטגוריה ולאובייקטים שבה. כוללים את חשבון השירות שנוצר במיוחד למטרה הזו. במאמר הרשאות IAM ל-
gcloud storageמפורטות ההרשאות שנדרשות כדי לגשת ל-Cloud Storage. - משתמשים בהתחזות לחשבון שירות כדי לתת למשתמש המקומי Google Cloud(או לחשבון השירות) גישה להתחזות לחשבון השירות שיצרתם קודם. לחלופין, אפשר ליצור משתמש חדש במיוחד למטרה הזו.
- בודקים שאפשר להעלות ולהוריד קבצים בקטגוריית היעד.
- מגדירים לוח זמנים לסקריפט שמשמש להעלאת הגיבויים באמצעות כלים כמו Linux
crontabומתזמן המשימות של Windows. - מגדירים תהליך שחזור שמשתמש בפקודה
gcloud storageכדי לשחזר את הנתונים לסביבת ה-DR לשחזור ב- Google Cloud.
אפשר גם להשתמש בפקודה gcloud storage rsync כדי לבצע סנכרונים מצטברים בזמן אמת בין הנתונים שלכם לבין קטגוריה של Cloud Storage.
לדוגמה, הפקודה הבאה של gcloud storage rsync מעתיקה את כל הקבצים או האובייקטים החסרים, או את אלה שהנתונים שלהם השתנו, כדי שהתוכן בקטגוריה של Cloud Storage יהיה זהה לתוכן בספריית קובצי המקור. אם נפח הנתונים שהשתנה בין סשנים עוקבים של גיבוי קטן ביחס לנפח הכולל של נתוני המקור, השימוש ב-gcloud storage rsync יכול להיות יעיל יותר מהשימוש בפקודה gcloud storage cp. באמצעות gcloud storage rsync, אתם יכולים להטמיע לוח זמנים תכוף יותר לגיבוי ולהשיג RPO נמוך יותר.
gcloud storage rsync -r SOURCE_DIRECTORY gs:// BUCKET_NAME
למידע נוסף, קראו את המאמר הפקודה gcloud storage להעברות קטנות יותר של נתונים מקומיים.
פתרון 2: גיבוי ב-Cloud Storage באמצעות שירות ההעברה לנתונים מקומיים
התבנית הזו משתמשת באבני הבניין הבאות של התאוששות מאסון:
- Cloud Storage
- שירות העברה לנתונים מקומיים
כדי להעביר כמויות גדולות של נתונים ברשת, בדרך כלל צריך לתכנן בקפידה את התהליך וליישם אסטרטגיות ביצוע חזקות. פיתוח סקריפטים בהתאמה אישית שניתנים להרחבה, אמינים וקלים לתחזוקה הוא משימה לא פשוטה. סקריפטים בהתאמה אישית יכולים לעיתים קרובות להוביל לערכי RPO נמוכים יותר, ואפילו להגביר את הסיכון לאובדן נתונים.
במאמר העברה או גיבוי של נתונים מאחסון מקומי מוסבר איך להעביר נפחים גדולים של נתונים ממיקומים מקומיים ל-Cloud Storage.
פתרון 3: גיבוי ב-Cloud Storage באמצעות פתרון שער של שותף
התבנית הזו משתמשת באבני הבניין הבאות של התאוששות מאסון:
- Cloud Interconnect
- אחסון מדורג ב-Cloud Storage
אפליקציות מקומיות משולבות לעיתים קרובות עם פתרונות של צד שלישי, שאפשר להשתמש בהם כחלק מאסטרטגיית הגיבוי והשחזור של הנתונים. בפתרונות האלה משתמשים בדרך כלל בתבנית אחסון מדורגת, שבה הגיבויים האחרונים נמצאים באחסון מהיר יותר, והגיבויים הישנים מועברים לאט לאט לאחסון זול יותר (איטי יותר). כשמשתמשים ב- Google Cloud כיעד, יש כמה אפשרויות של סוגי אחסון שאפשר להשתמש בהן כמקבילות לרמה האיטית יותר.
אחת מהדרכים ליישם את הדפוס הזה היא להשתמש בשער של שותף בין האחסון המקומי לבין Google Cloud כדי להקל על העברת הנתונים ל-Cloud Storage. בתרשים הבא מוצג הסידור הזה, עם פתרון של שותף שמנהל את ההעברה ממכשיר ה-NAS או ה-SAN המקומי.
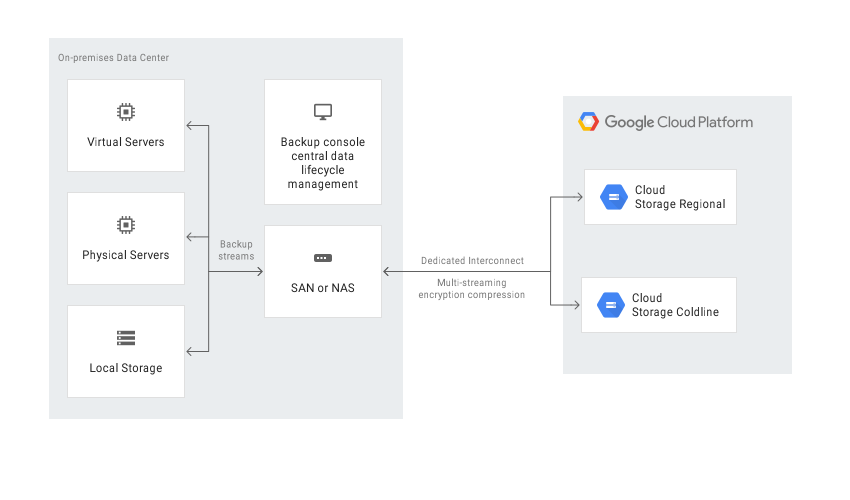
במקרה של כשל, צריך לשחזר את הנתונים שמגובים בסביבת ה-DR. סביבת ה-DR משמשת להצגת תנועה בסביבת הייצור עד שתוכלו לחזור לסביבת הייצור. הדרך לעשות זאת תלויה באפליקציה, בפתרון של השותף ובארכיטקטורה שלו. (חלק מהתרחישים מקצה לקצה מתוארים במסמך של אפליקציית DR).
אפשר גם להשתמש במסדי נתונים מנוהלים של Google Cloud כיעדי התאוששות מאסון. לדוגמה, Cloud SQL ל-SQL Server תומך בייבוא של יומני טרנזקציות. אתם יכולים לייצא את יומני הטרנזקציות מהמכונה המקומית של SQL Server, להעלות אותם ל-Cloud Storage ולייבא אותם ל-Cloud SQL ל-SQL Server.
במאמר העברת מערכי נתונים גדולים אל Google Cloud תוכלו לקרוא איך מעבירים נתונים מקומית אלGoogle Cloud.
למידע נוסף על פתרונות של שותפים, קראו את המאמר מציאת השותף המתאים של Google Cloud .
גיבוי ושחזור של מסד נתונים
יש כמה אסטרטגיות שאפשר להשתמש בהן כדי להטמיע תהליך לשחזור מערכת של מסד נתונים מקומית ב- Google Cloud. בקטע הזה נסקור שניים מהפתרונות הנפוצים ביותר.
במסמך הזה לא נדון בפירוט במנגנוני הגיבוי והשחזור המובנים השונים שכלולים במסדי נתונים של צד שלישי. בקטע הזה מופיעה הדרכה כללית, שמיושמת בפתרונות שמופיעים כאן.
פתרון 1: גיבוי ושחזור באמצעות שרת שחזור ב- Google Cloud
- יוצרים גיבוי של מסד הנתונים באמצעות מנגנוני הגיבוי המובנים של המערכת לניהול מסדי נתונים.
- חיבור הרשת המקומית לרשת Google Cloud .
- יוצרים קטגוריה של Cloud Storage כיעד לגיבוי הנתונים.
- מעתיקים את קובצי הגיבוי ל-Cloud Storage באמצעות
gcloud storageה-CLI של gcloud או פתרון שער של שותף (ראו את השלבים שפורטו קודם בקטע "גיבוי ושחזור של נתונים"). לפרטים, ראו העברה אל Google Cloud: העברת מערכי נתונים גדולים. - מעתיקים את יומני העסקאות לאתר השחזור ב- Google Cloud. גיבוי של יומני העסקאות עוזר לשמור על ערכי RPO קטנים.
אחרי שמגדירים את טופולוגיית הגיבוי הזו, צריך לוודא שאפשר לשחזר למערכת שנמצאת ב- Google Cloud. השלב הזה כולל בדרך כלל לא רק שחזור של קובץ הגיבוי למסד הנתונים של היעד, אלא גם הפעלה מחדש של יומני העסקאות כדי להגיע לערך ה-RTO הקטן ביותר. רצף שחזור אופייני נראה כך:
- יוצרים תמונה בהתאמה אישית של שרת מסד הנתונים ב- Google Cloud. שרת מסד הנתונים צריך להיות בעל אותה הגדרה בתמונה כמו שרת מסד הנתונים המקומי.
- מטמיעים תהליך להעתקת קובצי הגיבוי המקומיים וקובצי יומן הטרנזקציות ל-Cloud Storage. בפתרון 1 מופיעה דוגמה להטמעה.
- מפעילים מכונה בגודל מינימלי מהתמונה בהתאמה אישית ומצרפים את כל הדיסקים הנדרשים לאחסון מתמיד (persistent).
- מגדירים את דגל המחיקה האוטומטית לערך false בדיסקי אחסון מתמידים (persistent disk).
- מחילים את קובץ הגיבוי האחרון שהועתק קודם ל-Cloud Storage, לפי ההוראות של מערכת מסד הנתונים לשחזור קובצי גיבוי.
- מחילים את קובצי יומן הטרנזקציות האחרונים שהועתקו ל-Cloud Storage.
- מחליפים את המכונה המינימלית במכונה גדולה יותר שיכולה לקבל תנועה בסביבת הייצור.
- מעבירים את הלקוחות כך שיצביעו על מסד הנתונים ששוחזר ב- Google Cloud.
כשהסביבה שלכם פועלת ויכולה לתמוך בעומסי העבודה בסביבת הייצור, אתם צריכים לבצע בסדר הפוך את השלבים שביצעתם כדי לעבור למצב כשל בסביבת השחזור שלGoogle Cloud . רצף אופייני של חזרה לסביבת הייצור נראה כך:
- מגבים את מסד הנתונים שפועל ב- Google Cloud.
- מעתיקים את קובץ הגיבוי לסביבת הייצור.
- מחילים את קובץ הגיבוי על מערכת מסד הנתונים בסביבת הייצור.
- מונעים מלקוחות להתחבר למערכת מסד הנתונים ב-Google Cloud, למשל על ידי עצירת השירות של מערכת מסד הנתונים. מעכשיו, האפליקציה לא תהיה זמינה עד שתסיימו לשחזר את סביבת הייצור.
- מעתיקים את כל קובצי יומן העסקאות לסביבת הייצור ומחילים אותם.
- מפנים את החיבורים של הלקוחות לסביבת הייצור.
פתרון 2: שכפול לשרת המתנה ב- Google Cloud
אחת הדרכים להשיג ערכי RTO ו-RPO קטנים מאוד היא לשכפל (לא רק לגבות) נתונים, ובמקרים מסוימים את מצב מסד הנתונים בזמן אמת, לרפליקה של שרת מסד הנתונים.
- מחברים את הרשת המקומית לרשת Google Cloud .
- יוצרים תמונה בהתאמה אישית של שרת מסד הנתונים ב- Google Cloud. התצורה של שרת מסד הנתונים בתמונה צריכה להיות זהה לתצורה של שרת מסד הנתונים המקומי.
- מפעילים מכונה מהאימג' בהתאמה אישית ומצרפים את כל הדיסקים הנדרשים לאחסון מתמיד.
- מגדירים את דגל המחיקה האוטומטית לערך false בדיסקי אחסון מתמידים (persistent disk).
- מגדירים את הרפליקציה בין שרת מסד הנתונים המקומי לבין שרת מסד הנתונים המיועד ב- Google Cloud , לפי ההוראות הספציפיות לתוכנת מסד הנתונים.
- במצב רגיל, הלקוחות מוגדרים להצביע על שרת מסד הנתונים המקומי.
אחרי שמגדירים את טופולוגיית הרפליקציה הזו, מעבירים את הלקוחות כך שיצביעו על השרת במצב המתנה שפועל ברשת Google Cloud .
כשהסביבה שלכם חוזרת לפעול ויכולה לתמוך בעומסי עבודה, אתם צריכים לסנכרן מחדש את שרת מסד הנתונים של סביבת הייצור עם שרת מסד הנתונים שלGoogle Cloud , ואז להעביר את הלקוחות כך שיצביעו בחזרה לסביבת הייצור.
סביבת הייצור היא Google Cloud
בתרחיש הזה, גם סביבת הייצור וגם סביבת ה-DR פועלות ב- Google Cloud.
גיבוי ושחזור נתונים
דפוס נפוץ לגיבוי נתונים הוא שימוש בדפוס אחסון מדורג. כשהעומס בעבודה בסביבת הייצור נמצא ב- Google Cloud, מערכת האחסון השכבתית נראית כמו בתרשים הבא. אתם מעבירים נתונים לרמה עם עלויות אחסון נמוכות יותר, כי סביר להניח שלא תצטרכו לגשת לנתונים שגובו.
התבנית הזו משתמשת באבני הבניין הבאות של התאוששות מאסון:
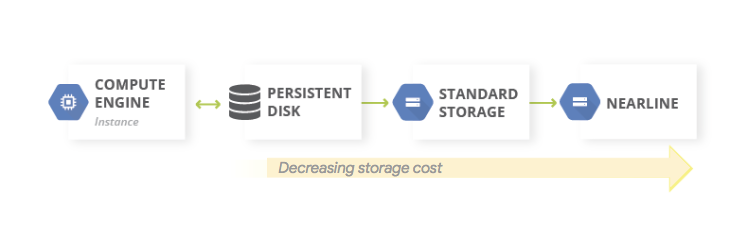
סוגי האחסון Nearline, Coldline ו-Archive Storage מיועדים לאחסון נתונים שניגשים אליהם לעיתים רחוקות, ולכן יש עלויות נוספות שקשורות לאחזור נתונים או מטא-נתונים שמאוחסנים בסוגי האחסון האלה, וגם משכי אחסון מינימליים שעליהם אתם מחויבים.
גיבוי ושחזור של מסד נתונים
כשמשתמשים במסד נתונים בניהול עצמי (לדוגמה, אם התקנתם את MySQL, PostgreSQL או SQL Server במכונה של Compute Engine), חלים אותם שיקולים תפעוליים כמו בניהול מסדי נתונים בסביבה המקומית, אבל לא צריך יותר לנהל את התשתית הבסיסית.
שירות Backup and DR הוא פתרון מרוכז ומבוסס-ענן לגיבוי ולשחזור של עומסי עבודה בענן ובעומסי עבודה היברידיים. הוא מאפשר שחזור נתונים מהיר וחזרה מהירה לפעילות עסקית חיונית.
למידע נוסף על השימוש ב-Backup and DR בתרחישים של מסדי נתונים בניהול עצמי ב- Google Cloud:
לחלופין, אפשר להגדיר זמינות גבוהה באמצעות התכונות המתאימות של אבני הבניין להתאוששות מאסון, כדי לשמור על RTO קטן. אתם יכולים לתכנן את הגדרת מסד הנתונים כך שיהיה אפשר לשחזר את המצב הקרוב ביותר למצב שלפני האסון, וכך לשמור על ערכי RPO קטנים. ב- Google Cloud יש מגוון רחב של אפשרויות לתרחיש הזה.
בקטע הזה נדון בשתי גישות נפוצות לתכנון ארכיטקטורת שחזור של מסדי נתונים בניהול עצמי ב- Google Cloud .
שחזור שרת מסד נתונים בלי לסנכרן את המצב
דפוס נפוץ הוא לאפשר שחזור של שרת מסד נתונים שלא דורש סנכרון של מצב המערכת עם עותק גיבוי עדכני.
התבנית הזו משתמשת באבני הבניין הבאות של התאוששות מאסון:
- Compute Engine
- קבוצות מופעי מכונה מנוהלים
- Cloud Load Balancing (איזון עומסים פנימי)
התרשים הבא ממחיש ארכיטקטורה לדוגמה שמתאימה לתרחיש הזה. אם תטמיעו את הארכיטקטורה הזו, תהיה לכם תוכנית להתאוששות מאסון שמגיבה באופן אוטומטי לכשל, בלי שתצטרכו לבצע שחזור ידני.
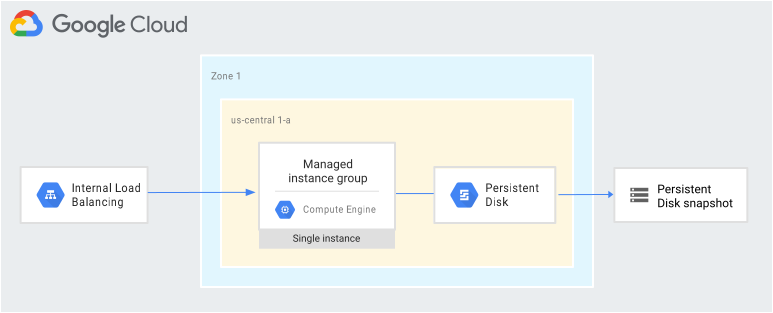
כך מגדירים את התרחיש הזה:
- יוצרים רשת VPC.
כדי ליצור תמונה בהתאמה אישית שמוגדרת עם שרת מסד הנתונים:
- מגדירים את השרת כך שקובצי מסד הנתונים וקובצי היומן ייכתבו בדיסק מתמיד סטנדרטי שמחובר אליו.
- יוצרים קובץ snapshot מדיסק האחסון המתמיד (persistent disk) המצורף.
- מגדירים סקריפט לטעינה בזמן ההפעלה כדי ליצור דיסק של אחסון מתמיד (persistent disk) מקובץ ה-snapshot ולטעון את הדיסק.
- יוצרים קובץ אימג' בהתאמה אישית של דיסק האתחול.
יוצרים תבנית של הגדרות מכונה שמשתמשת בתמונה.
משתמשים בתבנית של הגדרות המכונה כדי להגדיר קבוצת מופעי מכונה מנוהלים עם גודל יעד של 1.
להגדיר בדיקת תקינות באמצעות מדדי Cloud Monitoring.
מגדירים איזון עומסים פנימי באמצעות קבוצת מופעי המכונה המנוהלים.
מגדירים משימה מתוזמנת ליצירת קובצי snapshot רגילים של הדיסק הקבוע.
אם צריך להחליף את המכונה של מסד הנתונים, ההגדרה הזו מבצעת באופן אוטומטי את הפעולות הבאות:
- העלאת שרת מסד נתונים אחר של הגרסה הנכונה באותו אזור.
- מחברים דיסק אחסון מתמיד (persistent disk) עם קובצי הגיבוי ויומן הטרנזקציות העדכניים למכונה החדשה של שרת מסד הנתונים.
- מצמצם את הצורך להגדיר מחדש לקוחות שמתקשרים עם שרת מסד הנתונים בתגובה לאירוע.
- מוודאים שאמצעי האבטחה (מדיניות IAM, הגדרות חומת האש) שחלים על שרת מסד הנתונים בסביבת הייצור חלים גם על שרת מסד הנתונים ששוחזר. Google Cloud
מכיוון שהמכונה החלופית נוצרת מתבנית של הגדרות מכונה, אמצעי הבקרה שהוחלו על המכונה המקורית חלים גם על המכונה החלופית.
בתרחיש הזה נעשה שימוש בחלק מהתכונות של זמינות גבוהה שקיימות ב-Google Cloud. לא צריך להפעיל שלבים של יתירות כשל, כי הם מתרחשים באופן אוטומטי במקרה של אסון. מאזן העומסים הפנימי מבטיח שגם כשצריך מכונה חלופית, אותה כתובת IP משמשת לשרת מסד הנתונים. תבנית של הגדרות המכונה והתמונה בהתאמה אישית מבטיחות שהמכונה החלופית תוגדר באופן זהה למכונה שהיא מחליפה. אם יוצרים תמונות מצב של הדיסקים הקבועים באופן קבוע, אפשר לוודא שכאשר הדיסקים נוצרים מחדש מתמונות המצב ומחוברים למכונה החלופית, המכונה החלופית משתמשת בנתונים ששוחזרו בהתאם לערך RPO שנקבע לפי תדירות תמונות המצב. בארכיטקטורה הזו, קובצי יומן הטרנזקציות האחרונים שנכתבו לדיסק אחסון מתמיד (persistent disk) משוחזרים גם הם באופן אוטומטי.
קבוצת מופעי מכונה מנוהלים מספקת זמינות גבוהה (HA) לעומק. הוא מספק מנגנונים להגיב לכשלים ברמת האפליקציה או המכונה, ולא צריך להתערב באופן ידני אם אחד מהתרחישים האלה מתרחש. הגדרת גודל יעד של 1 מבטיחה שיהיה לכם רק מופע פעיל אחד שפועל בקבוצת מופעי מכונה מנוהלים ומטפל בתנועה.
דיסקים מתמידים סטנדרטיים הם אזוריים, כך שאם יש כשל אזורי, נדרשים קובצי snapshot כדי ליצור מחדש את הדיסקים. אפשר גם להשתמש בתמונות מצב בין אזורים, כדי לשחזר דיסק לא רק באותו אזור אלא גם באזור אחר.
וריאציה של ההגדרה הזו היא להשתמש בדיסקים אזוריים לאחסון מתמיד במקום בדיסקים רגילים לאחסון מתמיד. במקרה כזה, לא צריך לשחזר את קובץ ה-snapshot כחלק משלב השחזור.
הווריאציה שתבחרו תלויה בתקציב ובערכי ה-RTO וה-RPO שלכם.
שחזור ממסדי נתונים גדולים מאוד שהושחתו חלקית
רפליקציה אסינכרונית של Persistent Disk: מאפשרת רפליקציה של אחסון בלוקים עם RPO נמוך ו-RTO נמוך להתאוששות מאסון (DR) אקטיבית-פסיבית באזורים שונים. אפשרות האחסון הזו מאפשרת לכם לנהל את הרפליקציה של עומסי העבודה ב-Compute Engine ברמת התשתית, ולא ברמת עומס העבודה.
אם אתם משתמשים במסד נתונים שיכול לאחסן פטה-בייטים של נתונים, יכול להיות שתחוו הפסקה שמשפיעה על חלק מהנתונים, אבל לא על כולם. במקרה כזה, תרצו לצמצם את כמות הנתונים שצריך לשחזר. לא תצטרכו (או תרצו) לשחזר את כל מסד הנתונים רק כדי לשחזר חלק מהנתונים.
יש כמה אסטרטגיות שאפשר לאמץ כדי לצמצם את ההשפעה:
- לאחסן את הנתונים בטבלאות שונות לתקופות זמן ספציפיות. בשיטה הזו צריך לשחזר רק קבוצת משנה של נתונים לטבלה חדשה, ולא מערך נתונים שלם.
אחסון הנתונים המקוריים ב-Cloud Storage. בגישה הזו אפשר ליצור טבלה חדשה ולטעון מחדש את הנתונים שלא נפגמו. משם, תוכלו לשנות את האפליקציות כך שיפנו לטבלה החדשה.
בנוסף, אם ה-RTO מאפשר זאת, אתם יכולים למנוע גישה לטבלה עם הנתונים הפגומים על ידי השארת האפליקציות במצב אופליין עד שהנתונים התקינים ישוחזרו לטבלה חדשה.
שירותים מנוהלים של מסדי נתונים ב- Google Cloud
בקטע הזה נסביר על כמה שיטות שבהן אפשר להשתמש כדי להטמיע מנגנוני גיבוי ושחזור מתאימים לשירותי מסדי הנתונים המנוהלים ב-Google Cloud.
מסדי נתונים מנוהלים מיועדים לשינוי קנה מידה, ולכן בדרך כלל לא זמינים בהם מנגנוני הגיבוי והשחזור המסורתיים שרואים במערכות RDMBS מסורתיות. כמו במקרה של מסדי נתונים בניהול עצמי, אם אתם משתמשים במסד נתונים שיכול לאחסן פטה-בייטים של נתונים, כדאי למזער את כמות הנתונים שצריך לשחזר בתרחיש של התאוששות מאסון. יש כמה אסטרטגיות לכל מסד נתונים מנוהל שיעזרו לכם להשיג את המטרה הזו.
ב-Bigtable יש רפליקציה של Bigtable. מסד נתונים משוכפל של Bigtable יכול לספק זמינות גבוהה יותר מאשר אשכול יחיד, תפוקת קריאה נוספת, עמידות גבוהה יותר ויכולת התאוששות טובה יותר במקרה של כשלים אזוריים.
גיבויים ב-Bigtable הם שירות שמנוהל במלואו, שמאפשר לשמור עותק של הסכימה והנתונים של טבלה, ואז לשחזר מהגיבוי לטבלה חדשה במועד מאוחר יותר.
אפשר גם לייצא טבלאות מ-Bigtable כסדרה של קובצי רצף של Hadoop. אחר כך תוכלו לאחסן את הקבצים האלה ב-Cloud Storage או להשתמש בהם כדי לייבא את הנתונים חזרה למכונה אחרת של Bigtable. אתם יכולים לשכפל את מערך הנתונים של Bigtable באופן אסינכרוני בין אזורים בתוך Google Cloud אזור.
BigQuery. אם אתם רוצים להעביר נתונים לארכיון, אתם יכולים להשתמש באחסון לטווח ארוך של BigQuery. אם טבלה לא נערכת במשך 90 ימים רצופים, מחיר האחסון של הטבלה הזו יורד אוטומטית ב-50 אחוזים. אין פגיעה בביצועים, בעמידות, בזמינות או בכל פונקציונליות אחרת כשטבלה נחשבת לאחסון לטווח ארוך. עם זאת, אם הטבלה נערכת, היא חוזרת לתמחור האחסון הרגיל והספירה לאחור של 90 הימים מתחילה מחדש.
BigQuery משוכפל לשני אזורים באותו מחוז, אבל זה לא יעזור אם הטבלאות שלכם נפגמו. לכן, אתם צריכים שתהיה לכם תוכנית להתאוששות מתרחיש כזה. לדוגמה, אתם יכולים:
- אם הפגיעה בנתונים מתגלה תוך 7 ימים, אפשר לשלוח שאילתה לטבלה בנקודת זמן בעבר כדי לשחזר את הטבלה לפני הפגיעה בנתונים באמצעות מעצבי תמונת מצב.
- מייצאים את הנתונים מ-BigQuery ויוצרים טבלה חדשה שמכילה את הנתונים שיוצאו, אבל לא את הנתונים הפגומים.
- לאחסן את הנתונים בטבלאות שונות לתקופות זמן ספציפיות. כך תצטרכו לשחזר רק קבוצת משנה של נתונים לטבלה חדשה, ולא מערך נתונים שלם.
- ליצור עותקים של מערך הנתונים בפרקי זמן ספציפיים. אתם יכולים להשתמש בעותקים האלה אם אירוע של פגיעה בנתונים התרחש מעבר למה ששאילתה בנקודת זמן יכולה לתעד (לדוגמה, לפני יותר מ-7 ימים). אתם יכולים גם להעתיק מערך נתונים מאזור אחד לאזור אחר כדי להבטיח את זמינות הנתונים במקרה של כשלים באזור.
- לאחסן את הנתונים המקוריים ב-Cloud Storage, כדי שתוכלו ליצור טבלה חדשה ולטעון מחדש את הנתונים התקינים. משם, תוכלו לשנות את האפליקציות כך שיפנו לטבלה החדשה.
Firestore. שירות הייבוא והייצוא המנוהל מאפשר לייבא ולייצא ישויות של Firestore באמצעות קטגוריה של Cloud Storage. לאחר מכן תוכלו להטמיע תהליך שישמש לשחזור נתונים שנמחקו בטעות.
Cloud SQL. אם אתם משתמשים ב-Cloud SQL, מסד הנתונים המנוהל שלGoogle Cloud MySQL, כדאי להפעיל גיבויים אוטומטיים ורישום ביומן בינארי למכונות של Cloud SQL. בגישה הזו אפשר לבצע שחזור מערכת מנקודה מסוימת בזמן (PITR), שמשחזר את מסד הנתונים מגיבוי ומשחזר אותו למכונה חדשה של Cloud SQL. מידע נוסף זמין במאמרים מידע על גיבויים ב-Cloud SQL ומידע על תוכנית התאוששות מאסון (DR) ב-Cloud SQL.
כדי למקסם את זמן הפעילות במקרה של כשל באזור או בתחום, אפשר גם להגדיר את Cloud SQL בתצורת זמינות גבוהה ועותקים משוכפלים באזורים שונים.
אם הפעלתם תחזוקה מתוכננת עם זמן השבתה כמעט אפסי ב-Cloud SQL, אתם יכולים להעריך את ההשפעה של אירועי התחזוקה על המכונות שלכם על ידי הדמיה של אירועי תחזוקה מתוכננת עם זמן השבתה כמעט אפסי ב-Cloud SQL ל-MySQL וב-Cloud SQL ל-PostgreSQL.
ב-Cloud SQL Enterprise Plus, אתם יכולים להשתמש בתוכנית מתקדמת להתאוששות מאסון (DR) כדי לפשט את תהליכי ההתאוששות והחזרה למצב הקודם בלי לאבד נתונים, אחרי שאתם מבצעים מעבר לגיבוי בעת כשל בין אזורים.
Spanner. אתם יכולים להשתמש בתבניות של Dataflow כדי לייצא את מסד הנתונים במלואו לקבוצה של קובצי Avro בקטגוריה של Cloud Storage, ולהשתמש בתבנית אחרת כדי לייבא מחדש את הקבצים שיוצאו למסד נתונים חדש ב-Spanner.
כדי ליצור גיבויים מבוקרים יותר, המחבר של Dataflow מאפשר לכם לכתוב קוד לקריאה ולכתיבה של נתונים ב-Spanner בצינור עיבוד נתונים של Dataflow. לדוגמה, אתם יכולים להשתמש במחבר כדי להעתיק נתונים מ-Spanner אל Cloud Storage כיעד הגיבוי. המהירות שבה אפשר לקרוא נתונים מ-Spanner (או לכתוב אליו בחזרה) תלויה במספר הצמתים שהוגדרו. זה משפיע ישירות על ערכי ה-RTO.
התכונה חותמת זמן של ביצוע שינויים ב-Spanner יכולה להיות שימושית לגיבויים מצטברים, כי היא מאפשרת לבחור רק את השורות שנוספו או שונו מאז הגיבוי המלא האחרון.
לגיבויים מנוהלים, Spanner Backup and Restore מאפשר ליצור גיבויים עקביים שאפשר לשמור עד שנה. ערך ה-RTO נמוך יותר בהשוואה לייצוא, כי פעולת השחזור טוענת ישירות את הגיבוי בלי להעתיק את הנתונים.
אם ערכי ה-RTO קטנים, אפשר להגדיר מכונת Spanner במצב המתנה חמה עם מספר הצמתים המינימלי שנדרש כדי לעמוד בדרישות האחסון וקצב העברת הנתונים בקריאה ובכתיבה.
שחזור מערכת מנקודה מסוימת בזמן (PITR) ב-Spanner מאפשר לשחזר נתונים מנקודה מסוימת בזמן בעבר. לדוגמה, אם מפעיל כותב נתונים בטעות או שהשקת אפליקציה משחיתה את מסד הנתונים, באמצעות PITR אפשר לשחזר את הנתונים מנקודת זמן בעבר, עד למקסימום של 7 ימים.
Managed Airflow. אתם יכולים להשתמש ב-Managed Airflow (גרסה מנוהלת של Apache Airflow) כדי לתזמן גיבויים קבועים של כמה מסדי נתונים ב-Google Cloud . אתם יכולים ליצור גרף אציקלי מכוון (DAG) שיפעל לפי לוח זמנים (למשל, מדי יום) כדי להעתיק את הנתונים לפרויקט, למערך נתונים או לטבלה אחרים (בהתאם לפתרון שבו אתם משתמשים), או כדי לייצא את הנתונים ל-Cloud Storage.
אפשר לייצא או להעתיק נתונים באמצעות האופרטורים השונים של Cloud Platform.
לדוגמה, אתם יכולים ליצור DAG כדי לבצע את הפעולות הבאות:
- ייצוא טבלה ב-BigQuery ל-Cloud Storage באמצעות BigQueryToCloudStorageOperator.
- ייצוא של Firestore במצב Datastore (Datastore) ל-Cloud Storage באמצעות DatastoreExportOperator.
- ייצוא טבלאות MySQL ל-Cloud Storage באמצעות MySqlToGoogleCloudStorageOperator.
- מייצאים טבלאות Postgres ל-Cloud Storage באמצעות PostgresToGoogleCloudStorageOperator.
סביבת הייצור היא ענן אחר
בתרחיש הזה, סביבת הייצור שלכם משתמשת בספק שירותי ענן אחר, ותוכנית ההתאוששות מאסון כוללת שימוש ב- Google Cloud כאתר ההתאוששות.
גיבוי ושחזור נתונים
העברת נתונים בין מאגרי אובייקטים היא תרחיש שימוש נפוץ בתרחישי DR. Storage Transfer Service תואם ל-Amazon S3, והוא הדרך המומלצת להעביר אובייקטים מ-Amazon S3 ל-Cloud Storage.
אפשר להגדיר משימת העברה כדי לתזמן סנכרון תקופתי ממקור הנתונים ל-data sink, עם מסננים מתקדמים שמבוססים על תאריכי יצירת הקבצים, מסננים של שמות קבצים והשעות ביום שבהן אתם מעדיפים להעביר נתונים. כדי להשיג את ה-RPO הרצוי, צריך להביא בחשבון את הגורמים הבאים:
קצב השינוי. כמות הנתונים שנוצרים או מתעדכנים בפרק זמן נתון. ככל שקצב השינוי גבוה יותר, כך נדרשים יותר משאבים כדי להעביר את השינויים ליעד בכל תקופת העברה מצטברת.
ביצועי ההעברה. הזמן שלוקח להעביר קבצים. בהעברות של קבצים גדולים, בדרך כלל זה נקבע לפי רוחב הפס הזמין בין המקור ליעד. עם זאת, אם משימת ההעברה כוללת מספר גדול של קבצים קטנים, QPS יכול להפוך לגורם מגביל. במקרה כזה, אפשר לתזמן כמה משימות בו-זמנית כדי לשפר את הביצועים, כל עוד יש מספיק רוחב פס. מומלץ למדוד את ביצועי ההעברה באמצעות קבוצת משנה מייצגת של הנתונים האמיתיים.
תדירות. המרווח בין משימות הגיבוי. עדכניות הנתונים ביעד תלויה במועד האחרון שבו תזמנתם את משימת ההעברה. לכן חשוב שהמרווחים בין משימות העברה עוקבות לא יהיו ארוכים יותר מיעד ה-RPO. לדוגמה, אם יעד ה-RPO הוא יום אחד, צריך לתזמן את משימת ההעברה לפחות פעם ביום.
מעקב והתראות. שירות Storage Transfer Service מספק התראות Pub/Sub במגוון אירועים. מומלץ להירשם להתראות האלה כדי לטפל בכשלים בלתי צפויים או בשינויים בזמני השלמת המשימות.
גיבוי ושחזור של מסד נתונים
במסמך הזה לא נדון בפירוט במנגנוני הגיבוי והשחזור המובְנים השונים שכלולים במסדי נתונים של צד שלישי, או בשיטות הגיבוי והשחזור שבהן משתמשים ספקי שירותי ענן אחרים. אם אתם מפעילים מסדי נתונים לא מנוהלים בשירותי המחשוב, אתם יכולים לנצל את מתקני הזמינות הגבוהה שזמינים אצל ספק שירותי הענן שלכם בסביבת הייצור. אפשר להרחיב את הפתרונות האלה כדי לשלב פריסת HA ב- Google Cloud, או להשתמש ב-Cloud Storage כיעד הסופי לאחסון קר של קובצי הגיבוי של מסד הנתונים.
מה השלב הבא?
- Google Cloud מידע נוסף על מיקום גיאוגרפי ואזורים
מסמכים נוספים בסדרה הזו בנושא התאוששות מאסון:
- מדריך להכנת תוכנית התאוששות מאסון (DR)
- אבני הבניין של תוכנית התאוששות מאסון (DR)
- תרחישים של תוכנית התאוששות מאסון (DR) לאפליקציות
- תכנון תוכנית התאוששות מאסון (DR) לעומסי עבודה שמוגבלים למיקום
- תרחישים לדוגמה של תוכנית התאוששות מאסון (DR): אפליקציות לניתוח נתונים שמוגבלות למיקום מסוים
- תכנון תוכנית התאוששות מאסון (DR) להפסקות זמניות בתשתית הענן
- ארכיטקטורות לזמינות גבוהה של אשכולות MySQL ב-Compute Engine
כדאי להעמיק את הקריאה ולהכיר דוגמאות לארכיטקטורות, תרשימים ושיטות מומלצות בנושאי Google Cloud. כל אלה זמינים במרכז הארכיטקטורה של Cloud.