


המסמך הזה הוא החלק השני בסדרה שעוסקת בתוכנית התאוששות מאסון (DR) ב- Google Cloud. בחלק הזה נדון בשירותים ובמוצרים שבהם אתם יכולים להשתמש כאבני בניין לתוכנית ה-DR שלכם – גם מוצרים של Google Cloud וגם מוצרים שפועלים בפלטפורמות שונות.
הסדרה כוללת את החלקים הבאים:
- מדריך להכנת תוכנית התאוששות מאסון (DR)
- אבני הבניין של תוכנית התאוששות מאסון (המאמר הזה)
- תרחישים של תוכנית התאוששות מאסון (DR) לנתונים
- תרחישים של תוכנית התאוששות מאסון (DR) לאפליקציות
- תכנון תוכנית התאוששות מאסון (DR) לעומסי עבודה שמוגבלים למיקום
- תרחישים לדוגמה של תוכנית התאוששות מאסון (DR): אפליקציות לניתוח נתונים שמוגבלות למיקום מסוים
- תכנון תוכנית התאוששות מאסון (DR) להפסקות זמניות בתשתית הענן
ב-Google Cloud יש מגוון רחב של מוצרים שאפשר להשתמש בהם כחלק מארכיטקטורת ההתאוששות מאסון. בקטע הזה נדון בתכונות שקשורות להתאוששות מאסון במוצרים שהכי נפוץ להשתמש בהם כאבני בניין של Google Cloud התאוששות מאסון.
להרבה מהשירותים האלה יש תכונות של זמינות גבוהה (HA). זמינות גבוהה לא חופפת לגמרי להתאוששות מאסון, אבל הרבה מהיעדים של זמינות גבוהה רלוונטיים גם לתכנון של תוכנית התאוששות מאסון. לדוגמה, בעזרת תכונות של זמינות גבוהה, אתם יכולים לתכנן ארכיטקטורות שמבצעות אופטימיזציה של זמן הפעולה התקינה, ויכולות לצמצם את ההשפעות של כשלים בקנה מידה קטן, כמו כשל במכונה וירטואלית אחת. למידע נוסף על הקשר בין DR ל-HA, קראו את המדריך לתכנון התאוששות מאסון.
בקטעים הבאים מתוארים אבני הבניין האלה של Google Cloud DR ואיך הם עוזרים לכם להשיג את יעדי ה-DR.
מחשוב ואחסון
בטבלה הבאה מופיע סיכום של התכונות בשירותי המחשוב והאחסון של Google Cloud , שמשמשים כאבני בניין להתאוששות מאסון:
| מוצר | תכונה |
|---|---|
| Compute Engine |
|
| Cloud Storage |
|
| Google Kubernetes Engine (GKE) |
|
במאמר תכנון התאוששות מאסון (DR) להפסקות זמניות בשירות של תשתית הענן: חומר עזר למוצר מוסבר איך התכונות והעיצוב של מוצריGoogle Cloud האלה ושל מוצרים אחרים יכולים להשפיע על אסטרטגיית ה-DR שלכם.
Compute Engine
Compute Engine מספק מכונות וירטואליות (VM) והוא הכלי העיקרי של Google Cloud. בנוסף להגדרה, להפעלה ולמעקב אחרי מכונות Compute Engine, בדרך כלל משתמשים במגוון תכונות קשורות כדי להטמיע תוכנית להתאוששות מאסון.
בתרחישים של DR, אתם יכולים להגדיר את דגל ההגנה מפני מחיקה כדי למנוע מחיקה בטעות של מכונות וירטואליות. האפשרות הזו שימושית במיוחד כשמארחים שירותים עם שמירת מצב (stateful), כמו מסדי נתונים.
במאמר תכנון מערכות עמידות מוסבר איך לעמוד בערכי RTO ו-RPO נמוכים.
תבניות של הגדרות מכונה
אתם יכולים להשתמש בתבניות של הגדרות מכונה ב-Compute Engine כדי לשמור את פרטי ההגדרות של ה-VM, ואז ליצור מכונות Compute Engine מתבניות קיימות של הגדרות מכונה. אתם יכולים להשתמש בתבנית כדי להפעיל כמה מכונות שאתם צריכים, שמוגדרות בדיוק כמו שאתם רוצים, כשאתם צריכים להגדיר את סביבת היעד של ה-DR. תבניות של הגדרות מכונה משוכפלות באופן גלובלי, כך שאפשר ליצור מחדש את המכונה בכל מקום ב- Google Cloud עם אותן הגדרות.
מידע נוסף זמין במקורות המידע הבאים:
לפרטים על השימוש בתמונות של Compute Engine, קראו את הקטע איזון בין הגדרת התמונה לבין מהירות הפריסה בהמשך המאמר.
קבוצות מופעי מכונה מנוהלים
קבוצות מופעי מכונה מנוהלים פועלות עם Cloud Load Balancing (שנדון בהמשך המסמך) כדי לפזר את התנועה לקבוצות של מופעים עם הגדרות זהות, שמועתקים בין אזורים. קבוצות של מופעי מכונה מנוהלים מאפשרות תכונות כמו התאמה אוטומטית לעומס (autoscaling) ותיקון תוכנה אוטומטי (autohealing), שבהן קבוצת מופעי המכונה המנוהלים יכולה למחוק וליצור מחדש מופעים באופן אוטומטי.
הזמנות
ב-Compute Engine אפשר לשריין מכונות וירטואליות באזור ספציפי, באמצעות סוגי מכונות בהתאמה אישית או עם קונפיגורציה מוגדרת (predefined), עם או בלי מעבדי GPU או כונני SSD מקומיים נוספים. כדי להבטיח קיבולת לעומסי העבודה הקריטיים שלכם להתאוששות מאסון, כדאי ליצור הקצאות באזורי היעד להתאוששות מאסון. בלי מקומות שמורים, יכול להיות שלא תקבלו את הקיבולת על פי דרישה שאתם צריכים כדי לעמוד ביעד זמן ההתאוששות. מקומות שמורים יכולים להיות שימושיים בתרחישי DR קרים, חמימים או חמים. הם מאפשרים לשמור על זמינות של משאבי שחזור ליתירות כשל כדי לעמוד בדרישות של RTO נמוך יותר, בלי צורך להגדיר ולפרוס אותם באופן מלא מראש.
דיסקים לאחסון מתמיד ותמונות מצב
דיסקים לאחסון מתמיד הם התקני אחסון עמידים ברשת, שהמכונות שלכם יכולות לגשת אליהם. הם לא תלויים במכונות, כך שאפשר לנתק ולהעביר דיסקים קבועים כדי לשמור את הנתונים גם אחרי שמוחקים את המכונות.
אתם יכולים ליצור גיבויים מצטברים או תמונות מצב של מכונות וירטואליות ב-Compute Engine, להעתיק אותם בין אזורים ולהשתמש בהם כדי ליצור מחדש דיסקים לאחסון מתמיד במקרה של אסון. בנוסף, אתם יכולים ליצור קובצי snapshot של Persistent Disk כדי להגן מפני אובדן נתונים כתוצאה משגיאת משתמש. התמונות הן מצטברות, ונוצרות תוך דקות ספורות גם אם הדיסקים של התמונות מצורפים למכונות פועלות.
בדיסקי אחסון מתמידים (persistent disk) יש יתירות מובנית כדי להגן על הנתונים מפני כשל בציוד, ולהבטיח את זמינות הנתונים במהלך אירועי תחזוקה של מרכז הנתונים. דיסקים לאחסון מתמיד יכולים להיות אזוריים או של תחום מוגדר. דיסקים אזוריים מסוג Persistent Disk משכפלים את פעולות הכתיבה בשני תחומים (zones) באזור. במקרה של הפסקה זמנית בשירות בתחום, מופע VM לגיבוי יכול לאלץ חיבור של Persistent Disk אזורי בתחום המשני. מידע נוסף זמין במאמר אפשרויות לזמינות גבוהה באמצעות Persistent Disk אזוריים.
תחזוקה שקופה
Google מתחזקת את תשתית ה-IT שלה באופן קבוע על ידי תיקון מערכות באמצעות התוכנה העדכנית ביותר, ביצוע בדיקות שגרתיות ותחזוקה מונעת, ופועלת כדי להבטיח שתשתית ה-IT של Google תהיה מהירה ויעילה ככל האפשר.
כברירת מחדל, כל המכונות של Compute Engine מוגדרות כך שאירועי התחזוקה האלה יהיו שקופים לאפליקציות ולעומסי העבודה שלכם. מידע נוסף מופיע במאמר תחזוקה שקופה.
כשמתרחש אירוע תחזוקה, Compute Engine משתמש במיגרציה פעילה כדי להעביר באופן אוטומטי את המכונות הפועלות למארח אחר באותו אזור. המיגרציה הפעילה מאפשרת ל-Google לבצע פעולות תחזוקה שחיוניות לשמירה על ההגנה והאמינות של התשתית, בלי להפריע למכונות הווירטואליות שלכם.
כלי לייבוא דיסק וירטואלי
הכלי ייבוא דיסק וירטואלי מאפשר לייבא פורמטים של קבצים, כולל VMDK, VHD ו-RAW, כדי ליצור מכונות וירטואליות חדשות ב-Compute Engine. באמצעות הכלי הזה, אתם יכולים ליצור מכונות וירטואליות של Compute Engine עם אותה הגדרה כמו של המכונות הווירטואליות המקומיות שלכם. זו גישה טובה כשאי אפשר להגדיר קובצי אימג' של Compute Engine מקובצי המקור הבינאריים של תוכנה שכבר מותקנת בקובצי האימג'.
גיבויים אוטומטיים
אתם יכולים להשתמש בתגים כדי להגדיר גיבויים אוטומטיים של המכונות ב-Compute Engine. לדוגמה, אתם יכולים ליצור תבנית של תוכנית גיבוי באמצעות שירות Backup and DR, ולהחיל אותה באופן אוטומטי על המכונות שלכם ב-Compute Engine.
למידע נוסף, קראו את המאמר הגנה אוטומטית על מכונות חדשות של Compute Engine.
Cloud Storage
Cloud Storage הוא מאגר אובייקטים שמתאים במיוחד לאחסון קובצי גיבוי. הוא מספק סוגי אחסון (storage class) שונים שמתאימים לתרחישי שימוש ספציפיים, כמו שמתואר בדיאגרמה הבאה.

בתרחישים של התאוששות מאסון, סוגי האחסון Nearline, Coldline ו-Archive הם רלוונטיים במיוחד. סוגי האחסון האלה מפחיתים את עלות האחסון בהשוואה לאחסון Standard Storage. עם זאת, יש עלויות נוספות שקשורות לאחזור נתונים או מטא-נתונים שמאוחסנים בסוגי האחסון האלה, וגם משכי אחסון מינימליים שעליהם אתם מחויבים. Nearline מיועד לתרחישי גיבוי שבהם הגישה היא לכל היותר פעם בחודש, וזה אידיאלי כדי לאפשר לכם לבצע בדיקות עומסים רגילות של DR תוך שמירה על עלויות נמוכות.
סוגי האחסון Nearline, Coldline ו-Archive מותאמים לגישה לא תכופה, ומודל התמחור שלהם מבוסס על כך. לכן, תחויבו על משך האחסון המינימלי, ויהיו עלויות נוספות על אחזור נתונים או מטא-נתונים בסוגי האחסון האלה לפני משך האחסון המינימלי של סוג האחסון.
כדי להגן על הנתונים בקטגוריה של Cloud Storage מפני מחיקה מקרית או זדונית, אתם יכולים להשתמש בתכונה מחיקה זמנית כדי לשמור אובייקטים שנמחקו או הוחלפו למשך תקופה מסוימת, ובתכונה השהיית אובייקטים כדי למנוע מחיקה או עדכון של אובייקטים.
בעזרת Storage Transfer Service אפשר לייבא ל-Cloud Storage נתונים מ-Amazon S3, מ-Azure Blob Storage או ממקורות נתונים מקומיים. בתרחישים של DR, אפשר להשתמש ב-Storage Transfer Service כדי:
- לגבות נתונים מספקי אחסון אחרים בקטגוריה של Cloud Storage.
- כדי להוזיל את עלויות האחסון של הגיבויים, אתם יכולים להעביר נתונים מקטגוריה בשני אזורים או במספר אזורים לקטגוריה באזור אחד.
Filestore
מכונות Filestore הן שרתי קבצים מנוהלים מסוג NFS לשימוש עם אפליקציות שפועלות במכונות Compute Engine או באשכולות GKE.
רמות השירות Filestore Basic ו-Zonal הן משאבים של תחום מוגדר, ואי אפשר לשכפל אותם בין תחומים. לעומת זאת, מכונות ברמת השירות Filestore Enterprise הן משאבים אזוריים. כדי לשפר את העמידות של סביבת Filestore, מומלץ להשתמש במכונות ברמת Enterprise.
Google Kubernetes Engine
GKE הוא סביבה מנוהלת ומוכנה לייצור, שמאפשרת לפרוס אפליקציות בקונטיינרים. בעזרת GKE אפשר לתזמר מערכות HA, והוא כולל את התכונות הבאות:
- תיקון אוטומטי של צמתים. אם צומת נכשל בבדיקות תקינות עוקבות לאורך תקופה ממושכת (כ-10 דקות), GKE מתחיל תהליך תיקון של הצומת.
- בדיקות תקינות ומוכנות. אתם יכולים לציין בדיקת תקינות, שמודיעה ל-GKE מדי פעם שה-Pod פועל. אם ה-pod נכשל בבדיקה, אפשר להפעיל אותו מחדש.
- אשכולות אזוריים ואשכולות בכמה אזורים. אפשר לפזר משאבים ב-Kubernetes בין כמה אזורים בתוך אזור מסוים.
- שער מרובה אשכולות מאפשר להגדיר משאבים משותפים של איזון עומסים בכמה אשכולות GKE באזורים שונים.
- גיבוי ל-GKE מאפשר לגבות ולשחזר עומסי עבודה באשכולות GKE.
רשתות והעברת נתונים
בטבלה הבאה מופיע סיכום של התכונות בשירותי הרשת והעברת הנתונים של Google Cloud , שמשמשים כאבני בניין להתאוששות מאסון:
| מוצר | תכונה |
|---|---|
| Cloud Load Balancing |
|
| Cloud Service Mesh |
|
| Cloud DNS |
|
| Cloud Interconnect |
|
Cloud Load Balancing
Cloud Load Balancing מספק זמינות גבוהה למוצרי המחשוב של Google Cloud , על ידי חלוקת תנועת המשתמשים בין כמה מכונות של האפליקציות שלכם. אפשר להגדיר את Cloud Load Balancing עם בדיקות תקינות שקובעות אם המכונות זמינות לביצוע עבודה, כדי שהתנועה לא תנותב למכונות שנכשלו.
Cloud Load Balancing מספק כתובת IP אחת מסוג anycast שמשמשת כחזית לאפליקציות שלכם. לאפליקציות שלכם יכולים להיות מופעים שפועלים באזורים שונים (לדוגמה, באירופה ובארה"ב), ומשתמשי הקצה שלכם מופנים לקבוצת המופעים הקרובה ביותר. בנוסף לאיזון עומסים בשירותים שחשופים לאינטרנט, אתם יכולים להגדיר איזון עומסים פנימי לשירותים שמאחורי כתובת IP פרטית לאיזון עומסים. כתובת ה-IP הזו נגישה רק למכונות וירטואליות פנימיות בענן הווירטואלי הפרטי (VPC).
מידע נוסף זמין במאמר סקירה כללית על איזון עומסים ב-Cloud.
Cloud Service Mesh
Cloud Service Mesh היא רשת Service Mesh שמנוהלת על ידי Google וזמינה ב- Google Cloud. Cloud Service Mesh מספק טלמטריה מעמיקה כדי לעזור לכם לאסוף תובנות מפורטות לגבי האפליקציות שלכם. הוא תומך בשירותים שפועלים במגוון תשתיות מחשוב.
בנוסף, Cloud Service Mesh תומך בתכונות מתקדמות של ניהול תעבורת נתונים וניתוב, כמו מפסק זרם והזרקת תקלות. באמצעות מפסק זרם, אתם יכולים לאכוף מגבלות על בקשות לשירות מסוים. כשהמגבלות של מפסק הזרם מגיעות לסף, הבקשות לא מגיעות לשירות, וכך נמנעת פגיעה נוספת בשירות. באמצעות הזרקת תקלות, Cloud Service Mesh יכול להוסיף עיכובים או לבטל חלק מהבקשות לשירות. הזרקת תקלות מאפשרת לבדוק את היכולת של השירות להתמודד עם עיכובים בבקשות או עם בקשות שבוטלו.
מידע נוסף זמין במאמר סקירה כללית על Cloud Service Mesh.
Cloud DNS
Cloud DNS מספק דרך פרוגרמטית לניהול רשומות ה-DNS כחלק מתהליך שחזור אוטומטי. ב-Cloud DNS נעשה שימוש ברשת הגלובלית של Google של שרתי שמות Anycast, כדי להציג את תחומי ה-DNS ממיקומים מיותרים ברחבי העולם, וכך לספק זמינות גבוהה וזמן אחזור קצר יותר למשתמשים.
אם בחרתם לנהל את רשומות ה-DNS באופן מקומי, אתם יכולים להפעיל מכונות וירטואליות ב-Google Cloud כדי לפענח את הכתובות האלה באמצעות העברה של Cloud DNS.
ב-Cloud DNS יש תמיכה בכללי מדיניות שמאפשרים להגדיר איך הוא מגיב לבקשות DNS. לדוגמה, אפשר להגדיר כללי מדיניות לניתוב DNS כדי לנתב את התנועה על סמך קריטריונים ספציפיים, כמו הפעלת יתירות כשל להגדרת גיבוי כדי לספק זמינות גבוהה, או לנתב בקשות DNS על סמך המיקום הגיאוגרפי שלהן.
Cloud Interconnect
באמצעות Cloud Interconnect אפשר להעביר מידע ממקורות אחרים אל Google Cloud. אנחנו דנים במוצר הזה בהמשך, בקטע העברת נתונים אל Google Cloudוממנו.
ניהול ומעקב
בטבלה הבאה מופיע סיכום של התכונות בשירותי הניהול והמעקב של Google Cloud , שמשמשים כאבני בניין ל-DR:
| מוצר | תכונה |
|---|---|
| לוח הבקרה של סטטוס שירותי Google Cloud |
|
| Google Cloud Observability |
|
| השירות המנוהל של Google Cloud ל-Prometheus |
|
לוח הבקרה של סטטוס שירותי Google Cloud
בלוח הבקרה של סטטוס שירותי Cloud מוצגת הזמינות הנוכחית של שירותי Google Cloud . אתם יכולים לראות את הסטטוס בדף ולהירשם לפיד RSS שמתעדכן בכל פעם שיש חדשות לגבי שירות מסוים.
Cloud Monitoring
Cloud Monitoring אוסף מדדים, אירועים ומטא-נתונים מ- Google Cloud, מ-AWS, מבקשות לבדיקת תקינות של זמן פעולה תקינה במארחים, מאינסטרומנטציה של אפליקציות וממגוון רכיבים אחרים באפליקציות. אתם יכולים להגדיר התראות שיישלחו לכלים של צד שלישי כמו Slack או Pagerduty, כדי לעדכן את האדמינים בזמן.
ב-Cloud Monitoring אפשר ליצור בדיקות זמני פעילות לנקודות קצה שזמינות לכולם ולנקודות קצה בתוך רשתות ה-VPC. לדוגמה, אתם יכולים לעקוב אחרי כתובות URL, מכונות של Compute Engine, גרסאות של Cloud Run ומשאבים של צד שלישי, כמו מכונות של Amazon Elastic Compute Cloud (EC2).
השירות המנוהל של Google Cloud ל-Prometheus
השירות המנוהל של Google Cloud ל-Prometheus הוא פתרון שמנוהל על ידי Google, פועל בכמה עננים ובכמה פרויקטים, ומיועד למדדים של Prometheus. הוא מאפשר לכם לעקוב באופן גלובלי אחרי עומסי העבודה שלכם ולקבל התראות לגביהם באמצעות Prometheus, בלי שתצטרכו לנהל ולהפעיל את Prometheus באופן ידני בקנה מידה נרחב.
מידע נוסף זמין במאמר השירות המנוהל של Google Cloud ל-Prometheus.
אבני בניין של התאוששות מאסון בפלטפורמות שונות
כשמריצים עומסי עבודה בכמה פלטפורמות, אחת הדרכים לצמצם את התקורה התפעולית היא לבחור כלים שפועלים בכל הפלטפורמות שבהן אתם משתמשים. בקטע הזה נדון בכמה כלים ושירותים שאינם תלויים בפלטפורמה, ולכן תומכים בתרחישי התאוששות מאסון בפלטפורמות שונות.
תשתית כקוד
כשמגדירים את התשתית באמצעות קוד, במקום ממשקים גרפיים או סקריפטים, אפשר להשתמש בכלים של תבניות הצהרתיות ולהפוך את ההקצאה וההגדרה של התשתית לאוטומטיות בפלטפורמות שונות. לדוגמה, אתם יכולים להשתמש ב-Terraform וב-Infrastructure Manager כדי להפעיל את הגדרת התשתית הדקלרטיבית.
כלים לניהול הגדרות אישיות
בתשתית DR גדולה או מורכבת, מומלץ להשתמש בכלי ניהול תוכנה שלא תלויים בפלטפורמה, כמו Chef ו-Ansible. הכלים האלה מאפשרים להחיל הגדרות שניתנות לשחזור, לא משנה איפה נמצא עומס העבודה שלכם ב-Compute.
כלי תזמור
גם קונטיינרים יכולים להיחשב כאבן בניין של התאוששות מאסון. קונטיינרים הם דרך לארוז שירותים ולהציג עקביות בין פלטפורמות.
אם אתם עובדים עם קונטיינרים, בדרך כלל תשתמשו בכלי תזמור. Kubernetes לא רק מנהל קונטיינרים ב- Google Cloud (באמצעות GKE), אלא גם מאפשר לתזמר עומסי עבודה שמבוססים על קונטיינרים בכמה פלטפורמות. Google Cloud, AWS ו-Microsoft Azure מספקים גרסאות מנוהלות של Kubernetes.
כדי להפיץ תנועה לאשכולות Kubernetes שפועלים בפלטפורמות ענן שונות, אתם יכולים להשתמש בשירות DNS שתומך ברשומות משוקללות ומשלב בדיקת תקינות.
אתם גם צריכים לוודא שאתם יכולים למשוך את קובץ האימג' לסביבת היעד. כלומר, אתם צריכים להיות מסוגלים לגשת למאגר קובצי האימג' במקרה של אסון. אפשרות טובה נוספת שלא תלויה בפלטפורמה היא Artifact Registry.
העברת נתונים
העברת נתונים היא רכיב קריטי בתרחישי התאוששות מאסון בפלטפורמות שונות. חשוב לוודא שאתם מתכננים, מטמיעים ובודקים את תרחישי ה-DR בפלטפורמות השונות באמצעות מודלים מציאותיים של מה שנדרש בתרחיש העברת הנתונים של ה-DR. בקטע הבא נדון בתרחישים של העברת נתונים.
שירות Backup and DR
שירות Backup and DR הוא פתרון לגיבוי ול-DR של עומסי עבודה בענן. הוא עוזר לשחזר נתונים ולהמשיך בפעילות העסקית החיונית, ותומך בכמה Google Cloud מוצרים, מסדי נתונים של צד שלישי ומערכות לאחסון נתונים.
מידע נוסף זמין במאמר סקירה כללית על שירות הגיבוי והתאוששות מאסון.
תבניות ל-DR
בקטע הזה נדון בכמה מהתבניות הנפוצות ביותר לארכיטקטורות של DR, על סמך אבני הבניין שנדונו קודם לכן.
העברת נתונים אל Google Cloudוממנו
היבט חשוב בתוכנית להתאוששות מאסון הוא המהירות שבה אפשר להעביר נתונים אל Google Cloudוממנו. זה קריטי אם תוכנית ה-DR שלכם מבוססת על העברת נתונים מאחסון מקומי ל- Google Cloud או מספק שירותי ענן אחר ל- Google Cloud. בקטע הזה נדון ברשתות ובשירותיGoogle Cloud שיכולים להבטיח קצב העברת נתונים טוב.
כשמשתמשים ב- Google Cloud כאתר לשחזור של עומסי עבודה מקומיים או בסביבת ענן אחרת, חשוב להביא בחשבון את הדברים הבאים:
- איך מתחברים אל Google Cloud?
- מה רוחב הפס בין המיקום שלכם לבין ספק הקישור?
- מהו רוחב הפס שהספק מספק ישירות אל Google Cloud?
- אילו נתונים נוספים יועברו באמצעות הקישור הזה?
מידע נוסף על העברת נתונים אל Google Cloudזמין במאמר מעבר אל Google Cloud: העברת מערכי נתונים גדולים.
איזון בין הגדרת קובץ האימג' לבין מהירות הפריסה
כשמגדירים תמונת מכונה לפריסת מכונות חדשות, חשוב להביא בחשבון את ההשפעה של ההגדרה על מהירות הפריסה. יש פשרה בין כמות ההגדרות האישיות מראש של קובץ האימג', עלויות התחזוקה של קובץ האימג' ומהירות הפריסה. לדוגמה, אם תמונת מכונה מוגדרת באופן מינימלי, למכונות שמשתמשות בה ייקח יותר זמן להפעיל, כי הן צריכות להוריד ולהתקין יחסי תלות. לעומת זאת, אם תמונת המכונה מוגדרת באופן נרחב, המכונות שמשתמשות בה מופעלות מהר יותר, אבל צריך לעדכן את התמונה בתדירות גבוהה יותר. הזמן שנדרש להפעלת מכונה פעילה באופן מלא ישפיע באופן ישיר על ה-RTO.
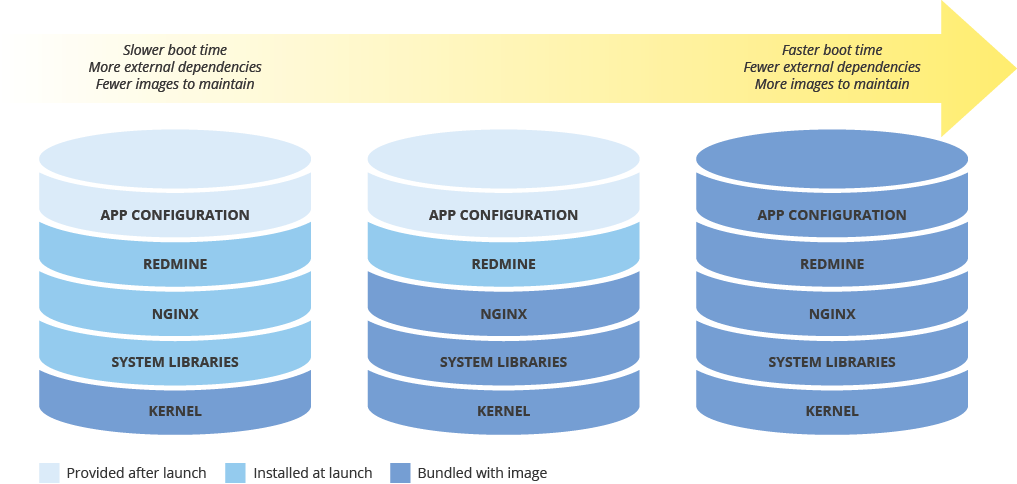
שמירה על עקביות של קובצי אימג' של מכונות בסביבות היברידיות
אם אתם מטמיעים פתרון היברידי (ממחשב מקומי לענן או מענן לענן), אתם צריכים למצוא דרך לשמור על עקביות של התמונות בסביבות הייצור.
אם נדרשת תמונה שהוגדרה באופן מלא, כדאי לשקול שימוש בכלי כמו Packer, שיכול ליצור תמונות מכונה זהות לכמה פלטפורמות. אפשר להשתמש באותם סקריפטים עם קובצי תצורה ספציפיים לפלטפורמה. במקרה של Packer, אפשר להכניס את קובץ התצורה לניהול גרסאות כדי לעקוב אחרי הגרסה שנפרסה בסביבת הייצור.
אפשרות נוספת היא להשתמש בכלים לניהול הגדרות כמו Chef, Puppet, Ansible או Saltstack כדי להגדיר מכונות ברמת פירוט גבוהה יותר, וליצור קובצי אימג' בסיסיים, קובצי אימג' עם הגדרות מינימליות או קובצי אימג' עם הגדרות מלאות לפי הצורך.
אתם יכולים גם להמיר ולייבא באופן ידני קובצי אימג' קיימים, כמו Amazon AMI, קובצי אימג' של Virtualbox וקובצי אימג' של דיסק RAW ל-Compute Engine.
הטמעת אחסון מדורג
תבנית האחסון השכבתית משמשת בדרך כלל לגיבויים, שבהם הגיבוי האחרון נמצא באחסון מהיר יותר, ואתם מעבירים לאט את הגיבויים הישנים יותר לאחסון בעלות נמוכה יותר (אבל איטי). כשמיישמים את התבנית הזו, מעבירים גיבויים בין קטגוריות של סוגי אחסון שונים, בדרך כלל מ-Standard לסוגי אחסון זולים יותר, כמו Nearline ו-Coldline.
כדי להטמיע את התבנית הזו, אפשר להשתמש בניהול מחזור החיים של אובייקטים. לדוגמה, אתם יכולים לשנות באופן אוטומטי את סוג האחסון של אובייקטים שנוצרו לפני פרק זמן מסוים ל-Coldline.
המאמרים הבאים
- Google Cloud מידע נוסף על מיקום גיאוגרפי ואזורים
מאמרים נוספים בסדרה הזו בנושא התאוששות מאסון:
- מדריך להכנת תוכנית התאוששות מאסון (DR)
- תרחישים של תוכנית התאוששות מאסון (DR) לנתונים
- תרחישים של תוכנית התאוששות מאסון (DR) לאפליקציות
- תכנון תוכנית התאוששות מאסון (DR) לעומסי עבודה שמוגבלים למיקום
- תרחישים לדוגמה של תוכנית התאוששות מאסון (DR): אפליקציות לניתוח נתונים שמוגבלות למיקום מסוים
- תכנון תוכנית התאוששות מאסון (DR) להפסקות זמניות בתשתית הענן
לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחברים:
- גרייס מוליסון | ראש צוות פתרונות
- מרקו פרארי | ארכיטקט פתרונות ענן