


המסמך הזה הוא החלק הראשון בסדרה שעוסקת בתוכנית התאוששות מאסון (DR) ב- Google Cloud. בחלק הזה נסביר מה צריך לדעת כדי לתכנן ולהטמיע תוכנית להתאוששות מאסון. בחלקים הבאים נדון בתרחישי שימוש ספציפיים של DR, עם דוגמאות להטמעה ב- Google Cloud.
הסדרה כוללת את החלקים הבאים:
- מדריך להכנת תוכנית התאוששות מאסון (המסמך הזה)
- אבני הבניין של תוכנית התאוששות מאסון (DR)
- תרחישים של תוכנית התאוששות מאסון (DR) לנתונים
- תרחישים של תוכנית התאוששות מאסון (DR) לאפליקציות
- תכנון תוכנית התאוששות מאסון (DR) לעומסי עבודה שמוגבלים למיקום
- תרחישים לדוגמה של תוכנית התאוששות מאסון (DR): אפליקציות לניתוח נתונים שמוגבלות למיקום מסוים
- תכנון תוכנית התאוששות מאסון (DR) להפסקות זמניות בשירות של תשתית הענן
אירועים שמשבשים את השירות יכולים לקרות בכל שלב. יכול להיות שתהיה הפסקה זמנית בשירות של הרשת, שעדכון האפליקציה האחרון יגרום לבאג קריטי או שתצטרכו להתמודד עם אסון טבע. כשהדברים משתבשים, חשוב שתהיה לכם תוכנית DR חזקה, ממוקדת ומנוסה.
אם תכינו תוכנית DR שתוכננה ונבדקה היטב, תוכלו לוודא שבמקרה של אסון, ההשפעה על השורה התחתונה של העסק תהיה מינימלית. לא משנה מהם הצרכים שלכם ל-DR, ב- Google Cloud יש מבחר חזק, גמיש ומשתלם של מוצרים ותכונות שתוכלו להשתמש בהם כדי לבנות או לשפר את הפתרון שמתאים לכם.
העקרונות הבסיסיים של תכנון התאוששות מאסון (DR)
התאוששות מאסון היא קבוצת משנה של תכנון המשכיות עסקית. תכנון התאוששות מאסון מתחיל בניתוח ההשפעה על העסק, שבו מגדירים שני מדדים עיקריים:
- יעד זמן התאוששות (RTO), שהוא משך הזמן המקסימלי שבו האפליקציה יכולה להיות אופליין. הערך הזה מוגדר בדרך כלל כחלק מהסכם רמת שירות (SLA) רחב יותר.
- יעד להתאוששות מאסון (RPO), שהוא משך הזמן המקסימלי הקביל שבו נתונים עלולים ללכת לאיבוד מהאפליקציה בגלל אירוע משמעותי. המדד הזה משתנה בהתאם לאופן שבו משתמשים בנתונים. לדוגמה, לנתוני משתמשים שמשתנים לעיתים קרובות יכול להיות RPO של כמה דקות בלבד. לעומת זאת, נתונים פחות קריטיים שמשתנים לעיתים רחוקות יכולים להיות עם RPO של כמה שעות. (המדד הזה מתאר רק את משך הזמן, ולא מתייחס לכמות או לאיכות של הנתונים שאבדו).
בדרך כלל, ככל שערכי ה-RTO וה-RPO קטנים יותר (כלומר, ככל שהאפליקציה צריכה להתאושש מהר יותר מהפרעה), כך עלות הפעלת האפליקציה תהיה גבוהה יותר. בתרשים הבא מוצג היחס בין העלות לבין RTO/RPO.
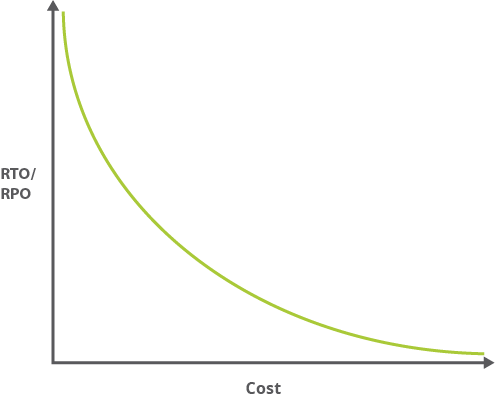
ערכי RTO ו-RPO קטנים יותר פירושם בדרך כלל מורכבות גדולה יותר, ולכן התקורה הניהולית הקשורה עוקבת אחר עקומה דומה. באפליקציה עם זמינות גבוהה, יכול להיות שתצטרכו לנהל את ההפצה בין שני מרכזי נתונים שמופרדים פיזית, לנהל את הרפליקציה ועוד.
ערכי RTO ו-RPO בדרך כלל נכללים במדד אחר: יעד למדידת רמת השירות (SLO), שהוא רכיב מרכזי שניתן למדידה בהסכם רמת השירות (SLA). הרבה פעמים מבלבלים בין SLA ל-SLO. הסכם SLA הוא ההסכם המלא שמפרט איזה שירות יסופק, איך הוא נתמך, זמנים, מיקומים, עלויות, ביצועים, קנסות ואחריות של הצדדים המעורבים. יעדי SLO הם מאפיינים ספציפיים ומדידים של הסכם ה-SLA, כמו זמינות, קצב העברת נתונים, תדירות, זמן תגובה או איכות. הסכם SLA יכול להכיל הרבה יעדי SLO. אפשר למדוד את ה-RTO וה-RPO, וצריך להתייחס אליהם כ-SLO.
בספר Google Site Reliability Engineering תוכלו לקרוא מידע נוסף על יעדי SLO והסכמי SLA.
יכול להיות שאתם מתכננים גם ארכיטקטורה לזמינות גבוהה (HA). זמינות גבוהה לא חופפת לגמרי להתאוששות מאסון, אבל לעיתים קרובות צריך להביא בחשבון זמינות גבוהה כשחושבים על ערכי RTO ו-RPO. זמינות גבוהה עוזרת להבטיח רמה מוסכמת של ביצועים תפעוליים, בדרך כלל זמן פעולה תקינה, לתקופה ארוכה מהרגיל. כשמריצים עומסי עבודה בסביבת הייצור ב-Google Cloud, אפשר להשתמש במערכת שפרוסה ברחבי העולם, כדי שאם משהו ישתבש באזור אחד, האפליקציה תמשיך לספק שירות גם אם הזמינות שלה תהיה נמוכה יותר. למעשה, האפליקציה הזו מפעילה את תוכנית ה-DR שלה.
למה Google Cloud?
Google Cloud יכול להפחית באופן משמעותי את העלויות שקשורות גם ל-RTO וגם ל-RPO, בהשוואה לעמידה בדרישות של RTO ו-RPO באופן מקומי. לדוגמה, תכנון DR דורש התייחסות למספר דרישות, כולל:
- קיבולת: הבטחת מספיק משאבים כדי להגדיל את קנה המידה לפי הצורך.
- אבטחה: אבטחה פיזית להגנה על נכסים.
- תשתית הרשת: כולל רכיבי תוכנה כמו חומות אש ומאזני עומסים.
- תמיכה: העמדת טכנאים מיומנים לביצוע תחזוקה ולטיפול בבעיות.
- רוחב פס: תכנון רוחב פס שמתאים לעומס שיא.
- מתקנים: הבטחת תשתית פיזית, כולל ציוד וחשמל.
הפתרון המנוהל שלGoogle Cloud בפלטפורמת ייצור ברמה עולמית עוזר לכם לעקוף את רוב הגורמים המורכבים האלה, או את כולם, וכך לחסוך הרבה עלויות עסקיות. בנוסף, ההתמקדות של Google Cloudבפשטות הניהול מאפשרת להפחית גם את עלויות הניהול של אפליקציה מורכבת.
ב-Google Cloud יש כמה תכונות שרלוונטיות לתכנון DR, כולל:
- רשת גלובלית. ל-Google יש את אחת מרשתות המחשבים הגדולות והמתקדמות בעולם. הרשת בשדרה המרכזית של Google משתמשת בשירותי Networking מוגדרי-תוכנה מתקדמים ובשירותי שמירה במטמון קצה כדי לספק ביצועים מהירים, עקביים וניתנים להתאמה.
- יתירות. נקודות נוכחות (PoP) מרובות ברחבי העולם מספקות יתירות חזקה. הנתונים שלכם משוכפלים באופן אוטומטי בין התקני אחסון במספר מיקומים.
- יכולת התאמה לעומס. Google Cloud מתוכנן להתאים לעומס כמו מוצרים אחרים של Google (לדוגמה, חיפוש ו-Gmail), גם כשחווה עלייה חדה בתנועה. שירותים מנוהלים כמו Cloud Run, Compute Engine ו-Firestore מאפשרים התאמה אוטומטית לעומס (automatic scaling), כך שהאפליקציה יכולה לגדול ולהצטמצם לפי הצורך.
- אבטחה. מודל האבטחה של Google מבוסס על עשרות שנים של ניסיון בשמירה על בטיחות הלקוחות באפליקציות של Google, כמו Gmail ו-Google Workspace. בנוסף, צוותי הנדסת האמינות של האתרים ב-Google עוזרים להבטיח זמינות גבוהה ולמנוע ניצול לרעה של משאבי הפלטפורמה.
- עמידה בדרישות. Google עוברת באופן קבוע ביקורות עצמאיות של צדדים שלישיים כדי לוודא ש- Google Cloud עומד בתקנות ובשיטות המומלצות בנושאי אבטחה, פרטיות ותאימות. Google Cloudהוא עומד באישורים כמו ISO 27001, SOC 2/3 ו-PCI DSS 3.0.
תבניות DR
דפוסי DR נחשבים קרים, חמימים או חמים. התבניות האלה מציינות באיזו קלות המערכת יכולה להתאושש כשמשהו משתבש. אפשר להשוות את זה למה שהייתם עושים אם הייתם נוהגים והיה לכם פנצ'ר בגלגל.
האופן שבו תתמודדו עם תקר תלוי במידת המוכנות שלכם:
- קר: אין לכם גלגל רזרבי, אז אתם צריכים להתקשר למישהו שיגיע אליכם עם גלגל חדש ויחליף אותו. הנסיעה שלכם תיעצר עד שיגיעו לתקן את התקלה.
- חם: יש לכם צמיג חלופי וערכת החלפה, אז אתם יכולים לחזור לנסוע באמצעות מה שיש לכם ברכב. אבל צריך לעצור את הנסיעה כדי לתקן את הבעיה.
- חם: יש לכם צמיגים חסיני תקרים. יכול להיות שתצטרכו להאט קצת, אבל אין השפעה מיידית על הנסיעה. הצמיגים פועלים מספיק טוב כדי שתוכלו להמשיך (אם כי בסופו של דבר תצטרכו לטפל בבעיה).
יצירת תוכנית DR מפורטת
בקטע הזה מפורטות המלצות ליצירת תוכנית DR.
תכנון בהתאם ליעדי השחזור
כשאתם מתכננים את תוכנית ה-DR, אתם צריכים לשלב את השיטות לשחזור האפליקציה והנתונים ולהסתכל על התמונה הרחבה יותר. הדרך המקובלת לעשות זאת היא לבחון את ערכי ה-RTO וה-RPO, ולבדוק איזה דפוס DR אפשר לאמץ כדי לעמוד בערכים האלה. לדוגמה, במקרה של נתונים היסטוריים שקשורים לתאימות, כנראה שלא צריך גישה מהירה לנתונים, ולכן מתאים להשתמש בערך RTO גדול ובדפוס DR קר. עם זאת, אם יש הפסקה בשירות אונליין, תרצו לשחזר את הנתונים ואת החלק של האפליקציה שגלוי למשתמשים במהירות האפשרית. במקרה כזה, תבנית חמה תתאים יותר. מערכת ההתראות באימייל, שבדרך כלל לא קריטית לעסק, היא כנראה מועמדת לתבנית חמה.
במאמר על תרחישי התאוששות של אפליקציות מוסבר איך להשתמש ב- Google Cloud כדי לטפל בתרחישי DR נפוצים. התרחישים האלה מספקים אסטרטגיות ממוקדות להתאוששות מאסון למגוון תרחישי שימוש, ומציעים דוגמאות להטמעה ב-Google Cloud לכל אחד מהם.
תכנון לשחזור מקצה לקצה
לא מספיק רק לתכנן את הגיבוי או הארכוב של הנתונים. חשוב לוודא שתוכנית ה-DR מתייחסת לתהליך ההתאוששות המלא, החל מהגיבוי, דרך השחזור ועד לניקוי. אנחנו דנים בנושא הזה במסמכים הקשורים לנתוני DR ולהתאוששות.
הגדירו משימות ספציפיות
כשיגיע הזמן להפעיל את תוכנית ה-DR, לא תרצו לנחש מה המשמעות של כל שלב. כל משימה בתוכנית ה-DR צריכה לכלול פקודה או פעולה אחת או יותר, קונקרטיות וחד-משמעיות. לדוגמה, "הפעלת הסקריפט לשחזור" היא הנחיה כללית מדי. לעומת זאת, "פתח מעטפת והפעל את /home/example/restore.sh" היא הוראה מדויקת וקונקרטית.
הטמעת אמצעי בקרה
הוסיפו אמצעי בקרה כדי למנוע אסונות ולזהות בעיות לפני שהן מתרחשות. לדוגמה, אפשר להוסיף חיישן ששולח התראה כשמתרחשת פעילות חריגה או קפיצה לא צפויה בתהליך שכולל מחיקת נתונים, כמו צינור עיבוד נתונים למחיקה. המעקב הזה יכול גם להפסיק את תהליכי צינור עיבוד הנתונים אם מגיעים לסף מחיקה מסוים, כדי למנוע מצב קטסטרופלי.
התוכנה בהכנה
חלק מהתכנון של DR הוא לוודא שהתוכנה שאתם מסתמכים עליה מוכנה לאירוע התאוששות.
מוודאים שאפשר להתקין את התוכנה
מוודאים שאפשר להתקין את האפליקציה מהמקור או מתמונה שהוגדרה מראש. חשוב לוודא שיש לכם רישיון מתאים לכל תוכנה שאתם פורסים ב- Google Cloud. אם אתם לא בטוחים, פנו לספק התוכנה.
מוודאים שהמשאבים הנדרשים של Compute Engine זמינים בסביבת השחזור. יכול להיות שתצטרכו להקצות מראש מכונות או לשמור אותן.
תכנון פריסה רציפה (CD) לשחזור
ערכת הכלים לפריסה רציפה (CD) היא חלק בלתי נפרד מפריסת האפליקציות. כחלק מתוכנית ההתאוששות, צריך להחליט איפה בסביבה המשוחזרת תפרסו פריטי מידע שנוצרו בתהליך הפיתוח (Artifacts). תכננו איפה אתם רוצים לארח את סביבת ה-CD והפריטים שלכם – הם צריכים להיות זמינים ופעילים במקרה של אסון.
הטמעת אמצעי בקרה לאבטחה ותאימות
כשמתכננים תוכנית להתאוששות מאסון, האבטחה חשובה. אותם אמצעי בקרה שקיימים בסביבת הייצור צריכים לחול גם על הסביבה ששוחזרה. תקנות התאימות יחולו גם על הסביבה ששוחזרה.
הגדרת אבטחה זהה לסביבות ה-DR והייצור
חשוב לוודא שבקרות הרשת מספקות את אותה הפרדה וחסימה שבהן משתמשים בסביבת הייצור של המקור. איך מגדירים VPC משותף וחומות אש כדי ליצור בקרה מרכזית על הרשת והאבטחה של הפריסה, להגדיר רשתות משנה ולשלוט בתעבורת הנתונים הנכנסת והיוצאת. איך משתמשים בחשבונות שירות כדי להטמיע את העיקרון של הרשאות מינימליות באפליקציות שניגשות לממשקי ה-API של Google Cloud . חשוב להשתמש בחשבונות שירות כחלק מהכללים של חומת האש.
חשוב לוודא שאתם נותנים למשתמשים את אותה גישה לסביבת ה-DR שיש להם בסביבת הייצור של המקור. ברשימה הבאה מפורטות דרכים לסנכרן הרשאות בין סביבות:
אם סביבת הייצור היא Google Cloud, קל לשכפל את מדיניות ה-IAM בסביבת ה-DR. אתם יכולים להשתמש בכלים של תשתית כקוד (IaC) כמו Terraform כדי לפרוס את מדיניות IAM בסביבת הייצור. לאחר מכן, משתמשים באותם כלים כדי לקשר את כללי המדיניות למשאבים המתאימים בסביבת ה-DR, כחלק מתהליך ההגדרה של סביבת ה-DR.
אם סביבת הייצור שלכם היא מקומית, אתם ממפים את התפקידים הפונקציונליים, כמו מנהל הרשת ומבקר החשבונות, למדיניות IAM עם תפקידי IAM מתאימים. במסמכי התיעוד של IAM יש כמה דוגמאות להגדרות של תפקידים פונקציונליים. לדוגמה, תוכלו לקרוא איך יוצרים תפקידים פונקציונליים של רשתות ושל רישום ביומן ביקורת.
צריך להגדיר מדיניות IAM כדי להעניק הרשאות מתאימות למוצרים. לדוגמה, יכול להיות שתרצו להגביל את הגישה לקטגוריות ספציפיות של Cloud Storage.
אם סביבת הייצור שלכם נמצאת אצל ספק שירותי ענן אחר, ממפים את ההרשאות במדיניות ה-IAM של הספק האחר למדיניות ה-IAM של Google Cloud .
אימות האבטחה של התאוששות מאסון (DR)
אחרי שמגדירים את ההרשאות לסביבת ה-DR, חשוב לבדוק שהכול עובד. יוצרים סביבת בדיקה. מוודאים שההרשאות שאתם נותנים למשתמשים תואמות להרשאות שיש למשתמשים באופן מקומי.
מוודאים שלמשתמשים יש גישה לסביבת ה-DR
אל תחכו לאסון כדי לבדוק אם המשתמשים יכולים לגשת לסביבת ה-DR. חשוב לוודא שהקציתם את זכויות הגישה המתאימות למשתמשים, למפתחים, לאופרטורים, למדעני הנתונים, לאדמינים של אבטחה, למנהלי רשת ולתפקידים אחרים בארגון. אם אתם משתמשים במערכת זהויות חלופית, ודאו שהחשבונות סונכרנו עם חשבון Cloud Identity. מכיוון שסביבת ה-DR תהיה סביבת הייצור שלכם לזמן מה, בקשו מהמשתמשים שצריכים גישה לסביבת ה-DR להיכנס אליה, ופתרו את כל בעיות האימות. כחלק מבדיקות ה-DR הרגילות שאתם מבצעים, שלבו משתמשים שמתחברים לסביבת ה-DR.
כדי לנהל באופן מרוכז את המשתמשים שיש להם הרשאת אדמין למכונות וירטואליות (VM) שמופעלות, צריך להפעיל את התכונה OS Login בפרויקטים ב- Google Cloud שמהווים את סביבת ה-DR.
הדרכת משתמשים
המשתמשים צריכים להבין איך לבצע ב- Google Cloud את הפעולות שהם רגילים לבצע בסביבת הייצור, כמו התחברות וגישה למכונות וירטואליות. בסביבת הבדיקה, אתם יכולים להדריך את המשתמשים איך לבצע את המשימות האלה בדרכים שישמרו על אבטחת המערכת.
מוודאים שסביבת ה-DR עומדת בדרישות התאימות
מוודאים שהגישה לסביבת ה-DR מוגבלת רק למי שצריך גישה. חשוב לוודא שפרטים אישיים מזהים (PII) מצונזרים ומוצפנים. אם אתם מבצעים בדיקות חדירה קבועות בסביבת הייצור, כדאי לכלול את סביבת ה-DR כחלק מההיקף הזה ולבצע בדיקות קבועות על ידי הגדרת סביבת DR.
חשוב לוודא שבזמן שסביבת ה-DR פועלת, כל היומנים שנאספים ממולאים באופן רטרואקטיבי בארכיון היומנים של סביבת הייצור. באופן דומה, ודאו שכחלק מסביבת ה-DR, אתם יכולים לייצא יומני ביקורת שנאספים באמצעות Cloud Logging לארכיון הראשי של ה-sink ביומן. שימוש במתקני הייצוא של הכיור. ליומני אפליקציות, צרו סביבה מקבילה לסביבת הרישום ביומן והמעקב המקומית. אם סביבת הייצור שלכם נמצאת אצל ספק שירותי ענן אחר, ממפים את הרישום ביומן והמעקב של אותו ספק לשירותים המקבילים ב- Google Cloud . צריך להגדיר תהליך לעיצוב הקלט בסביבת הייצור.
התייחסות לנתונים ששוחזרו כמו לנתוני ייצור
חשוב לוודא שאמצעי האבטחה שאתם מחילים על נתוני הייצור חלים גם על הנתונים ששוחזרו: אותן הרשאות, הצפנה ודרישות ביקורת צריכות לחול על כולם.
חשוב לדעת איפה הגיבויים נמצאים ומי מורשה לשחזר נתונים. חשוב לוודא שתהליך השחזור ניתן לביקורת – אחרי תוכנית התאוששות מאסון (DR), ודאו שאתם יכולים להראות למי הייתה גישה לנתוני הגיבוי ומי ביצע את השחזור.
איך לוודא שתוכנית ה-DR פועלת
חשוב לוודא שאם יתרחש אסון, תוכנית ה-DR תפעל כמצופה.
לשמור יותר מנתיב אחד לשחזור נתונים
במקרה של אסון, יכול להיות שלא תהיה אפשרות להתחבר ל- Google Cloud . להטמיע אמצעי גישה חלופי ל-Google Cloud כדי לוודא שתוכלו להעביר נתונים אלGoogle Cloud. בודקים באופן קבוע שנתיב הגיבוי פועל.
בדיקת התוכנית באופן קבוע
אחרי שיוצרים תוכנית DR, בודקים אותה באופן קבוע, מציינים את הבעיות שצצות ומתאימים את התוכנית בהתאם. באמצעות Google Cloud, אתם יכולים לבדוק תרחישי שחזור בעלות מינימלית. כדי לבצע את הבדיקות, מומלץ להטמיע את הדברים הבאים:
- הקצאת תשתית אוטומטית. אתם יכולים להשתמש בכלים של IaC כמו Terraform כדי להפוך את הקצאת התשתית של Google Cloudלאוטומטית. אם אתם מריצים את סביבת הייצור באופן מקומי, ודאו שיש לכם תהליך מעקב שיכול להתחיל את תהליך ה-DR כשהוא מזהה כשל, ויכול להפעיל את פעולות ההתאוששות המתאימות.
- מעקב אחרי הסביבות באמצעות Google Cloud Observability. ב-Google Cloud יש כלים מצוינים לרישום ביומן ולמעקב, שאפשר לגשת אליהם באמצעות קריאות ל-API. כך אפשר להפוך את הפריסה של תרחישי השחזור לאוטומטית, על ידי תגובה למדדים. כשאתם מתכננים בדיקות, ודאו שיש לכם מעקב והתראות מתאימים שיכולים להפעיל פעולות שחזור מתאימות.
מבצעים את הבדיקה שצוינה קודם:
- בודקים שההרשאות וגישת המשתמשים פועלות בסביבת ה-DR כמו בסביבת הייצור.
- לבצע בדיקת חדירה בסביבת ה-DR.
- מבצעים בדיקה שבה נתיב הגישה הרגיל אל Google Cloudלא עובד.
מה השלב הבא?
- Google Cloud מידע נוסף על מיקום גיאוגרפי ואזורים
- מסמכים נוספים בסדרה הזו בנושא התאוששות מאסון:
- אבני הבניין של תוכנית התאוששות מאסון (DR)
- תרחישים של תוכנית התאוששות מאסון (DR) לנתונים
- תרחישים של תוכנית התאוששות מאסון (DR) לאפליקציות
- תכנון תוכנית התאוששות מאסון (DR) לעומסי עבודה שמוגבלים למיקום
- תרחישים לדוגמה של תוכנית התאוששות מאסון (DR): אפליקציות לניתוח נתונים שמוגבלות למיקום מסוים
- תכנון תוכנית התאוששות מאסון (DR) להפסקות זמניות בתשתית הענן
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחברים:
- גרייס מוליסון | ראש צוות פתרונות
- מרקו פרארי | ארכיטקט פתרונות ענן