


המסמך הזה הוא חלק מסדרה שעוסקת בתוכנית התאוששות מאסון (DR) ב- Google Cloud. במאמר הזה מוסבר איך להחיל על אפליקציות לניתוח נתונים את ההגבלות על המיקום, שמתוארות במאמר תכנון תוכנית התאוששות מאסון (DR) לעומסי עבודה שמוגבלים למיקום. באופן ספציפי, המסמך מתאר איך הרכיבים שבהם אתם משתמשים בפלטפורמה לניתוח נתונים משתלבים בארכיטקטורת DR שעומדת במגבלות המיקום שחלות על האפליקציות או הנתונים שלכם.
הסדרה כוללת את החלקים הבאים:
- מדריך להכנת תוכנית התאוששות מאסון (DR)
- אבני הבניין של תוכנית התאוששות מאסון (DR)
- תרחישים של תוכנית התאוששות מאסון (DR) לנתונים
- תרחישים של תוכנית התאוששות מאסון (DR) לאפליקציות
- תכנון תוכנית התאוששות מאסון (DR) לעומסי עבודה שמוגבלים למיקום
- תכנון תוכנית התאוששות מאסון (DR) להפסקות זמניות בתשתית הענן
- תרחישים לדוגמה של תוכנית התאוששות מאסון (DR): אפליקציות לניתוח נתונים שמוגבלות למיקום (המסמך הזה)
המסמך הזה מיועד לאדריכלי מערכות ולמנהלי IT. אנחנו מניחים שיש לכם את הידע והכישורים הבאים:
- היכרות בסיסית עם Google Cloud שירותים לניתוח נתונים כמו Dataflow, Managed Service for Apache Spark, Managed Service for Apache Airflow, Pub/Sub, Cloud Storage ו-BigQuery.
- היכרות בסיסית עם Google Cloud שירותי רשת כמו Cloud Interconnect ו-Cloud VPN.
- היכרות עם תכנון התאוששות מאסון (DR).
- היכרות עם Apache Hive ו-Apache Spark.
דרישות מקומיות לפלטפורמה לניתוח נתונים
פלטפורמות לניתוח נתונים הן בדרך כלל אפליקציות מורכבות עם כמה שכבות, שמאחסנות נתונים במנוחה. האפליקציות האלה יוצרות אירועים שעוברים עיבוד ונשמרים במערכת הניתוח שלכם. יכול להיות שגם האפליקציה עצמה וגם הנתונים שמאוחסנים במערכת כפופים לתקנות מקומיות. התקנות האלה משתנות לא רק בין מדינות, אלא גם בין ענפים שונים. לכן, לפני שמתחילים לתכנן את ארכיטקטורת ה-DR, חשוב להבין היטב את הדרישות שלכם לגבי אחסון ועיבוד נתונים באופן מקומי.
כדי לקבוע אם לפלטפורמה לניתוח נתונים יש דרישות למיקום, ענו על שתי השאלות הבאות:
- האם צריך לפרוס את האפליקציה באזור ספציפי?
- האם הנתונים שלכם באחסון מוגבלים לאזור ספציפי?
אם עניתם "לא" על שתי השאלות, לפלטפורמת ניתוח הנתונים שלכם אין דרישות ספציפיות למיקום. מכיוון שלפלטפורמה שלכם אין דרישות למיקום, אתם יכולים לפעול לפי ההנחיות להתאוששות מאסון (DR) לשירותים ולמוצרים תואמים, שמפורטות במדריך לתכנון התאוששות מאסון.
עם זאת, אם התשובה לאחת מהשאלות היא "כן", האפליקציה מוגבלת מבחינת מיקום. מכיוון שפלטפורמת הניתוח שלכם מוגבלת למיקום, אתם צריכים לשאול את השאלה הבאה: האם אתם יכולים להשתמש בשיטות הצפנה כדי לצמצם את הדרישות לגבי נתונים במנוחה?
אם אתם יכולים להשתמש בשיטות הצפנה, אתם יכולים להשתמש בשירותים של Cloud External Key Manager ו-Cloud Key Management Service במספר אזורים ובשני אזורים. אפשר גם לפעול לפי השיטות הסטנדרטיות לזמינות גבוהה ולהתאוששות מאסון (HA/DR) שמפורטות במאמר תרחישים של התאוששות מאסון (DR) לנתונים.
אם אינכם יכולים להשתמש בטכניקות הצפנה, עליכם להשתמש בפתרונות בהתאמה אישית או בהצעות של שותפים לתכנון DR. למידע נוסף על שיטות לטיפול בהגבלות מיקום בתרחישים של DR, קראו את המאמר תכנון תוכנית התאוששות מאסון (DR) לעומסי עבודה שמוגבלים למיקום.
רכיבים בפלטפורמה לניתוח נתונים
אחרי שמבינים את הדרישות לגבי מיקום הנתונים, השלב הבא הוא להבין את הרכיבים שבהם משתמשת פלטפורמת ניתוח הנתונים. הרכיבים הנפוצים של פלטפורמת ניתוח נתונים הם מסדי נתונים, אגמי נתונים, צינורות עיבוד נתונים ומחסני נתונים, כפי שמתואר ברשימה הבאה:
- ב-Google Cloud יש קבוצה של שירותי מסדי נתונים שמתאימים לתרחישים שונים לדוגמה.
יכולים להיות הבדלים קלים בהגדרות של אגמי נתונים, מחסני נתונים וצינורות עיבוד נתונים. במסמך הזה אנחנו משתמשים בקבוצה של הגדרות שמתייחסות לשירותי Google Cloud :
- אגם נתונים הוא פלטפורמה מאובטחת וניתנת להתאמה, שמאפשרת להטמיע ולאחסן נתונים ממערכות מרובות. באגם נתונים טיפוסי, Cloud Storage יכול לשמש כמאגר הנתונים המרכזי.
- צינור עיבוד נתונים הוא תהליך מקצה לקצה שבו נתונים או אירועים נלקחים ממערכת אחת או יותר, עוברים שינוי ונטענים למערכת אחרת. צינור עיבוד הנתונים יכול לפעול לפי תהליך של חילוץ, טרנספורמציה וטעינה (ETL) או תהליך של חילוץ, טעינה וטרנספורמציה (ELT). בדרך כלל, המערכת שאליה נטענים הנתונים המעובדים היא מחסן נתונים. Pub/Sub, Dataflow ו-Managed Service for Apache Spark הם רכיבים נפוצים בצינור עיבוד נתונים.
- מחסן נתונים הוא מערכת ארגונית שמשמשת לניתוח נתונים ולדיווח עליהם, ובדרך כלל הנתונים מגיעים ממסד נתונים תפעולי. BigQuery היא מערכת מחסן נתונים (data warehouse) נפוצה שפועלת ב- Google Cloud.
ההטמעה בפועל של DR משתנה בהתאם לדרישות הרשות המוניציפאלית ולרכיבי ניתוח הנתונים שבהם אתם משתמשים. בקטעים הבאים מוסבר איך להשתמש בגרסה הזו בשני תרחישים לדוגמה.
תרחיש לדוגמה של אצווה: משימת ETL תקופתית
בתרחיש שימוש הראשון מתואר עיבוד ברצף שבו פלטפורמה קמעונאית אוספת מדי פעם אירועי מכירה כקבצים מחנויות שונות, ואז כותבת את הקבצים לקטגוריה של Cloud Storage. בתרשים הבא מוצגת ארכיטקטורת ניתוח הנתונים של המשימה באצווה של הקמעונאי.
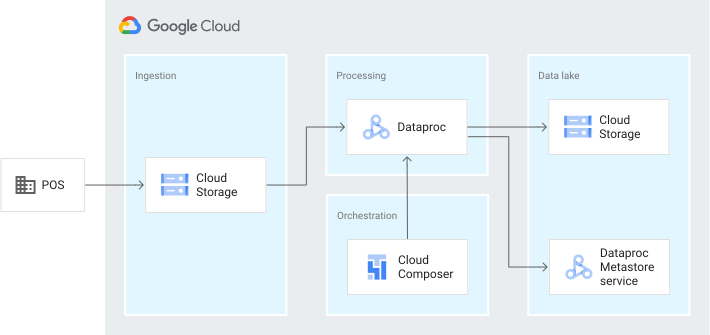
הארכיטקטורה כוללת את השלבים והרכיבים הבאים:
- בשלב ההטמעה, החנויות שולחות את נתוני נקודות המכירה (POS) שלהן ל-Cloud Storage. הנתונים האלה נקלטים וממתינים לעיבוד.
- בשלב התזמור, המערכת משתמשת ב-Managed Airflow כדי לתזמר את צינור עיבוד הנתונים באצווה מקצה לקצה.
- שלב העיבוד כולל משימת Apache Spark שפועלת באשכול Managed Service for Apache Spark. המשימה של Apache Spark מבצעת תהליך ETL על הנתונים שנקלטו. תהליך ה-ETL הזה מספק מדדים עסקיים.
- בשלב אגם הנתונים, הנתונים המעובדים נלקחים והמידע נשמר ברכיבים הבאים:
- הנתונים המעובדים מאוחסנים בדרך כלל בפורמטים של עמודות ב-Cloud Storage, כמו Parquet ו-ORC, כי הפורמטים האלה מאפשרים אחסון יעיל וגישה מהירה יותר לעומסי עבודה של ניתוח נתונים.
- המטא-נתונים של נתוני התהליך (כמו מסדי נתונים, טבלאות, עמודות ומחיצות) מאוחסנים בשירות Hive Metastore שמסופק על ידי Dataproc Metastore.
בתרחישים שמוגבלים למיקום מסוים, יכול להיות שיהיה קשה לספק יכולת עיבוד ותזמור מיותרת כדי לשמור על הזמינות. מכיוון שהנתונים מעובדים באצוות, אפשר ליצור מחדש את צינורות עיבוד הנתונים והתזמור, ולהפעיל מחדש את משימות האצווה אחרי שתרחיש האסון נפתר. לכן, בתוכנית התאוששות מאסון, המיקוד העיקרי הוא בשחזור הנתונים בפועל: נתוני ה-POS שנקלטו, הנתונים המעובדים שמאוחסנים באגם הנתונים והמטא-נתונים שמאוחסנים באגם הנתונים.
הטמעה ב-Cloud Storage
השיקול הראשון שצריך להביא בחשבון הוא דרישות המיקום של הקטגוריה ב-Cloud Storage שמשמשת להטמעת הנתונים ממערכת נקודת המכירה. השתמשו במידע הזה על המיקום כשאתם שוקלים את האפשרויות הבאות:
- אם דרישות המיקום מאפשרות לנתונים במנוחה להיות באחד מהמיקומים במספר אזורים או בשני אזורים, צריך לבחור את סוג המיקום המתאים כשיוצרים את הקטגוריה של Cloud Storage. סוג המיקום שתבחרו קובע באילו אזורים של Google Cloud תיווצר רפליקה של הנתונים באחסון. אם יש הפסקה זמנית בשירות באחד מהאזורים, עדיין אפשר לגשת לנתונים שנמצאים בקטגוריות במספר אזורים או בשני אזורים.
- ב-Cloud Storage יש תמיכה גם במפתחות הצפנה בניהול הלקוח (CMEK) וגם במפתחות הצפנה באספקת הלקוח (CSEK). כללי מיקום מסוימים מאפשרים לאחסן נתונים במנוחה בכמה מיקומים כשמשתמשים ב-CMEK או ב-CSEK לניהול מפתחות. אם כללי המיקום מאפשרים להשתמש ב-CMEK או ב-CSEK, אתם יכולים לתכנן את ארכיטקטורת ה-DR כך שתשתמש באזורי Cloud Storage.
- יכול להיות שדרישות המיקום שלכם לא מאפשרות לכם להשתמש בסוגי מיקומים או בניהול מפתחות הצפנה. אם אתם לא יכולים להשתמש בסוגי מיקומים או בניהול מפתחות הצפנה, אתם יכולים להשתמש בפקודה
gcloud storage rsyncכדי לסנכרן נתונים למיקום אחר, כמו אחסון מקומי או פתרונות אחסון של ספק שירותי ענן אחר.
אם מתרחש אסון, יכול להיות שבקטגוריה של Cloud Storage שבה נשמרים נתוני ה-POS שנקלטו יש נתונים שעדיין לא עברו עיבוד וייבוא לאגם הנתונים. לחלופין, יכול להיות שלא ניתן להטמיע את נתוני ה-POS בקטגוריה של Cloud Storage. במקרים כאלה, יש לכם את האפשרויות הבאות להתאוששות מאסון:
מנסים שוב במערכת ה-POS. אם המערכת לא מצליחה לכתוב את נתוני POS ב-Cloud Storage, תהליך הטמעת הנתונים נכשל. כדי לפתור את הבעיה, אתם יכולים להטמיע אסטרטגיית ניסיון חוזר שתאפשר למערכת POS לנסות שוב את פעולת הטמעת הנתונים. מכיוון ש-Cloud Storage מספק עמידות גבוהה, הטמעת הנתונים וצינור עיבוד הנתונים הבא יתחדשו עם אובדן נתונים מועט או ללא אובדן נתונים בכלל, אחרי ששירות Cloud Storage יתחדש.
ליצור עותקים של הנתונים שהוטמעו. Cloud Storage תומך בסוגי מיקומים במספר אזורים ובשני אזורים. בהתאם לדרישות שלכם לגבי אחסון ועיבוד נתונים באופן מקומי, יכול להיות שתוכלו להגדיר קטגוריה של Cloud Storage במספר אזורים או בשני אזורים כדי להגביר את הזמינות של הנתונים. אפשר גם להשתמש בכלים כמו הפקודה
gcloud storageשל Google Cloud CLI כדי לסנכרן נתונים בין Cloud Storage לבין מיקום אחר.
תזמור ועיבוד של נתוני POS שהוטמעו
בדיאגרמת הארכיטקטורה של תרחיש השימוש באצווה, Managed Airflow מבצע את השלבים הבאים:
- בודק אם קבצים חדשים הועלו לקטגוריית ההטמעה של Cloud Storage.
- הפעלת אשכול זמני של Managed Service for Apache Spark.
- מפעיל משימת Apache Spark כדי לעבד את הנתונים.
- מוחק את אשכול Managed Service for Apache Spark בסיום המשימה.
ב-Managed Airflow משתמשים בקובצי גרף אציקלי מכוון (DAG) שמגדירים את סדרת השלבים האלה. קובצי ה-DAG האלה מאוחסנים בקטגוריה של Cloud Storage שלא מוצגת בדיאגרמת הארכיטקטורה. מבחינת המיקום של שני אזורים ומספר אזורים, השיקולים של DR בקטגוריית קובצי ה-DAG זהים לאלה שנדונו בקטגוריית הטמעת הנתונים.
אשכולות של Managed Service for Apache Spark הם זמניים. כלומר, האשכולות קיימים רק כל עוד שלב העיבוד פועל. האופי הזמני הזה אומר שאתם לא צריכים לעשות שום דבר באופן מפורש להתאוששות מאסון באשכולות של Managed Service for Apache Spark.
אחסון אגם נתונים (data lake) באמצעות Cloud Storage
לקטגוריה של Cloud Storage שמשמשת לאגם הנתונים יש את אותם שיקולי מיקום כמו אלה שנדונו בקטגוריית הטמעת הנתונים: שיקולים של שני אזורים ומספר אזורים, שימוש בהצפנה ושימוש בפקודת ה-CLI של gcloud gcloud storage rsync.
כשמתכננים את תוכנית ה-DR לאגם הנתונים, כדאי לחשוב על ההיבטים הבאים:
גודל הנתונים. נפח הנתונים באגם נתונים יכול להיות גדול. שחזור של נפח נתונים גדול לוקח זמן. בתרחיש של DR, צריך להביא בחשבון את ההשפעה של נפח אגם הנתונים על משך הזמן שנדרש כדי לשחזר נתונים לנקודה שעומדת בקריטריונים הבאים:
- האפליקציה שלך זמינה.
- אתם עומדים בערך של יעד זמן ההתאוששות (RTO).
- אתם מקבלים את נקודת הבדיקה של הנתונים שאתם צריכים כדי לעמוד בערך של היעד להתאוששות מאסון (RPO).
בתרחיש לדוגמה הנוכחי של אצווה, Cloud Storage משמש למיקום של אגם הנתונים ומספק עמידות גבוהה. עם זאת, ההתקפות של תוכנות כופר מתגברות. כדי לוודא שתוכלו להתאושש ממתקפות כאלה, כדאי לפעול לפי השיטות המומלצות שמפורטות במאמר איך Cloud Storage מספק עמידות של 11 תשיעיות.
תלות בנתונים. בדרך כלל, הנתונים באגמי נתונים נצרכים על ידי רכיבים אחרים של מערכת ניתוח נתונים, כמו צינור עיבוד נתונים. בתרחיש של התאוששות מאסון, צינור עיבוד הנתונים והנתונים שהוא תלוי בהם צריכים להיות בעלי אותו RTO. בהקשר הזה, צריך להתמקד במשך הזמן שבו המערכת יכולה להיות לא זמינה.
גיל הנתונים. נתונים היסטוריים יכולים לאפשר RPO גבוה יותר. יכול להיות שרכיבים אחרים לניתוח נתונים כבר ניתחו או עיבדו את סוג הנתונים הזה, ושהוא נשמר ברכיב אחר שיש לו אסטרטגיות משלו להתאוששות מאסון. לדוגמה, רשומות של מכירות שמיוצאות ל-Cloud Storage מיובאות מדי יום ל-BigQuery לצורך ניתוח. עם אסטרטגיות DR מתאימות ל-BigQuery, רשומות היסטוריות של מכירות שיובאו ל-BigQuery עשויות להיות בעלות יעדי שחזור נמוכים יותר מאלה שלא יובאו.
אחסון מטא-נתונים של אגם נתונים (data lake) באמצעות Dataproc Metastore
Dataproc Metastore הוא Apache Hive metastore מנוהל, עם זמינות גבוהה, תיקון תוכנה אוטומטי (autohealing) ובלי שרת (serverless). מטא-נתונים מספק תכונות של הפשטת נתונים וגילוי נתונים. במקרה של אסון, אפשר לגבות את המטא-נתונים ולשחזר אותם. שירות Dataproc Metastore מאפשר גם לייצא ולייבא מטא-נתונים. אתם יכולים להוסיף משימה לייצוא המטא-נתונים ולשמור גיבוי חיצוני יחד עם משימת ה-ETL.
אם נתקלתם במצב שבו יש חוסר התאמה במטא-נתונים, אתם יכולים ליצור מחדש את מאגר המטא-נתונים מהנתונים עצמם באמצעות הפקודה MSCK.
תרחיש לדוגמה של סטרימינג: סימון נתונים שהשתנו (CDC) באמצעות ELT
בתרחיש השני מתוארת פלטפורמה קמעונאית שמשתמשת בסימון נתונים שהשתנו (CDC) כדי לעדכן את מערכות המלאי בקצה העורפי ולעקוב אחרי מדדי מכירות בזמן אמת. בתרשים הבא מוצגת ארכיטקטורה שבה אירועים ממסד נתונים טרנזקציונלי, כמו Cloud SQL, מעובדים ואז מאוחסנים במחסן נתונים.
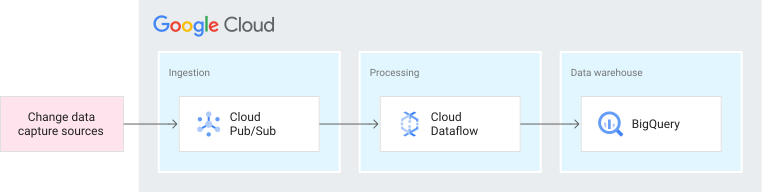
הארכיטקטורה כוללת את השלבים והרכיבים הבאים:
- בשלב ההטמעה, אירועי השינוי הנכנסים נשלחים אל Pub/Sub. Pub/Sub הוא שירות להעברת הודעות, שמשמש להטמעה ולהפצה של נתוני ניתוח בזמן אמת באופן מהימן. ל-Pub/Sub יש יתרונות נוספים: הוא גם ניתן להתאמה וגם פועל בלי שרת (serverless).
- בשלב העיבוד, משתמשים ב-Dataflow כדי לבצע תהליך ELT על האירועים שנקלטו.
- בשלב של מחסן הנתונים, האירועים המעובדים מאוחסנים ב-BigQuery. פעולת המיזוג מוסיפה או מעדכנת רשומה ב-BigQuery. הפעולה הזו מאפשרת לעדכן את המידע שמאוחסן ב-BigQuery בהתאם למסד הנתונים של העסקאות.
למרות שארכיטקטורת ה-CDC הזו לא מסתמכת על Managed Airflow, חלק מארכיטקטורות ה-CDC דורשות Managed Airflow כדי לתזמר את השילוב של הסטרימינג בעומסי עבודה באצווה. במקרים כאלה, תהליך העבודה של Managed Airflow מטמיע בדיקות תקינות, מילויים חסרים ותחזיות שלא ניתן לבצע בזמן אמת בגלל אילוצי זמן אחזור. טכניקות DR עבור Managed Airflow מתוארות בתרחיש השימוש של עיבוד ברצף (batch processing), שמופיע מוקדם יותר במאמרי העזרה.
כשמתכננים ארכיטקטורת DR לפייפליין נתונים בסטרימינג, צריך להביא בחשבון את הדברים הבאים:
- יחסי תלות של צינור עיבוד הנתונים. צינורות עיבוד נתונים מקבלים קלט ממערכת אחת או יותר (המקורות). לאחר מכן, הצינורות מעבדים את הקלט, משנים אותו ומאחסנים אותו במערכות אחרות (הכיורים). חשוב לתכנן את ארכיטקטורת ה-DR כך שתשיג את ה-RTO מקצה לקצה. חשוב לוודא שה-RPO של מקורות הנתונים ושל ה-sink מאפשר לכם לעמוד ב-RTO. בנוסף לתכנון של ארכיטקטורת הענן כך שתעמוד בדרישות המיקום, תצטרכו גם לתכנן את מקורות ה-CDC המקוריים כך שיאפשרו לעמוד ב-RTO מקצה לקצה.
- הצפנה ומיקום. אם ההצפנה מאפשרת לכם לצמצם את ההגבלות על המיקום, אתם יכולים להשתמש ב-Cloud KMS כדי להשיג את המטרות הבאות:
- לנהל את מפתחות ההצפנה שלכם.
- להשתמש ביכולת ההצפנה של שירותים ספציפיים.
- לפרוס שירותים באזורים שלא היו זמינים לשימוש בגלל הגבלות מקומיות.
- כללי לוקליזציה של נתונים בתנועה. יכול להיות שכללים מסוימים לגבי מיקום חלים רק על נתונים באחסון ולא על נתונים בתנועה. אם הכללים המקומיים לא חלים על נתונים בתנועה, כדאי לתכנן את ארכיטקטורת ה-DR כך שתשתמש במשאבים באזורים אחרים כדי לשפר את יעדי השחזור. אתם יכולים להשלים את הגישה האזורית באמצעות שילוב של שיטות הצפנה.
הטמעה ב-Pub/Sub
אם אין לכם הגבלות על מיקום, אתם יכולים לפרסם הודעות בנקודת הקצה הגלובלית של Pub/Sub. נקודות הקצה הגלובליות של Pub/Sub גלויות ונגישות מכל מיקום ב-Google Cloud .
אם דרישות המיקום שלכם מאפשרות שימוש בהצפנה, אפשר להגדיר את Pub/Sub כך שתהיה לו רמת זמינות גבוהה שדומה לזו של נקודות קצה גלובליות. הודעות Pub/Sub מוצפנות באמצעותGoogle-owned and Google-managed encryption keys כברירת מחדל, אבל אפשר להגדיר את Pub/Sub כך שישתמש ב-CMEK במקום זאת. השימוש ב-Pub/Sub עם CMEK מאפשר לכם לעמוד בכללי המיקום בנוגע להצפנה, ועדיין לשמור על זמינות גבוהה.
לפי כללים מקומיים מסוימים, ההודעות צריכות להישאר במיקום ספציפי גם אחרי ההצפנה. אם הכללים המקומיים שלכם כוללים את ההגבלה הזו, אתם יכולים לציין את מדיניות אחסון ההודעות של נושא Pub/Sub ולהגביל אותה לאזור מסוים. אם אתם משתמשים בגישה הזו לאחסון הודעות, הודעות שמתפרסמות בנושא אף פעם לא נשמרות מחוץ לקבוצת האזורים של Google Cloud שציינתם. אם כללי המיקום שלכם מאפשרים להשתמש ביותר מאזור אחד של Google Cloud , אתם יכולים להגדיל את זמינות השירות על ידי הפעלת האזורים האלה בנושא Pub/Sub. חשוב לדעת שהטמעת מדיניות אחסון הודעות כדי להגביל את מיקומי המשאבים של Pub/Sub כרוכה בפשרות בנוגע לזמינות.
מינוי ל-Pub/Sub מאפשר לאחסן הודעות שלא אושרו למשך עד 7 ימים, ללא הגבלה על מספר ההודעות. אם הסכם רמת השירות שלכם מאפשר עיכוב בנתונים, אתם יכולים לאחסן את הנתונים במאגר נתונים זמני במינוי ל-Pub/Sub אם צינורות עיבוד הנתונים מפסיקים לפעול. כשהצינורות יפעלו שוב, תוכלו לעבד את האירועים שגובו. היתרון של התכנון הזה הוא RPO נמוך. מידע נוסף על מגבלות המשאבים במכסות של Pub/Sub
עיבוד אירועים באמצעות Dataflow
Dataflow הוא שירות מנוהל להרצה של מגוון רחב של דפוסי עיבוד נתונים. Apache Beam SDK הוא מודל תכנות בקוד פתוח שמאפשר לפתח צינורות עיבוד נתונים באצווה ופייפליינים זורמים. אתם יוצרים את צינורות עיבוד הנתונים באמצעות תוכנית Apache Beam, ואז מריצים אותם בשירות Dataflow.
כשמתכננים הגבלות על מיקום, צריך להביא בחשבון את המיקום של המקורות, ה-sink והקבצים הזמניים. אם מיקומי הקבצים האלה נמצאים מחוץ לאזור של המשימה, יכול להיות שהנתונים יישלחו בין אזורים. אם הכללים המקומיים מאפשרים לעבד נתונים במיקום אחר, כדאי לתכנן את ארכיטקטורת ה-DR כך שפריסת ה-workers תהיה באזורי Google Cloud אחרים כדי לספק זמינות גבוהה.
אם הגבלות המיקום שלכם מגבילות את העיבוד למיקום אחד, אתם יכולים ליצור משימת Dataflow שמוגבלת לאזור או לתחום ספציפיים. כששולחים משימת Dataflow, אפשר לציין את הפרמטרים נקודת קצה אזורית, אזור של ה-worker ואזור של ה-worker. הפרמטרים האלה קובעים איפה העובדים נפרסים ואיפה המטא-נתונים של המשימה מאוחסנים.
Apache Beam מספקת מסגרת שמאפשרת להריץ צינורות עיבוד נתונים באמצעות מריצים שונים. אתם יכולים לתכנן את ארכיטקטורת ה-DR כך שתנצל את היכולת הזו. לדוגמה, אתם יכולים לתכנן ארכיטקטורת DR עם פייפליין לגיבוי, שפועל באשכול Spark המקומי באמצעות Apache Spark Runner. כדי לבדוק אם מריץ ספציפי יכול לבצע פעולה מסוימת בצינור עיבוד הנתונים, אפשר לעיין במטריצת היכולות של Beam.
אם ההצפנה מאפשרת לכם לצמצם את ההגבלות על המיקום, אתם יכולים להשתמש ב-CMEK ב-Dataflow כדי להצפין את פריטי המידע שנוצרו בתהליך של מצב צינור עיבוד הנתונים, וגם כדי לגשת למקורות ולכיורים שמוגנים באמצעות מפתחות Cloud KMS. באמצעות הצפנה, אתם יכולים לתכנן ארכיטקטורת DR שמשתמשת באזורים שלא היו זמינים בגלל מגבלות מקומיות.
מחסן נתונים (data warehouse) שמבוסס על BigQuery
מחסני נתונים תומכים בניתוח נתונים ובקבלת החלטות. בנוסף למסד נתונים אנליטי, מחסני נתונים מכילים כמה רכיבים ופרוצדורות אנליטיים.
כשמתכננים את תוכנית ה-DR למחסן הנתונים, כדאי לחשוב על המאפיינים הבאים:
גודל. מחסני נתונים גדולים בהרבה ממערכות לעיבוד טרנזקציות אונליין (OLTP). במחסני נתונים יש בדרך כלל נתונים בנפח של טרה-בייטים עד פטה-בייטים. כדי להשיג את ערכי ה-RPO וה-RTO, צריך להביא בחשבון את משך הזמן שיידרש לשחזור הנתונים האלה. כשמתכננים אסטרטגיית DR, צריך להביא בחשבון גם את העלות של שחזור טרה-בייטים של נתונים. למידע נוסף על טכניקות לצמצום נזקי התאוששות מאסון ב-BigQuery, קראו את המידע על BigQuery בקטע מנגנוני גיבוי ושחזור של שירותי מסדי הנתונים המנוהלים ב- Google Cloud.
זמינות. כשיוצרים מערך נתונים ב-BigQuery, בוחרים מיקום שבו הנתונים יאוחסנו: אזורי או במספר אזורים. מיקום אזורי הוא מיקום גיאוגרפי ספציפי אחד, כמו איווה (
us-central1). מיקום במספר אזורים הוא אזור גיאוגרפי גדול, כמו ארצות הברית (US) או אירופה (EU), שמכיל שני מקומות גיאוגרפיים או יותר.כשמתכננים תוכנית DR כדי לעמוד במגבלות המיקום, דומיין הכשל (כלומר, אם הכשל מתרחש ברמת המכונה, האזור או המחוז) ישפיע ישירות על העמידה ב-RTO שהגדרתם. במאמר זמינות ועמידות של BigQuery תוכלו לקרוא מידע נוסף על דומייני הכשל האלה ואיך הם משפיעים על הזמינות.
אופי הנתונים. מחסני נתונים מכילים מידע היסטורי, ורוב הנתונים הישנים הם בדרך כלל סטטיים. מחסני נתונים רבים מיועדים להוספה בלבד. אם מחסן הנתונים שלכם הוא מסוג append-only, יכול להיות שתוכלו להשיג את ה-RTO על ידי שחזור הנתונים שנוספים בלבד. בגישה הזו, אתם מגבים רק את הנתונים שנוספו. אם יקרה אסון, תוכלו לשחזר את הנתונים שנוספו ולהשתמש במחסן הנתונים, אבל רק עם חלק מהנתונים.
דפוס הוספה ועדכון של נתונים. בדרך כלל, מחסני נתונים מתעדכנים באמצעות תבניות ETL או ELT. כשיש לכם נתיבי עדכון מבוקרים, אתם יכולים לשחזר אירועי עדכון אחרונים ממקורות חלופיים.
יכול להיות שדרישות המיקום שלכם יגבילו את האפשרות להשתמש באזור אחד או בכמה אזורים למחסן הנתונים. אפשר להשתמש במערכי נתונים אזוריים ב-BigQuery, אבל אחסון בכמה אזורים הוא הדרך הפשוטה והמשתלמת ביותר להבטיח שהנתונים יהיו זמינים במקרה של אסון. אם האחסון במספר אזורים לא זמין באזור שלכם, אבל אתם יכולים להשתמש באזור אחר, אתם יכולים להשתמש בשירות העברת הנתונים ל-BigQuery כדי להעתיק את מערך הנתונים לאזור אחר. אם אתם יכולים להשתמש בהצפנה כדי לצמצם את דרישות המיקום, אתם יכולים לנהל את מפתחות ההצפנה שלכם באמצעות Cloud KMS ו-BigQuery.
אם אתם יכולים להשתמש רק באזור אחד, כדאי לגבות את הטבלאות ב-BigQuery. הפתרון הכי משתלם לגיבוי טבלאות הוא להשתמש בBigQuery Export. משתמשים ב-Cloud Scheduler או ב-Managed Airflow כדי לתזמן מדי פעם משימת ייצוא לכתיבה ב-Cloud Storage. אפשר להשתמש בפורמטים כמו Avro עם דחיסת SNAPPY או JSON עם דחיסת GZIP. כשאתם מתכננים את אסטרטגיות הייצוא, שימו לב למגבלות הייצוא.
יכול להיות שתרצו גם לאחסן גיבויים של BigQuery בפורמטים של עמודות כמו Parquet ו-ORC. הפורמטים האלה מספקים דחיסה גבוהה ומאפשרים יכולת פעולה הדדית עם הרבה מנועי קוד פתוח, כמו Hive ו-Presto, שיכול להיות שיש לכם במערכות המקומיות. בתרשים הבא מתואר תהליך הייצוא של נתוני BigQuery לפורמט עמודות, כדי לאחסן אותם במיקום מקומי.
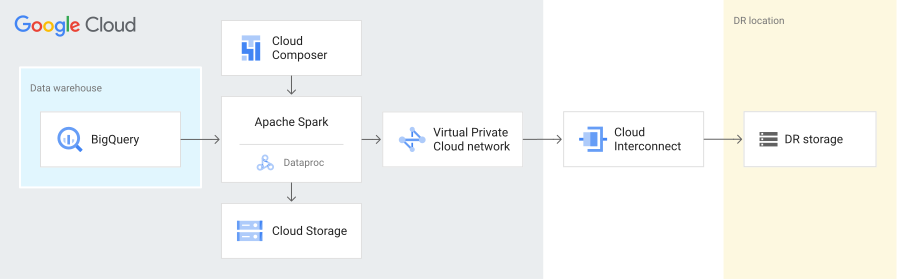
באופן ספציפי, התהליך של ייצוא נתונים מ-BigQuery למיקום אחסון מקומי כולל את השלבים הבאים:
- הנתונים מ-BigQuery נשלחים למשימת Apache Spark ב-Managed Service for Apache Spark. השימוש במשימת Apache Spark מאפשר פיתוח סכימה.
- אחרי שהמשימה של Managed Service for Apache Spark מעבדת את הקבצים של BigQuery, הקבצים המעובדים נכתבים ב-Cloud Storage ואז מועברים למיקום מקומי של התאוששות מאסון.
- Cloud Interconnect משמש לחיבור של רשת הענן הווירטואלי הפרטי (VPC) לרשת המקומית.
- ההעברה למיקום ה-DR המקומי יכולה להתבצע באמצעות משימת Spark.
אם מחסן הנתונים שלכם מוגדר להוספה בלבד ומחולק למחיצות לפי תאריך, אתם צריכים ליצור עותק של המחיצות הנדרשות בטבלה חדשה לפני שאתם מריצים משימת BigQuery Export בטבלה החדשה. אחר כך אפשר להשתמש בכלי כמו פקודת ה-CLI של gcloud gcloud storage כדי להעביר את הקבצים המעודכנים למיקום הגיבוי בארגון או בענן אחר.
(יכול להיות שיחולו חיובים על תעבורת נתונים יוצאת כשמעבירים נתונים מחוץ ל- Google Cloud).
לדוגמה, נניח שיש לכם מחסן נתונים של מכירות שמורכב מטבלת orders עם הרשאת הוספה בלבד, שבה הזמנות חדשות מתווספות למחיצה שמייצגת את התאריך הנוכחי. עם זאת, מדיניות החזרת מוצרים עשויה לאפשר החזרת פריטים תוך 7 ימים. לכן, יכול להיות שהרשומות בטבלה orders מ-7 הימים האחרונים יעודכנו. אסטרטגיות הייצוא שלכם צריכות להביא בחשבון את מדיניות החזרת המוצרים. בדוגמה הזו, כל משימת ייצוא לגיבוי הטבלה orders צריכה לייצא גם את המחיצות שמייצגות הזמנות מ-7 הימים האחרונים, כדי למנוע מצב שבו עדכונים יתפספסו בגלל החזרות.
המאמרים הבאים
- מאמרים נוספים בסדרה הזו בנושא התאוששות מאסון:
- בסקירה המפורטת מוסבר על מיקום, שקיפות תפעולית ופרטיות של נתונים ב- Google Cloudללקוחות באירופה.
- לדוגמאות נוספות של ארכיטקטורות, תרשימים ושיטות מומלצות, עיינו במאמר Cloud Architecture Center.
שותפים ביצירת התוכן
מחברים:
- גרייס מוליסון | ראש צוות פתרונות
- מרקו פרארי | ארכיטקט פתרונות ענן