


MedLM היא משפחה של מודלים בסיסיים שעברו התאמה מדויקת לתעשיית הבריאות. Med-PaLM 2 הוא אחד מהמודלים מבוססי-הטקסט שפותחו על ידי צוות המחקר של Google, שעליו מבוסס MedLM. זו הייתה מערכת ה-AI הראשונה שהגיעה לרמה של מומחה אנושי במענה על שאלות בסגנון בחינת הרישוי ברפואה של ארצות הברית (USMLE). פיתוח המודלים האלה התבסס על צרכים ספציפיים של לקוחות, כמו מענה על שאלות רפואיות וניסוח סיכומים.
כרטיס מודל MedLM
בכרטיס המודל של MedLM מפורטים פרטי המודל, כמו השימוש המיועד ב-MedLM, סקירת הנתונים ומידע על בטיחות. כדי להוריד גרסת PDF של כרטיס המודל MedLM, לוחצים על הקישור הבא:
תרחישים לדוגמה
- מענה לשאלות: יצירת טיוטות של תשובות לשאלות שקשורות לתחום הרפואה, שמוצגות כטקסט.
- סיכום: טיוטה של גרסה קצרה יותר של מסמך (כמו סיכום אחרי ביקור או הערה על היסטוריה ובדיקה גופנית) שכוללת מידע רלוונטי מהטקסט המקורי.
מידע נוסף על עיצוב הנחיות טקסט זמין במאמר סקירה כללית של אסטרטגיות למתן הנחיות.
בקשת HTTP
MedLM-medium (medlm-medium):
POST https://us-central1-aiplatform.googleapis.com/v1/projects/{PROJECT_ID}/locations/us-central1/publishers/google/models/medlm-medium:predict
MedLM-large (medlm-large):
POST https://us-central1-aiplatform.googleapis.com/v1/projects/{PROJECT_ID}/locations/us-central1/publishers/google/models/medlm-large:predict
מידע נוסף זמין בשיטה predict.
גרסאות המודלים
MedLM מספק את המודלים הבאים:
- MedLM-medium (
medlm-medium) - MedLM-large (
medlm-large)
בטבלה הבאה מפורטות הגרסאות היציבות של המודלים שזמינות:
| מודל medlm-medium | תאריך השקה |
|---|---|
medlm-medium |
13 בדצמבר 2023 |
| מודל medlm-large | תאריך השקה |
|---|---|
medlm-large |
13 בדצמבר 2023 |
ל-MedLM-medium ול-MedLM-large יש נקודות קצה נפרדות, והם מספקים ללקוחות גמישות נוספת לתרחישי השימוש שלהם. MedLM-medium מספק ללקוחות תפוקה טובה יותר וכולל נתונים עדכניים יותר. MedLM-large הוא אותו מודל משלב התצוגה המקדימה. שני המודלים ימשיכו להתעדכן במהלך מחזור החיים של המוצר. בדף הזה, המונח MedLM מתייחס לשני המודלים.
מידע נוסף זמין במאמר גרסאות של מודלים ומחזור החיים שלהם.
מסנני בטיחות ומאפיינים של MedLM
התוכן שעובר עיבוד באמצעות MedLM API נבדק לפי רשימה של מאפייני בטיחות, כולל 'קטגוריות מזיקות' ונושאים שעשויים להיחשב רגישים. אם אתם רואים תשובה חלופית, כמו "אין לי אפשרות לעזור בנושא הזה, כי אני רק מודל שפה", זה אומר שההנחיה או התשובה מפעילות מסנן בטיחות.
ערכי סף של בטיחות
כשמשתמשים ב-Vertex AI Studio, אפשר להשתמש בסף מתכוונן של מסנן בטיחות כדי לקבוע מה הסיכוי שתראו תשובות שעלולות להיות מזיקות. התשובות של המודל נחסמות על סמך ההסתברות שהן מכילות הטרדה, דברי שטנה, תוכן מסוכן או תוכן מיני בוטה. הגדרת מסנן הבטיחות נמצאת בצד שמאל של שדה ההנחיה ב-Vertex AI Studio. אפשר לבחור מבין שלוש אפשרויות: block most, block some ו-block few.
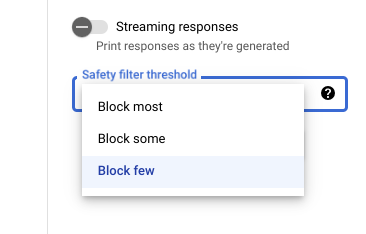
בדיקת ספי החומרה והביטחון
אתם יכולים לבדוק את מסנני הבטיחות של Google ולהגדיר ספי רמת ביטחון שמתאימים לעסק שלכם. בעזרת ערכי הסף האלה, תוכלו לנקוט אמצעים מקיפים כדי לזהות תוכן שמפר את מדיניות השימוש או את התנאים וההגבלות של Google, ולנקוט פעולות מתאימות.
ציוני המהימנות הם תחזיות בלבד, ואסור להסתמך עליהם כדי לקבוע את רמת המהימנות או הדיוק. Google לא אחראית לפרש את הציונים האלה או להשתמש בהם כדי לקבל החלטות עסקיות.
שיטות מומלצות
כדי להשתמש בטכנולוגיה הזו בצורה בטוחה ואחראית, חשוב לקחת בחשבון סיכונים אחרים שספציפיים לתרחיש השימוש, למשתמשים ולסביבה העסקית שלכם, בנוסף לאמצעי ההגנה הטכניים המובנים.
מומלץ לבצע את השלבים הבאים:
- הערכת סיכוני האבטחה של האפליקציה.
- כדאי לשקול לבצע שינויים כדי לצמצם את סיכוני הבטיחות.
- לבצע בדיקות בטיחות שמתאימות לתרחיש השימוש.
- לבקש משוב מהמשתמשים ולעקוב אחרי התוכן.
מידע נוסף זמין בהמלצות של Google בנושא אתיקה של בינה מלאכותית.
גוף הבקשה
{
  "instances": [
    {
      "content": string
    }
  ],
  "parameters": {
    "temperature": number,
    "maxOutputTokens": integer,
    "topK": integer,
    "topP": number
  }
}
משתמשים בפרמטרים הבאים עבור המודלים medlm-medium ו-medlm-large.
מידע נוסף זמין במאמר בנושא יצירת הנחיות טקסט.
| פרמטר | תיאור | ערכים קבילים |
|---|---|---|
|
קלט טקסט ליצירת תשובה לדוגמה. ההנחיות יכולות לכלול הקדמה, שאלות, הצעות, הוראות או דוגמאות. | טקסט |
|
רמת האקראיות משמשת לדגימה במהלך יצירת התגובה, שמתרחשת כשמחילים את topP ואת topK. הטמפרטורה שולטת במידת האקראיות בבחירת האסימון.
טמפרטורות נמוכות טובות להנחיות שדורשות תשובה פחות פתוחה או יצירתית, ואילו טמפרטורות גבוהות יכולות להוביל לתוצאות יותר מגוונות או יצירתיות. רמת אקראיות של 0
פירושה שהאסימונים עם ההסתברות הכי גבוהה תמיד נבחרים. במקרה כזה, התשובות להנחיה נתונה הן ברובן דטרמיניסטיות, אבל עדיין יכולות להיות וריאציות קלות.
אם המודל מחזיר תשובה כללית מדי, קצרה מדי או תשובת ברירת מחדל, נסו להגדיל את רמת האקראיות. אם המודל נכנס ליצירה אינסופית, יכול להיות שהעלאת רמת האקראיות ל- 1.0 הוא ערך הטמפרטורה המומלץ להתחלה.
|
|
|
מספר האסימונים המקסימלי שאפשר ליצור בתשובה. טוקן הוא בערך ארבעה תווים. 100 טוקנים תואמים בערך ל-60 עד 80 מילים.
כדי לקבל תשובות קצרות יותר, מציינים ערך נמוך יותר, וכדי לקבל תשובות ארוכות יותר, מציינים ערך גבוה יותר. |
|
|
השינוי של Top-K משפיע על האופן שבו המודל בוחר אסימונים לפלט. ערך של Top-K של 1 אומר שהאסימון הבא שנבחר הוא האסימון הסביר ביותר מבין כל האסימונים באוצר המילים של המודל (נקרא גם פענוח חמדני), בעוד שערך של Top-K של 3 אומר שהאסימון הבא נבחר מבין שלושת האסימונים הסבירים ביותר באמצעות רמת אקראיות.
בכל שלב של בחירת אסימון, המערכת דוגמת את האסימונים המובילים מתוך K האסימונים עם ההסתברות הכי גבוהה. לאחר מכן, הטוקנים מסוננים עוד יותר על סמך Top-P, והטוקן הסופי נבחר באמצעות דגימת רמת אקראיות. מציינים ערך נמוך יותר כדי לקבל תשובות פחות אקראיות, וערך גבוה יותר כדי לקבל תשובות יותר אקראיות. |
|
|
ההגדרה Top-P משנה את האופן שבו המודל בוחר אסימונים לפלט. האסימונים נבחרים מההסתברות הגבוהה ביותר להסתברות הנמוכה ביותר עד שסכום ההסתברויות שלהם שווה לערך של top-P. לדוגמה, אם לאסימונים A, B ו-C יש הסתברות של 0.3, 0.2 ו-0.1, והערך של top-P הוא 0.5, אז המודל יבחר באסימון A או באסימון B כאסימון הבא באמצעות רמת אקראיות, ויפסול את C כמועמד.
מציינים ערך נמוך יותר כדי לקבל תשובות פחות אקראיות, וערך גבוה יותר כדי לקבל תשובות יותר אקראיות. |
|
דוגמה לבקשה
כשמשתמשים ב-MedLM API, חשוב לשלב הנדסת הנחיות. לדוגמה, מומלץ מאוד לספק בתחילת כל הנחיה הוראות מתאימות וספציפיות למשימה. מידע נוסף זמין במאמר מבוא לכתיבת הנחיות.
REST
לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הנתונים הבאים:
-
PROJECT_ID: מזהה הפרויקט. -
MEDLM_MODEL: מודל MedLM, medlm-mediumאוmedlm-large.
ה-method של ה-HTTP וכתובת ה-URL:
POST https://us-central1-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/us-central1/publishers/google/models/MEDLM_MODEL:predict
גוף בקשת JSON:
{
  "instances": [
    {
      "content": "Question: What causes you to get ringworm?"
    }
  ],
  "parameters": {
    "temperature": 0,
    "maxOutputTokens": 256,
    "topK": 40,
    "topP": 0.95
  }
}
כדי לשלוח את הבקשה עליכם לבחור אחת מהאפשרויות הבאות:
curl
שומרים את גוף הבקשה בקובץ בשם request.json.
כדי ליצור או להחליף את הקובץ הזה בספרייה הנוכחית, מריצים את הפקודה הבאה בטרמינל:
cat > request.json << 'EOF'
{
  "instances": [
    {
      "content": "Question: What causes you to get ringworm?"
    }
  ],
  "parameters": {
    "temperature": 0,
    "maxOutputTokens": 256,
    "topK": 40,
    "topP": 0.95
  }
}
EOF
לאחר מכן מבצעים את הפקודה הבאה כדי לשלוח את בקשת ה-REST:
curl -X POST \
     -H "Authorization: Bearer $(gcloud auth print-access-token)" \
     -H "Content-Type: application/json; charset=utf-8" \
     -d @request.json \
     "https://us-central1-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/us-central1/publishers/google/models/MEDLM_MODEL:predict"
PowerShell
שומרים את גוף הבקשה בקובץ בשם request.json.
כדי ליצור או להחליף את הקובץ הזה בספרייה הנוכחית, מריצים את הפקודה הבאה בטרמינל:
@'
{
  "instances": [
    {
      "content": "Question: What causes you to get ringworm?"
    }
  ],
  "parameters": {
    "temperature": 0,
    "maxOutputTokens": 256,
    "topK": 40,
    "topP": 0.95
  }
}
'@  | Out-File -FilePath request.json -Encoding utf8
לאחר מכן מבצעים את הפקודה הבאה כדי לשלוח את בקשת ה-REST:
$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
    -Method POST `
    -Headers $headers `
    -ContentType: "application/json; charset=utf-8" `
    -InFile request.json `
    -Uri "https://us-central1-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/us-central1/publishers/google/models/MEDLM_MODEL:predict" | Select-Object -Expand Content
גוף התשובה
{
  "predictions": [
    {
      "content": string,
      "citationMetadata": {
        "citations": [
          {
            "startIndex": integer,
            "endIndex": integer,
            "url": string,
            "title": string,
            "license": string,
            "publicationDate": string
          }
        ]
      },
      "logprobs": {
        "tokenLogProbs": [ float ],
        "tokens": [ string ],
        "topLogProbs": [ { map<string, float> } ]
      },
      "safetyAttributes": {
        "categories": [ string ],
        "blocked": boolean,
        "scores": [ float ],
        "errors": [ int ]
      }
    }
  ],
  "metadata": {
    "tokenMetadata": {
      "input_token_count": {
        "total_tokens": integer,
        "total_billable_characters": integer
      },
      "output_token_count": {
        "total_tokens": integer,
        "total_billable_characters": integer
      }
    }
  }
}
| רכיב התגובה | תיאור |
|---|---|
content |
התוצאה שנוצרת מטקסט הקלט. |
categories |
השמות המוצגים של קטגוריות מאפייני הבטיחות שמשויכות לתוכן שנוצר. ההזמנה תואמת לניקוד. |
scores |
ציוני המהימנות של כל קטגוריה. ערך גבוה יותר מציין מהימנות גבוהה יותר. |
blocked |
דגל שמציין אם הקלט או הפלט של המודל נחסמו. |
errors |
קוד שגיאה שמזהה למה הקלט או הפלט נחסמו. רשימה של קודי שגיאה מופיעה במאמר מסנני בטיחות ומאפיינים. |
startIndex |
האינדקס בפלט החיזוי שבו מתחיל הציטוט (כולל). הערך חייב להיות גדול מ-0 או שווה לו וקטן מ-end_index. |
endIndex |
האינדקס בפלט החיזוי שבו מסתיים הציטוט (לא כולל). הערך חייב להיות גדול מ-start_index וקטן מ-len(output). |
url |
כתובת ה-URL שמשויכת לציטוט הזה. אם השדה הזה קיים, כתובת ה-URL הזו מקשרת לדף האינטרנט של מקור הציטוט. כתובות URL אפשריות כוללות אתרים חדשותיים, מאגרי GitHub וכו'. |
title |
השם שמשויך לציטוט הזה. אם הפרמטר קיים, הוא מתייחס לשם המקור של הציטוט. הכותרים האפשריים כוללים כותרים של חדשות, כותרים של ספרים וכו'. |
license |
הרישיון שמשויך לדקלום הזה. אם השדה הזה מופיע, הוא מתייחס לרישיון של המקור שבו מופיע הציטוט הזה. רישיונות אפשריים כוללים רישיונות קוד, כמו רישיון MIT. |
publicationDate |
תאריך הוצאה לאור שמשויך לציטוט ביבליוגרפי זה. אם הוא קיים, הוא מתייחס לתאריך שבו פורסם המקור של הציטוט הזה. הפורמטים האפשריים הם YYYY, YYYY-MM, YYYY-MM-DD. |
input_token_count |
מספר הטוקנים של הקלט. זהו המספר הכולל של הטוקנים בכל ההנחיות, הקידומות והסיומות. |
output_token_count |
מספר טוקני הפלט. זהו המספר הכולל של הטוקנים ב-content בכל התחזיות. |
tokens |
הטוקנים שנכללים במדגם. |
tokenLogProbs |
ההסתברויות הלוגריתמיות של האסימונים שנדגמו. |
topLogProb |
האסימונים המועמדים הסבירים ביותר וההסתברויות שלהם בכל שלב. |
logprobs |
תוצאות של הפרמטר logprobs. מיפוי 1:1 אל candidates. |
דוגמה לתשובה
{
  "predictions": [
    {
      "citationMetadata": {
        "citations": []
      },
      "content": "\n\nAnswer and Explanation:\nRingworm is a fungal infection of the skin that is caused by a type of fungus called dermatophyte. Dermatophytes can live on the skin, hair, and nails, and they can be spread from person to person through direct contact or through contact with contaminated objects.\n\nRingworm can cause a variety of symptoms, including:\n\n* A red, itchy rash\n* A raised, circular border\n* Blisters or scales\n* Hair loss\n\nRingworm is most commonly treated with antifungal medications, which can be applied to the skin or taken by mouth. In some cases, surgery may be necessary to remove infected hair or nails.",
      "safetyAttributes": {
        "scores": [
          1
        ],
        "blocked": false,
        "categories": [
          "Health"
        ]
      }
    }
  ],
  "metadata": {
    "tokenMetadata": {
      "outputTokenCount": {
        "totalTokens": 140,
        "totalBillableCharacters": 508
      },
      "inputTokenCount": {
        "totalTokens": 10,
        "totalBillableCharacters": 36
      }
    }
  }
}