


המסמך הזה הוא חלק מסדרה שעוסקת בהתאוששות מאסון (DR) ב- Google Cloud. בחלק הזה נסקור תרחישים נפוצים של התאוששות מאסון (DR) באפליקציות.
הסדרה מורכבת מהחלקים הבאים:
- מדריך להכנת תוכנית התאוששות מאסון (DR)
- אבני בניין של תוכנית התאוששות מאסון (DR)
- תרחישים של התאוששות מאסון (DR) עבור נתונים
- תרחישי התאוששות מאסון (DR) לאפליקציות (המסמך הזה)
- תכנון תוכנית התאוששות מאסון (DR) לעומסי עבודה שמוגבלים למיקום
- תרחישי שימוש להתאוששות מאסון: אפליקציות לניתוח נתונים עם הגבלות על מיקום
- תכנון תוכנית התאוששות מאסון (DR) להפסקות זמניות בתשתית הענן
מבוא
במסמך הזה מוצגים תרחישי DR לאפליקציות במונחים של דפוסי DR שמציינים עד כמה האפליקציה יכולה להתאושש מאירוע אסון. המאמר מתבסס על המושגים שמוסברים במסמך אבני הבניין של DR, ומתאר איך אפשר ליישם תוכנית DR מקצה לקצה שמתאימה ליעדי השחזור שלכם.
כדי להתחיל, כדאי לעיין בכמה עומסי עבודה אופייניים כדי להבין איך חשיבה על יעדי השחזור והארכיטקטורה משפיעה באופן ישיר על תוכנית ה-DR.
עומסי עבודה של עיבוד באצווה
עומסי עבודה של עיבוד באצווה בדרך כלל לא קריטיים, ולכן בדרך כלל לא צריך לשלם על תכנון ארכיטקטורה של זמינות גבוהה (HA) כדי למקסם את זמן הפעולה. באופן כללי, עומסי עבודה של עיבוד באצווה יכולים להתמודד עם הפרעות. עומס עבודה מהסוג הזה יכול להפיק תועלת ממוצרים חסכוניים כמו מכונות Spot VM ומכונות VM זמניות. מכונות VM זמניות הן מכונות שאפשר ליצור ולהפעיל במחיר נמוך בהרבה ממכונות רגילות. (עם זאת, יכול להיות ש-Compute Engine יפסיק או ימחק את המכונות האלה באופן יזום אם הוא יזדקק לגישה למשאבים האלה לצורך משימות אחרות.
אם מטמיעים נקודות ביקורת רגילות כחלק ממשימת העיבוד, אפשר להפעיל מחדש את משימת העיבוד מהנקודה שבה היא נכשלה כשמפעילים מכונות וירטואליות חדשות. אם אתם משתמשים ב-Managed Service for Apache Spark, התהליך של הפעלת צמתים זמניים של עובדים מנוהל על ידי קבוצת מופעי מכונה מנוהלים. אפשר לראות את זה כדפוס חם, שבו יש השהיה קצרה בהמתנה למכונות וירטואליות חלופיות כדי להמשיך את העיבוד.
אתרים למסחר אלקטרוני
באתרי מסחר אלקטרוני, לחלקים מסוימים באפליקציה יכולים להיות ערכי RTO גבוהים יותר. לדוגמה, צינור הרכישה בפועל צריך להיות זמין מאוד, אבל תהליך שליחת האימיילים עם התראות על הזמנות ללקוחות יכול לסבול עיכוב של כמה שעות. הלקוחות יודעים על הרכישה שלהם, ולכן למרות שהם מצפים לקבל אימייל אישור, ההתראה היא לא חלק חיוני בתהליך. זהו שילוב של דפוסים חמים (רכישה), חמימים וקרים (התראה).
החלק הטרנזקציוני של האפליקציה צריך להיות זמין לפרקי זמן ארוכים עם ערך RTO מינימלי. לכן, אתם משתמשים ב-HA, שממקסם את הזמינות של החלק הזה באפליקציה. הגישה הזו נחשבת לדפוס פעולה פופולרי.
תרחיש המסחר האלקטרוני ממחיש איך יכולים להיות ערכים שונים של RTO באותה אפליקציה.
וידאו בסטרימינג
לפתרון סטרימינג של סרטונים יש הרבה רכיבים שצריכים להיות זמינים מאוד, החל מחוויית החיפוש ועד לתהליך בפועל של סטרימינג תוכן למשתמש. בנוסף, המערכת דורשת זמן אחזור נמוך כדי ליצור חוויית משתמש מספקת. אם היבט כלשהו בפתרון לא מספק חוויה מעולה, זה רע לספק וללקוח. בנוסף, הלקוחות יכולים היום לפנות למוצר מתחרה.
במקרה כזה, ארכיטקטורה של זמינות גבוהה היא חובה, וצריך להגדיר ערכי RTO קטנים. במקרה כזה, צריך להשתמש בתבנית חמה בכל ארכיטקטורת האפליקציה כדי למזער את ההשפעה במקרה של אסון.
ארכיטקטורות של DR ו-HA לייצור מקומי
בקטע הזה נסביר איך להטמיע שלושה דפוסים – cold, warm ו-hot – כשהאפליקציה שלכם פועלת בפריסה מקומית ופתרון ה-DR שלכם נמצא ב-Google Cloud.
דפוס קר: החלמה עד Google Cloud
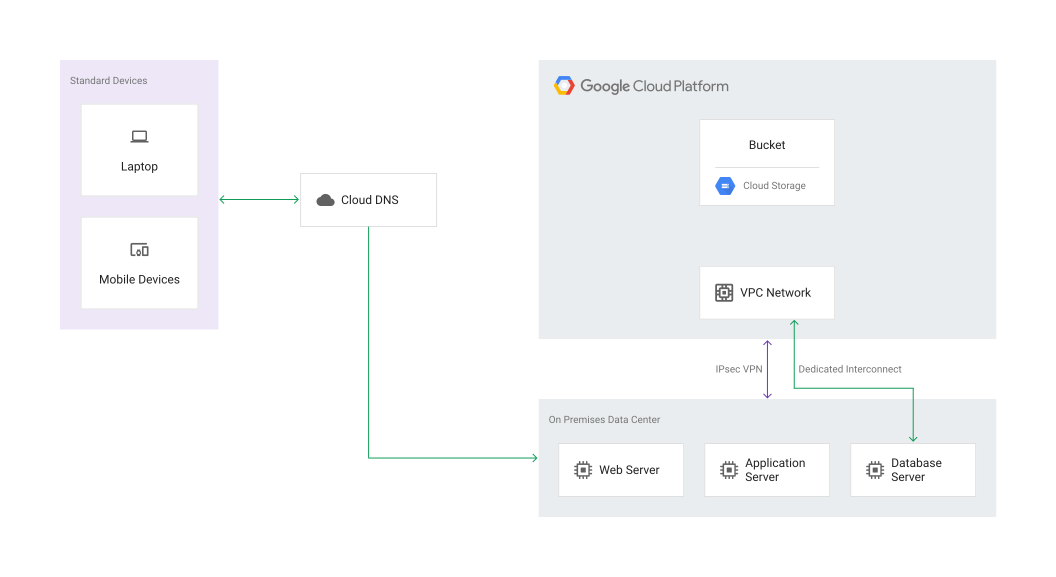
בתבנית קרה, יש לכם מינימום משאבים בפרויקט DR Google Cloud– רק מספיק כדי לאפשר תרחיש שחזור. אם יש בעיה שמונעת מסביבת הייצור להריץ עומסי עבודה של ייצור, אסטרטגיית המעבר לגיבוי מחייבת הפעלה של שיקוף של סביבת הייצור ב- Google Cloud. הלקוחות מתחילים להשתמש בשירותים מסביבת ה-DR.
בקטע הזה נבחן דוגמה לדפוס הזה. בדוגמה, Cloud Interconnect מוגדר עם פתרון VPN בניהול עצמי (לאGoogle Cloud) כדי לספק קישוריות ל- Google Cloud. הנתונים מועתקים ל-Cloud Storage כחלק מסביבת הייצור.
התבנית הזו משתמשת באבני הבניין הבאות של DR:
- Cloud DNS
- Cloud Interconnect
- פתרון VPN בניהול עצמי
- Cloud Storage
- Compute Engine
- Cloud Load Balancing
- Deployment Manager
התרשים הבא מדגים את הארכיטקטורה הזו:
בשלבים הבאים מוסבר איך להגדיר את הסביבה:
- יצירת רשת VPC.
- הגדרת קישוריות בין הרשת המקומית שלכם לבין רשת Google Cloud .
- יוצרים קטגוריה של Cloud Storage כיעד לגיבוי הנתונים.
- יוצרים חשבון שירות.
- יוצרים מדיניות IAM כדי להגביל את הגישה לקטגוריה ולאובייקטים שבה. אתם כוללים את חשבון השירות שנוצר במיוחד למטרה הזו. בנוסף, מוסיפים את חשבון המשתמש או הקבוצה למדיניות של האופרטור או של אדמין המערכת, וכך מעניקים לכל הזהויות האלה את ההרשאות הרלוונטיות. פרטים על הרשאות גישה ל-Cloud Storage מופיעים במאמר הרשאות IAM ל-Cloud Storage.
- משתמשים בהתחזות לחשבון שירות כדי לספק גישה למשתמש המקומי Google Cloud(או לחשבון השירות) להתחזות לחשבון השירות שיצרתם קודם. אפשרות אחרת היא ליצור משתמש חדש במיוחד למטרה הזו.
- בודקים שאפשר להעלות ולהוריד קבצים בדלי היעד.
- יוצרים סקריפט להעברת נתונים.
- יוצרים משימה מתוזמנת להרצת הסקריפט. אפשר להשתמש בכלים כמו Linux
crontabותזמון המשימות של Windows. יוצרים תמונות בהתאמה אישית שמוגדרות לכל שרת בסביבת הייצור. כל תמונה צריכה להיות באותה הגדרה כמו המקבילה שלה בפריסה המקומית.
כחלק מההגדרה של קובץ האימג' בהתאמה אישית לשרת מסד הנתונים, צריך ליצור סקריפט לטעינה בזמן ההפעלה שיעתיק באופן אוטומטי את הגיבוי האחרון מקטגוריה של Cloud Storage למופע, ואז יפעיל את תהליך השחזור.
הגדרת Cloud DNS כך שיפנה לשירותי האינטרנט שפונים לאינטרנט.
יוצרים תבנית Deployment Manager שתייצר שרתי אפליקציות ברשת Google Cloud באמצעות התמונות בהתאמה אישית שהוגדרו קודם. התבנית הזו צריכה גם להגדיר את כללי חומת האש המתאימים שנדרשים.
צריך להטמיע תהליכים כדי לוודא שלתמונות המותאמות אישית יש את אותה גרסה של האפליקציה כמו בשרת המקומי. חשוב לוודא שאתם משלבים שדרוגים בתמונות המותאמות אישית כחלק ממחזור השדרוג הרגיל, ולוודא שתבנית Deployment Manager משתמשת בתמונה המותאמת אישית העדכנית ביותר.
תהליך המעבר לגיבוי ומשימות אחרי ההפעלה מחדש
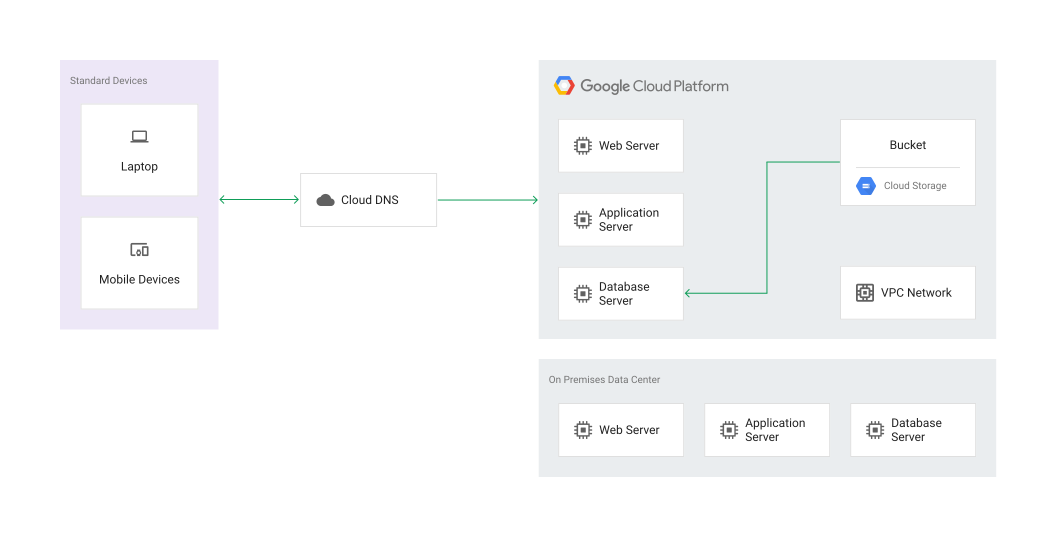
אם מתרחש אסון, אפשר לשחזר את המערכת שפועלת ב-Google Cloud. כדי לעשות זאת, מפעילים את תהליך השחזור כדי ליצור את סביבת השחזור באמצעות תבנית Deployment Manager שיוצרים. כשהמופעים בסביבת השחזור מוכנים לקבל תנועה של נתוני ייצור, משנים את ה-DNS כך שיצביע על שרת האינטרנט ב-Google Cloud.
רצף שחזור טיפוסי הוא כזה:
- משתמשים בתבנית Deployment Manager כדי ליצור פריסה ב-Google Cloud.
- מחילים את הגיבוי האחרון של מסד הנתונים ב-Cloud Storage על שרת מסד הנתונים שפועל ב- Google Cloud , בהתאם להוראות של מערכת מסד הנתונים לשחזור קובצי גיבוי.
- מחילים את יומני העסקאות האחרונים ב-Cloud Storage.
- בודקים שהאפליקציה פועלת כמו שצריך על ידי סימולציה של תרחישי שימוש בסביבה המשוחזרת.
- אם הבדיקות מצליחות, מגדירים את Cloud DNS כך שיפנה לשרת האינטרנט ב- Google Cloud. (לדוגמה, אפשר להשתמש בכתובת IP מסוג Anycast מאחורי מאזן עומסים של Google Cloud , עם כמה שרתי אינטרנט מאחורי מאזן העומסים).
התרשים הבא מציג את הסביבה המשוחזרת:
כאשר סביבת הייצור פועלת שוב במקום, והסביבה יכולה לתמוך בעומסי עבודה של ייצור, מבצעים את הפעולות בסדר הפוך לזה שבוצע כדי לבצע מעבר לגיבוי בעת כשל לסביבת השחזור Google Cloud . רצף אופייני לחזרה לסביבת הייצור:
- מבצעים גיבוי של מסד הנתונים שפועל ב- Google Cloud.
- מעתיקים את קובץ הגיבוי לסביבת הייצור.
- מחילים את קובץ הגיבוי על מערכת מסד הנתונים של הסביבה הפעילה.
- מניעת חיבורים לאפליקציה ב- Google Cloud. לדוגמה, אפשר למנוע חיבורים למאזן העומסים הגלובלי. מנקודה זו, האפליקציה לא תהיה זמינה עד שתסיימו לשחזר את סביבת הייצור.
- מעתיקים את כל קובצי יומן הטרנזקציות לסביבת הייצור ומחילים אותם על שרת מסד הנתונים.
- הגדרת Cloud DNS כך שיפנה לשירות האינטרנט המקומי.
- מוודאים שהתהליך שהגדרתם להעתקת נתונים ל-Cloud Storage פועל כצפוי.
- מחיקת הפריסה
המתנה חמה: שחזור אל Google Cloud
בדרך כלל, דפוס חם מיושם כדי לשמור על ערכי RTO ו-RPO קטנים ככל האפשר, בלי המאמץ וההוצאות של הגדרת זמינות גבוהה מלאה. ככל שערכי ה-RTO וה-RPO קטנים יותר, העלויות גבוהות יותר, כי מתקרבים למצב של סביבה עודפת לחלוטין שיכולה לשרת תנועה משתי סביבות. לכן, הטמעה של תבנית חמה לתרחיש DR היא פשרה טובה בין תקציב לזמינות.
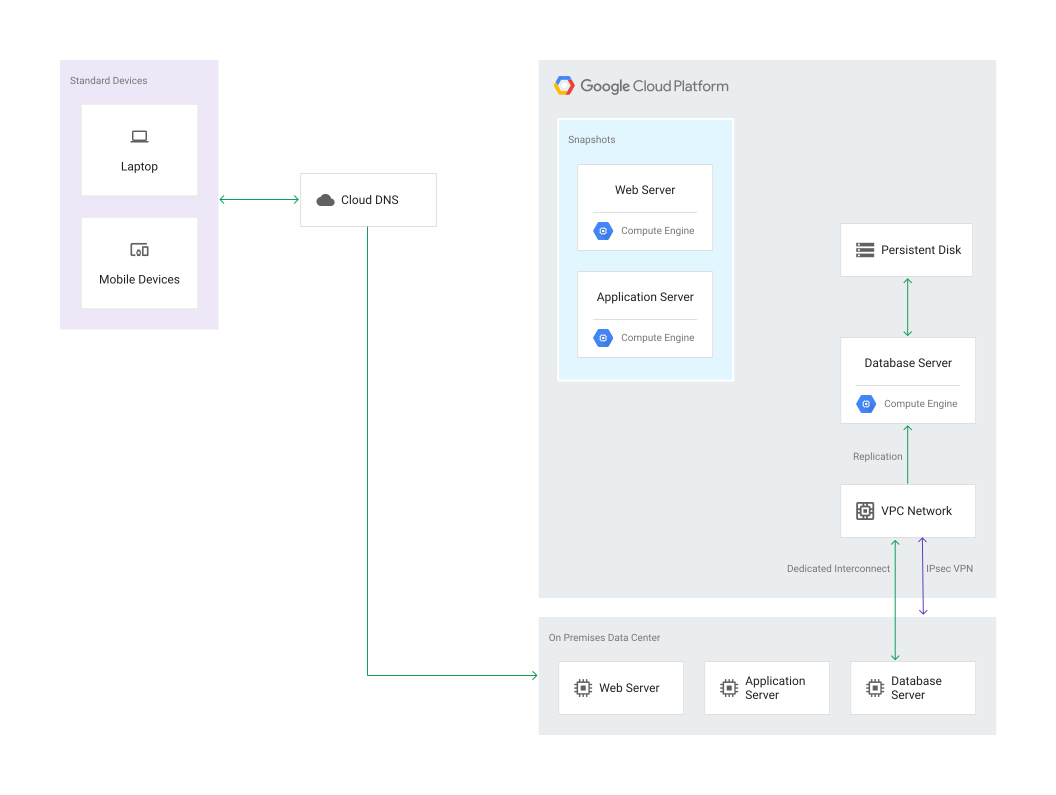
דוגמה לגישה כזו היא שימוש ב-Cloud Interconnect שהוגדר עם פתרון VPN בניהול עצמי כדי לספק קישוריות ל- Google Cloud. אפליקציה רב-שכבתית פועלת במקום, תוך שימוש בחבילת שחזור מינימלית ב- Google Cloud. חבילת השחזור מורכבת ממופע של שרת מסד נתונים תפעולי ב- Google Cloud. המופע הזה צריך לפעול כל הזמן כדי שיוכל לקבל עסקאות משוכפלות באמצעות טכניקות שכפול אסינכרוניות או חצי-סינכרוניות. כדי להפחית את העלויות, אפשר להריץ את מסד הנתונים על סוג המכונה הקטן ביותר שיכול להריץ את שירות מסד הנתונים. מכיוון שאפשר להשתמש במופע שפועל לזמן רב, יחולו הנחות על שימוש קבוע.
התבנית הזו משתמשת באבני הבניין הבאות של DR:
- Cloud DNS
- Cloud Interconnect
- פתרון VPN בניהול עצמי
- Compute Engine
- Deployment Manager
תמונות מצב ב-Compute Engine מאפשרות ליצור גיבויים שאפשר לחזור אליהם למצב קודם. בדוגמה הזו נעשה שימוש בתמונות מצב כי דפי אינטרנט מעודכנים וקבצים בינאריים של אפליקציות נכתבים לעיתים קרובות באינטרנט של הייצור ובשרתי האפליקציות. העדכונים האלה משוכפלים באופן קבוע למופעים של שרת האינטרנט ושרת האפליקציות להפניה ב- Google Cloud. (שרתי ההפניה לא מקבלים תנועה של ייצור, הם משמשים ליצירת ה-snapshots).
התרשים הבא מדגים ארכיטקטורה שמיישמת את הגישה הזו. יעדי השכפול לא מוצגים בתרשים.
בשלבים הבאים מוסבר איך להגדיר את הסביבה:
- יצירת רשת VPC.
- הגדרת קישוריות בין הרשת המקומית שלכם לבין רשת Google Cloud .
- משכפלים את השרתים המקומיים ל Google Cloud מכונות וירטואליות. אפשרות אחת היא להשתמש בפתרון של שותף. השיטה שבה תשתמשו תלויה בנסיבות שלכם.
- יוצרים קובץ אימג' בהתאמה אישית של שרת מסד הנתונים ב- Google Cloud עם אותה הגדרה כמו של שרת מסד הנתונים המקומי.
- יצירת תמונות מצב של המכונות של שרת האינטרנט ושרת האפליקציות.
- מפעילים מופע של מסד נתונים ב- Google Cloud באמצעות קובץ האימג' המותאם אישית שיצרתם קודם. משתמשים בסוג המכונה הקטן ביותר שיכול לקבל נתונים משוכפלים ממסד הנתונים של הייצור המקומי.
- מחברים דיסקים קבועים למכונת מסד הנתונים Google Cloud עבור מסדי הנתונים ויומני העסקאות.
- מגדירים שכפול בין שרת מסד הנתונים המקומי לבין שרת מסד הנתונים ב- Google Cloud , בהתאם להוראות של תוכנת מסד הנתונים.
- מגדירים את הדגל auto delete בדיסקים המתמידים שמחוברים למופע של מסד הנתונים לערך
no-auto-delete. - מגדירים משימה מתוזמנת ליצירת תמונות מצב רגילות של דיסקים מתמידים של מופע מסד הנתונים ב- Google Cloud.
- יוצרים הזמנות כדי להבטיח את הקיבולת של שרתי האינטרנט ושרתי האפליקציות לפי הצורך.
- בודקים את התהליך של יצירת מופעים מקובצי snapshot ושל יצירת קובצי snapshot של דיסקים של אחסון מתמיד.
- יוצרים מופעים של שרת האינטרנט ושל שרת האפליקציות באמצעות קובצי ה-snapshot שנוצרו קודם.
- יוצרים סקריפט שמעתיק עדכונים לאפליקציית האינטרנט ולשרת האפליקציות בכל פעם שהשרתים המקומיים המתאימים מתעדכנים. כותבים את הסקריפט ליצירת snapshot של השרתים המעודכנים.
- הגדרת Cloud DNS כך שיפנה לשירות האינטרנט שפונה לאינטרנט בפריסה המקומית.
תהליך המעבר לגיבוי ומשימות אחרי ההפעלה מחדש
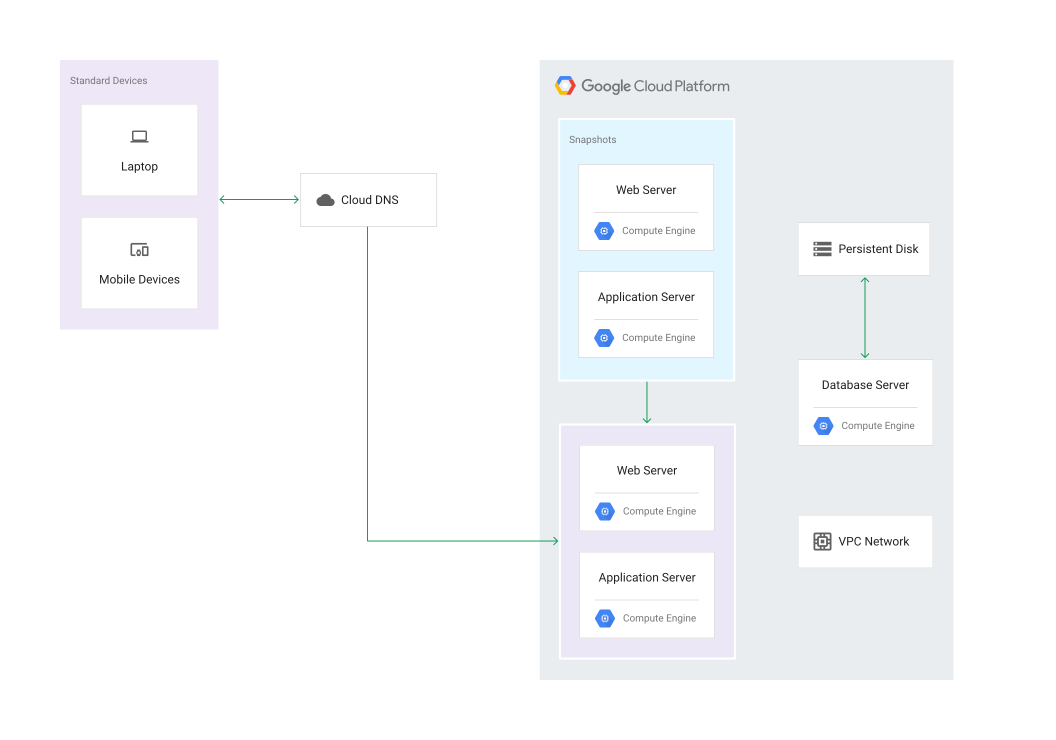
כדי לנהל מעבר לגיבוי, בדרך כלל משתמשים במערכת המעקב וההתראות כדי להפעיל תהליך אוטומטי של מעבר לגיבוי. כשהאפליקציה המקומית צריכה לבצע מעבר לגיבוי, צריך להגדיר את מערכת מסד הנתונים ב- Google Cloud כך שהיא תוכל לקבל תעבורת נתונים של ייצור. אתם גם מפעילים מופעים של שרת האינטרנט ושרת האפליקציות.
התרשים הבא מציג את ההגדרה אחרי מעבר לגיבוי (failover) אלGoogle Cloud , שמאפשר להפעיל עומסי עבודה של סביבת ייצור מ-Google Cloud:
רצף שחזור טיפוסי הוא כזה:
- משנים את הגודל של מופע שרת מסד הנתונים כדי שיוכל להתמודד עם עומסי ייצור.
- אפשר להשתמש ב-snapshots של שרת האינטרנט והאפליקציה ב- Google Cloud כדי ליצור מופעים חדשים של שרת האינטרנט והאפליקציה.
- בודקים שהאפליקציה פועלת כמו שצריך על ידי סימולציה של תרחישי שימוש בסביבה המשוחזרת.
- אם הבדיקות מצליחות, צריך להגדיר את Cloud DNS כך שיפנה לשירות האינטרנט ב- Google Cloud.
כאשר סביבת הייצור פועלת שוב באופן מקומי ויכולה לתמוך בעומסי עבודה של ייצור, מבצעים את הפעולות שביצעתם כדי לבצע מעבר לגיבוי במקרה של כשל אל Google Cloud סביבת השחזור. רצף טיפוסי לחזרה לסביבת הייצור:
- מבצעים גיבוי של מסד הנתונים שפועל ב- Google Cloud.
- מעתיקים את קובץ הגיבוי לסביבת הייצור.
- מחילים את קובץ הגיבוי על מערכת מסד הנתונים של הסביבה הפעילה.
- מניעת חיבורים לאפליקציה ב- Google Cloud. אחת הדרכים לעשות זאת היא למנוע חיבורים לשרת האינטרנט על ידי שינוי כללי חומת האש. החל משלב זה, האפליקציה לא תהיה זמינה עד שתסיימו לשחזר את סביבת הייצור.
- מעתיקים את כל קובצי יומן הטרנזקציות לסביבת הייצור ומחילים אותם על שרת מסד הנתונים.
- בודקים שהאפליקציה פועלת כמו שצריך על ידי סימולציה של תרחישי שימוש בסביבת הייצור.
- הגדרת Cloud DNS כך שיפנה לשירות האינטרנט המקומי.
- מוחקים את המופעים של שרת האינטרנט ושרת האפליקציות שפועלים ב-Google Cloud. משאירים את שרתי ההפניה פועלים.
- משנים את הגודל של שרת מסד הנתונים ב- Google Cloud בחזרה לגודל המינימלי של המופע שיכול לקבל נתונים משוכפלים ממסד הנתונים המקומי של הייצור.
- מגדירים שכפול בין שרת מסד הנתונים המקומי לבין שרת מסד הנתונים ב- Google Cloud , בהתאם להוראות של תוכנת מסד הנתונים.
זמינות גבוהה (HA) פעילה בפריסה מקומית וב- Google Cloud
אם יש לכם ערכי RTO ו-RPO קטנים, תוכלו להשיג אותם רק אם תפעילו זמינות גבוהה בסביבת הייצור שלכם ו Google Cloud במקביל. הגישה הזו יוצרת תבנית פעילה, כי גם המערכות המקומיות וגם Google Cloud משרתות תנועה של נתוני ייצור.
ההבדל העיקרי מהתבנית החמה הוא שהמשאבים בשתי הסביבות פועלים במצב ייצור ומשרתים תנועה של ייצור.
התבנית הזו משתמשת באבני הבניין הבאות של DR:
- Cloud Interconnect
- Cloud VPN
- Compute Engine
- קבוצות של מופעי מכונה מנוהלים
- Cloud Monitoring
- Cloud Load Balancing
התרשים הבא ממחיש את הארכיטקטורה הזו לדוגמה. הטמעה של הארכיטקטורה הזו מאפשרת ליצור תוכנית DR שלא דורשת התערבות מינימלית במקרה של אסון.
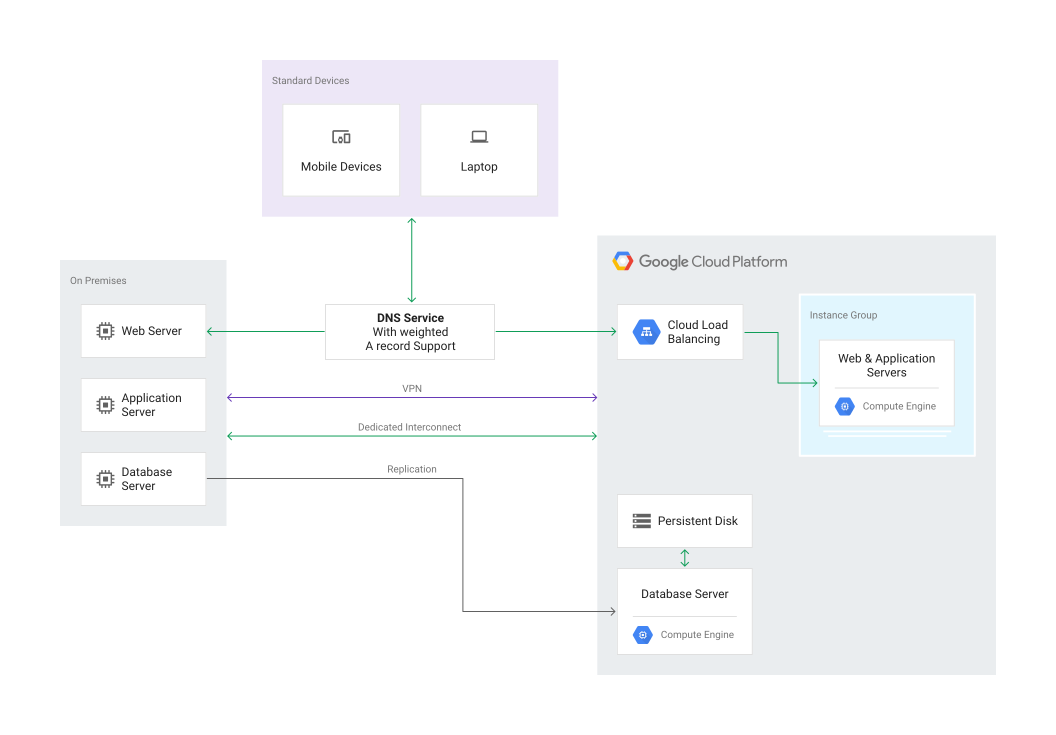
בשלבים הבאים מוסבר איך להגדיר את הסביבה:
- יצירת רשת VPC.
- הגדרת קישוריות בין הרשת המקומית לרשת Google Cloud .
- יוצרים תמונות בהתאמה אישית ב- Google Cloud שמוגדרות לכל שרת בסביבת הייצור המקומית. לכל Google Cloud תמונה צריכה להיות אותה הגדרה כמו לתמונה המקבילה שלה בשרת המקומי.
מגדירים שכפול בין שרת מסד הנתונים המקומי לבין שרת מסד הנתונים ב- Google Cloud , בהתאם להוראות של תוכנת מסד הנתונים.
במערכות רבות של מסדי נתונים, אפשר להגדיר שכפול רק אם יש מופע אחד של מסד נתונים שאפשר לכתוב בו. לכן, יכול להיות שתצטרכו לוודא שאחת מההעתקים של מסד הנתונים פועלת כשרת לקריאה בלבד.
יוצרים תבניות של מופעים שמשתמשות בתמונות של שרתי האפליקציות ושרתי האינטרנט.
הגדרת קבוצות אזוריות של מכונות וירטואליות מנוהלות עבור שרתי האפליקציות ושרתי האינטרנט.
הגדרת בדיקות תקינות באמצעות Cloud Monitoring.
מגדירים איזון עומסים באמצעות קבוצות מנוהלות של מכונות וירטואליות אזוריות שהוגדרו קודם.
מגדירים משימה מתוזמנת ליצירת תמונות מצב רגילות של הדיסקים המתמידים.
מגדירים שירות DNS כדי לחלק את התנועה בין הסביבה המקומית לבין סביבת Google Cloud .
בגישה ההיברידית הזו, צריך להשתמש בשירות DNS שתומך בהפניה מבוססת משקל לשתי סביבות הייצור, כדי שתוכלו להציג את אותה אפליקציה משתי הסביבות.
צריך לתכנן את המערכת כך שתהיה עמידה לכשלים שעלולים להתרחש רק בחלק מהסביבה (כשלים חלקיים). במקרה כזה, התנועה תנותב מחדש לשירות המקביל בסביבת הגיבוי השנייה. לדוגמה, אם שרתי האינטרנט המקומיים לא זמינים, אפשר להשבית את ניתוב ה-DNS לאותו סביבה. אם שירות ה-DNS שלכם תומך בבדיקות תקינות, הבדיקה תתבצע באופן אוטומטי כשהבדיקה תזהה שלא ניתן להגיע לשרתי אינטרנט באחת מהסביבות.
אם אתם משתמשים במערכת מסדי נתונים שמאפשרת רק מופע אחד שניתן לכתיבה, במקרים רבים מערכת מסד הנתונים תקדם אוטומטית את העותק לקריאה בלבד כעותק ראשי שניתן לכתיבה, כשהקשר בין מסד הנתונים המקורי שניתן לכתיבה לבין העותק לקריאה בלבד יאבד. חשוב להבין את ההיבט הזה של שכפול מסד הנתונים למקרה שתצטרכו להתערב אחרי אסון.
צריך להטמיע תהליכים כדי לוודא שבתמונות המכונות הווירטואליות בהתאמה אישית ב-Google Cloud מותקנת אותה גרסה של האפליקציה כמו בגרסאות המקומיות. כדאי לשלב שדרוגים של התמונות המותאמות אישית כחלק ממחזור השדרוג הרגיל, ולוודא שתבנית Deployment Manager משתמשת בתמונה המותאמת אישית העדכנית ביותר.
תהליך המעבר לגיבוי ומשימות אחרי ההפעלה מחדש
במקרה של תרחיש חם, כפי שמתואר כאן, אסון פירושו שאחת משתי הסביבות לא זמינה. אין תהליך מעבר לגיבוי (failover) כמו בתרחישים של חם או קר, שבהם צריך להעביר נתונים או עיבוד לסביבה השנייה. עם זאת, יכול להיות שתצטרכו לטפל בשינויים הבאים בהגדרות:
- אם שירות ה-DNS שלכם לא מפנה מחדש את התנועה באופן אוטומטי על סמך כשל בבדיקת תקינות, תצטרכו להגדיר ידנית את ניתוב ה-DNS כדי לשלוח את התנועה למערכת שעדיין פועלת.
- אם מערכת מסד הנתונים שלכם לא מקדמת אוטומטית רפליקה לקריאה בלבד להיות העותק הראשי שניתן לכתיבה במקרה של כשל, אתם צריכים להתערב כדי לוודא שהרפליקה מקודמת.
כשהסביבה השנייה פועלת שוב ויכולה לטפל בתנועה של נתוני ייצור, צריך לסנכרן מחדש את מסדי הנתונים. שתי הסביבות תומכות בעומסי עבודה של ייצור, ולכן לא צריך לבצע פעולות נוספות כדי לשנות את מסד הנתונים הראשי. אחרי שהמסדי נתונים מסונכרנים, אפשר לשנות את הגדרות ה-DNS כדי לאפשר שוב את חלוקת תנועת הגולשים בסביבת הייצור בין שתי הסביבות.
ארכיטקטורות של DR ו-HA לייצור ב- Google Cloud
כשמתכננים את ארכיטקטורת האפליקציה עבור עומס עבודה של ייצור ב-Google Cloud, תכונות הזמינות הגבוהה של הפלטפורמה משפיעות ישירות על ארכיטקטורת ההתאוששות מאסון.
שירות Backup and DR הוא פתרון מרוכז שפותח במיוחד לשימוש בענן, לגיבוי ולשחזור של עומסי עבודה בענן ובענן היברידי. הוא מאפשר שחזור מהיר של נתונים ומסייע לחידוש מהיר של פעולות עסקיות חיוניות.
למידע נוסף על שימוש בשירות Backup and DR לתרחישי שימוש באפליקציות ב-Google Cloud, אפשר לעיין במאמרים הבאים:
במאמר Backup and DR Service for Compute Engine מוסבר על המושגים והפרטים של השימוש ב- Google Cloud שירות Backup and DR לגיבוי מצטבר של נתונים מ-Persistent Disks ברמת המכונה.
במאמר Backup and DR Service for Google Cloud VMware Engine מוסברים המושגים והפרטים של השימוש ב- Google Cloud שירות Backup and DR כדי לגבות נתונים באופן מצטבר מקובצי VMDK ברמת המכונה הווירטואלית.
במאמר Backup and DR Service for Filestore and file systems מוסברים המושגים והפרטים של השימוש ב- Google Cloud שירות Backup and DR לצורך צילום וגיבוי של נתונים ממערכות קבצים של SMB, NFS ו-Filestore בייצור.
מצב לא פעיל: שרת אפליקציות שניתן לשחזר
בתרחיש של מעבר לגיבוי במצב לא פעיל שבו נדרש מופע שרת פעיל יחיד, רק מופע אחד צריך לכתוב לדיסק. בסביבה מקומית, לרוב משתמשים באשכול פעיל / סביל. כשמריצים סביבת ייצור ב-Google Cloud, אפשר ליצור מכונה וירטואלית בקבוצת מופעי מכונה מנוהלים שמריצה רק מופע אחד.
התבנית הזו משתמשת באבני הבניין הבאות של DR:
- Compute Engine
- קבוצות של מופעי מכונה מנוהלים
תרחיש הגיבוי הקר הזה מוצג בתמונה הבאה של ארכיטקטורת הדוגמה:
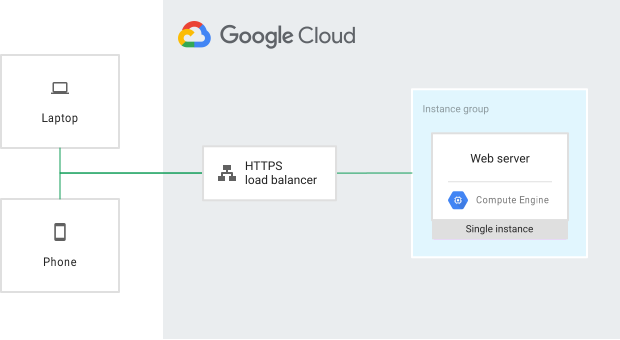
בשלבים הבאים מוסבר איך להגדיר את תרחיש המעבר לגיבוי חם הזה:
- יצירת רשת VPC.
- יצירת אימג' של מכונה וירטואלית בהתאמה אישית שמוגדר עם שירות האינטרנט של האפליקציה.
- מגדירים את המכונה הווירטואלית כך שהנתונים שעובדו על ידי שירות האפליקציה ייכתבו לדיסק קבוע שמצורף אליה.
- יוצרים קובץ snapshot מדיסק האחסון המתמיד המצורף.
- יוצרים תבנית של הגדרות מכונה שמפנה לקובץ האימג' של המכונה הווירטואלית בהתאמה אישית עבור שרת האינטרנט.
- מגדירים סקריפט לטעינה בזמן ההפעלה כדי ליצור דיסק אחסון מתמיד (persistent disk) מקובץ ה-snapshot האחרון ולהטמיע את הדיסק. הסקריפט צריך להיות מסוגל לקבל את תמונת המצב העדכנית ביותר של הדיסק.
- יצירת קבוצה של מופעי מכונה מנוהלים ובדיקות תקינות עם גודל יעד של אחד שמפנה לתבנית המכונה.
- יוצרים משימה מתוזמנת ליצירת קובצי snapshot רגילים של דיסק האחסון המתמיד.
- מגדירים מאזן עומסים חיצוני של אפליקציות.
- מגדירים התראות באמצעות Cloud Monitoring כדי לקבל התראה כשהשירות נכשל.
תרחיש המעבר לגיבוי חם הזה מסתמך על חלק מתכונות הזמינות הגבוהה שזמינות ב- Google Cloud. אם מכונה וירטואלית נכשלת, קבוצת מופעי מכונה מנוהלים מנסה ליצור מחדש את המכונה הווירטואלית באופן אוטומטי. לא צריך ליזום את שלב המעבר לגיבוי. מאזן העומסים החיצוני של האפליקציה מוודא שגם כשצריך מכונה וירטואלית חלופית, נעשה שימוש באותה כתובת IP מול שרת האפליקציה. תבנית המופע והתמונה בהתאמה אישית מבטיחות שהמכונה הווירטואלית החלופית מוגדרת באופן זהה למופע שהיא מחליפה.
ה-RPO נקבע לפי תמונת המצב האחרונה שצולמה. ככל שתצלמו תמונות מצב בתדירות גבוהה יותר, כך ערך ה-RPO יהיה נמוך יותר.
קבוצת מופעי מכונה מנוהלים מספקת זמינות גבוהה לעומק. קבוצת מופעי מכונה מנוהלים מספקת דרכים להגיב לכשלים ברמת האפליקציה או המכונה הווירטואלית. לא צריך להתערב ידנית אם אחד מהתרחישים האלה מתרחש. גודל יעד של אחד מבטיח שתהיה לכם רק דוגמה פעילה אחת שפועלת בקבוצת המופעים המנוהלת ומשרתת תנועה.
דיסקים לאחסון מתמיד הם אזוריים, ולכן צריך ליצור snapshots כדי ליצור מחדש דיסקים אם יש כשל אזורי. קובצי snapshot זמינים גם באזורים שונים, כך שאפשר לשחזר דיסק לאזור אחר, בדומה לשחזור לאותו אזור.
במקרה לא סביר של כשל אזורי, תצטרכו להתערב ידנית כדי לשחזר את הנתונים, כמו שמתואר בקטע הבא.
תהליך המעבר לגיבוי
אם מכונה וירטואלית נכשלת, קבוצת מופעי מכונה מנוהלים מנסה ליצור מחדש מכונה וירטואלית באותו אזור. סקריפט לטעינה בזמן ההפעלה בתבנית של הגדרות מכונה יוצר דיסק אחסון מתמיד (persistent disk) מה-snapshot האחרון ומצרף אותו למכונה הווירטואלית החדשה.
עם זאת, קבוצת מופעי מכונה מנוהלת בגודל אחד לא משתחזרת אם יש כשל באזור. בתרחיש שבו אזור נכשל, צריך להגיב להתראה של Cloud Monitoring או של פלטפורמת מעקב אחרת, כשהשירות נכשל, וליצור באופן ידני קבוצת מופעים באזור אחר.
אפשרות נוספת היא להשתמש בדיסקים לאחסון מתמיד אזורי במקום בדיסקים לאחסון מתמיד אזוריים. בגישה הזו, לא צריך להשתמש בתמונות מצב כדי לשחזר את הדיסק המתמשך כחלק משלב השחזור. עם זאת, הווריאציה הזו צורכת כמות כפולה של נפח אחסון, ולכן צריך להקצות לכך תקציב.
הגישה שתבחרו תהיה תלויה בתקציב ובערכי ה-RTO וה-RPO.
חם: מעבר אוטומטי לאתר סטטי
אם מכונות של Compute Engine נכשלות, אפשר לצמצם את ההפרעה בשירות באמצעות אתר סטטי שמבוסס על Cloud Storage במצב המתנה. התבנית הזו מתאימה אם אפליקציית האינטרנט שלכם היא בעיקר סטטית.
בתרחיש הזה, האפליקציה הראשית פועלת במכונות וירטואליות של Compute Engine. המופעים האלה מקובצים לקבוצות של מופעים מנוהלים, והקבוצות של המופעים משמשות כשירותי בק-אנד למאזן עומסים מסוג HTTPS. מאזן העומסים של HTTP מפנה את התעבורה הנכנסת למכונות בהתאם להגדרות של מאזן העומסים, להגדרות של כל קבוצת מכונות ולסטטוס התקינות של כל מכונה.
התבנית הזו משתמשת באבני הבניין הבאות של DR:
- Compute Engine
- Cloud Storage
- Cloud Load Balancing
- Cloud DNS
התרשים הבא מדגים את הארכיטקטורה הזו:
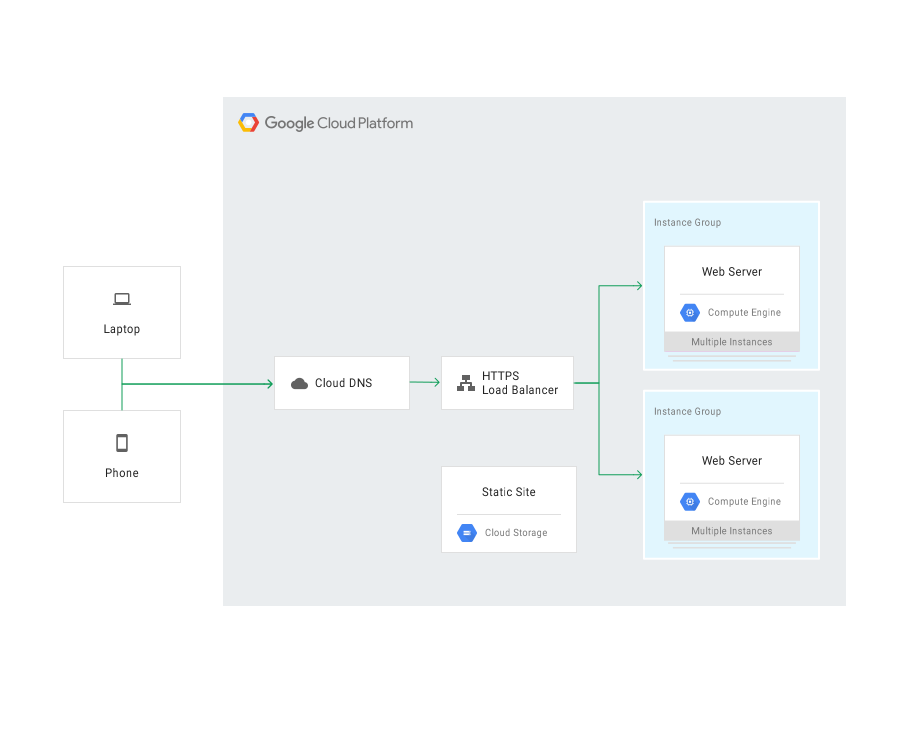
כדי להגדיר את התרחיש הזה, פועלים לפי השלבים הבאים:
- יצירת רשת VPC.
- יוצרים תמונה בהתאמה אישית שמוגדרת עם שירות האינטרנט של האפליקציה.
- יוצרים תבנית של הגדרות מכונה שמשתמשת בתמונה עבור שרתי האינטרנט.
- מגדירים קבוצת מופעי מכונה מנוהלים עבור שרתי האינטרנט.
- הגדרת בדיקות תקינות באמצעות Monitoring.
- מגדירים איזון עומסים באמצעות קבוצות המכונות המנוהלות שהגדרתם קודם.
- יצירת אתר סטטי שמבוסס על Cloud Storage.
בהגדרת הייצור, Cloud DNS מוגדר להפניה לאפליקציה הראשית הזו, והאתר הסטטי במצב המתנה לא פעיל. אם האפליקציה של Compute Engine מושבתת, צריך להגדיר את Cloud DNS כך שיפנה לאתר הסטטי הזה.
תהליך המעבר לגיבוי
אם שרת או שרתי האפליקציות מושבתים, רצף הפעולות לשחזור הוא הגדרת Cloud DNS כך שיפנה לאתר הסטטי שלכם. התרשים הבא מציג את הארכיטקטורה במצב שחזור:
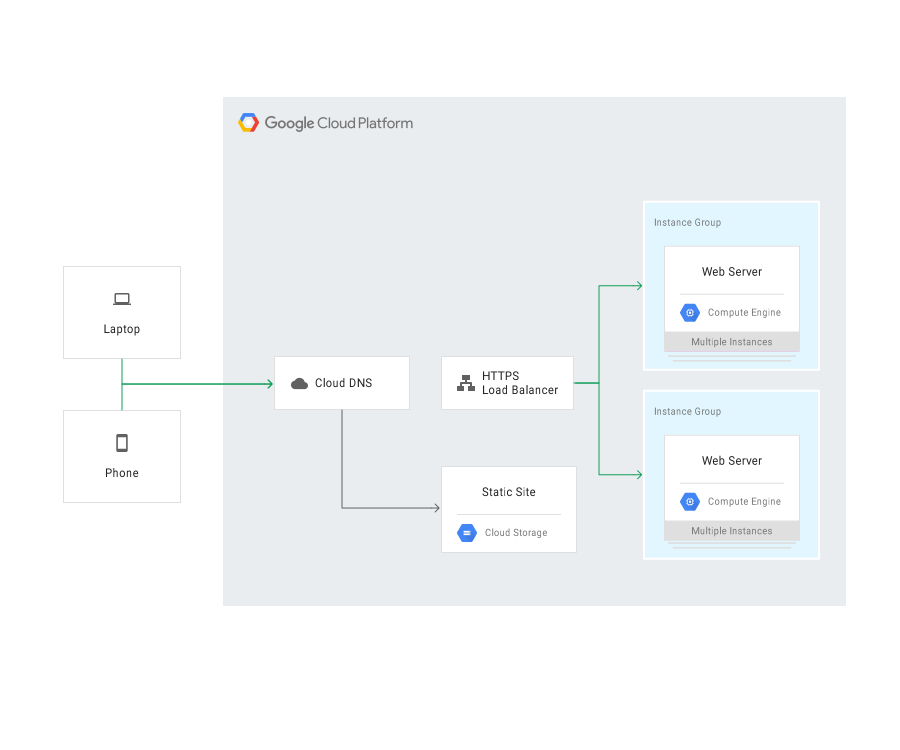
כשאפליקציית המכונות הווירטואליות ב-Compute Engine פועלת שוב ויכולה לתמוך בעומסי עבודה של ייצור, מבטלים את שלב השחזור: מגדירים את Cloud DNS כך שיצביע על מאזן העומסים שמוצב מול המכונות הווירטואליות.
אפשר גם להשתמש בשכפול אסינכרוני של Persistent Disk. האפשרות הזו מאפשרת לבצע רפליקציה של אחסון בלוקים עם יעד התאוששות מאסון (RPO) נמוך ויעד זמן התאוששות (RTO) נמוך עבור DR פעיל-סביל בין אזורים. אפשרות האחסון הזו מאפשרת לכם לנהל רפליקציה של עומסי עבודה ב-Compute Engine ברמת התשתית, ולא ברמת עומס העבודה.
Hot: אפליקציית אינטרנט עם זמינות גבוהה
דפוס חם כשסביבת הייצור שלכם פועלת ב- Google Cloud הוא הקמת פריסת HA עם ארכיטקטורה טובה.
התבנית הזו משתמשת באבני הבניין הבאות של DR:
- Compute Engine
- Cloud Load Balancing
- Cloud SQL
התרשים הבא מדגים את הארכיטקטורה הזו:
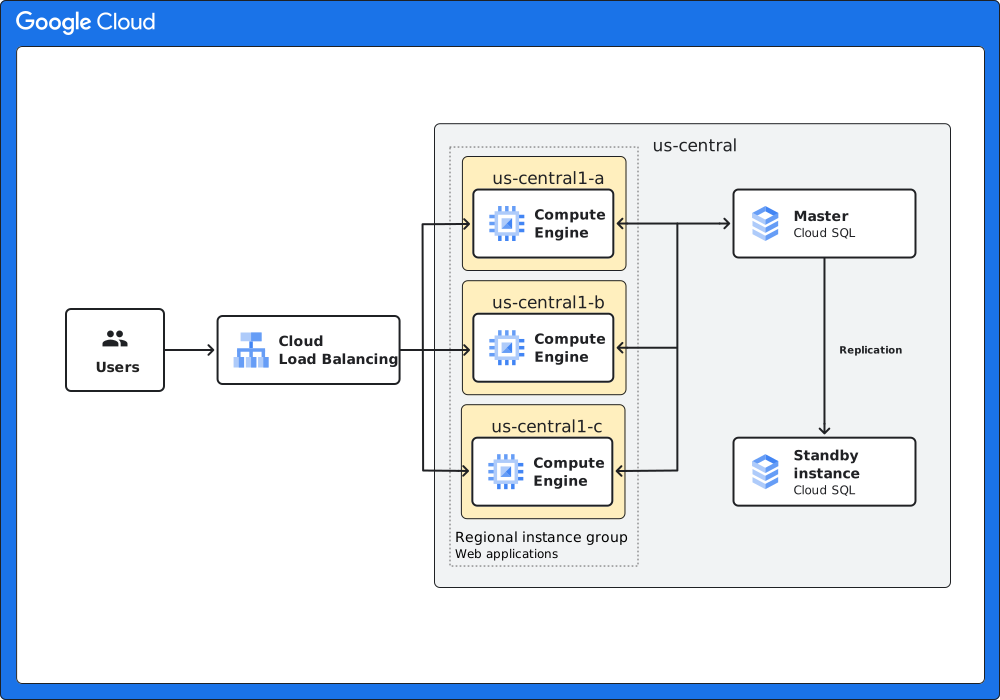
התרחיש הזה מנצל את תכונות הזמינות הגבוהה ב- Google Cloud– לא צריך ליזום שום שלב של יתירות כשל, כי הם יתרחשו אוטומטית במקרה של אסון.
כפי שמוצג בתרשים, הארכיטקטורה משתמשת בקבוצת מופעים מנוהלת אזורית יחד עם איזון עומסים גלובלי ו-Cloud SQL. בדוגמה הזו נעשה שימוש בקבוצה של מופעי מכונה מנוהלים באזור, ולכן המופעים מפוזרים על פני שלושה אזורים.
הגישה הזו מאפשרת לכם לקבל זמינות גבוהה לעומק. קבוצות של מופעי מכונה בניהול אזורי מספקות מנגנונים לתגובה לכשלים ברמת האפליקציה, המופע או האזור, ולא צריך להתערב ידנית אם אחד מהתרחישים האלה מתרחש.
כדי לטפל בשחזור ברמת האפליקציה, במסגרת ההגדרה של קבוצת המופעים המנוהלת, מגדירים בדיקות תקינות של HTTP שמאמתות שהשירותים פועלים בצורה תקינה במופעים בקבוצה הזו. אם בדיקת תקינות קובעת ששירות נכשל במופע, הקבוצה יוצרת מחדש את המופע באופן אוטומטי.
מידע נוסף על פיתוח אפליקציות עמידות שניתנות להרחבה ב-Google Cloudזמין במאמר תבניות לאפליקציות עמידות שניתנות להרחבה .
המאמרים הבאים
- Google Cloud מידע נוסף על מיקום גיאוגרפי ואזורים
מאמרים נוספים בסדרה בנושא DR:
- מדריך להכנת תוכנית התאוששות מאסון (DR)
- אבני בניין של תוכנית התאוששות מאסון (DR)
- תרחישים של התאוששות מאסון (DR) עבור נתונים
- תכנון תוכנית התאוששות מאסון (DR) לעומסי עבודה שמוגבלים למיקום
- תרחישי שימוש להתאוששות מאסון: אפליקציות לניתוח נתונים עם הגבלות על מיקום
- תכנון תוכנית התאוששות מאסון (DR) להפסקות זמניות בתשתית הענן
כדאי להעמיק את הקריאה ולהכיר דוגמאות לארכיטקטורות, תרשימים ושיטות מומלצות בנושאי Google Cloud. כל אלה זמינים במרכז הארכיטקטורה של Cloud.