


L'apprentissage par renforcement est une technique puissante permettant d'adapter les grands modèles de langage (LLM) afin de maximiser les récompenses de feedback fournies par une fonction de récompense définie par l'utilisateur. Le modèle explore de nombreuses réponses possibles, observe une récompense numérique pour chacune d'elles et modifie progressivement son comportement afin que les réponses à récompense élevée deviennent plus probables et que les réponses à faible récompense deviennent moins probables. Cette approche est particulièrement efficace dans les scénarios qui nécessitent un raisonnement en plusieurs étapes, une prise de décision complexe ou la compréhension de nuances subtiles dans les requêtes.
L'affinage par apprentissage par renforcement pour Gemini vous permet d'affiner Gemini à l'aide de vos propres requêtes et de fonctions de récompense que vous définissez vous-même. Vous pouvez l'utiliser pour améliorer la capacité de raisonnement et la qualité des résultats des modèles Gemini pour vos propres cas d'utilisation et workflows agentiques.
Fonctionnement
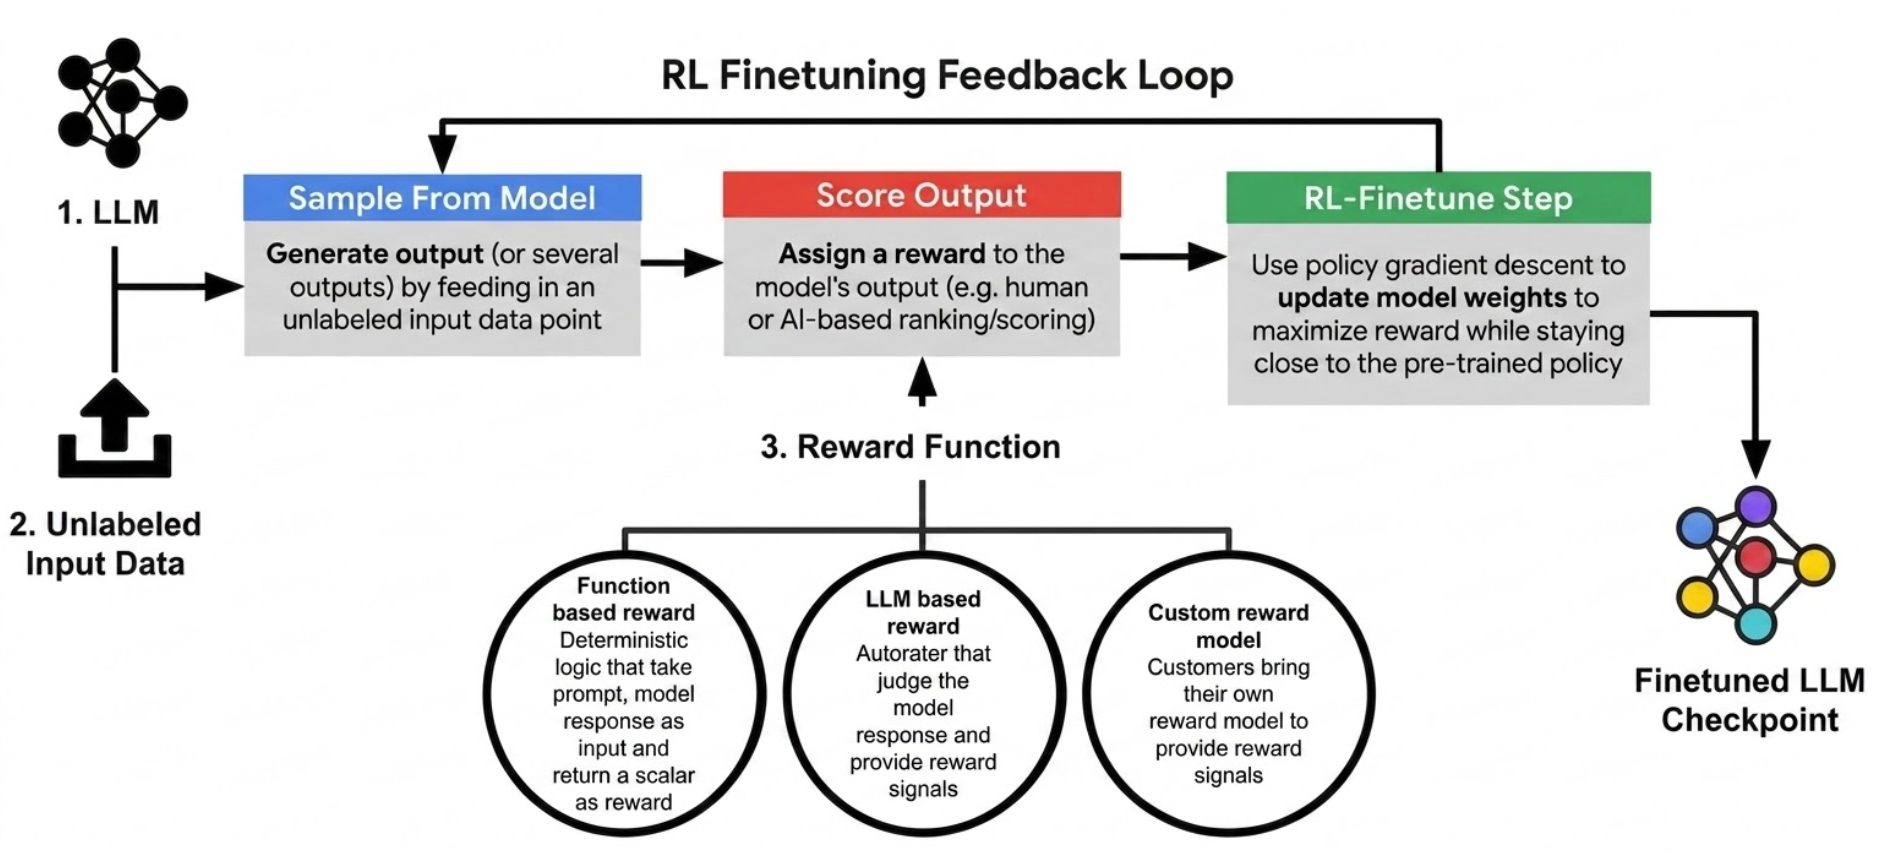
Le réglage fin par apprentissage par renforcement fonctionne de manière itérative pour affiner le comportement du LLM. À chaque itération, le modèle génère des réponses à un ensemble de prompts. Ces réponses sont ensuite évaluées par une fonction de récompense définie par l'utilisateur, qui quantifie la qualité du résultat généré en fonction de vos critères cibles. Le service utilise ce signal de récompense pour mettre à jour les paramètres du modèle via des algorithmes d'apprentissage par renforcement, afin d'encourager les comportements qui entraînent des récompenses plus élevées. Ce processus itératif de génération, d'évaluation et de mise à jour des paramètres adapte le modèle à vos cas d'utilisation spécifiques.
Le schéma suivant illustre le workflow global de réglage par apprentissage par renforcement :
Principales fonctionnalités
Le réglage par apprentissage par renforcement inclut les fonctionnalités clés suivantes :
Fonctions de récompense personnalisables : définissez vos propres fonctions de récompense pour optimiser précisément un large éventail de cas d'utilisation personnalisés et aligner le comportement du modèle sur des objectifs spécifiques. Pour en savoir plus sur les types de récompenses compatibles, consultez la page Fonctions de récompense.
Adaptateurs pour un réglage efficace : le réglage par apprentissage par renforcement utilise des adaptateurs, qui permettent une adaptation efficace tout en réutilisant l'infrastructure de diffusion existante.
Plusieurs niveaux de raisonnement : le service est compatible avec le réglage à deux niveaux de raisonnement,
MINIMALetHIGH(raisonnement dynamique). Vous pouvez ainsi choisir l'approche qui correspond le mieux à vos objectifs d'optimisation et à vos modèles de génération de réponses cibles. Pour en savoir plus, consultez la page Hyperparamètres.Réglage continu : affinez un modèle précédemment réglé en intégrant des exemples d'entraînement ou des époques supplémentaires. L'utilisation d'un modèle ou d'un point de contrôle réglé existant comme base permet d'optimiser le processus d'expérimentation du réglage. Pour en savoir plus, consultez la page Réglage continu.
Ensembles de données multimodaux : accepte les modalités de données textuelles, d'images, de vidéos (Gemini 3.5 Flash uniquement) et audio.
Quand utiliser le réglage par apprentissage par renforcement ?
Le réglage par apprentissage par renforcement est privilégié pour affiner les LLM dans les situations où les stratégies optimales ne sont pas évidentes par le biais de l'apprentissage supervisé. Cela inclut les tâches dont l'objectif est d'optimiser des métriques spécifiques sans étiquettes de vérité terrain facilement disponibles, où l'alignement avec les préférences humaines est crucial (et où une méthode de jugement existe), et pour les tâches nécessitant un raisonnement lourd qui bénéficient d'une amélioration et d'une exploration itératives.
Voici quelques scénarios dans lesquels le réglage fin par apprentissage par renforcement est préférable :
Suivi d'instructions complexes : lorsque le modèle doit suivre des instructions complexes où la sortie "correcte" n'est pas une réponse unique, mais nécessite un ensemble de vérifications. L'apprentissage par renforcement peut adapter le modèle pour qu'il gère ces ensembles d'instructions complexes.
Génération de contenu créatif : pour des tâches telles que la génération de textes créatifs, de poésie ou de code hautement spécialisé, pour lesquelles il est difficile de définir des métriques objectives. L'apprentissage par renforcement, avec une fonction de récompense bien conçue (impliquant potentiellement des commentaires humains ou une évaluation d'experts), peut guider le modèle vers des résultats plus efficaces et innovants.
Tâches de raisonnement : pour les tâches qui nécessitent un raisonnement complexe, comme la résolution d'énigmes ou de problèmes mathématiques, l'apprentissage par renforcement peut inciter le modèle à explorer différentes séquences de raisonnement afin d'identifier les modèles les plus efficaces pour résoudre les problèmes.
Modèles et régions compatibles
Les modèles Gemini suivants sont compatibles avec l'affinage par apprentissage par renforcement :
Gemini 3.5 Flash
| Spécification | Valeur |
|---|---|
| Points de terminaison compatibles pour le réglage de modèle |
|
| Points de terminaison compatibles pour la mise en service de modèles réglés |
|
| Version de l'API | v1beta1 uniquement |
Gemini 3.1 Flash-Lite
| Spécification | Valeur |
|---|---|
| Points de terminaison compatibles pour le réglage de modèle |
|
| Points de terminaison compatibles pour la mise en service de modèles réglés |
|
| Version de l'API | v1beta1 uniquement |
Modalités de réglage compatibles
Le réglage par apprentissage par renforcement accepte les modalités de données suivantes dans vos ensembles de données de réglage :
- Texte
- Audio
- Image
- Vidéo (compatible uniquement avec Gemini 3.5 Flash)
Pour connaître les limites des ensembles de données par modalité (par exemple, le nombre maximal de fichiers par requête, la taille maximale des fichiers et la longueur totale maximale), consultez la page Ensemble de données de réglage.
Réglage continu
Vous pouvez utiliser le résultat d'un job de réglage précédent comme base pour un nouveau job d'affinage par apprentissage par renforcement. Les modèles de réglage continu suivants sont acceptés :
- Affinage supervisé → Réglage fin par apprentissage par renforcement
- Réglage fin par apprentissage par renforcement → Réglage fin par apprentissage par renforcement
Pour en savoir plus sur la configuration, consultez la page Réglage continu.
Diffuser le modèle réglé
Une fois le job d'affinage par apprentissage par renforcement terminé sur le modèle Gemini de base, un modèle affiné basé sur le dernier point de contrôle est déployé sur un point de terminaison de votre projet. Les modèles réglés utilisent la même stratégie de point de terminaison de diffusion que le modèle de base. Par exemple, si vous exécutez un job de réglage dans us-central1, le modèle réglé est déployé sur un point de terminaison multirégional (mREP) us.
Pour récupérer le point de terminaison du modèle réglé déployé dans la console Google Cloud ou à l'aide de l'API et exécuter l'inférence sur celui-ci, consultez le guide de démarrage rapide de la consoleGoogle Cloud ou le guide de démarrage rapide de l'API.
Tarifs
Tarifs du réglage
Le réglage par apprentissage par renforcement pour Gemini génère des jetons en deux phases : une phase d'échantillonnage et une phase d'entraînement. Les jetons générés pendant la phase d'entraînement sont facturés conformément à la section "Réglage de modèle" de la page Tarifs de Gemini Enterprise Agent Platform.
Tarifs d'inférence
Après le réglage, les coûts d'inférence (requête de prédiction) du modèle réglé continuent de s'appliquer. Pour Gemini 3 et les modèles ultérieurs, le prix de prédiction du point de terminaison du modèle réglé est 1,5 fois supérieur à celui du modèle de base. Pour en savoir plus, consultez Versions de modèles Gemini stables et disponibles.
Si vous configurez le service d'évaluation de l'IA générative pour qu'il s'exécute automatiquement pendant le réglage, les évaluations sont facturées en tant que jobs de prédiction par lot. Pour en savoir plus, consultez la section "Réglage de modèle" de la page Tarifs d'Agent Platform.
Étapes suivantes
- Suivez le guide de démarrage rapide de la consoleGoogle Cloud ou le guide de démarrage rapide de l'API pour créer votre premier job d'affinage par apprentissage par renforcement.
- Découvrez comment préparer un ensemble de données de réglage et configurer des fonctions de récompense.
- Découvrez comment déployer un modèle Gemini réglé.