


O Gemini Distillation Service (destilação) permite que os usuários treinem um modelo "estudante" menor e mais eficiente que usa as saídas e os padrões de raciocínio de um modelo "professor" maior e mais capaz. Embora os modelos de fronteira definam a vanguarda da IA, eles podem ser superprovisionados para casos de uso empresariais específicos. A destilação preenche essa lacuna, permitindo eficiência de nível de produção (menor latência e custo), ao mesmo tempo em que permite que modelos menores alcancem um nível mais profundo de raciocínio.
Ao contrário do ajuste supervisionado (SFT) padrão, que usa apenas a saída de texto final, a destilação aproveita:
- Respostas do professor: a saída textual final.
- Pensamentos brutos: os caminhos de raciocínio internos gerados pelo modelo professor.
Modelos compatíveis
Os seguintes modelos são compatíveis com a destilação durante o acesso antecipado:
- Modelo professor:
gemini-3.1-pro - Modelo estudante:
gemini-2.5-flash
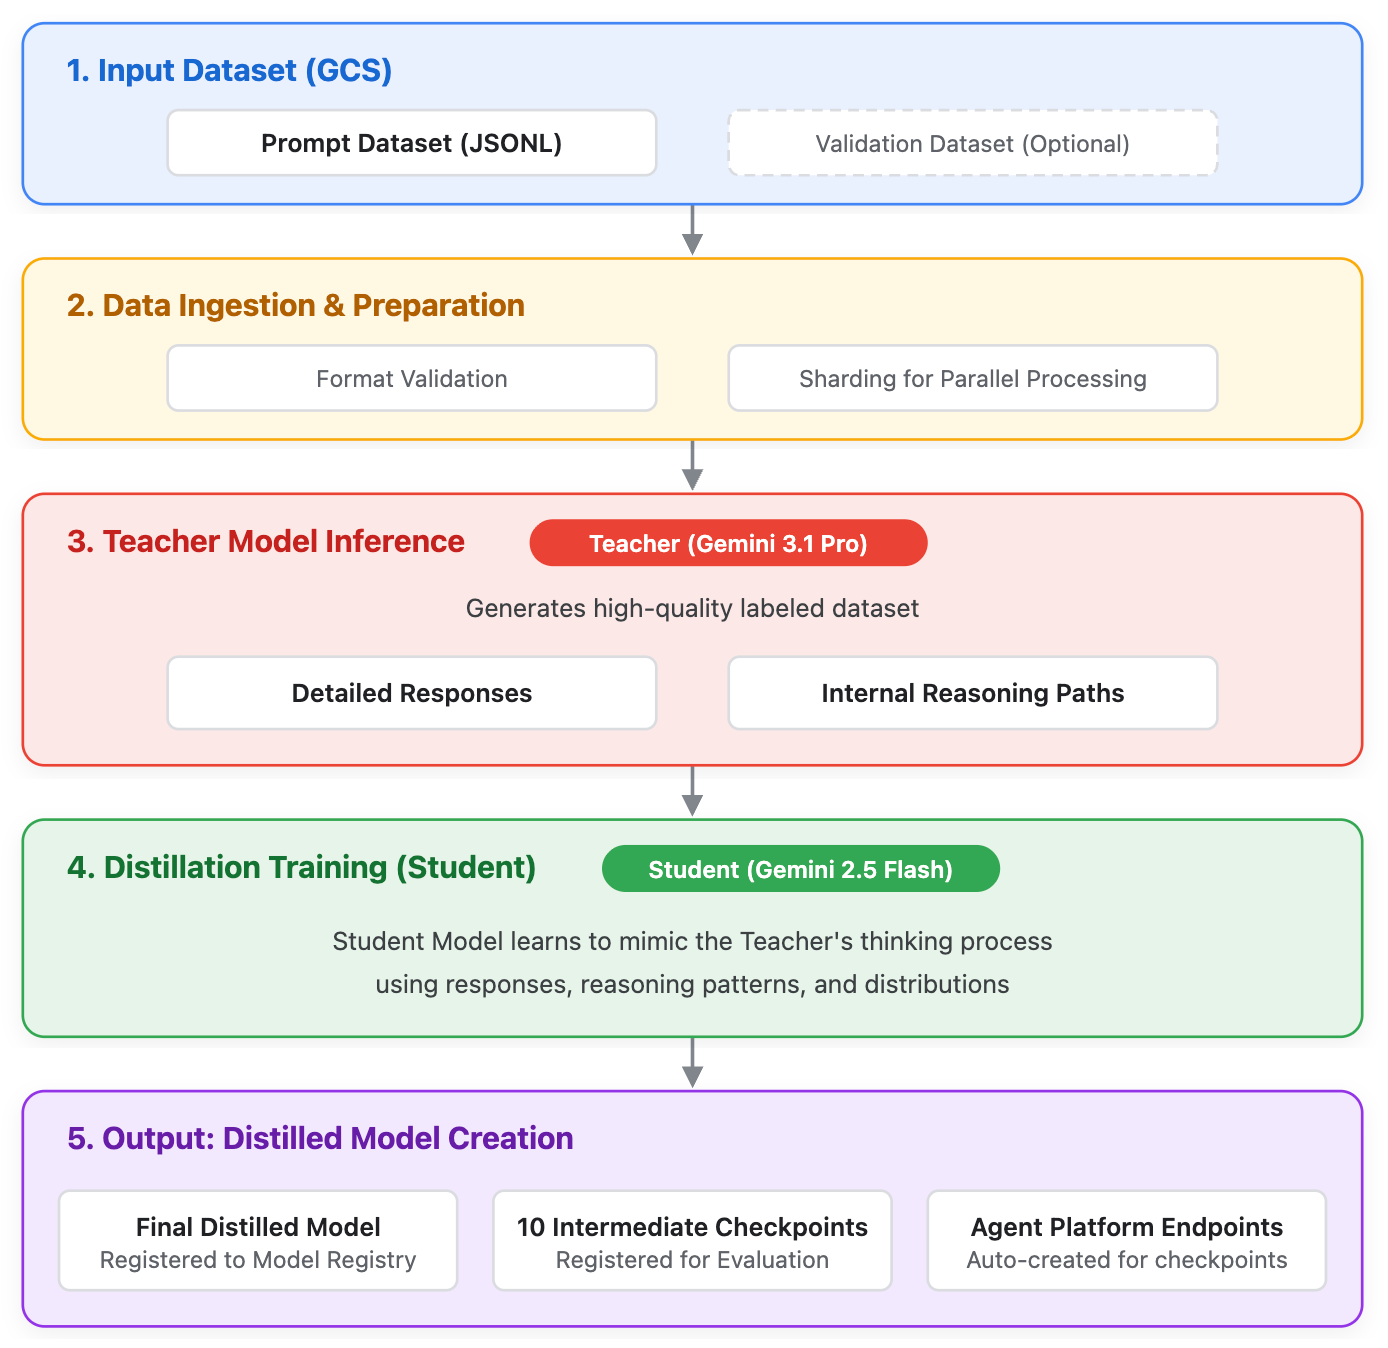
Figura 1. Ilustração do sistema de como o Gemini Distillation Service funciona.
Casos de uso adequados
A destilação é recomendada em vez de comandos padrão ou ajuste de detalhes supervisionado (SFT) nos seguintes cenários:
- Aplicativos de alto volume e sensíveis à latência: quando o aplicativo exige os recursos de raciocínio de um modelo de nível Pro, mas precisa atender a SLAs de latência rigorosos ou restrições de orçamento que exigem um modelo de nível Flash.
- Falta de dados de verdade absoluta (o SFT é inviável): quando você tem um grande conjunto de dados de comandos ou consultas do usuário, mas não tem os recursos para rotular ou gerar manualmente respostas de verdade absoluta de alta qualidade necessárias para o SFT padrão.
- Tarefas de raciocínio complexas: tarefas que envolvem lógica de várias etapas, resumo de documentos altamente técnicos ou tarefas de codificação complexas em que o modelo Flash básico tem dificuldades, mas o modelo Pro tem sucesso.
- Lacunas de desempenho significativas: quando o modelo professor supera substancialmente o modelo estudante básico na tarefa específica, fornecendo uma margem clara de conhecimento a ser transferida durante a destilação.
Pré-requisitos e configuração do projeto
Antes de iniciar um job de destilação, verifique se o Google Cloud ambiente está configurado corretamente:
- Solicitar acesso à lista de permissões: verifique se o ID do projeto Google Cloud foi adicionado à lista de permissões para o acesso antecipado do Gemini Distillation Service. Entre em contato com seu representante de vendas do Google para adicionar seu projeto à lista de permissões.
- Ativar a API: ative a API Agent Platform no seu Google Cloud projeto.
- Definir permissões de papel do IAM: você precisa ter o
papel de administrador da API Agent Platform (
roles/aiplatform.admin) do IAM. - Definir a região: os jobs de destilação precisam ser executados na
us-central1região.
Preparação do conjunto de dados
Um recurso fundamental desse serviço é o uso de conjuntos de dados somente de comandos. Como o modelo professor gera as saídas de destino durante o processo de destilação, não é necessário fornecer as respostas esperadas.
Requisitos do conjunto de dados
Os conjuntos de dados precisam estar no formato JSON Lines (JSONL) e armazenados em um bucket do Cloud Storage. Cada entrada precisa obedecer ao formato do conjunto de dados de ajuste do Gemini em adição ao seguinte:
- Instruções do sistema: é possível incluir um
systemInstructioncampo opcional (com um papel "system") para definir comandos do sistema. - Entrada: o campo de conteúdo (com um papel "user") é obrigatório para a entrada principal.
Comandos de várias etapas: é possível alternar entre os papéis "user" e "model", desde que a entrada final na sequência seja "user".
A seguir, há dois exemplos de arquivos dataset.jsonl:
{
  "contents": [
    {
      "role": "user",
      "parts": [
        {
          "text": "You're the artist here. Choose as many strands of thread as you like, as long as you're using three or more. Go for color combinations that you think would make a pretty pattern. Get creative! If you only use one color of thread, you won't be able to create a pattern.\n\nProvide a summary of the article in two or three sentences:\n\n"
        }
      ]
    }
  ]
},
{
  "contents": [
    {
      "role": "user",
      "parts": [
        {
          "text": "You're the artist here. Choose as many strands of thread as you like, as long as you're using three or more. Go for color combinations that you think would make a pretty pattern. Get creative! If you only use one color of thread, you won't be able to create a pattern.\n\nProvide a summary of the article in two or three sentences:\n\n"
        }
      ]
    },
    {
      "role": "model",
      "parts": [
        {
          "text": "Choose several strands of embroidery thread in a variety of colors."
        }
      ]
    },
    {
      "role": "user",
      "parts": [
        {
          "text": "You will need one egg (raw or hard boiled but hard boiled is best) and one spoon for each person participating in the race. You might even like to use dyed Easter eggs as something special for Easter. It's best to have this race on grass or some other soft surface, to give dropped eggs a chance!"
        }
      ]
    }
  ]
}
Práticas recomendadas
Use as diretrizes a seguir ao criar o conjunto de dados:
- Tamanho: um mínimo de 1.000 exemplos é recomendado para uma melhoria notável na qualidade .
- Diversidade: verifique se os comandos cobrem os casos extremos e os comprimentos variáveis esperados no tráfego de produção.
Configurar a solicitação de destilação
Um job de destilação exige a configuração do comportamento de geração do professor e dos hiperparâmetros de treinamento do estudante.
Configurar o comportamento de geração do modelo professor
É necessário definir como o modelo professor responde ao conjunto de dados. A qualidade do modelo estudante está diretamente vinculada à qualidade da saída do professor. Para configurar o comportamento de geração do modelo professor, defina o candidateCount:
candidateCount: o número de variações de resposta a serem geradas. Exemplo:4. Intervalo[1, 5]). Se não for especificado na solicitação, um valor padrão de4será usado.
Definir os hiperparâmetros de destilação
Os hiperparâmetros de destilação controlam o processo de treinamento do modelo estudante. Para mais informações sobre hiperparâmetros na Gemini Enterprise Agent Platform, consulte a "Criar um job de ajuste" seção do guia de ajuste supervisionado.
Os seguintes hiperparâmetros precisam ser definidos ao criar um job de destilação:
epochCount: o número de vezes que o modelo estudante vai iterar no conjunto de dados. Exemplo:20. Intervalo[1, 100]). Se não for especificado, um valor padrão de4será usado.learningRateMultiplier: modifica a taxa de aprendizado básica do modelo estudante. Exemplo:2.0. Intervalo[0.25, 4]). Se não for especificado, um valor padrão de1será usado.
Iniciar o job de destilação
Durante o período de acesso antecipado, é possível enviar e monitorar jobs de destilação usando a versão REST da API Agent Platform. É possível iniciar um novo job de destilação ou realizar um ajuste contínuo em um checkpoint de modelo já destilado.
Criar um novo job de destilação
Crie um arquivo JSON chamado request.json que contenha a configuração do job. No exemplo a seguir, a configuração de geração do professor está aninhada no campo hyperParameters:
{
    "description": "Distillation testing job.",
    "baseModel": "gemini-2.5-flash",
    "tunedModelDisplayName": "flash-distillation-run-1",
    "distillationSpec": {
        "promptDatasetUri": "gs://your-bucket/path/to/prompt_dataset.jsonl",
        "validationDatasetUri": "",
        "base_teacher_model": "gemini-3.1-pro-preview",
        "hyperParameters": {
            "epochCount": "20",
            "learningRateMultiplier": 2.0,
            "generation_config": {
              "candidateCount": 5
            }
        }
    }
}
Envie o job usando curl:
curl -X POST \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  https://us-central1-aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/us-central1/tuningJobs \
  -d @request.json
Realizar ajuste contínuo
Se você quiser retomar o ajuste de um checkpoint de modelo destilado anteriormente, inclua o bloco preTunedModel no arquivo request.json. O ajuste contínuo só é compatível com checkpoints de modelo destilados anteriormente, com o mesmo modelo estudante de base. Checkpoints de modelo ajustados anteriormente (mesmo com o mesmo modelo estudante de base) não são compatíveis.
Confira a seguir um exemplo de configuração de ajuste contínuo para um checkpoint de modelo destilado anteriormente:
{
    "description": "Continuous distillation testing job.",
    "preTunedModel": {
      "tunedModelName": "projects/YOUR_PROJECT_ID/locations/us-central1/models/PRETUNED_MODEL_ID@1",
      "checkpointId": "1",
      "baseModel": "gemini-2.5-flash"
    },
    "tunedModelDisplayName": "flash-distillation-continuous",
    "distillationSpec": {
        "promptDatasetUri": "gs://your-bucket/path/to/prompt_dataset.jsonl",
        "validationDatasetUri": "",
        "base_teacher_model": "gemini-3.1-pro-preview",
        "hyperParameters": {
            "epochCount": "20",
            "learningRateMultiplier": 2.0,
            "generation_config": {
              "candidateCount": 5,
            }
        }
    }
}
Envie o payload usando curl:
curl -X POST \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  https://us-central1-aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/us-central1/tuningJobs \
  -d @request.json
Monitorar o job de destilação
A resposta de envio vai retornar um nome de job que contém o
JOB_ID. É possível verificar o status do job (state, erros e hiperparâmetros finais) enviando uma solicitação GET:
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json; charset=utf-8" \
  https://us-central1-aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/us-central1/tuningJobs/JOB_ID
Também é possível monitorar o progresso visualmente no Google Cloud console. Acesse
Agent Platform > Tuning e escolha a
us-central1 região.
Para esta versão de acesso antecipado, a interface da Agent Platform Console tem as seguintes limitações conhecidas:
- Progresso da amostragem do professor: não há widget de progresso para o processo de amostragem do modelo professor. Embora o status possa mostrar "Executando a preparação para o ajuste", o job está prosseguindo normalmente em segundo plano.
- Gráficos de ajuste do estudante: durante a fase de ajuste do modelo estudante, a UI mostra gráficos para a curva de perda e o total de tokens de texto de treinamento.
- Tabela de checkpoints: a interface mostra uma tabela de checkpoints intermediários e links para o endpoint de previsão da Agent Platform gerado para avaliação. A coluna "Época" nesta tabela mostra "0" devido a um problema conhecido.
Cancelar o job de destilação
Para cancelar um job de destilação em andamento, faça uma das seguintes ações:
Use o Google Cloud console, mudando o seguinte URL:
https://console.cloud.google.com/agent-platform/tuning/managed?project=YOUR_PROJECT_ID&vertex_ai_region=us-central1Substitua YOUR_PROJECT_ID pelo ID do projeto.
Use
curlpara enviar uma solicitação POST para cancelar o job:curl -X POST \ -H "Authorization: Bearer $(gcloud auth print-access-token)" \ -H "Content-Type: application/json; charset=utf-8" \ https://us-central1-aiplatform.googleapis.com/v1beta1/projects/YOUR_PROJECT_ID/locations/us-central1/tuningJobs/YOUR_JOB_ID:cancelSubstitua:
YOUR_PROJECT_IDpelo ID do projeto.YOUR_JOB_IDpelo ID do job.
Como avaliar o resultado
Depois que o job de destilação for concluído, o novo modelo estudante será registrado automaticamente no Gemini Enterprise Agent Platform Model Registry, e um ou mais endpoints dedicados serão criados para disponibilizar previsões. Para avaliar o resultado, localize o endpoint, envie uma solicitação de previsão e, por fim, avalie.
Para avaliar o resultado, faça o seguinte:
Envie a seguinte solicitação GET para conferir o status do job de ajuste.
curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json; charset=utf-8" \
  https://us-central1-aiplatform.googleapis.com/v1beta1/projects/YOUR_PROJECT_ID/locations/us-central1/tuningJobs/YOUR_JOB_ID
Substitua:
YOUR_PROJECT_IDpelo ID do projeto.YOUR_JOB_IDpelo ID do job.
Os jobs concluídos mostram um campo
endpointaninhado dentro do objetotunedModel. Extraia oENDPOINT_IDdo final da string do caminho retornado (por exemplo,projects/.../endpoints/YOUR_ENDPOINT_ID). Anote o ID do endpoint.Verifique se o job de ajuste foi concluído, porque o endpoint não está disponível enquanto o job de ajuste ainda está em execução ou falhou. Se o campo
endpointestiver ausente, depure o job de ajuste visualizando as chavesstateouerrordo job.Crie uma solicitação de payload JSON chamada
generate_content_request.jsonque contenha o comando:{ "contents": { "role": "user", "parts": [ { "text": "hi, say something" } ] } }Use o exemplo POST a seguir para enviar uma solicitação de previsão:
curl -X POST \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  https://us-central1-aiplatform.googleapis.com/v1beta1/projects/YOUR_PROJECT_ID/locations/us-central1/endpoints/YOUR_ENDPOINT_ID:generateContent \
  -d @generate_content_request.json
Substitua:
YOUR_PROJECT_ID: o ID do projeto.YOUR_JOB_ID: o ID do job.ENDPOINT_ID: o ID do endpoint.
Faça o seguinte para avaliar os resultados:
Execute um conjunto de teste de validação, usando comandos não incluídos nos dados de treinamento, no modelo recém-destilado.
Compare as saídas com o modelo
gemini-2.5-flashde base para medir as melhorias de qualidade.Compare as saídas com o modelo
gemini-3.1-propara determinar o quão próximo o estudante se aproxima do raciocínio do professor.
Limitações
A tabela a seguir descreve as limitações da destilação:
A destilação está sujeita às seguintes limitações:
- Limitações do modelo:
- Consulte os modelos compatíveis.
- Restrições do conjunto de dados:
- Limites de volume:
- A capacidade máxima do conjunto de treinamento é de 50.000 exemplos.
- O tamanho do arquivo JSONL de origem não pode exceder 1 GB.
- Especificações da janela de contexto:
- O serviço acomoda um máximo de 8.000 tokens de entrada por entrada. Os jobs de destilação são encerrados se mais de 10% das entradas fornecidas excederem esse limite estabelecido.
- A amostragem do modelo professor é limitada a uma saída máxima de 24.000 tokens. Em instâncias em que o modelo professor gera mais de 24.000 tokens, o conteúdo é truncado nesse limite, o que pode afetar o desempenho do modelo estudante.
- Modalidade: limitada a dados baseados em texto. Não há suporte para entradas multimodais, incluindo vídeo, imagens ou chamadas de função.
- Limites de volume:
- Limitações de configuração e hiperparâmetros
- Obedeça aos limites a seguir ao definir o distillationSpec e os hiperparâmetros associados:
- Criptografia: a CMEK não está disponível para tarefas de destilação que envolvem modelos próprios do Google.
epochCount: restrito a um valor inteiro entre 1 e 100.learningRateMultiplier: os valores precisam estar dentro do intervalo de usar pontos flutuantes de0.25-4.0.
- Obedeça aos limites a seguir ao definir o distillationSpec e os hiperparâmetros associados:
- Destilação de uma etapa: a amostragem do modelo professor e o modelo estudante ajuste são executados em uma única chamada de API. Se você tiver uma grande quantidade de dados para amostrar, os mesmos dados precisarão ser amostrados novamente no ajuste a seguir.
Acesso
Se você tiver interesse em testar o Gemini Distillation Service, entre em contato com nossa equipe do Tuning Service em cloud-ai-tuning-service-support@google.com para solicitar acesso e permissão do projeto.
Para garantir o desempenho ideal e o gerenciamento de recursos, recomendamos criar um dedicado Google Cloud projeto para as tarefas de destilação. Ao entrar em contato com nossa equipe, forneça o ID do projeto ou o número do projeto para acelerar o processo de permissão.
Cotas e políticas de acesso
As seguintes cotas e políticas de acesso estão em vigor:
Capacidade: os projetos adicionados recentemente à nossa lista de permissões são provisionados com uma cota simultânea padrão de 4. Para evitar a disputa de recursos, recomendamos usar um projeto separado em vez de um que já esteja executando outros jobs de ajuste do Gemini.
Período de acesso: o acesso é concedido por um período inicial de 30 dias.