


AlphaFold 3 es un modelo de aprendizaje profundo desarrollado por Google DeepMind y Isomorphic Labs. Está diseñado para predecir las estructuras y las interacciones en 3D de proteínas, ADN, ARN, ligandos e iones. En este documento, se describe cómo implementar y usar el modelo AlphaFold 3 con Model Garden en Gemini Enterprise Agent Platform.
Funciones clave
La implementación de AlphaFold 3 en Agent Platform proporciona las siguientes capacidades necesarias para la investigación y el desarrollo (I+D) avanzados, y los flujos de trabajo comerciales de descubrimiento de fármacos:
Uso comercial: AlphaFold 3 en Model Garden está disponible para uso comercial.
Ligandos personalizados arbitrarios: AlphaFold 3 admite el plegamiento conjunto unificado de proteínas, ADN y ARN junto con ligandos personalizados definidos con cadenas SMILES o códigos del Diccionario de componentes químicos (CCD) de CIF.
Flexibilidad del flujo de trabajo: AlphaFold 3 en Model Garden admite una canalización de plegamiento integral completa (que combina la búsqueda en la base de datos y la predicción del modelo) o un modo solo de inferencia en el que puedes proporcionar alineaciones de MSA precalculadas para optimizar el tiempo de ejecución y el uso de la GPU.
Consideraciones
Cuando evalúes AlphaFold 3 para cargas de trabajo, ten en cuenta las siguientes restricciones:
Simultaneidad: El extremo de AlphaFold 3 tiene un límite de simultaneidad de uno por nodo. Para una mayor simultaneidad, los extremos se pueden escalar a varios nodos. Si se envía una solicitud de predicción mientras se ejecuta otra predicción de forma activa, el extremo rechaza la nueva solicitud con un error
HTTP 429 Too Many
Requests
si la cantidad de solicitudes es mayor que la cantidad de nodos.Límites de tokens: La duración máxima de la predicción en los extremos de Agent Platform es de 60 minutos. Debido a la sobrecarga variable de la búsqueda de MSA, el tamaño máximo de secuencia admitido en las GPU A3 es de aproximadamente 4,500 tokens biológicos (como aminoácidos, nucleótidos o átomos de ligandos) de sobrecarga. Proporcionar alineaciones precalculadas evita la ejecución de la búsqueda de MSA, lo que permite el plegamiento complejo hasta el límite de hardware de aproximadamente 5,400 tokens.
Límites de carga útil: Las solicitudes REST de predicción estándar tienen un límite de tamaño de 8 MB. Si usas el modo de solo inferencia, se debe hacer referencia a las alineaciones grandes precalculadas (archivos
.a3m) con URIs de Cloud Storage en lugar de incorporarlas como cadenas intercaladas para evitar el rechazo de la carga útil.Configuración de red: Debido a que las predicciones son operaciones de larga duración que pueden tardar hasta 60 minutos en completarse, solo debes implementar el extremo con Private Service Connect (PSC) para omitir los límites de tiempo de espera estándar del extremo de 10 minutos.
Instrucciones de la implementación
En esta sección, se detalla la implementación de AlphaFold 3 en un endpoint proporcionado por Agent Platform en un proyecto de Google Cloud .
Antes de comenzar
Antes de implementar AlphaFold 3, debes hacer lo siguiente:
- Solicita acceso al modelo.
- Adquiere recursos de GPU.
- Configura los permisos necesarios de Identity and Access Management (IAM):
- Crea una cuenta de servicio con el rol de IAM de Administrador de Agent Platform.
- Asegúrate de que tu principal de IAM tenga el rol
roles/iam.serviceAccountCreatorpara actuar como la cuenta de servicio mientras implementas el modelo.
- Verifica las cuotas de recursos.
Requisitos de los recursos
AlphaFold 3 requiere una máquina virtual (VM) a3-highgpu-1g.
Antes de la implementación, asegúrate de que tu proyecto Google Cloud tenga suficiente cuota en la región de implementación objetivo para los siguientes recursos:
Aceleradores: Al menos un tipo de máquina
a3-highgpu-1gSSD local: La VM A3 se aprovisiona con 750 GB de espacio de SSD local. Esto es necesario para almacenar en caché de forma persistente las bases de datos de secuencias de referencia (UniProt, MGnify, Rfam), lo que permite lecturas de baja latencia durante las búsquedas en bases de datos genéticas (Jackhmmer/Nhmmer) en todas las solicitudes de predicción.
Bucket de Cloud Storage
AlphaFold 3 requiere un bucket de Cloud Storage para almacenar los archivos de MSA proporcionados y exportar los resultados de predicción completos. Para evitar transferencias entre regiones, te recomendamos que uses un bucket de Cloud Storage en la misma región que tu extremo o un bucket multirregional.
Roles de Identity and Access Management
Configura los siguientes roles en las identidades participantes:
Implementador del modelo (también conocido como administrador de TI): La identidad que implementa el modelo requiere el permiso
roles/aiplatform.adminpara crear extremos y administrar implementaciones.Identidad de servicio: Cuando se ejecuta la inferencia, los extremos de AlphaFold 3 escriben estructuras de resultado directamente en Cloud Storage con la cuenta de servicio del proyecto del arrendatario. La cuenta de servicio correspondiente requiere el permiso
roles/storage.objectUseren el bucket de Cloud Storage de destino.Usuarios del modelo: Las cuentas que inician predicciones requieren lo siguiente:
roles/aiplatform.userpara enviar solicitudes de predicción al extremoroles/storage.objectUserpara acceder a los resultados de la predicción en el bucket de Cloud Storage
Implementa AlphaFold 3
Implementa AlphaFold 3 de forma programática con el SDK de Agent Platform como un extremo dedicado de Google Cloud o como un extremo de Private Service Connect únicamente. El extremo puede tardar entre 10 y 15 minutos en estar listo para la inferencia, según la disponibilidad de tu GPU.
A continuación, se muestra un fragmento de ejemplo de Python que muestra cómo implementar el modelo en un proyecto de Google Cloud , incluida una extensión del tiempo de espera de inferencia:
import google.auth
from google.auth.transport.requests import AuthorizedSession
import vertexai
from vertexai import model_garden

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
MODEL_ID = "google/alphafold3@v3_0_4"
MACHINE_TYPE = "a3-highgpu-1g"

vertexai.init(project=PROJECT_ID, location=LOCATION)

# 1. Deploy Model Garden OpenModel to Dedicated Endpoint
af3_model = model_garden.OpenModel(MODEL_ID)
endpoint = af3_model.deploy(
    endpoint_display_name="af3-dedicated-ep",
    model_display_name="af3-on-mg",
    machine_type=MACHINE_TYPE,
    accelerator_type="NVIDIA_H100_80GB",
    accelerator_count=1,
    reservation_affinity_type="ANY_RESERVATION",
    use_dedicated_endpoint=True,
    accept_eula=True,
    min_replica_count=1,
    max_replica_count=1,
    serving_container_deployment_timeout=3600,
)

# 2. Update inference timeout to 3,600 seconds
credentials, _ = google.auth.default(
    scopes=["https://www.googleapis.com/auth/cloud-platform"]
)
session = AuthorizedSession(credentials)
url = f"https://{LOCATION}-aiplatform.googleapis.com/v1/{endpoint.resource_name}:update"
payload = {
    "endpoint": {
        "name": endpoint.resource_name,
        "clientConnectionConfig": {
            "inferenceTimeout": {
                "seconds": 3600
            }
        }
    }
}
response = session.post(url, json=payload)
response.raise_for_status()
print(f"Endpoint Resource Name: {endpoint.resource_name}")
Referencia de la API
En esta sección, se describen la ubicación del extremo, el formato de URL, los parámetros de ruta y el esquema de la carga útil de la solicitud.
Solicitud HTTP
POST https://HOST/v1/projects/PROJECT_ID/locations/LOCATION/endpoints/ENDPOINT_ID:predict
Reemplaza lo siguiente:
HOST: Es el host del extremo del servicio. Esto depende de si el tipo de implementación es un extremo público dedicado o usa Private Service Connect.PROJECT_ID: Es el ID del proyecto de Google Cloud que aloja el extremo implementado.LOCATION: Es la región de Google Cloud en la que se implementa el extremo (por ejemplo,us-central1).ENDPOINT_ID: Es el identificador único del extremo de Agent Platform implementado.
Cuerpo de la solicitud
El cuerpo de la solicitud contiene datos con la siguiente estructura JSON:
{
  "instances": [
    {
      # The AlphaFold 3 input JSON - see the input documentation at
      # https://github.com/google-deepmind/alphafold3/blob/main/docs/input.md
    }
  ],
  "parameters": {
    "output_dir": "string",
    "dry_run": boolean,
    "run_data_pipeline": boolean,
    "force_output_dir": boolean,
    "resolve_msa_overlaps": boolean,
    "max_template_date": "string",
    "conformer_max_iterations": integer,
    "fix_standalone_glycans": boolean,
    "flash_attention_implementation": "string",
    "num_recycles": integer,
    "num_diffusion_samples": integer,
    "save_embeddings": boolean,
    "save_distogram": boolean,
    "compress_large_output_files": boolean,
    "num_seeds": integer
  }
}
Campos de solicitud de nivel superior
| Campo | Tipo | Descripción |
|---|---|---|
instances |
array |
Obligatorio. Lista de configuraciones de secuencias biológicas para predecir. Esta lista debe contener exactamente un elemento. Si se pasa cero o más de un elemento, se produce un error de HTTP 422 Unprocessable
Entity. El cuerpo de instances debe especificar las entradas según la especificación publicada en la
documentación de AlphaFold 3.
|
parameters |
object |
Opcional. Objeto que contiene parámetros de ejecución para configurar la ejecución de la predicción (como dry_run, output_dir).
|
Parámetros
Configura las marcas de ejecución para la ejecución de AlphaFold 3.
| Campo | Tipo | Valor predeterminado | Descripción |
|---|---|---|---|
dry_run |
boolean |
false |
Opcional. Si es true, la API ejecuta la validación de la solicitud, pero omite la ejecución del modelo y muestra una respuesta vacía de inmediato. Es útil para verificar la conectividad y la sintaxis.
|
run_data_pipeline |
boolean |
true |
Opcional. Si es true, ejecuta la canalización completa (búsqueda e inferencia de MSA). Si es false, solo ejecuta la inferencia (omite la búsqueda en la base de datos; requiere MSA precalculados). Consulta la
documentación en GitHub para obtener más detalles.
|
output_dir |
string |
null |
Opcional. Es el URI de Cloud Storage (como gs://bucket/path) en el que se suben los archivos de salida sin procesar completos (incluidas las estructuras CIF, el PAE y los archivos CSV de clasificación) tras una ejecución exitosa.
|
force_output_dir |
boolean |
false |
Opcional. Si es true, permite reemplazar los archivos existentes en el output_dir especificado. Si es false, la API devuelve un error HTTP 400 Bad Request de inmediato si la ruta de acceso de Cloud Storage no está vacía para evitar la pérdida accidental de datos.
|
resolve_msa_overlaps |
boolean |
true |
Opcional. Indica si se deben quitar los duplicados de las MSA no vinculadas con respecto a las MSA vinculadas. Consulta los lineamientos sobre las prácticas recomendadas en la documentación de GitHub AlphaFold 3. |
max_template_date |
string |
null |
Opcional. Fecha máxima de lanzamiento de la plantilla que se debe tener en cuenta en formato YYYY-MM-DD (por ejemplo, "2024-05-15"). La validación falla con un error HTTP 422 si el formato es incorrecto.
|
conformer_max_iterations |
integer |
null |
Opcional. Anula la cantidad máxima de iteraciones que se ejecutarán para la búsqueda de conformaciones de RDKit. Debe ser un número entero no negativo (mayor o igual que cero). Falla la validación con un error de HTTP 422
para valores negativos.
|
fix_standalone_glycans |
boolean |
false |
Opcional. Habilita la fijación de posición de glicanos independiente. |
flash_attention_implementation |
string |
null |
Opcional. Es la implementación del backend de Flash Attention que se usará. Los valores
permitidos son "triton", "cudnn",
"xla".
|
num_recycles |
integer |
10 |
Opcional. Cantidad de iteraciones de reciclaje que se usarán durante la inferencia. Debe ser un número entero positivo (mayor que cero). Consulta la sección de prácticas recomendadas para obtener información sobre las ventajas y desventajas. |
num_diffusion_samples |
integer |
5 |
Opcional. Es la cantidad de muestras de difusión que se generarán. Debe ser un número entero positivo (mayor que cero). Consulta la sección de prácticas recomendadas para obtener información sobre las ventajas y desventajas. |
save_embeddings |
boolean |
false |
Opcional. Indica si se deben guardar las incorporaciones finales de tronco único y de pares en la ubicación output_dir. Si es true, las incorporaciones se escriben como archivos .npz en una subcarpeta llamada seed-{SEED}_embeddings/ (por ejemplo, outputs_config_job_seed-50_embeddings.npz).
|
save_distogram |
boolean |
false |
Opcional. Indica si se debe guardar el distograma predicho final en la ubicación output_dir. Si es true, las incorporaciones se escriben como archivos .npz en una subcarpeta llamada seed-{SEED}_embeddings/ (por ejemplo, outputs_config_job_seed-50_embeddings.npz).
|
compress_large_output_files |
boolean |
false |
Opcional. Si es true, comprime los archivos de salida grandes (estructuras mmCIF y JSON de confianza) con zstandard. Esto genera archivos con las extensiones .cif.zst y .json.zst en lugar de .cif y .json. Los archivos pequeños (como ranking_scores.csv) permanecen sin comprimir.
|
num_seeds |
integer |
null |
Opcional. Cantidad de semillas aleatorias que se usarán para la inferencia. En general, debes establecer valores iniciales dentro del campo instances.modelSeeds para la reproducibilidad. Consulta la sección de prácticas recomendadas para obtener información sobre las ventajas y desventajas.
|
Respuesta (salida)
En esta sección, se describen los campos que se muestran en la respuesta de la API cuando la ejecución se realiza correctamente.
Cuerpo de la respuesta
Si la ejecución se realiza correctamente, el extremo devuelve la respuesta en el formato estándar del esquema de predicción en línea de Agent Platform:
{
  "deployedModelId": "string",
  "model": "string",
  "modelDisplayName": "string",
  "modelVersionId": "string",
  "predictions": [
    {
      "structure_cif": "string",
      "plddt": [
        number
      ],
      "pae": [
        [
          number
        ]
      ],
      "summary": {
        "ptm": number,
        "iptm": number,
        "fraction_disordered": number,
        "has_clash": boolean,
        "ranking_score": number,
        "chain_pair_pae_min": [
          [
            number
          ]
        ],
        "chain_pair_iptm": [
          [
            number
          ]
        ],
        "chain_ptm": [
          number
        ],
        "chain_iptm": [
          number
        ],
        "chain_ids": [
          string
        ]
      },
      "output_dir": "string"
    }
  ]
}
Campos de respuesta de nivel superior
| Campo | Tipo | Descripción |
|---|---|---|
deployedModelId |
string |
Es el ID del modelo implementado en el extremo de Agent Platform. |
model |
string |
Es el nombre del recurso del modelo completamente calificado. |
modelDisplayName |
string |
Es el nombre visible del modelo implementado (siempre "alphafold3").
|
modelVersionId |
string |
Es el ID de la versión del modelo implementado. |
predictions |
array |
Es la lista de resultados de la predicción. En el caso de AlphaFold 3, este array contiene exactamente un objeto de resultado de predicción. |
Detalles del resultado de la predicción (predictions[])
El extremo de predicción de AlphaFold 3 devuelve una respuesta JSON HTTP 200 que contiene un array predictions con coordenadas estructurales y métricas de confianza para el candidato mejor clasificado. Para obtener definiciones de campo completas y especificaciones de archivos de resultado, consulta la documentación oficial de AlphaFold 3 en GitHub.
Según si se proporciona parameters.output_dir en la solicitud, la estructura de salida en la respuesta de la API puede variar:
Predicción en la respuesta HTTP: La respuesta intercalada devuelve métricas de resumen globales (
summary), coordenadas de estructura 3D (structure_cif), puntuaciones de confianza por átomo (plddt) y la matriz de error alineado predicho en 2D (pae) directamente dentro del cuerpo de la carga útil de la respuesta JSON de HTTP. Cuando se especifica un directorio de salida, los campos de carga útil grandes (structure_cif,plddtypae) se omiten (nulos) de la carga útil de respuesta HTTP para evitar cuellos de botella de serialización. En cambio, todos los resultados sin procesar del modelo se exportan de forma asíncrona al bucket de Cloud Storage especificado.Artefacto guardado en el bucket de Cloud Storage: Cuando se especifica un directorio de salida (
parameters.output_dir), los resultados de la predicción integral se suben a Cloud Storage. La carpeta de salida contiene datos según la especificación publicada en la documentación de AlphaFold 3 en GitHub.
Realizar predicciones
La implementación de Model Garden simplifica la ejecución de la canalización de predicción de extremo a extremo, incluida la canalización de datos y la inferencia del modelo en una sola llamada a la API. En el siguiente diagrama, se muestra la arquitectura de alto nivel de las predicciones de AlphaFold 3:
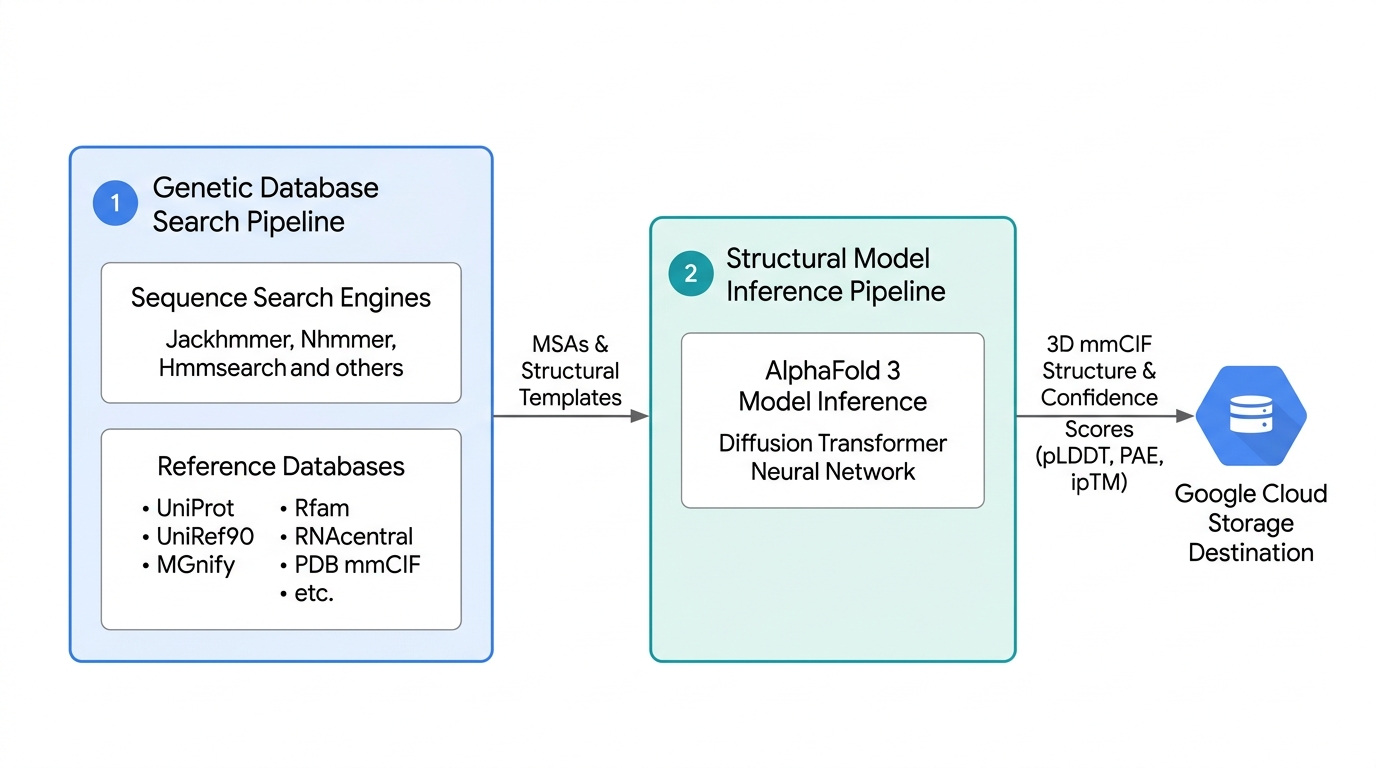
Fig. 1 Canalización de predicción completa
Cuando ejecutes predicciones, se recomienda proporcionar un bucket de Cloud Storage directamente en los parámetros para exportar el conjunto de datos sin procesar completo, incluidos los subdirectorios por muestra, los manifiestos de clasificación y los resultados sin procesar. Para obtener un desglose completo de todos los campos de solicitud configurables, incluido el ajuste de parámetros para el muestreo de múltiples semillas, el reciclado neuronal, las trayectorias de difusión y los enlaces covalentes personalizados, consulta la sección de referencia de la API.
Antes de iniciar trabajos de plegado de larga duración o canalizaciones por lotes, puedes ejecutar una ejecución de prueba para verificar rápidamente tu autenticación, los permisos de IAM y la conectividad de red del extremo.
Opciones de predicción
Según el flujo de trabajo, el procesamiento de AlphaFold 3 se puede organizar en cuatro modos de ejecución distintos:
- Modo de ejecución de prueba
- Modo de predicción de extremo a extremo
- Solo inferencia con MSA y plantillas precalculados
- Ejecución sin MSA ni plantillas
Modo de ejecución de prueba
Para verificar la conectividad de la API, la autenticación, las redes y los esquemas JSON sin iniciar la canalización de predicción, puedes enviar una solicitud con "dry_run":
true en el objeto parameters. El extremo ejecuta todas las rutinas de validación (incluida la verificación de los permisos de escritura del bucket de Cloud Storage y la validación de los caracteres de secuencia), pero omite la ejecución y devuelve de inmediato una respuesta de predicción vacía.
A continuación, se muestra un ejemplo de una secuencia de comandos de Python para el modo de ejecución de prueba:
from google.cloud import aiplatform

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Connect to Dedicated Endpoint
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define prediction payload
instances = [
    {
        "name": "preflight_check",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                }
            }
        ],
    }
]

parameters = {
    "dry_run": True,
}

# Execute prediction request
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)
print(response.predictions)
Modo de predicción de extremo a extremo
Para ejecutar la predicción de extremo a extremo, envía secuencias biológicas sin procesar (proteínas, ADN, ARN, ligandos y modificaciones postraduccionales) en una sola solicitud. El extremo ejecuta automáticamente la búsqueda en la base de datos genética y, luego, la inferencia del modelo. Se recomienda para trabajos de plegado sin alineaciones preexistentes.
A continuación, se muestra un ejemplo de una secuencia de comandos de Python para el modo de predicción de extremo a extremo:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/alphafold_output/"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "e2e_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
Solo inferencia con MSA y plantillas precalculados
Es posible que ya tengas plantillas de MSA y mmCIF precalculadas, ya sea de una ejecución anterior o generadas fuera del extremo del modelo. En esos casos, se puede omitir por completo la búsqueda en la base de datos genética si se proporcionan las alineaciones y las plantillas, y se enruta la solicitud directamente para la predicción de la estructura. Esto también puede reducir significativamente el tiempo de respuesta de la inferencia. Esta es la ruta recomendada en las siguientes situaciones:
- Cuando se acoplan varios ligandos de moléculas pequeñas diferentes a una sola proteína objetivo estática, se pueden reutilizar los MSA.
- Ejecutar la misma secuencia de moléculas en varias semillas aleatorias, de forma iterativa, para mapear la flexibilidad estructural
- Alinea secuencias sin conexión con bases de datos genómicas privadas y no públicas.
- Se optimizaron los recursos de GPU para AlphaFold 3, de modo que se centre solo en la generación de estructuras.
A continuación, se muestra un ejemplo de una secuencia de comandos de Python para el modo de inferencia únicamente:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                    "unpairedMsaPath": "gs://YOUR_BUCKET_NAME/path/to/unpaired.a3m",
                    "pairedMsa": "",
                    "templates": [],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "run_data_pipeline": False,
    "output_dir": STORAGE_OUTPUT_DIR,
    "force_output_dir": True,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
Ejecución sin MSA ni plantillas
También existe la opción de omitir por completo la búsqueda en la base de datos genética y la coincidencia de plantillas. El modelo predice la estructura 3D solo con la secuencia de la consulta, sin secuencias homólogas ni información coevolutiva. Para activar este modo, proporciona cadenas vacías para los parámetros de MSA unpairedMsa y pairedMsa, y una lista vacía para templates en la instancia, y establece run_data_pipeline en false en los parámetros. Esto puede ser útil para el diseño de moléculas sintéticas o diseñadas, o bien para probar predicciones estructurales en ausencia de contexto evolutivo.
A continuación, se muestra un ejemplo de una secuencia de comandos de Python para ejecutar AlphaFold 3 sin MSA ni plantillas:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only_gcs_job"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_only_gcs_job",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1, 2, 3],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "unpairedMsa": "",
                    "pairedMsa": "",
                    "templates": [],
                }
            }
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
    "run_data_pipeline": False,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters,
    timeout=3600.0,
)

print(response.predictions)
Para obtener especificaciones detalladas, parámetros de entidades y métricas de confianza de salida, consulta la documentación de AlphaFold 3 en GitHub.
Resultados de la predicción
El servicio de predicción de AlphaFold 3 proporciona dos mecanismos de entrega complementarios para recuperar los resultados de la predicción. De forma predeterminada, la respuesta de la API devuelve los resultados de la predicción de forma intercalada y síncrona para el candidato mejor clasificado. De manera opcional, puedes especificar un directorio de Cloud Storage.
En la siguiente sección, se proporciona una descripción general del resultado de la predicción. Para obtener más detalles, consulta la documentación de AlphaFold 3 en GitHub.
Comparación entre la respuesta intercalada y los artefactos guardados
El servicio de predicciones de AlphaFold 3 admite dos patrones de salida principales:
- Respuesta intercalada: Devuelve las coordenadas de la estructura 3D y las métricas de confianza solo para el candidato mejor clasificado directamente dentro de la carga útil de la respuesta HTTP REST. Esto es ideal para el prototipado interactivo rápido o las consultas de secuencia única.
- Artefactos guardados (Cloud Storage): Si especificas un directorio de salida, se exportará el conjunto de datos completo de varias muestras a Cloud Storage. Esto incluye archivos de coordenadas individuales, archivos JSON de confianza, distogramas, incorporaciones y métricas de resumen para cada semilla aleatoria y muestra de difusión generadas. Se recomienda usar Cloud Storage para las cargas de trabajo de producción, la asignación de conjuntos conformacionales y la omisión del límite de tamaño de la carga útil de la solicitud.
A continuación, se muestra un ejemplo en Python para recuperar artefactos guardados de Cloud Storage para el análisis posterior:
from google.cloud import storage

BUCKET_NAME = "your-bucket-name"
JOB_NAME = "my_alphafold_job"
STORAGE_PREFIX = f"af3_results/my_folder/{JOB_NAME}"

# Initialize GCS client
client = storage.Client(project="your-project-id")
bucket = client.bucket(BUCKET_NAME)

# Download the top-ranked 3D structure and global ranking ledger
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_model.cif").download_to_filename("model.cif")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_ranking_scores.csv").download_to_filename("ranking_scores.csv")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_summary_confidences.json").download_to_filename("summary.json")
Dado que AlphaFold 3 utiliza un modelo de difusión generativo, cada ejecución de predicción genera un ensamble de estructuras 3D candidatas en diferentes semillas y trayectorias de muestreo. Evaluar y comparar estas ejecuciones candidatas puede ayudar a interpretar los resultados de la predicción antes de realizar un análisis estructural detallado.
Puedes investigar el conjunto de datos completo de artefactos de varias muestras con tres archivos principales:
ranking_scores.csv: Es el libro de contabilidad principal que enumera cada par de trayectorias generadas y suranking_scorecompuesto. Las filas se guardan en el orden de ejecución de la trayectoria (ordenadas de forma ascendente por semilla y, luego, por índice de muestra), no se ordenan previamente por puntuación. Los usuarios deben ordenar los resultados porranking_scoreen orden descendente para identificar los rangos candidatos.summary_confidences.json: Contiene métricas de calidad globales (pTM,ipTM,has_clash,fraction_disordered) para el candidato principal.Per-Sample
summary_confidences.json: Se encuentra dentro de las carpetasseed-{SEED}_sample-{INDEX}/individuales, lo que te permite inspeccionar las matrices de pTM y de ipTM a nivel de la cadena para ejecuciones de candidatos no principales específicos si es necesario.
En el siguiente ejemplo de Python, se analizan ranking_scores.csv y summary_confidences.json para clasificar las muestras candidatas y validar la calidad de las principales candidatas:
import csv
import json

print("=== Candidate Samples Ledger (ranking_scores.csv) ===")
with open("ranking_scores.csv", "r", newline="", encoding="utf-8") as f:
    rows = sorted(
        csv.DictReader(f), key=lambda x: float(x["ranking_score"]), reverse=True
    )

# Calculate column widths cleanly and readably
headers = list(rows[0].keys())
widths = {}
for col in headers:
    lengths = [len(col)] + [len(r[col]) for r in rows]
    widths[col] = max(lengths)

print("  ".join(col.rjust(widths[col]) for col in headers))
for r in rows:
    print("  ".join(r[col].rjust(widths[col]) for col in headers))

top = rows[0]
print(
    f"\nPromoted Top Candidate: Seed {int(top['seed'])}, Sample"
    f" {int(top['sample'])} (Score: {float(top['ranking_score']):.4f})"
)

print("\n=== Top Candidate Quality Validation (summary.json) ===")
with open("summary.json", "r", encoding="utf-8") as f:
    summary = json.load(f)

clash_str = (
    "DETECTED (FAIL)" if summary.get("has_clash") else "None Detected (PASS)"
)
print("Top Candidate Metrics:")
print(f"  • Ranking Score : {summary.get('ranking_score', 'N/A')}")
print(f"  • Global pTM    : {summary.get('ptm', 'N/A')}")
print(f"  • Interface ipTM: {summary.get('iptm', 'N/A')}")
print(f"  • Steric Clash  : {clash_str}")
Para obtener especificaciones exhaustivas del esquema de los archivos guardados y los atributos de mmCIF, consulta la documentación de AlphaFold 3 en GitHub. Además, consulta la guía Cómo evaluar la calidad de las predicciones de AlphaFold 3 en EMBL-EBI para comprender cómo evaluar la calidad de las predicciones.
Prácticas recomendadas
En las siguientes secciones, se describen las prácticas recomendadas para usar AlphaFold 3 en Agent Platform:
Cómo mitigar los tiempos de espera de las solicitudes
Los extremos de Agent Platform aplican un tiempo de espera de ejecución máximo predeterminado de 60 minutos por solicitud. Para asegurarte de que tus predicciones se completen correctamente sin que se agote el tiempo de espera, sigue estos lineamientos:
- Evita el muestreo excesivo en una sola solicitud: Inicializar un amplio rango de semillas o parámetros de difusión inversa excesivamente altos en una sola llamada a la API puede hacer que el tiempo de ejecución supere el límite de 60 minutos.
- Desglosa las exploraciones grandes: Para los estudios a gran escala, divide tus semillas y tus exploraciones de parámetros en varias cargas útiles de predicción más pequeñas y envíalas como trabajos separados. Esto también aprovecha las capacidades de ajuste de escala automático de tu extremo.
Omitir la búsqueda de MSA
La canalización de búsqueda en la base de datos genética es la fase más lenta de la canalización de AlphaFold. Cuando ejecutas predicciones iterativas en la misma secuencia (por ejemplo, cuando ejecutas análisis de detección de ligandos en un objetivo de proteína fijo), puedes optimizar drásticamente los tiempos de ejecución si omites por completo la búsqueda en la base de datos:
- Extrae el MSA: Ejecuta una predicción inicial de extremo a extremo con un directorio de salida de Cloud Storage (
output_dir) especificado. Descarga el archivo{JOB_NAME}_data.jsongenerado del bucket de salida de Cloud Storage. - Envía predicciones solo de inferencia: Ubica los campos
unpairedMsaypairedMsadentro del archivo JSON. Extrae estas cadenas de MSA y pásalas a las solicitudes de predicción posteriores conunpairedMsaPathypairedMsaPathque apunten a URIs de Cloud Storage.
Como alternativa, puedes ejecutar la búsqueda de MSA en tu propia infraestructura y, luego, ingresar las plantillas de MSA precalculadas en la solicitud de predicción.
Cómo controlar las ejecuciones de baja confianza
Cuando los resultados de la predicción arrojan métricas de confianza baja, en lugar de considerarlos como fallas irrecuperables, puedes intentar una corrección segmentada. La optimización de parámetros específicos te permite explorar trayectorias latentes alternativas. En esta sección, se enumeran algunos enfoques para recuperarse en caso de predicciones con un nivel de confianza bajo.
Usa el muestreo con múltiples semillas
AlphaFold 3 inicializa la generación de coordenadas 3D a partir de ruido aleatorio en el espacio latente. Cuando se envía una predicción con una sola semilla determinada, la trayectoria de difusión podría seguir un camino diferente en comparación con otra semilla. Si pasas un array de semillas, se obliga al modelo a muestrear trayectorias a partir de diferentes estados.
El muestreo con múltiples semillas proporciona dos ventajas fundamentales: verifica la coherencia estructural en ejecuciones independientes y sondea la dinámica conformacional funcional. Por ejemplo, si las cinco semillas convergen en coordenadas 3D idénticas, puedes tener una gran confianza en el plegamiento global. Por el contrario, si diferentes semillas producen poses de unión distintas y con un alto nivel de confianza, el ensamble puede revelar estados conformacionales biológicamente significativos, como bucles del sitio activo abiertos o cerrados, o dímeros alternativos con intercambio de dominios.
Expande las trayectorias de difusión
Si bien modelSeeds altera el estado de ruido inicial en el espacio latente, el parámetro num_diffusion_samples (valor predeterminado 5) controla cuántas estructuras 3D candidatas se generan por semilla durante el proceso de difusión inversa. En el caso de las regiones de bucle flexibles o las cavidades de vinculación superficiales, aumentar el muestreo expande el grupo de candidatos para cada segmento inicial. Esto es particularmente eficaz cuando los niveles de confianza locales disminuyen en bucles específicos (pLDDT < 70) mientras que el pliegue del dominio general sigue siendo confiable (pTM > 0.80). Esto puede ayudar a descubrir estructuras candidatas de alta confianza que se habrían pasado por alto en la ejecución inicial.
Aumenta las iteraciones de reciclaje
Antes de que el módulo de difusión genere coordenadas 3D, AlphaFold 3 procesa las características de secuencia y de pares. El parámetro num_recycles indica cuántas veces se retroalimentan de forma iterativa las representaciones de estructura intermedia y las incorporaciones espaciales por pares a través de la red.
Para moléculas grandes y complejas, o bien objetivos con señales coevolutivas débiles, aumentar num_recycles le brinda a la red troncal iteraciones adicionales para resolver las relaciones espaciales entre cadenas distantes antes de pasar las entradas al módulo de difusión. Este enfoque se puede intentar cuando las matrices de PAE fuera de la diagonal muestran una alta incertidumbre entre cadenas (> 15 Å) a pesar de que las cadenas individuales muestran una alta confianza en el plegamiento local (pLDDT > 70). Ten en cuenta que aumentar los reciclajes incrementa de forma lineal el tiempo de ejecución de la predicción, por lo que se debe reservar para los objetivos de interfaz difíciles.
Usa una canalización de alineación personalizada
AlphaFold 3 ejecuta automáticamente la canalización de búsqueda en la base de datos genética para generar plantillas de MSA. Los usuarios también pueden proporcionar alineaciones personalizadas privadas, precalculadas y en formato .a3m con URIs de Cloud Storage a través de unpairedMsaPath y pairedMsaPath. Proporcionar MSA profundos ofrece restricciones coevolutivas sólidas, lo que convierte con frecuencia las predicciones de baja confianza en modelos de alta confianza.