


AlphaFold 3 ist ein Deep-Learning-Modell, das von Google DeepMind und Isomorphic Labs entwickelt wurde. Es wurde entwickelt, um die 3D-Strukturen und Interaktionen von Proteinen, DNA, RNA, Liganden und Ionen vorherzusagen. In diesem Dokument wird beschrieben, wie Sie das AlphaFold 3-Modell mit Model Garden auf der Gemini Enterprise Agent Platform bereitstellen und verwenden.
Hauptmerkmale
Die Bereitstellung von AlphaFold 3 auf der Agent Platform bietet die folgenden Funktionen, die für fortschrittliche Forschungs- und Entwicklungs-Workflows (F&E) und kommerzielle Workflows zur Arzneimittelforschung erforderlich sind:
Kommerzielle Nutzung: AlphaFold 3 in Model Garden ist für die kommerzielle Nutzung verfügbar.
Beliebige benutzerdefinierte Liganden: AlphaFold 3 unterstützt die einheitliche Co-Faltung von Proteinen, DNA und RNA zusammen mit benutzerdefinierten Liganden, die mithilfe von SMILES-Strings oder CIF-CCD-Codes (Chemical Component Dictionary) definiert werden.
Workflow-Flexibilität: AlphaFold 3 in Model Garden unterstützt eine vollständige End-to-End-Faltungspipeline (Kombination aus Datenbanksuche und Modellvorhersage) oder einen reinen Inferenzmodus, in dem Sie vorkonfigurierte MSA-Abgleiche bereitstellen können, um die Ausführungszeit und die GPU-Auslastung zu optimieren.
Hinweise
Beachten Sie bei der Bewertung von AlphaFold 3 für Arbeitslasten die folgenden Einschränkungen:
Nebenläufigkeit: Der AlphaFold 3-Endpunkt hat ein Nebenläufigkeitslimit von einem pro Knoten. Für eine höhere Nebenläufigkeit können Endpunkte auf mehrere Knoten skaliert werden. Wenn eine Vorhersageanfrage gesendet wird, während eine andere Vorhersage aktiv ausgeführt wird, lehnt der Endpunkt die neue Anfrage mit dem Fehler
HTTP 429 Too Many
Requests
ab, wenn die Anzahl der Anfragen die Anzahl der Knoten überschreitet.Tokenlimits: Die maximale Vorhersagedauer für Endpunkte der Agent Platform beträgt 60 Minuten. Aufgrund des variablen MSA-Such-Overheads beträgt die maximale Sequenzgröße, die auf A3-GPUs unterstützt wird, etwa 4.500 biologische Tokens (z. B. Aminosäuren, Nukleotide oder Ligandenatome). Wenn Sie vorberechnete Alignments bereitstellen, wird die MSA-Suche umgangen. Dadurch ist komplexes Folding bis zum Hardwarelimit von etwa 5.400 Tokens möglich.
Nutzlastlimits: Standard-REST-Anfragen für Vorhersagen haben ein Größenlimit von 8 MB. Wenn Sie den Modus „Nur Inferenz“ verwenden, müssen große vorberechnete Alignments (
.a3m-Dateien) über Cloud Storage-URIs referenziert werden, anstatt als Inline-Strings eingebettet zu werden, um eine Ablehnung der Nutzlast zu vermeiden.Netzwerkkonfiguration: Da Vorhersagen Vorgänge mit langer Ausführungszeit sind, die bis zu 60 Minuten dauern können, sollten Sie den Endpunkt nur mit Private Service Connect (PSC) bereitstellen, um die standardmäßigen Zeitlimits für Endpunkte von 10 Minuten zu umgehen.
Anleitung zur Bereitstellung
In diesem Abschnitt wird beschrieben, wie Sie AlphaFold 3 auf einem Endpunkt bereitstellen, der von der Agent Platform in einem Projekt in Google Cloud bereitgestellt wird.
Hinweis
Bevor Sie AlphaFold 3 bereitstellen, müssen Sie Folgendes tun:
- Modellzugriff anfordern
- GPU-Ressourcen beschaffen
- Konfigurieren Sie die erforderlichen IAM-Berechtigungen (Identity and Access Management):
- Erstellen Sie ein Dienstkonto mit der IAM-Rolle Agent Platform Administrator.
- Achten Sie darauf, dass Ihr IAM-Hauptkonto die Rolle
roles/iam.serviceAccountCreatorhat, um beim Bereitstellen des Modells als Dienstkonto zu fungieren.
- Ressourcenkontingente prüfen
Ressourcenanforderungen
AlphaFold 3 erfordert eine a3-highgpu-1g-VM.
Prüfen Sie vor der Bereitstellung, ob Ihr Google Cloud -Projekt in der Zielbereitstellungsregion ein ausreichendes Kontingent für die folgenden Ressourcen hat:
Beschleuniger: Mindestens ein
a3-highgpu-1g-Maschinentyp.Lokale SSD: Die A3-VM wird mit 750 GB lokalem SSD-Speicherplatz bereitgestellt. Dies ist erforderlich, um die Referenzsequenzdatenbanken (UniProt, MGnify, Rfam) dauerhaft im Cache zu speichern, sodass bei genetischen Datenbanksuchen (Jackhmmer/Nhmmer) über alle Vorhersageanfragen hinweg Lesevorgänge mit niedriger Latenz möglich sind.
Cloud Storage-Bucket
AlphaFold 3 benötigt einen Cloud Storage-Bucket, um alle bereitgestellten MSA-Dateien zu speichern und vollständige Vorhersageausgaben zu exportieren. Um regionsübergreifende Übertragungen zu vermeiden, empfehlen wir, entweder einen Cloud Storage-Bucket in derselben Region wie Ihr Endpunkt oder einen multiregionalen Bucket zu verwenden.
Identitäts- und Zugriffsverwaltungsrollen
Konfigurieren Sie die folgenden Rollen für die beteiligten Identitäten:
Modellbereitsteller (auch als IT-Administrator bezeichnet): Die Identität, die das Modell bereitstellt, benötigt die Berechtigung
roles/aiplatform.admin, um Endpunkte zu erstellen und Bereitstellungen zu verwalten.Bereitstellungsidentität: Bei der Inferenz schreiben die AlphaFold 3-Endpunkte Ausgabestrukturen direkt in Cloud Storage. Dazu wird das Dienstkonto des Mandantenprojekts verwendet. Das entsprechende Dienstkonto benötigt die Berechtigung
roles/storage.objectUserfür den Cloud Storage-Ziel-Bucket.Modellnutzer: Für die Konten, die Vorhersagen starten, ist Folgendes erforderlich:
roles/aiplatform.user, um Vorhersageanfragen an den Endpunkt zu senden.roles/storage.objectUser, um auf Vorhersageausgaben im Cloud Storage-Bucket zuzugreifen.
AlphaFold 3 bereitstellen
Stellen Sie AlphaFold 3 programmatisch mit dem Agent Platform SDK entweder als Google Cloud Dedicated-Endpunkt oder nur als Private Service Connect-Endpunkt bereit. Je nach GPU-Verfügbarkeit kann es 10–15 Minuten dauern, bis der Endpunkt für die Inferenz bereit ist.
Das folgende Python-Beispiel-Snippet zeigt, wie das Modell in einem Google Cloud -Projekt bereitgestellt wird, einschließlich einer Verlängerung des Zeitlimits für die Inferenz:
import google.auth
from google.auth.transport.requests import AuthorizedSession
import vertexai
from vertexai import model_garden

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
MODEL_ID = "google/alphafold3@v3_0_4"
MACHINE_TYPE = "a3-highgpu-1g"

vertexai.init(project=PROJECT_ID, location=LOCATION)

# 1. Deploy Model Garden OpenModel to Dedicated Endpoint
af3_model = model_garden.OpenModel(MODEL_ID)
endpoint = af3_model.deploy(
    endpoint_display_name="af3-dedicated-ep",
    model_display_name="af3-on-mg",
    machine_type=MACHINE_TYPE,
    accelerator_type="NVIDIA_H100_80GB",
    accelerator_count=1,
    reservation_affinity_type="ANY_RESERVATION",
    use_dedicated_endpoint=True,
    accept_eula=True,
    min_replica_count=1,
    max_replica_count=1,
    serving_container_deployment_timeout=3600,
)

# 2. Update inference timeout to 3,600 seconds
credentials, _ = google.auth.default(
    scopes=["https://www.googleapis.com/auth/cloud-platform"]
)
session = AuthorizedSession(credentials)
url = f"https://{LOCATION}-aiplatform.googleapis.com/v1/{endpoint.resource_name}:update"
payload = {
    "endpoint": {
        "name": endpoint.resource_name,
        "clientConnectionConfig": {
            "inferenceTimeout": {
                "seconds": 3600
            }
        }
    }
}
response = session.post(url, json=payload)
response.raise_for_status()
print(f"Endpoint Resource Name: {endpoint.resource_name}")
API-Referenz
In diesem Abschnitt werden der Endpunktstandort, das URL-Format, die Pfadparameter und das Schema der Anfragenutzlast beschrieben.
HTTP-Anfrage
POST https://HOST/v1/projects/PROJECT_ID/locations/LOCATION/endpoints/ENDPOINT_ID:predict
Ersetzen Sie Folgendes:
HOST: der Host des Dienstendpunkts. Dies hängt davon ab, ob der Bereitstellungstyp ein dedizierter öffentlicher Endpunkt ist oder Private Service Connect verwendet.PROJECT_ID: die Google Cloud -Projekt-ID, die den bereitgestellten Endpunkt hostet.LOCATION: die Google Cloud -Region, in der der Endpunkt bereitgestellt wird (z. B.us-central1).ENDPOINT_ID: die eindeutige Kennung des bereitgestellten Agent Platform-Endpunkts.
Anfragetext
Der Anfragetext enthält Daten mit folgender JSON-Struktur:
{
  "instances": [
    {
      # The AlphaFold 3 input JSON - see the input documentation at
      # https://github.com/google-deepmind/alphafold3/blob/main/docs/input.md
    }
  ],
  "parameters": {
    "output_dir": "string",
    "dry_run": boolean,
    "run_data_pipeline": boolean,
    "force_output_dir": boolean,
    "resolve_msa_overlaps": boolean,
    "max_template_date": "string",
    "conformer_max_iterations": integer,
    "fix_standalone_glycans": boolean,
    "flash_attention_implementation": "string",
    "num_recycles": integer,
    "num_diffusion_samples": integer,
    "save_embeddings": boolean,
    "save_distogram": boolean,
    "compress_large_output_files": boolean,
    "num_seeds": integer
  }
}
Anfragefelder auf oberster Ebene
| Feld | Typ | Beschreibung |
|---|---|---|
instances |
array |
Erforderlich. Die Liste der biologischen Sequenzkonfigurationen, die vorhergesagt werden sollen. Diese Liste muss genau ein Element enthalten. Wenn Sie null oder mehr als ein Element übergeben, wird ein HTTP 422 Unprocessable
Entity-Fehler ausgegeben. Im Text von instances sollten Eingaben gemäß der Spezifikation in der
AlphaFold 3-Dokumentation angegeben werden.
|
parameters |
object |
Optional. Ein Objekt mit Ausführungsparametern zum Konfigurieren des Vorhersagelaufs (z. B. dry_run, output_dir).
|
Parameter
Konfigurieren Sie Ausführungs-Flags für die AlphaFold 3-Ausführung.
| Feld | Typ | Standardwert | Beschreibung |
|---|---|---|---|
dry_run |
boolean |
false |
Optional. Wenn true, führt die API eine Anfragevalidierung durch, umgeht jedoch die Modellausführung und gibt sofort eine leere Antwort zurück. Nützlich für Verbindungs- und Syntaxprüfungen.
|
run_data_pipeline |
boolean |
true |
Optional. Wenn true, wird die gesamte Pipeline (MSA-Suche und Inferenz) ausgeführt. Wenn false, wird nur die Inferenz ausgeführt (die Datenbanksuche wird übersprungen; erfordert vorab berechnete MSAs). Weitere Informationen finden Sie in der
Dokumentation auf GitHub.
|
output_dir |
string |
null |
Optional. Der Cloud Storage-URI (z. B. gs://bucket/path), in den die vollständigen Rohausgabedateien (einschließlich CIF-Strukturen, PAE und Ranking-CSVs) nach erfolgreicher Ausführung hochgeladen werden.
|
force_output_dir |
boolean |
false |
Optional. Wenn true, können vorhandene Dateien im angegebenen output_dir überschrieben werden. Wenn false, gibt die API sofort einen HTTP 400 Bad Request-Fehler zurück, wenn der Cloud Storage-Pfad nicht leer ist, um versehentlichen Datenverlust zu vermeiden.
|
resolve_msa_overlaps |
boolean |
true |
Optional. Gibt an, ob nicht gekoppelte MSAs mit gekoppelten MSAs dedupliziert werden sollen. Best Practices finden Sie in den Richtlinien in der AlphaFold 3-Dokumentation auf GitHub. |
max_template_date |
string |
null |
Optional. Spätestes Releasedatum der Vorlage, das im Format YYYY-MM-DD berücksichtigt werden soll (z. B. "2024-05-15"). Die Validierung schlägt mit einem HTTP 422-Fehler fehl, wenn die Formatierung falsch ist.
|
conformer_max_iterations |
integer |
null |
Optional. Überschreibung für die maximale Anzahl von Iterationen, die für die RDKit-Konformersuche ausgeführt werden sollen. Muss eine nicht negative Ganzzahl (größer oder gleich null) sein. Die Validierung schlägt bei negativen Werten mit einem HTTP 422-Fehler fehl.
|
fix_standalone_glycans |
boolean |
false |
Optional. Ermöglicht die eigenständige Fixierung der Glykanposition. |
flash_attention_implementation |
string |
null |
Optional. Zu verwendende Flash-Attention-Backend-Implementierung. Zulässige Werte sind "triton", "cudnn", "xla".
|
num_recycles |
integer |
10 |
Optional. Anzahl der Recycling-Iterationen, die während der Inferenz verwendet werden sollen. Muss eine positive Ganzzahl (größer als null) sein. Informationen zu den Vor- und Nachteilen finden Sie im Abschnitt Best Practices. |
num_diffusion_samples |
integer |
5 |
Optional. Anzahl der zu generierenden Diffusionsstichproben. Muss eine positive Ganzzahl (größer als null) sein. Informationen zu den Vor- und Nachteilen finden Sie im Abschnitt Best Practices. |
save_embeddings |
boolean |
false |
Optional. Gibt an, ob die endgültigen Trunk-Einzel- und Paareinbettungen am Speicherort output_dir gespeichert werden sollen. Wenn true, werden Einbettungen als .npz-Dateien in einen Unterordner mit dem Namen seed-{SEED}_embeddings/ geschrieben (z. B. outputs_config_job_seed-50_embeddings.npz).
|
save_distogram |
boolean |
false |
Optional. Gibt an, ob das endgültige vorhergesagte Distogramm am Speicherort output_dir gespeichert werden soll. Wenn true, werden Einbettungen als .npz-Dateien in einen Unterordner mit dem Namen seed-{SEED}_embeddings/ geschrieben (z. B. outputs_config_job_seed-50_embeddings.npz).
|
compress_large_output_files |
boolean |
false |
Optional. Wenn true, werden die großen Ausgabedateien (mmCIF-Strukturen und Konfidenz-JSON) mit zstandard komprimiert. Dadurch werden Dateien mit den Erweiterungen .cif.zst und .json.zst anstelle von .cif und .json ausgegeben. Kleine Dateien (wie ranking_scores.csv) bleiben unkomprimiert.
|
num_seeds |
integer |
null |
Optional. Anzahl der zufälligen Seeds, die für die Inferenz verwendet werden sollen. Im Allgemeinen sollten Sie Seeds im Feld instances.modelSeeds festlegen, um die Reproduzierbarkeit zu gewährleisten. Informationen zu den Vor- und Nachteilen finden Sie im Abschnitt Best Practices.
|
Antwort (Ausgabe)
In diesem Abschnitt werden die Felder beschrieben, die bei erfolgreicher Ausführung in der API-Antwort zurückgegeben werden.
Antworttext
Nach erfolgreicher Ausführung gibt der Endpunkt die Antwort im Standard-Onlinevorhersageschemaformat der Agent Platform zurück:
{
  "deployedModelId": "string",
  "model": "string",
  "modelDisplayName": "string",
  "modelVersionId": "string",
  "predictions": [
    {
      "structure_cif": "string",
      "plddt": [
        number
      ],
      "pae": [
        [
          number
        ]
      ],
      "summary": {
        "ptm": number,
        "iptm": number,
        "fraction_disordered": number,
        "has_clash": boolean,
        "ranking_score": number,
        "chain_pair_pae_min": [
          [
            number
          ]
        ],
        "chain_pair_iptm": [
          [
            number
          ]
        ],
        "chain_ptm": [
          number
        ],
        "chain_iptm": [
          number
        ],
        "chain_ids": [
          string
        ]
      },
      "output_dir": "string"
    }
  ]
}
Antwortfelder der obersten Ebene
| Feld | Typ | Beschreibung |
|---|---|---|
deployedModelId |
string |
Die ID des bereitgestellten Modells auf dem Agent Platform-Endpunkt. |
model |
string |
Der voll qualifizierte Ressourcenname des Modells. |
modelDisplayName |
string |
Der Anzeigename des bereitgestellten Modells (immer "alphafold3").
|
modelVersionId |
string |
Die Versions-ID des bereitgestellten Modells. |
predictions |
array |
Die Liste der Vorhersageergebnisse. Bei AlphaFold 3 enthält dieses Array genau ein Vorhersageergebnisobjekt. |
Details zum Vorhersageergebnis (predictions[])
Der AlphaFold 3-Vorhersageendpunkt gibt eine JSON-Antwort vom Typ HTTP 200 zurück, die ein predictions-Array mit Strukturkoordinaten und Konfidenzwerten für den am besten bewerteten Kandidaten enthält. Umfassende Felddefinitionen und Spezifikationen für Ausgabedateien finden Sie in der offiziellen AlphaFold 3-Dokumentation auf GitHub.
Je nachdem, ob parameters.output_dir in der Anfrage angegeben ist, kann die Ausgabestruktur in der API-Antwort variieren:
Vorhersage in HTTP-Antwort: Die Inline-Antwort gibt globale Zusammenfassungsmesswerte (
summary), 3D-Strukturkoordinaten (structure_cif), Konfidenzwerte pro Atom (plddt) und die 2D-Matrix für den vorhergesagten ausgerichteten Fehler (pae) direkt im HTTP-JSON-Antwortnutzlasttext zurück. Wenn ein Ausgabeverzeichnis angegeben ist, werden große Nutzlastfelder (structure_cif,plddtundpae) in der HTTP-Antwortnutzlast weggelassen (null), um Serialisierungsengpässe zu vermeiden. Stattdessen werden alle Rohmodellausgaben asynchron in den angegebenen Cloud Storage-Bucket exportiert.Gespeichertes Artefakt im Cloud Storage-Bucket: Wenn ein Ausgabeverzeichnis (
parameters.output_dir) angegeben ist, werden die umfassenden Vorhersageergebnisse in Cloud Storage hochgeladen. Der Ausgabeordner enthält Daten gemäß der Spezifikation, die in der AlphaFold 3-Dokumentation auf GitHub veröffentlicht wurde.
Vorhersagen treffen
Die Bereitstellung im Model Garden vereinfacht die Ausführung einer End-to-End-Vorhersagepipeline, einschließlich Datenpipeline und Modellinferenz, in einem einzigen API-Aufruf. Das folgende Diagramm zeigt die allgemeine Architektur von AlphaFold 3-Vorhersagen:
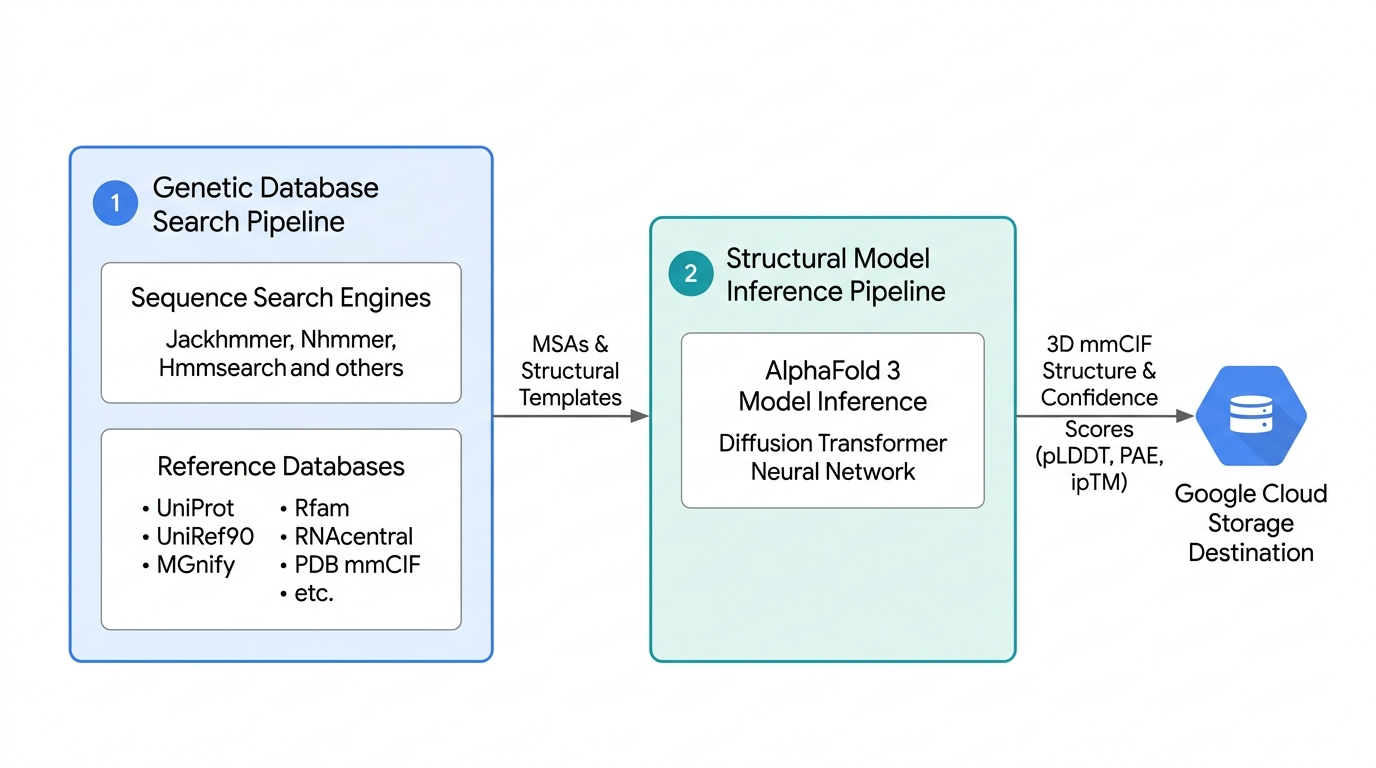
Abb. 1: Vollständige Vorhersagepipeline
Beim Ausführen von Vorhersagen wird dringend empfohlen, einen Cloud Storage-Bucket direkt in den Parametern anzugeben, um das vollständige Roh-Dataset zu exportieren, einschließlich Unterverzeichnissen pro Stichprobe, Ranking-Manifesten und Rohausgaben. Eine vollständige Aufschlüsselung aller konfigurierbaren Anfragefelder, einschließlich der Parameterabstimmung für Multi-Seed-Sampling, neuronales Recycling, Diffusionstrajektorien und benutzerdefinierte kovalente Bindungen, finden Sie im Abschnitt „API-Referenz“.
Bevor Sie lang andauernde Faltungsjobs oder Batch-Pipelines starten, können Sie einen Probelauf ausführen, um Ihre Authentifizierung, IAM-Berechtigungen und die Netzwerkverbindung des Endpunkts schnell zu überprüfen.
Vorhersageoptionen
Je nach Workflow kann die AlphaFold 3-Verarbeitung in vier verschiedene Ausführungsmodi unterteilt werden:
- Probelaufmodus
- End-to-End-Vorhersagemodus
- Nur Inferenz mit vorberechneten MSAs und Vorlagen
- Ohne MSA und Vorlagen ausführen
Probelaufmodus
Wenn Sie die API-Konnektivität, die Authentifizierung, das Netzwerk und die JSON-Schemas prüfen möchten, ohne die Vorhersagepipeline zu starten, können Sie eine Anfrage mit "dry_run":
true im Objekt parameters senden. Der Endpunkt führt alle Validierungsroutinen aus (einschließlich der Prüfung der Schreibberechtigungen für Cloud Storage-Bucket und der Validierung von Sequenzzeichen), überspringt jedoch die Ausführung und gibt sofort eine leere Vorhersageantwort zurück.
Das folgende Python-Beispielskript zeigt den Probelaufmodus:
from google.cloud import aiplatform

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Connect to Dedicated Endpoint
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define prediction payload
instances = [
    {
        "name": "preflight_check",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                }
            }
        ],
    }
]

parameters = {
    "dry_run": True,
}

# Execute prediction request
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)
print(response.predictions)
End-to-End-Vorhersagemodus
Wenn Sie eine End-to-End-Vorhersage ausführen möchten, senden Sie biologische Rohsequenzen (Proteine, DNA, RNA, Liganden und PTMs) in einer einzigen Anfrage. Der Endpunkt führt automatisch eine genetische Datenbanksuche aus, gefolgt von einer Modellinferenz. Dies wird für Faltungsjobs ohne vorhandene Alignments empfohlen.
Hier ein Beispiel für ein Python-Script für den End-to-End-Vorhersagemodus:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/alphafold_output/"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "e2e_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
Nur Inferenz mit vorberechneten MSAs und Vorlagen
Möglicherweise haben Sie bereits vorab berechnete MSAs und mmCIF-Vorlagen, entweder aus einer früheren Ausführung oder außerhalb des Modellendpunkts generiert. In diesen Szenarien kann die Suche in der genetischen Datenbank vollständig umgangen werden, indem die Alignments und Vorlagen bereitgestellt werden. Die Anfrage wird dann direkt zur Strukturvorhersage weitergeleitet. Dadurch kann auch die Inferenzantwortzeit erheblich verkürzt werden. Dies ist in den folgenden Szenarien der empfohlene Pfad:
- Wenn Sie mehrere verschiedene niedermolekulare Liganden an ein einzelnes statisches Proteintarget andocken, können die MSAs wiederverwendet werden.
- Ausführen derselben Molekülsequenz über mehrere zufällige Seeds, iterativ, um die strukturelle Flexibilität abzubilden.
- Sequenzen offline mit privaten, nicht öffentlichen Genomdatenbanken abgleichen.
- Optimierung von GPU-Ressourcen für AlphaFold 3, um sich nur auf die Strukturgenerierung zu konzentrieren.
Das folgende Python-Beispielskript ist für den reinen Inferenzmodus:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                    "unpairedMsaPath": "gs://YOUR_BUCKET_NAME/path/to/unpaired.a3m",
                    "pairedMsa": "",
                    "templates": [],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "run_data_pipeline": False,
    "output_dir": STORAGE_OUTPUT_DIR,
    "force_output_dir": True,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
Ohne MSA und Vorlage ausführen
Es gibt auch die Möglichkeit, die Suche in der genetischen Datenbank und den Vorlagenabgleich vollständig zu umgehen. Das Modell sagt die 3D-Struktur nur anhand der Abfragesequenz vorher, ohne homologe Sequenzen oder koevolutionäre Informationen. Um diesen Modus auszulösen, geben Sie in der Instanz leere Strings für die MSA-Parameter unpairedMsa und pairedMsa und eine leere Liste für templates an und setzen Sie run_data_pipeline in den Parametern auf false. Das kann für das Design synthetischer oder künstlicher Moleküle oder für das Testen von Strukturvorhersagen ohne evolutionären Kontext nützlich sein.
Das folgende Python-Beispielskript zeigt, wie AlphaFold 3 ohne MSA und Vorlagen ausgeführt wird:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only_gcs_job"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_only_gcs_job",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1, 2, 3],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "unpairedMsa": "",
                    "pairedMsa": "",
                    "templates": [],
                }
            }
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
    "run_data_pipeline": False,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters,
    timeout=3600.0,
)

print(response.predictions)
Detaillierte Spezifikationen, Entitätsparameter und Konfidenzmesswerte für die Ausgabe finden Sie in der AlphaFold 3-Dokumentation auf GitHub.
Vorhersageausgaben
Der AlphaFold 3-Vorhersagedienst bietet zwei sich ergänzende Bereitstellungsmechanismen zum Abrufen von Vorhersageausgaben. Standardmäßig werden in der API-Antwort die Vorhersageergebnisse für den am besten bewerteten Kandidaten synchron inline zurückgegeben. Optional können Sie ein Cloud Storage-Verzeichnis angeben.
Im folgenden Abschnitt finden Sie eine Übersicht über die Vorhersageausgabe. Weitere Informationen finden Sie in der AlphaFold 3-Dokumentation auf GitHub.
Inline-Antwort im Vergleich zu gespeicherten Artefakten
Der AlphaFold 3-Vorhersagedienst unterstützt zwei primäre Ausgabemuster:
- Inline-Antwort: Gibt die 3D-Strukturkoordinaten und Konfidenzmesswerte nur für den am besten bewerteten Kandidaten direkt in der HTTP-REST-Antwortnutzlast zurück. Dies ist ideal für schnelles interaktives Prototyping oder Abfragen mit einer einzelnen Sequenz.
- Gespeicherte Artefakte (Cloud Storage): Wenn Sie ein Ausgabeverzeichnis angeben, wird das vollständige Dataset mit mehreren Stichproben in Cloud Storage exportiert. Dazu gehören einzelne Koordinatendateien, Konfidenz-JSONs, Distogramme, Einbettungen und zusammenfassende Messwerte für jeden generierten Zufalls-Seed und jede Diffusionsstichprobe. Die Verwendung von Cloud Storage wird für Produktionsarbeitslasten, die Zuordnung von Konformationsensembles und die Umgehung des Größenlimits für die Anfrage-Nutzlast empfohlen.
Im folgenden Python-Beispiel wird gezeigt, wie Sie gespeicherte Artefakte aus Cloud Storage für die nachgelagerte Analyse abrufen:
from google.cloud import storage

BUCKET_NAME = "your-bucket-name"
JOB_NAME = "my_alphafold_job"
STORAGE_PREFIX = f"af3_results/my_folder/{JOB_NAME}"

# Initialize Cloud Storage client
client = storage.Client(project="your-project-id")
bucket = client.bucket(BUCKET_NAME)

# Download the top-ranked 3D structure and global ranking ledger
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_model.cif").download_to_filename("model.cif")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_ranking_scores.csv").download_to_filename("ranking_scores.csv")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_summary_confidences.json").download_to_filename("summary.json")
Da AlphaFold 3 ein generatives Diffusionsmodell verwendet, wird bei jedem Vorhersagelauf eine Gruppe von 3D-Kandidatenstrukturen über Seeds und Stichproben-Trajektorien hinweg generiert. Die Bewertung und der Vergleich dieser Kandidatenausführungen können bei der Interpretation von Vorhersageausgaben helfen, bevor eine detaillierte Strukturanalyse durchgeführt wird.
Sie können das vollständige Artefakt-Dataset mit mehreren Proben anhand von drei Hauptdateien untersuchen:
ranking_scores.csv: Das Haupt-Ledger, in dem jedes generierte Trajektorienpaar und der zugehörige zusammengesetzteranking_scoreaufgeführt sind. Die Zeilen werden in der Reihenfolge der Trajektorienausführung gespeichert (aufsteigend nach Seed, dann aufsteigend nach Stichprobenindex) und nicht nach Punktzahl vorsortiert. Nutzer sollten nachranking_scoreabsteigend sortieren, um Kandidatenränge zu identifizieren.summary_confidences.json: Enthält globale Qualitätsmesswerte (pTM,ipTM,has_clash,fraction_disordered) für den Top-Kandidaten.Pro Stichprobe
summary_confidences.json: Befindet sich in einzelnenseed-{SEED}_sample-{INDEX}/-Ordnern, sodass Sie bei Bedarf pTM- und ipTM-Matrizen auf Kettenebene für bestimmte Läufe prüfen können, die nicht zu den Top-Kandidaten gehören.
Im folgenden Python-Beispiel werden ranking_scores.csv und summary_confidences.json geparst, um Kandidatenbeispiele zu bewerten und die Qualität der besten Kandidaten zu validieren:
import csv
import json

print("=== Candidate Samples Ledger (ranking_scores.csv) ===")
with open("ranking_scores.csv", "r", newline="", encoding="utf-8") as f:
    rows = sorted(
        csv.DictReader(f), key=lambda x: float(x["ranking_score"]), reverse=True
    )

# Calculate column widths cleanly and readably
headers = list(rows[0].keys())
widths = {}
for col in headers:
    lengths = [len(col)] + [len(r[col]) for r in rows]
    widths[col] = max(lengths)

print("  ".join(col.rjust(widths[col]) for col in headers))
for r in rows:
    print("  ".join(r[col].rjust(widths[col]) for col in headers))

top = rows[0]
print(
    f"\nPromoted Top Candidate: Seed {int(top['seed'])}, Sample"
    f" {int(top['sample'])} (Score: {float(top['ranking_score']):.4f})"
)

print("\n=== Top Candidate Quality Validation (summary.json) ===")
with open("summary.json", "r", encoding="utf-8") as f:
    summary = json.load(f)

clash_str = (
    "DETECTED (FAIL)" if summary.get("has_clash") else "None Detected (PASS)"
)
print("Top Candidate Metrics:")
print(f"  • Ranking Score : {summary.get('ranking_score', 'N/A')}")
print(f"  • Global pTM    : {summary.get('ptm', 'N/A')}")
print(f"  • Interface ipTM: {summary.get('iptm', 'N/A')}")
print(f"  • Steric Clash  : {clash_str}")
Ausführliche Schemaspezifikationen der gespeicherten Dateien und mmCIF-Attribute finden Sie in der AlphaFold 3-Dokumentation auf GitHub. Weitere Informationen zur Bewertung der Qualität von Vorhersagen finden Sie im EMBL-EBI-Leitfaden How to assess the quality of AlphaFold 3 predictions.
Best Practices
In den folgenden Abschnitten werden Best Practices für die Verwendung von AlphaFold 3 auf der Agent Platform beschrieben:
Zeitlimits für Anfragen minimieren
Für Endpunkte auf der Agent Platform gilt ein standardmäßiges maximales Ausführungszeitlimit von 60 Minuten pro Anfrage. Damit Ihre Vorhersagen ohne Zeitüberschreitung erfolgreich abgeschlossen werden, beachten Sie die folgenden Richtlinien:
- Übermäßiges Sampling in einer einzelnen Anfrage vermeiden: Wenn Sie in einem einzelnen API-Aufruf eine große Anzahl von Seeds oder übermäßig hohe Parameter für die umgekehrte Diffusion initialisieren, kann die Ausführungszeit das Limit von 60 Minuten überschreiten.
- Große Sweeps aufteilen: Teilen Sie bei umfangreichen Studien Ihre Seeds und Parameter-Sweeps in mehrere kleinere Vorhersage-Nutzlasten auf und senden Sie sie als separate Jobs. Dabei werden auch die Autoscaling-Kapazitäten Ihres Endpunkts genutzt.
MSA-Suche umgehen
Die Pipeline für die Suche in genetischen Datenbanken ist die zeitaufwendigste Phase der AlphaFold-Pipeline. Wenn Sie iterative Vorhersagen für dieselbe Sequenz ausführen (z. B. Ligandenscreening-Sweeps für ein festes Proteintarget), können Sie die Ausführungszeiten drastisch optimieren, indem Sie die Datenbanksuche vollständig umgehen:
- MSA extrahieren: Führen Sie eine erste End-to-End-Vorhersage mit einem angegebenen Cloud Storage-Ausgabeverzeichnis (
output_dir) aus. Laden Sie die generierte{JOB_NAME}_data.json-Datei aus dem Cloud Storage-Ausgabe-Bucket herunter. - Nur-Inferenz-Vorhersagen senden: Suchen Sie in der JSON-Datei nach den Feldern
unpairedMsaundpairedMsa. Extrahieren Sie diese MSA-Strings und übergeben Sie sie in nachfolgenden Vorhersageanfragen mitunpairedMsaPathundpairedMsaPath, die auf Cloud Storage-URIs verweisen.
Alternativ können Sie die MSA-Suche in Ihrer eigenen Infrastruktur ausführen und die vorberechneten MSA-Vorlagen in die Vorhersageanfrage eingeben.
Ausführungen mit geringer Konfidenz verarbeiten
Wenn die Vorhersageausgaben niedrige Konfidenzmesswerte liefern, können Sie versuchen, eine gezielte Korrektur vorzunehmen, anstatt sie als nicht behebbare Vorhersagefehler zu behandeln. Durch die Optimierung bestimmter Parameter können Sie alternative latente Trajektorien untersuchen. In diesem Abschnitt werden einige Ansätze zur Wiederherstellung bei Vorhersagen mit geringer Konfidenz aufgeführt.
Multi-Seed-Stichprobenerhebung verwenden
AlphaFold 3 initialisiert die Generierung von 3D-Koordinaten aus zufälligem Rauschen im latenten Raum. Wenn eine Vorhersage mit einem bestimmten Seed gesendet wird, kann die Diffusions-Trajektorie einem anderen Pfad folgen als bei einem anderen Seed. Wenn Sie ein Array von Seeds übergeben, wird das Modell gezwungen, Trajektorien aus verschiedenen Zuständen zu ziehen.
Die Multi-Seed-Stichprobenerhebung bietet zwei entscheidende Vorteile: Sie überprüft die strukturelle Konsistenz über unabhängige Ausführungen hinweg und untersucht die funktionale Konformationsdynamik. Wenn beispielsweise alle fünf Seeds zu identischen 3D-Koordinaten konvergieren, können Sie der globalen Faltung ein hohes Maß an Vertrauen entgegenbringen. Wenn hingegen verschiedene Seeds unterschiedliche, hochgradig zuverlässige Bindungsposen erzeugen, kann das Ensemble biologisch bedeutsame Konformationszustände offenbaren, z. B. offene im Vergleich zu geschlossenen aktiven Stellen oder alternative Domänen-getauschte Dimere.
Diffusionstrajektorien maximieren
Während modelSeeds den anfänglichen Rauschzustand im latenten Raum ändert, steuert der Parameter num_diffusion_samples (Standardwert 5), wie viele 3D-Kandidatenstrukturen pro Seed während des umgekehrten Diffusionsprozesses generiert werden. Bei flexiblen Schleifenregionen oder flachen Bindungstaschen wird durch eine Erhöhung der Stichproben der Kandidatenpool für jeden Seed erweitert. Das ist besonders effektiv, wenn die lokalen Konfidenzwerte in bestimmten Schleifen sinken (pLDDT < 70), die Gesamtkonfidenz der Domänenfaltung aber hoch bleibt (pTM > 0,80). So können Sie Kandidatenstrukturen mit hoher Konfidenz finden, die im ersten Durchlauf möglicherweise übersehen wurden.
Recycling-Iterationen erhöhen
Bevor das Diffusionsmodul 3D-Koordinaten generiert, verarbeitet AlphaFold 3 Sequenz- und paarweise Merkmale. Der Parameter num_recycles bestimmt, wie oft Zwischenstruktur-Darstellungen und paarweise räumliche Einbettungen iterativ durch das Netzwerk geleitet werden.
Bei großen, komplexen Molekülen oder Targets mit schwachen koevolutionären Signalen erhält das Trunk-Netzwerk durch Erhöhung von num_recycles zusätzliche Iterationen, um räumliche Beziehungen zwischen weit entfernten Ketten aufzulösen, bevor die Eingaben an das Diffusionsmodul übergeben werden. Dieser Ansatz kann versucht werden, wenn die PAE-Matrizen außerhalb der Diagonale eine hohe Unsicherheit zwischen den Ketten (> 15 Å) aufweisen, obwohl die einzelnen Ketten eine hohe lokale Faltungskonfidenz (pLDDT > 70) aufweisen. Beachten Sie, dass eine Erhöhung der Recycles die Vorhersagelaufzeit linear erhöht. Daher sollte dies nur für schwierige Schnittstellenziele verwendet werden.
Benutzerdefinierte Abgleichspipeline verwenden
AlphaFold 3 führt automatisch die Pipeline für die Suche in genetischen Datenbanken aus, um MSA-Vorlagen zu generieren. Nutzer können auch private, vorab berechnete, benutzerdefinierte Alignments im .a3m-Format mithilfe von Cloud Storage-URIs mit unpairedMsaPath und pairedMsaPath bereitstellen. Die Bereitstellung tiefer MSAs liefert starke koevolutionäre Einschränkungen, wodurch Vorhersagen mit geringer Zuverlässigkeit häufig in Modelle mit hoher Zuverlässigkeit umgewandelt werden.