


トレーニング クラスタは、ノードで自動ヘルスチェックを実行し、チェックが失敗すると介入します。たとえば、致命的な XID エラーを特定すると、ノードをドレインし、影響を受ける Slurm ジョブを再キューイングして、ノードを再作成します。これらの介入はそれぞれ、レジリエンス イベントとしてプロジェクトのログに書き込まれます。
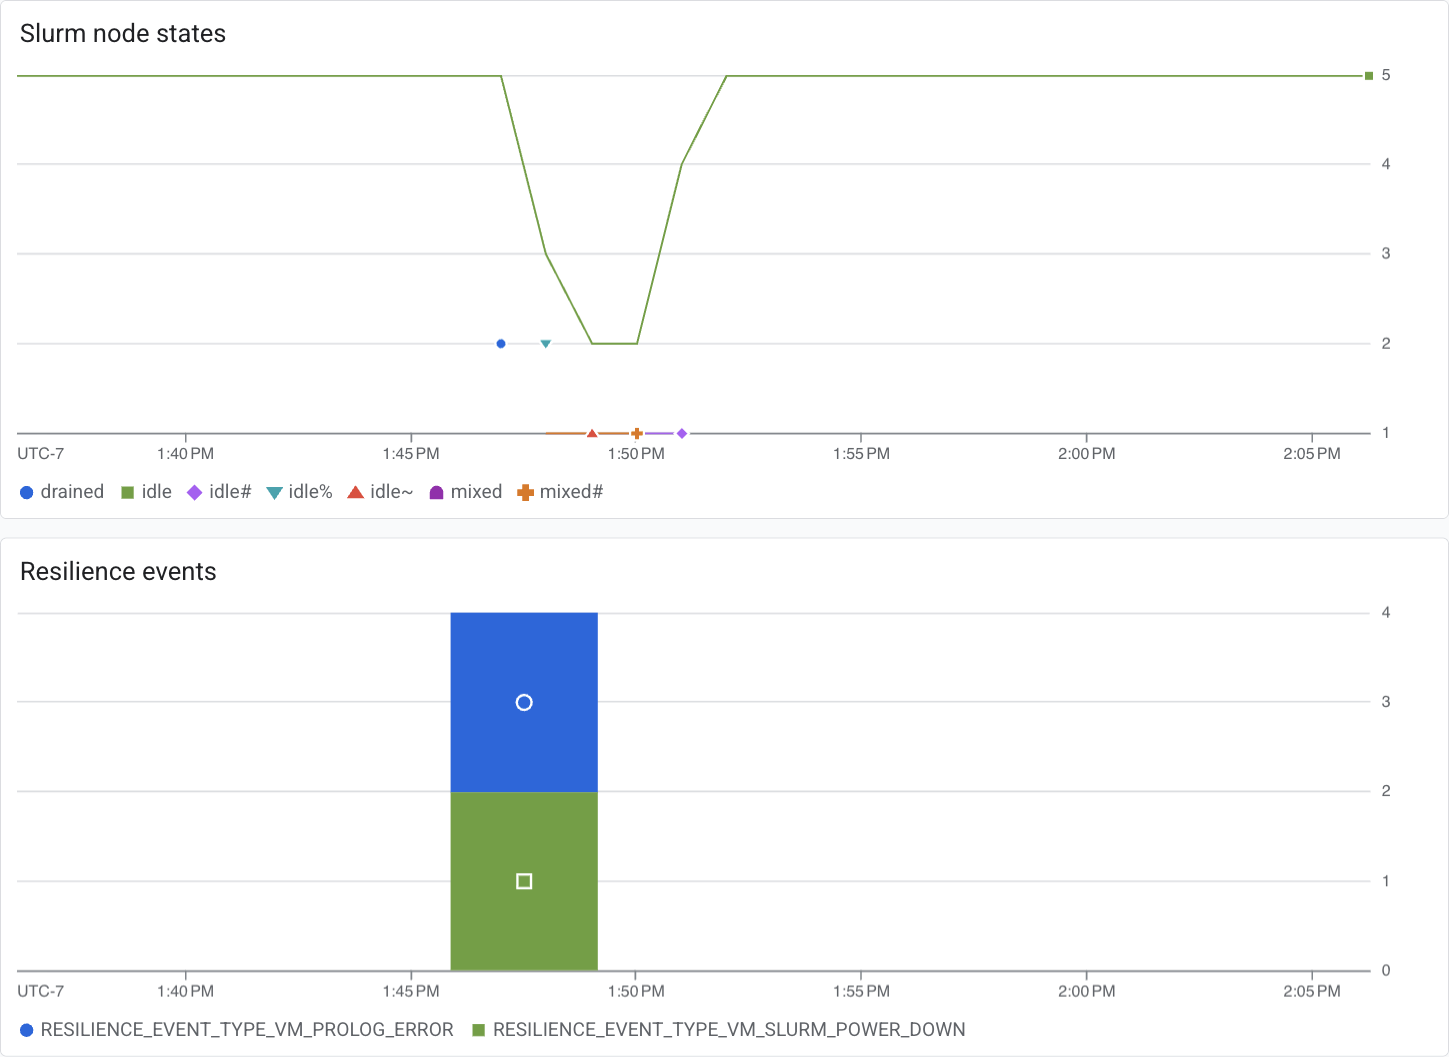
このページでは、コンピューティング ノードの Slurm 状態の横にこれらの復元イベントをグラフ化するカスタム Cloud Monitoring ダッシュボードを作成する方法について説明します。これにより、サービスが実行した復旧アクションと、それらがクラスタの状態とどのように関連しているかを確認できます。ダッシュボードには 2 つのグラフがあります。
- Slurm ノードの状態:
hypercomputecluster.googleapis.com/slurm/node_state指標から取得された、各 Slurm 状態のノード数の経時変化。 - 復元力イベント: 復元力イベントの数。イベントタイプ別に分類され、次のセクションで作成するログベースの指標から取得されます。
始める前に
Google Cloud CLI をインストールして初期化し、トレーニング クラスタを含むプロジェクトを設定します。
gcloud auth login
gcloud config set project PROJECT_ID
PROJECT_ID は、プロジェクトの ID に置き換えます。
必要なロール
ログベースの指標とダッシュボードの作成に必要な権限を取得するには、プロジェクトに対する次の IAM ロールを付与するよう管理者に依頼してください。
-
ログベースの指標を作成する: ログ構成書き込み(
roles/logging.configWriter) -
ダッシュボードを作成する: モニタリング ダッシュボード構成の編集者(
roles/monitoring.dashboardEditor)
ロールの付与については、プロジェクト、フォルダ、組織へのアクセス権の管理をご覧ください。
これらの事前定義ロールには、ログベースの指標とダッシュボードの作成に必要な権限が含まれています。必要とされる正確な権限については、「必要な権限」セクションを開いてご確認ください。
必要な権限
ログベースの指標とダッシュボードを作成するには、次の権限が必要です。
-
ログベースの指標を作成します。
logging.logMetrics.create -
ダッシュボードを作成します。
monitoring.dashboards.create
カスタムロールや他の事前定義ロールを使用して、これらの権限を取得することもできます。
ログベースの指標を作成する
レジリエンス イベントはプロジェクトのログに記録されます。各イベントには、RESILIENCE_EVENT_TYPE_ という接頭辞が付いた event_type ラベルが付けられます。ログ エクスプローラで未加工のイベントを表示するには、次のクエリを使用します。
labels.event_type=~"RESILIENCE_EVENT_TYPE_.*"
Cloud Monitoring ではログエントリを直接グラフ化できないため、まずこのクエリをログベースの指標に変換します。
次の構成を
resilience_metric.yamlという名前のファイルに保存します。name: training_cluster_resilience_events description: "Resilience events on training cluster nodes (VM instances)." filter: 'resource.type="gce_instance" AND labels.event_type=~"RESILIENCE_EVENT_TYPE_.*"' metricDescriptor: metricKind: DELTA valueType: INT64 unit: "1" labels: - key: cluster_id valueType: STRING description: "The ID of the training cluster." - key: event_type valueType: STRING description: "The type of resilience event." - key: slurm_job_name valueType: STRING description: "The name of the Slurm job that triggered the resilience event, if applicable." - key: slurm_job_id valueType: STRING description: "The ID of the Slurm job that triggered the resilience event, if applicable." - key: slurm_job_partition valueType: STRING description: "The partition that the resilience event acts on." labelExtractors: cluster_id: "EXTRACT(labels.cluster_id)" event_type: "EXTRACT(labels.event_type)" slurm_job_name: "EXTRACT(labels.slurm_job_name)" slurm_job_id: "EXTRACT(labels.slurm_job_id)" slurm_job_partition: "EXTRACT(labels.slurm_job_partition)"labelExtractorsフィールドは、各ログエントリのラベルを指標にコピーします。これにより、イベントタイプ、クラスタ、Slurm ジョブごとにグラフを分類できます。指標を作成します。
gcloud logging metrics create training_cluster_resilience_events \
    --config-from-file=resilience_metric.yaml
指標が存在することを確認します。
gcloud logging metrics describe training_cluster_resilience_eventsGoogle Cloud コンソールの [ログベースの指標] ページで指標を確認することもできます。
ダッシュボードを作成する
次の構成を
resilience_dashboard.jsonという名前のファイルに保存します。{ "displayName": "Training Clusters Resilience Dashboard", "mosaicLayout": { "columns": 48, "tiles": [ { "height": 16, "width": 24, "widget": { "title": "Slurm node states", "xyChart": { "chartOptions": { "mode": "COLOR" }, "dataSets": [ { "minAlignmentPeriod": "60s", "plotType": "LINE", "targetAxis": "Y1", "timeSeriesQuery": { "timeSeriesFilter": { "aggregation": { "alignmentPeriod": "60s", "crossSeriesReducer": "REDUCE_SUM", "groupByFields": [ "metric.label.\"state\"" ], "perSeriesAligner": "ALIGN_MEAN" }, "filter": "metric.type=\"hypercomputecluster.googleapis.com/slurm/node_state\" resource.type=\"gce_instance\"" } } } ], "yAxis": { "scale": "LINEAR" } } } }, { "yPos": 16, "height": 16, "width": 24, "widget": { "title": "Resilience events", "xyChart": { "chartOptions": { "mode": "COLOR" }, "dataSets": [ { "minAlignmentPeriod": "60s", "plotType": "STACKED_BAR", "targetAxis": "Y1", "timeSeriesQuery": { "timeSeriesFilter": { "aggregation": { "alignmentPeriod": "60s", "crossSeriesReducer": "REDUCE_COUNT", "groupByFields": [ "metric.label.\"event_type\"" ], "perSeriesAligner": "ALIGN_COUNT" }, "filter": "metric.type=\"logging.googleapis.com/user/training_cluster_resilience_events\" resource.type=\"gce_instance\"" } } } ], "yAxis": { "scale": "LINEAR" } } } } ] } }前のセクションでログベースの指標に別の名前を付けた場合は、一致するように
logging.googleapis.com/user/フィルタを変更します。ダッシュボードを作成します。
gcloud monitoring dashboards create \
    --config-from-file=resilience_dashboard.json
Google Cloud コンソールで [ダッシュボード] ページに移動し、[マイ ダッシュボード] で [トレーニング クラスタの復元力ダッシュボード] を開きます。ダッシュボードが表示されるまでに 1 分ほどかかることがあります。
トラブルシューティング
以降のセクションでは、指標とダッシュボードの作成後に発生する可能性が高い問題について説明します。
[レジリエンス イベント] グラフが空である
ログベースの指標はバックフィルされません。指標の作成後に到着したログエントリのみがカウントされます。ログベースの指標の概要で説明されているように、指標に、Cloud Logging にすでにあるログエントリのデータが遡及的に含まれることはありません。
指標を作成してから復元イベントが発生し、グラフがまだ空の場合は、ログベースの指標を作成するのクエリを実行して、イベントがログ エクスプローラに存在することを確認します。
「Slurm ノードの状態」グラフに一部のクラスタが表示されない
hypercomputecluster.googleapis.com/slurm/node_state 指標は、クラスタ ソフトウェアの最新バージョンを実行しているクラスタによってのみ報告されます。クラスタがグラフに表示されない場合は、クラスタを更新してから、グラフをもう一度確認します。
「Slurm ノードの状態」グラフにログインノードが表示されない
これは予期されたエラーです。ログインノードには idle や mixed などの Slurm 状態がないため、slurm/node_state 指標は報告されません。
「レジリエンス イベント」グラフでイベントが過剰にカウントされる
Cloud Logging は各ログエントリを少なくとも 1 回処理するため、一時的な内部エラーにより、エントリが複数回カウントされることがあります。詳細については、ログベースの指標のトラブルシューティングをご覧ください。
ログエントリ自体が信頼できる情報源です。特定の期間の正確な数を取得するには、グラフから読み取るのではなく、ログ エクスプローラでイベントをクエリします。
次のステップ
- クラスタの復元力の仕組みを学習する
- クラスタの事前構築済みのオブザーバビリティ ダッシュボードを表示する
- Gemini Enterprise Agent Platform でトレーニング ジョブをモニタリングする