


Le routine di inferenza personalizzate ti consentono di creare container personalizzati con codice di pre-elaborazione e post-elaborazione, senza dover gestire i dettagli della configurazione di un server HTTP o della creazione di un container da zero. Puoi utilizzare la pre-elaborazione per normalizzare e trasformare gli input o effettuare chiamate a servizi esterni per ottenere dati aggiuntivi e utilizzare la post-elaborazione per formattare l'inferenza del modello o eseguire la logica di business.
Il seguente diagramma mostra il workflow dell'utente con e senza routine di inferenza personalizzate.
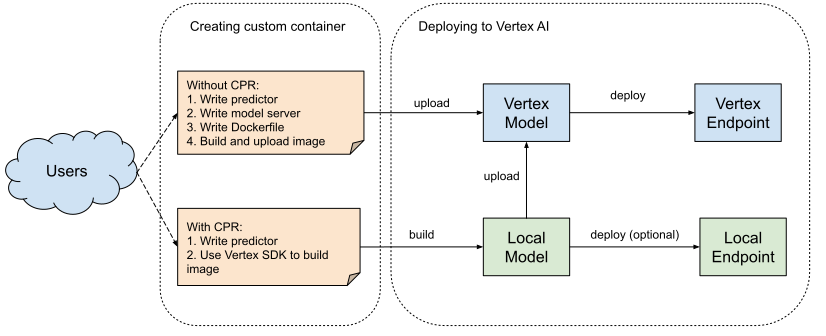
Le differenze principali sono:
Non è necessario scrivere un server di modelli o un Dockerfile. Il server di modelli, ovvero il server HTTP che ospita il modello, è già fornito.
Puoi eseguire il deployment del modello ed eseguirne il debug localmente, velocizzando il ciclo di iterazione durante lo sviluppo.
Crea ed esegui il deployment di un container personalizzato
Questa sezione descrive come utilizzare CPR per creare un container personalizzato con logica di pre-elaborazione e post-elaborazione ed eseguire il deployment sia su un endpoint locale che su un endpoint online.
Configurazione
Devi aver installato l'SDK Agent Platform per Python e Docker nel tuo ambiente.
Scrivi un'interfaccia di inferenza Predictor personalizzata
Implementa l'interfaccia Predictor.
Ad esempio, consulta l'implementazione di Predictor di Sklearn.
Scrivi Handler personalizzato (facoltativo)
I gestori personalizzati hanno accesso all'oggetto della richiesta non elaborato e, pertanto, sono utili nei rari casi in cui è necessario personalizzare la logica relativa al server web, ad esempio per supportare intestazioni di richiesta e intestazioni della risposta aggiuntive o deserializzare richieste di inferenza non formattate in JSON.
Ecco un blocco note di esempio che implementa sia Predictor che Handler.
Anche se non è obbligatorio, per una migliore organizzazione e riusabilità del codice, ti consigliamo di implementare la logica del server web in Handler e la logica ML in Predictor, come mostrato nel gestore predefinito.
Crea un container personalizzato
Inserisci il codice personalizzato e un file requirements.txt aggiuntivo, se devi installare pacchetti nelle immagini, in una directory.
Utilizza l'SDK Agent Platform per Python per creare container personalizzati come segue:
from google.cloud.aiplatform.prediction import LocalModel

# {import your predictor and handler}

local_model = LocalModel.build_cpr_model(
    {PATH_TO_THE_SOURCE_DIR},
    f"{REGION}-docker.pkg.dev/{PROJECT_ID}/{REPOSITORY}/{IMAGE}",
    predictor={PREDICTOR_CLASS},
    handler={HANDLER_CLASS},
    requirements_path={PATH_TO_REQUIREMENTS_TXT},
)
Puoi esaminare la specifica del container per ottenere informazioni utili come l'URI dell'immagine e le variabili di ambiente.
local_model.get_serving_container_spec()
(Facoltativo) Esegui il container in locale
Questo passaggio è obbligatorio solo se vuoi eseguire e testare il container localmente, il che è utile per un'iterazione più rapida. Nell'esempio seguente, esegui il deployment in un endpoint locale e invii una richiesta di inferenza (formato per il corpo della richiesta).
with local_model.deploy_to_local_endpoint(
    artifact_uri={GCS_PATH_TO_MODEL_ARTIFACTS},
    credential_path={PATH_TO_CREDENTIALS},
) as local_endpoint:
    health_check_response = local_endpoint.run_health_check()
    predict_response = local_endpoint.predict(
        request_file={PATH_TO_INPUT_FILE},
        headers={ANY_NEEDED_HEADERS},
    )
Stampa il controllo di integrità e la risposta dell'inferenza.
print(health_check_response, health_check_response.content)
print(predict_response, predict_response.content)
Stampa tutti i log del container.
local_endpoint.print_container_logs(show_all=True)
Carica su Model Registry di Gemini Enterprise Agent Platform
Il modello dovrà accedere agli artefatti del modello (i file dell'addestramento), quindi assicurati di averli caricati su Cloud Storage.
Esegui il push dell'immagine in Artifact Registry.
local_model.push_image()
Quindi, caricalo in Model Registry.
from google.cloud import aiplatform

model = aiplatform.Model.upload(
    local_model=local_model,
    display_name={MODEL_DISPLAY_NAME},
    artifact_uri={GCS_PATH_TO_MODEL_ARTIFACTS},
)
Una volta caricato il modello in Model Registry, può essere utilizzato per ottenere inferenze batch o per eseguire il deployment in un endpoint di Agent Platform per ottenere inferenze online.
Esegui il deployment sull'endpoint Agent Platform
endpoint = model.deploy(machine_type="n1-standard-4")
Una volta eseguito il deployment del modello, puoi ottenere inferenze online.
Esempi di notebook
Gli esempi mostrano i diversi modi in cui puoi eseguire il deployment di un modello con pre-elaborazione e post-elaborazione personalizzate utilizzando Vertex AI Inference.
- Predittore personalizzato con pre-elaborazione e post-elaborazione personalizzate per Sklearn, crea il tuo container con l'SDK Agent Platform per Python.
- Implementa solo il caricamento dei metodi di pre-elaboratore, pre-elaborazione e post-elaborazione serializzati nel Predictor. Eredita il comportamento predefinito di caricamento e previsione del modello da
SklearnPredictordistribuito da Agent Platform.
- Implementa solo il caricamento dei metodi di pre-elaboratore, pre-elaborazione e post-elaborazione serializzati nel Predictor. Eredita il comportamento predefinito di caricamento e previsione del modello da
- Predittore personalizzato, crea il tuo container con l'SDK Agent Platform per Python.
- Implementazione personalizzata dell'intero Predictor.
- Predittore e gestore personalizzati, crea il tuo container con l'SDK Agent Platform per Python.
- Implementazione personalizzata di Predictor e Handler.
- La personalizzazione del gestore consente al server di modelli di gestire gli input CSV.
- Predittore personalizzato, crea il tuo container con l'SDK Agent Platform per Python e PyTorch.
- Implementazione personalizzata del Predictor.
- Immagine esistente, testa l'inferenza localmente ed esegui il deployment dei modelli con l'SDK Agent Platform per Python.
- Utilizza il server di inferenza NVIDIA Triton per i modelli PyTorch.