


L'isolation des charges de travail dans Google Distributed Cloud (GDC) avec isolation physique vous permet de séparer les applications de conteneur et de machine virtuelle (VM) entre les projets et les clusters Kubernetes. La planification des limites de l'environnement vous aide à contrôler les règles d'accès, à limiter l'impact de la maintenance et à optimiser la capacité des nœuds. Vous pouvez adapter ces modèles d'architecture aux exigences spécifiques de chaque univers GDC.
Ce document s'adresse au personnel informatique du groupe d'administrateurs de plate-forme qui gère les ressources de l'organisation et aux développeurs du groupe d'opérateurs d'applications qui gèrent les services. Pour en savoir plus, consultez la documentation sur les audiences pour GDC sous air gap.
Où déployer les charges de travail
Sur la plate-forme GDC, les opérations de déploiement des charges de travail de machines virtuelles (VM) et des charges de travail de conteneurs sont différentes. Le schéma suivant illustre la séparation des charges de travail au sein de la couche du plan de données de votre organisation.
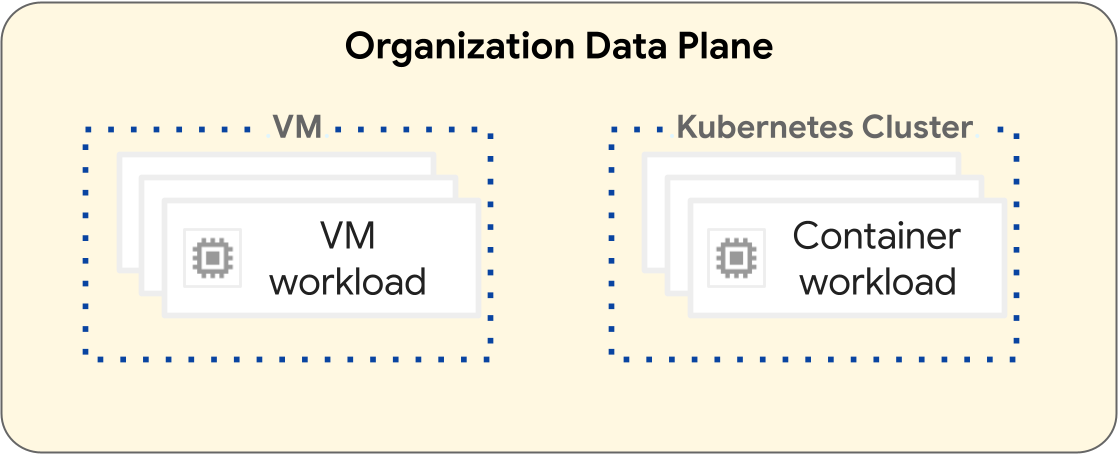
Les charges de travail basées sur des VM s'exécutent dans une VM. À l'inverse, les charges de travail de conteneur s'exécutent dans un cluster Kubernetes. La séparation fondamentale entre les VM et les clusters Kubernetes fournit des limites d'isolation entre vos charges de travail de VM et vos charges de travail de conteneur. Pour en savoir plus, consultez Hiérarchie des ressources.
Les sections suivantes présentent les différences entre chaque type de charge de travail et leur cycle de vie de déploiement.
Charges de travail basées sur des VM
Vous pouvez créer des VM pour héberger vos charges de travail basées sur des VM. Vous disposez de nombreuses options de configuration pour la forme et la taille de votre VM afin de répondre au mieux aux exigences de votre charge de travail basée sur des VM. Vous devez créer une VM dans un projet, qui peut comporter de nombreuses charges de travail de VM. Les VM sont des ressources enfants d'un projet. Pour en savoir plus, consultez la présentation des VM.
Les projets contenant uniquement des charges de travail basées sur des VM ne nécessitent pas de cluster Kubernetes. Par conséquent, vous n'avez pas besoin de provisionner des clusters Kubernetes pour les charges de travail basées sur des VM.
Charges de travail basées sur des conteneurs
Vous pouvez déployer des charges de travail basées sur des conteneurs sur un pod d'un cluster Kubernetes. Un cluster Kubernetes se compose des types de nœuds suivants :
Nœud du plan de contrôle : exécute les services de gestion, tels que la planification, etcd et un serveur d'API.
Nœud de calcul : exécute vos pods et vos applications de conteneur.
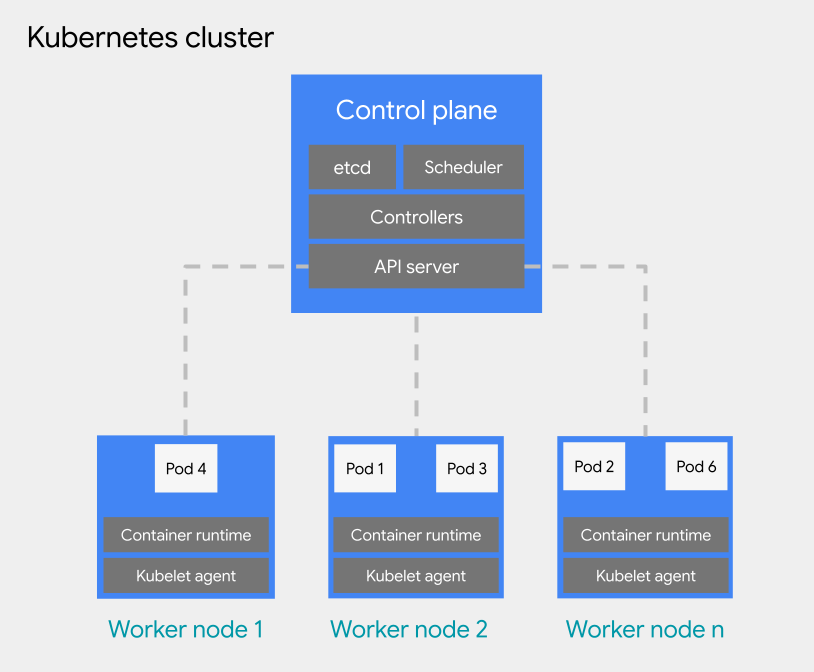
Il existe deux types de configuration pour les clusters Kubernetes :
- Clusters partagés : cluster Kubernetes au niveau de l'organisation qui peut s'étendre sur plusieurs projets et qui n'est pas géré par un seul projet, mais qui leur est associé.
- Clusters standards : cluster Kubernetes à l'échelle du projet qui gère les ressources de cluster d'un projet et ne peut pas s'étendre sur plusieurs projets.
Pour en savoir plus, consultez Configurations de clusters Kubernetes.
Les clusters Kubernetes offrent différentes options de hiérarchie des ressources, car les clusters partagés sont au niveau de l'organisation et les clusters standards sont au niveau du projet. Il s'agit d'une différence fondamentale entre les clusters Kubernetes et les VM. Une VM est une ressource enfant d'un projet et ne peut pas être configurée pour fonctionner en dehors d'un projet. Pour en savoir plus sur la conception de l'infrastructure de votre cluster Kubernetes, consultez Bonnes pratiques pour la conception de clusters Kubernetes.
Pour la planification des pods dans un cluster Kubernetes, GDC adopte les concepts généraux de Kubernetes concernant la planification, la préemption et l'éviction. Les bonnes pratiques de planification des pods au sein d'un cluster varient en fonction des exigences de votre charge de travail.
Pour en savoir plus sur les clusters Kubernetes, consultez la présentation des clusters Kubernetes. Pour en savoir plus sur la gestion de vos conteneurs dans un cluster Kubernetes, consultez Charges de travail de conteneurs dans GDC.
Bonnes pratiques pour concevoir des clusters Kubernetes
Cette section présente les bonnes pratiques pour concevoir des clusters Kubernetes :
- Créer des clusters distincts pour chaque environnement de développement logiciel
- Créer moins de clusters, mais plus grands
- Créer moins de pools de nœuds, mais plus grands, dans un cluster
Tenez compte de chaque bonne pratique pour concevoir un cluster résilient pour le cycle de vie de votre charge de travail de conteneur.
Créer des clusters distincts par environnement de développement logiciel
En plus de projets distincts par environnement de développement logiciel, nous vous recommandons de concevoir des clusters Kubernetes distincts par environnement de développement logiciel. Un environnement de développement logiciel est une zone de votre univers GDC destinée à toutes les opérations correspondant à une phase désignée du cycle de vie. Par exemple, si votre organisation dispose de trois environnements de développement logiciel nommés development, staging et production, vous pouvez créer un ensemble distinct de clusters Kubernetes pour chaque environnement et associer des projets à chaque cluster en fonction de vos besoins.
Nous vous recommandons d'utiliser des clusters standards dans les cycles de vie en préproduction limités à un seul projet. Cela permet d'isoler les processus destructeurs liés aux tests des projets de production, tandis que les clusters partagés sont idéaux pour les environnements de production pouvant s'étendre sur plusieurs projets. Un cluster partagé qui héberge des charges de travail de production s'étendant sur plusieurs projets fournit une zone de déploiement partagée dans laquelle les clusters standards limités à un seul projet peuvent promouvoir leurs charges de travail directement dans l'environnement de production.
Les clusters standards définis pour chaque environnement de développement logiciel supposent que les charges de travail en préproduction d'un environnement de développement logiciel sont limitées à ce cluster. Un cluster Kubernetes peut être subdivisé en plusieurs pools de nœuds ou utiliser des rejets pour l'isolation des charges de travail.
En séparant les clusters Kubernetes par environnement de développement logiciel, vous isolez la consommation des ressources, les règles d'accès, les événements de maintenance et les modifications de configuration au niveau du cluster entre vos charges de travail de production et hors production.
Le schéma suivant illustre un exemple de conception de cluster Kubernetes pour plusieurs charges de travail qui couvrent des projets, des clusters, des environnements de développement logiciel et des classes de machines fournies par différents pools de nœuds.
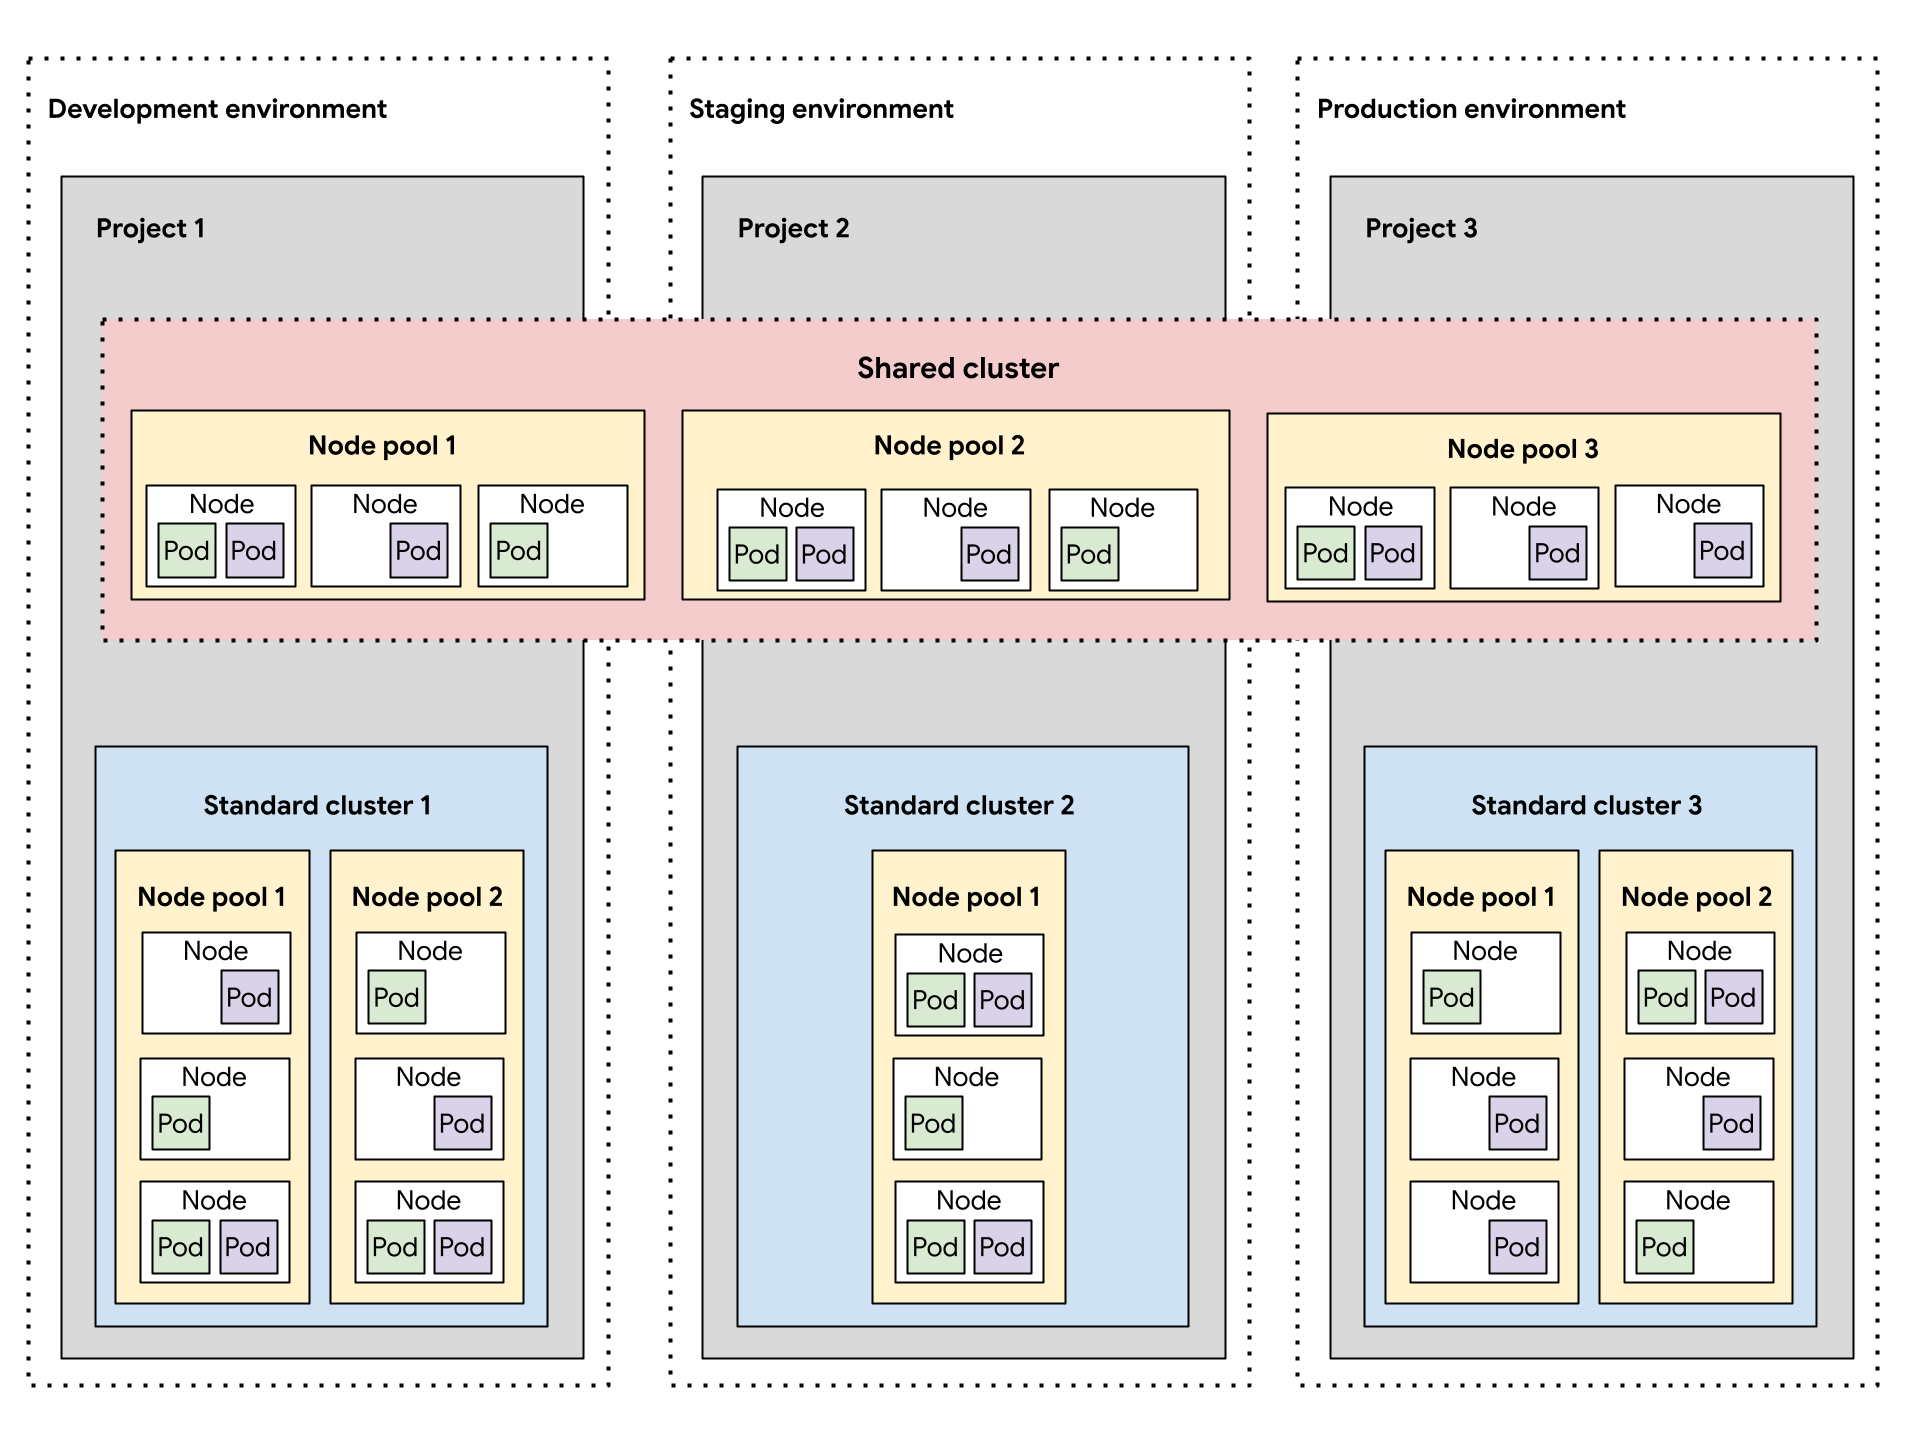
Cet exemple d'architecture suppose que les charges de travail des environnements de développement, de préproduction et de production de logiciels peuvent partager des clusters. Chaque environnement dispose d'un cluster standard distinct, qui est ensuite subdivisé en plusieurs pools de nœuds pour différentes exigences de classe de machine. Le cluster partagé couvre tous les environnements de développement logiciel, fournissant une zone de déploiement commune pour tous les environnements.
Vous pouvez également concevoir plusieurs clusters standards par environnement de développement logiciel, ce qui est utile pour les opérations de conteneur, comme dans les scénarios suivants :
- Certaines de vos charges de travail sont associées à une version spécifique de Kubernetes. Vous gérez donc différents clusters avec différentes versions.
- Certaines de vos charges de travail nécessitent des configurations de cluster différentes, telles que la stratégie de sauvegarde. Vous créez donc plusieurs clusters avec des configurations différentes.
- Vous exécutez des copies d'un cluster en parallèle pour faciliter les mises à niveau de version perturbatrices ou une stratégie de déploiement bleu-vert.
- Vous créez une charge de travail expérimentale qui risque de limiter le serveur d'API ou un autre point de défaillance unique au sein d'un cluster. Vous l'isolez donc des charges de travail existantes.
Vous devez adapter vos environnements de développement logiciel aux exigences définies par vos opérations de conteneur.
Créer moins de clusters
Pour une utilisation efficace des ressources, nous vous recommandons de concevoir le plus petit nombre de clusters Kubernetes répondant à vos exigences de séparation des environnements de développement logiciel et des opérations de conteneur. Chaque cluster supplémentaire entraîne une consommation de ressources supplémentaire, comme des nœuds de plan de contrôle supplémentaires requis. Par conséquent, un cluster plus grand avec de nombreuses charges de travail utilise les ressources de calcul sous-jacentes plus efficacement que de nombreux petits clusters.
Lorsque plusieurs clusters ont des configurations similaires, cela crée une surcharge de maintenance supplémentaire pour surveiller la capacité des clusters et planifier les dépendances entre clusters.
Si un cluster approche de sa capacité maximale, nous vous recommandons d'ajouter des nœuds supplémentaires au cluster plutôt que d'en créer un autre.
Créer moins de pools de nœuds dans un cluster
Pour une utilisation efficace des ressources, nous vous recommandons de concevoir des pools de nœuds plus grands et moins nombreux dans un cluster Kubernetes.
La configuration de plusieurs pools de nœuds est utile lorsque vous devez planifier des pods qui nécessitent une classe de machine différente des autres. Créez un pool de nœuds pour chaque classe de machine requise par vos charges de travail, puis définissez la capacité des nœuds sur l'autoscaling pour permettre une utilisation efficace des ressources de calcul.
Étapes suivantes
- Hiérarchie des ressources
- Créer une application de conteneur hautement disponible
- Créer une application de VM hautement disponible