


Wenn Sie einen Google Distributed Cloud (GDC) Kubernetes-Cluster mit Air Gap erstellen, wird mit der Anzahl und dem Typ der Knoten, die Sie angeben, der erste Knotenpool des Clusters erstellt. Sie können die folgenden Knotenpoolaufgaben für einen vorhandenen Cluster ausführen, wenn sich die Computing-Anforderungen ändern:
Neuen Knotenpool hinzufügen: Fügen Sie neue Knotenpools hinzu, wenn die Nachfrage nach Ihren Clusterarbeitslasten steigt.
Knotenpool ansehen: Sehen Sie sich die Merkmale und den Status Ihrer vorhandenen Knotenpools an.
Größe eines Knotenpools anpassen: Knotenpools manuell hoch- oder herunterskalieren, um sie an Schwankungen des Arbeitslast-Traffics anzupassen.
Knotenpool löschen: Entfernen Sie Knotenpools, wenn die Nachfrage nach Ihren Clusterarbeitslasten sinkt oder Sie Maschinentypen löschen möchten, die für Ihre Containervorgänge nicht mehr sinnvoll sind.
Weitere Informationen zu Knotenpools in einem Cluster finden Sie unter Knoten.
Dieses Dokument richtet sich an Anwendungsentwickler in der Gruppe der Anwendungsoperatoren und IT-Administratoren in der Gruppe der Plattformadministratoren, die für die Verwaltung von Kubernetes-Clustern in ihrer Organisation verantwortlich sind. Weitere Informationen finden Sie unter Dokumentation zu Zielgruppen für GDC mit Air Gap.
Hinweis
Zum Ausführen der Aufgaben in diesem Dokument müssen Sie die erforderlichen Berechtigungen anfordern und Ihre Umgebung vorbereiten.
IAM-Rollen anfordern
Sie benötigen bestimmte Rollen, um die Berechtigungen zu erhalten, die Sie zum Verwalten von Knotenpools in einem Kubernetes-Cluster benötigen. Welche Rollen Sie benötigen, hängt davon ab, ob Sie in einem freigegebenen Cluster auf Organisationsebene oder in einem Standardcluster auf Projektebene arbeiten. Weitere Informationen finden Sie unter Kubernetes-Clusterkonfigurationen.
Freigegebene Clusterrollen
Wenn Sie die Knotenpools eines freigegebenen Clusters erstellen, löschen, bearbeiten oder ansehen möchten, wenden Sie sich an Ihren IAM-Admin der Organisation, um die Rolle User Cluster Admin (user-cluster-admin) anzufordern. Diese Rolle ist nicht an einen Namespace gebunden.
Standardclusterrollen
Wenden Sie sich an Ihren IAM-Projektadministrator, um die folgenden Rollen anzufordern:
Standard-Cluster-Administrator (
standard-cluster-admin): Knotenpools eines Standard-Clusters erstellen, löschen, bearbeiten oder ansehen.Cluster-Entwickler (
cluster-developer): Standardcluster erstellen, löschen, bearbeiten oder ansehen. Diese Rolle ist erforderlich, um die Details des Knotenpools des Clusters in der GDC Console aufzurufen.
Diese Rollen sind an Ihren Projekt-Namespace gebunden.
Umgebung vorbereiten
Wenn Sie Befehle für einen Kubernetes-Cluster über die API ausführen möchten, benötigen Sie die folgenden Ressourcen:
Suchen Sie den Namen des Kubernetes-Clusters oder fragen Sie ein Mitglied der Plattformadministratorgruppe nach dem Clusternamen.
Ersetzen Sie
KUBERNETES_CLUSTER_NAMEin dieser Anleitung durch den Namen des Kubernetes-Clusters.Melden Sie sich an und generieren Sie die kubeconfig-Datei des Management API-Servers für den Kubernetes-Cluster.
Ersetzen Sie
MANAGEMENT_API_SERVERin dieser Anleitung durch den kubeconfig-Pfad des Verwaltungs-API-Servers.
Knotenpool hinzufügen
Führen Sie die folgenden Schritte aus, um einem vorhandenen Kubernetes-Cluster einen Knotenpool hinzuzufügen:
Console
Wählen Sie in der Projektauswahl Ihr Projekt oder Ihre Organisation aus.
Standardcluster sind projektbezogen und freigegebene Cluster sind organisationsbezogen. Wählen Sie den richtigen Bereich aus, um den entsprechenden Kubernetes-Clustertyp aufzurufen.
Wählen Sie im Navigationsmenü Kubernetes Engine > Cluster aus.
Klicken Sie in der Clusterliste auf den Cluster. Die Seite Clusterdetails wird angezeigt.
Wählen Sie Knotenpools > Knotenpool hinzufügen aus.
Weisen Sie dem Knotenpool einen Namen zu. Sie können den Namen nicht mehr ändern, nachdem Sie den Knotenpool erstellt haben.
Geben Sie die Anzahl der Worker-Knoten an, die im Knotenpool erstellt werden sollen.
Wählen Sie die Maschinenklasse aus, die am besten zu Ihren Arbeitslastanforderungen passt. Die Maschinenklassen werden in den folgenden Einstellungen angezeigt:
- Maschinentyp
- vCPU
- Arbeitsspeicher
Klicken Sie auf Speichern.
API
Öffnen Sie die Spezifikation der benutzerdefinierten Ressource
Clustermit derkubectl-Befehlszeile im interaktiven Editor:kubectl edit clusters.cluster.gdc.goog/KUBERNETES_CLUSTER_NAME \ -n KUBERNETES_CLUSTER_NAMESPACE \ --kubeconfig MANAGEMENT_API_SERVERErsetzen Sie Folgendes:
KUBERNETES_CLUSTER_NAME: der Name des Clusters.KUBERNETES_CLUSTER_NAMESPACE: der Namespace des Clusters. Verwenden Sie für freigegebene Cluster den Namespaceplatform. Verwenden Sie für Standardcluster den Projekt-Namespace des Clusters.MANAGEMENT_API_SERVER: der kubeconfig-Pfad des zonalen API-Servers, auf dem der Kubernetes-Cluster gehostet wird.
Fügen Sie im Abschnitt
nodePoolseinen neuen Eintrag hinzu:nodePools: # Several lines of code are omitted here. - machineTypeName: MACHINE_TYPE name: NODE_POOL_NAME nodeCount: NUMBER_OF_WORKER_NODES taints: TAINTS labels: LABELS acceleratorOptions: gpuPartitionScheme: GPU_PARTITION_SCHEMEErsetzen Sie Folgendes:
MACHINE_TYPE: der Maschinentyp für die Worker-Knoten des Knotenpools. Sehen Sie sich die verfügbaren Maschinentypen an, um zu erfahren, was konfiguriert werden kann.NODE_POOL_NAMEist der Name des Knotenpools.NUMBER_OF_WORKER_NODES: die Anzahl der Worker-Knoten, die im Knotenpool bereitgestellt werden sollen.TAINTS: Die Markierungen, die auf die Knoten dieses Knotenpools angewendet werden sollen. Dieses Feld ist optional.LABELS: die Labels, die auf die Knoten dieses Knotenpools angewendet werden sollen. Sie enthält eine Liste von Schlüssel/Wert-Paaren. Dieses Feld ist optional.GPU_PARTITION_SCHEME: das GPU-Partitionierungsschema, wenn Sie GPU-Arbeitslasten ausführen. Beispiel:mixed-2. Die GPU wird nicht partitioniert, wenn dieses Feld nicht festgelegt ist. Informationen zu verfügbaren MIG-Profilen (Multi-Instanz-GPU) finden Sie unter Unterstützte MIG-Profile.
Speichern Sie die Datei und beenden Sie den Editor.
Knotenpools ansehen
Führen Sie die folgenden Schritte aus, um vorhandene Knotenpools in einem Kubernetes-Cluster aufzurufen:
Console
Wählen Sie in der Projektauswahl Ihr Projekt oder Ihre Organisation aus.
Standardcluster sind projektbezogen und freigegebene Cluster sind organisationsbezogen. Wählen Sie den richtigen Bereich aus, um den entsprechenden Kubernetes-Clustertyp aufzurufen.
Wählen Sie im Navigationsmenü Kubernetes Engine > Cluster aus.
Klicken Sie in der Clusterliste auf den Cluster. Die Seite Clusterdetails wird angezeigt.
Wählen Sie Knotenpools aus.
Die Liste der im Cluster ausgeführten Knotenpools wird angezeigt. Auf dieser Seite können Sie die Knotenpools des Clusters verwalten.
API
Rufen Sie die Knotenpools eines bestimmten Kubernetes-Clusters auf:
kubectl get clusters.cluster.gdc.goog/KUBERNETES_CLUSTER_NAME \
    -n KUBERNETES_CLUSTER_NAMESPACE \
    -o json --kubeconfig MANAGEMENT_API_SERVER | \
    jq .status.workerNodePoolStatuses
Ersetzen Sie Folgendes:
KUBERNETES_CLUSTER_NAME: der Name des Clusters.KUBERNETES_CLUSTER_NAMESPACE: der Namespace des Clusters. Verwenden Sie für freigegebene Cluster den Namespaceplatform. Verwenden Sie für Standardcluster den Projekt-Namespace des Clusters.
Die Ausgabe sieht etwa so aus:
[
  {
    "conditions": [
      {
        "lastTransitionTime": "2023-08-31T22:16:17Z",
        "message": "",
        "observedGeneration": 2,
        "reason": "NodepoolReady",
        "status": "True",
        "type": "Ready"
      },
      {
        "lastTransitionTime": "2023-08-31T22:16:17Z",
        "message": "",
        "observedGeneration": 2,
        "reason": "ReconciliationCompleted",
        "status": "False",
        "type": "Reconciling"
      }
    ],
    "name": "worker-node-pool",
    "readyNodes": 3,
    "readyTimestamp": "2023-08-31T18:59:46Z",
    "reconcilingNodes": 0,
    "stalledNodes": 0,
    "unknownNodes": 0
  }
]
Größe von Knotenpools anpassen
Sie können die Größe von Knotenpools in einem Kubernetes-Cluster manuell anpassen, indem Sie den Pool hoch- oder herunterskalieren. Sie können beim Herunterskalieren eines Knotenpools keinen bestimmten Knoten zum Entfernen auswählen.
So skalieren Sie einen Knotenpool in einem vorhandenen Cluster:
Console
Wählen Sie in der Projektauswahl Ihr Projekt oder Ihre Organisation aus.
Standardcluster sind projektbezogen und freigegebene Cluster sind organisationsbezogen. Wählen Sie den richtigen Bereich aus, um den entsprechenden Kubernetes-Clustertyp aufzurufen.
Wählen Sie im Dashboard das Projekt aus, in dem sich der Cluster befindet, den Sie bearbeiten möchten.
Wählen Sie im Navigationsmenü Kubernetes Engine > Cluster aus.
Wählen Sie den Clusternamen aus, mit dem der Knotenpool verknüpft ist. Die Seite Clusterdetails wird angezeigt.
Klicken Sie auf den Tab Knotenpools.
Wählen Sie das Symbol edit Bearbeiten für den Knotenpool aus, dessen Größe Sie anpassen möchten. Die Eingabeaufforderung Knotenpool bearbeiten wird angezeigt.
Aktualisieren Sie das Feld Anzahl der Knoten, um die neue Anzahl von Knoten im Knotenpool anzugeben. Sie können die Anzahl der Knoten erhöhen oder verringern, um sie an die Anforderungen Ihrer Arbeitslast anzupassen.
Klicken Sie auf Speichern.
Kehren Sie zum Tab Knotenpools für Ihren Cluster zurück und prüfen Sie, ob der Knotenpool mit der angepassten Größe den Status
Readyund die richtige Anzahl von Knoten hat. Es kann einige Minuten dauern, bis der Knotenpool gemäß Ihren Vorgaben skaliert ist.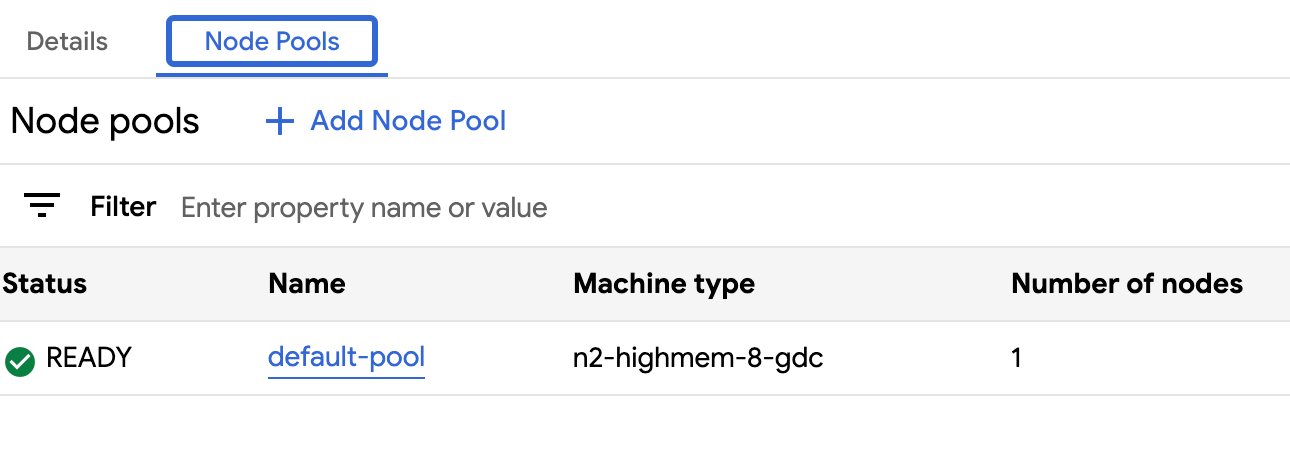
API
Öffnen Sie die Spezifikation der benutzerdefinierten Ressource
Clustermit der kubectl-Befehlszeile im interaktiven Editor:kubectl edit clusters.cluster.gdc.goog/KUBERNETES_CLUSTER_NAME \ -n KUBERNETES_CLUSTER_NAMESPACE \ --kubeconfig MANAGEMENT_API_SERVERErsetzen Sie Folgendes:
KUBERNETES_CLUSTER_NAME: der Name des Clusters, der den Knotenpool hostet.KUBERNETES_CLUSTER_NAMESPACE: der Namespace des Clusters. Verwenden Sie für freigegebene Cluster den Namespaceplatform. Verwenden Sie für Standardcluster den Projekt-Namespace des Clusters.MANAGEMENT_API_SERVER: der kubeconfig-Pfad des zonalen API-Servers, auf dem der Kubernetes-Cluster gehostet wird.
Aktualisieren Sie das Feld
nodeCountfür den Knotenpool, dessen Größe geändert werden soll:nodePools: # Several lines of code are omitted here. - machineTypeName: n2-standard-2-gdc name: nodepool-1 nodeCount: NUMBER_OF_WORKER_NODESErsetzen Sie
NUMBER_OF_WORKER_NODESdurch die aktualisierte Anzahl von Worker-Knoten, die im Knotenpool bereitgestellt werden sollen.Speichern Sie die Datei und beenden Sie den Editor.
Prüfen Sie, ob die Knotenskalierung abgeschlossen ist, indem Sie die Konfiguration des Knotenpools prüfen:
kubectl get clusters.cluster.gdc.goog/KUBERNETES_CLUSTER_NAME \
    -n KUBERNETES_CLUSTER_NAMESPACE -o json \
    --kubeconfig MANAGEMENT_API_SERVER | jq .status.workerNodePoolStatuses
Prüfen Sie, ob die Zahl
readyNodesder Anzahl der Knoten entspricht, die Sie für den Knotenpool festgelegt haben. Es kann einige Minuten dauern, bis der Knotenpool gemäß Ihren Vorgaben skaliert ist.
Knotenpool löschen
Durch das Löschen eines Knotenpools werden dessen Knoten und Routen gelöscht. Auf diesen Knoten werden alle ausgeführten Pods entfernt und neu geplant. Wenn die Pods spezifische Knotenauswahlen haben, bleiben die Pods womöglich in einem nicht-planbaren Zustand, wenn kein anderer Knoten im Cluster die Kriterien erfüllt.
Sie benötigen mindestens drei Worker-Knoten, bevor Sie einen Knotenpool löschen, damit Ihr Cluster genügend Rechenkapazität hat, um effektiv zu funktionieren.
Führen Sie die folgenden Schritte aus, um einen Knotenpool zu löschen:
Console
Wählen Sie in der Projektauswahl Ihr Projekt oder Ihre Organisation aus.
Standardcluster sind projektbezogen und freigegebene Cluster sind organisationsbezogen. Wählen Sie den richtigen Bereich aus, um den entsprechenden Kubernetes-Clustertyp aufzurufen.
Wählen Sie im Navigationsmenü Kubernetes Engine > Cluster aus.
Klicken Sie auf den Cluster, der den Knotenpool hostet, den Sie löschen möchten.
Wählen Sie Knotenpools aus.
Klicken Sie neben dem Knotenpool, den Sie löschen möchten, auf delete Löschen.
API
Öffnen Sie die Spezifikation der benutzerdefinierten Ressource
Clustermit der kubectl-Befehlszeile im interaktiven Editor:kubectl edit clusters.cluster.gdc.goog/KUBERNETES_CLUSTER_NAME \ -n KUBERNETES_CLUSTER_NAMESPACE \ --kubeconfig MANAGEMENT_API_SERVERErsetzen Sie Folgendes:
KUBERNETES_CLUSTER_NAME: der Name des Clusters.KUBERNETES_CLUSTER_NAMESPACE: der Namespace des Clusters. Verwenden Sie für freigegebene Cluster den Namespaceplatform. Verwenden Sie für Standardcluster den Projekt-Namespace des Clusters.MANAGEMENT_API_SERVER: der kubeconfig-Pfad des zonalen API-Servers, auf dem der Kubernetes-Cluster gehostet wird.
Entfernen Sie den Knotenpooleintrag aus dem Abschnitt
nodePools. Im folgenden Snippet müssen Sie beispielsweise die FeldermachineTypeName,nameundnodeCountentfernen:nodePools: # Several lines of code are omitted here. - machineTypeName: n2-standard-2-gdc name: nodepool-1 nodeCount: 3Entfernen Sie alle Felder für den Knotenpool, den Sie löschen.
Speichern Sie die Datei und beenden Sie den Editor.