


광학 문자 인식 (OCR)은 Google Distributed Cloud (GDC) 에어 갭의 사전 학습된 Vertex AI API로, 이미지, 문서, 필기 메모를 포함한 지원되는 파일 형식에서 텍스트를 감지하고 추출할 수 있습니다. 텍스트 추출을 위한 인라인 요청을 처리하거나 지원되는 언어로 버킷에 저장된 파일에 대해 비동기 일괄 작업을 실행할 수 있습니다.
광학 문자 인식 방법
OCR은 Distributed Cloud에서 텍스트를 인식하는 데 사용할 수 있는 다음 메서드를 제공합니다.
| 메서드 | 설명 |
|---|---|
BatchAnnotateImages |
인라인 요청에 제공된 JPEG 또는 PNG 이미지 배치에서 텍스트를 인식합니다. |
BatchAnnotateFiles |
인라인 요청에 제공된 PDF 또는 TIFF 파일 배치에서 텍스트를 인식합니다. |
AsyncBatchAnnotateFiles |
오프라인 요청을 위해 스토리지 버킷에 있는 PDF 또는 TIFF 파일 배치에서 텍스트를 인식합니다. |
광학 문자 인식 기능
OCR API는 이미지에서 텍스트를 인식하고 추출할 수 있습니다. 다음 두 주석 기능은 광학 문자 인식을 지원합니다.
TEXT_DETECTION은 임의의 이미지에서 텍스트를 감지하고 추출합니다. 예를 들어 사진에 거리 또는 교통 표지판이 포함될 수 있습니다. OCR 서비스는 추출된 문자열, 개별 단어, 경계 상자가 포함된 JSON 파일을 반환합니다.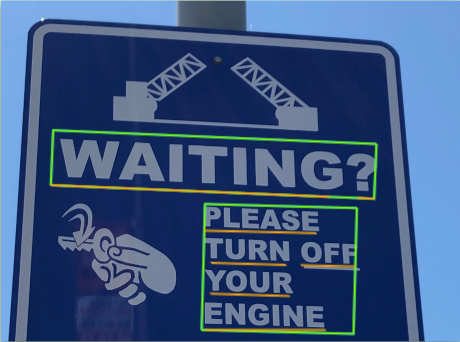
그림 1. OCR API가 단어와 경계 상자를 감지하는 도로 표지판 사진
DOCUMENT_TEXT_DETECTION도 이미지에서 텍스트를 추출하지만, 이 서비스는 밀집 텍스트와 문서에 맞게 응답을 최적화합니다. 예를 들어 입력된 텍스트의 스캔 이미지에는 여러 단락과 제목이 포함될 수 있습니다. OCR 서비스는 페이지, 블록, 단락, 단어, 줄바꿈 정보가 포함된 JSON 파일을 반환합니다.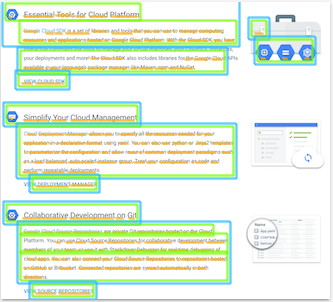
그림 2. OCR API가 단어, 페이지, 단락과 같은 정보를 감지하는 입력된 텍스트의 스캔 이미지
필기 입력 텍스트
그림 3은 필기 입력 텍스트의 이미지입니다. OCR API는 이러한 이미지에서 텍스트를 감지하고 추출합니다. 필기 인식을 지원하는 필기 스크립트 목록은 필기 스크립트를 참조하세요.
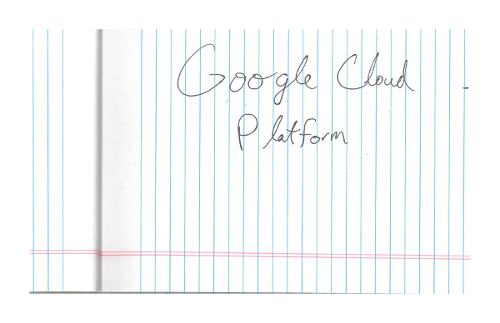
그림 3. OCR API가 텍스트를 감지하는 필기 입력 이미지
광학 문자 인식 한도
BatchAnnotateImages 및 BatchAnnotateFiles API 메서드는 일괄 호출당 단일 요청만 지원합니다.
다음 표에는 Distributed Cloud의 OCR 서비스에 대한 현재 한도가 나와 있습니다.
| OCR 파일 한도 | 값 |
|---|---|
| 최대 페이지 수 | 5개 |
| 최대 파일 크기 | 20MB |
| 최대 이미지 크기 | 2,000만 픽셀 (길이x너비) |
최대 페이지 수 또는 최대 파일 크기를 초과하는 OCR API에 제출된 파일은 오류를 반환합니다. 제출된 파일이 최대 이미지 크기를 초과하면 2,000만 픽셀로 축소됩니다.
OCR에 지원되는 파일 형식
OCR 선행 학습된 API는 다음 파일 형식에서 텍스트를 감지하고 스크립트를 작성합니다.
- TIFF
- JPG
- PNG
Distributed Cloud 환경에 파일을 로컬로 저장해야 합니다. Cloud Storage에 호스팅된 파일이나 공개적으로 사용 가능한 파일에 액세스하여 텍스트를 인식할 수 없습니다.