


問題描述
在實體隔離環境中運作的組織面臨重大挑戰:他們需要大型語言模型,但基於嚴格的安全通訊協定,嚴禁連線至外部雲端式 API。為解決這個問題,這些客戶需要一個強大、獨立的生態系統,能直接在 Google Distributed Cloud (GDC) 實體隔離基礎架構上,託管及管理開放權重模型。這種本地化部署方式對於維護絕對資料主權至關重要,可確保私密資訊不會離開實體場所。將安全執行環境與服務後端整合,使用者就能使用進階 AI 功能,同時保有資料、模型權重和內部資安態勢的完整管理控制權。
雖然 Gemini on GDC 提供強大的代管前沿功能,但客戶通常會部署 Gemma 4 或 Llama 4 等開放權重模型,以獲得更精細的控管能力。在實體隔離的 GDC 環境中部署開放權重模型,成本明顯低於代管專屬服務。組織擁有模型權重後,就不必支付週期性每詞元 API 費用,這筆費用對於高用量、自動化的工作負載來說,可能會成為一筆不小的開銷。此外,開放權重模型可進行量化 (例如 4 位元或 8 位元),在邊緣端較小、較便宜的硬體上執行高效能推論。這種垂直最佳化,加上能跨多個內部應用程式共用基礎架構,不需額外授權費用,可大幅降低持續、大規模推論作業的總持有成本 (TCO)。
解決方案提案
本文件說明參考架構,用於在 Google Distributed Cloud (GDC) 實體隔離環境中,部署及管理開放權重大型語言模型 (LLM)。許多客戶 (尤其是高度受管制的產業) 由於嚴格的資料主權和安全性要求,無法使用雲端式 LLM API。這項架構可滿足在本機安全 GDC 執行個體中,執行強大 LLM 的需求。
內容:這個架構涵蓋使用 vLLM 或 Ollama 服務後端,部署開放權重模型 (例如 Gemma 4、Llama、DeepSeek、Mistral)。包括使用 Kubernetes 進行自動化調度管理、Harbor 儲存構件、永久磁碟區儲存模型權重、網路政策 (NetworkPolicy / ProjectNetworkPolicy) 確保網路安全,以及 Open WebUI 做為選用的瀏覽器前端。
不包含的內容:這個架構不涵蓋代管 AI Gateway 服務、Google 的 Gemini 模型等專屬模型、模型微調程序,或其他模態的生成式 AI 模型 (例如圖像生成)。
目標對象:本文件主要適用於負責在 GDC 部署及管理服務的平台管理員,以及在實體隔離環境中設計 AI 解決方案的技術架構師。與已部署模型互動的使用者和開發人員,則是次要目標對象,他們可透過瞭解基礎結構而受益。
架構
這項解決方案會部署 vLLM、Ollama 或兩者,做為標準叢集中的容器化推論服務後端 (Deployment)。模型權重會儲存在永久磁碟區,並透過模型載入器 Pod 從工作站填入。LoadBalancer 類型的 Kubernetes Service 會公開後端 API,NetworkPolicy / ProjectNetworkPolicy 物件則會保護這些 API 的存取權,而 Open WebUI 可視需要部署為 OpenAI 相容 API 的瀏覽器前端。
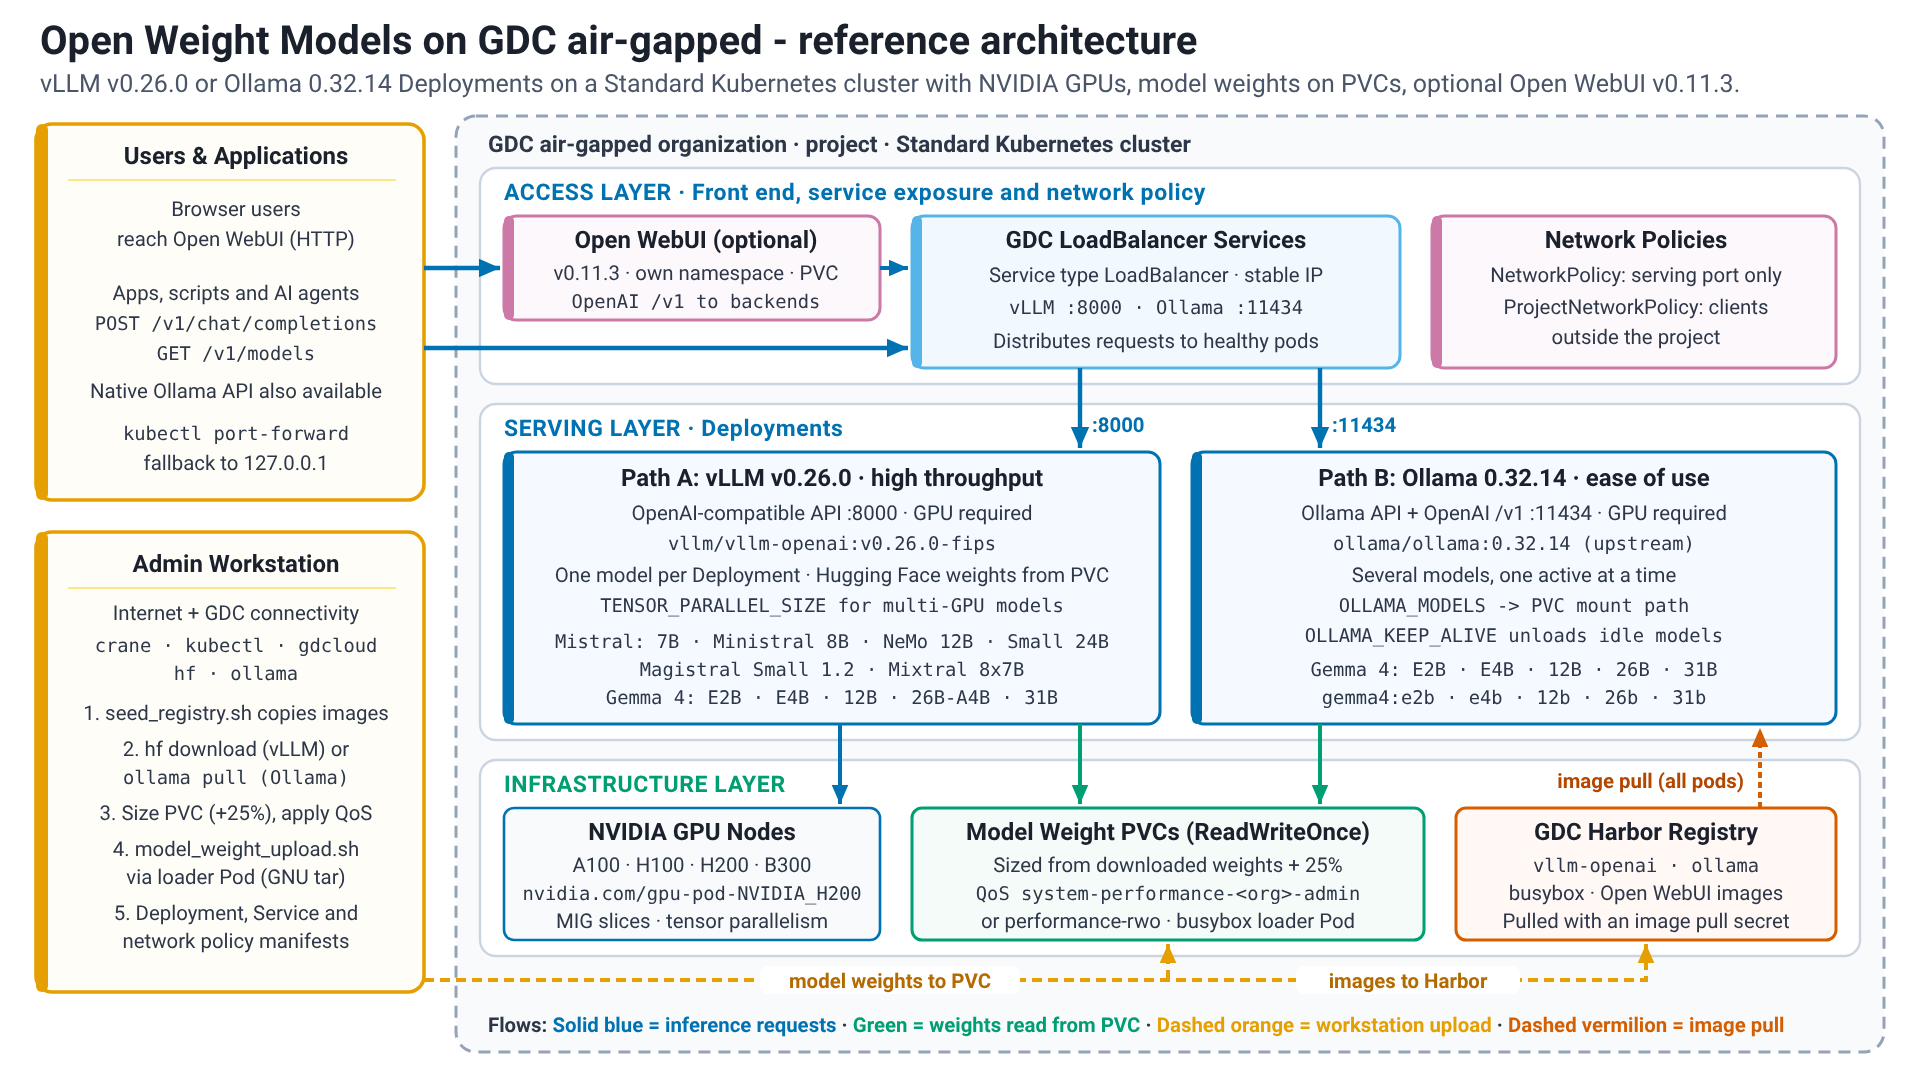
解決方案元件
這項解決方案使用下列元件:
| 解決方案元件 | 責任 | 資料流程 | 介面 |
|---|---|---|---|
| GDC 實體隔離方案客戶可用區 | 託管 Kubernetes 叢集、網路和儲存空間基礎架構 | 基礎平台 | IO 的基礎架構管理介面。適用於平台管理員和使用者的 Kubernetes API |
| 負載平衡器 | 將 LLM 服務 Pod (vLLM、Ollama) 公開給 Kubernetes 叢集外部的流量,並提供穩定的 IP 位址。 | 外部用戶端要求會傳送至 LoadBalancer 的外部 IP。LoadBalancer 會根據 Service 的選取器,將要求分配至健康狀態良好的後端 Pod (vLLM 或 Ollama) | Kubernetes Service API。在 GDC 環境中自動佈建網路負載平衡器。 |
| vLLM | 高處理量 LLM 推論服務。採用 PagedAttention 等技術,可縮短延遲時間。通常每個執行個體提供一個模型。 | 接收用戶端的 HTTP 推論要求。從掛接的 PVC 載入模型權重。在連接的 GPU 上執行運算。傳回含有生成的文字的 HTTP 回應。 | 與 OpenAI 相容的 RESTful API,可用於推論。接受 JSON 要求。 |
| Ollama | LLM 推論服務,專為易用性設計;一個執行個體可提供多個模型,並視需求載入。 | 接收 HTTP 推論要求。從掛接的 PVC (OLLAMA_MODELS) 載入模型,並在連接的 GPU 上執行運算。傳回 HTTP 回應。模型會在閒置一段時間後卸載 (OLLAMA_KEEP_ALIVE)。 |
Ollama RESTful API 和 OpenAI 相容 API (/v1)。接受 JSON 要求。另提供 CLI。 |
| NVIDIA GPU 和 MIG | 為 LLM 推論提供硬體加速。 | LLM 後端 (vLLM、Ollama) 會將密集的模型運算 (例如矩陣乘法) 卸載至 GPU,加速推論。MIG 可將單一 GPU 分區,供多個較小的模型執行個體使用。 | 在 Kubernetes 中公開為資源類型 (例如 nvidia.com/gpu-pod-NVIDIA_H200;確切資源名稱取決於安裝的 GPU 型號,並從節點中探索)。Pod 會要求這些資源 |
| Harbor | 安全儲存及管理 vLLM、Ollama、Open WebUI 和任何輔助 Pod (例如 busybox) 的容器映像檔 | 容器映像檔會從公開註冊資料庫複製到 Harbor,並使用 seed_registry.sh (crane) 從具備網路連線能力的工作站複製。Kubernetes 節點會從 Harbor 提取這些映像檔,以便執行容器。 |
Docker Registry API。Kubernetes 節點會與 Harbor 互動,在建立 Pod 時提取映像檔。使用者可透過 crane、Docker CLI 或 Harbor UI 推送映像檔。 |
| 永久磁碟區要求 | 為 LLM 模型權重提供永久儲存空間,不受 Pod 生命週期影響。 | 模型檔案會下載至工作站,用於動態計算 PVC 大小 (含 25% 的負擔),並透過臨時模型載入器 Pod (busybox) 和 model_weight_upload.sh 串流至 Persistent Volume。PVC 會透過已啟用高效能區塊儲存空間的 performance-rwo 佈建,否則基礎架構運作人員會將 system-performance-<org>-admin QoS 政策套用至其支援磁碟區。無論選擇哪一種,每 GiB 都能提供 30 IOPS (最低 6,148 IOPS)。兩個後端在啟動時,都會從這個掛接磁碟區讀取模型權重:vLLM 會載入 Hugging Face 模型目錄,Ollama 則會將 OLLAMA_MODELS 指向掛接路徑。不使用 kubectl cp,也不會將模型綁定至容器映像檔。 |
Kubernetes Storage API。在 YAML (ReadWriteOnce) 中定義,並以磁碟區形式掛接至 Pod。 |
| 網路政策 | 強制執行網路隔離,並控管 LLM 服務的流量。命名空間 NetworkPolicy (networking.k8s.io/v1) 允許叢集內部的流量進入服務通訊埠;如要從專案外部存取,則需要 ProjectNetworkPolicy (networking.gdc.goog/v1)。 |
系統會檢查命名空間內進出 Pod 的網路流量。政策規則會根據來源 IP 範圍或其他標籤,決定是否允許連至 LLM 服務通訊埠 (例如 vLLM 的 8000、Ollama 的 11434)。 | Kubernetes networking.k8s.io/v1 和 networking.gdc.goog/v1 API。以 YAML 定義。 |
| Open WebUI | 使用者可選用瀏覽器前端。與 vLLM 和 Ollama 的 OpenAI 相容 API 互動,不含模型權重,也不需要加速器。 | 使用者透過 Kubernetes Service 存取 Open WebUI。Open WebUI 會透過與 OpenAI 相容的 /v1 API,將對話要求轉送至 vLLM 和 Ollama 服務,並將自身狀態 (使用者、對話、設定) 儲存在永久磁碟區。 |
對使用者採用 HTTP (瀏覽器),對後端則採用與 OpenAI 相容的 REST API。有狀態工作負載部署在專屬命名空間。 |
特點與功能
這項參考架構提供下列核心功能:
- 開放權重 LLM 服務:可託管及推論各種開放權重模型 (例如 Gemma 4、Llama、DeepSeek、Mistral)。
- 元件:LLM 服務後端 (vLLM、Ollama)、Kubernetes 部署作業/Pod。
- 職責:載入模型權重、管理推論程序、在硬體加速器上執行模型,以及公開端點。
- 介面:REST API (與 OpenAI 相容,適用於 vLLM 和 Ollama,以及 Ollama 專屬 API),用於推論要求,通常使用 JSON。
- 自備模型 (BYOM):使用者可將自選的開放權重 LLM 匯入並部署至實體隔離環境。
- 元件:Harbor、永久磁碟區要求、模型載入器 Pod、Kubernetes。
- 職責:安全儲存容器映像檔和模型權重。將模型轉移至環境 (透過載入器 Pod
model_weight_upload.sh),並讓服務引擎存取模型的機制。 - 介面:Docker Registry API (用於 Harbor)、Kubernetes API (用於 PVC 和磁碟區掛接)。
- 硬體加速推論:使用 GDC 叢集中的 NVIDIA GPU,有效率地執行 LLM 推論。
- 元件:NVIDIA GPU、Kubernetes、裝置外掛程式。
- 職責:在具備 GPU 資源的節點上排定 Pod。將 GPU 硬體公開給 LLM 後端容器。支援多實體 GPU (MIG) 分區,以及多 GPU 張量平行處理 (
TENSOR_PARALLEL_SIZE),適用於 Mixtral 8x7Bbf16等大型模型。 - 介面:Kubernetes API (用於要求
nvidia.com/gpu-pod-NVIDIA_H200或nvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE等 GPU 資源)。
- 網路控管存取權:確保 LLM 推論端點的存取權受到控管,並在 GDC 環境中隔離。
- 元件:Kubernetes Service (LoadBalancer)、NetworkPolicy、ProjectNetworkPolicy。
- 職責:使用穩定的 IP 公開推論服務。定義及強制執行網路規則,根據來源、目的地和通訊埠,允許或拒絕傳送至 LLM 後端的流量。
- 介面:Kubernetes API (適用於 Service、NetworkPolicy 和 ProjectNetworkPolicy)。
- 可擴充服務:可根據需求調整容量。
- 元件:Kubernetes Deployment。
- 職責:增加 LLM 後端 Pod 的副本數量,啟用水平擴充功能。調整資源要求/限制,垂直調度資源。
- 介面:Kubernetes API (用於管理 Deployment 副本和資源)。
- 瀏覽器前端 (選用):使用者不必編寫 API 呼叫,就能與部署的模型對話。
- 元件:Open WebUI Deployment、Service 和 Persistent Volume Claim。
- 職責:在單一介面中呈現 vLLM 和 Ollama 提供的模型;保留使用者、對話和設定。
- 介面:HTTP (瀏覽器);與 OpenAI 相容的
/v1API (後端)。
架構原則
- 安全第一:所有元件和資料都位於 GDC 實體隔離邊界內,確保資料安全性和控管能力達到最高。網路存取權是使用
NetworkPolicy和ProjectNetworkPolicy物件限制。 - 資料主權:客戶可完全控管模型和資料,不需外部連線即可運作。
- 開放且彈性:這個架構採用開放原始碼服務後端 (vLLM、Ollama),並支援多種開放權重 LLM,讓客戶能自由選擇,避免受制於特定供應商的推論引擎。
- 元件解耦:模型儲存空間 (PVC)、映像檔管理 (Harbor)、推論服務 (vLLM/Ollama Pod) 和使用者介面 (Open WebUI) 等重要函式都是獨立元件,可分開管理及更新。
- 擴充性與效能:可水平擴充 (增加 Pod 副本數量) 和垂直擴充 (調整 CPU/GPU 資源,包括多 GPU 張量平行處理),滿足效能需求。vLLM 適用於高處理量、低延遲的情境。
- 資源最佳化:支援 NVIDIA 多實體 GPU (MIG),讓較小的模型有效率地共用 GPU 資源,並搭配高效能儲存空間 QoS,動態調整 PVC 大小 (+25% 負載),在不犧牲模型載入速度的情況下,避免過度佈建儲存空間。
- 標準介面:以 Kubernetes 標準為基礎,用於自動化調度管理、部署和服務公開。推論端點提供 REST API,vLLM 和 Ollama 則與 OpenAI 相容。
- 韌性:使用 Kubernetes 健康狀態檢查和複製功能,確保服務可用性。
注意事項
- 擴充性和效能:
- 如要水平擴充,請增加 vLLM 和 Ollama 的 Kubernetes Deployment 副本數量。如果沒有
ReadOnlyManyStorageClass,模型 Deployment 只能有一個副本 (模型磁碟區為ReadWriteOnce);額外容量則來自其他 Deployment,每個 Deployment 都有自己的 PVC。 - 垂直擴充是指分配更多 CPU/記憶體和更大的 GPU 切片,最多可達完整 GPU 或多 GPU 張量平行處理 (
TENSOR_PARALLEL_SIZE),跨越同一節點上的多個 GPU。 - vLLM 每個執行個體提供一個模型,如需其他模型,則須建立新的 Deployment。Ollama 可從一個執行個體提供多個模型;在這些指南中,每個 Ollama Deployment 都會提供一個模型。
- 每個模型的 PVC 會根據下載的權重動態調整大小,並加上 25% 的額外負擔,同時設定高效能儲存空間 QoS 政策 (
system-performance-<org>-admin,每 GiB 30 IOPS,下限為 6,148 IOPS,或啟用高效能區塊儲存空間的performance-rwo),因此模型載入時間不會受到預設standard-rwo每 GiB 3 IOPS 上限的限制。
- 如要水平擴充,請增加 vLLM 和 Ollama 的 Kubernetes Deployment 副本數量。如果沒有
- 資源管理:
- 請務必仔細規劃 GPU 資源。NVIDIA MIG 可用於為較小的模型分割 GPU,提高使用率,而較大的模型 (例如
bf16中的 Mixtral 8x7B) 則可使用張量平行處理,在多個 GPU 之間分割權重。 - 您必須分配足夠的 CPU 和記憶體,才能處理推論和模型管理負擔;vLLM 和 Ollama 則會透過 GPU 加速提供模型。
- 必須為 PVC 佈建足夠的儲存空間,才能容納模型大小並確保效能。
- 請務必仔細規劃 GPU 資源。NVIDIA MIG 可用於為較小的模型分割 GPU,提高使用率,而較大的模型 (例如
- 可用性和穩定性:
- Kubernetes Deployment 提供自我修復和滾動式更新功能。
- LoadBalancer 服務會將流量分配給健康狀態良好的 Pod,掩蓋個別 Pod 故障。
- 將模型權重儲存在 PVC,可確保 Pod 重新啟動後仍會保留。
- 作業複雜度:
- 在 Harbor 中管理不同後端和版本的容器映像檔。
- 將模型權重安全轉移至實體隔離環境的程序。
- 為每個模型和後端建立及管理 Kubernetes 資訊清單 (Deployment、Service、PVC、網路政策)。
- 監控 GPU 使用率、推論延遲時間和錯誤率。
- 安全性與法規遵循:
- 整個解決方案都在 GDC 實體隔離安全範圍內運作。
- 您必須設定網路政策,強制執行嚴格的網路隔離措施,並控管 LLM 端點的存取權:
NetworkPolicy命名空間用於叢集內存取,ProjectNetworkPolicy則用於專案外存取。 - Harbor 機器人帳戶和 Kubernetes 映像檔提取密鑰,可確保安全存取容器映像檔。
- 網路政策會限制哪些用戶端可以連線至端點。PVC 上的靜態資料則仰賴 GDC 儲存空間加密。
設計決策
這項參考架構已做出下列重要設計決策:
決策 1:同時提供 vLLM 和 Ollama,而非單一服務後端
| 背景資訊 | 重要決策 | 理由 |
|---|---|---|
| 提供一個或兩個 serving 後端 (vLLM 或 Ollama)。 | 兩者都提供,因為使用者和用途對效能、API 相容性和模型管理難易度的要求不同。 | vLLM 提供高處理量、低延遲的服務,並與 OpenAI API 相容,適合用於正式環境應用程式。Ollama 的設定更簡單、多模型管理更輕鬆,而且容易使用,更適合開發和實驗。同時支援這兩種方式可提供彈性。 |
決策 2:PersistentVolumeClaims 上的模型權重
| 背景資訊 | 重要決策 | 理由 |
|---|---|---|
| vLLM 和 Ollama 需要在執行階段將模型權重儲存在檔案系統中。在實體隔離環境中,模型無法隨選下載。 | 將每個模型的權重儲存在各自的 ReadWriteOnce PersistentVolumeClaim,並透過暫時的模型載入器 Pod 從工作站填入。 |
PersistentVolumeClaim 為大型模型檔案提供具韌性的永久儲存空間層,與推論 Pod 生命週期分離。這樣一來,Pod 啟動時就能快速載入模型。 |
決策 3:將 Ollama (載入器 Pod) 的模型權重儲存在 PersistentVolume,而非綁定在映像檔
| 背景資訊 | 重要決策 | 理由 |
|---|---|---|
| Ollama 可以下載模型,但需要網路連線能力,而實體隔離環境無法連上網路。如果將模型綁定至自訂 Ollama 映像檔,則必須為每個模型重新建構映像檔,並將數 GB 的映像檔儲存在 Harbor 中。 | Ollama 採用與 vLLM 相同的載入器 Pod 工作流程:模型會提取至工作站 (ollama pull 到 ollama_model_weight_download.sh),透過模型載入器 Pod 以 model_weight_upload.sh (GNU tar) 串流至 PVC,並將 OLLAMA_MODELS 指向掛接路徑。 |
一個工作流程適用於兩個後端;不需重建映像檔即可新增或更新模型;未修改的上游 Ollama 映像檔在 Harbor 中保持小巧。 |
決策 4:使用 LoadBalancer Service 公開 vLLM 和 Ollama,還是不使用負載平衡器
| 背景資訊 | 重要決策 | 理由 |
|---|---|---|
| GDC 環境中的應用程式必須能存取 LLM API。 | 透過 LoadBalancer 類型的 Service 公開每個後端,這是標準的 Kubernetes 做法。這項功能仰賴 GDC 實體隔離方案平台的負載平衡器佈建。 |
LoadBalancer 類型的 Kubernetes Service 提供標準、可靠的方法,可公開 LLM 後端、提供穩定的 IP 位址,以及分配負載。 |
決策 5:強制執行必要網路政策 (NetworkPolicy 和 ProjectNetworkPolicy)
| 背景資訊 | 重要決策 | 理由 |
|---|---|---|
| 在 GDC 實體隔離方案部署中,安全性和隔離性至關重要。 | 對每個 LLM 端點強制執行網路政策 (僅允許服務通訊埠的命名空間 NetworkPolicy,並在專案外部用戶端需要存取權時,搭配 ProjectNetworkPolicy),強化已部署 LLM 服務的資安態勢。 |
NetworkPolicy 物件提供 Kubernetes 原生方式,可在命名空間層級強制執行網路隔離,而 ProjectNetworkPolicy 物件則可將隔離範圍擴大至專案邊界,確保只有授權流量能連至 LLM 服務。 |
決策 6:動態 PVC 適當調整 (+25% 負載),搭配高效能儲存空間 QoS 政策
| 背景資訊 | 重要決策 | 理由 |
|---|---|---|
預設的 standard-rwo StorageClass 會強制執行 standard-<org>-admin ONTAP Adaptive QoS 政策 (3,072 IOPS per TiB 或 3 IOPS per GiB,最低下限為 75 IOPS)。如果嚴格按照模型權重大小調整 standard-rwo PVC,會將依序權重讀取速度限制在 5 到 21 MBps,而過度佈建靜態 300 到 500 GiB PVC 則會浪費儲存空間,同時將依序讀取處理量限制在約 60 MBps。 |
請先下載模型權重,然後從下載的目錄動態計算 GDCS_MODEL_PVC_SIZE,並加上 25% 的額外負擔 (無條件進位至下一個整數 GiB),接著使用已啟用高效能區塊儲存空間的 storageClassName: performance-rwo,或要求基礎架構操作員將 system-performance-${GDC_ORG}-admin QoS 政策套用至備份磁碟區。 |
system-performance-<org>-admin QoS 政策提供 30,720 IOPS per TiB (30 IOPS per GiB,比 standard 高 10 倍),任何磁碟區最多 204 GiB,最低下限為 6,148 IOPS (ONTAP 上限約為 393 MBps)。搭配使用動態 25% 額外負擔大小調整功能和 system-performance,可消除 3 到 40 倍的儲存空間過度佈建 (12Gi 到 109Gi,而非 100Gi 到 500Gi),同時將單一 LUN KubeVirt virtio-scsi 循序讀取速度提高至約 150 MBps (模型啟動速度提升 2.5 到 30 倍)。 |
假設和限制
- 可使用 GDC 實體隔離方案 1.16.2 hotfix 1 (
1.16.2-gdch.1353-1) 以上版本環境 (標準叢集中的 GPU 節點集區需要這個版本,較早版本僅在共用叢集中提供 GPU)。 - 標準叢集具備充足的硬體資源 (包括 NVIDIA GPU)。vLLM 和 Ollama 都需要 GPU。
- Harbor 執行個體已設定完成,且可供存取。
- 工作站可連上網際網路和 GDC 環境 (Harbor 和 Kubernetes API),用於植入映像檔及上傳模型權重。
- 使用者具備必要權限:專案角色 Harbor 執行個體檢視者和標準叢集管理員,以及標準叢集上的 StandardClusterRoleBinding (叢集管理員),請參閱 SRI。
- 模型與所選服務後端 (vLLM/Ollama) 相容。
- 限制:模型權重 PVC 為
ReadWriteOnce;如果沒有ReadOnlyManyStorageClass,每個模型 Deployment 只能有一個副本。
使用者流程
以下是在 Google Distributed Cloud (GDC) 實體隔離環境中,部署開放權重大型語言模型 (LLM) 的完整使用者流程。流程分為一般設定、兩種部署路徑 (vLLM 和 Ollama)、選用前端和最終驗證。
1. 常見設定:映像檔管理
部署任何 LLM 之前,您必須設定 GDC 環境如何從私人 Harbor 登錄檔提取容器映像檔。
- 建立 Harbor 機器人帳戶:在 Harbor UI 中產生機器人帳戶:一個具有
crane的推送權限 (映像檔播種),另一個具有 Kubernetes 映像檔提取密鑰的提取權限。 - 驗證 crane 和種子映像檔:使用機器人帳戶憑證,從具備網路連線能力的工作站 (
crane auth login) 登入 Harbor,並使用seed_registry.sh將必要的容器映像檔 (busybox、ollama/ollama、vllm/vllm-openai,以及選用的 Open WebUI) 複製到 Harbor。 - 建立 Kubernetes Secret:使用 kubectl 在工作負載命名空間中建立 docker-registry Secret,儲存提取機器人帳戶憑證,供叢集使用。
2. 部署路徑 A:使用 vLLM 提高處理量
如要使用 GPU 提供 Mistral 7B Instruct 等效能導向模型,建議採用這個路徑。
- 取得映像檔:使用
seed_registry.sh將 vLLM 映像檔 (vllm/vllm-openai:v0.26.0) 植入 Harbor,然後按照 SRI 中的說明,建構並推送修補後的映像檔標記v0.26.0-fips。 - 準備模型儲存空間:
- 從工作站 (
hf download) 上的 Hugging Face 下載權重。 - 根據下載的權重 (加上 25% 的額外負擔) 計算所需的 PVC 大小,建立
ReadWriteOnce永久磁碟區要求 (PVC) 來儲存模型權重,並套用高效能 QoS 政策。 - 啟動暫時的模型載入器 Pod (
busybox),掛接 PVC 並使用model_weight_upload.sh將權重串流至其中 (kubectl exec上的 GNU tar;不使用kubectl cp,因為 BusyBox tar 無法讀取大於 8 GiB 檔案的 PAX 標頭),然後刪除載入器 Pod。
- 從工作站 (
- 部署後端:套用 Kubernetes Deployment 資訊清單,參照 vLLM 映像檔、要求從節點探索到的加速器資源 (例如
nvidia.com/gpu-pod-NVIDIA_H200),並掛接模型權重 PVC。 - 公開服務:建立 LoadBalancer 服務,為 vLLM API 提供外部 IP。
- 安全網路:套用命名空間 NetworkPolicy,允許服務通訊埠 (8000) 上的輸入流量;如果專案外部的用戶端需要存取權,請新增 ProjectNetworkPolicy。
3. 部署路徑 B:使用 Ollama 輕鬆部署
這個路徑著重於簡化設定。這項服務會使用未經修改的上游 Ollama 映像檔,以及與 vLLM 相同的模型載入器工作流程。
- 種子映像檔:使用
seed_registry.sh將上游 Ollama 映像檔 (ollama/ollama:0.32.14) 複製到 Harbor。 - 準備模型儲存空間:
- 使用
ollama_model_weight_download.sh在工作站上提取模型 (例如gemma4:e4b),這會執行暫時本機ollama serve,並將OLLAMA_MODELS指向下載目錄。 - 根據下載的權重 (加上 25% 的額外負擔) 計算所需的 PVC 大小、建立
ReadWriteOncePVC、套用高效能 QoS 政策,並啟動掛接該 PVC 的臨時模型載入器 Pod。 - 使用
model_weight_upload.sh將下載目錄上傳至 PVC,然後刪除載入器 Pod。
- 使用
- 部署及公開:建立 Ollama Deployment,並將
OLLAMA_MODELS指向 PVC 掛接路徑 (要求從節點探索到的加速器資源) 和 LoadBalancer 服務。 - 安全網路:為 Ollama 通訊埠 (11434) 套用命名空間 NetworkPolicy;如果專案外部的用戶端需要存取權,請新增 ProjectNetworkPolicy。
4. 選用:開啟 WebUI
- 部署 Open WebUI:將 Open WebUI 映像檔植入 Harbor,並部署在專屬命名空間,使用永久儲存空間儲存狀態。將其指向 vLLM 服務和/或 Ollama 服務的 OpenAI 相容
/v1端點。相關步驟請參閱「Open WebUI for Open Weight Models 使用手冊」。
5. 驗證與測試
部署完成後,最後步驟是確認服務是否正常運作。
- 檢查狀態:確認 Pod 正在運作,且服務已獲派外部 IP 位址。
- 測試推論:
- vLLM:使用與 OpenAI 相容的
/v1/models和/v1/chat/completions端點,將 curl 要求傳送至 vLLM LoadBalancer IP。 - Ollama:使用與 OpenAI 相容的
/v1/models和/v1/chat/completions端點,將 curl 要求傳送至 Ollama LoadBalancer IP。
- vLLM:使用與 OpenAI 相容的
- 通訊埠轉送備用:如果無法從工作站連上 LoadBalancer IP (例如尚未設定 ProjectNetworkPolicy),請使用
kubectl port-forward連至服務,並將相同要求傳送至127.0.0.1。
6. 作業和資源調度
- 垂直擴充:增加 GPU 切片,或改用多 GPU 設定,以處理較大的模型。
- 水平擴充:增加 Deployment 中的副本數量 (需要
ReadOnlyMany模型磁碟區),或部署其他模型 Deployment,以處理更多並行使用者要求。 - 疑難排解:使用
kubectl logs監控記錄,並檢查常見問題,例如 FIPS 自我測試失敗或網路政策限制。
詳細步驟請參閱「Open Weight Models with Ollama reference implementation」(使用 Ollama 參考實作開放權重模型)、「Open Weight Models with vLLM reference implementation」(使用 vLLM 參考實作開放權重模型) 和相關使用手冊。
其他資料
- 開放權重模型與 Ollama 參考實作
- 開放權重模型與 vLLM 參考實作
- Gemma 4 E4B 搭配 Ollama 使用手冊
- [SUG] 在 GDC 實體隔離方案使用 vLLM 部署 Mistral 7B Instruct
- [SUG] 在 GDC 實體隔離方案使用 vLLM 執行 Mistral NeMo 12B Instruct
- [SUG] 在 GDC 實體隔離方案使用 vLLM 部署 Mistral Small 3.2 24B Instruct
- [SUG] 在 GDC 實體隔離方案上使用 vLLM 部署 Ministral 8B Instruct
- [SUG] 在 GDC 實體隔離方案使用 vLLM 部署 Mixtral 8x7B Instruct
- [SUG] 在 GDC 實體隔離方案上,透過 vLLM 使用 Magistral Small 1.2 24B
- Open WebUI for Open Weight Models 使用手冊
- vLLM 說明文件
- Ollama
- Open WebUI
- Google Distributed Cloud 實體隔離方案說明文件