


문제 기술문
에어 갭 환경에서 운영되는 조직은 대규모 언어 모델이 필요하지만 엄격한 보안 프로토콜로 인해 외부 클라우드 기반 API에 연결하는 것이 엄격히 금지되는 중대한 과제에 직면해 있습니다. 이러한 격차를 해소하기 위해 이러한 고객은 Google Distributed Cloud (GDC) 에어 갭 적용형 인프라에서 직접 가중치 공개 모델을 호스팅하고 관리할 수 있는 강력하고 독립적인 생태계가 필요합니다. 이 현지화된 배포는 절대적인 데이터 주권을 유지하고 민감한 정보가 물리적 구내를 벗어나지 않도록 하는 데 필수적입니다. 보안 실행 환경을 서빙 백엔드와 통합하면 사용자는 데이터, 모델 가중치, 내부 보안 상황에 대한 전체 관리 제어 권한을 유지하면서 고급 AI 기능을 사용할 수 있습니다.
GDC의 Gemini는 강력한 관리형 첨단 기능을 제공하지만, 고객은 더 세밀한 세분화 및 제어를 위해 Gemma 4 또는 Llama 4와 같은 가중치 공개 모델을 배포하는 경우가 많습니다. 에어 갭 GDC 환경에 개방형 가중치 모델을 배포하면 관리형 독점 서비스에 비해 상당한 비용 이점이 있습니다. 모델 가중치를 소유하면 조직은 반복적인 토큰당 API 요금을 없앨 수 있습니다. 이 요금은 대량의 자동화된 워크로드에 엄청난 부담이 될 수 있습니다. 또한 개방형 가중치 모델은 양자화 (예: 4비트 또는 8비트)를 지원하므로 에지에서 더 작고 저렴한 하드웨어 공간에서 고성능 추론을 실행할 수 있습니다. 이러한 수직적 최적화는 추가 라이선스 비용 없이 여러 내부 애플리케이션에서 인프라를 공유하는 기능과 결합되어 지속적인 대규모 추론 작업의 총소유비용 (TCO)을 크게 낮춥니다.
제안된 솔루션
이 문서에서는 Google Distributed Cloud (GDC) 에어 갭 환경에서 개방형 가중치 대규모 언어 모델 (LLM)을 배포하고 관리하기 위한 참조 아키텍처를 간략하게 설명합니다. 많은 고객, 특히 규제가 엄격한 분야의 고객은 엄격한 데이터 주권 및 보안 요구사항으로 인해 클라우드 기반 LLM API를 사용할 수 없습니다. 이 아키텍처는 자체 보안 GDC 인스턴스 내에서 강력한 LLM을 로컬로 실행해야 하는 요구사항을 해결합니다.
포함된 항목: 이 아키텍처는 vLLM 또는 Ollama 서빙 백엔드를 사용하여 가중치 공개 모델 (예: Gemma 4, Llama, DeepSeek, Mistral)을 배포하는 방법을 다룹니다. 여기에는 조정을 위한 Kubernetes, 아티팩트 스토리지를 위한 Harbor, 모델 가중치를 위한 영구 볼륨, 네트워크 보안을 위한 네트워크 정책 (NetworkPolicy / ProjectNetworkPolicy), 선택적 브라우저 프런트엔드로서의 Open WebUI 사용이 포함됩니다.
포함되지 않는 항목: 이 아키텍처에는 관리형 AI 게이트웨이 서비스, Google의 Gemini 모델과 같은 독점 모델, 모델 미세 조정 프로세스 또는 이미지 생성과 같은 다른 모달리티를 위한 생성형 AI 모델이 포함되지 않습니다.
대상: 이 문서의 주요 대상은 GDC에서 서비스를 배포하고 관리하는 플랫폼 관리자와 에어 갭 적용 환경 내에서 AI 솔루션을 설계하는 기술 설계자입니다. 배포된 모델과 상호작용하는 최종 사용자와 개발자는 기본 구조를 이해함으로써 이점을 얻는 보조 대상입니다.
아키텍처
이 솔루션은 vLLM, Ollama 또는 둘 다를 표준 클러스터 내에서 컨테이너화된 추론 서빙 백엔드 (Deployment)로 배포합니다. 모델 가중치는 모델 로더 Pod를 통해 워크스테이션에서 채워지는 영구 볼륨에 저장됩니다. LoadBalancer 유형의 Kubernetes Service는 백엔드 API를 노출하고, NetworkPolicy / ProjectNetworkPolicy 객체는 이에 대한 액세스를 보호하며, Open WebUI는 OpenAI 호환 API의 브라우저 프런트엔드로 선택적으로 배포할 수 있습니다.
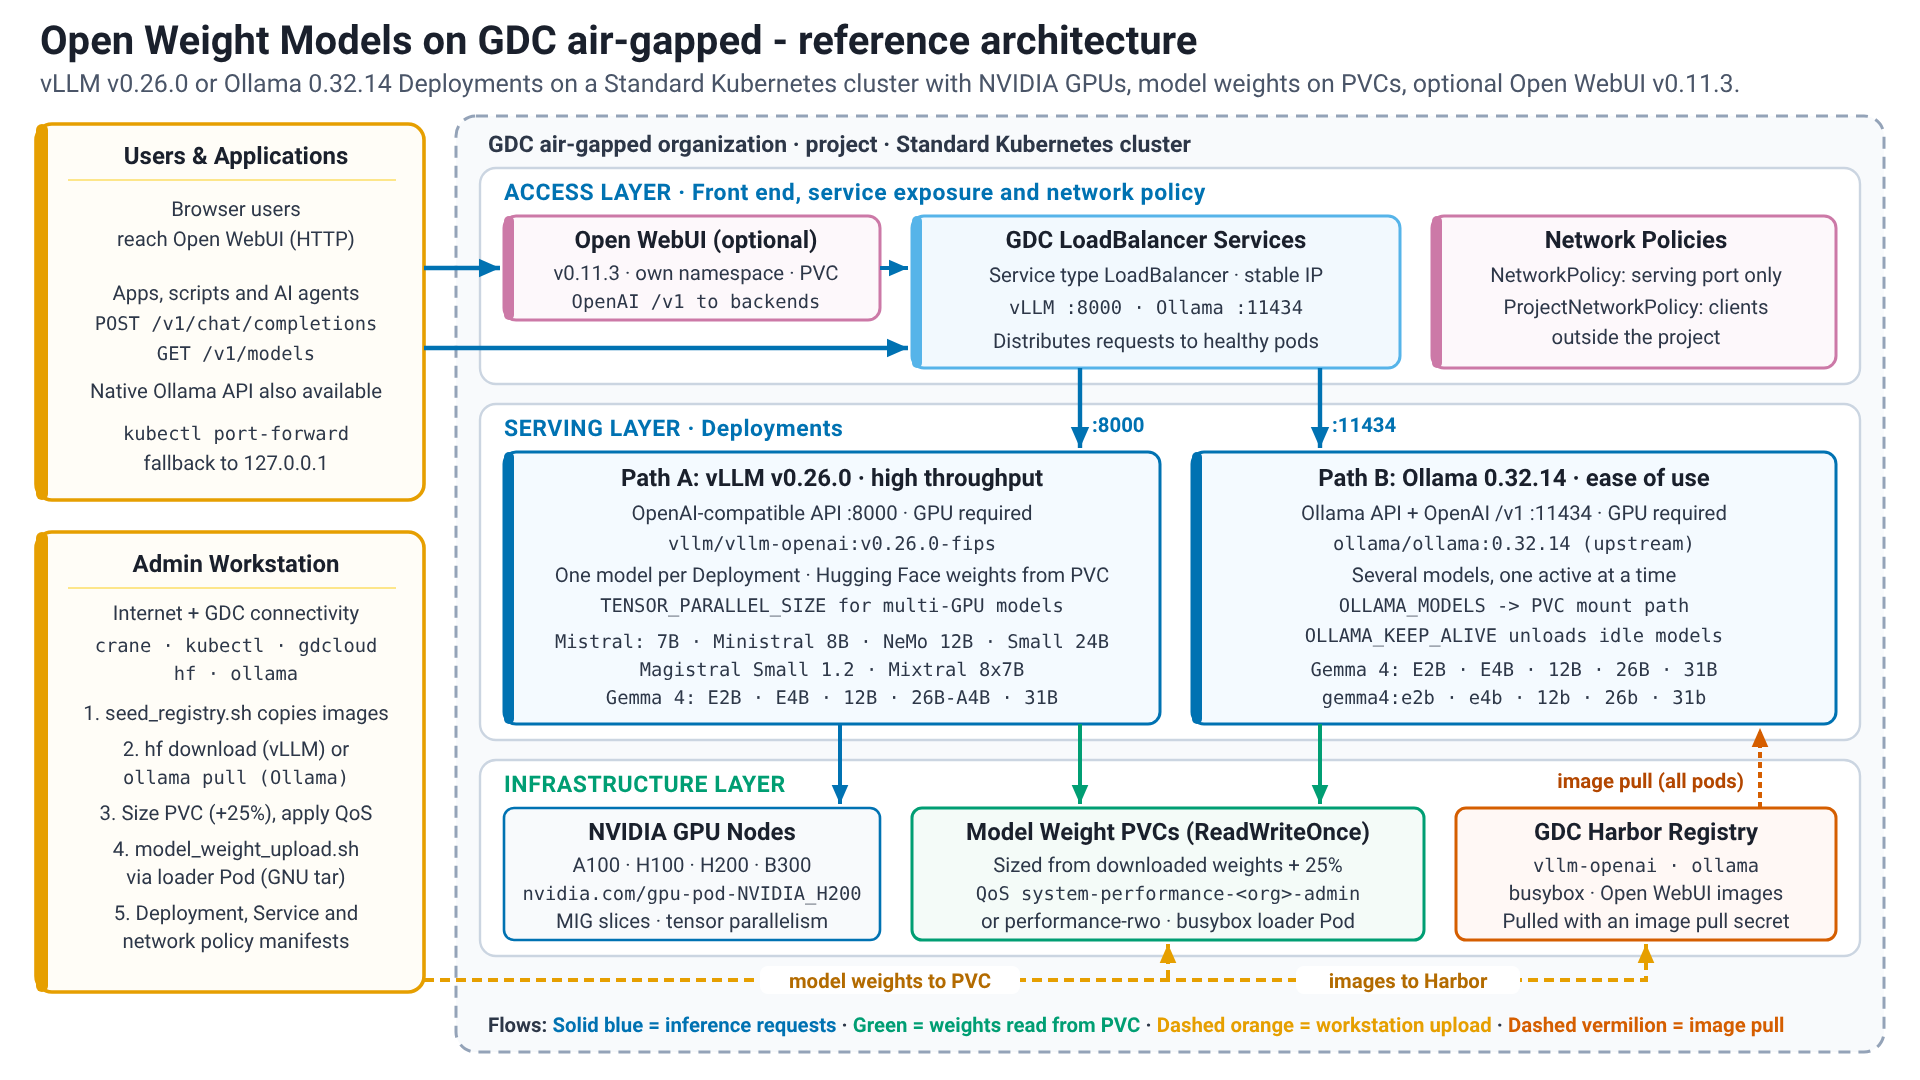
솔루션 구성요소
이 솔루션은 다음 구성요소를 사용합니다.
| 솔루션 구성요소 | 책임 | 데이터 흐름 | 인터페이스 |
|---|---|---|---|
| GDC 에어 갭 적용 고객 영역 | Kubernetes 클러스터, 네트워킹, 스토리지 인프라를 호스팅합니다. | 기본 플랫폼 | IO를 위한 인프라 관리 인터페이스 플랫폼 관리자 및 사용자를 위한 Kubernetes API |
| 부하 분산기 | LLM 서빙 포드 (vLLM, Ollama)를 Kubernetes 클러스터 외부의 트래픽에 노출하여 안정적인 IP 주소를 제공합니다. | 외부 클라이언트 요청은 LoadBalancer의 외부 IP로 전송됩니다. LoadBalancer는 서비스의 선택기에 따라 정상 백엔드 포드 (vLLM 또는 Ollama)에 요청을 분산합니다. | Kubernetes Service API GDC 환경 내에서 네트워크 부하 분산기를 자동으로 프로비저닝합니다. |
| vLLM | 높은 처리량의 LLM 추론 서빙 PagedAttention과 같은 기술을 사용하여 짧은 지연 시간에 최적화되어 있습니다. 일반적으로 인스턴스당 하나의 모델을 제공합니다. | 클라이언트로부터 HTTP 추론 요청을 수신합니다. 마운트된 PVC에서 모델 가중치를 로드합니다. 연결된 GPU에서 계산을 수행합니다. 생성된 텍스트가 포함된 HTTP 응답을 반환합니다. | 추론을 위한 OpenAI 호환 RESTful API JSON 요청을 허용합니다. |
| Ollama | 사용 편의성을 위해 설계된 LLM 추론 서빙으로, 하나의 인스턴스가 여러 모델을 서빙하고 필요에 따라 로드할 수 있습니다. | HTTP 추론 요청을 수신합니다. 마운트된 PVC (OLLAMA_MODELS)에서 모델을 로드합니다. 연결된 GPU에서 계산을 수행합니다. HTTP 응답을 반환합니다. 모델은 구성 가능한 비활성 기간 (OLLAMA_KEEP_ALIVE) 후에 언로드됩니다. |
Ollama RESTful API 및 OpenAI 호환 API (/v1). JSON 요청을 허용합니다. CLI도 있습니다. |
| NVIDIA GPU 및 MIG | LLM 추론을 위한 하드웨어 가속을 제공합니다. | LLM 백엔드 (vLLM, Ollama)는 추론을 가속화하기 위해 집약적인 모델 계산 (예: 행렬 곱셈)을 GPU로 오프로드합니다. MIG를 사용하면 단일 GPU를 여러 개의 작은 모델 인스턴스에서 사용할 수 있도록 파티셔닝할 수 있습니다. | Kubernetes에서 리소스 유형으로 노출됩니다 (예: nvidia.com/gpu-pod-NVIDIA_H200, 정확한 리소스 이름은 설치된 GPU 모델에 따라 다르며 노드에서 검색됨). 포드가 이러한 리소스를 요청함 |
| Harbor | vLLM, Ollama, Open WebUI, 도우미 포드 (예: busybox)의 컨테이너 이미지를 안전하게 저장하고 관리합니다. | 컨테이너 이미지는 인터넷 액세스 권한이 있는 워크스테이션에서 seed_registry.sh (crane)를 사용하여 공개 레지스트리에서 Harbor로 복사됩니다. Kubernetes 노드는 Harbor에서 이러한 이미지를 가져와 컨테이너를 실행합니다. |
Docker Registry API Kubernetes 노드는 포드 생성 중에 Harbor와 상호작용하여 이미지를 가져옵니다. 사용자는 crane, Docker CLI 또는 Harbor UI를 사용하여 이미지를 푸시합니다. |
| 영구 볼륨 클레임 | 포드 수명 주기와 분리된 LLM 모델 가중치를 위한 영구 스토리지를 제공합니다. | 모델 파일은 워크스테이션에 다운로드되고, 25% 오버헤드로 PVC 크기를 동적으로 계산하는 데 사용되며, model_weight_upload.sh를 사용하는 임시 모델 로더 포드 (busybox)를 통해 영구 볼륨으로 스트리밍됩니다. PVC는 고성능 블록 스토리지가 사용 설정된 performance-rwo로 프로비저닝됩니다. 그렇지 않으면 인프라 운영자가 지원 볼륨에 system-performance-<org>-admin QoS 정책을 적용합니다. 두 옵션 모두 GiB당 30 IOPS (최소 6,148 IOPS)를 제공합니다. 두 백엔드 모두 시작 시 이 마운트된 볼륨에서 모델 가중치를 읽습니다. vLLM은 Hugging Face 모델 디렉터리를 로드하고 Ollama는 마운트 경로에서 OLLAMA_MODELS를 가리킵니다. kubectl cp가 사용되지 않으며 모델이 컨테이너 이미지에 번들로 묶이지 않습니다. |
Kubernetes 스토리지 API YAML (ReadWriteOnce)에 정의되고 포드에 볼륨으로 마운트됩니다. |
| 네트워크 정책 | 네트워크 격리를 적용하고 LLM 서비스로의 트래픽 흐름을 제어합니다. 네임스페이스 NetworkPolicy (networking.k8s.io/v1)는 클러스터 내부에서 서빙 포트로의 트래픽을 허용합니다. 프로젝트 외부에서 액세스하려면 ProjectNetworkPolicy (networking.gdc.goog/v1)가 추가로 필요합니다. |
네임스페이스 내 포드와 주고받는 네트워크 트래픽이 검사됩니다. 정책 규칙은 일반적으로 소스 IP 범위 또는 기타 라벨을 기반으로 LLM 서비스 포트 (예: vLLM의 경우 8000, Ollama의 경우 11434)에 대한 연결이 허용되는지 여부를 지정합니다. | Kubernetes networking.k8s.io/v1 및 networking.gdc.goog/v1 API YAML에 정의됩니다. |
| Open WebUI | 최종 사용자를 위한 브라우저 기반 프런트엔드(선택사항)입니다. vLLM 및 Ollama의 OpenAI 호환 API와 통신합니다. 모델 가중치를 보유하지 않으며 가속기가 필요하지 않습니다. | 사용자는 Kubernetes 서비스를 통해 Open WebUI에 도달합니다. Open WebUI는 OpenAI 호환 /v1 API를 통해 채팅 요청을 vLLM 및 Ollama 서비스로 전달하고 자체 상태 (사용자, 채팅, 설정)를 영구 볼륨에 유지합니다. |
사용자에게는 HTTP (브라우저), 백엔드에는 OpenAI 호환 REST API를 제공합니다. 자체 네임스페이스에 배포된 스테이트풀(Stateful) 워크로드 |
특징 및 기능
이 참조 아키텍처는 다음과 같은 핵심 기능을 제공합니다.
- 개방형 가중치 LLM 서빙: 다양한 개방형 가중치 모델 (예: Gemma 4, Llama, DeepSeek, Mistral)의 호스팅 및 추론을 지원합니다.
- 구성요소: LLM 서빙 백엔드 (vLLM, Ollama), Kubernetes 배포/포드
- 책임: 모델 가중치 로드, 추론 프로세스 관리, 하드웨어 가속기에서 모델 실행, 엔드포인트 노출
- 인터페이스: 일반적으로 JSON을 사용하는 추론 요청을 위한 REST API (vLLM 및 Ollama용 OpenAI 호환 및 Ollama 전용 API)
- 사용자 모델 사용 (BYOM): 사용자는 선택한 가중치 공개 LLM을 에어 갭 환경으로 가져와 배포할 수 있습니다.
- 구성요소: Harbor, 영구 볼륨 클레임, 모델 로더 포드, Kubernetes
- 책임: 컨테이너 이미지 및 모델 가중치의 안전한 저장 모델을 환경으로 전송하고(
model_weight_upload.sh를 통해 로더 포드) 서빙 엔진에서 액세스할 수 있도록 하는 메커니즘입니다. - 인터페이스: Docker Registry API (Harbor용), Kubernetes API (PVC 및 볼륨 마운트용)
- 하드웨어 가속 추론: GDC 클러스터 내에서 NVIDIA GPU를 사용하여 LLM 추론을 효율적으로 실행합니다.
- 구성요소: NVIDIA GPU, Kubernetes, 기기 플러그인
- 책임: GPU 리소스가 있는 노드에 포드를 예약합니다.
LLM 백엔드 컨테이너에 GPU 하드웨어 노출 파티셔닝을 위한 멀티 인스턴스 GPU (MIG)와 Mixtral 8x7B
bf16와 같은 대규모 모델을 위한 멀티 GPU 텐서 동시 로드 (TENSOR_PARALLEL_SIZE)를 지원합니다. - 인터페이스: Kubernetes API (
nvidia.com/gpu-pod-NVIDIA_H200또는nvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE와 같은 GPU 리소스 요청용)
- 네트워크 제어 액세스: LLM 추론 엔드포인트에 대한 액세스가 GDC 환경 내에서 제어되고 격리되도록 합니다.
- 구성요소: Kubernetes 서비스 (LoadBalancer), NetworkPolicy, ProjectNetworkPolicy
- 책임: 안정적인 IP를 사용하여 추론 서비스를 노출합니다. 소스, 대상, 포트를 기반으로 LLM 백엔드에 대한 트래픽을 허용하거나 거부하는 네트워크 규칙을 정의하고 시행합니다.
- 인터페이스: Kubernetes API (서비스, NetworkPolicy, ProjectNetworkPolicy용)
- 확장 가능한 서빙: 수요에 따라 용량을 조정할 수 있습니다.
- 구성요소: Kubernetes 배포
- 책임: LLM 백엔드 포드의 복제본 수를 늘려 수평 확장을 사용 설정합니다. 리소스 요청/한도를 조정하여 수직 확장
- 인터페이스: Kubernetes API (배포 복제본 및 리소스 관리용)
- 브라우저 프런트엔드 (선택사항): 최종 사용자가 API 호출을 작성하지 않고도 배포된 모델과 채팅할 수 있습니다.
- 구성요소: Open WebUI 배포, 서비스, 영구 볼륨 클레임
- 책임: vLLM 및 Ollama에서 제공하는 모델 서빙을 하나의 인터페이스에 표시하고 사용자, 채팅, 설정을 유지합니다.
- 인터페이스: HTTP (브라우저), 백엔드에 대한 OpenAI 호환
/v1API
아키텍처 원칙
- 보안 우선: 모든 구성요소와 데이터가 GDC 에어 갭 경계 내에 상주하므로 데이터 보안과 제어가 극대화됩니다. 네트워크 액세스는
NetworkPolicy및ProjectNetworkPolicy객체를 사용하여 제한됩니다. - 데이터 주권: 고객은 모델과 데이터에 대한 완전한 제어권을 유지하며, 운영에 외부 연결이 필요하지 않습니다.
- 개방성 및 유연성: 이 아키텍처는 오픈소스 서빙 백엔드(vLLM, Ollama)를 사용하고 다양한 개방형 가중치 LLM을 지원하므로 고객에게 선택권을 제공하고 추론 엔진에 대한 공급업체 종속을 방지합니다.
- 구성요소 분리: 모델 스토리지 (PVC), 이미지 관리 (Harbor), 추론 서빙 (vLLM/Ollama 포드), 사용자 인터페이스 (Open WebUI)와 같은 주요 기능은 별개의 구성요소이므로 독립적으로 관리하고 업데이트할 수 있습니다.
- 확장성 및 성능: 포드 복제본 수를 늘려 수평으로 확장하고 CPU/GPU 리소스 (다중 GPU 텐서 동시 로드 포함)를 조정하여 수직으로 확장하여 성능 요구사항을 충족하도록 설계되었습니다. vLLM은 처리량이 높고 지연 시간이 짧은 시나리오에 적합합니다.
- 리소스 최적화: NVIDIA 멀티 인스턴스 GPU (MIG)를 지원하여 소규모 모델이 GPU 리소스를 효율적으로 공유할 수 있도록 하고, 고성능 스토리지 QoS와 함께 동적 PVC 크기 조정(+25% 오버헤드)을 지원하여 모델 로드 속도를 저하시키지 않으면서 스토리지 오버프로비저닝을 제거합니다.
- 표준 인터페이스: 조정, 배포, 서비스 노출을 위한 Kubernetes 표준을 기반으로 빌드됩니다. 추론 엔드포인트는 REST API를 제공하며, vLLM과 Ollama 모두 OpenAI 호환성을 제공합니다.
- 복원력: Kubernetes 상태 점검 및 복제를 사용하여 서비스 가용성을 보장합니다.
고려사항
- 확장성 및 성능:
- 수평 확장은 vLLM 및 Ollama 모두에 대해 Kubernetes 배포의 복제본 수를 늘려 수행됩니다.
ReadOnlyManyStorageClass가 없으면 모델 배포가 복제본 하나로 제한됩니다(모델 볼륨은ReadWriteOnce). 추가 용량은 추가 배포에서 제공되며 각 배포에는 자체 PVC가 있습니다. - 수직 확장은 동일한 노드의 여러 GPU에서 전체 GPU 또는 멀티 GPU 텐서 동시 로드(
TENSOR_PARALLEL_SIZE)까지 더 많은 CPU/메모리와 더 큰 GPU 슬라이스를 할당하는 것을 포함합니다. - vLLM은 인스턴스당 하나의 모델을 제공하므로 추가 모델을 사용하려면 새 배포가 필요합니다. Ollama는 한 인스턴스에서 여러 모델을 서빙할 수 있습니다. 이 가이드에서는 각 Ollama 배포가 하나의 모델을 서빙합니다.
- 각 모델의 PVC는 다운로드된 가중치에서 25% 오버헤드로 동적으로 크기가 조정되고 고성능 스토리지 QoS 정책(
system-performance-<org>-admin, GiB당 30 IOPS,6, 148 IOPS 하한 또는 고성능 블록 스토리지가 사용 설정된performance-rwo)으로 구성되므로 모델 로드 시간이 기본standard-rwoGiB당 3 IOPS 한도로 제한되지 않습니다.
- 수평 확장은 vLLM 및 Ollama 모두에 대해 Kubernetes 배포의 복제본 수를 늘려 수행됩니다.
- 리소스 관리:
- GPU 리소스를 신중하게 계획하는 것이 중요합니다. NVIDIA MIG를 사용하면 소규모 모델의 GPU를 파티셔닝하여 사용률을 개선할 수 있으며, 대규모 모델 (예:
bf16의 Mixtral 8x7B)은 텐서 동시 로드를 사용하여 여러 GPU에 가중치를 샤딩할 수 있습니다. - 추론 및 모델 관리 오버헤드를 모두 처리할 수 있도록 충분한 CPU와 메모리를 할당해야 합니다. vLLM과 Ollama는 GPU 가속을 사용하여 모델을 서빙합니다.
- 모델 크기를 수용하고 성능을 보장하기 위해 PVC에 충분한 스토리지를 프로비저닝해야 합니다.
- GPU 리소스를 신중하게 계획하는 것이 중요합니다. NVIDIA MIG를 사용하면 소규모 모델의 GPU를 파티셔닝하여 사용률을 개선할 수 있으며, 대규모 모델 (예:
- 가용성 및 안정성:
- Kubernetes 배포는 자가 복구 및 순차적 업데이트 기능을 제공합니다.
- LoadBalancer 서비스는 정상 포드 간에 트래픽을 분산하여 개별 포드 오류를 마스킹합니다.
- PVC에 모델 가중치를 저장하면 포드가 다시 시작되어도 지속성이 보장됩니다.
- 운영 복잡성:
- Harbor에서 다양한 백엔드 및 버전에 대한 컨테이너 이미지 관리
- 모델 가중치를 에어 갭 적용 환경으로 안전하게 전송하는 절차
- 각 모델 및 백엔드에 대한 Kubernetes 매니페스트 (배포, 서비스, PVC, 네트워크 정책)를 만들고 관리합니다.
- GPU 사용률, 추론 지연 시간, 오류율 모니터링
- 보안 및 규정 준수:
- 전체 솔루션은 GDC 에어 갭 보안 경계 내에서 작동합니다.
- 엄격한 네트워크 격리를 적용하고 LLM 엔드포인트에 대한 액세스를 제어하려면 네트워크 정책이 필요합니다. 클러스터 내 액세스를 위한 네임스페이스
NetworkPolicy와 프로젝트 외부에서 액세스하기 위한ProjectNetworkPolicy가 필요합니다. - Harbor 로봇 계정과 Kubernetes 이미지 가져오기 보안 비밀은 컨테이너 이미지에 대한 안전한 액세스를 보장합니다.
- 네트워크 정책은 엔드포인트에 도달할 수 있는 클라이언트를 제한합니다. PVC의 저장 데이터는 GDC 스토리지 암호화를 사용합니다.
설계 결정
이 참조 아키텍처에 대해 다음과 같은 주요 설계 결정이 내려졌습니다.
결정 1: 하나의 서빙 백엔드 대신 vLLM과 Ollama를 모두 제공
| 컨텍스트 | 주요 결정사항 | 근거 |
|---|---|---|
| 서빙 백엔드 (vLLM 또는 Ollama)를 하나 또는 둘 다 제공합니다. | 사용자와 사용 사례에 따라 성능, API 호환성, 모델 관리 편의성에 대한 요구사항이 다르므로 두 가지를 모두 제공합니다. | vLLM은 처리량이 높고 지연 시간이 짧은 서빙과 OpenAI API 호환성을 제공하므로 프로덕션 애플리케이션에 적합합니다. Ollama는 설정이 더 간단하고, 여러 모델을 더 쉽게 관리할 수 있으며, 사용이 간편하여 개발 및 실험에 더 적합합니다. 두 가지를 모두 지원하면 유연성이 제공됩니다. |
결정 2: PersistentVolumeClaims의 모델 가중치
| 컨텍스트 | 주요 결정사항 | 근거 |
|---|---|---|
| vLLM 및 Ollama는 런타임 시 파일 시스템에 모델 가중치가 필요합니다. 에어 갭 환경에서는 모델을 요청 시 다운로드할 수 없습니다. | 각 모델의 가중치를 자체 ReadWriteOnce PersistentVolumeClaim에 저장하고, 임시 모델 로더 포드를 통해 워크스테이션에서 채웁니다. |
PersistentVolumeClaims는 추론 포드 수명 주기와 분리된 대규모 모델 파일에 탄력적이고 영구적인 스토리지 레이어를 제공합니다. 이렇게 하면 포드 시작 시 모델을 빠르게 로드할 수 있습니다. |
결정 3: Ollama (로더 포드)의 PersistentVolumes에 모델 가중치를 이미지에 번들로 묶는 대신 사용
| 컨텍스트 | 주요 결정사항 | 근거 |
|---|---|---|
| Ollama는 모델을 다운로드할 수 있지만, 이를 위해서는 인터넷 액세스가 필요하며, 에어 갭 환경에서는 인터넷 액세스가 불가능합니다. 모델을 커스텀 Ollama 이미지로 번들로 묶으려면 모든 모델에 대해 이미지를 다시 빌드해야 하며 Harbor에 멀티 GB 이미지를 저장해야 합니다. | Ollama는 vLLM과 동일한 로더 포드 워크플로를 사용합니다. 모델은 워크스테이션 (ollama pull~ollama_model_weight_download.sh)에서 가져와 model_weight_upload.sh (GNU tar)를 사용하여 모델 로더 포드를 통해 PVC로 스트리밍되고 OLLAMA_MODELS는 마운트 경로를 가리킵니다. |
두 백엔드 모두에 하나의 워크플로를 사용합니다. 이미지를 다시 빌드하지 않고도 모델을 추가하거나 업데이트할 수 있습니다. 수정되지 않은 업스트림 Ollama 이미지는 Harbor에서 작게 유지됩니다. |
결정 4: LoadBalancer 서비스를 사용하여 vLLM 및 Ollama 노출과 부하 분산기 없음 비교
| 컨텍스트 | 주요 결정사항 | 근거 |
|---|---|---|
| GDC 환경 내의 애플리케이션에서 LLM API에 액세스할 수 있어야 합니다. | 표준 Kubernetes 접근 방식인 LoadBalancer 유형의 서비스를 통해 각 백엔드를 노출합니다. 이는 GDC 에어 갭 플랫폼의 부하 분산기 프로비저닝에 따라 달라집니다. |
LoadBalancer 유형의 Kubernetes 서비스는 LLM 백엔드를 노출하는 표준적이고 안정적인 방법을 제공하여 안정적인 IP 주소를 제공하고 부하를 분산합니다. |
결정 5: 필수 네트워크 정책 적용 (NetworkPolicy 및 ProjectNetworkPolicy)
| 컨텍스트 | 주요 결정사항 | 근거 |
|---|---|---|
| GDC 에어 갭 배포에서는 보안과 격리가 매우 중요합니다. | 모든 LLM 엔드포인트에 네트워크 정책을 적용하여 (서빙 포트만 허용하는 네임스페이스 NetworkPolicy, 프로젝트 외부의 클라이언트가 액세스해야 하는 경우 ProjectNetworkPolicy로 보완) 배포된 LLM 서비스의 보안 상황을 강화합니다. |
NetworkPolicy 객체는 네임스페이스 수준에서 네트워크 격리를 적용하는 Kubernetes 네이티브 방식을 제공하고, ProjectNetworkPolicy 객체는 이를 프로젝트 경계로 확장하여 승인된 트래픽만 LLM 서비스에 도달할 수 있도록 합니다. |
결정 6: 고성능 스토리지 QoS 정책과 페어링된 동적 PVC 적정 크기 조정 (+25% 오버헤드)
| 컨텍스트 | 주요 결정사항 | 근거 |
|---|---|---|
기본 standard-rwo StorageClass는 standard-<org>-admin ONTAP 적응형 QoS 정책 (3,072 IOPS per TiB 또는 3 IOPS per GiB, 최소 75 IOPS)을 적용합니다. standard-rwo PVC의 크기를 모델의 가중치 크기에 맞게 엄격하게 조정하면 순차 가중치 읽기가 5~21MBps로 제한되고, 정적 300~500GiB PVC를 과도하게 프로비저닝하면 스토리지가 낭비되면서 순차 읽기 처리량이 약 60MBps로 제한됩니다. |
먼저 모델 가중치를 다운로드하고, 다운로드한 디렉터리에서 GDCS_MODEL_PVC_SIZE를 동적으로 계산합니다. 이때 25% 의 오버헤드를 다음 정수 GiB로 반올림합니다. 고성능 블록 스토리지가 사용 설정된 storageClassName: performance-rwo를 사용하거나 인프라 운영자에게 백 볼륨에 system-performance-${GDC_ORG}-admin QoS 정책을 적용하도록 요청합니다. |
system-performance-<org>-admin QoS 정책은 최대 204GiB의 모든 볼륨에 대해 6,148 IOPS 최솟값 (ONTAP 최댓값 약 393MBps)으로 30,720 IOPS per TiB (30 IOPS per GiB, standard보다 10배 높음)를 제공합니다. 동적 25% 오버헤드 크기 조정을 system-performance와 함께 사용하면 스토리지 오버프로비저닝이 3~40배 (100Gi~500Gi 대신 12Gi~109Gi) 줄어들고 단일 LUN KubeVirt virtio-scsi 순차 읽기 속도가 최대 150MBps (모델 시작 속도 2.5~30배 향상)로 증가합니다. |
가정 및 제한사항
- GDC 에어 갭 1.16.2 핫픽스 1(
1.16.2-gdch.1353-1) 이상 환경을 사용할 수 있습니다 (표준 클러스터의 GPU 노드 풀에는 이 출시 버전이 필요하며, 이전 출시 버전에서는 공유 클러스터에서만 GPU를 제공함). - 표준 클러스터에 충분한 하드웨어 리소스 (NVIDIA GPU 포함)가 있습니다. vLLM과 Ollama 모두 GPU가 필요합니다.
- Harbor 인스턴스가 설정되고 액세스할 수 있습니다.
- 인터넷 액세스 및 GDC 환경 (Harbor 및 Kubernetes API)에 대한 연결이 있는 워크스테이션을 사용하여 이미지를 시드하고 모델 가중치를 업로드할 수 있습니다.
- 사용자에게 필요한 권한이 있습니다. 프로젝트 역할 Harbor 인스턴스 뷰어 및 표준 클러스터 관리자와 표준 클러스터의 StandardClusterRoleBinding (cluster-admin)이 있습니다. SRI를 참조하세요.
- 모델이 선택한 서빙 백엔드 (vLLM/Ollama)와 호환됩니다.
- 제한사항: 모델 가중치 PVC는
ReadWriteOnce입니다.ReadOnlyManyStorageClass가 없으면 각 모델 배포는 복제본 1개로 제한됩니다.
사용자 플로우
다음은 Google Distributed Cloud (GDC) 에어 갭 환경에 가중치 공개 대규모 언어 모델 (LLM)을 배포하는 포괄적인 사용자 플로우입니다. 흐름은 공통 설정, 두 가지 배포 경로 (vLLM 및 Ollama), 선택적 프런트엔드, 최종 검증으로 나뉩니다.
1. 일반 설정: 이미지 관리
LLM을 배포하기 전에 GDC 환경이 비공개 Harbor 레지스트리에서 컨테이너 이미지를 가져오는 방법을 구성해야 합니다.
- Harbor 로봇 계정 만들기: Harbor UI에서 로봇 계정을 생성합니다. 하나는
crane(이미지 시딩)에 대한 푸시 권한이 있고 다른 하나는 Kubernetes 이미지 가져오기 보안 비밀에 대한 가져오기 권한이 있습니다. - 크레인 및 시드 이미지 인증: 로봇 계정 사용자 인증 정보를 사용하여 인터넷 액세스 권한이 있는 워크스테이션(
crane auth login)에서 Harbor에 로그인하고 필요한 컨테이너 이미지 (busybox,ollama/ollama,vllm/vllm-openai, 선택적으로 Open WebUI)를seed_registry.sh를 사용하여 Harbor에 복사합니다. - Kubernetes 보안 비밀 만들기: kubectl을 사용하여 워크로드 네임스페이스에 docker-registry 보안 비밀을 만들어 클러스터에서 사용할 가져오기 로봇 계정 사용자 인증 정보를 저장합니다.
2. 배포 경로 A: 높은 처리량을 위한 vLLM
이 경로는 GPU에서 Mistral 7B Instruct와 같은 성능 지향 모델을 서빙하는 데 권장됩니다.
- 이미지 획득:
seed_registry.sh를 사용하여 vLLM 이미지 (vllm/vllm-openai:v0.26.0)를 Harbor에 시드한 후 SRI에 설명된 대로 패치된 이미지 태그v0.26.0-fips를 빌드하고 푸시합니다. - 모델 스토리지 준비:
- 워크스테이션 (
hf download)에서 Hugging Face의 가중치를 다운로드합니다. - 다운로드한 가중치 (오버헤드 25%)에서 필요한 PVC 크기를 계산하고, 모델 가중치를 저장할
ReadWriteOnce영구 볼륨 클레임 (PVC)을 만들고, 고성능 QoS 정책을 적용합니다. - PVC를 마운트하는 임시 모델 로더 포드 (
busybox)를 시작하고model_weight_upload.sh를 사용하여 가중치를 스트리밍합니다 (kubectl exec를 통한 GNU tar, BusyBox tar는 8GiB보다 큰 파일의 PAX 헤더를 읽을 수 없으므로kubectl cp는 사용되지 않음). 그런 다음 로더 포드를 삭제합니다.
- 워크스테이션 (
- 백엔드 배포: vLLM 이미지를 참조하고 노드에서 검색된 가속기 리소스(예:
nvidia.com/gpu-pod-NVIDIA_H200)를 요청하고 모델 가중치 PVC를 마운트하는 Kubernetes 배포 매니페스트를 적용합니다. - 서비스 노출: LoadBalancer 서비스를 만들어 vLLM API에 외부 IP를 제공합니다.
- 보안 네트워크: 네임스페이스 NetworkPolicy를 적용하여 서비스 포트 (8000)에서 인그레스 트래픽을 허용합니다. 프로젝트 외부의 클라이언트에 액세스 권한이 필요한 경우 ProjectNetworkPolicy를 추가합니다.
3. 배포 경로 B: 사용 편의성을 위한 Ollama
이 경로는 간소화된 설정에 중점을 둡니다. 업스트림 Ollama 이미지를 변경하지 않고 vLLM과 동일한 모델 로더 워크플로를 사용합니다.
- 시드 이미지:
seed_registry.sh를 사용하여 업스트림 Ollama 이미지 (ollama/ollama:0.32.14)를 Harbor에 복사합니다. - 모델 스토리지 준비:
ollama_model_weight_download.sh를 사용하여 워크스테이션에서 모델 (예:gemma4:e4b)을 가져옵니다. 그러면 다운로드 디렉터리를 가리키는OLLAMA_MODELS를 사용하여 임시 로컬ollama serve가 실행됩니다.- 다운로드한 가중치 (오버헤드 25%)에서 필요한 PVC 크기를 계산하고,
ReadWriteOncePVC를 만들고, 고성능 QoS 정책을 적용하고, 이를 마운트하는 임시 모델 로더 포드를 시작합니다. model_weight_upload.sh를 사용하여 다운로드 디렉터리를 PVC에 업로드한 후 로더 포드를 삭제합니다.
- 배포 및 노출: PVC 마운트 경로 (노드에서 검색된 가속기 리소스 요청)와 LoadBalancer 서비스를 가리키는
OLLAMA_MODELS로 Ollama 배포를 만듭니다. - 보안 네트워크: Ollama 포트(11434)에 네임스페이스 NetworkPolicy를 적용합니다. 프로젝트 외부의 클라이언트에 액세스 권한이 필요한 경우 ProjectNetworkPolicy를 추가합니다.
4. 선택사항: WebUI 열기
- Open WebUI 배포: Open WebUI 이미지를 Harbor에 시드하고 상태에 대한 영구 스토리지가 있는 자체 네임스페이스에 배포합니다. vLLM 서비스, Ollama 서비스 또는 둘 다의 OpenAI 호환
/v1엔드포인트를 가리킵니다. 단계는 개방형 가중치 모델용 Open WebUI 사용자 가이드에 나와 있습니다.
5. 검증 및 테스트
배포가 완료되면 마지막 단계로 서비스가 작동하는지 확인합니다.
- 상태 확인: 포드가 실행 중이고 서비스에 외부 IP 주소가 할당되었는지 확인합니다.
- 추론 테스트:
- vLLM: OpenAI 호환
/v1/models및/v1/chat/completions엔드포인트를 사용하여 vLLM LoadBalancer IP에 curl 요청을 전송합니다. - Ollama: 동일한 OpenAI 호환
/v1/models및/v1/chat/completions엔드포인트를 사용하여 Ollama LoadBalancer IP에 curl 요청을 보냅니다.
- vLLM: OpenAI 호환
- 포트 전달 대체: 워크스테이션에서 LoadBalancer IP에 연결할 수 없는 경우 (예: ProjectNetworkPolicy가 아직 마련되지 않음) 서비스에
kubectl port-forward를 사용하고 동일한 요청을127.0.0.1에 전송합니다.
6. 작업 및 확장
- 수직 확장: GPU 슬라이스를 늘리거나 더 큰 모델을 위해 멀티 GPU 구성으로 이동합니다.
- 수평 확장: 배포의 복제본 수를 늘리거나(
ReadOnlyMany모델 볼륨 필요) 추가 모델 배포를 배포하여 더 많은 동시 사용자 요청을 처리합니다. - 문제 해결:
kubectl logs를 사용하여 로그를 모니터링하고 FIPS 자체 테스트 실패 또는 네트워크 정책 제한과 같은 일반적인 문제를 확인합니다.
자세한 단계는 Ollama를 사용한 개방형 가중치 모델 참조 구현, vLLM을 사용한 개방형 가중치 모델 참조 구현 및 해당 사용자 가이드에 나와 있습니다.
추가 자료
- Ollama 참조 구현을 사용한 가중치 공개 모델
- vLLM 참조 구현이 포함된 개방형 가중치 모델
- Ollama를 사용한 Gemma 4 E4B 사용자 가이드
- [SUG] GDC 에어 갭에서 vLLM을 사용하는 Mistral 7B Instruct
- [SUG] GDC 에어 갭에서 vLLM을 사용한 Mistral NeMo 12B Instruct
- [SUG] GDC 에어 갭에서 vLLM을 사용하는 Mistral Small 3.2 24B Instruct
- [SUG] GDC 에어 갭에서 vLLM을 사용하는 Ministral 8B Instruct
- [SUG] GDC 에어 갭에서 vLLM을 사용하는 Mixtral 8x7B Instruct
- [SUG] GDC 에어 갭에서 vLLM을 사용하는 Magistral Small 1.2 24B
- 가중치 공개 모델용 Open WebUI 사용자 가이드
- vLLM 문서
- Ollama
- Open WebUI
- 에어 갭이 적용된 Google Distributed Cloud 문서