


Énoncé du problème
Les organisations qui opèrent dans des environnements sous air gap sont confrontées à un défi de taille : elles ont besoin de grands modèles de langage, mais ne sont pas autorisées à se connecter à des API externes dans le cloud en raison de protocoles de sécurité rigoureux. Pour combler cette lacune, ces clients ont besoin d'un écosystème robuste et autonome capable d'héberger et de gérer des modèles de pondérations ouverts directement sur leur infrastructure Google Distributed Cloud (GDC) sous air gap. Ce déploiement localisé est essentiel pour maintenir une souveraineté absolue des données, en garantissant que les informations sensibles ne quittent jamais les locaux physiques. En intégrant des environnements d'exécution sécurisés aux backends de diffusion, les utilisateurs peuvent exploiter des fonctionnalités d'IA avancées tout en conservant un contrôle administratif total sur leurs données, les pondérations de leurs modèles et leur stratégie de sécurité interne.
Bien que Gemini sur GDC fournisse des fonctionnalités de pointe gérées et puissantes, les clients déploient souvent des modèles à pondération ouverte comme Gemma 4 ou Llama 4 pour une précision et un contrôle accrus. Le déploiement de modèles à pondération ouverte sur des environnements GDC sous air gap offre des avantages financiers significatifs par rapport aux services propriétaires gérés. En possédant les pondérations du modèle, les organisations éliminent les frais d'API par jeton récurrents, qui peuvent devenir prohibitifs pour les charges de travail automatisées à volume élevé. De plus, les modèles à pondérations ouvertes permettent la quantification (par exemple, 4 bits ou 8 bits), ce qui permet d'exécuter un raisonnement hautes performances sur des empreintes matérielles plus petites et moins coûteuses en périphérie. Cette optimisation verticale, combinée à la possibilité de partager l'infrastructure entre plusieurs applications internes sans frais de licence supplémentaires, se traduit par un coût total de possession (TCO) nettement inférieur pour les opérations d'inférence soutenues et à grande échelle.
Solution proposée
Ce document présente l'architecture de référence pour le déploiement et la gestion de grands modèles de langage (LLM) à pondération ouverte dans des environnements Google Distributed Cloud (GDC) air-gapped. De nombreux clients, en particulier ceux des secteurs hautement réglementés, ne peuvent pas utiliser d'API LLM basées sur le cloud en raison d'exigences strictes en matière de souveraineté et de sécurité des données. Cette architecture répond au besoin d'exécuter des LLM puissants localement dans leur propre instance GDC sécurisée.
Ce qui est inclus : cette architecture couvre le déploiement de modèles à pondération ouverte (tels que Gemma 4, Llama, DeepSeek et Mistral) à l'aide des backends de diffusion vLLM ou Ollama. Il inclut l'utilisation de Kubernetes pour l'orchestration, de Harbor pour le stockage des artefacts, de volumes persistants pour les pondérations de modèle, de règles de réseau (NetworkPolicy / ProjectNetworkPolicy) pour la sécurité du réseau et d'Open WebUI en tant qu'interface de navigateur facultative.
Ce qui n'est pas inclus : cette architecture ne couvre pas les services de passerelle d'IA gérés, les modèles propriétaires tels que le modèle Gemini de Google, les processus d'affinage des modèles ni les modèles d'IA générative pour d'autres modalités telles que la génération d'images.
Public : ce document s'adresse principalement aux administrateurs de plate-forme chargés de déployer et de gérer des services sur GDC, ainsi qu'aux architectes techniques qui conçoivent des solutions d'IA dans l'environnement air gap. Les utilisateurs finaux et les développeurs qui interagiront avec les modèles déployés sont des audiences secondaires qui ont intérêt à comprendre la structure sous-jacente.
Architecture
La solution déploie vLLM, Ollama ou les deux en tant que backends de diffusion d'inférence conteneurisés (Deployment) dans un cluster standard. Les pondérations du modèle sont stockées sur des volumes persistants qui sont renseignés à partir du poste de travail via un chargeur de modèle Pod. Les Service Kubernetes de type LoadBalancer exposent les API de backend, les objets NetworkPolicy / ProjectNetworkPolicy sécurisent l'accès à celles-ci, et Open WebUI peut éventuellement être déployé en tant qu'interface de navigateur pour les API compatibles avec OpenAI.
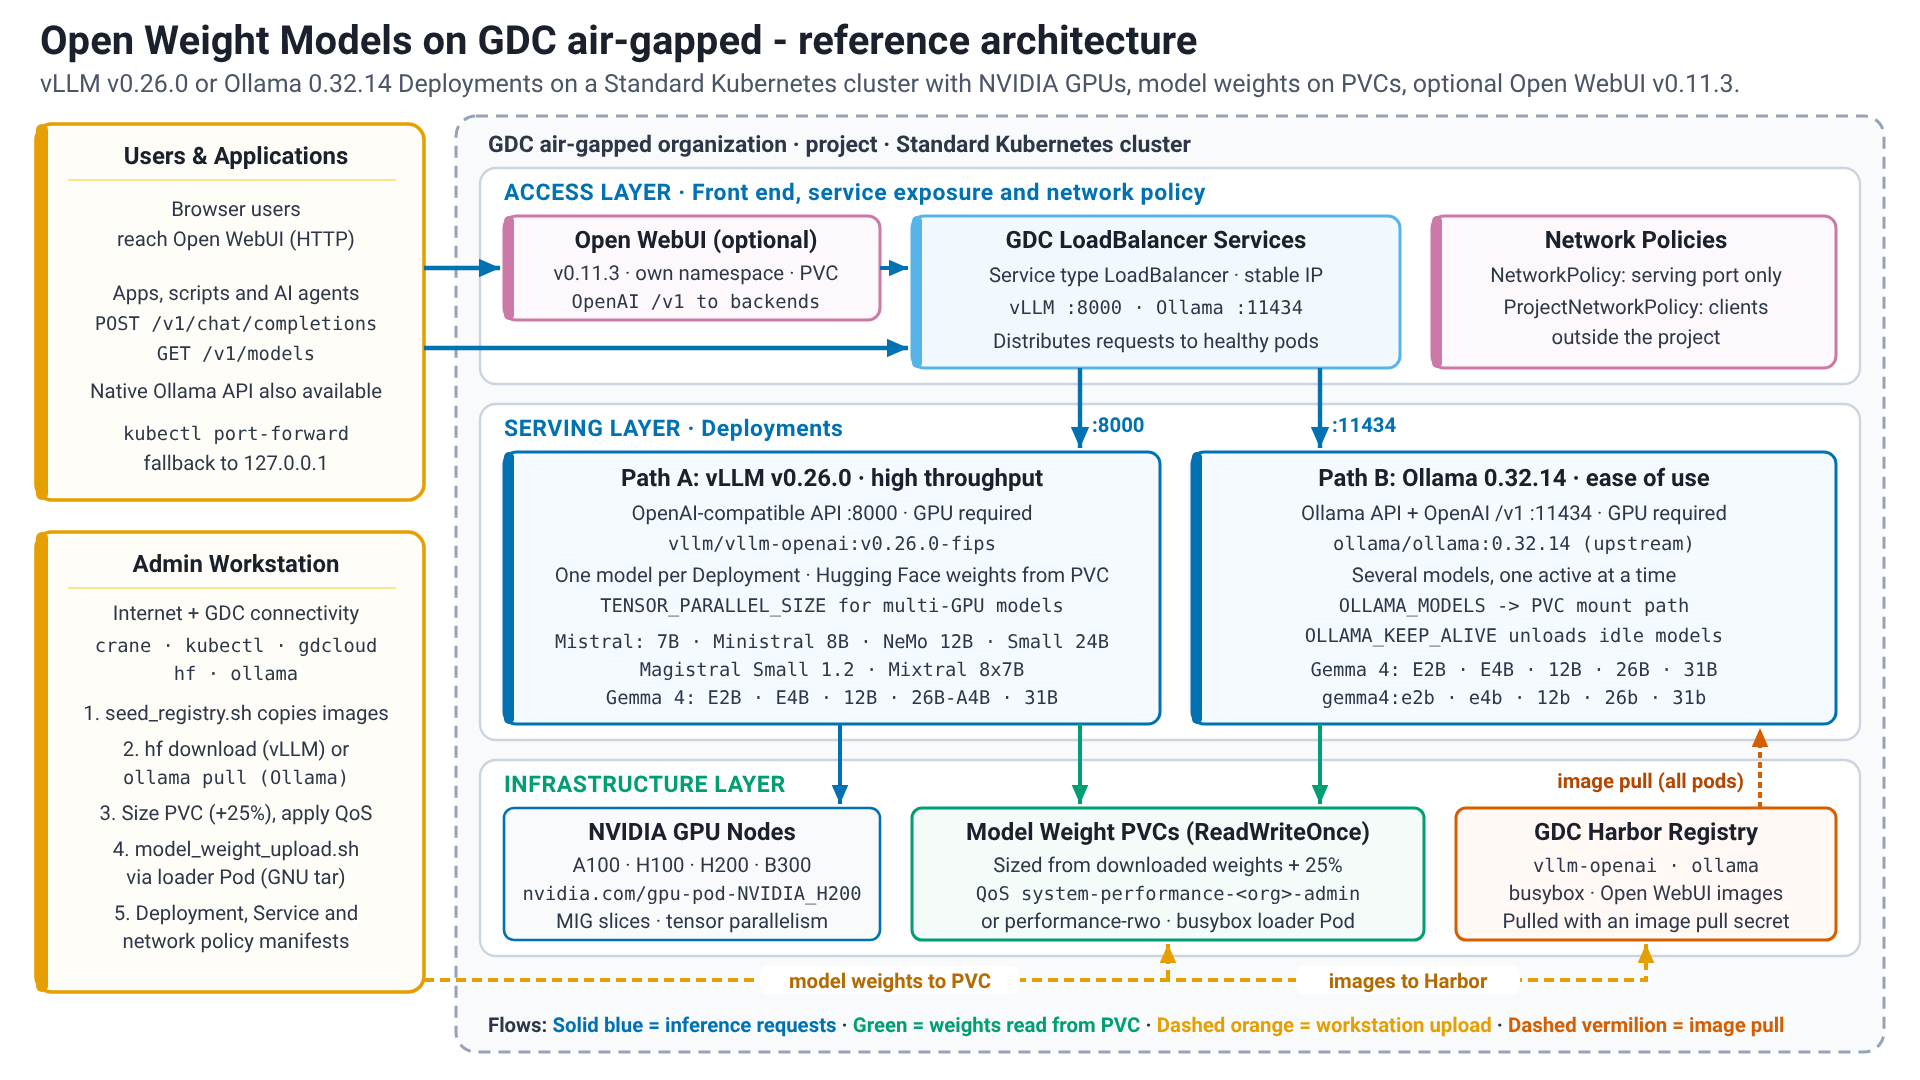
Composants de la solution
La solution utilise les composants suivants :
| Composant de la solution | Responsabilités | Flux de données | Interfaces |
|---|---|---|---|
| Zone client GDC sous air gap | Héberge les clusters Kubernetes, la mise en réseau et l'infrastructure de stockage | Plate-forme de base | Interfaces de gestion de l'infrastructure pour l'IO. API Kubernetes pour les administrateurs de plate-forme et les utilisateurs |
| Équilibreur de charge | Expose les pods de diffusion de LLM (vLLM, Ollama) au trafic provenant de l'extérieur du cluster Kubernetes, en fournissant une adresse IP stable. | Les requêtes des clients externes sont envoyées à l'adresse IP externe de l'équilibreur de charge. L'équilibreur de charge répartit les requêtes entre les pods de backend opérationnels (vLLM ou Ollama) en fonction du sélecteur du service. | API de service Kubernetes. Provisionne automatiquement un équilibreur de charge réseau dans l'environnement GDC. |
| vLLM | Diffusion d'inférence LLM à haut débit. Optimisé pour une faible latence à l'aide de techniques telles que PagedAttention. Diffuse généralement un modèle par instance. | Reçoit les requêtes d'inférence HTTP des clients. Charge les pondérations du modèle à partir du PVC installé. Effectue des calculs sur les GPU associés. Renvoie des réponses HTTP avec du texte généré. | API RESTful compatible avec OpenAI pour l'inférence. Accepte les requêtes JSON. |
| Ollama | Mise en service de l'inférence LLM, conçue pour être facile à utiliser : une instance peut diffuser plusieurs modèles et les charger à la demande. | Reçoit les requêtes d'inférence HTTP. Charge les modèles à partir du PVC installé (OLLAMA_MODELS). Effectue des calculs sur les GPU associés. Renvoie des réponses HTTP. Les modèles sont déchargés après une période d'inactivité configurable (OLLAMA_KEEP_ALIVE). |
API RESTful Ollama et API compatible avec OpenAI (/v1). Accepte les requêtes JSON. Il dispose également d'une CLI. |
| GPU NVIDIA et MIG | Fournir une accélération matérielle pour l'inférence LLM. | Les backends LLM (vLLM, Ollama) déchargent les calculs de modèle intensifs (comme les multiplications matricielles) sur les GPU pour accélérer l'inférence. Le MIG permet de partitionner un seul GPU pour l'utiliser avec plusieurs instances de modèle plus petites. | Exposé en tant que type de ressource dans Kubernetes (par exemple, nvidia.com/gpu-pod-NVIDIA_H200 ; le nom exact de la ressource dépend du modèle de GPU installé et est détecté à partir des nœuds). Les pods demandent ces ressources |
| Harbor | Stocke et gère de manière sécurisée les images de conteneurs pour vLLM, Ollama, Open WebUI et tous les pods d'assistance (comme busybox) | Les images de conteneurs sont copiées depuis des registres publics vers Harbor avec seed_registry.sh (crane) à partir d'un poste de travail disposant d'un accès à Internet. Les nœuds Kubernetes extraient ces images de Harbor pour exécuter des conteneurs. |
API Docker Registry. Les nœuds Kubernetes s'interfacent avec Harbor pour extraire des images lors de la création des pods. Les utilisateurs se servent de crane, de la CLI Docker ou de l'interface utilisateur Harbor pour transférer des images. |
| Demandes de volume persistant | Fournit un stockage persistant pour les pondérations de modèle LLM, dissocié des cycles de vie des pods. | Les fichiers de modèle sont téléchargés sur le poste de travail, utilisés pour calculer de manière dynamique la taille de la PVC avec une surcharge de 25 %, puis diffusés dans le volume persistant via un pod de chargement de modèle temporaire (busybox) avec model_weight_upload.sh. La PVC est provisionnée avec performance-rwo lorsque le stockage de blocs hautes performances est activé. Sinon, un opérateur d'infrastructure applique la règle de QoS system-performance-<org>-admin à son volume de sauvegarde. Les deux options fournissent 30 IOPS par Gio (6 148 IOPS minimum). Les deux backends lisent les pondérations de leur modèle à partir de ce volume installé au démarrage : vLLM charge le répertoire du modèle Hugging Face, et Ollama pointe OLLAMA_MODELS vers le chemin d'installation. Aucun kubectl cp n'est utilisé et aucun modèle n'est intégré aux images de conteneur. |
API de stockage Kubernetes. Définis en YAML (ReadWriteOnce) et installés dans les pods en tant que volumes. |
| Règles de réseau | Appliquez l'isolation du réseau et contrôlez le flux de trafic vers les services LLM. Un espace de noms NetworkPolicy (networking.k8s.io/v1) autorise le trafic vers le port de diffusion depuis l'intérieur du cluster. Un ProjectNetworkPolicy (networking.gdc.goog/v1) est également requis pour l'accès depuis l'extérieur du projet. |
Le trafic réseau vers et depuis les pods de l'espace de noms est inspecté. Les règles de stratégie déterminent si les connexions aux ports du service LLM (par exemple, 8000 pour vLLM, 11434 pour Ollama) sont autorisées, généralement en fonction des plages d'adresses IP sources ou d'autres étiquettes. | API Kubernetes networking.k8s.io/v1 et networking.gdc.goog/v1. Définie en YAML. |
| Ouvrir WebUI | Interface facultative basée sur un navigateur pour les utilisateurs finaux. Il communique avec les API compatibles avec OpenAI de vLLM et Ollama. Il ne contient pas de pondérations de modèle et ne nécessite pas d'accélérateur. | Les utilisateurs accèdent à Open WebUI via son service Kubernetes. Open WebUI transfère les requêtes de chat aux services vLLM et Ollama via l'API /v1 compatible avec OpenAI et conserve son propre état (utilisateurs, chats, paramètres) sur un volume persistant. |
HTTP (navigateur) vers les utilisateurs, API REST compatible avec OpenAI vers les backends. Charge de travail avec état déployée dans son propre espace de noms. |
Fonctionnalités et capacités
Cette architecture de référence offre les fonctionnalités de base suivantes :
- Mise en service de LLM à pondération ouverte : permet l'hébergement et l'inférence de divers modèles à pondération ouverte (par exemple, Gemma 4, Llama, DeepSeek, Mistral).
- Composants : backends de diffusion LLM (vLLM, Ollama), déploiements/pods Kubernetes.
- Responsabilités : charger les pondérations du modèle, gérer le processus d'inférence, exécuter les modèles sur des accélérateurs matériels et exposer les points de terminaison.
- Interfaces : API REST (compatibles avec OpenAI pour vLLM et Ollama, plus l'API spécifique à Ollama) pour les requêtes d'inférence, généralement au format JSON.
- Bring Your Own Model (BYOM) : les utilisateurs peuvent importer et déployer les LLM à pondération ouverte de leur choix dans l'environnement sous air gap.
- Composants : Harbor, demandes de volumes persistants, pod de chargement de modèle, Kubernetes.
- Responsabilités : stockage sécurisé des images de conteneurs et des pondérations de modèles. Mécanisme permettant de transférer des modèles dans l'environnement (
model_weight_upload.shvia le pod de chargement) et de les rendre accessibles aux moteurs de diffusion. - Interfaces : API Docker Registry (pour Harbor), API Kubernetes (pour les PVC et les installations de volumes).
- Inférence avec accélération matérielle : utilise les GPU NVIDIA du cluster GDC pour exécuter efficacement les inférences de LLM.
- Composants : GPU NVIDIA, Kubernetes, plug-ins d'appareils.
- Responsabilités : planifier des pods sur des nœuds disposant de ressources GPU.
Exposer le matériel GPU aux conteneurs de backend LLM. Compatible avec le GPU multi-instance (MIG) pour le partitionnement et le parallélisme de tenseurs multi-GPU (
TENSOR_PARALLEL_SIZE) pour les grands modèles tels que Mixtral 8x7Bbf16. - Interfaces : API Kubernetes (pour demander des ressources GPU telles que
nvidia.com/gpu-pod-NVIDIA_H200ounvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE).
- Accès contrôlé au réseau : garantit que l'accès aux points de terminaison d'inférence LLM est contrôlé et isolé dans l'environnement GDC.
- Composants : services Kubernetes (LoadBalancer), NetworkPolicy, ProjectNetworkPolicy.
- Responsabilités : exposer les services d'inférence à l'aide d'une adresse IP stable. Définir et appliquer des règles réseau pour autoriser ou refuser le trafic vers les backends de LLM en fonction de la source, de la destination et des ports.
- Interfaces : API Kubernetes (pour les services, NetworkPolicy et ProjectNetworkPolicy).
- Mise en service évolutive : permet d'ajuster la capacité en fonction de la demande.
- Composants : déploiements Kubernetes.
- Responsabilités : activer le scaling horizontal en augmentant le nombre d'instances répliquées pour les pods de backend LLM. Scaling vertical en ajustant les demandes/limites de ressources.
- Interfaces : API Kubernetes (pour gérer les instances répliquées et les ressources du déploiement).
- Interface de navigateur (facultatif) : permet aux utilisateurs finaux de discuter avec les modèles déployés sans écrire d'appels d'API.
- Composants : déploiement, service et PersistentVolumeClaim Open WebUI.
- Responsabilités : présenter les modèles diffusés par vLLM et Ollama dans une seule interface ; conserver les utilisateurs, les discussions et les paramètres.
- Interfaces : HTTP (navigateur) ; API
/v1compatible avec OpenAI vers les backends.
Principes architecturaux
- La sécurité avant tout : tous les composants et toutes les données résident dans la limite de l'environnement isolé de GDC, ce qui garantit une sécurité et un contrôle optimaux des données. L'accès au réseau est limité à l'aide des objets
NetworkPolicyetProjectNetworkPolicy. - Souveraineté des données : les clients gardent le contrôle total de leurs modèles et de leurs données, sans qu'une connectivité externe soit nécessaire pour le fonctionnement.
- Ouverte et flexible : l'architecture utilise des backends de diffusion Open Source (vLLM, Ollama) et est compatible avec divers LLM à pondération ouverte, ce qui offre un choix aux clients et évite la dépendance vis-à-vis d'un fournisseur pour le moteur d'inférence.
- Découplage des composants : les fonctions clés telles que le stockage des modèles (PVC), la gestion des images (Harbor), la diffusion d'inférence (pods vLLM/Ollama) et l'interface utilisateur (Open WebUI) sont des composants distincts, ce qui permet une gestion et des mises à jour indépendantes.
- Évolutivité et performances : conçu pour évoluer à la fois horizontalement en augmentant le nombre d'instances répliquées de pods et verticalement en ajustant les ressources de processeur/GPU (y compris le parallélisme de tenseurs multi-GPU) pour répondre aux exigences de performances. vLLM est choisi pour les scénarios à haut débit et à faible latence.
- Optimisation des ressources : compatible avec les GPU multi-instances (MIG) NVIDIA pour permettre aux modèles plus petits de partager efficacement les ressources GPU, et dimensionnement dynamique des PVC (+25% de surcharge) associé à une QoS de stockage hautes performances pour éliminer le surprovisionnement du stockage sans sacrifier la vitesse de chargement des modèles.
- Interfaces standards : basées sur les normes Kubernetes pour l'orchestration, le déploiement et l'exposition des services. Les points de terminaison d'inférence fournissent des API REST, vLLM et Ollama offrant une compatibilité avec OpenAI.
- Résilience : utilise les vérifications d'état et la réplication Kubernetes pour garantir la disponibilité du service.
Remarques
- Évolutivité et performances :
- Le scaling horizontal est obtenu en augmentant le nombre d'instances répliquées dans le déploiement Kubernetes pour vLLM et Ollama. Sans StorageClass
ReadOnlyMany, un déploiement de modèle est limité à une instance répliquée (le volume du modèle estReadWriteOnce). La capacité supplémentaire provient alors de déploiements supplémentaires, chacun avec sa propre PVC. - Le scaling vertical implique d'allouer plus de CPU/mémoire et des tranches de GPU plus grandes, jusqu'à des GPU complets ou un parallélisme de tenseur multi-GPU (
TENSOR_PARALLEL_SIZE) sur plusieurs GPU du même nœud. - vLLM diffuse un modèle par instance, ce qui nécessite de nouveaux déploiements pour les modèles supplémentaires. Ollama peut diffuser plusieurs modèles à partir d'une seule instance. Dans ces guides, chaque déploiement Ollama diffuse un modèle.
- La taille du PVC de chaque modèle est dimensionnée de manière dynamique à partir de ses pondérations téléchargées avec une surcharge de 25% et configurée avec la règle de QoS de stockage hautes performances (
system-performance-<org>-admin, 30 IOPS par Gio avec un plancher de 6 148 IOPS, ouperformance-rwooù le stockage de blocs hautes performances est activé) afin que les temps de chargement du modèle ne soient pas limités par la limite par défaut destandard-rwode 3 IOPS par Gio.
- Le scaling horizontal est obtenu en augmentant le nombre d'instances répliquées dans le déploiement Kubernetes pour vLLM et Ollama. Sans StorageClass
- Gestion des ressources :
- Il est essentiel de planifier soigneusement les ressources GPU. NVIDIA MIG peut être utilisé pour partitionner les GPU pour les modèles plus petits, ce qui améliore l'utilisation, tandis que les modèles plus grands (comme Mixtral 8x7B dans
bf16) peuvent segmenter les pondérations sur plusieurs GPU à l'aide du parallélisme de tenseur. - Vous devez allouer suffisamment de processeur et de mémoire pour gérer à la fois l'inférence et la surcharge de gestion des modèles. vLLM et Ollama diffusent des modèles avec accélération GPU.
- Un espace de stockage suffisant doit être provisionné pour les PVC afin de s'adapter à la taille des modèles et de garantir les performances.
- Il est essentiel de planifier soigneusement les ressources GPU. NVIDIA MIG peut être utilisé pour partitionner les GPU pour les modèles plus petits, ce qui améliore l'utilisation, tandis que les modèles plus grands (comme Mixtral 8x7B dans
- Disponibilité et fiabilité :
- Les déploiements Kubernetes offrent des fonctionnalités d'autoréparation et de mise à jour progressive.
- Les services LoadBalancer répartissent le trafic entre les pods opérationnels, masquant ainsi les défaillances de pods individuels.
- Le stockage des pondérations de modèle sur des PVC garantit la persistance lors des redémarrages des pods.
- Complexité opérationnelle :
- Gérer les images de conteneurs pour différents backends et versions dans Harbor.
- Procédures de transfert sécurisé des pondérations de modèle vers l'environnement sous air gap.
- Créer et gérer des fichiers manifestes Kubernetes (déploiements, services, PVC, règles de réseau) pour chaque modèle et backend.
- Surveiller l'utilisation des GPU, la latence d'inférence et les taux d'erreur.
- Sécurité et conformité :
- L'ensemble de la solution fonctionne dans le périmètre de sécurité isolé de GDC.
- Les règles de réseau sont obligatoires pour appliquer une isolation réseau stricte et contrôler l'accès aux points de terminaison LLM : un espace de noms
NetworkPolicypour l'accès au cluster et unProjectNetworkPolicypour l'accès depuis l'extérieur du projet. - Les comptes de robot Harbor et les secrets d'extraction d'images Kubernetes garantissent un accès sécurisé aux images de conteneurs.
- Les règles de réseau limitent les clients pouvant atteindre les points de terminaison. Les données au repos sur les PVC reposent sur le chiffrement du stockage GDC.
Décisions de conception
Les décisions de conception clés suivantes ont été prises pour cette architecture de référence :
Décision 1 : Proposer à la fois vLLM et Ollama au lieu d'un seul backend de diffusion
| Contexte | Décision clé | Explication |
|---|---|---|
| Proposer un backend de diffusion (vLLM ou Ollama) ou les deux. | Proposez les deux, car les utilisateurs et les cas d'utilisation ont des exigences différentes en termes de performances, de compatibilité des API et de facilité de gestion des modèles. | vLLM fournit une diffusion à haut débit et à faible latence, ainsi qu'une compatibilité avec l'API OpenAI, adaptée aux applications de production. Ollama offre une configuration plus simple, une gestion plus facile de plusieurs modèles et une utilisation plus aisée, ce qui est idéal pour le développement et l'expérimentation. La prise en charge des deux types de requêtes offre une grande flexibilité. |
Décision 2 : Poids du modèle sur les PersistentVolumeClaims
| Contexte | Décision clé | Explication |
|---|---|---|
| vLLM et Ollama nécessitent des pondérations de modèle sur le système de fichiers au moment de l'exécution. Dans un environnement sous air gap, les modèles ne peuvent pas être téléchargés à la demande. | Stockez les pondérations de chaque modèle sur son propre PersistentVolumeClaim ReadWriteOnce, renseigné à partir du poste de travail via un pod de chargement de modèle temporaire. |
Les PersistentVolumeClaims fournissent une couche de stockage résiliente et persistante pour les fichiers de modèle volumineux, dissociée du cycle de vie du pod d'inférence. Cela permet de charger rapidement les modèles au démarrage du pod. |
Décision 3 : Poids du modèle sur les PersistentVolumes pour Ollama (pod de chargement) au lieu de les regrouper dans l'image
| Contexte | Décision clé | Explication |
|---|---|---|
| Ollama peut télécharger des modèles, mais cela nécessite un accès à Internet, qui n'est pas disponible dans les environnements sous air gap. Le regroupement des modèles dans une image Ollama personnalisée nécessite de recréer une image pour chaque modèle et de stocker des images de plusieurs gigaoctets dans Harbor. | Ollama utilise le même workflow de pod de chargement que vLLM : le modèle est extrait sur le poste de travail (ollama pull via ollama_model_weight_download.sh), transmis au PVC via le pod de chargement de modèle avec model_weight_upload.sh (GNU tar), et OLLAMA_MODELS pointe vers le chemin d'installation. |
Un seul workflow pour les deux backends ; les modèles peuvent être ajoutés ou mis à jour sans recréer d'images ; l'image Ollama en amont non modifiée reste petite dans Harbor. |
Décision 4 : Exposer vLLM et Ollama à l'aide de services LoadBalancer ou sans équilibreur de charge
| Contexte | Décision clé | Explication |
|---|---|---|
| Les API de LLM doivent être accessibles aux applications de l'environnement GDC. | Exposez chaque backend via un service de type LoadBalancer, l'approche Kubernetes standard. Cela repose sur le provisionnement de l'équilibreur de charge de la plate-forme GDC sous air gap. |
Les services Kubernetes de type LoadBalancer fournissent une méthode standard et fiable pour exposer les backends LLM, en fournissant une adresse IP stable et en répartissant la charge. |
Décision 5 : Appliquer des règles de réseau obligatoires (NetworkPolicy et ProjectNetworkPolicy)
| Contexte | Décision clé | Explication |
|---|---|---|
| La sécurité et l'isolation sont essentielles dans les déploiements GDC sous air gap. | Appliquez des règles de réseau sur chaque point de terminaison de LLM (un espace de noms NetworkPolicy qui n'accepte que le port de diffusion, complété par un ProjectNetworkPolicy lorsque des clients extérieurs au projet ont besoin d'un accès) pour améliorer la stratégie de sécurité des services de LLM déployés. |
Les objets NetworkPolicy permettent d'appliquer l'isolation réseau au niveau de l'espace de noms de manière native dans Kubernetes, et les objets ProjectNetworkPolicy l'étendent à la limite du projet, ce qui garantit que seul le trafic autorisé peut atteindre les services LLM. |
Décision 6 : Dimensionnement dynamique des PVC (+25% de surcharge) associé à une règle de QoS de stockage hautes performances
| Contexte | Décision clé | Explication |
|---|---|---|
La StorageClass standard-rwo par défaut applique la règle de QoS adaptative ONTAP standard-<org>-admin (3,072 IOPS per TiB ou 3 IOPS per GiB, avec un plancher minimal de 75 IOPS). Le dimensionnement d'un PVC standard-rwo strictement en fonction de la taille des pondérations d'un modèle limite les lectures séquentielles des pondérations à une vitesse comprise entre 5 et 21 Mo/s. De plus, le surprovisionnement de PVC statiques de 300 à 500 Gio gaspille de l'espace de stockage tout en plafonnant le débit de lecture séquentielle à environ 60 Mo/s. |
Téléchargez d'abord les pondérations du modèle, calculez dynamiquement GDCS_MODEL_PVC_SIZE à partir du répertoire téléchargé avec une surcharge de 25% arrondie au Gio entier supérieur, et utilisez storageClassName: performance-rwo où le stockage de blocs hautes performances est activé, ou demandez à un opérateur d'infrastructure d'appliquer la règle de QoS system-performance-${GDC_ORG}-admin au volume de sauvegarde. |
La règle de QoS system-performance-<org>-admin fournit 30,720 IOPS per TiB (30 IOPS per GiB, soit 10 fois plus que standard) avec un seuil minimal de 6,148 IOPS (plafond ONTAP d'environ 393 Mo/s) pour tout volume jusqu'à 204 Gio. L'association d'un dimensionnement dynamique avec une marge de 25 % à system-performance élimine le surprovisionnement de l'espace de stockage de 3x à 40x (12Gi à 109Gi au lieu de 100Gi à 500Gi) tout en augmentant la vitesse de lecture séquentielle virtio-scsi de KubeVirt sur un seul LUN à environ 150 Mo/s (démarrage du modèle 2,5x à 30x plus rapide). |
Hypothèses et limites
- Un environnement GDC sous air gap 1.16.2 hotfix 1 (
1.16.2-gdch.1353-1) ou version ultérieure est disponible (les pools de nœuds GPU dans les clusters standards nécessitent cette version ; les versions antérieures ne proposent des GPU que dans les clusters partagés). - Le cluster standard dispose de ressources matérielles suffisantes (y compris des GPU NVIDIA). vLLM et Ollama nécessitent tous deux un GPU.
- L'instance Harbor est configurée et accessible.
- Une station de travail avec un accès à Internet et une connectivité à l'environnement GDC (API Harbor et Kubernetes) est disponible pour l'amorçage des images et l'importation des pondérations de modèle.
- Les utilisateurs disposent des autorisations nécessaires : rôles de projet "Lecteur d'instance Harbor" et "Administrateur de cluster standard", ainsi qu'un StandardClusterRoleBinding (cluster-admin) sur le cluster standard (voir les SRI).
- Les modèles sont compatibles avec les backends de diffusion choisis (vLLM/Ollama).
- Limitation : la PVC de pondération du modèle est
ReadWriteOnce. Sans StorageClassReadOnlyMany, chaque déploiement de modèle est limité à une instance répliquée.
Parcours utilisateur
Voici un parcours utilisateur complet pour déployer des grands modèles de langage (LLM) à pondération ouverte sur des environnements avec air gap Google Distributed Cloud (GDC). Le flux est divisé en une configuration commune, deux chemins de déploiement (vLLM et Ollama), une interface facultative et une validation finale.
1. Configuration courante : gestion des images
Avant de déployer un LLM, vous devez configurer la manière dont l'environnement GDC extraira les images de conteneur de votre registre Harbor privé.
- Créer des comptes de robot Harbor : générez des comptes de robot dans l'interface utilisateur de Harbor : un avec des autorisations d'envoi pour
crane(amorçage d'image) et un avec des autorisations d'extraction pour le secret d'extraction d'image Kubernetes. - Authentifier les images de grue et d'amorçage : utilisez les identifiants du compte de robot pour vous connecter à Harbor depuis un poste de travail disposant d'un accès à Internet (
crane auth login) et copiez les images de conteneur requises (busybox,ollama/ollama,vllm/vllm-openai, éventuellement Open WebUI) dans Harbor avecseed_registry.sh. - Créer un secret Kubernetes : créez un secret docker-registry dans l'espace de noms de la charge de travail à l'aide de kubectl pour stocker les identifiants du compte de robot d'extraction que le cluster doit utiliser.
2. Chemin de déploiement A : vLLM pour un débit élevé
Ce chemin est recommandé pour diffuser des modèles axés sur les performances, comme Mistral 7B Instruct, sur des GPU.
- Acquérir l'image : amorcez l'image vLLM (
vllm/vllm-openai:v0.26.0) dans Harbor avecseed_registry.sh, puis créez et transférez le tag d'image corrigév0.26.0-fipscomme décrit dans le SRI. - Préparer le stockage du modèle :
- Téléchargez les pondérations depuis Hugging Face sur le poste de travail (
hf download). - Calculez la taille de PVC requise à partir des pondérations téléchargées (avec une surcharge de 25 %), créez une revendication de volume persistant (PVC)
ReadWriteOncepour stocker les pondérations du modèle, puis appliquez la règle de QoS hautes performances. - Démarrez un pod de chargement de modèle temporaire (
busybox) qui installe le PVC et diffuse les pondérations dans celui-ci avecmodel_weight_upload.sh(GNU tar surkubectl exec;kubectl cpn'est pas utilisé, car BusyBox tar ne peut pas lire ses en-têtes PAX pour les fichiers de plus de 8 Gio), puis supprimez le pod de chargement.
- Téléchargez les pondérations depuis Hugging Face sur le poste de travail (
- Déployer le backend : appliquez un fichier manifeste de déploiement Kubernetes qui référence l'image vLLM, demande la ressource d'accélérateur découverte à partir des nœuds (par exemple,
nvidia.com/gpu-pod-NVIDIA_H200) et installe le PVC de pondération du modèle. - Exposer le service : créez un service LoadBalancer pour fournir une adresse IP externe à l'API vLLM.
- Réseau sécurisé : appliquez un objet NetworkPolicy d'espace de noms pour autoriser le trafic entrant sur le port de service (8000). Ajoutez un objet ProjectNetworkPolicy lorsque des clients extérieurs au projet ont besoin d'un accès.
3. Chemin de déploiement B : Ollama pour la facilité d'utilisation
Ce parcours se concentre sur une configuration simplifiée. Il utilise l'image Ollama en amont sans modification et le même workflow de chargeur de modèle que vLLM.
- Image source : copiez l'image Ollama en amont (
ollama/ollama:0.32.14) dans Harbor avecseed_registry.sh. - Préparer le stockage du modèle :
- Extrayez le modèle (par exemple,
gemma4:e4b) sur le poste de travail avecollama_model_weight_download.sh, qui exécute unollama servelocal temporaire avecOLLAMA_MODELSpointé vers le répertoire de téléchargement. - Calculez la taille de PVC requise à partir des pondérations téléchargées (avec une surcharge de 25 %), créez un PVC
ReadWriteOnce, appliquez la règle de QoS hautes performances et démarrez un pod de chargeur de modèle temporaire qui l'installe. - Importez le répertoire de téléchargement dans le PVC avec
model_weight_upload.sh, puis supprimez le pod du chargeur.
- Extrayez le modèle (par exemple,
- Déployer et exposer : créez un déploiement Ollama avec
OLLAMA_MODELSpointant vers le chemin d'installation du PVC (en demandant la ressource d'accélérateur découverte à partir des nœuds) et un service LoadBalancer. - Réseau sécurisé : appliquez une règle NetworkPolicy d'espace de noms pour le port Ollama (11434). Ajoutez une règle ProjectNetworkPolicy lorsque des clients extérieurs au projet ont besoin d'un accès.
4. Facultatif : ouvrir l'interface Web
- Déployer Open WebUI : insérez l'image Open WebUI dans Harbor et déployez-la dans son propre espace de noms avec un stockage persistant pour son état. Pointez-la vers les points de terminaison
/v1compatibles avec OpenAI du service vLLM, du service Ollama ou des deux. La procédure est décrite dans le guide de l'utilisateur d'Open WebUI pour les modèles à pondération ouverte.
5. Validation et test
Une fois le déploiement terminé, les dernières étapes consistent à vérifier que les services sont fonctionnels.
- Vérifier l'état : vérifiez que les pods sont en cours d'exécution et que des adresses IP externes ont été attribuées aux services.
- Tester l'inférence :
- vLLM : envoyez une requête curl à l'adresse IP de l'équilibreur de charge vLLM à l'aide des points de terminaison
/v1/modelset/v1/chat/completionscompatibles avec OpenAI. - Ollama : envoyez une requête curl à l'adresse IP de l'équilibreur de charge Ollama en utilisant les mêmes points de terminaison
/v1/modelset/v1/chat/completionscompatibles avec OpenAI.
- vLLM : envoyez une requête curl à l'adresse IP de l'équilibreur de charge vLLM à l'aide des points de terminaison
- Solution de secours pour le transfert de port : lorsque l'adresse IP de l'équilibreur de charge n'est pas accessible depuis le poste de travail (par exemple, parce qu'aucune règle ProjectNetworkPolicy n'est encore en place), utilisez
kubectl port-forwardpour le service et envoyez les mêmes requêtes à127.0.0.1.
6. Opérations et scaling
- Scaling vertical : augmentez le nombre de tranches de GPU ou passez à des configurations multi-GPU pour les modèles plus volumineux.
- Scaling horizontal : augmentez le nombre d'instances répliquées dans le déploiement (nécessite un volume de modèle
ReadOnlyMany) ou déployez des déploiements de modèle supplémentaires pour gérer davantage de requêtes utilisateur simultanées. - Dépannage : surveillez les journaux à l'aide de
kubectl logset recherchez les problèmes courants tels que les échecs d'autotest FIPS ou les restrictions de règles de réseau.
La procédure détaillée est décrite dans l'implémentation de référence des modèles à pondération ouverte avec Ollama, l'implémentation de référence des modèles à pondération ouverte avec vLLM et leurs guides de l'utilisateur.
Autres ressources
- Modèles à pondération ouverte avec l'implémentation de référence Ollama
- Modèles à pondération ouverte avec l'implémentation de référence vLLM
- Guide de l'utilisateur de Gemma 4 E4B avec Ollama
- [SUG] Mistral 7B Instruct avec vLLM sur GDC air-gapped
- [SUG] Mistral NeMo 12B Instruct avec vLLM sur GDC air-gapped
- [SUG] Mistral Small 3.2 24B Instruct avec vLLM sur GDC sous air gap
- [SUG] Ministral 8B Instruct avec vLLM sur GDC en mode déconnecté
- [SUG] Mixtral 8x7B Instruct avec vLLM sur GDC avec air gap
- [SUG] Mistral Small 1.2 24B avec vLLM sur GDC avec air gap
- Guide de l'utilisateur d'Open WebUI pour les modèles Open Weight
- Documentation vLLM
- Ollama
- Ouvrir WebUI
- Documentation de Google Distributed Cloud sous air gap