


Ce document fournit des instructions détaillées pour déployer des modèles de pondération ouverts tels que Gemma, Llama et DeepSeek dans des environnements Google Distributed Cloud (GDC) air gap. Il explique comment utiliser Ollama pour plus de simplicité, et comment utiliser les fonctionnalités de la plate-forme GDC, y compris Kubernetes, Harbor et les ressources d'accélérateur.
Architecture
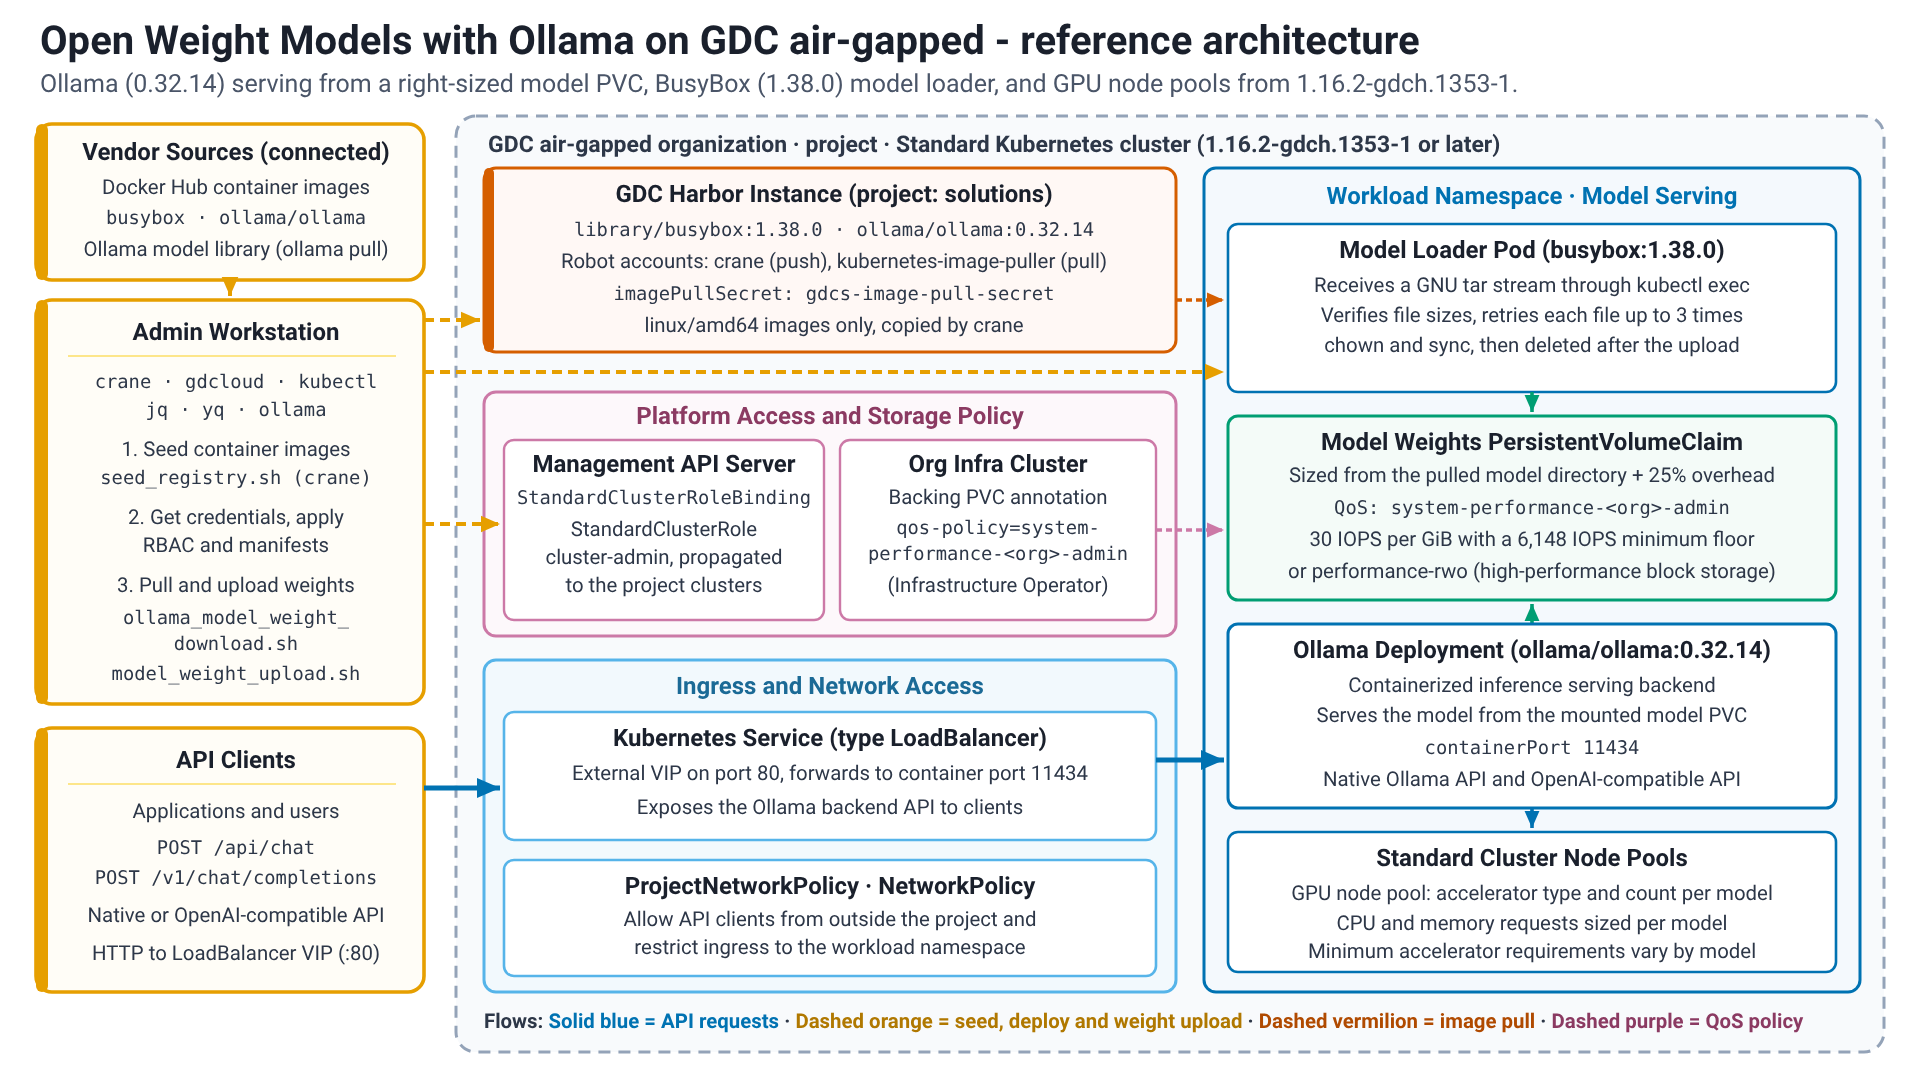
La solution consiste à déployer Ollama en tant que backend de diffusion d'inférence conteneurisé (Deployment) dans un cluster standard. Les pondérations de modèle sont stockées sur des volumes persistants dont la taille est ajustée de manière dynamique à partir du répertoire du modèle téléchargé avec un surcoût de 25 %, configurés avec la règle de QoS de stockage system-performance-<org>-admin (30 IOPS par Gio avec un plancher minimal de 6 148 IOPS, ou performance-rwo où le stockage de blocs hautes performances est activé) et renseignés à l'aide d'un workflow de chargeur de modèle. Les Service Kubernetes de type LoadBalancer exposent l'API de backend, et les objets NetworkPolicy / ProjectNetworkPolicy sécurisent l'accès à celle-ci.
Avant de commencer
Avant de procéder au déploiement, assurez-vous que votre environnement remplit toutes les conditions préalables nécessaires et que les utilitaires de ligne de commande requis sont correctement configurés. La configuration de ces outils sur votre poste de travail est essentielle pour gérer les registres de conteneurs, interagir avec les clusters et automatiser le processus de déploiement.
- Cluster standard créé avec suffisamment de ressources (processeur, mémoire, accélérateur). Les exigences minimales concernant les accélérateurs varient en fonction du modèle.
- Instance Harbor disponible et accessible.
- Les autorisations IAM nécessaires ont été appliquées.
- Poste de travail disposant de la connectivité nécessaire à l'environnement et à Internet
Configuration de l'environnement
Identity and Access Management
Assurez-vous que les comptes, rôles et autorisations IAM nécessaires sont correctement configurés.
Rôles Utilisateur GDC sur le projet (RoleBinding dans l'espace de noms du projet, accordés par un administrateur IAM du projet) :
- Lecteur d'instance Harbor (
harbor-instance-viewer) - Créateur de projet Harbor (
harbor-project-creator, uniquement si le projet Harbor n'existe pas encore) - Administrateur de cluster standard (
standard-cluster-admin, requis pourgdcloud clusters get-credentials)
Rôle Utilisateur GDC sur le cluster standard : les rôles de projet précédents n'accordent aucune autorisation dans le cluster. Un administrateur IAM du projet doit également lier l'utilisateur au cluster-admin StandardClusterRole avec un StandardClusterRoleBinding dans l'espace de noms du projet sur le serveur de l'API de gestion. La liaison est propagée aux clusters standards du projet en quelques secondes (status.clusters[].conditions affiche Propagated=True).
cat <<EOF | kubectl --kubeconfig MANAGEMENT_API_SERVER apply -f -
apiVersion: iam.gdc.goog/v1
kind: StandardClusterRoleBinding
metadata:
  name: BINDING_NAME
  namespace: PROJECT
spec:
  roleRef:
    apiGroup: iam.gdc.goog
    kind: StandardClusterRole
    name: cluster-admin
  subjects:
    - apiGroup: rbac.authorization.k8s.io
      kind: User
      name: USER
EOF
Remplacez les éléments suivants :
MANAGEMENT_API_SERVER: chemin d'accès au fichier kubeconfig du serveur d'API de gestion.BINDING_NAME: nom de la liaison, par exemplealex-cluster-admin(lettres minuscules, chiffres et traits d'union).PROJECT: nom du projet.USER: nom d'utilisateur à lier, exactement tel que votre fournisseur d'identité le signale (par exemple, une adresse e-mail).
Assistance de l'opérateur d'infrastructure (uniquement lorsque performance-rwo n'est pas disponible sur le cluster standard) : les guides de l'utilisateur créent le modèle PersistentVolumeClaim avec la classe StorageClass standard-rwo par défaut, ce qui limite les volumes de modèle de taille appropriée à 3 IOPS par Gio. Demandez à votre opérateur d'infrastructure d'appliquer la règle de QoS system-performance-<ORG>-admin au volume qui sauvegarde le modèle PersistentVolumeClaim afin qu'il reçoive le plancher de 6 148 IOPS. Les guides de l'utilisateur affichent les valeurs dont l'opérateur d'infrastructure a besoin.
Autorisations du compte robot Harbor pour crane :
- Lister les dépôts
- Dépôt d'extraction
- Dépôt push
- Lire l'artefact
- Lister l'artefact
- Créer un tag
- Balise de liste
Autorisations du compte de robot Harbor pour les extractions d'images Kubernetes :
- Lister les dépôts
- Dépôt d'extraction
- Lire l'artefact
- Lister l'artefact
- Balise de liste
Station de travail
Sauf indication contraire, exécutez toutes les commandes de ce guide à partir d'un poste de travail disposant des outils requis et d'une connectivité à l'environnement et à Internet.
Conditions requises
Les outils suivants doivent être installés sur le poste de travail :
crane: gérez et copiez des images de conteneurs entre les registres (documentation).gdcloud: interface de ligne de commande (CLI) permettant de gérer les ressources GDC (documentation).kubectl: interface de ligne de commande (CLI) utilisée pour communiquer avec un cluster Kubernetes et le gérer.jq: processeur JSON de ligne de commande léger et flexible.ollama: outil Open Source qui vous permet de télécharger et d'exécuter des modèles.yq: processeur YAML portable en ligne de commande.
Configuration de la station de travail
Les informations suivantes sur l'environnement sont requises pour la configuration de la station de travail :
GDC_STANDARD_CLUSTER_NAME: nom du cluster GDC Standard.GDC_DOMAIN_SUFFIX: suffixe de domaine de l'environnement GDC (par exemple,gdc.example.com).GDC_ORG: nom de l'organisation GDC.GDC_PROJECT: nom du projet GDC.GDC_ZONE: nom de la zone de déploiement GDC.GDC_HARBOR_INSTANCE_NAME: nom de l'instance Harbor dans le projet.GDCS_HARBOR_PROJECT_NAME: nom du projet Harbor à utiliser pour les images (par défaut :solutions).GDCS_HARBOR_CRANE_ROBOT_NAME: nom du compte de robot Harborcrane.GDCS_HARBOR_CRANE_ROBOT_TOKEN: jeton d'authentification du compte de robot Harborcrane.GDCS_HARBOR_K8S_ROBOT_NAME: nom du compte de robot d'extraction d'images Kubernetes Harbor.GDCS_HARBOR_K8S_ROBOT_TOKEN: jeton d'authentification du compte de robot d'extraction d'images Kubernetes Harbor.
Une fois que vous avez collecté les valeurs de toutes les variables requises, générez le fichier de variables d'environnement. Une fois créé, vous pouvez modifier manuellement le fichier à tout moment.
Créez les répertoires de la solution racine et le dossier des secrets :
mkdir -p ${HOME}/gdcag-solutions/env.d
mkdir -p ${HOME}/gdcag-solutions/secrets

touch ${HOME}/gdcag-solutions/secrets/harbor_crane_robot_token
touch ${HOME}/gdcag-solutions/secrets/harbor_k8s_robot_token

chmod u=rwx,go= ${HOME}/gdcag-solutions/secrets
chmod -R u=rw,go= ${HOME}/gdcag-solutions/secrets/*
Créez le fichier de configuration de l'environnement de la plate-forme :
cat << 'EOF' > ${HOME}/gdcag-solutions/env.d/platform.sh && echo "Successfully created." || echo "Failed to create!"
# Infrastructure (Platform Native)
export GDC_STANDARD_CLUSTER_NAME="STANDARD_CLUSTER_NAME"
export GDC_DOMAIN_SUFFIX="DOMAIN_SUFFIX"
export GDC_ORG="ORG"
export GDC_PROJECT="PROJECT"
export GDC_ZONE="ZONE"
export GDC_HARBOR_INSTANCE_NAME="HARBOR_INSTANCE_NAME"

# Derived platform values
export GDC_ZONAL_HOSTNAME="${GDC_ORG}.${GDC_ZONE}.${GDC_DOMAIN_SUFFIX}"
export GDC_ZONAL_CONSOLE_URL="https://console.${GDC_ZONAL_HOSTNAME}"
export GDC_HARBOR_HOST="${GDC_HARBOR_INSTANCE_NAME}-${GDC_PROJECT}.${GDC_ORG}.${GDC_ZONE}.${GDC_DOMAIN_SUFFIX}"
EOF
Remplacez les éléments suivants :
STANDARD_CLUSTER_NAME: nom du cluster GDC standard.DOMAIN_SUFFIX: suffixe de domaine GDC.ORG: organisation GDC.PROJECT: projet GDC.ZONE: zone GDC.HARBOR_INSTANCE_NAME: nom de l'instance GDC Harbor.
Créez le fichier de configuration de l'environnement du registre :
cat << 'EOF' > ${HOME}/gdcag-solutions/env.d/registry.sh && echo "Successfully created." || echo "Failed to create!"
# GDC Solutions Registry & Secrets
export GDCS_HARBOR_PROJECT_NAME="solutions"
export GDCS_HARBOR_CRANE_ROBOT_NAME='HARBOR_CRANE_ROBOT_NAME'
export GDCS_HARBOR_CRANE_ROBOT_TOKEN="$(cat ${GDCS_ROOT_HOME}/secrets/harbor_crane_robot_token)"
export GDCS_HARBOR_K8S_ROBOT_NAME='HARBOR_K8S_ROBOT_NAME'
export GDCS_HARBOR_K8S_ROBOT_TOKEN="$(cat ${GDCS_ROOT_HOME}/secrets/harbor_k8s_robot_token)"
export GDCS_HARBOR_K8S_PULL_SECRET="gdcs-image-pull-secret"

# Derived registry values
export GDCS_HARBOR_PROJECT_URI="${GDC_HARBOR_HOST}/${GDCS_HARBOR_PROJECT_NAME}"
export GDCS_HARBOR_CHART_OCI_URI="oci://${GDCS_HARBOR_PROJECT_URI}"
EOF
Remplacez les éléments suivants :
HARBOR_CRANE_ROBOT_NAME: nom complet du compte de robot Harbor pourcrane, tel qu'il est affiché par Harbor, y compris le préfixerobot$. Conservez les guillemets simples pour que le shell ne développe pas$.HARBOR_K8S_ROBOT_NAME: nom complet du compte robot Harbor pour les extractions d'images Kubernetes, tel qu'il est affiché par Harbor, y compris le préfixerobot$. Conservez les guillemets simples pour que l'interface système ne développe pas$.
Ajoutez vos jetons aux fichiers de secrets :
set +o history

echo "CRANE_ROBOT_TOKEN" > ${HOME}/gdcag-solutions/secrets/harbor_crane_robot_token
echo "KUBERNETES_ROBOT_TOKEN" > ${HOME}/gdcag-solutions/secrets/harbor_k8s_robot_token

set -o history
Remplacez les éléments suivants :
CRANE_ROBOT_TOKEN: secret du compte de robotcrane.KUBERNETES_ROBOT_TOKEN: secret du compte de robot d'extraction d'images Kubernetes.
Créez le fichier de chargement de l'environnement racine :
cat << 'EOF' > ${HOME}/gdcag-solutions/env.sh && echo "Successfully created." || echo "Failed to create!"
export GDCS_ROOT_HOME="${HOME}/gdcag-solutions"
echo "GDCS_ROOT_HOME=${GDCS_ROOT_HOME}"

# Sourced in dependency order
source "${GDCS_ROOT_HOME}/env.d/platform.sh"
source "${GDCS_ROOT_HOME}/env.d/registry.sh"
EOF
Configurer les variables de solution
Créez le répertoire d'implémentation de la solution :
mkdir -p ${HOME}/gdcag-solutions/open-weight-models/ollama/env.dCréez le fichier de configuration de l'accélérateur :
cat << 'EOF' > ${HOME}/gdcag-solutions/open-weight-models/ollama/env.d/accelerator.sh && echo "Successfully created." || echo "Failed to create!"
# Workload Accelerator (NVIDIA GPU)
export GDCS_WORKLOAD_ACCELERATOR_TYPE="WORKLOAD_ACCELERATOR_TYPE"
export GDCS_WORKLOAD_ACCELERATOR_COUNT="1"
EOF
Remplacez les éléments suivants :
WORKLOAD_ACCELERATOR_TYPE: nom de la ressource GPU exposée par vos nœuds GPU, par exemplenvidia.com/gpu-pod-NVIDIA_A100_80GB_PCIE. Les guides de l'utilisateur listent le nom de ressource de chaque GPU proposé par GDC sous air gap. Après avoir récupéré les identifiants du cluster, vous pouvez lister les noms de votre cluster aveckubectl get nodes --output=json | jq -r '[.items[].status.allocatable | keys[] | select(startswith("nvidia.com/"))] | unique[]'.
Créez le fichier de configuration de l'environnement de la solution :
cat << 'EOF' > ${HOME}/gdcag-solutions/open-weight-models/ollama/env.d/ollama.sh && echo "Successfully created." || echo "Failed to create!"
# Images
export GDCS_BUSYBOX_IMAGE_TAG="1.38.0"
export GDCS_OLLAMA_IMAGE_TAG="0.32.14"

# Docker configuration directories for crane and Kubernetes
export GDCS_HARBOR_CRANE_DOCKER_CONFIG="${GDCS_IMPLEMENTATION_HOME}/docker/crane"
export GDCS_HARBOR_K8S_DOCKER_CONFIG="${GDCS_IMPLEMENTATION_HOME}/docker/k8s"
EOF
Créez le fichier de chargement de l'environnement d'implémentation :
cat << 'EOF' > ${HOME}/gdcag-solutions/open-weight-models/ollama/env.sh && echo "Successfully created." || echo "Failed to create!"
source "${HOME}/gdcag-solutions/env.sh"

export GDCS_IMPLEMENTATION_HOME="${HOME}/gdcag-solutions/open-weight-models/ollama"
echo "GDCS_IMPLEMENTATION_HOME=${GDCS_IMPLEMENTATION_HOME}"

# Sourced in dependency order
source "${GDCS_IMPLEMENTATION_HOME}/env.d/accelerator.sh"
source "${GDCS_IMPLEMENTATION_HOME}/env.d/ollama.sh"
EOF
Modifiez et examinez les fichiers d'environnement avec l'éditeur de votre choix :
${EDITOR:-vi} ${HOME}/gdcag-solutions/env.d/platform.sh
${EDITOR:-vi} ${HOME}/gdcag-solutions/env.d/registry.sh
${EDITOR:-vi} ${HOME}/gdcag-solutions/open-weight-models/ollama/env.d/accelerator.sh
${EDITOR:-vi} ${HOME}/gdcag-solutions/open-weight-models/ollama/env.d/ollama.sh
Sourcez le fichier d'environnement :
source ${HOME}/gdcag-solutions/open-weight-models/ollama/env.shLe résultat ressemble à ce qui suit :
GDCS_ROOT_HOME=HOME_DIRECTORY_PATH/gdcag-solutions
GDCS_IMPLEMENTATION_HOME=HOME_DIRECTORY_PATH/gdcag-solutions/open-weight-models/ollama
GDC
Ce guide suppose que votre poste de travail est configuré pour faire confiance aux certificats TLS de votre environnement GDC et de votre instance Harbor.
Configurez
gdcloud:gdcloud config set core/account "default-user" gdcloud config set core/organization_console_url "${GDC_ZONAL_CONSOLE_URL}" gdcloud config set core/project "${GDC_PROJECT}" gdcloud config set core/zone "${GDC_ZONE}"Authentifiez-vous auprès de l'environnement GDC :
gdcloud auth login
Cluster
Récupérez les identifiants du cluster :
gdcloud clusters get-credentials "${GDC_STANDARD_CLUSTER_NAME}" \
--project="${GDC_PROJECT}" \
--standard \
--zone="${GDC_ZONE}"
Vérifiez la connectivité au cluster :
kubectl get nodes -L node.cluster.private.gdc.goog/machine-class
Préparation de la migration des artefacts
- Vérifiez la connectivité et la configuration d'Artifact Registry.
Créez un fichier de configuration Docker pour Crane. Un compte de robot est utilisé pour transférer des couches d'images volumineuses afin d'éviter les délais d'expiration des jetons d'authentification lors de l'utilisation de l'assistant d'identification Managed Harbor Service (MHS) (docker-credential-mhs) avec un compte utilisateur :
export DOCKER_CONFIG="${GDCS_HARBOR_CRANE_DOCKER_CONFIG}"

crane auth login "${GDC_HARBOR_HOST}" \
--password="${GDCS_HARBOR_CRANE_ROBOT_TOKEN}" \
--username="${GDCS_HARBOR_CRANE_ROBOT_NAME}"
Créez un fichier de configuration Docker pour Kubernetes :
export DOCKER_CONFIG="${GDCS_HARBOR_K8S_DOCKER_CONFIG}"

crane auth login "${GDC_HARBOR_HOST}" \
--password="${GDCS_HARBOR_K8S_ROBOT_TOKEN}" \
--username="${GDCS_HARBOR_K8S_ROBOT_NAME}"
Créez le script
seed_registry.sh:cat << 'EOF' > ${GDCS_IMPLEMENTATION_HOME}/seed_registry.sh && echo "Successfully created." || echo "Failed to create!" #!/bin/bash # seed_registry.sh: Modular artifact migration for GDC Solutions # Requires the env.sh file to be sourced first. SCRIPT_DIR="$(cd "$(dirname "${BASH_SOURCE[0]}")" && pwd)" set -o nounset source "${SCRIPT_DIR}/env.sh" # Set the Docker config export DOCKER_CONFIG="${GDCS_HARBOR_CRANE_DOCKER_CONFIG}" eval "${SERIALIZED_IMAGES}" # Ensure GDCS_REGISTRY_IMAGES is set if [[ ${#GDCS_REGISTRY_IMAGES[@]} -eq 0 ]]; then echo "GDCS_REGISTRY_IMAGES must be set, exiting..." exit 1 fi # Migrate the images for source_image in "${GDCS_REGISTRY_IMAGES[@]}"; do # Strip the registry host only when the first path segment is a host (contains a dot or a port) first_segment="${source_image%%/*}" if [[ "${first_segment}" == *.* || "${first_segment}" == *:* ]]; then image_path="${source_image#*/}" else image_path="${source_image}" fi destination_image="${GDCS_HARBOR_PROJECT_URI}/${image_path}" # Ensure the folder structure is created crane append \ --new_layer=<(tar czf - -T /dev/null) \ --new_tag="${destination_image%:*}:create" \ --oci-empty-base 2> /dev/null || true # Copy the linux/amd64 platform only to avoid transferring multi-arch layers over air-gapped links crane copy --platform linux/amd64 "${source_image}" "${destination_image}" || { echo "Failed to copy ${source_image} to ${destination_image}"; exit 1; } done echo "Migration complete: Images are available at ${GDCS_HARBOR_PROJECT_URI}" EOF chmod u+x "${GDCS_IMPLEMENTATION_HOME}/seed_registry.sh"Définissez la liste des images de conteneurs requises pour la solution :
declare -a GDCS_REGISTRY_IMAGES=(
  "docker.io/library/busybox:${GDCS_BUSYBOX_IMAGE_TAG}"
  "docker.io/ollama/ollama:${GDCS_OLLAMA_IMAGE_TAG}"
)
export SERIALIZED_IMAGES=$(declare -p GDCS_REGISTRY_IMAGES)
Amorcez les images de conteneur requises dans Artifact Registry :
${GDCS_IMPLEMENTATION_HOME}/seed_registry.sh
Préparation du modèle
Créez le script
ollama_model_weight_download.sh. Il exécute unollama servelocal temporaire avecOLLAMA_MODELSpointé vers le répertoire de téléchargement et y extrait le modèle :cat << 'EOF' > ${GDCS_IMPLEMENTATION_HOME}/ollama_model_weight_download.sh && echo "Successfully created." || echo "Failed to create!" #!/bin/bash # ollama_model_weight_download.sh: pull GDCS_OLLAMA_MODEL into GDCS_OLLAMA_MODEL_DOWNLOAD_DIR with a temporary local Ollama server. # Requires: GDCS_OLLAMA_MODEL, GDCS_OLLAMA_MODEL_DOWNLOAD_DIR SCRIPT_DIR="$(cd "$(dirname "${BASH_SOURCE[0]}")" && pwd)" set -o nounset set -o pipefail # Ensure GDCS_OLLAMA_MODEL_DOWNLOAD_DIR is set if [[ -z "${GDCS_OLLAMA_MODEL_DOWNLOAD_DIR:-}" ]]; then echo "GDCS_OLLAMA_MODEL_DOWNLOAD_DIR must be set, exiting..." exit 1 fi mkdir -p "${GDCS_OLLAMA_MODEL_DOWNLOAD_DIR}" # Use a dedicated local port so an already running Ollama instance is not reused export OLLAMA_HOST="${OLLAMA_DOWNLOAD_HOST:-127.0.0.1:11435}" export OLLAMA_MODELS="${GDCS_OLLAMA_MODEL_DOWNLOAD_DIR}" ollama serve > "${GDCS_OLLAMA_MODEL_DOWNLOAD_DIR}/ollama-serve.log" 2>&1 & OLLAMA_PID=$! # Set up a trap to kill ollama serve when the script exits trap "kill ${OLLAMA_PID} 2>/dev/null" EXIT INT TERM # Wait for the local server for i in $(seq 1 30); do ollama list > /dev/null 2>&1 && break sleep 1 done ollama pull "${GDCS_OLLAMA_MODEL}" || exit 1 rm -f "${GDCS_OLLAMA_MODEL_DOWNLOAD_DIR}/ollama-serve.log" echo "Model '${GDCS_OLLAMA_MODEL}' is available in '${GDCS_OLLAMA_MODEL_DOWNLOAD_DIR}'." EOF chmod u+x "${GDCS_IMPLEMENTATION_HOME}/ollama_model_weight_download.sh"Créez le script
model_weight_upload.sh. Il copie un répertoire de modèle local dansPersistentVolumevia le chargeur de modèlePod(streaming GNUtar, fichiers de plus de 8 Gio inclus) et ignore les fichiers déjà présents avec la même taille :cat << 'EOF' > ${GDCS_IMPLEMENTATION_HOME}/model_weight_upload.sh && echo "Successfully created." || echo "Failed to create!" #!/bin/bash # model_weight_upload.sh: copy LOCAL_MODEL_DIR into REMOTE_MODEL_DIR on the PersistentVolume mounted in the loader Pod. # Requires: GDCS_WORKLOAD_NAMESPACE, GDCS_MODEL_LOADER_POD_NAME, LOCAL_MODEL_DIR, REMOTE_MODEL_DIR # Optional: REMOTE_MOUNT_DIR (PersistentVolume mount path, defaults to REMOTE_MODEL_DIR) - its lost+found directory is removed. SCRIPT_DIR="$(cd "$(dirname "${BASH_SOURCE[0]}")" && pwd)" set -o errexit set -o nounset set -o pipefail # Ensure LOCAL_MODEL_DIR is set if [[ -z "${LOCAL_MODEL_DIR:-}" ]]; then echo "LOCAL_MODEL_DIR must be set, exiting..." exit 1 fi # Ensure REMOTE_MODEL_DIR is set if [[ -z "${REMOTE_MODEL_DIR:-}" ]]; then echo "REMOTE_MODEL_DIR must be set, exiting..." exit 1 fi REMOTE_MOUNT_DIR="${REMOTE_MOUNT_DIR:-${REMOTE_MODEL_DIR}}" KEEPALIVE_INTERVAL_SEC=300 start_session_keepalive() { echo "[KeepAlive] Started background heartbeat (every ${KEEPALIVE_INTERVAL_SEC}s)." while true; do sleep "${KEEPALIVE_INTERVAL_SEC}" # Lightweight API request to prevent session inactivity logout if kubectl get namespace "${GDCS_WORKLOAD_NAMESPACE}" >/dev/null 2>&1; then echo "[KeepAlive] Session heartbeat sent at $(date)" else echo "[KeepAlive] Heartbeat failed or context expired at $(date)" fi done } start_session_keepalive & MY_KEEPALIVE_PID=$! cleanup() { echo "[Cleanup] Stopping keep-alive process (PID: ${MY_KEEPALIVE_PID})..." kill "${MY_KEEPALIVE_PID}" 2>/dev/null || true wait "${MY_KEEPALIVE_PID}" 2>/dev/null || true echo "[Cleanup] Session keep-alive terminated." } trap cleanup EXIT INT TERM # Remove the lost+found directory kubectl exec "pod/${GDCS_MODEL_LOADER_POD_NAME}" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ -- rm -rf "${REMOTE_MOUNT_DIR}/lost+found" # Create the model directory kubectl exec "pod/${GDCS_MODEL_LOADER_POD_NAME}" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ -- mkdir -p "${REMOTE_MODEL_DIR}" # Loop through all files in the local directory FAILED_FILES=() MAX_UPLOAD_ATTEMPTS="${MAX_UPLOAD_ATTEMPTS:-3}" remote_size_of() { # Prints the remote file size (0 if the file does not exist) kubectl exec "pod/${GDCS_MODEL_LOADER_POD_NAME}" --namespace="${GDCS_WORKLOAD_NAMESPACE}" -- stat -c%s "$1" 2>/dev/null || echo 0 } # Loop through all files in the local directory (process substitution keeps FAILED_FILES in this shell) while read -r local_file; do # Get relative path rel_path="${local_file#"${LOCAL_MODEL_DIR}"/}" remote_file="${REMOTE_MODEL_DIR}/${rel_path}" # Get local file size local_size=$(stat -L -c%s "${local_file}") # Get remote file size (returns 0 if file does not exist) remote_size=$(remote_size_of "${remote_file}") if [ "${local_size}" -eq "${remote_size}" ]; then echo "[Loader] Skipping: ${rel_path} (Size matches)" continue fi if [ "${remote_size}" -ne "0" ]; then echo "[Loader] Mismatch: ${rel_path} (${remote_size} remote vs ${local_size} local)" fi # Ensure remote parent subdirectories exist if your model has folders remote_parent=$(dirname "${remote_file}") kubectl exec "pod/${GDCS_MODEL_LOADER_POD_NAME}" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ -- mkdir -p "${remote_parent}" attempt=1 while [ "${attempt}" -le "${MAX_UPLOAD_ATTEMPTS}" ]; do echo "[Loader] Uploading: ${rel_path} (${local_size} bytes, attempt ${attempt}/${MAX_UPLOAD_ATTEMPTS})..." # Copy the individual file using GNU tar streaming. # Note: 'kubectl cp' uses Go's archive/tar, which defaults to PAX format for files > 8 GiB. # BusyBox's tar in the loader pod does not parse PAX size headers and fails with 'tar: invalid tar magic'. # Streaming via GNU tar (--format=gnu) uses base-256 binary encoding for files > 8 GiB, which BusyBox tar supports. tar --format=gnu -C "$(dirname "${local_file}")" -cf - "$(basename "${local_file}")" | \ kubectl exec -i "pod/${GDCS_MODEL_LOADER_POD_NAME}" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ -- tar -xf - -C "${remote_parent}" || true # Verify: an interrupted exec stream leaves a truncated file behind without an error remote_size=$(remote_size_of "${remote_file}") if [ "${local_size}" -eq "${remote_size}" ]; then echo "[Loader] Verified: ${rel_path} (${remote_size} bytes)" break fi echo "[Loader] Incomplete upload: ${rel_path} (${remote_size} remote vs ${local_size} local), retrying..." attempt=$((attempt + 1)) done if [ "${local_size}" -ne "${remote_size}" ]; then FAILED_FILES+=("${rel_path}") fi done < <(find -L "${LOCAL_MODEL_DIR}" -type f) if [ "${#FAILED_FILES[@]}" -ne 0 ]; then echo "[Loader] FAILED: ${#FAILED_FILES[@]} file(s) could not be uploaded completely after ${MAX_UPLOAD_ATTEMPTS} attempts:" printf '[Loader] %s\n' "${FAILED_FILES[@]}" exit 1 fi echo "[Loader] Completed" # Fix file permissions kubectl exec "pod/${GDCS_MODEL_LOADER_POD_NAME}" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ -- chown 0:0 -R "${REMOTE_MODEL_DIR}" # Flush the volume before the loader Pod is deleted (a detached volume with unwritten page cache loses data) kubectl exec "pod/${GDCS_MODEL_LOADER_POD_NAME}" \ --namespace="${GDCS_WORKLOAD_NAMESPACE}" \ -- sync EOF chmod u+x "${GDCS_IMPLEMENTATION_HOME}/model_weight_upload.sh"
Déployer un modèle
- Guide de l'utilisateur des modèles Gemma avec Ollama : Gemma 4 E2B, E4B, 12B, 26B-A4B et 31B, avec les options de GPU de GDC sous air gap