


Visão geral
Esta arquitetura de referência define o design conceitual para implantar o Elastic Stack (Elasticsearch e Kibana) no Google Distributed Cloud (GDC) isolado e integrá-lo a um serviço de modelo de linguagem grande (LLM) para ativar os recursos de IA generativa do Elastic.
O Elastic Stack é uma plataforma de análise de pesquisa, observabilidade e segurança amplamente adotada. As versões recentes do Elastic adicionam recursos de IA generativa ao Kibana, incluindo o Elastic AI Agent, agentes personalizados criados com o Agent Builder, e a Attack Discovery. Esses recursos dependem de um LLM para traduzir solicitações de linguagem natural em consultas do Elasticsearch, orquestrar chamadas de ferramentas de várias etapas e correlacionar alertas de segurança.
Essa arquitetura implanta o Elastic Stack usando o operador oficial do Elastic Cloud no Kubernetes (ECK) disponível no GDC com isolamento físico Marketplace e conecta o Kibana a um endpoint de inferência de LLM hospedado no limite do GDC, seja o serviço gerenciado do Gemini no GDC ou um servidor de inferência autogerenciado compatível com a OpenAI, como o Ollama ou o vLLM.
Recursos e funcionalidades
A solução oferece vários componentes funcionais principais para pesquisa, observabilidade e análise de segurança assistidas por IA:
- Gerenciamento do ciclo de vida baseado no Marketplace: instale o operador ECK do
GDC com isolamento físico Marketplace em um namespace de projeto
em um cluster compartilhado e deixe que ele automatize o provisionamento,
a configuração e a reconciliação de
ElasticsearcheKibanarecursos personalizados. - Investigação de dados em linguagem natural: use o agente de IA do Elastic para explorar dados do Elasticsearch em linguagem natural. O agente descobre índices e mapeamentos, gera e executa consultas ES|QL e sintetiza descobertas sem exigir conhecimento prévio do esquema subjacente.
- Agentes personalizados e fluxos de trabalho automatizados: use o Agent Builder para criar agentes específicos que combinam instruções personalizadas com ferramentas integradas, ferramentas ES|QL personalizadas e fluxos de trabalho do Kibana (por exemplo, abrir automaticamente casos de segurança do Kibana com descobertas de investigação).
- Correlação de alertas de segurança orientada por IA: use a Attack Discovery para analisar alertas de segurança do Elastic abertos, mapeá-los para o framework MITRE ATT&CK e correlacionar alertas, endereços IP e contas de usuário relacionados em cadeias de ataques.
- Compatibilidade com isolamento físico: as imagens do contêiner do operador ECK, do Elasticsearch e do Kibana são extraídas do registro local do GDC Harbor, e todo o tráfego de inferência de LLM permanece na rede interna do GDC.
- Back-ends de LLM conectáveis: conecte o Kibana ao Gemini gerenciado no
GDC ou a qualquer servidor de inferência autogerenciado que exponha
uma API compatível com o OpenAI
/v1/chat/completionspelo conector OpenAI do Kibana.
Princípios arquitetônicos
- Modelo de responsabilidade compartilhada: o GDC fornece o cluster compartilhado, o pacote do Marketplace, o registro do Harbor e a rede. O cliente opera a implantação do Elastic Stack, gerencia o licenciamento do Elastic e é responsável pela seleção e operação do serviço de LLM autogerenciado (se usado).
- Soberania de dados: todos os dados operacionais e de segurança, comandos e respostas do modelo permanecem no limite do GDC com isolamento físico. Nenhum tráfego é enviado para serviços de LLM públicos ou hospedados pelo Elastic.
- Operações nativas da nuvem: usa o padrão de operador do Kubernetes para gerenciar cargas de trabalho do Elastic com estado de forma declarativa, garantindo implantações consistentes e repetíveis
- Padronização de protocolo: depende da API de conclusões de chat compatível com o OpenAI, amplamente aceita, com chamadas de função nativas, desvinculando o Kibana de qualquer mecanismo de inferência ou fornecedor de modelo específico.
Arquitetura
A arquitetura consiste em uma implantação do Elastic Stack gerenciada pelo operador ECK dentro de um namespace de projeto em um cluster de usuário compartilhado do GDC. O Kibana se comunica pela rede interna do GDC com um endpoint de inferência de LLM.
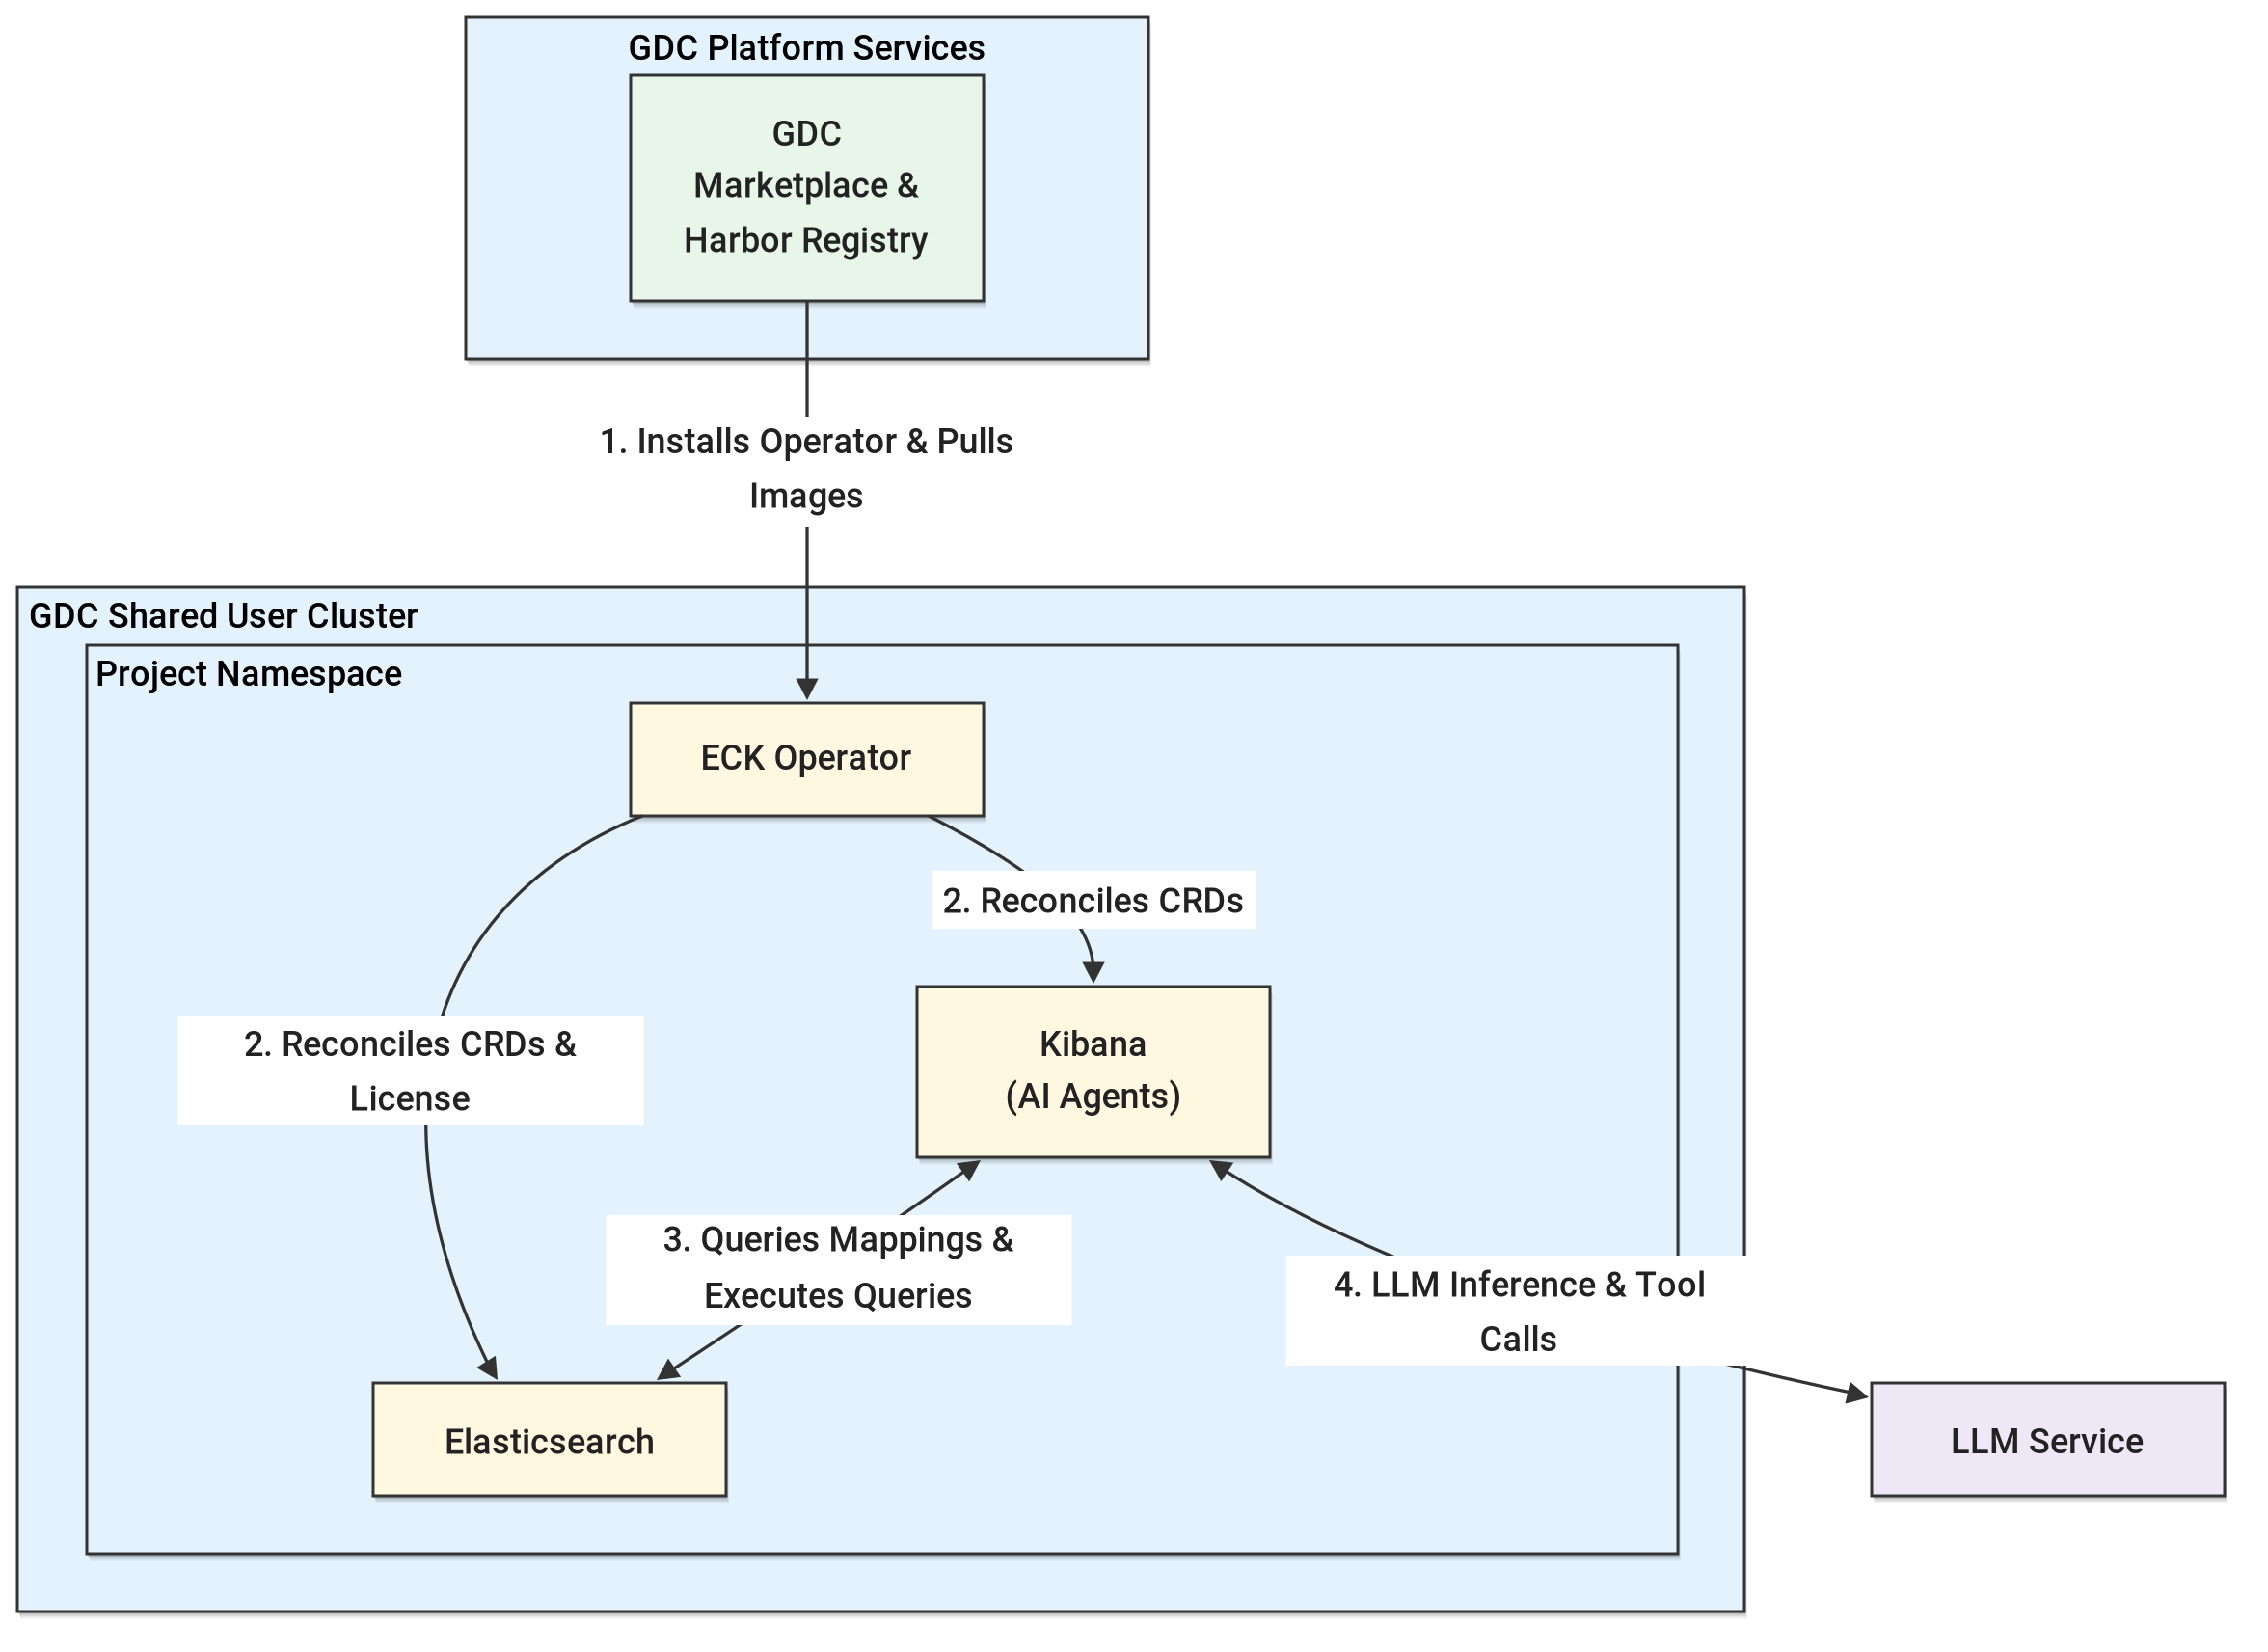
Os principais componentes dessa arquitetura incluem:
- Cluster compartilhado do GDC: um cluster compartilhado do Kubernetes com escopo da organização anexado a vários projetos, hospedando pacotes de software e cargas de trabalho de aplicativos do GDC Marketplace.
- Projeto do GDC: o namespace do projeto no cluster compartilhado que isola o operador ECK, o cluster do Elasticsearch, a instância do Kibana e os Secrets e NetworkPolicies do Kubernetes associados.
- Operador do Elastic Cloud no Kubernetes (ECK): instalado do
GDC Marketplace no namespace do projeto, o
operador gerencia os recursos personalizados do
Elasticsearche doKibanae reconcilia a licença do Elastic necessária para recursos de IA generativa e conectores de LLM externos. - Elasticsearch: armazena e indexa dados operacionais e de segurança e executa consultas de pesquisa e ES|QL geradas pelos recursos e agentes de IA do Kibana.
- Kibana: hospeda os recursos de IA generativa do Elastic (Elastic AI Agent, Agent Builder e Attack Discovery) e gerencia os conectores de ação de LLM que orquestram a chamada de ferramentas de várias etapas entre o usuário, o Elasticsearch e o serviço de LLM.
- Serviço de LLM: um serviço de LLM gerenciado (como o Gemini no GDC) ou um servidor de inferência autogerenciado (como o Ollama ou o vLLM) que fornece recursos de conclusão de chat e chamada de ferramentas para o Kibana na rede interna do GDC.
Conceitos e tecnologias
Esta seção detalha os componentes funcionais, as responsabilidades deles e como eles se comunicam no sistema.
Infraestrutura e plataforma
- Cluster compartilhado do GDC: o ambiente de computação principal em que os pods do operador ECK, do Elasticsearch e do Kibana residem em um namespace de projeto.
- GDC Marketplace: o catálogo usado para instalar e fazer upgrade do pacote do Marketplace do Elastic, que registra as CustomResourceDefinitions do Elastic e implanta o
elastic-operatorStatefulSet. - Registro do Harbor: a fonte de verdade local e segura para as imagens de contêiner do operador ECK, do Elasticsearch e do Kibana no ambiente isolado.
- Armazenamento persistente: os PersistentVolumeClaims provisionados pelos
Elasticsearch
volumeClaimTemplatesfornecem armazenamento de blocos durável para dados do Elasticsearch. - Rede do GDC: os serviços LoadBalancer expõem o
Elasticsearch (porta
9200) e o Kibana (porta5601), enquanto os recursosNetworkPolicyeProjectNetworkPolicyglobais do Kubernetes regem o tráfego de entrada e entre projetos, incluindo a conectividade com o serviço de LLM.
Serviços e lógica
- Operador ECK: o controlador que observa os recursos personalizados
ElasticsearcheKibanae os reconcilia em StatefulSets, implantações, serviços e Secrets. Olicense-controllerreconcilia continuamente a licença do cluster com os Secrets de licença no namespace do operador. - Elastic AI Agent: o agente de conversação padrão no Kibana. Ele usa ferramentas integradas do Agent Builder (
platform.core.list_indices,platform.core.get_index_mapping,platform.core.searcheplatform.core.execute_esql) para descobrir dados, gerar ES|QL e resumir resultados. - Agent Builder: O framework para criar agentes personalizados que combinam
instruções de sistema personalizadas com ferramentas integradas e definidas pelo usuário
(
esql,index_search,workflow, emcp). - Fluxos de trabalho do Kibana: automações declarativas definidas por YAML (por exemplo,
cases.createCase) que podem ser registradas como ferramentas do Agent Builder para permitir que os agentes realizem ações como abrir casos de segurança do Kibana. - Attack Discovery: um recurso de segurança do Elastic que envia o contexto de alerta anônimo
para o LLM para correlacionar alertas do índice
.alerts-security.alerts-defaultem cadeias de ataques mapeadas para táticas MITRE ATT&CK. - Serviço de LLM: fornece conclusões de chat ajustadas por instrução com suporte nativo para chamada de ferramentas. O modelo precisa gerar invocações de ferramentas válidas, JSON estruturado e consultas ES|QL de maneira confiável.
Fluxo de dados e interfaces
- API de conclusões de chat compatível com o OpenAI (
/v1/chat/completions): a interface entre o conector OpenAI (.gen-ai) do Kibana e o serviço de LLM, configurada com o provedor Outro serviço compatível com o OpenAI , chamada de função nativa ativada e eventos enviados pelo servidor. - APIs REST e ES|QL do Elasticsearch: usadas pelo Kibana e pelos agentes dele para inspecionar mapeamentos, executar pesquisas e executar agregações ES|QL.
- APIs REST do Kibana: usadas para gerenciamento programático de conectores
(
/api/actions), agentes e ferramentas (/api/agent_builder), fluxos de trabalho (/api/workflows), regras de detecção (/api/detection_engine) e Attack Discovery (/api/attack_discovery). - HTTPS com autenticação integrada: os endpoints do Elasticsearch e do Kibana são veiculados por TLS usando certificados gerados pelo ECK, com credenciais armazenadas em Secrets do Kubernetes gerenciados pelo ECK.
Considerações
- Escalabilidade e desempenho:
- As solicitações de recursos, os limites, as contagens de nós e os tamanhos de armazenamento do Elasticsearch e do Kibana precisam ser ajustados dos padrões de avaliação para corresponder aos volumes de dados de produção e à simultaneidade de consultas.
- O conector OpenAI do Kibana aplica um tempo limite padrão de 60 segundos por turno de streaming. O serviço de LLM precisa ser executado na aceleração de GPU com otimizações, como o Flash Attention, para manter cada turno dentro desse limite.
- Um único turno de agente pode acionar subchamadas de LLM aninhadas. O servidor de inferência precisa manter vários slots de cache KV paralelos (por exemplo,
OLLAMA_NUM_PARALLEL=2) para evitar que as subchamadas despejem o contexto armazenado em cache da conversa principal.
- Requisitos do modelo de LLM:
- O modelo precisa ser ajustado por instrução com suporte nativo para chamada de função. A chamada de função nativa precisa ser ativada no conector do Kibana, já que a chamada de função simulada baseada em comandos é menos confiável para chamadas de ferramentas aninhadas.
- Uma janela de contexto de pelo menos 128.000 tokens é altamente recomendada, já que investigações de várias etapas que combinam definições de ferramentas, esquemas de índice, documentação ES|QL e resultados da pesquisa podem exceder 70.000 tokens.
- Um limite de token de saída de pelo menos 8.192 tokens e uma penalidade de repetição suave são recomendados para modelos capazes de raciocínio, porque o Kibana trata um motivo de conclusão
lengthcomo um erro fatal e usa a decodificação greedy. - A Attack Discovery exige um modelo de classe 30B ou maior (como
gemma4:31b) para sintetizar de maneira confiável saídas estruturadas de vários alertas.
- Segurança e conformidade:
- Todos os comandos, dados recuperados e respostas do modelo permanecem na rede interna do GDC.
- As políticas de rede precisam ser reforçadas das configurações de avaliação permissivas para restringir o acesso de entrada ao Elasticsearch e ao Kibana a clientes autorizados e limitar a saída ao endpoint do serviço de LLM.
- O acesso ao Kibana e ao Elasticsearch precisa ser regido por controles de acesso baseados em papéis do Elastic, em vez do superusuário
elastic.
- Gerenciamento de recursos e licenciamento:
- Os recursos de IA generativa do Elastic e os conectores de LLM externos exigem uma licença Enterprise (ou um teste ativo de 30 dias), que precisa ser provisionada por um Secret de licença ECK para persistir em ciclos de reconciliação de operadores.
- Disponibilidade e confiabilidade:
- As implantações Production precisam usar vários nós do Elasticsearch com fragmentos de réplica e várias instâncias do Kibana para evitar pontos únicos de falha.
- A disponibilidade dos recursos de IA depende da disponibilidade e da latência do serviço de LLM.
- Gerenciamento operacional:
- O cliente é responsável por fazer upgrade do pacote do Elastic Marketplace e das versões do Elastic Stack, gerenciar licenças e fazer backup dos dados do Elasticsearch.
- Quando um serviço de LLM autogerenciado é usado, o cliente é responsável pela implantação, pelo planejamento da capacidade da GPU, pelas atualizações do modelo e pelo ajuste.
Decisão de design
As principais opções arquitetônicas para essa solução se concentram em ativar os recursos de IA generativa do Elastic dentro das restrições do ambiente com isolamento físico.
Operador ECK do GDC Marketplace
O operador ECK é instalado do GDC com isolamento físico do Marketplace, em vez de ser implantado manualmente. O pacote do Marketplace vem pré-configurado para extrair imagens de contêiner do registro local do Harbor, registra as CustomResourceDefinitions necessárias e se integra aos papéis do IAM no nível do projeto do GDC. Isso reduz o esforço de espelhamento de imagens e mantém a implantação alinhada ao ciclo de vida do software do GDC.
Implantação de cluster compartilhado
A solução implanta o Elastic Stack em um namespace de projeto em um cluster compartilhado do GDC. Isso permite que os clientes consumam o software do Marketplace junto com outras cargas de trabalho do projeto sem provisionar e operar um cluster dedicado, enquanto o namespace do projeto fornece isolamento de recursos, Secrets e políticas de rede.
Opções de serviço de LLM
O Gemini gerenciado no GDC é a opção preferencial quando disponível, já que remove o ônus operacional da hospedagem da infraestrutura de inferência. Quando não estiver disponível ou quando os clientes exigirem um modelo aberto específico, o Kibana poderá se conectar a qualquer servidor de inferência autogerenciado que exponha um endpoint /v1/chat/completions compatível com o OpenAI. A padronização nessa API mantém a configuração do Elastic independente do mecanismo de inferência (como Ollama ou vLLM).
Chamada de função nativa
A chamada de função nativa é ativada no conector do Kibana para que a formatação da chamada de ferramenta seja delegada ao protocolo tools do OpenAI do servidor de inferência.
A chamada de função simulada baseada em comandos padrão do Kibana é menos confiável durante chamadas de ferramentas aninhadas e pode falhar com erros de análise.
Reconciliação de licenças gerenciada pelo ECK
A licença Enterprise (ou de teste) é declarada como um Secret de licença ECK, em vez de ser ativada diretamente pela API de licença do Elasticsearch. Como o ECK reconcilia continuamente a licença do cluster, as licenças aplicadas fora do ECK são revertidas para basic no próximo ciclo de reconciliação.
Suposições e limitações
Suposições
- Um cluster compartilhado do GDC e um projeto anexado estão disponíveis, com capacidade de computação e armazenamento persistente suficientes para o operador ECK, o Elasticsearch e o Kibana.
- O pacote do Elastic Marketplace e as imagens de contêiner correspondentes do Elasticsearch e do Kibana estão disponíveis no GDC Marketplace isolado e no registro local do Harbor.
- Os usuários têm os papéis de projeto necessários (
namespace-admin,project-viewer,marketplace-editoreproject-networkpolicy-admin). - Um serviço de LLM (Gemini gerenciado no GDC ou um servidor de inferência autogerenciado compatível com o OpenAI) é implantado e acessível pelo pod do Kibana na rede interna do GDC.
- Uma licença do Elastic Enterprise está disponível ou o teste de 30 dias do Enterprise é usado para avaliação.
Limitações
- Serviço de LLM fora do escopo: a implantação e a operação de um serviço de LLM autogerenciado, incluindo a infraestrutura de GPU, não são cobertas por essa arquitetura.
- Sem serviços de IA hospedados pelo Elastic: os LLMs gerenciados pelo Elastic e outros serviços de IA do Elastic hospedados na nuvem não estão disponíveis no ambiente isolado.
- Qualidade dependente do modelo: a precisão e a confiabilidade dos resultados do agente de IA, do Agent Builder e da Attack Discovery dependem dos recursos do modelo selecionado e da configuração de tempo de execução dele.
- Padrões de avaliação: a implementação de referência usa um cluster do Elasticsearch de nó único, certificados autoassinados e políticas de rede permissivas, que precisam ser reforçadas para uso em produção.
- Especificidade da versão: a solução foi validada com o Elastic v9.4.0, o Elastic Kubernetes Operator v3.4.0 e o GDC v1.16.2. Outras versões podem exigir ajustes.
Outros recursos
Implementação de referência da solução (SRI, na sigla em inglês): Implantação dos recursos de IA generativa do Elastic Stack no GDC com isolamento físico