


Panoramica
Questa architettura di riferimento definisce la progettazione concettuale per il deployment di Elastic Stack (Elasticsearch e Kibana) su Google Distributed Cloud (GDC) con air gap e la sua integrazione con un servizio di modelli linguistici di grandi dimensioni (LLM) per abilitare le funzionalità di AI generativa di Elastic.
L'Elastic Stack è una piattaforma di analisi di ricerca, osservabilità e sicurezza ampiamente adottata. Le versioni recenti di Elastic aggiungono funzionalità di AI generativa a Kibana, tra cui Elastic AI Agent, agenti personalizzati creati con Agent Builder, e Attack Discovery. Queste funzionalità si basano su un LLM per tradurre le richieste in linguaggio naturale in query Elasticsearch, orchestrare le chiamate di strumenti in più passaggi e correlare gli avvisi di sicurezza.
Questa architettura esegue il deployment di Elastic Stack utilizzando l'operatore ufficiale Elastic Cloud on Kubernetes (ECK) disponibile in GDC Marketplace con air gap e connette Kibana a un endpoint di inferenza LLM ospitato all'interno del limite di GDC, ovvero il servizio Gemini gestito su GDC o un server di inferenza autogestito compatibile con OpenAI come Ollama o vLLM.
Caratteristiche e funzionalità
La soluzione fornisce diversi componenti funzionali di base per la ricerca, l'osservabilità e l'analisi della sicurezza assistite dall'AI:
- Gestione del ciclo di vita basata su Marketplace: installa l'operatore ECK da
GDC Marketplace con air gap in uno spazio dei nomi del progetto
su un cluster condiviso e lascia che automatizzi il provisioning,
la configurazione e la riconciliazione delle risorse personalizzate
ElasticsearcheKibana. - Indagine sui dati in linguaggio naturale: utilizza l'agente AI di Elastic per esplorare i dati di Elasticsearch in linguaggio naturale. L'agente rileva indici e mapping, genera ed esegue query ES|QL e sintetizza i risultati senza richiedere una conoscenza preliminare dello schema sottostante.
- Agenti personalizzati e workflow automatizzati: utilizza Agent Builder per creare agenti appositamente progettati che combinano istruzioni personalizzate con strumenti integrati, strumenti ES|QL personalizzati e workflow Kibana (ad esempio, l'apertura automatica di casi di sicurezza Kibana con i risultati delle indagini).
- Correlazione degli avvisi di sicurezza basata sull'AI: utilizza Attack Discovery per analizzare gli avvisi di Elastic Security aperti, mappali sul framework MITRE ATT&CK e correla gli avvisi, gli indirizzi IP e gli account utente correlati in catene di attacchi.
- Compatibilità con air gap: le immagini container dell'operatore ECK, di Elasticsearch e di Kibana vengono estratte dal registro Harbor di GDC locale e tutto il traffico di inferenza LLM rimane sulla rete GDC interna.
- Backend LLM collegabili: connetti Kibana a Gemini gestito su
GDC o a qualsiasi server di inferenza autogestito che espone
un'API compatibile con OpenAI
/v1/chat/completionstramite il connettore OpenAI di Kibana.
Principi architetturali
- Modello di responsabilità condivisa: GDC fornisce il cluster condiviso, il pacchetto Marketplace, il registro Harbor e la rete. Il cliente gestisce il deployment di Elastic Stack, gestisce le licenze Elastic e possiede la selezione e il funzionamento del servizio LLM autogestito (se utilizzato).
- Sovranità dei dati: tutti i dati operativi e di sicurezza, i prompt e le risposte del modello rimangono all'interno del limite di GDC con air gap. Nessun traffico viene inviato a servizi LLM pubblici o ospitati da Elastic.
- Operazioni cloud-native: utilizza il pattern dell'operatore Kubernetes per gestire i carichi di lavoro Elastic con stato in modo dichiarativo, garantendo deployment coerenti e ripetibili.
- Standardizzazione del protocollo: si basa sull' API di completamento della chat compatibile con OpenAI ampiamente supportata con la chiamata di funzione nativa, disaccoppiando Kibana da qualsiasi motore di inferenza o fornitore di modelli specifico.
Architettura
L'architettura è costituita da un deployment di Elastic Stack gestito dall'operatore ECK all'interno di uno spazio dei nomi del progetto su un cluster utente condiviso di GDC. Kibana comunica tramite la rete GDC interna con un endpoint di inferenza LLM.
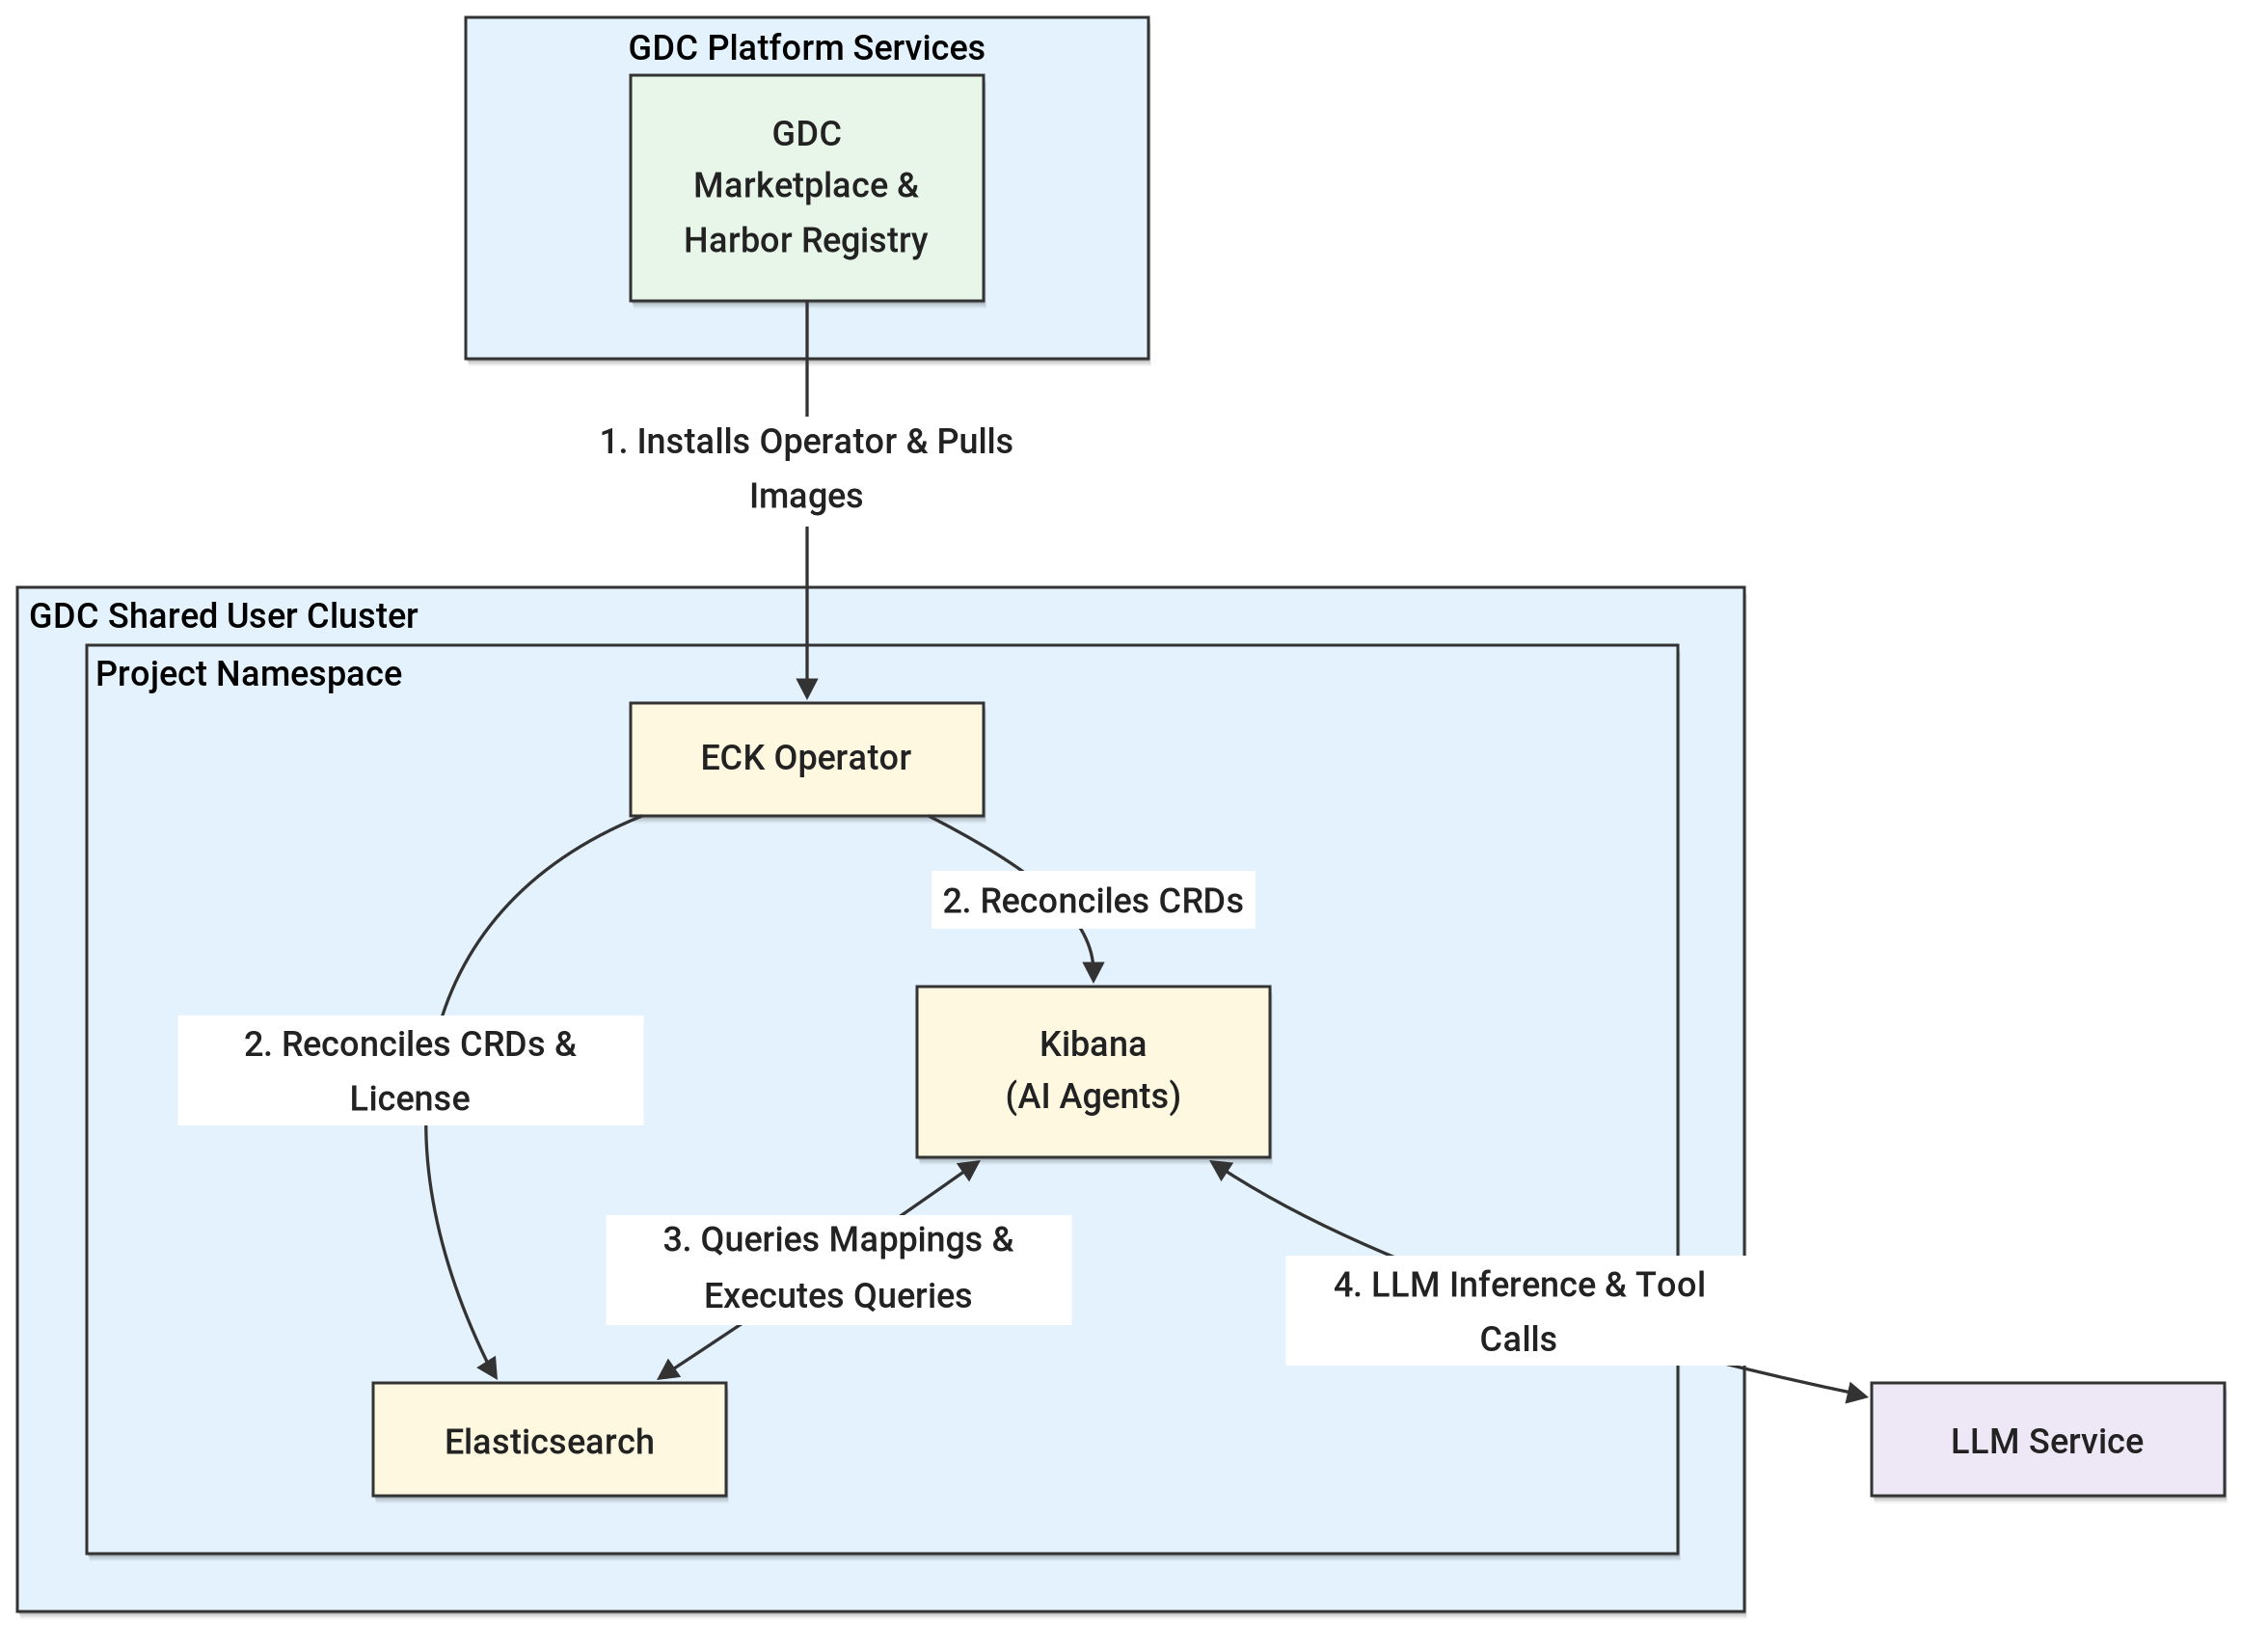
I componenti chiave di questa architettura includono:
- Cluster condiviso di GDC: un cluster Kubernetes condiviso con ambito organizzazione collegato a più progetti, che ospita pacchetti software GDC Marketplace e carichi di lavoro delle applicazioni.
- Progetto GDC: lo spazio dei nomi del progetto sul cluster condiviso che isola l'operatore ECK, il cluster Elasticsearch, l'istanza Kibana e i segreti e le NetworkPolicy Kubernetes associati.
- Operatore Elastic Cloud on Kubernetes (ECK): installato da
GDC Marketplace nello spazio dei nomi del progetto, l'
operatore gestisce le risorse personalizzate
ElasticsearcheKibanae riconcilia la licenza Elastic richiesta per le funzionalità di AI generativa e i connettori LLM esterni. - Elasticsearch: archivia e indicizza i dati operativi e di sicurezza ed esegue query di ricerca ed ES|QL generate dalle funzionalità di AI e dagli agenti di Kibana.
- Kibana: ospita le funzionalità di AI generativa di Elastic (Elastic AI Agent, Agent Builder e Attack Discovery) e gestisce i connettori di azioni LLM che orchestrano la chiamata di strumenti in più passaggi tra l'utente, Elasticsearch e il servizio LLM.
- Servizio LLM: un servizio LLM gestito (come Gemini su GDC) o un server di inferenza autogestito (come Ollama o vLLM) che fornisce funzionalità di completamento della chat e chiamata di strumenti a Kibana tramite la rete GDC interna.
Concetti e tecnologie
Questa sezione descrive in dettaglio i componenti funzionali, le loro responsabilità e il modo in cui comunicano all'interno del sistema.
Infrastruttura e piattaforma
- Cluster condiviso di GDC: l'ambiente di computing principale in cui i pod dell'operatore ECK, di Elasticsearch e di Kibana risiedono all'interno di uno spazio dei nomi del progetto.
- GDC Marketplace: il catalogo utilizzato per installare ed
eseguire l'upgrade del pacchetto Elastic Marketplace, che registra le CustomResourceDefinitions
di Elastic ed esegue il deployment di
elastic-operatorStatefulSet. - Registro Harbor: l'origine attendibile locale e sicura per le immagini container dell'operatore ECK, di Elasticsearch e di Kibana nell'ambiente con air gap.
- Archiviazione permanente: i PersistentVolumeClaim di cui è stato eseguito il provisioning tramite
Elasticsearch
volumeClaimTemplatesforniscono un'archiviazione a blocchi durevole per i dati di Elasticsearch. - Networking GDC: i servizi LoadBalancer espongono
Elasticsearch (porta
9200) e Kibana (porta5601), mentre le risorseNetworkPolicydi Kubernetes eProjectNetworkPolicyglobali regolano il traffico in entrata e tra progetti, inclusa la connettività al servizio LLM.
Servizi e logica
- Operatore ECK: il controller che monitora le risorse personalizzate
ElasticsearcheKibanae le riconcilia in StatefulSet, Deployment, Services e Secrets. Il relativolicense-controllerriconcilia continuamente la licenza del cluster con i segreti della licenza nello spazio dei nomi dell'operatore. - Elastic AI Agent: l'agente conversazionale predefinito in Kibana. Utilizza gli strumenti integrati di Agent Builder (
platform.core.list_indices,platform.core.get_index_mapping,platform.core.searcheplatform.core.execute_esql) per scoprire i dati, generare ES|QL e riepilogare i risultati. - Agent Builder: il framework per la creazione di agenti personalizzati che combinano
istruzioni di sistema personalizzate con strumenti integrati e strumenti definiti dall'utente
(
esql,index_search,workflow, emcp). - Workflow Kibana: automazioni dichiarative definite in YAML (ad esempio,
cases.createCase) che possono essere registrate come strumenti di Agent Builder per consentire agli agenti di eseguire azioni come l'apertura di casi di sicurezza Kibana. - Attack Discovery: una funzionalità di sicurezza di Elastic Security che invia il contesto degli avvisi anonimizzato all'LLM per correlare gli avvisi dall'indice
.alerts-security.alerts-defaultin catene di attacchi mappate sulle tattiche MITRE ATT&CK. - Servizio LLM: fornisce completamenti della chat ottimizzati per le istruzioni con supporto nativo per la chiamata di strumenti. Il modello deve generare in modo affidabile chiamate di strumenti, JSON strutturato e query ES|QL validi.
Flusso di dati e interfacce
- API di completamento della chat compatibile con OpenAI (
/v1/chat/completions): l'interfaccia tra il connettore OpenAI (.gen-ai) di Kibana e il servizio LLM, configurata con il provider Altro (servizio compatibile con OpenAI), la chiamata di funzione nativa abilitata e lo streaming di eventi inviati dal server. - API REST ed ES|QL di Elasticsearch: utilizzate da Kibana e dai relativi agenti per ispezionare i mapping, eseguire ricerche ed eseguire aggregazioni ES|QL.
- API REST di Kibana: utilizzate per la gestione programmatica di connettori
(
/api/actions), agenti e strumenti (/api/agent_builder), workflow (/api/workflows), regole di rilevamento (/api/detection_engine) e Attack Discovery (/api/attack_discovery). - HTTPS con autenticazione integrata: gli endpoint di Elasticsearch e Kibana vengono pubblicati tramite TLS utilizzando i certificati generati da ECK, con le credenziali archiviate nei segreti Kubernetes gestiti da ECK.
Considerazioni
- Scalabilità e prestazioni:
- Le richieste di risorse, i limiti, i conteggi dei nodi e le dimensioni di archiviazione di Elasticsearch e Kibana devono essere modificati rispetto ai valori predefiniti di valutazione per corrispondere ai volumi di dati di produzione e alla concorrenza delle query.
- Il connettore OpenAI di Kibana applica un timeout predefinito di 60 secondi per ogni turno di streaming. Il servizio LLM deve essere eseguito con l'accelerazione della GPU con ottimizzazioni come Flash Attention per mantenere ogni turno entro questo limite.
- Un singolo turno dell'agente può attivare chiamate secondarie LLM nidificate. Il server di inferenza deve mantenere più slot di cache KV paralleli (ad esempio,
OLLAMA_NUM_PARALLEL=2) per impedire alle chiamate secondarie di eliminare il contesto memorizzato nella cache della conversazione principale.
- Requisiti del modello LLM:
- Il modello deve essere ottimizzato per le istruzioni con supporto nativo per la chiamata di funzioni. La chiamata di funzione nativa deve essere abilitata nel connettore Kibana, poiché la chiamata di funzione simulata basata su prompt è meno affidabile per le chiamate di strumenti nidificate.
- È vivamente consigliata una finestra contestuale di almeno 128.000 token, poiché le indagini in più passaggi che combinano definizioni di strumenti, schemi di indici, documentazione ES|QL e risultati di ricerca possono superare i 70.000 token.
- Per i modelli in grado di ragionare,è consigliato un limite di token di output di almeno 8192 token e una penalità di ripetizione moderata, perché Kibana considera un motivo di completamento
lengthcome un errore irreversibile e utilizza la decodifica greedy. - Attack Discovery richiede un modello di classe 30B o superiore (ad esempio,
gemma4:31b) per sintetizzare in modo affidabile gli output strutturati con più avvisi.
- Sicurezza e conformità:
- Tutti i prompt, i dati recuperati e le risposte del modello rimangono sulla rete GDC interna.
- Le policy di rete devono essere rafforzate dalle impostazioni di valutazione permissive per limitare l'accesso in entrata a Elasticsearch e Kibana ai client autorizzati e per limitare l'uscita all'endpoint del servizio LLM.
- L'accesso a Kibana e Elasticsearch deve essere regolato tramite i controlli di accesso basati sui ruoli di Elastic anziché tramite il super utente
elastic.
- Gestione delle risorse e licenze:
- Le funzionalità di AI generativa di Elastic e i connettori LLM esterni richiedono una licenza Enterprise (o una prova Enterprise attiva di 30 giorni), di cui deve essere eseguito il provisioning tramite un segreto della licenza ECK per persistere nei cicli di riconciliazione dell'operatore.
- Disponibilità e affidabilità:
- I deployment di produzione devono utilizzare più nodi Elasticsearch con shard di replica e più istanze Kibana per evitare singoli punti di errore.
- La disponibilità delle funzionalità di AI dipende dalla disponibilità e dalla latenza del servizio LLM.
- Gestione operativa:
- Il cliente è responsabile dell'upgrade del pacchetto Elastic Marketplace e delle versioni di Elastic Stack, della gestione delle licenze e del backup dei dati di Elasticsearch.
- Quando viene utilizzato un servizio LLM autogestito, il cliente è proprietario del deployment, della pianificazione della capacità della GPU, degli aggiornamenti del modello e dell'ottimizzazione.
Decisione di progettazione
Le scelte architetturali principali per questa soluzione si concentrano sull'abilitazione delle funzionalità di AI generativa di Elastic nei limiti dell'ambiente con air gap.
Operatore ECK da GDC Marketplace
L'operatore ECK viene installato da GDC Marketplace con air gap anziché essere sottoposto a deployment manuale. Il pacchetto Marketplace è preconfigurato per estrarre le immagini container dal registro Harbor locale, registra le CustomResourceDefinitions richieste e si integra con i ruoli IAM a livello di progetto GDC. Ciò riduce l'impegno di mirroring delle immagini e mantiene il deployment allineato al ciclo di vita del software GDC.
Deployment del cluster condiviso
La soluzione esegue il deployment di Elastic Stack in uno spazio dei nomi del progetto su un cluster condiviso di GDC. In questo modo, i clienti possono utilizzare il software Marketplace insieme ad altri carichi di lavoro del progetto senza eseguire il provisioning e il funzionamento di un cluster dedicato, mentre lo spazio dei nomi del progetto fornisce l'isolamento di risorse, segreti e policy di rete.
Opzioni del servizio LLM
Gemini gestito su GDC è l'opzione preferita, se disponibile, in quanto elimina il carico operativo dell'hosting dell'infrastruttura di inferenza. Se non è disponibile o se i clienti richiedono un modello open specifico, Kibana può connettersi a qualsiasi server di inferenza autogestito che espone un endpoint /v1/chat/completions compatibile con OpenAI. La standardizzazione di questa API mantiene la configurazione Elastic indipendente dal motore di inferenza (come Ollama o vLLM).
Chiamata di funzione nativa
La chiamata di funzione nativa è abilitata nel connettore Kibana in modo che la formattazione della chiamata di strumenti venga delegata al protocollo tools OpenAI del server di inferenza.
La chiamata di funzione simulata basata su prompt predefinita di Kibana è meno affidabile durante le chiamate di strumenti nidificate e può non riuscire con errori di analisi.
Riconciliazione delle licenze gestita da ECK
La licenza Enterprise (o di prova) viene dichiarata come secret della licenza ECK anziché essere attivata direttamente tramite l'API per le licenze Elasticsearch. Poiché ECK riconcilia continuamente la licenza del cluster, le licenze applicate al di fuori di ECK vengono ripristinate a basic nel ciclo di riconciliazione successivo.
Ipotesi e limitazioni
Ipotesi
- Sono disponibili un cluster condiviso di GDC e un progetto collegato, con capacità di computing e di archiviazione permanente sufficienti per l'operatore ECK, Elasticsearch e Kibana.
- Il pacchetto Elastic Marketplace e le immagini container di Elasticsearch e Kibana corrispondenti sono disponibili in GDC Marketplace con air gap e nel registro Harbor locale.
- Gli utenti dispongono dei ruoli di progetto richiesti (
namespace-admin,project-viewer,marketplace-editoreproject-networkpolicy-admin). - È stato eseguito il deployment di un servizio LLM (Gemini gestito su GDC o un server di inferenza autogestito compatibile con OpenAI) ed è raggiungibile dal pod Kibana tramite la rete GDC interna.
- È disponibile una licenza Elastic Enterprise oppure viene utilizzata la prova Enterprise di 30 giorni per la valutazione.
Limitazioni
- Servizio LLM fuori ambito: il deployment e il funzionamento di un servizio LLM autogestito, inclusa l'infrastruttura GPU, non sono trattati in questa architettura.
- Nessun servizio AI ospitato da Elastic: i servizi LLM gestiti da Elastic e altri servizi AI ospitati sul cloud di Elastic non sono disponibili nell'ambiente con air gap.
- Qualità dipendente dal modello: l'accuratezza e l'affidabilità dei risultati di agente AI, Agent Builder e Attack Discovery dipendono dalle funzionalità del modello selezionato e dalla sua configurazione di runtime.
- Valori predefiniti di livello di valutazione: l'implementazione di riferimento utilizza un cluster Elasticsearch a nodo singolo, certificati autofirmati e policy di rete permissive, che devono essere rafforzati per l'utilizzo in produzione.
- Specificità della versione: la soluzione è stata convalidata con Elastic v9.4.0, Elastic Kubernetes Operator v3.4.0 e GDC v1.16.2. Altre versioni potrebbero richiedere modifiche.
Materiali aggiuntivi
Implementazione di riferimento della soluzione (SRI): deployment delle funzionalità di AI generativa di Elastic Stack su GDC con air gap