


Problema
As organizações que executam modelos de linguagem grandes (LLMs) em ambientes com isolamento físico acumulam rapidamente endpoints de modelo: cada modelo de peso aberto disponibilizado no Google Distributed Cloud com isolamento físico (consulte o guia complementar "Definir modelos de peso aberto no GDC com isolamento físico") expõe seu próprio Service do Kubernetes, endereço, credenciais e ciclo de vida operacional.
Os desenvolvedores de aplicativos e agentes acabam em silos arquitetônicos, codificando um endpoint por modelo e reescrevendo as integrações a cada iteração do modelo. Essa fragmentação cria dívida técnica e dificulta a implantação de cargas de trabalho de agentes de várias etapas e essenciais para a missão.
As camadas de rede padrão também são "cegas para IA": um balanceador de carga convencional trata o tráfego de inferência como HTTP genérico e não pode ler o campo model de uma solicitação, priorizar cargas de trabalho sensíveis à latência, considerar tokens em vez de solicitações ou direcionar uma solicitação para a réplica do servidor de modelo que já contém o cache KV relevante. Em clusters de GPU isolados com alto custo, isso leva ao subaproveitamento do hardware e a um retorno do investimento ruim. Embora o Gemini no
GDC
forneça modelos de fronteira gerenciados, os clientes que os combinam com modelos de peso aberto
auto-hospedados precisam de uma camada de inferência que ofereça agilidade semelhante à da nuvem
sem comprometer a soberania de dados: nenhuma solicitação, comando ou peso do modelo pode
sair do limite do GDC.
Solução proposta
Este documento descreve a arquitetura de referência para um gateway de IA autogerenciado em um GDC com isolamento físico: uma camada de inferência segura e centralizada que oferece aos aplicativos um endpoint compatível com a OpenAI para todos os modelos e roteia cada solicitação para o back-end correto. A implementação de referência se baseia na API Kubernetes Gateway: o Envoy Gateway é a implementação da API Gateway (plano de controle e plano de dados do proxy Envoy), e o Envoy Agent Router (antigo Envoy AI Gateway) a estende com o processamento de solicitações específicas de IA: extração de modelo do corpo da solicitação, tradução de solicitação e resposta, autenticação upstream, contagem de tokens e, opcionalmente, limitação de taxa baseada em tokens. A extensão de inferência da API Gateway adiciona a seleção de endpoints compatível com o servidor de modelos (InferencePool e Endpoint Picker) para que a capacidade da GPU seja usada com eficiência. Todos os artefatos são
armazenados no registro do Harbor da organização do GDC
e toda a pilha é executada em um cluster padrão sem conectividade
externa.
O que está incluído:essa arquitetura abrange a implantação do Envoy Gateway e do Envoy Agent Router em um cluster padrão, os recursos da API Gateway (GatewayClass, Gateway) e os recursos do Envoy Agent Router (AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, GatewayConfig) que expõem um endpoint unificado compatível com a OpenAI, o roteamento baseado em corpo no campo model, a extensão de inferência da API Gateway (InferencePool, InferenceObjective, Endpoint Picker) para balanceamento de carga com reconhecimento de modelo, limitação de taxa opcional baseada em token com Redis, término de TLS no gateway, políticas de rede (NetworkPolicy / ProjectNetworkPolicy) e o gerenciamento de artefatos com isolamento físico em Harbor. Os back-ends de disponibilização do modelo por trás do gateway (Ollama, vLLM) são implantados com o guia complementar "Open Weight Models on GDC" com isolamento físico.
O que não está incluído:esta arquitetura não abrange um produto de gateway de IA gerenciado, a implantação e o ajuste dos modelos (conjunto de guias complementares), o ajuste fino do modelo, as modalidades de IA generativa que não são LLMs, o tráfego de agente para ferramenta (MCPRoute) ou distribuições de gateway com suporte comercial. O Gemini no GDC é uma experiência no produto gerenciada. O provisionamento dele está fora do escopo, e esta versão do conjunto de guias valida o gateway com modelos de peso aberto auto-hospedados.
Público-alvo:o público principal deste documento inclui administradores de plataforma responsáveis por implantar e operar o gateway em um cluster padrão e arquitetos técnicos que projetam plataformas de IA no ambiente isolado. Os desenvolvedores de aplicativos que consomem o endpoint unificado são um público secundário que se beneficia ao entender como as solicitações são encaminhadas.
Arquitetura
A solução é executada inteiramente em um cluster padrão da organização GDC com isolamento físico. Na camada de serviços, o padrão da API Gateway do Kubernetes padroniza o modelo de configuração. O plano de controle do gateway de IA (o controlador do Envoy Gateway e o controlador do Envoy Agent Router) lê os recursos da API Gateway e do Envoy Agent Router e configura o plano de dados: um proxy do Envoy Deployment, que é o ponto de entrada da solicitação (exposto por um Service do tipo LoadBalancer), e o processador externo do Envoy Agent Router, que é executado como um arquivo secundário no proxy Pod e executa a lógica específica da IA. Na camada de aplicativo, as cargas de trabalho do cliente
(aplicativos e agentes) enviam uma solicitação de IA ao proxy (1). O proxy entrega
a solicitação ao processador externo, que extrai o nome do modelo, traduz
a solicitação e registra o uso de tokens (2). O proxy encaminha o tráfego balanceado
para os Pods de inferência do modelo selecionado (3), e o modelo é executado nos nós
da GPU da camada de infraestrutura (4). Os backends de veiculação de modelos são anexados ao gateway como um AIServiceBackend (qualquer Service compatível com a OpenAI) ou como um InferencePool, cujo seletor de endpoints escolhe a melhor réplica por solicitação. As imagens de contêiner e os gráficos Helm são extraídos do Harbor.
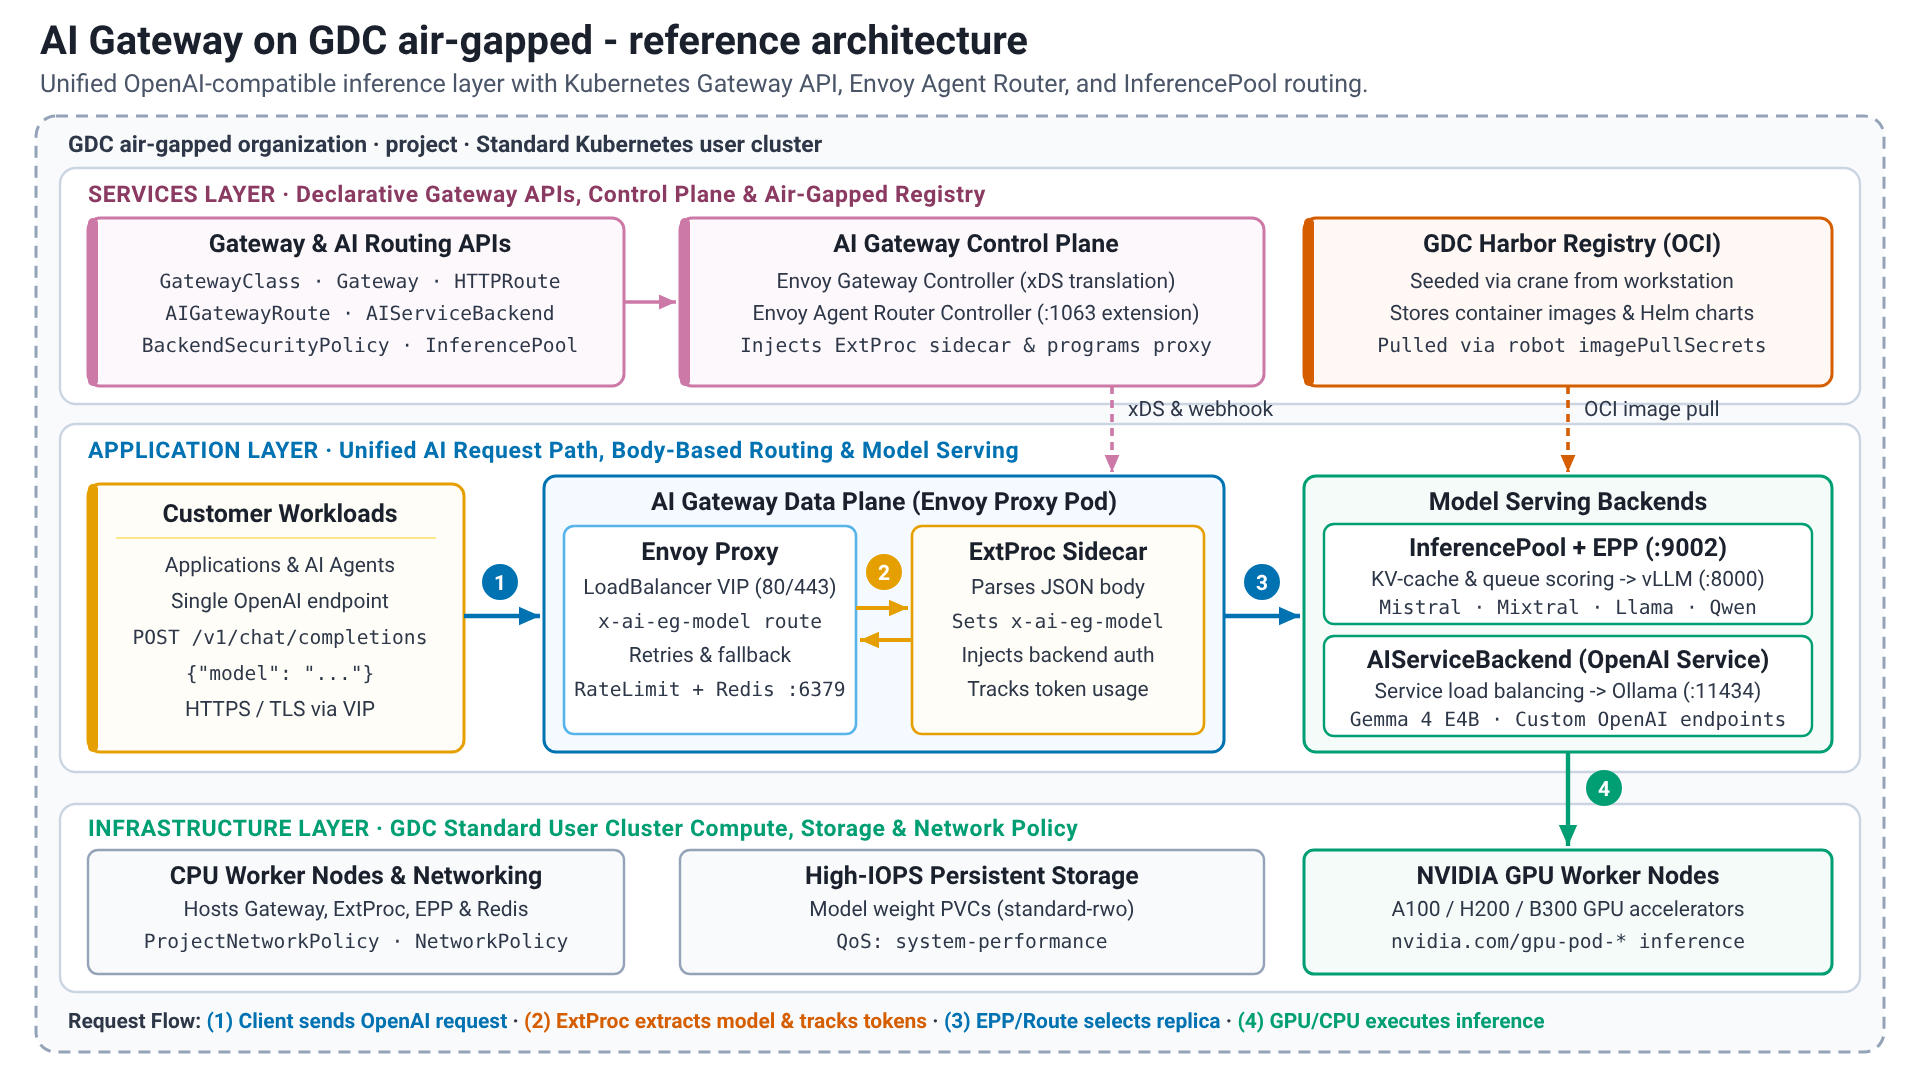
Componentes da solução
A solução usa os seguintes componentes:
| Componente da solução | Responsabilidades | Fluxo de dados | Interfaces |
|---|---|---|---|
| API Kubernetes Gateway | Modelo de recurso padrão orientado a papéis para entrada e roteamento: GatewayClass (de propriedade da plataforma), Gateway (listeners, TLS) e recursos de rota (de propriedade das equipes de aplicativos). Sucessor da API Ingress sem anotações específicas do fornecedor. |
Apenas configuração declarativa. Os recursos são monitorados pelos controladores e não têm tráfego de solicitações. | API do Kubernetes (gateway.networking.k8s.io/v1). Os CRDs são instalados do gráfico CRD do Envoy Gateway. |
| Controlador do Envoy Gateway (plano de controle) | Implementa a API Gateway: provisiona um proxy Envoy Deployment e LoadBalancer Service por Gateway, traduz rotas e políticas (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) para a configuração xDS, executa o serviço global de limitação de taxa quando configurado e chama o servidor de extensão do roteador do agente Envoy pelo gerenciador de extensões para que os back-ends InferencePool sejam adicionados à tradução. |
Monitora a API Kubernetes e envia a configuração xDS para os proxies. Não há tráfego de solicitações. | API Kubernetes (watch), gRPC xDS para os proxies, gRPC para o servidor de extensão (porta 1063). |
| Controlador de roteador do agente do Envoy (plano de controle) | Faz a reconciliação dos recursos aigateway.envoyproxy.io/v1beta1, AIGatewayRoute (regras de roteamento no nome do modelo extraído), AIServiceBackend (um back-end com o esquema de API), BackendSecurityPolicy (credenciais upstream) e GatewayConfig (configurações de processador externo por Gateway) em recursos do Envoy Gateway, injeta o sidecar do processador externo nos Pods do proxy do Envoy e veicula o servidor de extensão usado pelo Envoy Gateway. |
Somente configuração. | API Kubernetes, servidor de extensão gRPC (porta 1063), webhook de admissão mutante para a injeção de sidecar. |
| Proxy do Envoy (plano de dados) | Ponto de entrada de solicitação: encerra o TLS, corresponde a listeners e rotas, faz o balanceamento de carga em endpoints de back-end, aplica limites de taxa e tempos limite, tenta novamente e volta para back-ends alternativos, além de emitir registros de acesso e métricas. | Recebe solicitações do cliente no VIP LoadBalancer (80/443), consulta o processador externo para cada solicitação de IA, encaminha a solicitação para o endpoint de back-end selecionado (um Service ou o Pod escolhido pelo Endpoint Picker) e transmite a resposta de volta para o cliente. |
HTTP/HTTPS para clientes (API compatível com OpenAI), gRPC ext_proc para o sidecar e o Endpoint Picker, HTTP para os back-ends, gRPC para o serviço de limitação de taxa. |
| Processador externo (ExtProc) do roteador de agente do Envoy | Analisa o corpo da solicitação compatível com a OpenAI, extrai o campo model para o cabeçalho de roteamento x-ai-eg-model, aplica substituições de nome do modelo, traduz solicitações e respostas entre o esquema de API do cliente e o esquema de API de back-end, injeta as credenciais upstream definidas por BackendSecurityPolicy e extrai o uso de tokens (entrada, saída, total) da resposta para metadados dinâmicos usados para limitação de taxa e métricas baseadas em token. |
Contêiner secundário no proxy Envoy Pod; processa corpos de solicitação e resposta, incluindo respostas transmitidas. |
gRPC ext_proc do Envoy; endpoint de métricas do Prometheus. |
| Extensão de inferência da API Gateway (InferencePool + Endpoint Picker) | InferencePool (inference.networking.k8s.io/v1) agrupa os Pods de uma implantação de servidor de modelo (seletor de rótulo, porta de destino, por exemplo, 8000) e faz referência ao seletor de endpoint (EPP). InferenceObjective (v1alpha2) atribui uma prioridade por modelo ou objetivo. O EPP extrai as métricas do servidor de modelo (profundidade da fila de solicitações, utilização do cache de chave-valor, adaptadores LoRA carregados) e seleciona o endpoint para cada solicitação. |
O proxy chama o EPP (ext_proc, porta 9002) com os cabeçalhos de solicitação. O EPP responde com o endpoint a ser usado. O proxy encaminha a solicitação para esse Pod. |
API Kubernetes (CRDs), gRPC ext_proc (9002), verificação do Prometheus dos servidores de modelo. |
| Redis (opcional) | Armazenamento de apoio do serviço de limitação de taxa do Envoy: contadores compartilhados para limites baseados em solicitações e tokens em todas as réplicas de proxy. Só é necessário quando a limitação de taxa global está configurada. | O serviço de limitação de taxa lê e incrementa contadores na porta 6379 para cada solicitação limitada. | Protocolo do Redis (6379). Redis 8.10 implantado no cluster ou uma instância do Redis atual. |
| Back-ends de disponibilização de modelos (Ollama / vLLM) | Disponibilize os modelos de peso aberto por trás do gateway, implantados com o guia complementar "Modelos de peso aberto no GDC com isolamento físico". Anexado como um AIServiceBackend (qualquer Service compatível com a OpenAI, por exemplo, o Ollama) ou como um InferencePool (servidores de modelos como o vLLM que expõem as métricas em que o seletor de endpoints pontua). |
Recebe as solicitações roteadas do proxy, executa a inferência nos nós de GPU (ou na CPU para avaliação funcional com modelos pequenos) e retorna a resposta compatível com a OpenAI. | API REST compatível com OpenAI: vLLM na porta 8000, Ollama na porta 11434; métricas do Prometheus (vLLM) para o seletor de endpoints. |
| Harbor | Armazena as imagens de contêiner (proxy Envoy, gateway Envoy, controlador de roteador do agente Envoy e processador externo, serviço de limitação de taxa, seletor de endpoints, Redis) e os gráficos Helm (artefatos OCI) da solução. | Os artefatos são copiados dos registros públicos para o Harbor com seed_registry.sh (crane) de uma estação de trabalho com acesso à Internet. O cluster extrai imagens com uma conta de robô usando segredos de extração de imagens, e os gráficos são renderizados do Harbor com helm template. |
API OCI Distribution, interface do Harbor e contas de robô. |
| Cluster padrão e nós de GPU | Hospeda todos os componentes do gateway (nós de CPU são suficientes) e as Pods de inferência (nós de GPU com os recursos de acelerador descobertos nos nós). Fornece VIPs LoadBalancer, armazenamento permanente para os pesos do modelo e a aplicação da política de rede. |
Plataforma fundamental: as solicitações entram pelo VIP LoadBalancer do Gateway e permanecem dentro da rede do cluster. |
API Kubernetes, APIs de rede do GDC (networking.gdc.goog/v1 ProjectNetworkPolicy), console do GDC e gdcloud para o administrador da plataforma. |
Recursos e funcionalidades
Esta arquitetura de referência oferece os seguintes recursos principais:
- Endpoint unificado compatível com a OpenAI:os aplicativos chamam um endereço (
/v1/chat/completions,/v1/modelsetc.) para cada modelo veiculado por trás do gateway.- Componentes:
Gateway,AIGatewayRoute, proxy Envoy, processador externo. - Responsabilidades:expor um IP virtual estável, encerrar o TLS, aceitar o formato de solicitação compatível com a OpenAI e traduzi-lo para o esquema de back-end quando necessário.
- Interfaces:HTTPS REST (JSON, incluindo eventos enviados pelo servidor para streaming).
- Componentes:
- Roteamento baseado no corpo (com reconhecimento do modelo):o gateway lê o campo
modeldo corpo da solicitação e a encaminha para o back-end correspondente sem nenhuma lógica de endpoint do lado do cliente.- Componentes:processador externo, correspondência de regras
AIGatewayRouteemx-ai-eg-model,AIServiceBackend,InferencePool. - Responsabilidades:extrair o nome do modelo, corresponder regras de rota, renomear modelos (
modelNameOverride), dividir o tráfego por peso e voltar para back-ends alternativos por prioridade. - Interfaces:API Kubernetes (
aigateway.envoyproxy.io/v1beta1).
- Componentes:processador externo, correspondência de regras
- Balanceamento de carga com reconhecimento do servidor de modelo:as solicitações para um
InferencePoolsão enviadas para a réplica com a fila mais curta e o cache KV mais útil em vez de round robin.- Componentes:extensão de inferência da API Gateway (
InferencePool,InferenceObjective, seletor de endpoints). - Responsabilidades:raspagem de métricas do servidor de modelo, endpoints de pontuação (profundidade da fila, utilização do KV-cache, afinidade do cache de prefixo, adaptadores LoRA), respeitando as prioridades por objetivo sob carga.
- Interfaces:API Kubernetes (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), gRPC ext_proc (9002).
- Componentes:extensão de inferência da API Gateway (
- Políticas de segurança e autenticação upstream:as credenciais para back-ends que as exigem são injetadas pelo gateway e nunca distribuídas aos aplicativos.
- Componentes:
BackendSecurityPolicy, Envoy GatewaySecurityPolicye listeners de TLS. - Responsabilidades:injetar chaves de API nos back-ends, encerrar
o TLS do cliente no
Gatewaye aplicar políticas de autenticação e autorização do cliente quando necessário. - Interfaces:
Secrets do Kubernetes referenciados pelas políticas.
- Componentes:
- Limitação de taxa baseada em tokens (opcional): o uso é medido em tokens, não apenas em solicitações.
- Componentes:processador externo (
llmRequestCosts), Envoy GatewayBackendTrafficPolicy(limite de taxa global), serviço de limite de taxa, Redis. - Responsabilidades:extrair tokens de entrada, saída e totais de cada resposta, anexando-os como custos de solicitação e aplicando orçamentos por consumidor ou por modelo em todas as réplicas de proxy.
- Interfaces:API Kubernetes, Redis (6379).
- Componentes:processador externo (
- Gerenciamento de tráfego:os recursos padrão da API Gateway se aplicam ao tráfego de IA.
- Componentes:
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - Responsabilidades:correspondência baseada em host, caminho e cabeçalho, tempos limite adequados para gerações longas, novas tentativas, divisão ponderada de tráfego e fallback baseado em prioridade entre back-ends.
- Interfaces:API Kubernetes.
- Componentes:
- Observabilidade:as métricas de solicitação, latência e token estão disponíveis para todos os modelos.
- Componentes:registros de acesso e estatísticas do proxy Envoy, métricas do processador externo (uso de token, duração da solicitação, tempo até o primeiro token), métricas do Endpoint Picker.
- Responsabilidades:expor métricas no formato do Prometheus e registros de acesso estruturados que a pilha de observabilidade do GDC ou um Prometheus gerenciado pelo cliente pode extrair.
- Interfaces:endpoints de métricas do Prometheus, registros de saída padrão.
- Gerenciamento de artefatos isolados:todas as imagens e gráficos são preparados no Harbor antes da instalação.
- Componentes:Harbor,
seed_registry.sh, contas de robô, segredos de extração de imagens, recursoEnvoyProxy(imagem de proxy e segredo de extração). - Responsabilidades:incluir imagens e gráficos Helm OCI de uma estação de trabalho conectada, fixar versões, renderizar gráficos off-line com
helm template. - Interfaces:API OCI Distribution, API Kubernetes.
- Componentes:Harbor,
Princípios de arquitetura
- Padrões primeiro: o gateway é configurado pela API Gateway do Kubernetes e pela extensão de inferência dela. Ele se comunica com a API compatível com a OpenAI para aplicativos. Assim, aplicativos, rotas e back-ends permanecem portáteis em todas as implementações de gateway.
- Segurança em primeiro lugar: todos os componentes e dados residem no limite do GDC com isolamento físico. O TLS é encerrado no
Gateway, as credenciais de back-end são injetadas pelo gateway, e o acesso à rede é restrito com objetosNetworkPolicyeProjectNetworkPolicy. - Soberania de dados: comandos, respostas, ponderações de modelo e dados de uso nunca saem da organização do GDC do cliente. Nenhuma conectividade externa é necessária para a operação.
- Separação de responsabilidades: a API Gateway orientada a funções permite que o administrador da plataforma tenha as políticas de
GatewayClass,Gateway, TLS e rede, enquanto as equipes de aplicativos têm os recursosAIGatewayRoute,AIServiceBackendeInferencePoolnos próprios namespaces. - Plano de controle e dados desacoplados: os controladores apenas traduzem a configuração. O caminho da solicitação consiste no proxy Envoy, no sidecar do processador externo e no Endpoint Picker, que continuam atendendo ao tráfego se um controlador for reiniciado.
- Aberto e flexível: a arquitetura usa software de código aberto em toda parte (Envoy Gateway, Envoy Agent Router, extensão de inferência da API Gateway, Ollama, vLLM), e os mesmos recursos da API Gateway podem ser atendidos por implementações alternativas.
- Escalonabilidade e performance: o plano de dados é escalonado horizontalmente com a adição de réplicas de proxy e verticalmente com o ajuste de CPU e memória. O balanceamento de carga compatível com o servidor de modelos mantém as GPUs saturadas sem sobrecarregar réplicas individuais.
- Experiência simplificada do usuário final: um endpoint, um formato de API e uma credencial para cada modelo encurtam o caminho da implantação ao consumo.
- Resiliência: as verificações de integridade e a replicação do Kubernetes, as novas tentativas do Envoy e o fallback baseado em prioridade entre back-ends mantêm o endpoint disponível quando réplicas de modelo individuais falham.
Considerações
- Escalonabilidade e desempenho:
- Os componentes do gateway são cargas de trabalho somente de CPU. O proxy Envoy
Deploymentde umGatewayé escalonado horizontalmente aumentando a contagem de réplicas (recursoEnvoyProxy) e verticalmente aumentando as solicitações de CPU e memória. A inspeção de corpo pelo processador externo custa CPU proporcional ao tamanho da solicitação e da resposta. As respostas transmitidas são processadas de forma incremental. - O balanceamento de carga com reconhecimento do servidor de modelo só se aplica a back-ends anexados como um
InferencePool. Os back-ends anexados como umAIServiceBackendsão balanceados pelo proxy nos endpoints doService. - O gateway não adiciona capacidade de GPU: a capacidade de processamento e a latência são limitadas pelos servidores de modelo. Dimensionar as implantações de modelo com o conjunto de guias complementares (vLLM para alta capacidade de processamento, Ollama para facilidade de uso e avaliação somente de CPU).
- Gerações longas precisam de tempos limite de solicitação e inatividade mais longos do que as APIs HTTP típicas. Configure-os nas rotas e políticas, e não nos clientes.
- Os componentes do gateway são cargas de trabalho somente de CPU. O proxy Envoy
- Gerenciamento de recursos:
- Todos os componentes do gateway são executados em nós de CPU e não precisam de acelerador. A tabela a seguir mostra um dimensionamento indicativo para uma implantação funcional. A implementação de referência define as solicitações e os limites exatos. Os valores de produção dependem da taxa de solicitação e dos tamanhos de payload.
- A tabela de portas a seguir lista todas as portas que as políticas de rede precisam permitir.
- O planejamento de GPU pertence às implantações de modelo: os nomes de recursos do acelerador são descobertos nos nós, conforme descrito no conjunto de guias complementares.
Dimensionamento indicativo dos componentes do gateway (somente CPU)
| Componente | Réplicas | CPU (solicitação) | Memória (solicitação) | Observações |
|---|---|---|---|---|
| Controlador do Envoy Gateway | 1 | 100 m a 500 m | 256Mi–1Gi | Plano de controle; não está no caminho da solicitação |
| Controlador do roteador de agente do Envoy | 1 | 100 m a 500 m | 256Mi–512Mi | Plano de controle e servidor de extensão |
Proxy Envoy Pod (proxy + arquivo secundário do processador externo) |
1 a 2 por Gateway |
500m–2 | 512Mi–2Gi | Escalonamento com taxa de solicitação e tamanho do payload |
| Selecionador de endpoints | 1 por InferencePool |
100 m a 500 m | 256Mi–512Mi | Extrai as métricas do servidor de modelo. |
| Serviço de limitação de taxa (opcional) | 1 | 100 m a 500 m | 256Mi–512Mi | Somente com limitação de taxa global |
| Redis (opcional) | 1 | 100 m a 500 m | 256Mi–1Gi | Somente com limitação de taxa global |
Portas de rede
| Porta | Componente | Finalidade |
|---|---|---|
| 80 / 443 | Proxy Envoy (listeners de Gateway) |
Ponto de entrada HTTP / HTTPS no VIP LoadBalancer |
| 1063 | Controlador de roteador do agente do Envoy (servidor de extensão) | Chamadas gRPC do gerenciador de extensões do Envoy Gateway |
| 9002 | Selecionador de endpoints | Chamadas gRPC ext_proc do proxy Envoy |
| 6379 | Redis | Contadores de limite de taxa |
| 8000 | vLLM | API compatível com a OpenAI e métricas do servidor de modelo |
| 11434 | Ollama | Ollama e API compatível com OpenAI do servidor de modelo |
- Disponibilidade e confiabilidade:
- O proxy e o processador externo são executados no mesmo
Pod. Várias réplicas por trás da máscaraLoadBalancerServiceevitam falhas individuais dePod, e os controladores podem ser reiniciados sem interromper o tráfego. - As regras
AIGatewayRoutepodem listar vários back-ends com prioridades para que o gateway faça fallback para outro conjunto de réplicas ou servidor de modelo quando um back-end estiver com problemas. - O seletor de endpoints é um
Deploymentpor pool. Se ele não estiver disponível, as solicitações para esseInferencePoolvão falhar até que ele volte. Execute-o com solicitações de recursos e sondagens de prontidão e monitore-o como um componente do plano de dados. - O Redis mantém apenas contadores de limitação de taxa. Uma interrupção do Redis afeta a limitação de taxa, não o roteamento.
- O proxy e o processador externo são executados no mesmo
- Complexidade operacional:
- Alinhamento de versão entre o Envoy Gateway, o Envoy Agent Router e a extensão de inferência da API Gateway: faça upgrade dos três juntos com a combinação testada (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, extensão de inferência da API Gateway 1.5.0).
- Ciclo de vida com isolamento físico: todas as imagens e gráficos são reinseridos no Harbor para cada upgrade. O recurso
EnvoyProxye os valores do gráfico fixam o registro e o segredo de extração. - Duas camadas de configuração:
GatewayClass/Gateway/EnvoyProxypertencentes à plataforma eAIGatewayRoute/AIServiceBackend/InferencePoolpertencentes à equipe. Integrar um novo modelo significa adicionar uma regra de rota e um back-end, não um novo gateway. - Monitoramento: taxa de solicitação, latência (incluindo o tempo até o primeiro token), uso de token por modelo e por consumidor, pontuação do Endpoint Picker e utilização da GPU dos servidores de modelo.
- A
InferenceObjectiveainda é uma API Alfa (v1alpha2). Portanto, espere mudanças no esquema entre as versões da extensão Inference.
- Segurança e compliance:
- Toda a solução opera dentro do perímetro de segurança isolado por ar do GDC.
- As políticas de rede são obrigatórias: um namespace
NetworkPolicyaceita tráfego do proxy para as portas do servidor de modelo (8000, 11434) e para o Endpoint Picker (9002), e umProjectNetworkPolicyaceita tráfego do cliente para o VIPLoadBalancerquando os consumidores residem fora do projeto. - O TLS é encerrado no
Gatewaycom um certificado armazenado em umSecretdo Kubernetes. Os clientes só veem o endpoint do gateway. - As credenciais upstream (por exemplo, uma chave de API exigida por um servidor de modelo) são armazenadas em
Secrets referenciados por umBackendSecurityPolicye injetados pelo gateway. Assim, os aplicativos nunca mantêm credenciais de back-end. - A limitação de taxa baseada em token restringe o consumo de capacidade de GPU cara por consumidor ou por modelo.
- As contas de robô do Harbor e os secrets de extração de imagens do Kubernetes garantem o acesso seguro a imagens de contêiner. O RBAC da API Gateway orientado a papéis separa as responsabilidades da plataforma e do aplicativo.
Decisões de design
As seguintes decisões de design importantes foram tomadas para esta arquitetura de referência:
Decisão 1: implementação do gateway de IA: roteador de agente Envoy de código aberto no gateway Envoy versus distribuições alternativas
| Contexto | Decisão principal | Justificativa |
|---|---|---|
| O gateway de IA é a principal opção de arquitetura com alternativas viáveis, desde opções de código aberto autogerenciadas até ofertas com suporte comercial: (a) Envoy Agent Router no Envoy Gateway (código aberto), (b) kgateway e agentgateway (implementações de API de gateway de código aberto que também processam o tráfego do provedor de LLM, ferramentas do MCP e comunicação entre agentes em um plano de dados, opcionalmente com suporte do fornecedor da solo.io) e (c) Solo Enterprise para agentgateway como a opção premium com suporte comercial. | A implementação de referência usa o roteador de agente Envoy de código aberto no gateway Envoy. As alternativas continuam sendo opções válidas nos mesmos recursos da API Gateway. Uma distribuição com suporte comercial é recomendada para ambientes de produção que exigem suporte dedicado do fornecedor. | Vantagens do código aberto: leve e compatível com padrões, roteamento de camada 7 de alta performance, sem taxas de licenciamento, ideal para avaliar a solução antes de se comprometer com uma oferta paga. O roteador de agente do Envoy é a opção validada neste conjunto de guias. Desvantagens do código aberto: o suporte é feito com base no melhor esforço da equipe de soluções e da comunidade, o que pode não atender aos ambientes de produção principais. Vantagens premium: contratos de suporte empresarial para o ciclo de vida do gateway e, geralmente, recursos agênticos avançados. Desvantagens do Premium: licenciamento ou contrato de suporte pago e um relacionamento adicional com um fornecedor. |
Decisão 2: API Kubernetes Gateway com a extensão de inferência x Entrada ou uma API de gateway proprietária
| Contexto | Decisão principal | Justificativa |
|---|---|---|
| Os endpoints de inferência podem ser expostos com a API Ingress legada, um formato de configuração específico do gateway ou a API Kubernetes Gateway. O balanceamento de carga com reconhecimento de modelo também precisa de uma maneira de descrever os pools de servidores de modelo e as prioridades deles. | A solução padroniza a API Kubernetes Gateway (GatewayClass, Gateway, rotas) implementada pelo Envoy Gateway e a extensão de inferência da API Gateway (InferencePool, InferenceObjective, Endpoint Picker) para roteamento com reconhecimento de modelo. |
A API Gateway é o padrão do Kubernetes que substitui Entrada, é orientada a funções (equipes de plataforma x equipes de aplicativos) e portátil em todas as implementações. A extensão de inferência é o padrão da comunidade para roteamento com reconhecimento de servidor de modelo (profundidade da fila, cache KV, prioridades) e é compatível com o roteador do agente Envoy sem configuração. As distribuições alternativas de gateway implementam as mesmas APIs, o que mantém a decisão 1 reversível. |
Decisão 3: roteamento baseado no corpo no campo model de solicitações compatíveis com a OpenAI como o endpoint unificado
| Contexto | Decisão principal | Justificativa |
|---|---|---|
Os aplicativos podem acessar modelos por um endpoint por modelo (com base no host ou no caminho), por um conjunto de cabeçalhos personalizados definidos pelo cliente ou pelo campo model que toda solicitação compatível com a OpenAI já carrega. |
O gateway expõe um endpoint e rotas compatíveis com a OpenAI no campo model: o processador externo extrai isso para o cabeçalho x-ai-eg-model, e as regras AIGatewayRoute correspondem a esse cabeçalho. |
Os clientes e SDKs compatíveis com a OpenAI funcionam sem alterações e trocam de modelos mudando uma string. Os endpoints, as credenciais e o posicionamento do modelo podem mudar sem afetar os aplicativos. As mesmas regras podem mapear um nome de modelo para vários back-ends para divisão de tráfego, substituição ou substituições de nome de modelo. |
Decisão 4: inclusão de artefatos com isolamento físico no Harbor x extrações sob demanda
| Contexto | Decisão principal | Justificativa |
|---|---|---|
| A instalação upstream extrai imagens de contêiner de registros públicos e gráficos Helm como artefatos OCI sob demanda, o que é impossível em um ambiente isolado. | Todas as imagens de contêiner (proxy Envoy, gateway Envoy, controlador de roteador do agente Envoy e processador externo, serviço de limitação de taxa, seletor de endpoints, Redis) e os gráficos do Helm do gateway Envoy e do roteador do agente Envoy são propagados em um projeto do Harbor com seed_registry.sh (crane). Os gráficos são renderizados off-line com helm template do Harbor, e o recurso EnvoyProxy e os valores do gráfico fixam o registro do Harbor e o segredo de extração. |
Uma etapa de propagação repetível e auditável por versão. O cluster nunca precisa de conectividade externa. A fixação de versão torna os upgrades explícitos e reversíveis. |
Decisão 5: limitação de taxa opcional baseada em token com Redis versus limites baseados em solicitação apenas
| Contexto | Decisão principal | Justificativa |
|---|---|---|
| A capacidade da GPU é consumida por token, não por solicitação. Um limite de contagem de solicitações não pode proteger um modelo compartilhado de alguns comandos muito grandes ou gerações longas. A limitação de taxa global no Envoy Gateway precisa de um repositório de contadores compartilhados. | A limitação de taxa baseada em token é um recurso opcional da arquitetura: o processador externo registra a entrada, a saída e o total de tokens por solicitação (llmRequestCosts), um BackendTrafficPolicy impõe o orçamento, e uma instância do Redis (Redis 8.10, implantado no cluster ou em uma instância atual) armazena os contadores. Implantações sem limitação de taxa não precisam do Redis. |
O uso é medido na unidade que reflete o custo, os orçamentos são aplicados de maneira consistente em todas as réplicas de proxy, e a dependência só é paga por clientes que precisam de cotas. |
Decisão 6: topologia: controle de gateway e plano de dados em um namespace dedicado de um cluster padrão, modelos em namespaces de aplicativos
| Contexto | Decisão principal | Justificativa |
|---|---|---|
| O gateway pode ser executado em um cluster dedicado, em todos os namespaces de aplicativos ou uma vez por cluster padrão ao lado dos modelos que ele apresenta. Os modelos de peso aberto no GDC com isolamento físico são implantados em clusters padrão (conjunto de guias complementares). | O plano de controle do Envoy Gateway e do Envoy Agent Router e o plano de dados do proxy Envoy são executados em um namespace dedicado do cluster padrão que hospeda os modelos: AIGatewayRoute, AIServiceBackend, InferencePool. As implantações de modelo ficam nos namespaces do aplicativo e são referenciadas em todos os namespaces. |
As solicitações permanecem dentro da rede do cluster entre o proxy e os Pods do modelo (menor latência, sem balanceadores de carga adicionais), o administrador da plataforma é proprietário do namespace do gateway, enquanto as equipes de aplicativos são proprietárias das rotas e modelos, e o Endpoint Picker pode extrair os servidores de modelo diretamente. Um gateway de cliente por projeto que encaminha para um gateway de servidor central continua sendo uma extensão dessa topologia para consumo em vários projetos. |
Suposições e limitações
- O ambiente GDC com isolamento físico 1.16.2-hf1 ou mais recente está disponível com um cluster padrão que executa o Kubernetes v1.32.13-gke.400 ou mais recente.
- Recursos de hardware suficientes (especialmente GPUs) estão presentes para os backends de serviço de modelo. Os componentes de gateway são executados em nós de CPU. Modelos reais precisam de GPUs. Modelos pequenos no Ollama podem ser executados na CPU apenas para avaliação funcional.
- Uma instância do Harbor está configurada e acessível, e uma estação de trabalho com acesso à Internet e conectividade com o ambiente do GDC (API do Harbor e do Kubernetes) está disponível para propagação de imagens e gráficos.
- Os usuários têm as permissões necessárias: papéis do projeto "Leitor da instância do Harbor" e "Administrador do cluster Standard", além de um
StandardClusterRoleBindingpara o papelcluster-adminno cluster Standard para a instalação no escopo do cluster (CRDs,GatewayClass, namespaces). Consulte a implementação de referência. - Os back-ends de disponibilização do modelo expõem uma API compatível com a OpenAI. Os back-ends anexados como um
InferencePooltambém expõem as métricas compatíveis com vLLM em que o Endpoint Picker se baseia. - Limitação:o suporte para os componentes de código aberto (Envoy Gateway, Envoy Agent Router, extensão de inferência da API Gateway) é feito da melhor maneira possível pela equipe de soluções. Para ter suporte dedicado do fornecedor, é necessário usar uma distribuição com suporte comercial (Decisão 1).
- Limitação:
InferenceObjectiveé uma API Alfa (inference.networking.x-k8s.io/v1alpha2) e pode mudar entre as versões da extensão Inference. - Limitação:um VIP
LoadBalancerpara oGatewaye umProjectNetworkPolicysão necessários para consumidores fora do projeto. Dentro do projeto, clientes no cluster oukubectl port-forwardpodem acessar o gatewayServicediretamente. - Limitação:o Gemini no GDC, o ajuste fino de modelos, os modelos de IA generativa não LLM e a veiculação de modelos de vários nós estão fora do escopo desta versão da solução.
Fluxo do usuário
Confira a seguir um fluxo do usuário abrangente para o gateway de IA no GDC com isolamento físico: primeiro, o caminho de solicitação em que um desenvolvedor de aplicativos confia e, em seguida, o caminho de configuração que o administrador da plataforma segue.
1. Caminho da solicitação do desenvolvedor
Um aplicativo ou agente precisa apenas do endpoint do gateway, uma credencial do cliente se o gateway exigir uma e o nome do modelo.
- Envie a solicitação:o aplicativo chama
POST /v1/chat/completionsno endpoint do gateway com um corpo JSON compatível com a OpenAI que nomeia o modelo (por exemplo,"model": "gemma"), exatamente como chamaria qualquer serviço compatível com a OpenAI. - Entra no gateway:a solicitação chega ao VIP
LoadBalancerdoGateway. O proxy Envoy encerra o TLS e corresponde ao listener e à rota. - Processar o corpo:o proxy entrega a solicitação ao processador externo do roteador do agente Envoy, que analisa o corpo, extrai o nome do modelo para o cabeçalho
x-ai-eg-modele traduz o payload para o esquema de back-end, se for diferente. - Selecione o back-end:a regra
AIGatewayRouteque corresponde ao nome do modelo seleciona umAIServiceBackend(por exemplo, o OllamaService) ou umInferencePool(por exemplo, um conjunto de réplicas vLLM). Para umInferencePool, o seletor de endpoints escolhe a réplica com a fila mais curta e a melhor correspondência de cache KV. - Encaminhar e responder:o proxy injeta credenciais upstream quando um
BackendSecurityPolicyé aplicado, encaminha a solicitação para oPodescolhido, transmite a resposta de volta e permite que o processador externo registre o uso do token, que alimenta as métricas e, quando configurado, o limite de taxa baseado em token. - Trocar de modelo:para usar outro modelo, o desenvolvedor muda a string
model. Não é necessário um novo endpoint, credencial ou biblioteca de cliente.
2. Caminho de configuração do administrador da plataforma
- Fazer seed de artefatos no Harbor:crie as contas de robô do Harbor e copie as imagens de contêiner e os gráficos do Helm do Envoy Gateway e do Envoy Agent Router para o Harbor com
seed_registry.shde uma estação de trabalho com acesso à Internet. - Instale o Envoy Gateway:renderize os gráficos de CRD e controlador do Harbor
com
helm templatee aplique-os no namespace do gateway. Crie o recursoEnvoyProxyque fixa a imagem do proxy e o segredo de extração e verifique o controlador com umGatewayClass,GatewayeHTTPRoutebásicos. - Instalar o roteador do agente Envoy:instale os CRDs do roteador do agente Envoy e os
CRDs da extensão de inferência da API Gateway, implante o controlador do roteador do agente Envoy
e reconfigure o Envoy Gateway para chamar o servidor de extensão (porta
1063) e aceitar back-ends
InferencePool. Se quiser, implante o Redis e ative o serviço global de limitação de taxa. - Exponha o gateway:crie o
GatewayClasse oGatewaycom listeners HTTP e HTTPS (certificado TLSSecret), aguarde o VIPLoadBalancere aplique oProjectNetworkPolicypara consumidores fora do projeto. - Anexar modelos:implante os back-ends de veiculação de modelos com o conjunto de guias
complementares e crie recursos
AIServiceBackendparaServices compatíveis com a OpenAI eInferencePool, além de recursos do seletor de endpoints para conjuntos de réplicas compatíveis com vLLM, junto com os objetos do namespaceNetworkPolicy. - Publicar a rota:crie o
AIGatewayRoutecom uma regra por nome de modelo (roteamento com base no corpo) e, quando necessário, objetosBackendSecurityPolicyeBackendTrafficPolicypara credenciais upstream e orçamentos de token. - Validar e operar:chame
/v1/modelse/v1/chat/completionspelo VIP (ou um fallbackkubectl port-forward), verifique o proxy, o processador externo e as métricas do Endpoint Picker e entregue os nomes do endpoint e do modelo às equipes de aplicativos. Escalone réplicas de proxy e implantações de modelo de forma independente. Faça upgrade do Envoy Gateway, do Envoy Agent Router e da extensão de inferência juntos.
As etapas detalhadas estão disponíveis na implementação de referência do roteador de agente do Envoy e no guia do usuário do roteador de agente do Envoy para roteamento baseado no corpo.
Outros materiais
- Implementação de referência do roteador de agente do Envoy
- Guia do usuário do roteador de agente Envoy para roteamento baseado no corpo
- Arquitetura de referência de LLMs de peso aberto
- Documentação do roteador de agentes do Envoy
- Envoy Gateway
- API Kubernetes Gateway
- Extensão Gateway API Inference
- Documentação do Google Distributed Cloud com isolamento físico