


A finalidade de uma configuração de alta disponibilidade é reduzir a inatividade quando uma instância de cluster de banco de dados fica indisponível. Isso pode acontecer quando uma instância fica sem memória. A alta disponibilidade permite que seus dados continuem disponíveis para aplicativos cliente.
Em um site, a configuração é composta por uma instância principal e uma réplica em espera. Todas as gravações feitas na instância principal são replicadas na réplica em espera antes que uma transação seja relatada como confirmada. Se a instância principal ficar indisponível, o GDC vai promover automaticamente a réplica em espera para atuar como a nova instância principal. O tráfego do aplicativo é então redirecionado para a nova instância principal. Esse processo é chamado de failover.
Um failover automático é iniciado após três falhas consecutivas na verificação de integridade na instância principal, com 30 segundos de intervalo entre cada uma.
O GDC é compatível com failover automático e manual. O failover automático é ativado por padrão, e você pode desativá-lo, se necessário. Também é possível acionar manualmente um failover a qualquer momento para se recuperar de uma falha inesperada e minimizar o tempo de inatividade.
O failover envolve o seguinte processo, em ordem:
O GDC coloca a instância principal off-line.
O GDC transforma a réplica em espera no novo cluster de banco de dados ativo.
O GDC exclui o cluster de banco de dados ativo anterior.
O GDC cria uma nova réplica em espera.
Atualizar um cluster atual
É possível atualizar as configurações de alta disponibilidade de um cluster de banco de dados:
Console
No menu de navegação, selecione Serviço de banco de dados.
Na lista de clusters de banco de dados, clique no cluster que você quer atualizar.
Selecione Editar Editar na seção Alta disponibilidade.
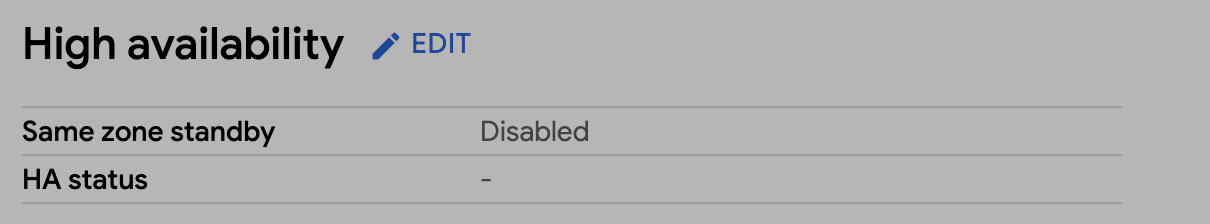
Selecione Ativar espera na mesma zona para ativar ou desativar a disponibilidade de uma instância em espera na mesma zona do cluster de banco de dados principal.
Clique em Salvar.
Verifique se o cluster de banco de dados reflete a atualização de alta disponibilidade visualizando o status na coluna Alta disponibilidade da lista de clusters de banco de dados.
gdcloud
Atualize a configuração de alta disponibilidade do cluster de banco de dados:
gdcloud database clusters update CLUSTER_NAME \
    --availability-type HA_TYPE
Substitua:
CLUSTER_NAME: o nome do cluster de banco de dados.HA_TYPE: o nível de alta disponibilidade do cluster de banco de dados. É possível definirzonalouzonal_ha. O valorzonalé definido por padrão.
Verifique se o cluster de banco de dados reflete a atualização de alta disponibilidade:
gdcloud database clusters list
API
Atualize a configuração de alta disponibilidade do cluster de banco de dados:
  kubectl patch dbcluster.postgresql.dbadmin.gdc.goog DBCLUSTER_NAME \
    -n USER_PROJECT \
    -p '{"spec": {"availability": {"enableHighAvailability": HA_ENABLED}}}' \
    --type=merge
Substitua as seguintes variáveis:
DBCLUSTER_NAME: o nome do cluster de banco de dados.USER_PROJECT: o nome do projeto de usuário em que o cluster de banco de dados foi criado.HA_ENABLED: o nível de alta disponibilidade do cluster de banco de dados. É possível definirtrueoufalse. O valorfalseé definido por padrão.
Verifique se o cluster de banco de dados reflete a atualização de alta disponibilidade:
kubectl get dbcluster.DBENGINE_NAME.dbadmin.gdc.goog DBCLUSTER_NAME \
  -n USER_PROJECT \
  -o yaml
Migrar para a implementação de alta disponibilidade mais recente
Para verificar se o cluster de banco de dados de alta disponibilidade está usando a implementação mais recente, confira se a anotação dbcluster.dbadmin.goog/raasEnabled existe no CR do cluster de banco de dados de alta disponibilidade. Essa anotação só vai aparecer em clusters que usam a nova implementação. Se você não tiver essa anotação, poderá ativá-la e migrar o cluster seguindo estas etapas:
- Verifique com o operador de infraestrutura se o ambiente do GDC foi atualizado para a versão 1.15.1 ou mais recente.
- Desative a alta disponibilidade no cluster de banco de dados. Aguarde até que a condição
HAReadydesapareça e reative a alta disponibilidade. - Depois de ver
HAReady in progressouHAReady setup complete, verifique se há a anotaçãodbcluster.dbadmin.goog/raasEnabledno CR do cluster de banco de dados. Se ele aparecer, significa que o cluster de banco de dados foi migrado.
Acionar um failover
Se você tiver configurado a alta disponibilidade para o cluster de banco de dados, poderá acionar um failover. Para acionar um failover, siga estas etapas:
Console
No menu de navegação, selecione Serviço de banco de dados.
Na lista de clusters de banco de dados, clique no cluster de banco de dados para acionar um failover. O cluster de banco de dados precisa ter a alta disponibilidade ativada para estar qualificado para um failover.
Clique em Failover.
Digite o ID do cluster para a frase de confirmação e clique em Failover para acionar o processo de failover.
gdcloud
Acione o failover para o cluster de banco de dados:
gdcloud database clusters failover CLUSTER_NAME
Substitua CLUSTER_NAME pelo nome do cluster de banco de dados.
API
  apiVersion: fleet.dbadmin.gdc.goog/v1
  kind: Failover
  metadata:
    name: FAILOVER_NAME
    namespace: USER_PROJECT
  spec:
    dbclusterRef: DBCLUSTER_NAME
Substitua as seguintes variáveis:
DBCLUSTER_NAME, o nome do cluster de banco de dados.USER_PROJECT: o nome do projeto de usuário em que o cluster de banco de dados foi criado.FAILOVER_NAME, o nome exclusivo do failover, por exemplo,failover-sample.
Desativar o failover automático
O failover automático é ativado por padrão em clusters de banco de dados de alta disponibilidade.
Para desativar o failover automático, defina enableAutoFailover como false no
manifesto do cluster de banco de dados:
spec:
  availability:
    enableAutoFailover: false
Para atualizar a configuração de failover automático de um cluster de banco de dados usando a API, execute o seguinte comando:
kubectl patch dbcluster.postgresql.dbadmin.gdc.goog DBCLUSTER_NAME \
  -n USER_PROJECT \
  -p '{"spec": {"availability": {"enableAutoFailover": AUTO_FAILOVER_ENABLED}}}' \
  --type=merge
Substitua as seguintes variáveis:
DBCLUSTER_NAME: o nome do cluster de banco de dados.USER_PROJECT: o nome do projeto de usuário em que o cluster de banco de dados foi criado.AUTO_FAILOVER_ENABLED: a configuração de failover automático para o cluster de banco de dados. É possível definirtrueoufalse. O valortrueé definido por padrão.