


A finalidade de uma configuração de alta disponibilidade é reduzir a inatividade quando uma instância de cluster de banco de dados fica indisponível. Isso pode acontecer quando uma instância fica sem memória. A alta disponibilidade permite que seus dados continuem disponíveis para aplicativos cliente.
Em um site, a configuração é composta por uma instância principal e uma réplica de espera. Todas as gravações feitas na instância principal são replicadas na réplica de espera antes da confirmação da transação. Em caso de falha na instância, você pode solicitar que a réplica de espera se torne a nova instância principal. O tráfego do aplicativo é redirecionado para a nova instância principal. Esse processo é chamado de failover.
Você pode acionar um failover manualmente a qualquer momento. O failover envolve o seguinte processo, em ordem:
O GDC coloca a instância principal off-line.
O GDC transforma a réplica de espera no novo cluster de banco de dados ativo.
O GDC exclui o cluster de banco de dados ativo anterior.
O GDC cria uma nova réplica de espera.
Atualizar um cluster atual
É possível atualizar as configurações de alta disponibilidade de um cluster de banco de dados atual:
Console
No menu de navegação, selecione Serviço de banco de dados.
Na lista de clusters de banco de dados, clique no cluster de banco de dados que você quer atualizar.
Selecione editar Editar em a seção Alta disponibilidade.
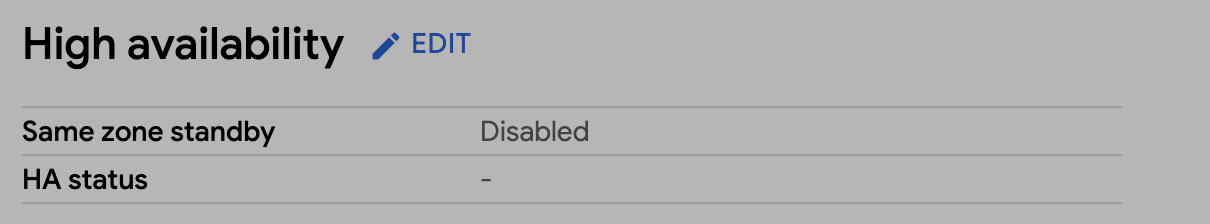
Selecione Ativar espera na mesma zona para ativar ou desativar a disponibilidade de uma instância de espera na mesma zona do cluster de banco de dados principal.
Clique em Salvar.
Verifique se o cluster de banco de dados reflete a atualização de alta disponibilidade visualizando o status na coluna Alta disponibilidade da lista de clusters de banco de dados.
gdcloud
Atualize a configuração de alta disponibilidade do cluster de banco de dados:
gdcloud database clusters update CLUSTER_NAME \
    --availability-type HA_TYPE
Substitua:
CLUSTER_NAME: o nome do cluster de banco de dados.HA_TYPE: o nível de alta disponibilidade do cluster de banco de dados. É possível definirzonalouzonal_ha. O valorzonalé definido por padrão.
Verifique se o cluster de banco de dados reflete a atualização de alta disponibilidade:
gdcloud database clusters list
API
Atualize a configuração de alta disponibilidade do cluster de banco de dados:
kubectl patch dbcluster.postgresql.dbadmin.gdc.goog DBCLUSTER_NAME \ -n USER_PROJECT \ -p '{"spec": {"availability": {"enableHighAvailability":HA_ENABLED}}}' \ --type=mergeSubstitua as seguintes variáveis:
DBCLUSTER_NAME: o nome do cluster de banco de dados.USER_PROJECT: o nome do projeto do usuário em que o cluster de banco de dados foi criado.HA_ENABLED: o nível de alta disponibilidade do cluster de banco de dados. É possível definirtrueoufalse. O valorfalseé definido por padrão.
Verifique se o cluster de banco de dados reflete a atualização de alta disponibilidade:
kubectl get dbcluster.DBENGINE_NAME.dbadmin.gdc.goog DBCLUSTER_NAME \
  -n USER_PROJECT \
  -o yaml
Migrar para a implementação de alta disponibilidade mais recente
Para verificar se o cluster de banco de dados de alta disponibilidade está usando a implementação mais recente, confira se a anotação dbcluster.dbadmin.goog/raasEnabled existe no CR do cluster de banco de dados de alta disponibilidade. Essa anotação só vai aparecer em clusters que usam a nova implementação. Se você não tiver essa anotação, ative-a e migre o cluster seguindo estas etapas:
- Verifique com o operador de infraestrutura se o ambiente do GDC foi atualizado para a versão 1.15.1 ou mais recente.
- Desative a alta disponibilidade no cluster de banco de dados. Aguarde a condição
HAReadydesaparecer e reative a alta disponibilidade. - Depois de ver
HAReady in progressouHAReady setup complete, verifique se há a anotaçãodbcluster.dbadmin.goog/raasEnabledno CR do cluster de banco de dados. Se ela aparecer, o cluster de banco de dados foi migrado.
Acionar um failover
Se você configurou a alta disponibilidade para o cluster de banco de dados, é possível acionar um failover. Para acionar um failover, siga estas etapas:
Console
No menu de navegação, selecione Serviço de banco de dados.
Na lista de clusters de banco de dados, clique no cluster de banco de dados para acionar um failover. O cluster de banco de dados precisa ter a alta disponibilidade ativada para ser qualificado para um failover.
Clique em Failover.
Digite o ID do cluster para a frase de confirmação e clique em Failover para acionar o processo de failover.
gdcloud
Acione o failover para o cluster de banco de dados:
gdcloud database clusters failover CLUSTER_NAMESubstitua
CLUSTER_NAMEpelo nome do cluster de banco de dados.
API
  apiVersion: fleet.dbadmin.gdc.goog/v1
  kind: Failover
  metadata:
    name: FAILOVER_NAME
  spec:
    dbclusterRef: DBCLUSTER_NAME
Substitua as seguintes variáveis:
DBCLUSTER_NAME, o nome do cluster de banco de dados.FAILOVER_NAME, o nome exclusivo do failover, por exemplo,failover-sample.