


הרצת שאילתה
ב-BigQuery אפשר להריץ שאילתות באופן מיידי (אינטראקטיבי), באצוות או באופן רציף, בהתאם לתרחיש לדוגמה. כדי לאמת את תחביר ה-SQL ולהעריך את כמות הנתונים שהשאילתה מעבדת, אתם יכולים לבצע הרצה יבשה. כך תוכלו לשלוט טוב יותר בעלויות.
סוגי השאילתות
אתם יכולים לשלוח שאילתות לנתונים ב-BigQuery באמצעות אחד מסוגי המשימות הבאים:
משימות של שאילתות אינטראקטיביות. כברירת מחדל, BigQuery מריץ שאילתות כעבודות של שאילתות אינטראקטיביות, שנועדו להתחיל לפעול כמה שיותר מהר.
משימות של שאילתות באצווה. לשאילתות באצווה יש עדיפות נמוכה יותר מאשר לשאילתות אינטראקטיביות. כשבפרויקט או בהזמנה נעשה שימוש בכל משאבי המחשוב הזמינים, סביר יותר ששאילתות באצווה יתווספו לתור ויישארו בו. אחרי ששאילתת אצווה מתחילה לפעול, היא פועלת כמו שאילתה אינטראקטיבית. למידע נוסף, ראו תורי שאילתות.
משימות של שאילתות מתמשכות. במשימות האלה, השאילתה פועלת באופן רציף, כך שאתם יכולים לנתח נתונים נכנסים ב-BigQuery בזמן אמת, ואז לכתוב את התוצאות בטבלה ב-BigQuery או לייצא את התוצאות ל-Bigtable או ל-Pub/Sub. אתם יכולים להשתמש ביכולת הזו כדי לבצע משימות שרגישות לזמן, כמו יצירת תובנות ופעולה מיידית לפיהן, החלת הסקת מסקנות של למידת מכונה (ML) בזמן אמת ויצירת פייפליינים מבוססי-אירועים.
אפשר להריץ משימות של שאילתות בשיטות הבאות:
- כותבים ומריצים שאילתה במסוףGoogle Cloud .
- מריצים את הפקודה
bq queryבכלי שורת הפקודה של BigQuery. - קוראים באופן פרוגרמטי ל-method
jobs.queryאוjobs.insertב-API בארכיטקטורת REST של BigQuery. - שימוש בספריות הלקוח של BigQuery.
BigQuery שומר את תוצאות השאילתה בטבלה זמנית (ברירת המחדל) או בטבלה קבועה. כשמציינים טבלה קבועה כטבלת היעד של התוצאות, אפשר לבחור אם להוסיף לטבלה קיימת או להחליף אותה, או ליצור טבלה חדשה עם שם ייחודי.
התפקידים הנדרשים
כדי לקבל את ההרשאות שדרושות להרצת משימת שאילתה, בקשו מהאדמין להקצות לכם את התפקידים הבאים ב-IAM:
- BigQuery Job User (
roles/bigquery.jobUser) בפרויקט. - BigQuery Data Viewer (
roles/bigquery.dataViewer) בכל הטבלאות ותצוגות הנתונים שהשאילתה מפנה אליהן. כדי לשלוח שאילתות לתצוגות, צריך את התפקיד הזה גם בכל הטבלאות והתצוגות הבסיסיות. אם אתם משתמשים בתצוגות מורשות או במערכי נתונים מורשים, אתם לא צריכים גישה לנתוני המקור הבסיסיים.
להסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
התפקידים המוגדרים מראש האלה כוללים את ההרשאות שנדרשות כדי להריץ משימת שאילתה. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי להריץ משימת שאילתה, נדרשות ההרשאות הבאות:
-
bigquery.jobs.createבפרויקט שממנו מריצים את השאילתה, בלי קשר למקום שבו הנתונים מאוחסנים. -
bigquery.tables.getDataבכל הטבלאות והתצוגות שהשאילתה מפנה אליהן. כדי לשלוח שאילתות לתצוגות, צריך את ההרשאה הזו גם בכל הטבלאות והתצוגות הבסיסיות. אם אתם משתמשים בתצוגות מורשות או במערכי נתונים מורשים, אתם לא צריכים גישה לנתוני המקור הבסיסיים.
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
פתרון בעיות
Access Denied: Project [project_id]: User does not have bigquery.jobs.create
permission in project [project_id].
השגיאה הזו מתרחשת כשאין לחשבון המשתמש הרשאה ליצור משימות שאילתה בפרויקט.
פתרון: אדמין צריך לתת לכם את ההרשאה bigquery.jobs.create בפרויקט שאתם שולחים אליו שאילתה. ההרשאה הזו נדרשת בנוסף לכל הרשאה שנדרשת כדי לגשת לנתונים ששלחתם לגביהם שאילתה.
במאמר בקרת גישה באמצעות IAM יש מידע נוסף על הרשאות ב-BigQuery.
הרצת שאילתה אינטראקטיבית
כדי להריץ שאילתה אינטראקטיבית, בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery.
לוחצים על שאילתת SQL.
בעורך השאילתות, מזינים שאילתת GoogleSQL תקינה.
לדוגמה, אפשר להריץ שאילתה במערך הנתונים הציבורי של BigQuery
usa_namesכדי לזהות את השמות הנפוצים ביותר בארצות הברית בין השנים 1910 ל-2013:SELECT name, gender, SUM(number) AS total FROM `bigquery-public-data.usa_names.usa_1910_2013` GROUP BY name, gender ORDER BY total DESC LIMIT 10;אפשר גם להשתמש בחלונית Reference כדי ליצור שאילתות חדשות.
אופציונלי: כדי להציג באופן אוטומטי הצעות לקוד כשמקלידים שאילתה, לוחצים על Tools > Parser-based auto-completion. אם אתם לא צריכים הצעות של השלמה אוטומטית, בטלו את הבחירה באפשרות השלמה אוטומטית מבוססת-מנתח. הפעולה הזו גם משביתה את ההצעות למילוי אוטומטי של שם הפרויקט.
אופציונלי: כדי לבחור הגדרות שאילתה נוספות, לוחצים על Edit > Query settings.
לוחצים על הפעלה.
אם לא מציינים טבלת יעד, משימת השאילתה כותבת את הפלט בטבלה זמנית (מטמון).
עכשיו אפשר לבדוק את תוצאות השאילתה בכרטיסייה Results שבחלונית Query results.
אופציונלי: כדי למיין את תוצאות השאילתה לפי עמודה, לוחצים על Open sort menu ליד שם העמודה ובוחרים סדר מיון. אם מספר הבייטים המשוער לעיבוד לצורך המיון גדול מאפס, מספר הבייטים מוצג בחלק העליון של התפריט.
אופציונלי: כדי לראות תצוגה חזותית של תוצאות השאילתה, עוברים לכרטיסייה Visualization. אפשר להגדיל או להקטין את התצוגה של התרשים, להוריד אותו כקובץ PNG או להציג או להסתיר את המקרא.
בחלונית Visualization configuration אפשר לשנות את סוג התצוגה החזותית ולהגדיר את המדדים והמאפיינים שלה. השדות בחלונית הזו מאוכלסים מראש בהגדרה הראשונית, שנגזרת מהסכימה של טבלת היעד של השאילתה. ההגדרות נשמרות בין הרצות של שאילתות באותו עורך שאילתות.
בתרשימי קו, עמודות או פיזור, המאפיינים הנתמכים הם סוגי הנתונים
INT64,FLOAT64,NUMERIC,BIGNUMERIC,TIMESTAMP,DATE,DATETIME,TIMEו-STRING, והמדדים הנתמכים הם סוגי הנתוניםINT64,FLOAT64,NUMERICו-BIGNUMERIC.אם תוצאות השאילתה כוללות את הסוג
GEOGRAPHY, אז מפה היא סוג התצוגה החזותית שמוגדר כברירת מחדל, שמאפשרת לכם להציג את התוצאות במפה אינטראקטיבית.אופציונלי: בכרטיסייה JSON אפשר לבדוק את תוצאות השאילתה בפורמט JSON, שבו המפתח הוא שם העמודה והערך הוא התוצאה של אותה עמודה.
BQ
-
מפעילים את Cloud Shell במסוף Google Cloud .
בחלק התחתון של מסוף Google Cloud יתחיל סשן של Cloud Shell ותופיע הודעה של שורת הפקודה. Cloud Shell היא סביבת מעטפת שבה ה-CLI של Google Cloud מותקן ומוגדרים ערכים לפרויקט הקיים. הסשן יופעל תוך כמה שניות.
משתמשים בפקודה
bq query. בדוגמה הבאה, הדגל--use_legacy_sql=falseמאפשר להשתמש בתחביר של GoogleSQL.bq query \ --use_legacy_sql=false \ 'QUERY'
מחליפים את QUERY בשאילתת GoogleSQL תקינה. לדוגמה, אפשר להריץ שאילתה במערך הנתונים הציבורי של BigQuery
usa_namesכדי לגלות מהם השמות הנפוצים ביותר בארצות הברית בין השנים 1910 ל-2013:bq query \ --use_legacy_sql=false \ 'SELECT name, gender, SUM(number) AS total FROM `bigquery-public-data.usa_names.usa_1910_2013` GROUP BY name, gender ORDER BY total DESC LIMIT 10;'משימת השאילתה כותבת את הפלט לטבלה זמנית (במטמון).
אפשר גם לציין את טבלת היעד ואת המיקום של תוצאות השאילתה. כדי לכתוב את התוצאות בטבלה קיימת, צריך לכלול את הדגל המתאים להוספה (
--append_table=true) או להחלפה (--replace=true) של הטבלה.bq query \ --location=LOCATION \ --destination_table=TABLE \ --use_legacy_sql=false \ 'QUERY'
מחליפים את מה שכתוב בשדות הבאים:
LOCATION: האזור או מספר האזורים של טבלת היעד, לדוגמה
USבדוגמה הזו, מערך הנתונים
usa_namesמאוחסן במיקום של מספר אזורים בארה"ב. אם מציינים טבלת יעד לשאילתה הזו, מערך הנתונים שמכיל את טבלת היעד צריך להיות גם הוא במספר אזורים בארה"ב. אי אפשר לשלוח שאילתה למערך נתונים במיקום אחד ולכתוב את התוצאות בטבלה במיקום אחר.אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ bigqueryrc..
TABLE: שם לטבלת היעד, למשל
myDataset.myTableאם טבלת היעד היא טבלה חדשה, BigQuery יוצר את הטבלה כשמריצים את השאילתה. אבל צריך לציין מערך נתונים קיים.
אם הטבלה לא נמצאת בפרויקט הנוכחי, מוסיפים את מזהה הפרויקט בפורמטGoogle Cloud , לדוגמה
PROJECT_ID:DATASET.TABLE, ואזmyProject:myDataset.myTable. אם לא מציינים את--destination_table, נוצרת משימת שאילתה שכותבת את הפלט לטבלה זמנית.
Terraform
משתמשים במשאב google_bigquery_job.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
בדוגמה הבאה מריצים שאילתה. כדי לאחזר את תוצאות השאילתה, אפשר לצפות בפרטי המשימה:
כך מחילים את ההגדרות של Terraform בפרויקט ב- Google Cloud :
הכנת Cloud Shell
- מפעילים את Cloud Shell.
-
מגדירים את פרויקט ברירת המחדל ב- Google Cloud שבו רוצים להחיל את ההגדרות של Terraform.
תצטרכו להריץ את הפקודה הזו רק פעם אחת לכל פרויקט, ותוכלו לעשות זאת בכל ספרייה.
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
אם תגדירו ערכים ספציפיים בקובץ התצורה של Terraform, הם יבטלו את ערכי ברירת המחדל של משתני הסביבה.
הכנת הספרייה
לכל קובץ תצורה של Terraform צריכה להיות ספרייה משלו (שנקראת גם מודול ברמה הבסיסית).
-
יוצרים ספרייה חדשה ב-Cloud Shell ובה יוצרים קובץ חדש. שם הקובץ חייב לכלול את הסיומת
.tf, למשלmain.tf. במדריך הזה, הקובץ נקראmain.tf.mkdir DIRECTORY && cd DIRECTORY && touch main.tf
-
אם אתם עוקבים אחרי המדריך, תוכלו להעתיק את הקוד לדוגמה בכל קטע או שלב.
מעתיקים את הקוד לדוגמה בקובץ
main.tfהחדש שיצרתם.לחלופין, אפשר גם להעתיק את הקוד מ-GitHub. כדאי לעשות את זה כשקטע הקוד של Terraform הוא חלק מפתרון מקצה לקצה.
- בודקים את הפרמטרים לדוגמה ומשנים אותם בהתאם לסביבה שלכם.
- שומרים את השינויים.
-
מפעילים את Terraform. צריך לעשות זאת רק פעם אחת לכל ספרייה.
terraform init
אופציונלי: תוכלו לכלול את האפשרות
-upgrade, כדי להשתמש בגרסה העדכנית ביותר של הספק של Google:terraform init -upgrade
החלה של השינויים
-
בודקים את ההגדרות ומוודאים שהמשאבים שמערכת Terraform תיצור או תעדכן תואמים לציפיות שלכם:
terraform plan
מתקנים את ההגדרות לפי הצורך.
-
מריצים את הפקודה הבאה ומזינים
yesבהודעה שמופיעה, כדי להחיל את הגדרות Terraform:terraform apply
ממתינים עד שב-Terraform תוצג ההודעה "Apply complete!".
- פותחים את הפרויקט ב- Google Cloud כדי להציג את התוצאות. במסוף Google Cloud , נכנסים למשאבים בממשק המשתמש כדי לוודא שהם נוצרו או עודכנו ב-Terraform.
API
כדי להריץ שאילתה באמצעות ה-API, מוסיפים משימה חדשה ומאכלסים את מאפיין הגדרת המשימה query. אם רוצים, אפשר לציין את המיקום במאפיין location בקטע jobReference של משאב המשימה.
מבצעים סקר כדי לקבל תוצאות באמצעות קריאה ל-getQueryResults.
מבצעים סקר עד ש-jobComplete שווה ל-true. בודקים אם יש שגיאות ואזהרות ברשימה errors.
C#
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של C# במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery C# API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להריץ שאילתה עם שרת proxy, קראו את המאמר הגדרת שרת proxy.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של PHP במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Ruby
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Ruby במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Ruby API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
הרצה יבשה
הרצת בדיקה ב-BigQuery מספקת את המידע הבא:
- אומדן החיובים במצב על פי דרישה
- אימות השאילתה
- מספר הבייטים המשוער שעובדו על ידי השאילתה במצב קיבולת
הרצות בדיקה לא משתמשות במשבצות של שאילתות, ואין חיוב על ביצוע הרצת בדיקה. אתם יכולים להשתמש בהערכה שמתקבלת מהרצת בדיקה כדי לחשב את עלויות השאילתה במחשבון עלויות.
הרצת בדיקה
כדי לבצע הרצת בדיקה, בצע את הפעולות הבאות:
המסוף
נכנסים לדף BigQuery.
מזינים את השאילתה בעורך השאילתות.
אם השאילתה תקינה, מופיע סימן וי באופן אוטומטי, וגם כמות הנתונים שהשאילתה תעבד. אם השאילתה לא תקינה, יופיע סימן קריאה עם הודעת שגיאה.
BQ
מזינים שאילתה כמו זו שבהמשך באמצעות הדגל --dry_run.
bq query \
--use_legacy_sql=false \
--dry_run \
'SELECT
   COUNTRY,
   AIRPORT,
   IATA
 FROM
   `project_id`.dataset.airports
 LIMIT
   1000'
אם השאילתה תקינה, הפקודה יוצרת את התגובה הבאה:
Query successfully validated. Assuming the tables are not modified,
running this query will process 10918 bytes of data.
API
כדי לבצע הרצת בדיקה באמצעות ה-API, שולחים משימת שאילתה עם dryRun שמוגדר כ-true בסוג JobConfiguration.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
PHP
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של PHP במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery PHP API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
מגדירים את המאפיין QueryJobConfig.dry_run כ-True.
הפונקציה Client.query() תמיד מחזירה QueryJob שהושלם כשמספקים הגדרת שאילתה להרצה יבשה.
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
פתרון בעיות בשאילתות
למידע על פתרון בעיות בהרצת שאילתות, קראו את המאמר פתרון בעיות בשאילתות.
הרצת שאילתת אצווה
כדי להריץ שאילתת אצווה, בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery.
לוחצים על שאילתת SQL.
בעורך השאילתות, מזינים שאילתת GoogleSQL תקינה.
לדוגמה, אפשר להריץ שאילתה במערך הנתונים הציבורי של BigQuery
usa_namesכדי לזהות את השמות הנפוצים ביותר בארצות הברית בין השנים 1910 ל-2013:SELECT name, gender, SUM(number) AS total FROM `bigquery-public-data.usa_names.usa_1910_2013` GROUP BY name, gender ORDER BY total DESC LIMIT 10;לוחצים על עריכה > הגדרות השאילתה.
בקטע Resource management, לוחצים על Batch.
אופציונלי: משנים את הגדרות השאילתה.
לוחצים על Save.
לוחצים על הפעלה.
אם לא מציינים טבלת יעד, משימת השאילתה כותבת את הפלט בטבלה זמנית (מטמון).
BQ
-
מפעילים את Cloud Shell במסוף Google Cloud .
בחלק התחתון של מסוף Google Cloud יתחיל סשן של Cloud Shell ותופיע הודעה של שורת הפקודה. Cloud Shell היא סביבת מעטפת שבה ה-CLI של Google Cloud מותקן ומוגדרים ערכים לפרויקט הקיים. הסשן יופעל תוך כמה שניות.
משתמשים בפקודה
bq queryומציינים את הדגל--batch. בדוגמה הבאה, הדגל--use_legacy_sql=falseמאפשר להשתמש בתחביר GoogleSQL.bq query \ --batch \ --use_legacy_sql=false \ 'QUERY'
מחליפים את QUERY בשאילתת GoogleSQL תקינה. לדוגמה, אפשר להריץ שאילתה במערך הנתונים הציבורי של BigQuery
usa_namesכדי לגלות מהם השמות הנפוצים ביותר בארצות הברית בין השנים 1910 ל-2013:bq query \ --batch \ --use_legacy_sql=false \ 'SELECT name, gender, SUM(number) AS total FROM `bigquery-public-data.usa_names.usa_1910_2013` GROUP BY name, gender ORDER BY total DESC LIMIT 10;'משימת השאילתה כותבת את הפלט לטבלה זמנית (במטמון).
אפשר גם לציין את טבלת היעד ואת המיקום של תוצאות השאילתה. כדי לכתוב את התוצאות בטבלה קיימת, צריך לכלול את הדגל המתאים להוספה (
--append_table=true) או להחלפה (--replace=true) של הטבלה.bq query \ --batch \ --location=LOCATION \ --destination_table=TABLE \ --use_legacy_sql=false \ 'QUERY'
מחליפים את מה שכתוב בשדות הבאים:
LOCATION: האזור או מספר האזורים של טבלת היעד, לדוגמה
USבדוגמה הזו, מערך הנתונים
usa_namesמאוחסן במיקום של מספר אזורים בארה"ב. אם מציינים טבלת יעד לשאילתה הזו, מערך הנתונים שמכיל את טבלת היעד צריך להיות גם הוא במספר אזורים בארה"ב. אי אפשר לשלוח שאילתה למערך נתונים במיקום אחד ולכתוב את התוצאות בטבלה במיקום אחר.אפשר להגדיר ערך ברירת מחדל למיקום באמצעות הקובץ bigqueryrc..
TABLE: שם לטבלת היעד, למשל
myDataset.myTableאם טבלת היעד היא טבלה חדשה, BigQuery יוצר את הטבלה כשמריצים את השאילתה. אבל צריך לציין מערך נתונים קיים.
אם הטבלה לא נמצאת בפרויקט הנוכחי, מוסיפים את מזהה הפרויקט בפורמטGoogle Cloud , לדוגמה
PROJECT_ID:DATASET.TABLE, ואזmyProject:myDataset.myTable. אם לא מציינים את--destination_table, נוצרת משימת שאילתה שכותבת את הפלט לטבלה זמנית.
API
כדי להריץ שאילתה באמצעות ה-API, מוסיפים משימה חדשה ומאכלסים את מאפיין הגדרת המשימה query. אם רוצים, אפשר לציין את המיקום במאפיין location בקטע jobReference של משאב המשימה.
כשממלאים את מאפייני משימת השאילתה, צריך לכלול את המאפיין configuration.query.priority ולהגדיר את הערך ל-BATCH.
מבצעים סקר כדי לקבל תוצאות באמצעות קריאה ל-getQueryResults.
מבצעים סקר עד ש-jobComplete שווה ל-true. בודקים אם יש שגיאות ואזהרות ברשימה errors.
המשך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Java
כדי להריץ שאילתת אצווה, מגדירים את עדיפות השאילתה לערך QueryJobConfiguration.Priority.BATCH כשיוצרים QueryJobConfiguration.
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Node.js
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
Python
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
הרצת שאילתה מתמשכת
כדי להריץ משימת שאילתה מתמשכת, צריך לקבוע הגדרות נוספות. מידע נוסף זמין במאמר יצירת שאילתות מתמשכות.
שימוש בחלונית Reference
בחלונית Reference בעורך השאילתות מוצג מידע דינמי תלוי-הקשר על טבלאות, תמונות מצב, תצוגות ותצוגות מהותיות. בחלונית אפשר לראות תצוגה מקדימה של פרטי הסכימה של המשאבים האלה, או לפתוח אותם בכרטיסייה חדשה. אפשר גם להשתמש בחלונית Reference כדי ליצור שאילתות חדשות או לערוך שאילתות קיימות על ידי הוספת קטעי קוד של שאילתות או שמות של שדות.
כדי ליצור שאילתה חדשה באמצעות החלונית Reference:
נכנסים לדף BigQuery במסוף Google Cloud .
לוחצים על שאילתת SQL.
לוחצים על quick_reference_all Reference.
לוחצים על טבלה או תצוגה שנוספו לאחרונה או סומנו בכוכב. אפשר גם להשתמש בשורת החיפוש כדי למצוא טבלאות ותצוגות.
לוחצים על View actions ואז על Insert query snippet.
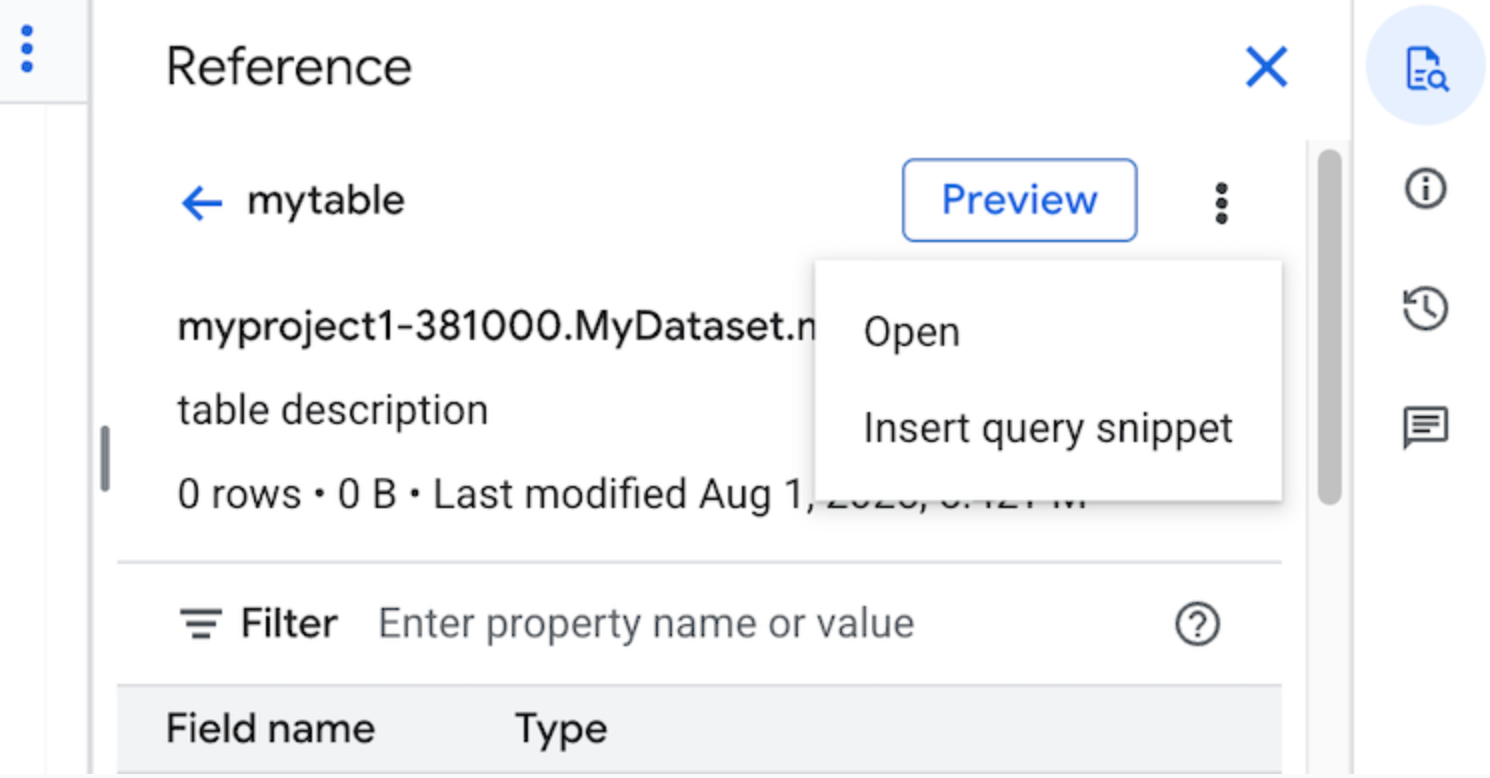
אופציונלי: אפשר לראות תצוגה מקדימה של פרטי הסכימה של הטבלה או התצוגה, או לפתוח אותם בכרטיסייה חדשה.
עכשיו אפשר לערוך את השאילתה באופן ידני או להוסיף שמות של שדות ישירות לשאילתה. כדי להוסיף שם של שדה, לוחצים על המקום בעורך השאילתות שבו רוצים להוסיף את שם השדה, ואז לוחצים על שם השדה בחלונית Reference.
הגדרות השאילתה
כשמריצים שאילתה, אפשר לציין את ההגדרות הבאות:
טבלת יעד לתוצאות השאילתה.
העדיפות של המשימה.
אם להשתמש בתוצאות של שאילתות שנשמרו במטמון.
הזמן הקצוב לתפוגה של המשימה באלפיות השנייה.
אם להשתמש במצב סשן.
סוג ההצפנה שבו רוצים להשתמש.
מספר הבייטים המקסימלי לחיוב בשאילתה.
הניב של SQL שבו משתמשים.
המיקום שבו השאילתה תרוץ. השאילתה צריכה לפעול באותו מיקום שבו נמצאות הטבלאות שאליהן היא מפנה.
ההזמנה שבה תריצו את השאילתה.
מצב יצירה אופציונלית של משימות
מצב יצירה אופציונלית של משימות יכול לשפר את זמן האחזור הכולל של שאילתות שפועלות לזמן קצר, כמו שאילתות מלוחות בקרה או מעומסי עבודה של ניתוח נתונים. במצב הזה, השאילתה מופעלת והתוצאות מוחזרות בתוך השורה של הצהרות SELECT, בלי שצריך להשתמש ב-jobs.getQueryResults כדי לאחזר את התוצאות. שאילתות שמשתמשות במצב יצירה אופציונלית של משימות לא יוצרות משימה כשהן מופעלות, אלא אם BigQuery קובע שיצירת משימה נדרשת כדי להשלים את השאילתה.
כדי להפעיל את מצב יצירה אופציונלית של משימות, מגדירים את השדה jobCreationMode של המכונה QueryRequest לערך JOB_CREATION_OPTIONAL בגוף הבקשה jobs.query.
כשהערך של השדה הזה מוגדר כ-JOB_CREATION_OPTIONAL, המערכת של BigQuery קובעת אם השאילתה יכולה להשתמש במצב יצירה אופציונלית של משימות. אם כן, BigQuery מריץ את השאילתה ומחזיר את כל התוצאות בשדה rows של התגובה. מכיוון שלא נוצרת משימה לשאילתה הזו, BigQuery לא מחזיר jobReference בגוף התגובה. במקום זאת, היא מחזירה את השדה queryId, שבו אפשר להשתמש כדי לקבל תובנות לגבי השאילתה באמצעות התצוגה INFORMATION_SCHEMA.JOBS. מכיוון שלא נוצרת משימה, אין jobReference שאפשר להעביר לממשקי ה-API jobs.get ו-jobs.getQueryResults כדי לחפש את השאילתות האלה.
אם המערכת של BigQuery קובעת שנדרשת משימה כדי להשלים את השאילתה, מוחזר הערך jobReference. כדי לברר למה נוצרה משימה בשביל השאילתה, אפשר לבדוק את השדה job_creation_reason בתצוגה INFORMATION_SCHEMA.JOBS. במקרה כזה, צריך להשתמש ב-jobs.getQueryResults כדי לאחזר את התוצאות כשהשאילתה מסתיימת.
כשמשתמשים בערך JOB_CREATION_OPTIONAL, יכול להיות שהשדה jobReference לא יופיע בתגובה. לפני שניגשים לשדה, צריך לבדוק אם הוא קיים.
כשמציינים את JOB_CREATION_OPTIONAL לשאילתות עם כמה הצהרות (סקריפטים), יכול להיות ש-BigQuery ישפר את תהליך ההפעלה. כחלק מהאופטימיזציה הזו, יכול להיות ש-BigQuery יקבע שהוא יכול להשלים את הסקריפט על ידי יצירת פחות משאבי משימות ממספר ההצהרות הנפרדות, ואולי אפילו להריץ את כל הסקריפט בלי ליצור משימה בכלל.
האופטימיזציה הזו תלויה בהערכת הסקריפט של BigQuery, ויכול להיות שהיא לא תתבצע בכל מקרה. המערכת מבצעת את האופטימיזציה באופן אוטומטי לחלוטין. לא נדרשות פעולות או אמצעי בקרה מצד המשתמשים.
כדי להריץ שאילתה באמצעות מצב יצירה אופציונלית של משימות, בוחרים באחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery.
לוחצים על שאילתת SQL.
בעורך השאילתות, מזינים שאילתת GoogleSQL תקינה.
לדוגמה, אפשר להריץ שאילתה במערך הנתונים הציבורי של BigQuery
usa_namesכדי לזהות את השמות הנפוצים ביותר בארצות הברית בין השנים 1910 ל-2013:SELECT name, gender, SUM(number) AS total FROM `bigquery-public-data.usa_names.usa_1910_2013` GROUP BY name, gender ORDER BY total DESC LIMIT 10;לוחצים על Edit > Query mode > Optional job creation. כדי לאשר את הבחירה, לוחצים על אישור.
לוחצים על הפעלה.
BQ
-
מפעילים את Cloud Shell במסוף Google Cloud .
בחלק התחתון של מסוף Google Cloud יתחיל סשן של Cloud Shell ותופיע הודעה של שורת הפקודה. Cloud Shell היא סביבת מעטפת שבה ה-CLI של Google Cloud מותקן ומוגדרים ערכים לפרויקט הקיים. הסשן יופעל תוך כמה שניות.
משתמשים בפקודה
bq queryומציינים את הדגל--job_creation_mode=JOB_CREATION_OPTIONAL. בדוגמה הבאה, הדגל--use_legacy_sql=falseמאפשר להשתמש בתחביר של GoogleSQL.bq query \ --rpc=true \ --use_legacy_sql=false \ --job_creation_mode=JOB_CREATION_OPTIONAL \ --location=LOCATION \ 'QUERY'
מחליפים את QUERY בשאילתת GoogleSQL תקינה, ואת LOCATION באזור תקין שבו נמצאת קבוצת הנתונים. לדוגמה, אפשר להריץ שאילתה במערך הנתונים הציבורי של BigQuery
usa_namesכדי לגלות מהם השמות הנפוצים ביותר בארצות הברית בין השנים 1910 ל-2013:bq query \ --rpc=true \ --use_legacy_sql=false \ --job_creation_mode=JOB_CREATION_OPTIONAL \ --location=us \ 'SELECT name, gender, SUM(number) AS total FROM `bigquery-public-data.usa_names.usa_1910_2013` GROUP BY name, gender ORDER BY total DESC LIMIT 10;'משימת השאילתה מחזירה את הפלט בתוך השורה בתגובה.
API
כדי להריץ שאילתה במצב יצירה אופציונלית של משימות באמצעות ה-API, מריצים שאילתה באופן סינכרוני ומאכלסים את המאפיין QueryRequest. כוללים את המאפיין jobCreationMode ומגדירים את הערך שלו ל-JOB_CREATION_OPTIONAL.
בודקים את התשובה. אם jobComplete שווה ל-true והשדה jobReference ריק, קוראים את התוצאות מהשדה rows. אפשר גם לקבל את ה-queryId מהתשובה.
אם השדה jobReference קיים, אפשר לבדוק בשדה jobCreationReason למה המשימה נוצרה על ידי BigQuery. מבצעים סקר כדי לקבל תוצאות באמצעות קריאה ל-getQueryResults.
מבצעים סקר עד ש-jobComplete שווה ל-true. בודקים אם יש שגיאות ואזהרות ברשימה errors.
Java
גרסה זמינה: 2.51.0 ואילך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Java API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
כדי להריץ שאילתה עם שרת proxy, קראו את המאמר הגדרת שרת proxy.
Python
גרסה זמינה: 3.34.0 ואילך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Python במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Python API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
צומת
גרסה זמינה: 8.1.0 ואילך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Node.js API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
המשך
גרסה זמינה: 1.69.0 ואילך
לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של BigQuery באמצעות ספריות לקוח. למידע נוסף, קראו את מאמרי העזרה של BigQuery Go API.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לספריות לקוח.
מנהל התקן JDBC
גרסה זמינה: JDBC גרסה 1.6.1 ואילך
צריך להגדיר את JobCreationMode=2 במחרוזת החיבור.
jdbc:bigquery://https://www.googleapis.com/bigquery/v2:443;JobCreationMode=2;Location=US;
מנהל התקן ODBC
גרסה זמינה: ODBC v3.0.7.1016 ואילך
צריך להגדיר את JobCreationMode=2 בקובץ .ini.
    [ODBC Data Sources]
    Sample DSN=Simba Google BigQuery ODBC Connector 64-bit
    [Sample DSN]
    JobCreationMode=2
שאילתות עם אחזור נתונים גלובלי
השאילתות מופעלות במיקום של הנתונים שאליהם הן מפנות. עם זאת, אם שאילתה מפנה לנתונים שמאוחסנים ביותר ממיקום אחד, מתבצעת שאילתה עם אחזור נתונים גלובלי. כשמריצים שאילתה עם אחזור נתונים גלובלי, BigQuery יכול לאסוף את כל הנתונים הנדרשים ממיקומים שונים במקום אחד, להריץ שאילתה ולהחזיר את התוצאות. שאילתות עם אחזור נתונים גלובלי דורשות העברת נתונים בין מיקומים, ולכן נדרשות הרשאות נוספות ויכולות להיות עלויות נוספות.
מידע נוסף על שאילתות עם אחזור נתונים גלובלי זמין במאמר שאילתות עם אחזור נתונים גלובלי.
מכסות
למידע על מכסות שקשורות לשאילתות אינטראקטיביות ולשאילתות אצווה, ראו משימות של שאילתות.
כדי לפתור שגיאות שקשורות למכסות של שאילתות, אפשר לעיין בדף פתרון הבעיות של BigQuery. השגיאות הבאות במכסות והמידע לפתרון הבעיות קשורים ישירות לשאילתות:
מעקב אחרי שאילתות
אתם יכולים לקבל מידע על שאילתות בזמן שהן פועלות באמצעות סייר המשימות או באמצעות שליחת שאילתה לתצוגה INFORMATION_SCHEMA.JOBS_BY_PROJECT.
סביבת זמן ריצה מתקדמת
סביבת זמן ריצה מתקדמת ב-BigQuery היא קבוצה של שיפורים בביצועים שנועדו להאיץ באופן אוטומטי את עומסי העבודה של הניתוח, בלי שהמשתמש יצטרך לבצע פעולה או לשנות את הקוד. השאילתות מנצלות באופן אוטומטי את האופטימיזציות של סביבת זמן ריצה מתקדמת כשאופטימיזציות של וקטוריזציה משופרת או של שאילתות קצרות זמינות.
וקטוריזציה משופרת
ביצוע וקטורי הוא מודל לעיבוד שאילתות שפועל על עמודות של נתונים בבלוקים שתואמים לגודל המטמון של המעבד (CPU), ומשתמש בהוראות SIMD (הוראה אחת, נתונים מרובים). הווקטוריזציה המשופרת מרחיבה את הרצת השאילתות הווקטוריות ב-BigQuery להיבטים הבאים של עיבוד השאילתות:
- באמצעות קידוד נתונים מיוחד בפורמט האחסון של Capacitor, אפשר לבצע פעולות של הערכת מסננים על הנתונים המקודדים.
- קידודים מיוחדים מופצים דרך התוכנית לביצוע שאילתה, וכך אפשר לעבד יותר נתונים כשהם עדיין מקודדים.
- באמצעות קיפול ביטויים להערכת פונקציות דטרמיניסטיות וביטויים קבועים, BigQuery יכול לפשט פרדיקטים מורכבים לערכים קבועים.
אופטימיזציה של שאילתות קצרות
בדרך כלל, BigQuery מריץ שאילתות בסביבה מבוזרת באמצעות שכבת ביניים של ערבוב. אופטימיזציות של שאילתות קצרות מזהות באופן דינמי שאילתות שאפשר להריץ כשלב יחיד, וכך מקצרות את זמן האחזור ומפחיתות את צריכת ה-slots. אפשר להשתמש בקידודים מיוחדים בצורה יעילה יותר כשמריצים שאילתה בשלב אחד. האופטימיזציות האלה הכי יעילות כשמשתמשים במצב יצירה אופציונלית של משימות, שמצמצם את זמן האחזור של הפעלת המשימה, התחזוקה שלה ואחזור התוצאות.
הזכאות לאופטימיזציה של שאילתות קצרות היא דינמית ומושפעת מהגורמים הבאים:
- הגודל הצפוי של סריקת הנתונים.
- כמות הנתונים שצריך להעביר.
- הסלקטיביות של מסנני השאילתות.
- הסוג והפריסה הפיזית של הנתונים באחסון.
- המבנה הכללי של השאילתה.
- הנתונים הסטטיסטיים ההיסטוריים של הרצות שאילתות קודמות.
הערכת ההשפעה של סביבת זמן הריצה המתקדמת
כדי להעריך את ההשפעה של סביבת זמן הריצה המתקדמת, אתם יכולים להשתמש בשאילתת ה-SQL הבאה כדי לזהות שאילתות בפרויקט עם השיפור המשוער הגדול ביותר בזמן הביצוע:
WITH
  jobs AS (
    SELECT
      *,
      query_info.query_hashes.normalized_literals AS query_hash,
      TIMESTAMP_DIFF(end_time, start_time, MILLISECOND) AS elapsed_ms,
      EXISTS(
        SELECT 1
        FROM UNNEST(JSON_QUERY_ARRAY(query_info.optimization_details.optimizations)) AS o
        WHERE JSON_VALUE(o, '$.enhanced_vectorization') = 'applied'
      ) AS has_advanced_runtime
    FROM region-LOCATION.INFORMATION_SCHEMA.JOBS_BY_PROJECT
    WHERE EXTRACT(DATE FROM creation_time) > DATE_SUB(CURRENT_DATE(), INTERVAL 30 DAY)
  ),
  most_recent_jobs_without_advanced_runtime AS (
    SELECT *
    FROM jobs
    WHERE NOT has_advanced_runtime
    QUALIFY ROW_NUMBER() OVER (PARTITION BY query_hash ORDER BY end_time DESC) = 1
  )
SELECT
  job.job_id,
  100 * SAFE_DIVIDE(
    original_job.elapsed_ms - job.elapsed_ms,
    original_job.elapsed_ms) AS percent_execution_time_saved,
  job.elapsed_ms AS new_elapsed_ms,
  original_job.elapsed_ms AS original_elapsed_ms,
FROM jobs AS job
INNER JOIN most_recent_jobs_without_advanced_runtime AS original_job
  USING (query_hash)
WHERE
  job.has_advanced_runtime
  AND original_job.end_time < job.start_time
ORDER BY percent_execution_time_saved DESC
LIMIT 10;
מחליפים את מה שכתוב בשדות הבאים:
-
LOCATION: המיקום שבו צריך למדוד את ביצועי המשימה
אם סביבת זמן הריצה המתקדמת הופעלה, התוצאות של השאילתה הזו עשויות להיות דומות לתוצאות הבאות:
/*--------------+----------------------------+----------------+---------------------*
 |    job_id    | percent_elapsed_time_saved | new_elapsed_ms | original_elapsed_ms |
 +--------------+----------------------------+----------------+---------------------+
 | sample_job1  |         45.38834951456311  |            225 |                 412 |
 | sample_job2  |         45.19480519480519  |            211 |                 385 |
 | sample_job3  |         33.246753246753244 |            257 |                 385 |
 | sample_job4  |         29.28802588996764  |           1311 |                1854 |
 | sample_job5  |         28.18181818181818  |           1027 |                1430 |
 | sample_job6  |         25.804195804195807 |           1061 |                1430 |
 | sample_job7  |         25.734265734265733 |           1062 |                1430 |
 | sample_job8  |         25.454545454545453 |           1066 |                1430 |
 | sample_job9  |         25.384615384615383 |           1067 |                1430 |
 | sample_job10 |         25.034965034965033 |           1072 |                1430 |
 *--------------+----------------------------+----------------+---------------------*/
התוצאות של השאילתה הזו הן רק אומדן של ההשפעה של סביבת זמן הריצה המתקדמת. יש הרבה גורמים שיכולים להשפיע על ביצועי השאילתה, כולל, בין היתר, זמינות המשבצות, שינוי בנתונים לאורך זמן, הגדרות של תצוגה או פונקציה מוגדרת-משתמש (UDF) והבדלים בערכי הפרמטרים של השאילתה.
אם תוצאות השאילתה ריקות, יכול להיות שאף משימה לא השתמשה בסביבת זמן ריצה מתקדמת, או שכל המשימות עברו אופטימיזציה לפני יותר מ-30 יום.
אפשר להחיל את השאילתה הזו על מדדים אחרים של ביצועי שאילתות, כמו total_slot_ms ו-total_bytes_billed. מידע נוסף זמין בסכימה של INFORMATION_SCHEMA.JOBS_BY_PROJECT.
המאמרים הבאים
- איך מנהלים משימות של שאילתות
- איך לצפות בהיסטוריית השאילתות
- איך שומרים ומשתפים שאילתות
- מידע על תורי שאילתות
- איך כותבים תוצאות של שאילתות