


מבוא לשאילתות מתמשכות
במסמך הזה מתוארות שאילתות רציפות ב-BigQuery.
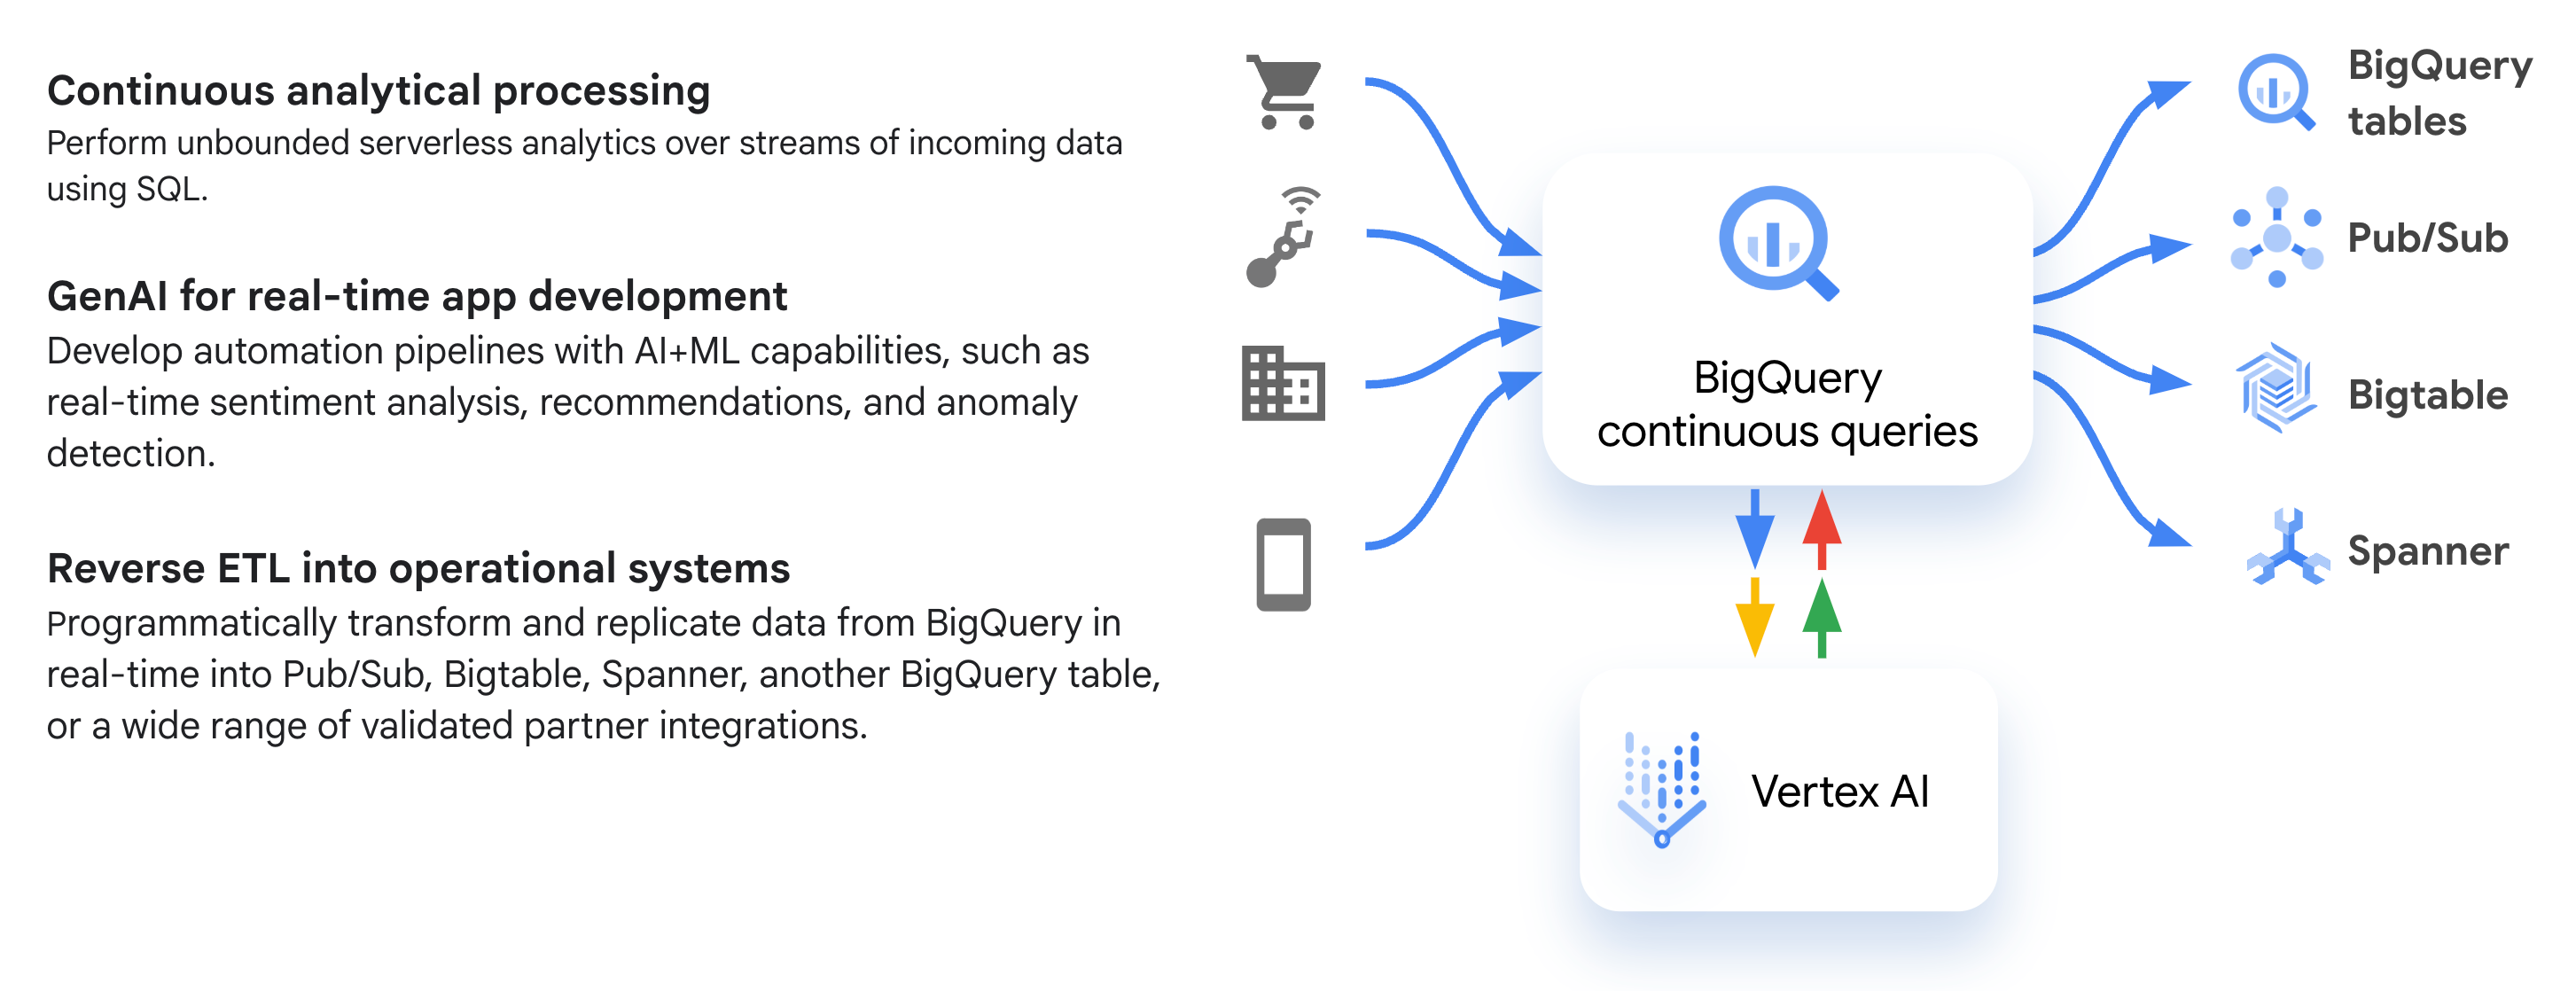
שאילתות מתמשכות ב-BigQuery הן הצהרות SQL שמופעלות באופן מתמשך. שאילתות רציפות מאפשרות לכם לנתח נתונים נכנסים ב-BigQuery בזמן אמת. אתם יכולים לכתוב או לייצא את שורות הפלט שנוצרו על ידי שאילתה מתמשכת ליעדים הבאים:
- טבלאות ב-BigQuery
- טבלאות מנוהלות של Apache Iceberg
- נושאים ב-Pub/Sub
- טבלאות Bigtable
- טבלאות Spanner
שאילתות רציפות יכולות לעבד נתונים שנכתבו בטבלאות BigQuery רגילות באחת מהשיטות הבאות:
- BigQuery Storage Write API (gRPC)
- BigQuery Storage Write API (REST)
- טעינה באצווה
- פקודת ה-DML
INSERT - שינוי של הצהרות בשפת טיפול בנתונים (DML) כמו
DELETE,UPDATEו-MERGEכשמייצאים נתונים ל-Pub/Sub. - כתיבה מתוצאות של שאילתת אצווה לטבלה קבועה
- כתיבה מתוצאות של שאילתה מתמשכת ב-BigQuery לטבלה קבועה
- הרשמה ל-Pub/Sub BigQuery
- פעולות כתיבה מ-Dataflow ל-BigQuery
- פעולות כתיבה מ-Datastream ל-BigQuery באמצעות מצב כתיבה של הוספה בלבד
אפשר להשתמש בשאילתות רציפות כדי לבצע משימות שרגישות לזמן, כמו יצירת תובנות ופעולה מיידית על סמך התובנות, החלת מסקנות של למידת מכונה (ML) בזמן אמת ושכפול נתונים בפלטפורמות אחרות. כך תוכלו להשתמש ב-BigQuery כמנוע לעיבוד נתונים מבוסס-אירועים ללוגיקת ההחלטות של האפליקציה.
התרשים הבא מציג תהליכי עבודה נפוצים של שאילתות מתמשכות:
תרחישים לדוגמה
אלה כמה תרחישי שימוש נפוצים שבהם כדאי להשתמש בשאילתות רציפות:
- שירותים מותאמים אישית לאינטראקציה עם לקוחות: שימוש ב-AI גנרטיבי ליצירת הודעות מותאמות אישית לכל אינטראקציה עם לקוח.
- זיהוי אנומליות: אפשר לבנות פתרונות שיאפשרו לכם לזהות אנומליות ואיומים בנתונים מורכבים בזמן אמת, כדי שתוכלו להגיב לבעיות מהר יותר.
- פייפליינים מותאמים אישית מבוססי-אירועים: אפשר להשתמש בשילוב של שאילתות מתמשכות עם Pub/Sub כדי להפעיל אפליקציות במורד הזרם על סמך נתונים נכנסים.
- העשרת נתונים וחילוץ ישויות: אפשר להשתמש בשאילתות רציפות כדי לבצע העשרה וטרנספורמציה של נתונים בזמן אמת באמצעות פונקציות SQL ומודלים של ML.
- העברת נתונים הפוכה של ETL: ביצוע העברת נתונים הפוכה של ETL בזמן אמת למערכות אחסון אחרות שמתאימות יותר להצגת אפליקציות עם זמן אחזור נמוך. לדוגמה, ניתוח או שיפור של נתוני אירועים שנכתבים ב-BigQuery, ואז העברתם בסטרימינג ל-Bigtable, ל-Spanner או לטבלאות מנוהלות של Apache Iceberg להצגה באפליקציה.
- הפעלת סוכן אוטונומי: הפעלת צינורות נתונים מבוססי-סוכן בזמן אמת על סמך אירועים מורכבים שזוהו בפידים של נתונים בזמן אמת. לדוגמה, אפשר לעיין ב-Codelab בנושא יצירת סוכן נתונים מבוסס-אירועים באמצעות BigQuery ו-Agent Development Kit (ADK).
- מעקב אחרי סוכנים אוטונומיים: פיתוח מעקב אוטומטי בזמן אמת והתראות לגבי אינטראקציות של סוכנים בזמן אמת באמצעות התוסף BigQuery agent analytics, שמעביר בסטרימינג את כל נתוני המעקב של הסוכנים, השימוש בכלים ויומני הפעילות ישירות ל-BigQuery כדי לספק תובנות מעמיקות לגבי כוח העבודה של ה-AI.
פונקציונליות נתמכת
הפעולות הבאות נתמכות בשאילתות רציפות:
- הפעלת הצהרות
INSERTכדי לכתוב נתונים משאילתה מתמשכת לטבלה ב-BigQuery או לטבלה מנוהלת ב-Iceberg. הפעלת הצהרות
EXPORT DATAכדי לפרסם פלט של שאילתות מתמשכות בנושאי Pub/Sub.צריך להריץ שאילתות רציפות שמייצאות נתונים ל-Pub/Sub באמצעות חשבון שירות. מידע נוסף על ייצוא נתונים ל-Pub/Sub
מנושא Pub/Sub אפשר להשתמש בנתונים עם שירותים אחרים, למשל לבצע ניתוח נתונים בזמן אמת באמצעות Dataflow, או להשתמש בנתונים בתהליך עבודה של שילוב אפליקציות.
הפעלת הצהרות
EXPORT DATAכדי לייצא נתונים מ-BigQuery לטבלאות Bigtable. מידע נוסף זמין במאמר בנושא ייצוא נתונים ל-Bigtable.הפעלת הצהרות
EXPORT DATAכדי לייצא נתונים מ-BigQuery לטבלאות Spanner. מידע נוסף זמין במאמר בנושא ייצוא נתונים ל-Spanner (תהליך ETL הפוך).הפעלת הפונקציות הבאות של AI גנרטיבי:
AI.GENERATE-
- כדי להשתמש בפונקציה הזו, צריך מודל מרוחק של BigQuery ML על מודל של Gemini Enterprise Agent Platform.
קריאה לפונקציות ה-AI הבאות:
כדי להשתמש בפונקציות האלה, צריך מודל מרוחק של BigQuery ML דרך Cloud AI API.
נרמול של נתונים מספריים באמצעות הפונקציה
ML.NORMALIZER.ניתוח ועיבוד של נתוני
JSON, כולל תמיכה בפונקציות JSON ובביטול קינון של JSON.שימוש בפונקציות GoogleSQL חסרות מצב – לדוגמה, פונקציות המרה. בפונקציות חסרות מצב, כל שורה מעובדת בנפרד משאר השורות בטבלה.
שימוש בפעולות עם שמירת מצב – למשל
JOINs, צבירות וצבירות של חלונות. בפעולות עם שמירת מצב, המצב של הנתונים שנקלטים נשמר בכמה שורות או מרווחי זמן כדי לחשב תוצאה מדויקת.שימוש בפונקציה של היסטוריית השינויים
APPENDSכדי לעבד נתונים שנוספו מנקודת זמן ספציפית.שימוש בפונקציה של היסטוריית השינויים
CHANGESכדי לעבד נתונים שהשתנו, כולל נתונים שנוספו ושינויים, מנקודת זמן ספציפית כשמייצאים נתונים ל-Pub/Sub. עם זאת, אי אפשר להשתמש ב-CHANGESכשמבצעים פעולה עם שמירת מצב.הפעלת שאילתות על תצוגות, כל עוד שאילתת ה-SQL הבסיסית של התצוגה היא שאילתה מתמשכת תקינה.
פעולות נתמכות עם שמירת מצב
כדי לבקש תמיכה או לשלוח משוב על התכונה הזו, אפשר לשלוח אימייל לכתובת bq-continuous-queries-feedback@google.com.
פעולות עם שמירת מצב מאפשרות לביצוע שאילתות רציפות של ניתוח מורכב שדורש שמירת מידע בכמה שורות או מרווחי זמן. פונקציות בלי שמירת מצב מעבדות כל שורה בנפרד, אבל פעולות עם שמירת מצב שומרות את המצב של הנתונים שהוטמעו כדי לתמוך בפונקציות כמו JOINs, צבירות וצבירות של חלונות. היכולת הזו מאפשרת לכם ליצור קורלציה בין אירועים ממקורות שונים או לחשב מדדים לאורך זמן – כמו ממוצע של 30 דקות – על ידי אחסון הנתונים הנדרשים בזיכרון בזמן שהשאילתה פועלת.
שאילתות מתמשכות תומכות בפעולות הבאות עם שמירת מצב:
הרשאה
Google Cloud טוקני הגישה שמשמשים להרצת משימות של שאילתות מתמשכות, כוללים אורך חיים (TTL) של יומיים כשהם נוצרים על ידי חשבון משתמש. לכן, עבודות כאלה מפסיקות לפעול אחרי יומיים. אסימוני הגישה שנוצרים על ידי חשבונות שירות יכולים לפעול למשך זמן ארוך יותר, אבל הם עדיין צריכים לעמוד בדרישות של זמן הריצה המקסימלי של השאילתה. מידע נוסף זמין במאמר בנושא הפעלת שאילתה מתמשכת באמצעות חשבון שירות.
מיקומים
רשימת האזורים הנתמכים מופיעה במאמר מיקומים של שאילתות מתמשכות ב-BigQuery.
מגבלות
השאילתות המתמשכות כפופות למגבלות הבאות:
- המצב של הנתונים שהוזנו נשמר רק עבור פעולות ספציפיות עם שמירת מצב בתצוגה מקדימה.
למרות ששאילתות רציפות תומכות עכשיו בחלק מסוגי
JOIN, צבירות וצבירות של חלונות, הן מוגבלות לפעולות ספציפיות עם שמירת מצב. לא כל סוגי הפעולות עם שמירת מצב נתמכים. אי אפשר להשתמש ביכולות ה-SQL הבאות בשאילתה מתמשכת, אלא אם הן מופיעות כפעולה נתמכת עם שמירת מצב:
האופרטורים הבאים של שאילתות:
אופרטורים של קבוצות בשאילתה, למעט
UNION ALL.פונקציות BigQuery ML שלא מופיעות בפונקציונליות נתמכת
הצהרות של שפת טיפול בנתונים (DML) חוץ מ-
INSERT.
EXPORT DATAהצהרות שלא מכוונות ל-Bigtable, ל-Pub/Sub או ל-Spanner.
שאילתות רציפות לא תומכות במקורות הנתונים הבאים:
- טבלאות חיצוניות.
- תצוגות של סכימת מידע.
- טבלאות מנוהלות של Apache Iceberg. חשוב לדעת: אין תמיכה בטבלאות מנוהלות של Iceberg כמקורות נתונים, אבל יש תמיכה בהן כיעדים לפלט של שאילתות רציפות.
- טבלאות עם תווים כלליים לחיפוש.
- עדכון נתונים (upsert) באמצעות סימון נתונים שהשתנו (CDC)
- תצוגות מהותיות.
- תצוגות שבהן שאילתת ה-SQL הבסיסית משתמשת בתכונות שלא נתמכות, כמו פונקציות בהגדרת המשתמש, טבלאות חיצוניות או טבלאות עם CDC.
שאילתות רציפות לא תומכות בתכונות האבטחה column- וברמת השורה.
הפלט של שאילתה מתמשכת כפוף למכסות ולמגבלות המובנות של שירות היעד שאליו מיוצא הפלט.
כשמייצאים נתונים ל-Bigtable, ל-Spanner או לנקודות קצה אזוריות של Pub/Sub, אפשר לטרגט רק משאבים של Bigtable, Spanner או Pub/Sub שנמצאים באותו Google Cloudגבול אזורי כמו מערך הנתונים ב-BigQuery שמכיל את הטבלה שמתבצעת עליה שאילתה. ההגבלה הזו לא חלה כשמייצאים נתונים לנקודות קצה גלובליות של Pub/Sub. מידע נוסף על ייצוא אל פרופיל אפליקציה של Bigtable ומדיניות ניתוב זמין במאמר שיקולים לגבי מיקום.
אי אפשר להריץ שאילתה מתמשכת מקנבס נתונים.
אי אפשר לשנות את ה-SQL שמשמש בשאילתה מתמשכת בזמן שהעבודה של השאילתה המתמשכת פועלת. מידע נוסף מופיע במאמר בנושא שינוי ה-SQL של שאילתה מתמשכת.
אם משימת שאילתה מתמשכת לא מצליחה לעבד את הנתונים הנכנסים בזמן ויש לה פיגור של חותמת הזמן של הפלט של יותר מ-48 שעות, היא נכשלת. אפשר להריץ את השאילתה שוב ולהשתמש בפונקציה של היסטוריית השינויים
APPENDSאוCHANGESכדי להמשיך את העיבוד מהנקודה בזמן שבה הפסקתם את משימת השאילתה המתמשכת הקודמת. מידע נוסף זמין במאמר בנושא הפעלת שאילתה מתמשכת מנקודת זמן מסוימת.שאילתה מתמשכת שהוגדרה באמצעות חשבון משתמש יכולה לפעול עד יומיים. שאילתה מתמשכת שהוגדרה עם חשבון שירות יכולה לפעול למשך עד 150 ימים. כשמגיעים לזמן הריצה המקסימלי של השאילתה, השאילתה נכשלת והעיבוד של הנתונים הנכנסים מופסק.
למרות ששאילתות רציפות מבוססות על תכונות האמינות של BigQuery, יכולות להתרחש בעיות זמניות מדי פעם. בעיות עלולות להוביל לעיבוד מחדש אוטומטי של חלק מהשאילתה המתמשכת, מה שעלול לגרום לשכפול נתונים בפלט של השאילתה המתמשכת. חשוב לתכנן את המערכות במורד הזרם כך שיוכלו להתמודד עם תרחישים כאלה.
מגבלות על הזמנות
- כדי להריץ שאילתות רציפות, צריך ליצור הזמנה של מהדורת Enterprise או מהדורת Enterprise Plus עם סוג הקצאה
CONTINUOUS. שאילתות מתמשכות לא תומכות במודל החיוב על פי דרישה של Compute. - כשיוצרים
CONTINUOUSהקצאת הזמנה, ההזמנה המשויכת מוגבלת ל-500 משבצות לכל היותר. כדי לבקש להגדיל את המגבלה הזו, אפשר לפנות אלינו בכתובת bq-continuous-queries-feedback@google.com. - אי אפשר ליצור הקצאת הזמנה שמשתמשת בסוג עבודה שונה באותה הזמנה כמו הקצאת הזמנה של שאילתה מתמשכת.
מערכת BigQuery קובעת את מספר השאילתות הרציפות שאפשר להריץ בו-זמנית לכל פרויקט על סמך הגודל המוגדר של הקצאת השמורה שמשתמשת ב
CONTINUOUSסוג העבודה. כדי לאפשר הרצה של משימות חדשות, BigQuery דורש סף של 10 יחידות קיבולת לכל משימת שאילתה רציפה. השאילתה לא בהכרח צורכת את כל 10 המשבצות במהלך הביצוע הרגיל. הסף הזה מבטיח שלכל שאילתה רציפה שפועלת תהיה קיבולת בסיסית מספקת של מחשוב כדי לטפל בעליות פתאומיות בנפח הנתונים הנכנסים, בלי שהעיבוד יתעכב או שהשיהוי יהיה גבוה.כדי לוודא שהשאילתות יתקבלו בהצלחה בלי להגיע למגבלות של מספר הפעולות בו-זמנית, מומלץ להשתמש בשינוי אוטומטי של מספר המשבצות. התאמה אוטומטית לעומס מאפשרת לשנות את השימוש הכולל במשבצות באופן דינמי על סמך הביקוש בפועל למשאבים. אתם יכולים להגדיר הקצאה קטנה יותר של משאבים כבסיס, ולהגדיר מגבלה מקסימלית של שינוי גודל אוטומטי שתכסה בנוחות את סף 10 המשבצות לכל שאילתה עבור השאילתות המקבילות הצפויות.
כשמריצים כמה שאילתות רציפות באמצעות אותה הזמנה, יכול להיות שהמשימות לא יחלקו את המשאבים הזמינים באופן הוגן, כפי שמוגדר בהוגנות ב-BigQuery.
התאמה אוטומטית לעומס של מכונות מזל
בשאילתות רציפות אפשר להשתמש בשינוי גודל אוטומטי של משבצות כדי לשנות באופן דינמי את הקיבולת שהוקצתה בהתאם לעומס העבודה. ככל שעומס העבודה של השאילתות הרציפות גדל או קטן, BigQuery מתאים את יחידות הקיבולת באופן דינמי.
אחרי שמתחילה הרצה של שאילתה רציפה, היא מאזינה באופן פעיל לנתונים נכנסים, וזה צורך משאבי משבצות. מקום שמור עם שאילתה מתמשכת פעילה לא מצטמצם אנכית לאפס יחידות קיבולת (Slots), אבל שאילתה מתמשכת בלי פעילות שמיועדת בעיקר להאזנה לנתונים נכנסים צפויה לצרוך כמות מינימלית של יחידות קיבולת (Slots), בדרך כלל יחידת קיבולת (Slot) אחת.
שיתוף משבצות זמן פנויות
שאילתות מתמשכות יכולות להשתמש בשיתוף יחידות קיבולת פנויות כדי לשתף משאבי יחידות קיבולת לא בשימוש עם מקומות שמורים אחרים וסוגי עבודות.
- עדיין נדרש
CONTINUOUSהקצאת מקום שמור כדי להריץ שאילתה מתמשכת, ואי אפשר להסתמך רק על יחידות קיבולת (Slot) פנויות ממקומות שמורים אחרים. לכן, הקצאת הזמנה שלCONTINUOUSמחייבת הגדרה של בסיס משבצות שאינו אפס או הגדרה של שינוי גודל אוטומטי של משבצות שאינו אפס. - אפשר לשתף רק משבצות זמן פנויות או משבצות זמן שהוקצו מתוך הקצאת הזמנה של
CONTINUOUS. אי אפשר לשתף יחידות קיבולת שגודלן משתנה אוטומטית כיחידות קיבולת פנויות למקומות שמורים אחרים.
תמחור
שאילתות רציפות יכולות להשתמש בהתאמה גמישה לעומס ב-BigQuery.
שאילתות רציפות משתמשות בתמחור של קיבולת מחשוב ב-BigQuery, שנמדדת ביחידות קיבולת (Slot).
כדי להריץ שאילתות מתמשכות, צריך מקום שמור שמשתמש במהדורת Enterprise או Enterprise Plus והקצאת מקום שמור שמשתמשת בסוג העבודה CONTINUOUS.
השימוש במשאבים אחרים של BigQuery, כמו הטמעה ואחסון של נתונים, מחויב לפי התעריפים שמופיעים בתמחור של BigQuery.
השימוש בשירותים אחרים שמקבלים תוצאות של שאילתות מתמשכות או שמופעלים במהלך העיבוד של שאילתות מתמשכות מחויב בתעריפים שפורסמו עבור השירותים האלה. למידע על התמחור של שירותים אחרים של Google Cloud שאילתות רציפות, אפשר לעיין בנושאים הבאים:
הערכה של דרישות הקיבולת של יחידות הקיבולת (Slot)
מכיוון שכל עומס עבודה הוא שונה, לרוב אי אפשר להעריך מראש את מספר המשבצות המדויק עבור שאילתות רציפות. מספר המשבצות שנדרשות לשאילתות הרציפות תלוי בשילוב של כמה גורמים:
- מספר השאילתות המתמשכות שפועלות בו-זמנית.
- מורכבות הצהרת ה-SQL.
- השימוש בפונקציות עיבוד עם שמירת מצב, כולל משכי זמן של חלונות,
JOINs, וצבירות. - הקצב או המהירות של הנתונים הנכנסים.
- המבנה והגודל של הנתונים שמועברים.
מבחינה קונספטואלית, אפשר להעריך את מספר יחידות הקיבולת (Slot) הכולל שנדרש כפונקציה של עומס העבודה של השאילתות המתמשכות:
Estimated Slots ≈ Number of continuous queries x ∑ (Data rate x Query complexity)
מכיוון שצריכת הסלוטים בפועל תלויה מאוד בעומס העבודה ובדפוסי הנתונים הייחודיים שלכם, הדרך הכי מדויקת להערכת העלות היא מעקב אחרי עבודה שמתבצעת. אפשר למדוד את השימוש המקסימלי ביחידת קיבולת (Slot) בהרצה מבודדת של שאילתה מתמשכת באמצעות תצוגות INFORMATION_SCHEMA. הוראות מפורטות ושאילתות לדוגמה למעקב אחר השימוש במשבצות לאורך זמן מופיעות במאמר בנושא הצגת מידע על צריכת משבצות.
המאמרים הבאים
אפשר לנסות ליצור שאילתה מתמשכת.