


從 Cloud Storage 載入 Avro 資料
BigQuery 可讓您將 Cloud Storage 中的 Avro 資料載入新的資料表或分區,或附加至現有資料表或分區,或覆寫現有資料表或分區。將資料載入 BigQuery 時,BigQuery 會自動擷取結構定義,並將載入的資料轉換為 Capacitor 的資料欄格式。
如需從本機檔案載入 Avro 資料的相關資訊,請參閱將資料從本機資料來源載入至 BigQuery。
限制
從 Cloud Storage bucket 將資料載入 BigQuery 時,須遵守下列限制:
- BigQuery 不保證外部資料來源的資料一致性。如果基礎資料在查詢執行期間遭到變更,可能會導致非預期的行為。
- BigQuery 不支援 Cloud Storage 物件版本管理。如果您在 Cloud Storage URI 中加入世代編號,載入工作就會失敗。
將 Avro 檔案載入 BigQuery 時,也適用下列限制:
- BigQuery 不支援載入獨立 Avro 結構定義 (.avsc) 檔案。
- BigQuery 不支援巢狀陣列格式。使用這種格式的 Avro 檔案必須先轉換,才能匯入。
- 在 Avro 檔案中,全名的名稱和命名空間只能包含英數字元和底線字元
_。下列規則運算式顯示允許的字元:[A-Za-z_][A-Za-z0-9_]*。
如要瞭解 BigQuery 載入工作限制,請參閱「載入工作」。
輸入檔案規定
將 Avro 檔案載入 BigQuery 時,為避免發生 resourcesExceeded 錯誤,請遵循下列規範:
- 資料列大小不得超過 50 MB。
- 如果資料列包含許多陣列欄位,或任何非常長的陣列欄位,請將陣列值拆分為個別欄位。
事前準備
授予 Identity and Access Management (IAM) 角色,讓使用者具備執行本文件中各項工作所需的權限,並建立資料集和資料表來儲存資料。
所需權限
如要將資料載入 BigQuery,您必須具備 IAM 權限,才能執行載入工作,並將資料載入 BigQuery 資料表和分區。如果您是從 Cloud Storage 載入資料,也需要 IAM 權限,才能存取含有資料的 bucket。
將資料載入 BigQuery 的權限
如要將資料載入新的 BigQuery 資料表或分區,或附加或覆寫現有資料表或分區,您必須具備下列 IAM 權限:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
下列各項預先定義的 IAM 角色,都包含將資料載入 BigQuery 資料表或分區所需的權限:
roles/bigquery.dataEditorroles/bigquery.dataOwnerroles/bigquery.admin(包含bigquery.jobs.create權限)bigquery.user(包含bigquery.jobs.create權限)bigquery.jobUser(包含bigquery.jobs.create權限)
此外,如果您具備 bigquery.datasets.create 權限,則可在建立的資料集中,使用載入工作建立及更新資料表。
如要進一步瞭解 BigQuery 的 IAM 角色和權限,請參閱「預先定義的角色和權限」。
從 Cloud Storage 載入資料的權限
如要取得從 Cloud Storage bucket 載入資料所需的權限,請要求管理員授予您 bucket 的儲存空間管理員 (roles/storage.admin) IAM 角色。如要進一步瞭解如何授予角色,請參閱「管理專案、資料夾和組織的存取權」。
這個預先定義的角色具備從 Cloud Storage bucket 載入資料所需的權限。如要查看確切的必要權限,請展開「Required permissions」(必要權限) 部分:
所需權限
您必須具備下列權限,才能從 Cloud Storage bucket 載入資料:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
建立資料集和資料表
如要儲存資料,您必須建立 BigQuery 資料集,然後在該資料集中建立 BigQuery 資料表。
Avro 的優勢
如要將資料載入 BigQuery,建議您使用 Avro 格式。相較於 CSV 與 JSON (以換行符號分隔),載入 Avro 檔案有以下優勢:
- Avro 二進位格式:
- 載入較快。即便資料區塊經過壓縮,還是能夠平行讀取。
- 無需任何輸入或序列化作業。
- 沒有 ASCII 等其他格式會有的編碼問題,所以剖析較容易。
- 將 Avro 檔案載入 BigQuery 時,會從自述式來源資料自動擷取資料表結構定義。
Avro 結構定義
將 Avro 檔案載入新的 BigQuery 資料表時,系統會使用來源資料自動擷取資料表結構定義。當 BigQuery 從來源資料擷取結構定義時,會按字母順序使用最後一個檔案。
舉例來說,Cloud Storage 中有下列 Avro 檔案:
gs://mybucket/00/
  a.avro
  z.avro
gs://mybucket/01/
  b.avro
在 bq 指令列工具中執行這項指令,會載入所有檔案 (以逗號分隔的清單),並從 mybucket/01/b.avro 衍生結構定義:
bq load \
--source_format=AVRO \
dataset.table \
"gs://mybucket/00/*.avro","gs://mybucket/01/*.avro"
匯入擁有不同 Avro 結構定義的多個 Avro 檔案時,所有結構定義都必須與 Avro 的結構定義解析相容。
BigQuery 偵測到結構定義時,會將部分 Avro 資料類型轉換為 BigQuery 資料類型,使其與 GoogleSQL 語法相容。如需更多資訊,請參閱 Avro 轉換。
如要提供資料表結構定義來建立外部資料表,請將 BigQuery API 中的referenceFileSchemaUri 屬性或 bq 指令列工具中的 --reference_file_schema_uri 參數設為參考檔案的網址。例如 --reference_file_schema_uri="gs://mybucket/schema.avro"。
您也可以指定 JSON 結構定義檔案,將結構定義匯入 BigQuery。
Avro 壓縮
BigQuery 支援下列 Avro 檔案內容壓縮轉碼器:
SnappyDEFLATEZSTD
將 Avro 資料載入至新的資料表
如要將 Cloud Storage 中的 Avro 資料載入新的 BigQuery 資料表,請選取下列其中一個選項:
控制台
在 Google Cloud 控制台開啟「BigQuery」頁面。
點選左側窗格中的 「Explorer」。
如果沒有看到左側窗格,請按一下 「Expand left pane」(展開左側窗格),開啟窗格。
在「Explorer」窗格中展開專案,依序點選「Datasets」(資料集) 和資料集名稱。
在詳細資料窗格,點選「建立資料表」。
在「Create table」(建立資料表) 頁面的「Source」(來源) 區段中:
在「建立資料表來源」部分,選取「Google Cloud Storage」。
在來源欄位中,瀏覽或輸入 Cloud Storage URI。請注意,您無法在Google Cloud 控制台中加入多個 URI,但可以使用萬用字元。Cloud Storage bucket 必須與資料集位於相同位置,而資料集包含您要建立的資料表。
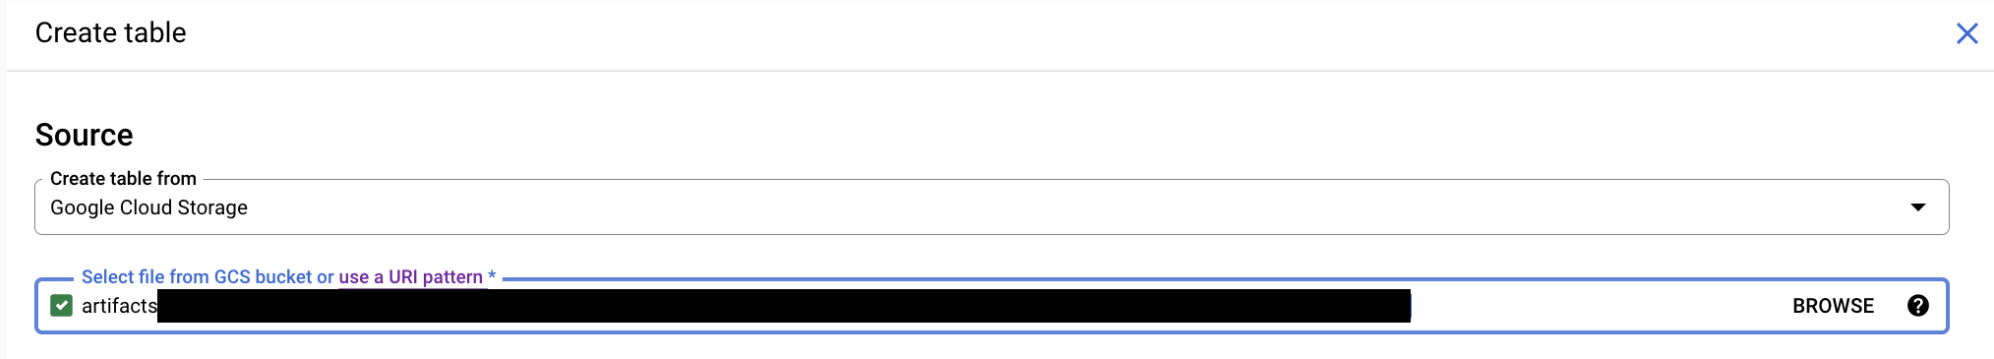
在「File format」(檔案格式) 中,選取 [Avro]。
在「Create table」(建立資料表) 頁面的「Destination」(目的地) 區段中:
- 針對「Dataset name」(資料集名稱),選擇適當的資料集。
- 確認「Table type」(資料表類型) 已設為「Native table」(原生資料表)。
- 在「Table name」(資料表名稱) 欄位中,輸入您在 BigQuery 中建立資料表時使用的資料表名稱。
在「Schema」(結構定義) 區段中,不必執行任何操作。結構定義自述於 Avro 檔案中。
(選用) 如要分區資料表,請在「Partition and cluster settings」(分區與叢集設定) 中選擇選項。詳情請參閱「建立分區資料表」。
(選擇性操作) 針對「Partitioning filter」(分區篩選器),請勾選「Require partition filter」(需要分區篩選器) 的方塊,藉此要求使用者加入
WHERE子句來指定要查詢的分區。使用分區篩選器可以降低成本並提升效能。詳情請參閱「在查詢中要求分區篩選器」。如果選取 [No partitioning] (無分區),就無法使用這個選項。(選用) 如要分群資料表,請在「Clustering order」(分群順序) 方塊中輸入一到四個欄位名稱。
(選擇性操作) 按一下 [Advanced options] (進階選項)。
- 讓「Write preference」(寫入偏好設定) 的 [Write if empty] (空白時寫入) 選項維持在已選取狀態。這個選項能建立新的資料表,並將您的資料載入其中。
- 在「不明的值」部分,請勿勾選「略過不明的值」。這個選項僅適用於 CSV 和 JSON 檔案。
- 在「Encryption」(加密) 部分,按一下「Customer-managed key」(客戶自行管理的金鑰),使用 Cloud Key Management Service 金鑰。如果保留 Google-managed key 設定,BigQuery 會加密靜態資料。
點選「建立資料表」。
SQL
使用 LOAD DATA DDL 陳述式。以下範例會將 Avro 檔案載入新資料表 mytable:
前往 Google Cloud 控制台的「BigQuery」頁面。
在查詢編輯器中輸入下列陳述式:
LOAD DATA OVERWRITE mydataset.mytable
FROM FILES (
  format = 'avro',
  uris = ['gs://bucket/path/file.avro']);
按一下「 執行」。
如要進一步瞭解如何執行查詢,請參閱「執行互動式查詢」。
bq
請使用 bq load 指令,然後使用 --source_format 旗標指定 AVRO,並加入 Cloud Storage URI。您可以加入單一 URI、以逗號分隔的 URI 清單,或包含萬用字元的 URI。
(選用) 提供 --location 旗標,並將值設為您的位置。
其他選用標記包括:
--time_partitioning_type:針對資料表啟用時間分區並設定分區類型。可能的值為HOUR、DAY、MONTH和YEAR。建立依DATE、DATETIME或TIMESTAMP資料欄分區的資料表時,可以選擇是否使用這個旗標。時間分區的預設分區類型為DAY。您無法變更現有資料表的分區規格。--time_partitioning_expiration:這是一個整數,用來指定系統應在何時刪除時間分區 (以秒為單位)。到期時間為分區的世界標準時間日期加上整數值。--time_partitioning_field:用於建立分區資料表的DATE或TIMESTAMP欄。如果啟用時間分區,但未提供這個值,系統會建立擷取時間分區資料表。--require_partition_filter:這個選項啟用後,系統會要求使用者加入WHERE子句,以指定要查詢的分區。使用分區篩選器可以降低成本並提升效能。詳情請參閱「在查詢中要求分區篩選器」。--clustering_fields:以半形逗號分隔的清單,最多列出四個用於建立分群資料表的資料欄名稱。--destination_kms_key:用於加密資料表資料的 Cloud KMS 金鑰。如要進一步瞭解分區資料表,請參閱:
如要進一步瞭解分群資料表,請參閱:
如要進一步瞭解資料表加密作業,請參閱下列說明文章:
如要將 Avro 資料載入 BigQuery,請輸入下列指令:
bq --location=location load \
--source_format=format \
dataset.table \
path_to_source
更改下列內容:
- location 是您的位置。
--location是選用旗標。舉例來說,如果您在東京地區使用 BigQuery,就可以將該旗標的值設定為asia-northeast1。您可以使用 .bigqueryrc 檔案來設定位置的預設值。 - format為
AVRO。 - dataset 是現有資料集。
- table 是您正在載入資料的資料表名稱。
- path_to_source 是完整的 Cloud Storage URI,或以半形逗號分隔的 URI 清單。您也可以使用萬用字元。
範例:
下列指令會將資料從 gs://mybucket/mydata.avro 載入到 mydataset 中名為 mytable 的資料表。
    bq load \
    --source_format=AVRO \
    mydataset.mytable \
    gs://mybucket/mydata.avro
下列指令會將資料從 gs://mybucket/mydata.avro 載入到 mydataset 中名為 mytable 的擷取時間分區資料表。
    bq load \
    --source_format=AVRO \
    --time_partitioning_type=DAY \
    mydataset.mytable \
    gs://mybucket/mydata.avro
下列指令會將 gs://mybucket/mydata.avro 中的資料載入 mydataset 中名為 mytable 的新分區資料表。資料表會依 mytimestamp 資料欄進行分區。
    bq load \
    --source_format=AVRO \
    --time_partitioning_field mytimestamp \
    mydataset.mytable \
    gs://mybucket/mydata.avro
下列指令會將 gs://mybucket/ 中多個檔案的資料載入到 mydataset 中名為 mytable 的資料表。指令中的 Cloud Storage URI 使用萬用字元。
    bq load \
    --source_format=AVRO \
    mydataset.mytable \
    gs://mybucket/mydata*.avro
下列指令會將 gs://mybucket/ 中多個檔案的資料載入到 mydataset 中名為 mytable 的資料表。指令包含以逗號分隔且帶有萬用字元的 Cloud Storage URI 清單。
    bq load \
    --source_format=AVRO \
    mydataset.mytable \
    "gs://mybucket/00/*.avro","gs://mybucket/01/*.avro"
API
建立指向 Cloud Storage 中來源資料的
load工作。source URIs屬性必須是完整的,且必須符合下列格式:gs://bucket/object。每個 URI 可包含一個「*」萬用字元。藉由將
sourceFormat屬性設為AVRO,以指定 Avro 資料格式。如要檢查工作狀態,請呼叫
jobs.get(job_id),其中 job_id 是初始要求傳回的工作 ID。- 如果是
status.state = DONE,代表工作已順利完成。 - 如果出現
status.errorResult屬性,代表要求執行失敗,且該物件會包含描述問題的相關資訊。如果要求執行失敗,系統就不會建立任何資料表,也不會載入任何資料。 - 如果未出現
status.errorResult,代表工作順利完成,但可能有一些不嚴重的錯誤,例如少數資料列在匯入時發生問題。不嚴重的錯誤都會列在已傳回工作物件的status.errors屬性中。
- 如果是
API 附註:
載入工作不可部分完成,且資料狀態具一致性。如果載入工作失敗,所有資料都無法使用;如果載入工作成功,則所有資料都可以使用。
最佳做法是產生專屬 ID,並在呼叫
jobs.insert建立載入工作時,將該 ID 做為jobReference.jobId傳遞。這個方法較不受網路故障問題的影響,因為用戶端可使用已知的工作 ID 進行輪詢或重試。對指定的工作 ID 呼叫
jobs.insert是一種冪等作業。也就是說,您可以對同一個工作 ID 重試無數次,最多會有一個作業成功。
Go
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Go 設定操作說明進行操作。詳情請參閱 BigQuery Go API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
Java
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Java 設定操作說明進行操作。詳情請參閱 BigQuery Java API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
Node.js
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Node.js 設定操作說明進行操作。詳情請參閱 BigQuery Node.js API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Python 設定操作說明進行操作。詳情請參閱 BigQuery Python API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
從 Avro 資料擷取 JSON 資料
如要確保 Avro 資料以 JSON 資料的形式載入 BigQuery,有兩種方法:
為 Avro 結構定義加上註解,並將
sqlType設為JSON。舉例來說,如果您使用下列 Avro 結構定義載入資料,系統會將json_field欄讀取為JSON類型:{ "type": {"type": "string", "sqlType": "JSON"}, "name": "json_field" }
明確指定 BigQuery 目的地資料表結構定義,並將資料欄類型設為
JSON。詳情請參閱「指定結構定義」。
如果您未在 Avro 結構定義或 BigQuery 資料表結構定義中,將 JSON 指定為類型,系統會將資料讀取為 STRING。
將 Avro 資料附加到資料表或使用 Avro 資料覆寫資料表
如要將其他資料載入資料表,您可以指定來源檔案或附加查詢結果。
在 Google Cloud 控制台中,使用「Write preference」(寫入偏好設定) 選項,指定從來源檔案或查詢結果載入資料時要採取的動作。
將額外資料載入資料表時,可以選擇下列選項:
| 主控台選項 | bq 工具旗標 | BigQuery API 屬性 | 說明 |
|---|---|---|---|
| 空白時寫入 | 不支援 | WRITE_EMPTY |
資料表空白時才會寫入資料。 |
| 附加到資料表 | --noreplace 或 --replace=false;如果未指定 --[no]replace,則預設動作為附加 |
WRITE_APPEND |
(預設) 將資料附加至資料表結尾。 |
| 覆寫資料表 | --replace或--replace=true |
WRITE_TRUNCATE |
在寫入新資料前,清除資料表中的所有現有資料。 這項操作也會刪除資料表結構定義、資料列層級安全性,並移除所有 Cloud KMS 金鑰。 |
如果您將資料載入現有資料表,該載入工作可附加資料,或覆寫資料表。
如要使用 Avro 資料附加或覆寫資料表:
控制台
在 Google Cloud 控制台開啟「BigQuery」頁面。
點選左側窗格中的 「Explorer」。
在「Explorer」窗格中展開專案,依序點選「Datasets」(資料集) 和資料集名稱。
在詳細資料窗格,點選「建立資料表」。
在「Create table」(建立資料表) 頁面的「Source」(來源) 區段中:
- 針對「Create table from」(使用下列資料建立資料表),選取 [Cloud Storage]。
在來源欄位中,瀏覽至或輸入 Cloud Storage URI。請注意,您無法在 Google Cloud 控制台中加入多個 URI,但可以使用萬用字元。Cloud Storage bucket 必須與資料集位於相同位置,且該資料集包含您要附加或覆寫的資料表。
在「File format」(檔案格式) 中,選取 [Avro]。
在「Create table」(建立資料表) 頁面的「Destination」(目的地) 區段中:
在「Dataset name」(資料集名稱) 部分選擇適當的資料集。

在「Table name」(資料表名稱) 欄位中,輸入要在 BigQuery 中進行附加或覆寫作業的資料表。
確認「Table type」(資料表類型) 已設為「Native table」(原生資料表)。
在「Schema」(結構定義) 區段中,不必執行任何操作。結構定義自述於 Avro 檔案中。
保留「Partition and cluster settings」(分區與叢集設定) 的預設值。您無法透過附加或覆寫的方式,將資料表轉換為分區或分群資料表,且 Google Cloud 控制台不支援在載入工作中附加或覆寫分區或分群資料表。
點選「進階選項」。
- 針對「Write preference」(寫入偏好設定),選擇 [Append to table] (附加到資料表中) 或 [Overwrite table] (覆寫資料表)。
- 在「不明的值」部分,請勿勾選「略過不明的值」。這個選項僅適用於 CSV 和 JSON 檔案。
- 在「Encryption」(加密) 部分,按一下「Customer-managed key」(客戶自行管理的金鑰),使用 Cloud Key Management Service 金鑰。如果保留 Google-owned and managed key 設定,BigQuery 會加密靜態資料。
點選「建立資料表」。
SQL
使用 LOAD DATA DDL 陳述式。以下範例會將 Avro 檔案附加至 mytable 資料表:
前往 Google Cloud 控制台的「BigQuery」頁面。
在查詢編輯器中輸入下列陳述式:
LOAD DATA INTO mydataset.mytable
FROM FILES (
  format = 'avro',
  uris = ['gs://bucket/path/file.avro']);
按一下「 執行」。
如要進一步瞭解如何執行查詢,請參閱「執行互動式查詢」。
bq
如要覆寫資料表,請輸入 bq load 指令並加上 --replace 旗標。如要附加資料至資料表,使用 --noreplace 旗標。若未指定任何旗標,預設動作為附加資料。提供 --source_format 旗標,並將其設為 AVRO。由於系統會自動從自述來源資料中擷取 Avro 結構定義,所以您不需要提供結構定義。
(選用) 提供 --location 旗標,並將值設為您的位置。
其他選用標記包括:
--destination_kms_key:用於加密資料表資料的 Cloud KMS 金鑰。
bq --location=location load \
--[no]replace \
--source_format=format \
dataset.table \
path_to_source
更改下列內容:
- location是你的位置。
--location是選用旗標。您可以使用 .bigqueryrc 檔案來設定位置的預設值。 - format為
AVRO。 - dataset 是現有資料集。
- table 是您正在載入資料的資料表名稱。
- path_to_source 是完整的 Cloud Storage URI,或以半形逗號分隔的 URI 清單。您也可以使用萬用字元。
範例:
下列指令會從 gs://mybucket/mydata.avro 載入資料,並覆寫 mydataset 中名為 mytable 的資料表。
    bq load \
    --replace \
    --source_format=AVRO \
    mydataset.mytable \
    gs://mybucket/mydata.avro
下列指令會從 gs://mybucket/mydata.avro 載入資料,並將資料附加至 mydataset 中名為 mytable 的資料表。
    bq load \
    --noreplace \
    --source_format=AVRO \
    mydataset.mytable \
    gs://mybucket/mydata.avro
如要瞭解如何使用 bq 指令列工具附加及覆寫分區資料表,請參閱「附加及覆寫分區資料表資料」。
API
建立指向 Cloud Storage 中來源資料的
load工作。source URIs屬性必須是完整的,且必須符合下列格式:gs://bucket/object。您可以使用逗號分隔清單的形式加入多個 URI。請注意,系統也支援使用萬用字元。藉由將
configuration.load.sourceFormat屬性設為AVRO,以指定資料格式。藉由將
configuration.load.writeDisposition屬性設為WRITE_TRUNCATE或WRITE_APPEND,以指定寫入偏好設定。
Go
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Go 設定操作說明進行操作。詳情請參閱 BigQuery Go API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
Java
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Java 設定操作說明進行操作。詳情請參閱 BigQuery Java API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
Node.js
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Node.js 設定操作說明進行操作。詳情請參閱 BigQuery Node.js API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Python 設定操作說明進行操作。詳情請參閱 BigQuery Python API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
正在載入 Hive 分區的 Avro 資料
BigQuery 支援載入儲存在 Cloud Storage 的 Hive 分區 Avro 資料,並將 Hive 分區資料欄填入目的地 BigQuery 代管資料表。詳情請參閱「載入外部分區資料」。
Avro 轉換
BigQuery 會將 Avro 資料類型轉換為下列 BigQuery 資料類型:
原始類型
| BigQuery 資料類型 | 附註 | |
|---|---|---|
| null | BigQuery 會略過這些值 | |
| boolean | BOOLEAN | |
| int | INTEGER | |
| long | INTEGER | |
| float | FLOAT | |
| double | FLOAT | |
| bytes | BYTES | |
| string | STRING | 僅限 UTF-8 |
邏輯類型
根據預設,BigQuery 會忽略多數類型的 logicalType 屬性,並改用基礎 Avro 類型。如要將 Avro 邏輯類型轉換為對應的 BigQuery 資料類型,請使用 bq 指令列工具將 --use_avro_logical_types 旗標設為 true,或在呼叫 jobs.insert 方法建立載入工作時,設定工作資源中的 useAvroLogicalTypes 屬性。
下表顯示 Avro 邏輯類型到 BigQuery 資料類型的轉換。
| BigQuery 資料類型:已停用邏輯類型 | BigQuery 資料類型:已啟用邏輯類型 | |
|---|---|---|
| 日期 | INTEGER | DATE |
| time-millis | INTEGER | 時間 |
| time-micros | INTEGER (從 LONG 轉換) | 時間 |
| timestamp-millis | INTEGER (從 LONG 轉換) | TIMESTAMP |
| timestamp-micros | INTEGER (從 LONG 轉換) | TIMESTAMP |
| local-timestamp-millis | INTEGER (從 LONG 轉換) | DATETIME |
| local-timestamp-micros | INTEGER (從 LONG 轉換) | DATETIME |
| 持續時間 | BYTES (從大小為 12 的 fixed 類型轉換) |
BYTES (從大小為 12 的 fixed 類型轉換) |
| decimal | NUMERIC、BIGNUMERIC 或 STRING (請參閱「十進位邏輯類型」) | NUMERIC、BIGNUMERIC 或 STRING (請參閱「十進位邏輯類型」) |
如需進一步瞭解 Avro 資料類型,請參閱 Apache Avro™ 1.8.2 規格。
日期邏輯類型
在您要載入的任何 Avro 檔案中,必須以下列格式指定日期邏輯類型:
{
       "type": {"logicalType": "date", "type": "int"},
       "name": "date_field"
}
Decimal 邏輯類型
Decimal 邏輯類型可轉換為 NUMERIC、BIGNUMERIC 或 STRING 類型。轉換後的類型取決於 decimal 邏輯類型的有效位數和小數位數參數,以及指定的小數目標類型。請按照下列方式指定十進位指定類型:
- 如要使用
jobs.insertAPI 執行載入工作,請使用JobConfigurationLoad.decimalTargetTypes欄位。 - 如要使用 bq 指令列工具中的
bq load指令執行載入工作,請使用--decimal_target_types旗標。 - 如要查詢具有外部來源的資料表,請使用
ExternalDataConfiguration.decimalTargetTypes欄位。 - 如果是使用 DDL 建立的永久外部資料表:請使用
decimal_target_types選項。
為確保回溯相容性,如果未指定十進位指定類型,您可以將包含 bytes 資料欄 (具有 decimal 邏輯類型) 的 Avro 檔案載入現有資料表的 BYTES 資料欄。在這種情況下,系統會忽略 Avro 檔案中資料欄的 decimal 邏輯類型。這個轉換模式已淘汰,日後可能會移除。
如要進一步瞭解 Avro decimal邏輯類型,請參閱 Apache Avro™ 1.8.2 規格。
時間邏輯類型
在您要載入的任何 Avro 檔案中,必須以下列其中一種格式指定時間邏輯類型。
如要精確到毫秒:
{
       "type": {"logicalType": "time-millis", "type": "int"},
       "name": "time_millis_field"
}
如要達到微秒精確度:
{
       "type": {"logicalType": "time-micros", "type": "int"},
       "name": "time_micros_field"
}
時間戳記邏輯類型
在您要載入的任何 Avro 檔案中,您必須以下列其中一種格式指定時間戳記邏輯類型。
如要精確到毫秒:
{
       "type": {"logicalType": "timestamp-millis", "type": "long"},
       "name": "timestamp_millis_field"
}
如要達到微秒精確度:
{
       "type": {"logicalType": "timestamp-micros", "type": "long"},
       "name": "timestamp_micros_field"
}
Local-Timestamp 邏輯類型
在您要載入的任何 Avro 檔案中,您必須以下列其中一種格式指定 local-timestamp 邏輯類型。
如要精確到毫秒:
{
       "type": {"logicalType": "local-timestamp-millis", "type": "long"},
       "name": "local_timestamp_millis_field"
}
如要達到微秒精確度:
{
       "type": {"logicalType": "local-timestamp-micros", "type": "long"},
       "name": "local_timestamp_micros_field"
}
複合類型
| BigQuery 資料類型 | 附註 | |
|---|---|---|
| record | RECORD |
|
| enum | STRING |
|
| array | 重複欄位 | 不支援陣列的陣列。只包含 NULL 類型的陣列會被略過。 |
| map<T> | RECORD | BigQuery 會將 Avro map<T> 欄位轉換為包含兩個欄位 (鍵與值) 的重複 RECORD。BigQuery 會將鍵儲存為 STRING,並將其值轉換為 BigQuery 中相對應的資料類型。 |
| 聯集 |
|
|
| fixed | BYTES |
|