


透過變更資料擷取擷取功能串流資料表更新
BigQuery 變更資料擷取 (CDC) 擷取功能可讓您串流即時 upsert 和刪除資料列作業,讓資料表與來源資料變更保持同步。您也可以設定資料表過時時間間隔和自訂序號,在查詢時效性、排序和運算成本之間取得平衡。本文假設您熟悉 BigQuery Storage Write API (gRPC)。
事前準備
授予 Identity and Access Management (IAM) 角色,讓使用者具備執行本文件中各項工作所需的權限,並確保工作流程符合各項必要條件。
所需權限
如要取得使用 Storage Write API (gRPC) 所需的權限,請要求管理員授予您 BigQuery 資料編輯者 (roles/bigquery.dataEditor) IAM 角色。如要進一步瞭解如何授予角色,請參閱「管理專案、資料夾和組織的存取權」。
這個預先定義的角色具備 bigquery.tables.updateData 權限,可使用 Storage Write API (gRPC)。
如要進一步瞭解 BigQuery 的 IAM 角色和權限,請參閱「IAM 簡介」。
必要條件
如要使用 BigQuery CDC 擷取功能,工作流程必須符合下列條件:
- 您必須在預設串流中使用 Storage Write API (gRPC)。
- 您必須使用 protobuf 格式做為擷取格式。不支援 Apache Arrow 格式。
- 您必須在 BigQuery 中宣告目的地資料表的主鍵。支援最多包含 16 個資料欄的複合式主鍵。
- 必須有足夠的 BigQuery 運算資源,才能執行 CDC 資料列作業。請注意,如果 CDC 資料列修改作業失敗,您可能會不小心保留原本要刪除的資料。詳情請參閱「刪除資料注意事項」。
指定現有記錄的變更
在 BigQuery CDC 擷取作業中,虛擬資料欄 _CHANGE_TYPE 會指出各資料列要處理的變更類型。如要使用 CDC,請在使用 Storage Write API (gRPC) 串流資料列修改內容時,設定 _CHANGE_TYPE。虛擬資料欄 _CHANGE_TYPE 僅接受 UPSERT 和 DELETE 值。如果 Storage Write API (gRPC) 以這種方式將資料列修改內容串流至資料表,或正在套用待處理的資料列修改內容,則資料表會視為已啟用 CDC。
UPSERT 和 DELETE 值的範例
請參考下列 BigQuery 資料表:
| ID | 名稱 | 薪資 |
|---|---|---|
| 100 | Charlie | 2000 |
| 101 | Tal | 3000 |
| 102 | Lee | 5000 |
Storage Write API (gRPC) 會串流下列資料列修改內容:
| ID | 名稱 | 薪資 | _CHANGE_TYPE |
|---|---|---|---|
| 100 | 刪除 | ||
| 101 | Tal | 8000 | UPSERT |
| 105 | Izumi | 6000 | UPSERT |
更新後的表格如下:
| ID | 名稱 | 薪資 |
|---|---|---|
| 101 | Tal | 8000 |
| 102 | Lee | 5000 |
| 105 | Izumi | 6000 |
管理資料表過時狀態
根據預設,每次執行查詢時,BigQuery 都會傳回最新結果。查詢含有有效 CDC 的資料表時,為提供最新結果,BigQuery 必須在查詢開始時間前套用每項串流資料列修改,以便查詢最新版本的資料表。在查詢執行期間套用這些資料列修改,會增加查詢延遲時間和成本。不過,如果您不需要完全最新的查詢結果,可以設定資料表的 max_staleness 選項,降低查詢成本和延遲時間。設定這個選項後,BigQuery 會在 max_staleness 值定義的間隔內,至少套用一次資料列修改,讓您不必等待更新套用,即可執行查詢,但代價是資料會有些過時。
如果資訊主頁和報表不需要最新資料,這項行為就特別實用。此外,您還能進一步控管 BigQuery 套用資料列修改作業的頻率,有助於管理費用。
查詢已設定 max_staleness 選項的資料表
查詢已設定 max_staleness 選項的資料表時,BigQuery 會根據 max_staleness 的值和上次套用工作的時間 (以資料表的 upsert_stream_apply_watermark 時間戳記表示) 傳回結果。
請參考以下範例,其中資料表的 max_staleness 選項設為 10 分鐘,而最近一次套用工作發生在 T20:
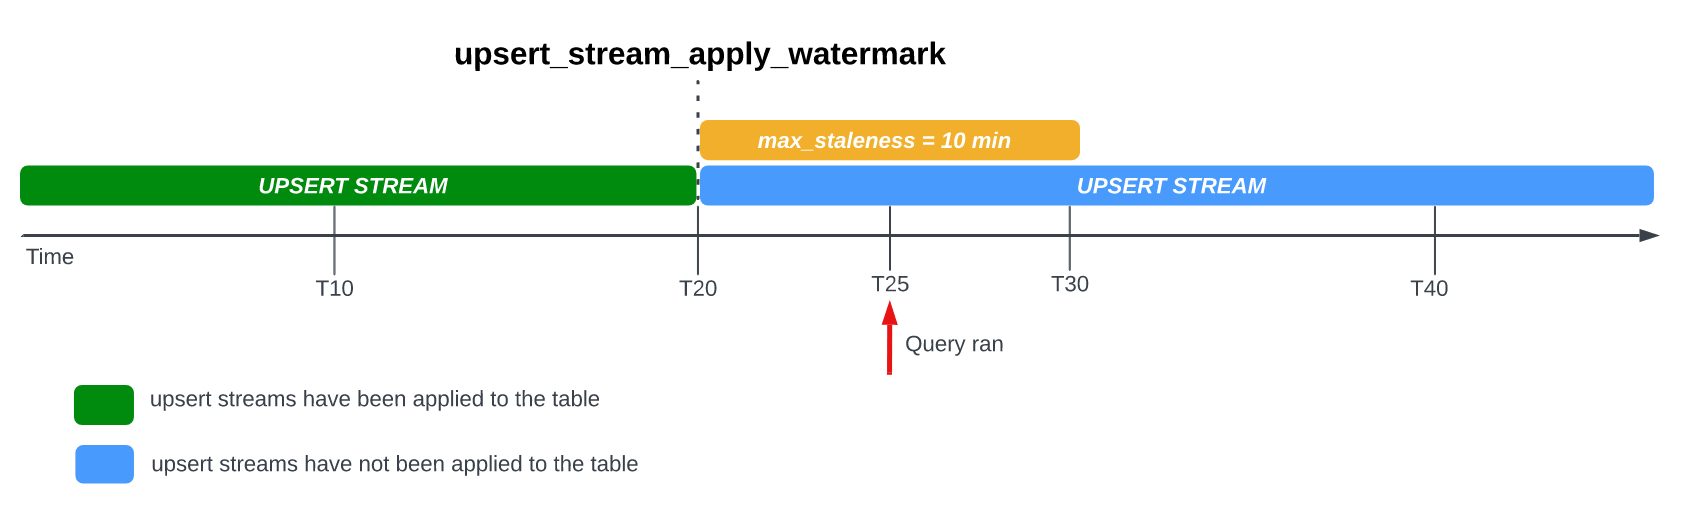
如果您在 T25 查詢資料表,則資料表的目前版本已過時 5 分鐘,小於 10 分鐘的 max_staleness 間隔。在這種情況下,BigQuery 會傳回 T20 的資料表基準版本,也就是說,傳回的資料也過時了 5 分鐘。
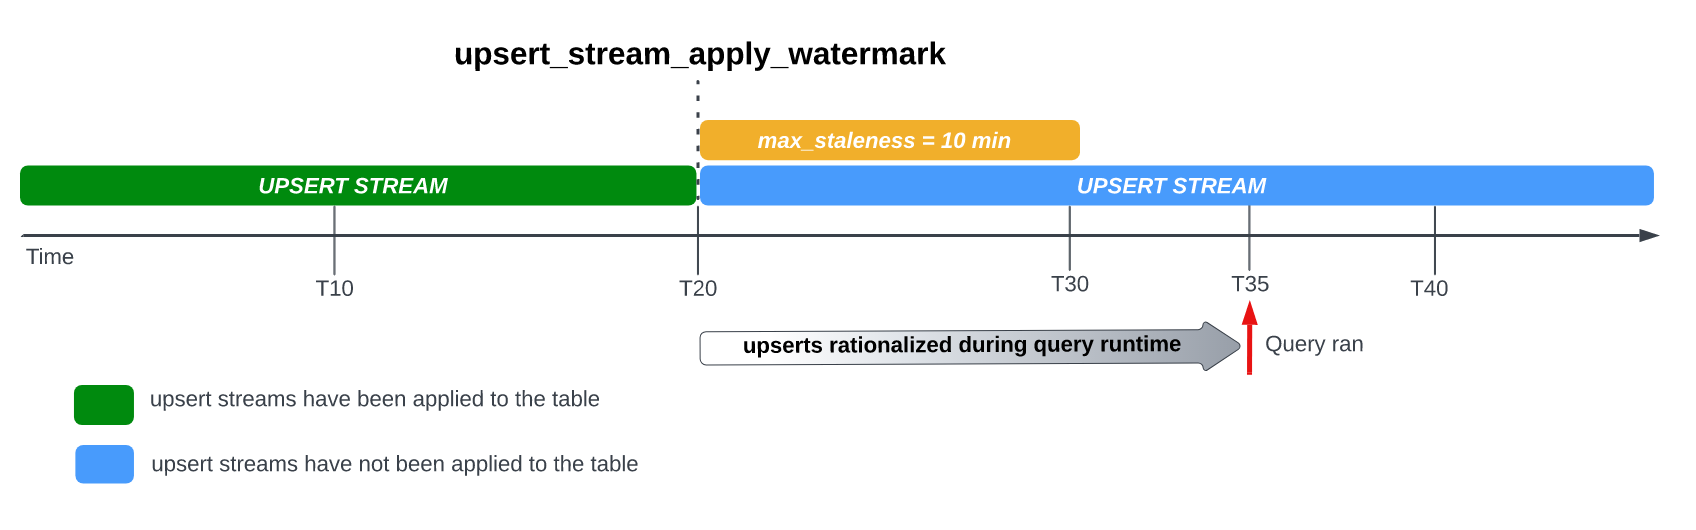
在資料表上設定 max_staleness 選項時,BigQuery 會在 max_staleness 間隔內至少套用一次待處理的資料列修改。不過,在某些情況下,BigQuery 可能無法在間隔內完成套用這些待處理資料列修改作業的程序。
舉例來說,如果您在 T35 查詢資料表,而套用待處理資料列修改作業的程序尚未完成,則資料表的目前版本已過時 15 分鐘,超過 10 分鐘的 max_staleness 間隔。在這種情況下,BigQuery 會在查詢執行時,為目前查詢套用 T20 到 T35 之間的所有資料列修改,這表示查詢的資料完全是最新的,但會產生一些額外的查詢延遲。這稱為「執行階段合併工作」。
分區剪除和執行階段合併
當您查詢已啟用 CDC 的分區資料表 (例如由 Datastream 複製的目的地資料表) 時,BigQuery 是否能套用分區剪除,取決於查詢是否會觸發執行階段合併工作:
max_staleness視窗內的查詢:如果上次背景套用工作後經過的時間在資料表的max_staleness間隔內,BigQuery 會直接從基準資料表讀取。分區剪除和叢集剪除會正常運作,BigQuery 只會掃描符合WHERE子句篩選條件的分區。- 觸發執行階段合併的查詢:如果未設定
max_staleness、設為0,或基準資料表早於max_staleness間隔,BigQuery 會執行基準資料表和最近串流資料列修改作業的執行階段合併。在執行階段合併期間,系統會略過分區剪除,因為 BigQuery 無法預先判斷哪些分區會受到未套用的串流變更影響。因此,即使您篩選分區資料欄,查詢仍會掃描整個資料表。
如果查詢可以容忍輕微的資料過時,您可以啟用分區剪除功能,並在資料表上設定 max_staleness 選項 (例如 15 分鐘),避免完整資料表掃描,讓背景套用工作在查詢執行前合併變更:
ALTER TABLE `DATASET_NAME.TABLE_NAME`
SET OPTIONS (
  max_staleness = INTERVAL 15 MINUTE);
更改下列內容:
DATASET_NAME:資料表所在的資料集名稱。TABLE_NAME:分區資料表的名稱。
如要瞭解如何選擇間隔,避免工作負載在執行階段合併,請參閱「建議的資料表 max_staleness 值」。
建議的資料表 max_staleness 值
資料表的 max_staleness 值通常應為下列兩個值中較高者:
- 工作流程可容忍的資料過時程度上限。
- 將 upsert 變更套用至資料表所需的時間上限乘以二,再加上一些額外緩衝時間。
如要計算將 upsert 變更套用至現有資料表所需的時間,請使用下列 SQL 查詢,判斷背景套用工作的第 95 個百分位數時間長度,再加上 7 分鐘的緩衝時間,以便進行 BigQuery 寫入最佳化儲存空間 (串流緩衝區) 轉換。
SELECT
  project_id,
  destination_table.dataset_id,
  destination_table.table_id,
  APPROX_QUANTILES((TIMESTAMP_DIFF(end_time, creation_time,MILLISECOND)/1000), 100)[OFFSET(95)] AS p95_background_apply_duration_in_seconds,
  CEILING(APPROX_QUANTILES((TIMESTAMP_DIFF(end_time, creation_time,MILLISECOND)/1000), 100)[OFFSET(95)]*2/60)+7 AS recommended_max_staleness_with_buffer_in_minutes
FROM `region-REGION`.INFORMATION_SCHEMA.JOBS AS job
WHERE
  project_id = 'PROJECT_ID'
  AND DATE(creation_time) BETWEEN DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY) AND CURRENT_DATE()
  AND job_id LIKE "%cdc_background%"
GROUP BY 1,2,3;
更改下列內容:
REGION:專案所在的區域名稱。例如:us。PROJECT_ID:專案 ID,內含 BigQuery CDC 擷取作業修改的 BigQuery 資料表。
背景套用工作的時間長度會受到多項因素影響,包括在過時時間間隔內發出的 CDC 作業數量和複雜度、資料表大小,以及 BigQuery 資源可用性。如要進一步瞭解資源可用性,請參閱「調整及監控 BACKGROUND 預留項目」。
使用 max_staleness 選項建立資料表
如要使用 max_staleness 選項建立資料表,請使用 CREATE TABLE 陳述式。以下範例會建立資料表 employees,並將 max_staleness 限制設為 10 分鐘:
CREATE TABLE employees (
  id INT64 PRIMARY KEY NOT ENFORCED,
  name STRING)
  CLUSTER BY
    id
  OPTIONS (
    max_staleness = INTERVAL 10 MINUTE);
修改現有資料表的 max_staleness 選項
如要在現有資料表中新增或修改 max_staleness 限制,請使用 ALTER TABLE 陳述式。以下範例會將 employees 資料表的 max_staleness 限制變更為 15 分鐘:
ALTER TABLE employees
SET OPTIONS (
  max_staleness = INTERVAL 15 MINUTE);
判斷資料表目前的 max_staleness 值
如要判斷資料表目前的 max_staleness 值,請查詢 INFORMATION_SCHEMA.TABLE_OPTIONS 檢視表。以下範例會檢查資料表 mytable 目前的 max_staleness 值:
SELECT
  option_name,
  option_value
FROM
  DATASET_NAME.INFORMATION_SCHEMA.TABLE_OPTIONS
WHERE
  option_name = 'max_staleness'
  AND table_name = 'TABLE_NAME';
更改下列內容:
DATASET_NAME:資料表所在的資料集名稱。TABLE_NAME:資料表名稱。
結果顯示 max_staleness 值為 10 分鐘:
+---------------------+--------------+
| Row |  option_name  | option_value |
+---------------------+--------------+
|  1  | max_staleness | 0-0 0 0:10:0 |
+---------------------+--------------+
監控資料表 upsert 作業進度
如要監控資料表狀態,並查看上次套用資料列修改的時間,請查詢 INFORMATION_SCHEMA.TABLES 檢視表,取得 upsert_stream_apply_watermark 時間戳記。
以下範例會檢查 mytable 資料表的 upsert_stream_apply_watermark 值:
SELECT upsert_stream_apply_watermark
FROM DATASET_NAME.INFORMATION_SCHEMA.TABLES
WHERE table_name = 'TABLE_NAME';
更改下列內容:
DATASET_NAME:資料表所在的資料集名稱。TABLE_NAME:資料表名稱。
結果大致如下:
[{
 "upsert_stream_apply_watermark": "2022-09-15T04:17:19.909Z"
}]
更新插入作業是由 bigquery-adminbot@system.gserviceaccount.com 服務帳戶執行,並會顯示在專案的工作記錄中,該專案包含啟用 CDC 的資料表。
管理自訂排序
將新增或更新串流至 BigQuery 時,系統會根據記錄擷取至 BigQuery 的 BigQuery 系統時間,決定主鍵相同記錄的預設行為。也就是說,最近擷取且時間戳記最新的記錄,優先順序高於先前擷取且時間戳記較舊的記錄。在某些用途中,例如在極短時間內對相同主鍵進行非常頻繁的 upsert,或無法保證 upsert 順序時,這可能不夠。在這些情況下,可能需要使用者提供的排序鍵。
如要設定使用者提供的排序鍵,請使用虛擬資料欄 _CHANGE_SEQUENCE_NUMBER,指示 BigQuery 根據兩個具有相同主鍵的比對記錄中較大的 _CHANGE_SEQUENCE_NUMBER,套用記錄的順序。虛擬資料欄 _CHANGE_SEQUENCE_NUMBER 是選用資料欄,僅接受固定格式 STRING 的值。
_CHANGE_SEQUENCE_NUMBER
格式
虛擬資料欄 _CHANGE_SEQUENCE_NUMBER 只接受 STRING 值,且必須以固定格式寫入。這種固定格式使用以十六進位表示的 STRING 值,並以正斜線 / 分隔成多個部分。每個區段最多可包含 16 個十六進位字元,每個 _CHANGE_SEQUENCE_NUMBER 最多可包含四個區段。_CHANGE_SEQUENCE_NUMBER 的允許範圍支援 0/0/0/0 到 FFFFFFFFFFFFFFFF/FFFFFFFFFFFFFFFF/FFFFFFFFFFFFFFFF/FFFFFFFFFFFFFFFF 之間的值。_CHANGE_SEQUENCE_NUMBER 值同時支援大寫和小寫字元。
您可以使用單一區段來表示基本排序鍵。舉例來說,如要單純根據應用程式伺服器記錄的處理時間戳記排序索引鍵,可以使用一個區段:'2024-04-30 11:19:44 UTC',將時間戳記轉換為 Epoch 毫秒數,以十六進位表示,在本例中為 '18F2EBB6480'。使用 Storage Write API (gRPC) 將資料寫入 BigQuery 時,用戶端必須負責將資料轉換為十六進位。
支援多個區段可讓您將多個處理邏輯值合併為一個鍵,以因應更複雜的用途。舉例來說,如要根據應用程式伺服器的記錄處理時間戳記、記錄序號和記錄狀態來排序索引鍵,可以使用三個部分:'2024-04-30 11:19:44 UTC' / '123' / 'complete',每個部分都以十六進位表示。區段的順序是決定處理邏輯排名的重要考量因素。BigQuery 會先比較第一個部分,然後在先前部分相等時,才會比較下一個部分,藉此比較 _CHANGE_SEQUENCE_NUMBER 值。
BigQuery 會使用 _CHANGE_SEQUENCE_NUMBER,將兩個以上的 _CHANGE_SEQUENCE_NUMBER 欄位視為不帶正負號的數值進行比較,藉此執行排序。
請參考以下 _CHANGE_SEQUENCE_NUMBER 比較範例及其優先順序結果:
範例 1:
- 記錄 #1:
_CHANGE_SEQUENCE_NUMBER= '77' - 記錄 #2:
_CHANGE_SEQUENCE_NUMBER= '7B'
結果:記錄 #2 視為最新記錄,因為「7B」>「77」(即「123」>「119」)
- 記錄 #1:
範例 2:
- 記錄 #1:
_CHANGE_SEQUENCE_NUMBER= 'FFF/B' - 記錄 #2:
_CHANGE_SEQUENCE_NUMBER= 'FFF/ABC'
結果:記錄 #2 視為最新記錄,因為「FFF/ABC」>「FFF/B」(即「4095/2748」>「4095/11」)
- 記錄 #1:
範例 3:
- 記錄 #1:
_CHANGE_SEQUENCE_NUMBER= 'BA/FFFFFFFF' - 記錄 #2:
_CHANGE_SEQUENCE_NUMBER= 'ABC'
結果:記錄 #2 視為最新記錄,因為「ABC」>「BA/FFFFFFFF」(即「2748」>「186/4294967295」)
- 記錄 #1:
範例 4:
- 記錄 1:
_CHANGE_SEQUENCE_NUMBER= 'FFF/ABC' - 記錄 #2:
_CHANGE_SEQUENCE_NUMBER= 'ABC'
結果:記錄 #1 視為最新記錄,因為「FFF/ABC」>「ABC」(即「4095/2748」>「2748」)
- 記錄 1:
如果兩個 _CHANGE_SEQUENCE_NUMBER 值相同,則 BigQuery 系統擷取時間最新的記錄優先於先前擷取的記錄。
如果表格使用自訂排序,請務必提供 _CHANGE_SEQUENCE_NUMBER 值。如果寫入要求未指定
_CHANGE_SEQUENCE_NUMBER 值,導致資料列中同時存在有
_CHANGE_SEQUENCE_NUMBER 值和沒有
_CHANGE_SEQUENCE_NUMBER 值的情況,排序結果將無法預測。
設定 BigQuery 預留項目,用於 CDC 擷取作業
您可以使用 BigQuery 預留項目,分配 CDC 資料列修改作業專用的 BigQuery 運算資源。預留項目可讓您設定執行這些作業的費用上限。如果工作流程經常對大型資料表執行 CDC 作業,這種做法特別實用,否則每次執行作業時,都會處理大量位元組,導致隨選費用高昂。
在 max_staleness 間隔內套用待處理資料列修改作業的 BigQuery CDC 擷取工作,會視為背景工作,並使用 BACKGROUND 或 BACKGROUND_CHANGE_DATA_CAPTURE 指派類型,而非 QUERY 指派類型。相較之下,max_staleness 間隔以外的查詢,如果需要在查詢執行時套用資料列修改,則會使用 QUERY 指派類型。如果表格沒有 max_staleness 設定,或 max_staleness 設為 0,也會使用 QUERY 指派類型。如果執行 BigQuery CDC 擷取背景工作時,未指派 BACKGROUND 或 BACKGROUND_CHANGE_DATA_CAPTURE,則會採用隨選定價。為 BigQuery CDC 擷取作業設計工作負載管理策略時,請務必考量這項因素。
如要設定與 CDC 搭配使用的 BigQuery 預留項目,請先在 BigQuery 資料表所在區域設定預留項目。如需預留項目大小的相關指引,請參閱「調整及監控 BACKGROUND 預留項目」。建立預留項目後,請將 BigQuery 專案指派給預留項目,並執行下列 CREATE ASSIGNMENT 陳述式,將 job_type 選項設為 BACKGROUND:
CREATE ASSIGNMENT
  `ADMIN_PROJECT_ID.region-REGION.RESERVATION_NAME.ASSIGNMENT_ID`
OPTIONS (
  assignee = 'projects/PROJECT_ID',
  job_type = 'BACKGROUND');
更改下列內容:
ADMIN_PROJECT_ID:擁有預留項目的管理專案 ID。REGION:專案所在的區域名稱。例如:us。RESERVATION_NAME:預留項目名稱。ASSIGNMENT_ID:作業 ID。ID 在專案和位置中不得重複,開頭和結尾須為小寫英文字母或數字,且只能使用小寫英文字母、數字和破折號。PROJECT_ID:專案 ID,該專案包含 BigQuery CDC 擷取作業修改的 BigQuery 資料表。這項專案已指派給預留項目。
調整及監控 BACKGROUND 預留項目
預留項目會決定可用於執行 BigQuery 運算作業的運算資源量。如果預留項目過小,CDC 資料列修改作業的處理時間可能會增加。如要準確預估預留項目大小,請查詢 INFORMATION_SCHEMA.JOBS_TIMELINE 檢視表,監控執行 CDC 作業的專案歷來運算單元用量:
SELECT
  period_start,
  SUM(period_slot_ms) / (1000 * 60) AS slots_used
FROM
  region-REGION.INFORMATION_SCHEMA.JOBS_TIMELINE_BY_PROJECT
WHERE
  DATE(job_creation_time) BETWEEN DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY)
  AND CURRENT_DATE()
  AND job_id LIKE '%cdc_background%'
GROUP BY
  period_start
ORDER BY
  period_start DESC;
將 REGION 替換為專案所在的區域名稱。例如:us。
已刪除資料的注意事項
- BigQuery CDC 擷取作業會使用 BigQuery 運算資源。如果 CDC 作業設為使用隨選計費,系統會定期使用內部 BigQuery 資源執行 CDC 作業。如果 CDC 作業設有
BACKGROUND或BACKGROUND_CHANGE_DATA_CAPTURE預留項目,則 CDC 作業會受限於所設預留項目的資源可用性。如果設定的預留項目中沒有足夠的可用資源,處理 CDC 作業 (包括刪除) 的時間可能會比預期長。 - 只有在
upsert_stream_apply_watermark時間戳記超過 Storage Write API (gRPC) 串流作業的時間戳記時,系統才會套用 CDCDELETE作業。如要進一步瞭解upsert_stream_apply_watermark時間戳記,請參閱「監控資料表 upsert 作業進度」。 - 為了套用不按順序抵達的 CDC
DELETE作業,BigQuery 會保留兩天的刪除保留期。在這段期間內,系統會儲存資料表DELETE作業,然後才開始標準Google Cloud 資料刪除程序。在刪除保留期間內,DELETE作業會按照標準 BigQuery 儲存空間定價計費。
限制
- BigQuery CDC 擷取作業不會強制執行鍵,因此主鍵必須不重複。
- 主鍵不得超過 16 個資料欄。
- 如果資料表已啟用 CDC,則資料表結構定義定義的頂層資料欄不得超過 2,000 個。
- 啟用 CDC 的資料表不支援下列項目:
DELETE、UPDATE和MERGE等資料操縱語言 (DML) 異動陳述式。如果資料表正在接收 CDC 串流,或資料表仍有未合併的變更,系統會封鎖變動 DML 陳述式。如果沒有任何執行中的 upsert 串流,且所有待變更項目都已合併至基準資料表,則支援變動 DML 陳述式。如果使用 DML 修改目的地資料表,請確保變更不會在 CDC 串流恢復時,導致資料與來源資料庫不一致。- 查詢Wildcard 資料表
- 搜尋索引
- 如果資料表的
max_staleness值過低,導致資料表在 CDC 啟用時執行執行階段合併工作,則不支援下列項目: - 如果資料表已啟用 CDC,BigQuery 匯出作業不會匯出最近串流、尚未由背景工作套用的資料列修改內容。如要匯出完整資料表,請使用
EXPORT DATA陳述式。 - 如果查詢在分區資料表上觸發執行階段合併,則系統會略過分區剪除,並掃描整個資料表,無論查詢是否僅限於分區子集。如要允許對可容忍輕微資料過時的查詢進行分區剪除,請設定資料表的
max_staleness選項。 - 如果您使用的是標準版,則無法使用
BACKGROUND預留項目,因此套用待處理的資料列修改項目時,會採用隨選定價模式。不過,無論使用哪個版本,您都可以查詢已啟用 CDC 的資料表。 - 執行資料表讀取作業時,無法查詢虛擬資料欄
_CHANGE_TYPE和_CHANGE_SEQUENCE_NUMBER。 - 系統不支援在同一連線中,混合
_CHANGE_TYPE具有UPSERT或DELETE值的資料列,以及_CHANGE_TYPE具有INSERT或未指定值的資料列,否則會導致下列驗證錯誤:The given value is not a valid CHANGE_TYPE。
BigQuery CDC 擷取作業定價
BigQuery CDC 擷取作業會使用 Storage Write API (gRPC) 擷取資料、BigQuery 儲存空間儲存資料,以及 BigQuery 運算資源執行資料列修改作業,這些都會產生費用。如需定價資訊,請參閱「BigQuery 定價」。
預估 BigQuery CDC 擷取費用
除了一般 BigQuery 費用估算最佳做法外,如果工作流程有大量資料、max_staleness 設定較低,或資料經常變更,則估算 BigQuery CDC 擷取費用可能很重要。
BigQuery 資料擷取定價和 BigQuery 儲存空間定價是直接根據您擷取和儲存的資料量 (包括虛擬資料欄) 計算。不過,BigQuery 運算定價較難預估,因為這與執行 BigQuery CDC 擷取工作時,所耗用的運算資源有關。
BigQuery CDC 擷取工作分為三類:
- 背景套用工作:在背景定期執行的工作,執行頻率由資料表的
max_staleness值定義。這些工作會將最近串流的資料列修改內容,套用至已啟用 CDC 的資料表。 - 查詢工作:在
max_staleness視窗內執行的 GoogleSQL 查詢,且僅從啟用 CDC 的資料表基準讀取。 - 執行階段合併工作:由
max_staleness視窗外執行的臨時 GoogleSQL 查詢觸發的工作。這些工作必須在查詢執行階段,即時合併資料表的基準 (已啟用 CDC) 和最近串流的資料列修改內容。這類工作不會推進upsert_stream_apply_watermark時間戳記。
只有查詢工作會使用 BigQuery 分割。背景套用工作和執行階段合併工作無法使用分區,因為套用最近串流的資料列修改時,無法保證最近串流的 upsert 會套用至哪個資料表分區。換句話說,在背景套用工作和執行階段合併工作期間,系統會讀取完整的基準資料表。基於相同原因,只有查詢工作能受益於 BigQuery 叢集資料欄的篩選器。瞭解執行 CDC 作業時讀取的資料量,有助於估算總費用。
如果從資料表基準讀取的資料量很大,建議使用 BigQuery 運算資源定價模式,這種模式不會根據處理的資料量計費。
BigQuery CDC 擷取成本最佳做法
除了一般 BigQuery 成本最佳做法,您也可以使用下列技術,盡可能降低 BigQuery CDC 擷取作業的成本:
- 除非必要,否則請避免將資料表的
max_staleness選項設為極低的值。max_staleness值可能會增加背景套用工作和執行階段合併工作的發生頻率,這些工作比查詢工作更昂貴且更慢。如需詳細指南,請參閱「建議的表格max_staleness值」。 - 建議設定 BigQuery 預留項目,以便與 CDC 資料表搭配使用。否則,背景套用工作和執行階段合併工作會採用隨選定價,由於資料處理量較多,費用可能較高。詳情
請參閱
BigQuery 預留項目,並
按照這篇文章的指引,
瞭解如何調整及監控
BACKGROUND預留項目大小,以便 用於 BigQuery CDC 擷取作業。
後續步驟
- 瞭解如何實作 Storage Write API (gRPC) 預設串流。
- 瞭解 Storage Write API (gRPC) 的最佳做法。
- 瞭解如何使用 Datastream,透過 BigQuery CDC 擷取功能將交易資料庫複製到 BigQuery。